2026年に試す価値のあるKimi K2.7 Codeの代替8選
Kurnia Kharisma

Katelin Teen
最終更新 July 9, 2026
人々がKimi K2.7 Codeの代替を探す理由
まずはMoonshotの功績を正当に評価しておこう。Kimi K2.7 Codeは、本当に信頼できるオープンウェイトのコーディングモデルだ。1兆パラメータのMixture-of-Expertsモデル(トークンごとに320億パラメータが活性化)であり、Moonshotが公開した6つのベンチマークすべてで前モデルのKimi K2.6を上回っている。さらに100万トークンあたり入力0.95ドル/出力4.00ドルという価格は、あらゆるクローズドなフロンティアモデルよりも安い。重みはModified MITライセンスの下で配布されており、セルフホストはマーケティング上の建前ではなく実際に取れる選択肢だ。
それでも人々が離れていく理由は、漠然とした不満ではなく具体的なものだ。3つの理由については私のKimi K2.7 Code reviewで詳しく掘り下げているが、要点は次の通りだ。
- 効率性に関する目玉の主張が実際の請求額と一致しない。 Moonshotのモデルカードは、K2.6より推論トークンが約30%少ないと謳っている。しかし実際のユーザーは真逆の結果を報告している。
- Thinking modeが必須である。 無効化することも、固定されたサンプリングパラメータを上書きすることもできないため、推論の深さと速度・コストをトレードオフするレバーが存在しない。
- 利用可能な中で最も賢いモデルというわけではない。 GPT-5.5はMoonshot自身の6つのベンチマークのうち5つでリードしており、Claude Opus 4.8は純粋なコーディング品質で最も重視すべき2つを含む4つでリードしている。
コミュニティから直接届いた、まさにその矛盾を示す声がこちらだ。
"Kimi 2.7 Codeは良いモデルだが、延々と考え込んでリミットを大量に消費してしまう。"
r/kimiより

以下のすべての項目を通じて心に留めておくべきパターンはこれだ。AIラボ自身のモデルカードと、実際のアカウントの支出は別物の文書であり、あなたのものであるのは後者だけだということだ。
代替案の一覧
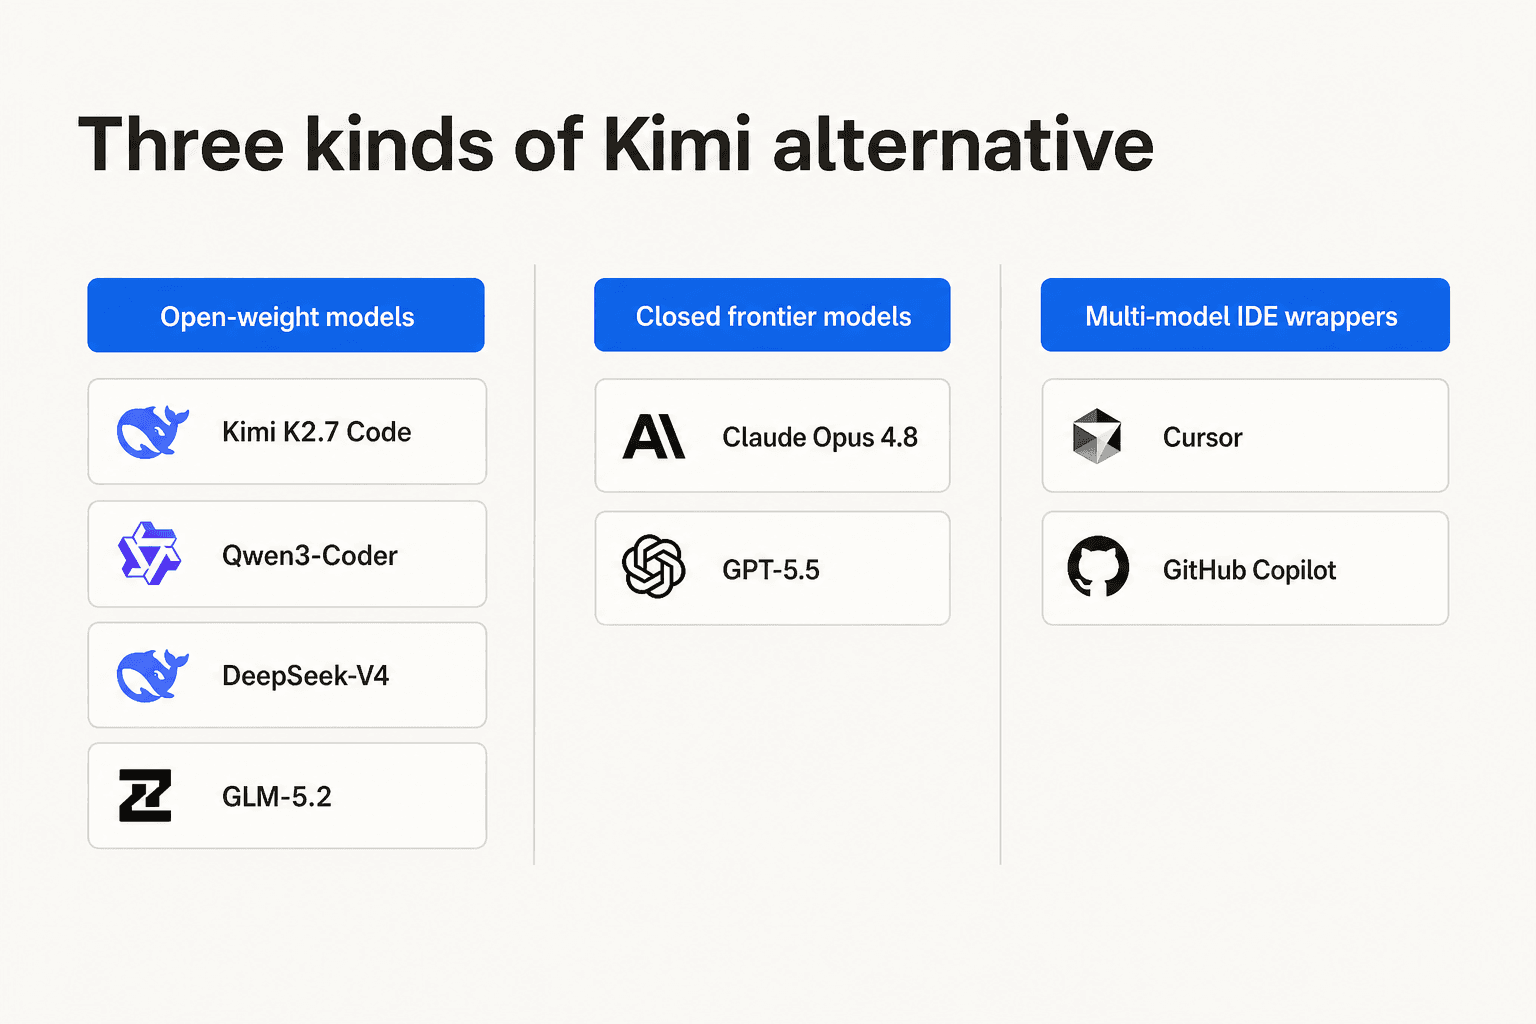
詳細に入る前に、乗り換える際に実際に重要となる観点、つまり価格、オープン性、そして実際に何を手に入れるのか(生のモデルなのかフルIDEなのか)で8つの選択肢を比較しておこう。
| ツール | 最適な用途 | 100万トークンあたりの入力/出力 | オープンウェイト? | セルフホストの選択肢 | コンテキストウィンドウ | 際立ったベンチマーク |
|---|---|---|---|---|---|---|
| Claude Code | 価格を度外視した最高のコーディング品質 | $5.00 / $25.00(Opus 4.8) | いいえ | いいえ | 100万トークン(API) | Kimi K2.7 Codeに対し6項目中4項目でリード |
| GPT-5.5 / OpenAI Codex | 純粋なベンチマークでの首位 | $5.00 / $30.00 | いいえ | いいえ | ロングコンテキスト階層あり | Kimi K2.7 Codeに対し6項目中5項目でリード |
| Qwen3-Coder-480B | 安価でオープンウェイト、巨大なリポジトリコンテキスト | $1.50 / $7.50 | はい(Apache 2.0) | はい | 262Kトークン | リポジトリ規模のリファクタリング向け480B-A35B MoE |
| DeepSeek-V4 | 最安のホスト型API価格 | $0.44 / $0.87(Proティア) | はい | はい | 100万トークン | このリストで最安のフロンティア級モデル |
| GLM-5.2 | 割安な長時間のエージェント型コーディング | $1.40 / $4.40 | はい(MIT) | はい | 100万トークン(安定) | Terminal-Bench 2.1で81.0 |
| ZCode | GLM-5.2を取り巻く純正のエージェントハーネス | 月額$12.60〜$112のプランに含まれる | モデルは可、ハーネスは不可 | モデルのみ | GLM-5.2の100万を継承 | WeChat/Feishu/Telegram経由のリモート操作 |
| Cursor | 一つのIDEであらゆるフロンティアモデルを | 月額$20〜$200のサブスクリプション | いいえ | いいえ | モデルに依存 | Fortune 500企業の64%が利用と主張 |
| GitHub Copilot | 最安のエージェント型導入 + GitHubネイティブなツール群 | 月額$10〜$100のサブスクリプション | いいえ | いいえ | モデルに依存 | 2,000万人以上のユーザー、6,000万件以上のコードレビュー実施 |
1. Claude Code - 価格を度外視して最も賢いコーディングエージェントを求めるチームに最適
Claude CodeはAnthropicのエージェント型コーディングツールであり、難易度の高いコーディング作業で最も重要な指標において、Kimi K2.7 Code自身のベンチマーク表でも打ち負かせないモデルだ。ターミナルCLI、VS Code、JetBrains、デスクトップアプリ、さらにはモバイルからPRまでのワークフローまで、すべて同じエンジンを共有しているため、CLAUDE.mdの指示やMCPサーバーは使用する画面が変わってもそのまま持ち運べる。
得意なこと: Moonshot自身による6項目のベンチマーク比較表では、Claude Opus 4.8が6項目中4項目でリードしており、その中には私が最も重視するコーディング品質のベンチマーク2つ(Program Bench、MLS Bench Lite)も含まれる。コミュニティの評価もこれを強く裏付けている。RedditやXのユーザーはClaude CodeをGemini CLI、Copilot、Cursorと比較する際、一貫して「まるでコードベース全体を2回読み終えたシニアエンジニアのように振る舞う」と表現する。Anthropic自身の指標によれば、エンジニアは現在1日平均5件のPRをマージしており、これはClaude Code導入以来67%の増加だという。
物足りない点: レート制限が最も繰り返し聞かれる不満だ。月額$17〜20のProプランのユーザーは、集中的なセッションを始めてから数分でキャップに達すると報告しており、コミュニティの総意では持続的なエージェント型コーディングに現実的な下限となるのは$20のエントリー階層ではなく月額$100のMaxプランだという。
料金: Claude Code自体は単体販売ではなくClaudeのサブスクリプションプランにバンドルされている。Proは月額$17〜20、Max 5xは$100、Max 20xは約$200。基盤モデルへのAPIアクセスは、Opus 4.8で100万トークンあたり入力$5.00/出力$25.00、フラッグシップが不要ならSonnet 4.6で$3.00/$15.00。
私たちの見解: Kimi K2.7 Codeを離れる理由がハルシネーションや品質後退への不満であれば、Claude Codeが最も安全な着地点だ。トークンあたりのコストはKimiより高いが、信頼性についてのコミュニティの評価は、このリスト全体の中で最も際立ったコントラストを見せている。
2. GPT-5.5(OpenAI Codex経由) - 純粋なベンチマークでの首位を求めるなら最適
GPT-5.5は、Moonshotが公開した6つのベンチマークのうち5つでKimi K2.7 Codeをリードしており、このリストの中で他のどのモデルよりも上回る項目数が多い。OpenAI Codex経由でアクセスでき、価格やオープン性よりも難易度の高いコーディングタスクにおける純粋な問題解決の深さを決め手にするなら、これが選ぶべきモデルだ。OpenAIは次世代のGPT-5.6ファミリー(Sol、Terra、Luna)も、サイバーセキュリティ機能を目玉としてプレビューしているが、これは執筆時点ではまだ審査済みパートナーに限定公開されておりChatGPTや公開APIには未搭載のため、実際に今日購入できるモデルはGPT-5.5のままだ。
得意なこと: Kimi K2.7 Codeとのベンチマーク差は僅差ではない。GPT-5.5はKimi Code Bench v2(69.0対62.0)、Program Bench(69.1対53.6)、MLS Bench Lite(35.5対35.1)、Kimi Claw 24/7 Bench(52.8対46.9)、MCP Atlas(79.4対76.0)のすべてで勝っている。Kimi K2.7 CodeがGPT-5.5とClaude Opus 4.8の両方に対して明確に勝っている唯一のベンチマークはツール使用の指標であるMCP Mark Verifiedであり、純粋な推論よりもツール呼び出しが極端に多いワークロードであれば、これは知っておく価値のある本当の注意点だ。
物足りない点: GPT-5.5のショートコンテキストAPIレートは100万トークンあたり入力$5.00/出力$30.00で、このリストのどのモデルよりも高い出力レートであり、約272Kトークンを超えるロングコンテキスト階層では$10/$45まで跳ね上がる。最も重い推論ワークロード向けに$30/$180のProティアもある。これは予算重視の選択肢ではなく「上限に対して支払う」タイプのモデルだ。
料金: APIおよびCodex経由で100万トークンあたり$5.00/$30.00(ショートコンテキスト)。ChatGPTの一般向けプランはFree($0)、Go(月額$8)、Plus(月額$20)、Pro(月額$100〜200)があり、Plus以上のティアにCodexアクセスがバンドルされている。
私たちの見解: GPT-5.5のベンチマークでのリードだけでは決め手にならないとしても、Kimi K2.7 Code自身のローンチ資料が、6項目中5項目で越えられなかった基準としてまさにこのモデルを選んでいたことを思い出してほしい。この一つの選択肢を超えて他のOpenAI Codexの代替を探すなら、そのまとめ記事が用途別により広い分野をカバーしている。
3. Qwen3-Coder - 安価でオープンウェイトなリポジトリ規模のコーディングに最適
AlibabaのQwenファミリーには専用のコーディングラインがあり、Qwen3-Coder-480B-A35Bは、オープンウェイト、MoE、コストで勝負する価格設定という点で、Kimi K2.7 Codeに最も近い1対1の乗り換え先だ。合計4,800億パラメータのうちトークンごとに活性化するのは350億のみで、規模の割に高速さを保っている。Qwen CloudのAPIは完全にOpenAI互換なので、ハーネスの切り替えはほぼ1行の設定変更で済む。
得意なこと: フル480Bモデルで100万トークンあたり$1.50/$7.50、より小型のQwen3 Coder Nextバリアントならサードパーティのホストで$0.07/Mまで下がり、これは本物の低予算領域だ。あるRedditユーザーは日常のコーディング作業において$0.07/Mティアを「ズルだ」と評し、Pythonファイル5〜6本をまるごと一度に投入できる262,144トークンのコンテキストを称賛した。
物足りない点: Qwen自身のトークンプランは、不透明さと消費速度の速さで厳しい批判を浴びている。ある詳細な比較記録によれば、Qwenの$30プランは単一のコードレビュータスクで月間クォータの23%を消費したのに対し、Claude、OpenAI、Kimiは同一タスクで同等プランのクォータの1%未満しか消費しなかったという。コミュニティの説明では、他のプロバイダーに比べてプロンプトキャッシングが弱いことが原因とされており、これはまさに今Kimi K2.7 Codeを悩ませているのと同じ「紙の上では安いが実際には高くつく」話だ。Alibabaはまた2026年4月に寛大な無料コーディング枠(1日2,000リクエスト)を廃止し、Claudeやセルフホストへのリアルなチャーンの波を引き起こした。
料金: Qwen CloudでQwen3-Coder-480B-A35Bが100万トークンあたり入力$1.50/出力$7.50。Qwen3 Coder NextはOpenRouterや他のサードパーティホスト経由で$0.07〜$0.22/Mまで下がる。Qwenのより広いラインナップの詳細はQwen pricing guideを参照。
私たちの見解: 表示価格はあくまで出発点であり全体像ではないと捉え、契約前に実際の使用量を見積もっておこう。Kimiの「トークンあたりは安いが請求書は高い」という問題こそがあなたを遠ざけた理由なら、同じ欠点を持つ双子に乗り換えないことだ。これがしっくりこなければ、Qwen alternativesのまとめ記事が他にどこを見ればいいかをカバーしている。
4. DeepSeek-V4 - ホスト型APIで最安値を求めるなら最適
DeepSeekは、そもそもオープンウェイトのフロンティア級推論モデルを主流の選択肢にした中国の研究機関であり、その現行フラッグシップであるDeepSeek-V4は、オープン性ではKimi K2.7 Codeと同等でありながら価格では下回る。一般向けチャットアプリchat.deepseek.comは従量制の上限なしで無料であり、APIはOpenAIとAnthropicの両方に互換なので、既存のコードに手を加えることなくClaude Code、GitHub Copilot、その他あらゆるハーネスに本物の意味でそのまま差し替えられる。
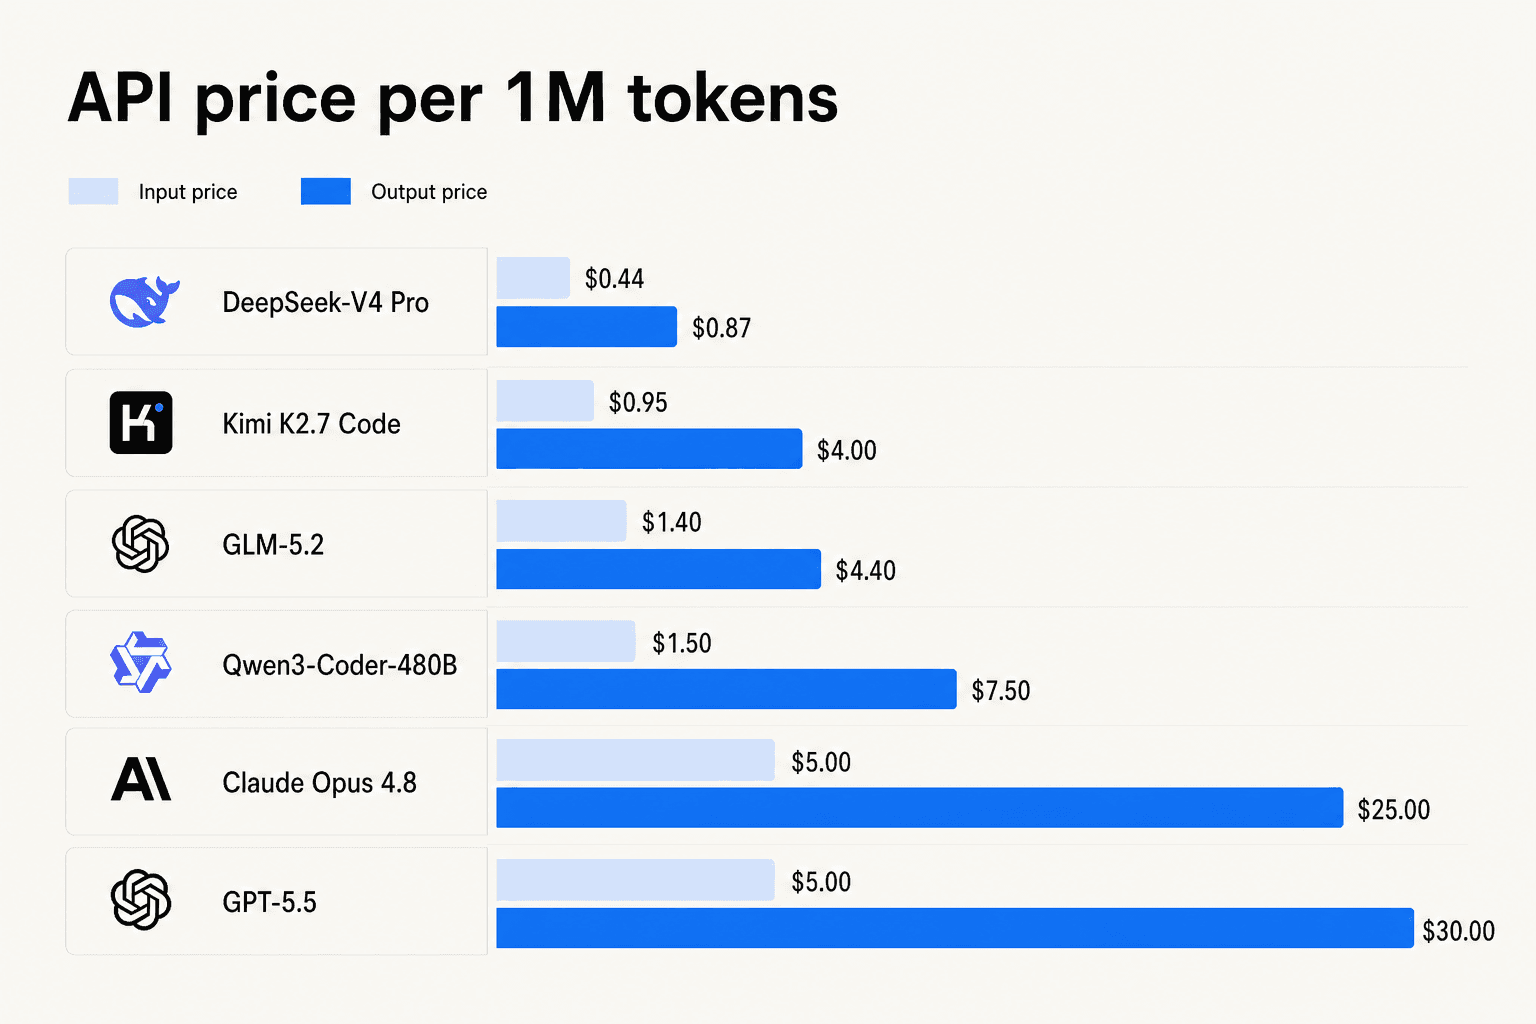
得意なこと: DeepSeek-V4 Proは100万トークンあたり入力$0.435/出力$0.87で、Kimi K2.7 Code自身の$0.95/$4.00というレートの半分以下であり、しかも自動コンテキストキャッシングによってキャッシュヒットした入力は1セントの何分の一かにまで下がる。コンテキストウィンドウは100万トークン(出力は最大38万4,000トークン)で、Kimi K2.7 Codeの25万6,000という上限を大きく上回り、Thinking modeも常時オンに固定されるのではなく切り替え可能だ。
物足りない点: DeepSeekのリアルタイムウェブ検索と最新ニュースの鮮度は、Googleを後ろ盾に持つ代替サービスに劣る。また中国でホストされ中国のデータ法の下にあることは、厳格なデータ所在地要件を持つチームにとってコミュニティの議論で繰り返し取り沙汰される懸念点だ。正確なV4のベンチマーク数値も、MoonshotやZ.aiのローンチ表のように第三者と突き合わせて独立に検証されているわけではないため、具体的なスコアの主張はどのベンダー数値とも同じく「予算を投じる前に検証する」という慎重さで扱うべきだ。
料金: 軽量なワークロード向けのdeepseek-v4-flashが100万トークンあたり入力$0.14/出力$0.28、より高性能なタスク向けのdeepseek-v4-proが$0.435/$0.87。一般向けのチャットとモバイルアプリは無料。
私たちの見解: 実際の使用量がぶつかった途端にKimiの「安い」レートが安く感じられなくなった、というのが探している理由のすべてなら、DeepSeek-V4が最も直接的な解決策だ。本当に低い価格でありながら、ホスト型のレートがいつか変わってしまってもオープンウェイトという同じセーフティネットを持っている。
5. GLM-5.2 - フロンティア級の価格タグなしで長時間のエージェント型コーディングを求めるなら最適
GLM-5.2はZ.ai(旧Zhipu AI)のフラッグシップとなるオープンウェイトモデルで、2026年6月16日にリリースされた。Kimi K2.7 Codeが狙うのとまさに同じ種類の、数時間にわたる長時間のエージェント型コーディングセッション向けに、フロンティア価格の約6分の1で作られている。GLM-5世代で初めて安定した100万トークンのコンテキストウィンドウを持つモデルであり(GLM-5.1の20万から拡大)、Z.aiは単に名目上のトークン数を受け入れるだけでなく、長く煩雑なエージェントの軌道全体を通じて信頼性を保つよう明示的に訓練したという。
得意なこと: GLM-5.2は最上位にランクされるオープンウェイトモデルであり、長時間コーディングに関する3つの独立したベンチマーク(FrontierSWE、PostTrainBench、SWE-Marathon)でトップに立ち、Terminal-Bench 2.1で80%を超えた初のオープンウェイトモデルとして81.0を記録した(Claude Opus 4.8は85.0)。Artificial Analysisによる独立した検証でも、GLM-5.2は同社のインテリジェンス指数においてすべてのオープンウェイトモデルをリードすると確認されている。制限のないMITライセンスの下で配布され、Z.ai自身の言葉を借りれば「地域制限なし」だという。これは、そもそも中国ホストのモデルから離れる理由の一部にデータ主権への懸念があるなら(あるいは離れない理由の一部であっても)重要な点だ。
物足りない点: APIでは100万トークンあたり入力$1.40/出力$4.40で、紙の上ではKimi K2.7 Code自身のレートよりまだ高い。あるHacker Newsのコメント者は指摘したが、ClaudeやCodexのサブスクリプションが実際にどれだけ使えるかを考慮すると、GLM-5.2は「自宅で動かすには大きすぎ、同等の能力を持つモデルと比べると高くて遅い、不気味の谷」に位置しているという。Z.ai自身も国家安全保障上の懸念から2025年1月に米商務省のEntity Listに追加されたことがあり、企業調達の話をする前に知っておく価値がある。
料金: APIは100万トークンあたり入力$1.40/出力$4.40。GLM Coding PlanはLiteが月額約$12.60、Proが$50.40、Maxが$112(年払い)で、ピーク時間帯にはクォータを3倍消費する。
私たちの見解: GLM-5.2は、このリストの中で「Kimi K2.7 Codeと同じ発想を、より大きなコンテキストウィンドウとよりすっきりした効率性のストーリーで実現した」最有力の選択肢だが、Kimiと同じようにサブスクリプションの計算については独自の注意点を抱えている。
6. ZCode - GLM-5.2専用に構築された純正のエージェントハーネスを求めるなら最適
GLM-5.2がモデルであるのに対し、ZCodeはそれを取り巻くZ.ai独自のデスクトップ「エージェント開発環境」であり、MoonshotとKimi CLIの関係に相当する。2026年7月2日にローンチされ、既存のエディタに後付けされたチャットサイドバーではなく、ターミナルと並走する形で動作し、複数ステップのタスク向けの「Goals」システムを備え、さらにWeChat、Feishu、Telegramからリモートで作業をトリガーしたり操作したりするオプションもある。
得意なこと: エージェントハーネスとGLM-5.2の実行モデルとの間で深く純正のチューニングが行われている点、そして本当に新しいリモート操作、確認するだけでなくチャットアプリ経由でスマートフォンから長時間実行中のタスクを後押しできる点だ。BYOK(自分のキーを持ち込む)対応により、GLM-5.2をデフォルトとして使いたくない場合はAnthropic、DeepSeek、Kimi、OpenRouterのモデルもすべて接続できる。
物足りない点: コミュニティの評価は賛否が分かれており、契約前に知っておく価値がある。最も内容の濃いHacker Newsのスレッドには、Claude Opus 4.8との詳細な実体験に基づく比較が含まれている。
"GLM 5.2はこれまでタスクを拒否したことがない。だからセキュリティ関連の作業には…GLM 5.2を使う…平均すればOpus 4.8の方がまだ優れていて、より信頼性が高く、より速いモデルだと思うが、もし明日それがなくなってGLM 5.2しか残らなかったとしても、そこまで悲しくはならないと思う。"

他のコメント者は、TUIが「Claude Codeと比べてかなり重く、頻繁にクラッシュする」と指摘し、「GLMの開発元によるClaude Code」というマーケティング上の位置づけにもかかわらずインターフェースを「Codexの完全なコピー」と評し、「システム全体の制御権を握る中国製の独自ソフトウェア」であることについての本物の信頼性への疑問を投げかけた。プラン階層ごとの正確な利用上限もZ.ai自身の料金ページのどこにも開示されておらず、これはKimiのToken PlansやQwenのクレジットシステムに向けられているのと同じ価格の不透明さへの不満だ。
料金: GLM-5.2自体と同じGLM Coding Planにバンドルされており、Liteが月額約$12.60、Proが約$50.40、Maxが約$112(年払い、年間割引レート)。
私たちの見解: Z.aiのリモート操作という切り口を特に求めているか、機密性の高いタスクでGLM-5.2の「決して拒否しない」挙動をすでに好んでいるなら、ZCodeは試す価値がある。ただし信頼性と安定性への懸念は本物であり、メインのリポジトリではなくまずサンドボックス化したプロジェクトで試験運用するだけの理由がある。
7. Cursor - 一つのIDEに留まりながら価格変動に応じてモデルを乗り換えたいなら最適
上記のモデルはすべて、単一のラボへの単一の賭けだ。Cursorはそれを完全に回避する。VS Codeのフォーク上に構築されたAIネイティブなコードエディタであり、Claude Opus 4.8、GPT-5.5、Gemini 3.1 Pro、Grok Build 0.1、そしてCursor独自のComposer 2.5モデルを、一つのサブスクリプションの中で提供する。2026年半ば時点でFortune 500企業の64%での利用を主張している。
得意なこと: Composer/AgentモードはGitHub Copilotに対する際立った差別化要因であり、Copilotがオートコンプリートに課金するのと同じ価格帯で、本当に自律的なマルチファイル編集を提供する。無料のHobby階層は釣り広告的な体験版ではなく本物だ。クレジットカードなしで月2,000件のTab補完と50件の低速なプレミアムリクエストが使える。G2のレビュアーは205件のレビューで4.7/5と評価しており、「摩擦のないVS Code移行」がオンボーディングで最も繰り返される称賛だ。
物足りない点: 月額$20のProプランでもパワーユーザーには利用制限がきつく感じられ、ヘビーなAgentセッションでは月間クレジットを1日で使い切ってしまうこともある。Electronベースのアプリはレビューで「Chromeのようにメモリを食う」とも指摘されており、リリースのペースが速いため、動きの遅いツールに比べてキーボードショートカットやワークフローが頻繁に変わってしまう。
料金: Hobbyは無料。Proは月額$20(年払いで$16)、Pro+は$60、Ultraは$200、Teamsはユーザーあたり$40〜、Enterpriseは個別見積もり。学生は認証済みの学校メールアドレスで丸1年無料になる。
私たちの見解: 価格やベンチマークが変わるたびにモデルを乗り換えるのが刺激的というより億劫に感じるなら、Cursorはその判断そのものを不要にしてくれる。生のAPIキーがMoonshotのロードマップに縛り付けるのとは違い、一つのラボのロードマップに縛られることは決してない。より広い分野については、Cursor alternativesのまとめ記事と、直接的なCursor対Windsurfの比較がさらに詳しく掘り下げている。
8. GitHub Copilot - GitHubネイティブな範囲を持つ最安のエージェント型導入を求めるなら最適
GitHub Copilotはもう一つの主要なマルチモデルラッパーであり、Cursorにはない2つの点で勝っている。導入が安価であることと、外部から後付けされるのではなくissue、プルリクエスト、Actions、コードレビューなどGitHub自体に直接組み込まれていることだ。2026年半ば時点で2,000万ユーザーを突破し、6,000万件のコードレビューを実施した。そのうち71%が本当に実行可能なフィードバックを提示しているという。
得意なこと: Proティアは月額$10からで、Cursorのエントリー価格の半分であり、クラウドエージェントアクセス、コードレビュー、サードパーティエージェントの選択(同じGitHub issueの担当者ドロップダウンからClaudeとCodexの両方を選べる)が含まれている。G2の評価は4.5/5、Gartner Peer Insightsは463件の評価で4.4/5としている。
物足りない点: 2026年のコミュニティで最も支配的な議論はCopilot対Claude Codeであり、Redditの総意は率直だ。
"GitHub CopilotはClaude CodeやCodexより劣る。少なくとも自分にとってはそれが真実だ。ただ、コストパフォーマンスの面ではGCが一番だと思う。"
2026年6月に従量課金制へ移行したこと(コードレビューがGitHub Actionsの実行時間を消費するようになった)と、2026年4月にFree/Pro/Pro+でのやり取りがデフォルトでGitHubのモデルの学習に使われるようになったこと(オプトインではなくオプトアウト)は、どちらもコミュニティから本物の反発を招いている。
料金: 無料ティアは月2,000件の補完。Proは月額$10(AIクレジット$15分)、Pro+は$39(クレジット$70分、Opusクラスのモデルが解放される)、Maxは$100(クレジット$200分)。詳細はCopilot pricing guideを参照。
私たちの見解: 予算が最優先の制約であり、すでにGitHubのエコシステムの中で生活しているなら、Copilotはエージェント型コーディングへの最も安価で信頼できる入り口であり、それに尽きる。品質の上限をいくらか犠牲にする代わりに、コストの本物の下限を手に入れることになる。より広い候補については、Copilot alternativesのまとめ記事が他にどこを見ればいいかをカバーしている。
これらの中からどう選ぶか
上記のそれぞれの代替は、「Kimi K2.7 Codeが自分には合わない」という問題の異なるバージョンを解決する。だから「どれを選ぶべきか」への正直な答えは、あなたの実際の不満を名指しすることから始まる。
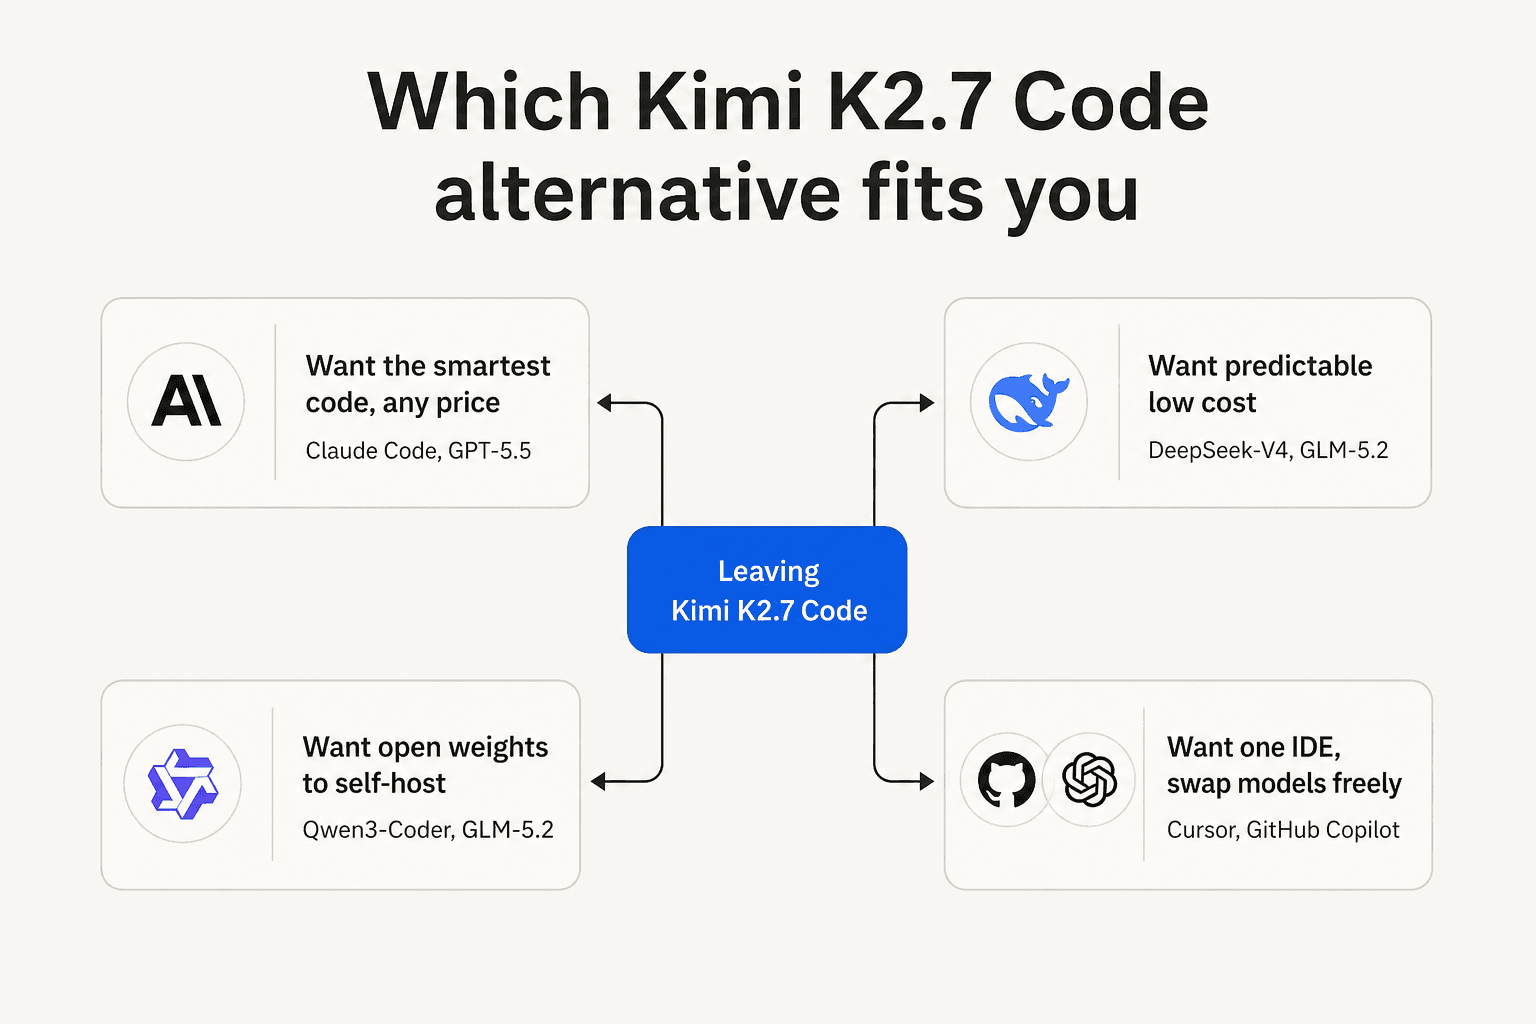
- モデルが十分に賢くない → Claude CodeかGPT-5.5を選び、高い価格を上限の代償として受け入れる。
- 価格が約束と一致しなかった → DeepSeek-V4かGLM-5.2。どちらもKimi K2.7 Code自身のレートより本当に安いが、表示価格ではなく実際の使用量に基づいて予算を組むこと。
- Kimi特有の癖なしにオープンウェイトが欲しい → Qwen3-CoderかGLM-5.2。セルフホストというセーフティネットは同じだが、実行のされ方が異なる。
- そもそも一つのラボに賭けること自体に疲れた → CursorかGitHub Copilot。裏側のモデルはロックインではなく自分の選択になる。
どの説明も当てはまらず、単にKimi K2.7 Codeの効率性に関する具体的な主張が自分のワークロードで契約前に成り立つかどうかが気になっているだけなら、ローンチ記事にもこのリストにも頼らず、直接テストする価値がある。どのモデルが勝つとしても同じルールが当てはまる。予算の話をする前に、実際の作業で実際のコストを検証すること。後からではなく。
eeselを試す
私はeeselに携わっており、まさにこの問題、つまりベンダーの効率性の数字が実際の請求書ではなくラボの数字だったという問題は、コーディングモデルに限らずAIサポートツールの世界で何年も繰り広げられるのを見てきた。あるベンダーの1件あたりの単価から慎重に予算を組んだ買い手が、実際の使用量の計算が売り込み内容とは違う形で着地した途端、オンボーディングの途中でパニックになった電話に何度も同席したことがある。これはまさに今Kimi K2.7 Code自身のローンチが抱えているのと同じギャップであり、ただ違うベンダーのロゴをまとっているだけだ。
だからこそeeselは、トークンあたりでも、インタラクションあたりでも、席あたりでもなく、解決済みチケットあたり$0.40でサポート自動化の価格を設定している。だから営業資料に書かれた数字が、月ごとのチケット量がどう動こうとそのまま請求書の数字になる。eeselはZendesk、Freshdesk、Frontなど、既存のヘルプデスクにそのままつながり、実際のチケット履歴から学習し、何かが本番稼働する前にあなた自身の過去のチケットに対して完全なシミュレーションを実行する。だから他人のデータによるベンチマーク数値ではなく、実際の解決率と実際のコストが見える。エンジニアリングチームがどのコーディングモデルに落ち着くとしても、事業のサポート側も同じ「予算を賭ける前に検証する」という規律に値する。
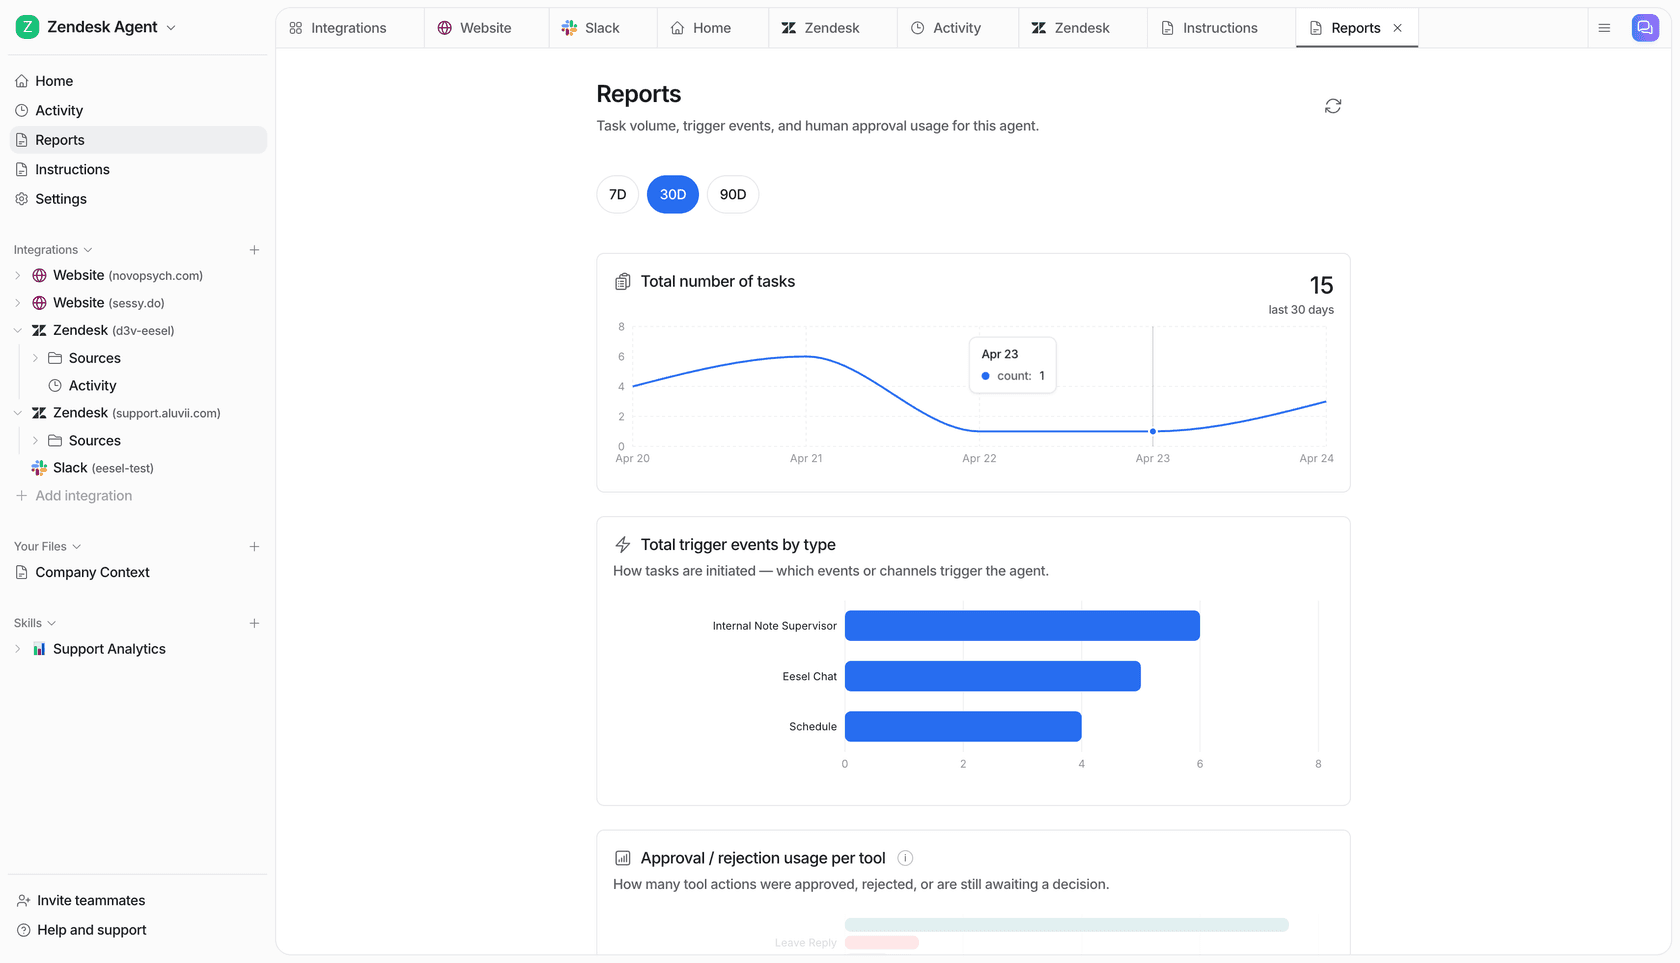
eeselを試すのは無料で、セルフホストもクレジットカードも不要、3週間後になって「ラボの数字と実際の請求書のギャップ」を発見することもない。
よくある質問
なぜ人々はKimi K2.7 Codeの代替を探しているのか?
Kimi K2.7 Codeの最良の無料代替は何か?
コーディングにおいてClaude CodeはKimi K2.7 Codeより優れているか?
大量のコーディング用途で最も安いKimi K2.7 Codeの代替はどれか?
APIを使う代わりにKimi K2.7 Codeの代替をセルフホストできるか?
Kimiのような単一モデルの代わりにCursorやGitHub Copilotを使うべきか?
GLM-5.2とZCodeの違いは何か?

Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.