

要点
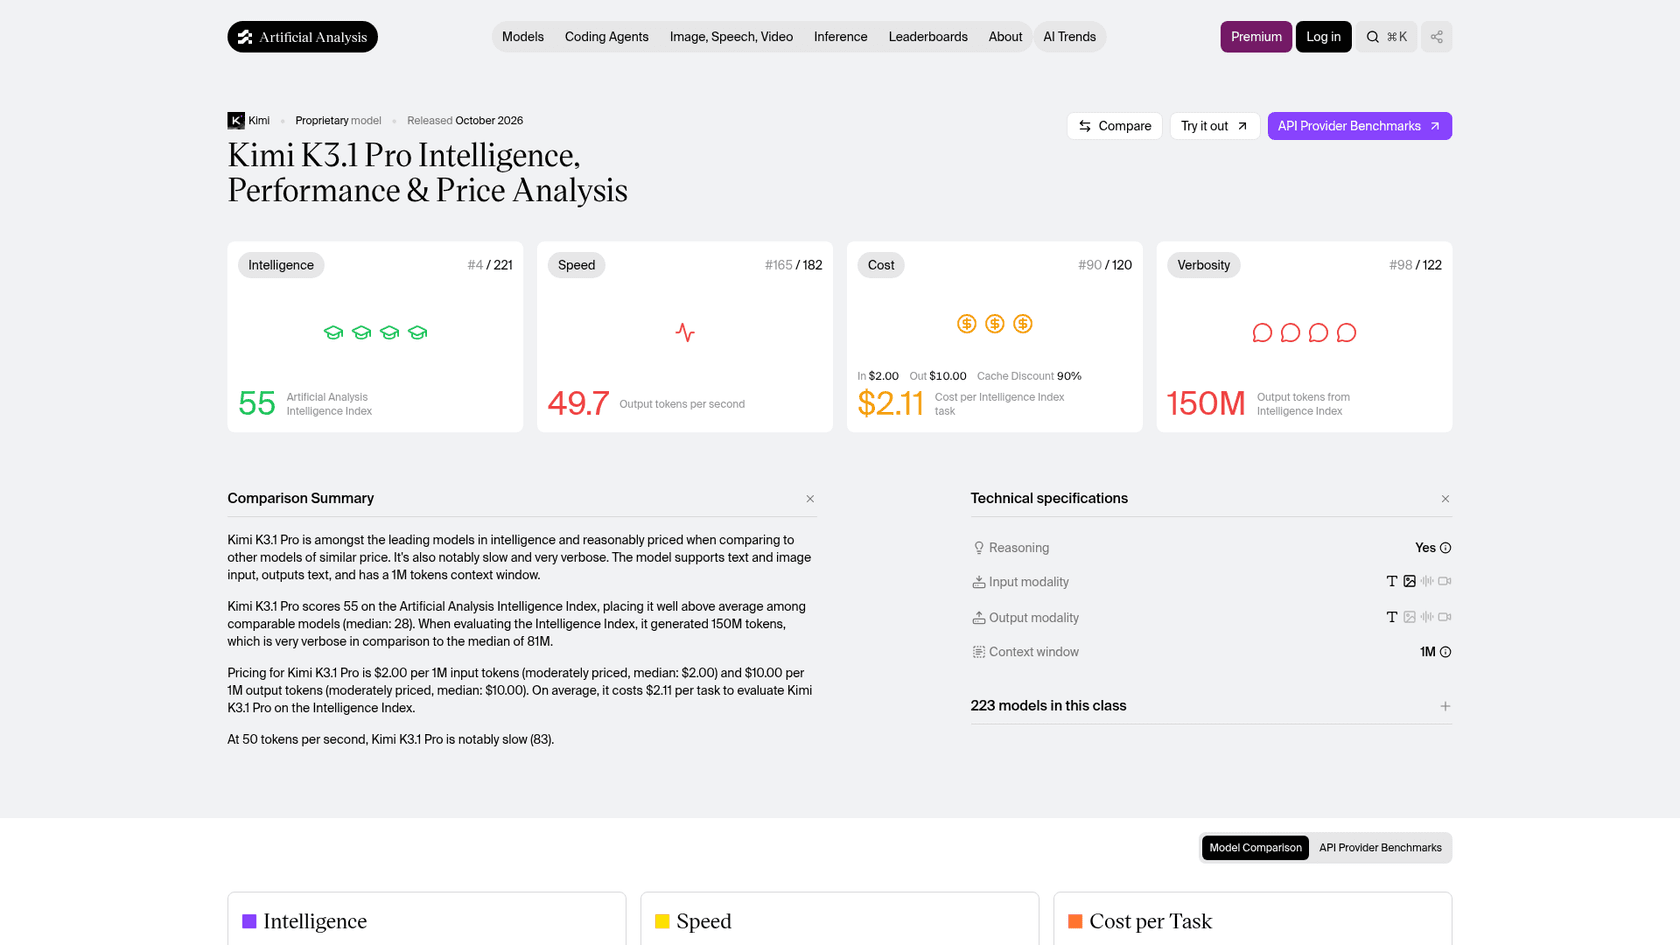
Kimi K3.1 Proは、これまでに発表された中で最も高性能なオープンウェイトモデルです。Artificial Analysis Intelligence Indexで55を記録し、Claude Opus 5.5との差は2.5ポイントで、料金は100万トークンあたり入力$2、出力$10です。 Moonshotは2026年10月23日、Kimi K3に大規模な事後学習を施したバージョンとしてリリースしました。その進化は確かです。Artificial AnalysisでのTerminal-Bench 4.0のスコアは、12.6%から67.2%に上がりました。
ただし、注意すべきなのはスコア以外の部分です。動作速度は毎秒約50トークンで、同クラスでは下位に位置します。ウェイトの公開は"by Nov 4"と約束されているため、現時点ではAPIでしか利用できません。また、初期のKimi Code契約者からは、5時間枠の上限を1時間もかからず使い切ったという報告があります。値下げは回答単位ではなく、トークン単位です。出力が長いため、ベンチマークインデックス全体の実行コストは、K3の$3,658に対して$3,117です。削減率は33%ではなく15%です。
AIサポートエージェント用のモデルを選ぶ場合、モデル選定は仕事のうち小さいほうの半分です。私はeeselで何年も、実際のヘルプデスクのキューにAIを導入してきましたが、難しいのはエンジンそのものではありません。ヘルプデスクへの接続、引き継ぎルール、そして実際の過去のチケットを使ったテストです。SE Rankingは、Zendesk上の3つの製品でこのレイヤーを運用し、月に約4,650件の会話に対応しています。
Kimi K3.1 Proとは?
Kimi K3.1 ProはMoonshot AIの新しいフラッグシップモデルであり、K3.1シリーズ初のリリースでもあります。Moonshotはこれを"our most capable 3T-class open-weight model to date"と呼んでおり、コンテキストウィンドウは100万トークンです。Xでの発表投稿によると、内部はMixture-of-Expertsモデルで、総パラメータ数は2.8T、アクティブパラメータ数は104Bです。
2つのバージョンがあります。Kimi K3.1 Proが標準版で、Kimi K3.1 Pro Highspeedは同じモデルを2倍の料金で"2-3× faster"に提供するものです。どちらも同じ日に、kimi.ai、Kimiアプリ、Kimi Work、Kimi Code、Kimi APIで提供が始まりました。
Moonshotは、コーディング、3D制作、金融リサーチ、長時間のエージェント作業という4つの改善分野を打ち出しています。7月のKimi K3のリリースから追ってきた方に一言で説明するなら、こうです。エージェントタスクにおいて、K3.1 ProはK3が本来目指していたモデルです。
Kimi K3から何が変わったのでしょうか?
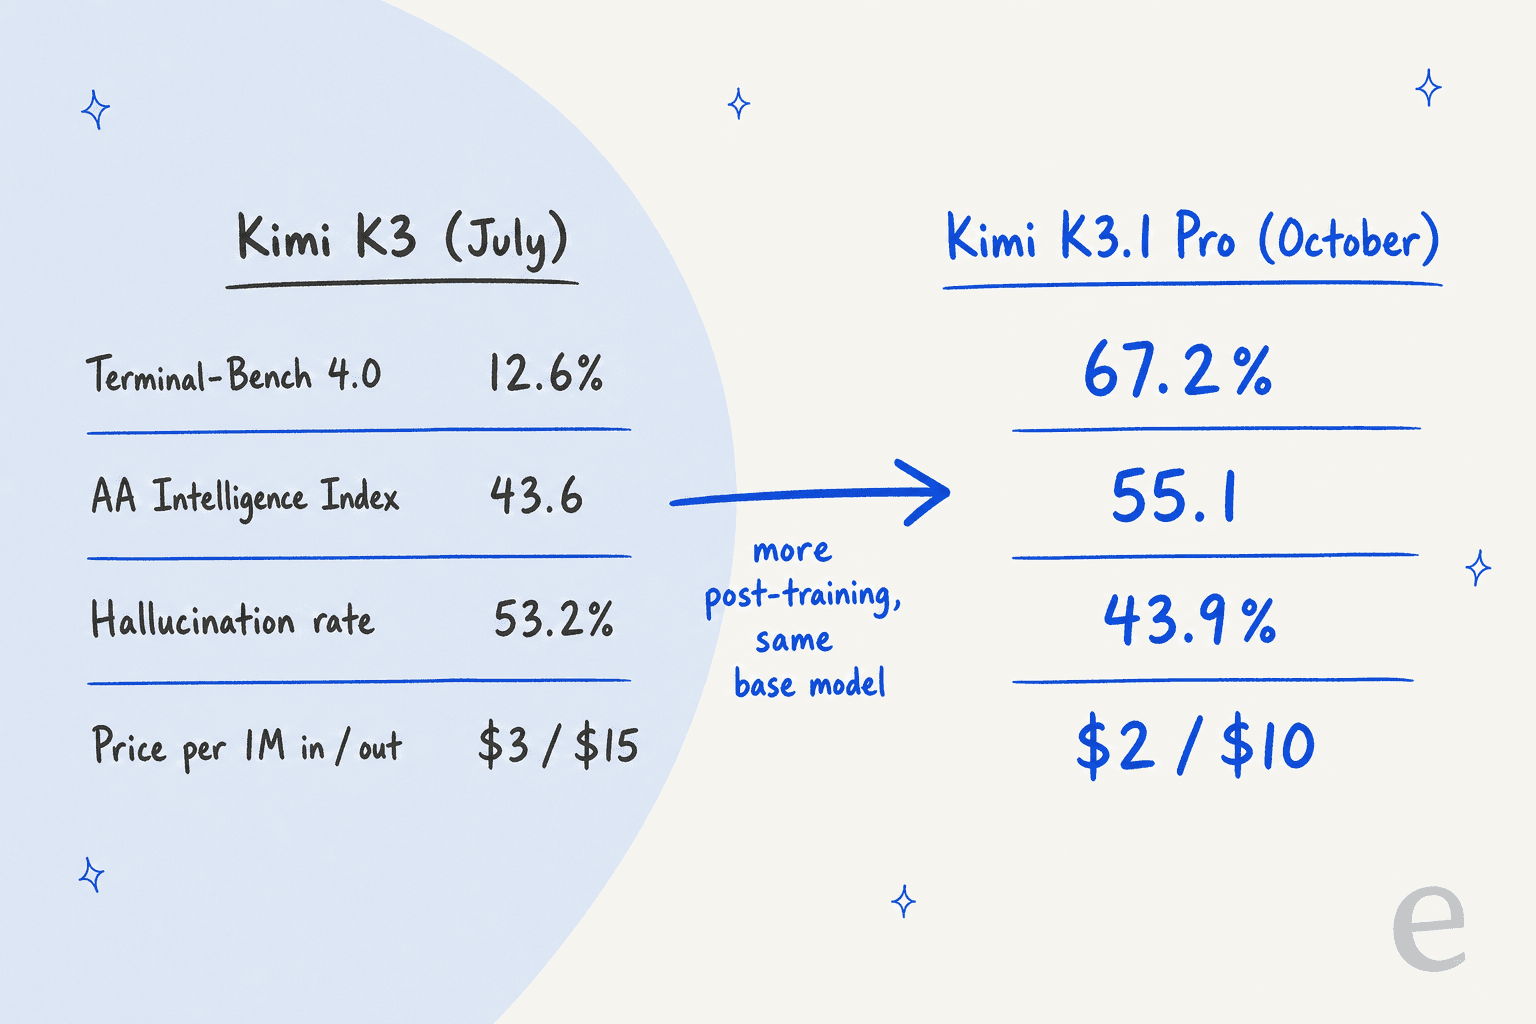
はっきりさせておくと、Kimi K3.1 Proは新しいベースモデルではありません。Moonshotはこれを"a post-trained version of Kimi K3, with substantially larger post-training compute"と説明しており、"hundreds of downstream domains"にわたって強化学習を行っています。つまり、2.8Tのウェイトは同じで、変わったのはそれを使いこなすためにどれだけ学習を重ねたかです。
説明だけ聞くと小幅な改良に思えますが、数字は違うことを示しています。Artificial AnalysisのK3.1 Proページでは、Kimi K3と同じバージョンのインデックスで次のように測定されています。
| Kimi K3 (Max) | Kimi K3.1 Pro | |
|---|---|---|
| リリース日 | 2026年7月16日 | 2026年10月23日 |
| Intelligence Index (v4.3.2) | 43.6 | 55.1 |
| Terminal-Bench 4.0 | 12.6% | 67.2% |
| ハルシネーション率 (AA-Omniscience) | 53.2% | 43.9% |
| GDPval-AA (Elo) | 1,534 | 1,846 |
| 100万トークンあたりのAPI料金 (入力 / 出力) | $3 / $15 | $2 / $10 |
| 出力速度 | 54.5トークン/秒 | 49.7トークン/秒 |
| ウェイト | 公開済み | 11月4日までに公開予定 |
最大の注目点は、Terminal-Benchが12.6%から67.2%に上がったことです。 このベンチマークは、モデルがターミナル内で複数ステップの作業を実際に完了できるかを確認するもので、コーディングエージェントが日々行っていることそのものです。K3は賢いものの、その賢さを行動に移すのが苦手なモデルでした。一方、K3.1 Proは実際に行動できます。
古い記事と比較する場合、注意したい落とし穴が1つあります。K3は8月にArtificial Analysisで57を記録しましたが、その後インデックスの尺度が変更されています。現在のバージョンではK3は43.6なので、K3.1 Proは2ポイントの低下ではなく、11.5ポイントの向上です。私も当時のKimi K3レビューで同じ比較をしているので、古い数値は別の尺度によるものとして扱ってください。
Moonshotは少し珍しいこともしています。オープンウェイト版から、サイバー関連の学習データを意図的に除外しました。同社独自の内部エクスプロイトベンチマークでは、最終モデルのスコアは81.0で、その除外をせずに学習した同じモデルは90.5です。Moonshotが掲げるルールは、"release open weights that would extend the absolute frontier of cyber capability."をしないというものです。
ベンチマークでのKimi K3.1 Proの実力は?
Moonshot独自の14項目の評価チャートでは、Kimi K3.1 ProはClaude Opus 5.5、GPT-6 Astra、Claude Fable 5.1、DeepSeek V4.1 Flash、GLM-5.3を相手に、6項目で1位、5項目で2位となっています。すべてのモデルは、思考の労力を最大に設定して実行されました。
Moonshotのリリースブログから直接抜き出した主な結果がこちらです。
| ベンチマーク | Kimi K3.1 Pro | Opus 5.5 | GPT-6 Astra | Fable 5.1 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | 57.9 |
| SWE Marathon | 51.7 | 46.3 | 42.5 | 45.6 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | 54.5 |
| Humanity's Last Exam (ツールあり) | 70.0 | 67.7 | 57.2 | 65.6 |
| OSWorld V2.1 | 79.6 | 81.8 | 75.8 | 80.7 |
| GDPval-AA v2.1 (Elo) | 1846 | 1866 | 1573 | 1754 |
| BenchCAD (ツールあり) | 92.7 | 96.2 | 95.9 | 92.6 |
| Terminal-Bench-Science 0.1 | 38.1 | 63.3 | 68.1 | 40.0 |
これらを引用する前に、知っておきたいことが2つあります。
まず、コーディングのベンチマークはMoonshot独自のハーネスではなく、Claude Codeのハーネス内で実行されました。多くの開発者がそのハーネスを使っているため、合理的な選択ではあります。ただし、この結果が示しているのは、Claudeと同じように動かしたときのKimiの性能だということです。Lisan al Gaibの投稿も、リリース当日にまさにこの疑問を提起しています。
次に、第三者の数値とベンダーの数値は完全には一致しません。Artificial Analysisでは、Terminal-Bench 4.0でK3.1 Proが67.2%、Opus 5.5 (Max)が59.6%となっています。Moonshot自身の65.7対66.4とは異なり、はるかに大きな差で勝っています。そのほかの注目される結果のいくつか(Kimi Code Bench、金融テスト、Kimi Hallu Bench)は、Moonshot自身の内部ベンチマークです。私なら独立したインデックスの数値を重視します。55.1で、215モデル中4位です。
コーディングと長時間稼働するエージェント
コーディングでの売りは、パッチだけでなく、プロジェクト全体を扱えることです。Moonshotによると、K3.1 ProはUnity、Unreal Engine、Godotでゲームを構築できます。同社が選んだ紹介事例は、オープンソースのhuman-atlasプロジェクトでの長時間の実行です。167のミッションと420の独立したレビューを通じて、296の骨格部品と402の筋肉部品を持つ人体モデルの歩行シミュレーターを構築しました。最終的に、シミュレーション上の人間は数秒で崩れ落ちる状態から、11.2秒間歩ける状態になりました。
長期的なコーディングのベンチマークであるSWE Marathonでは、Opus 5.5の46.3に対して51.7を記録しています。結果を1つだけ注視するなら、私はこれを選びます。長いタスクほど、Claudeとの料金差が積み重なっていくからです。
3Dモデリングとデザイン
これは今回のリリースで最も特徴的な部分です。K3.1 ProはBlenderやCADソフトウェア向けのスクリプトを書き、"without MCP connectors"で直接実行します。Moonshotはこれを中心に、3D Makeという一般ユーザー向け機能を構築しました。
ツールありのBenchCADでは92.7を記録し、Opus 5.5 (96.2)とGPT-6 Astra (95.9)を下回っています。ツールなしでは、72.8対73.0と、Opusとほぼ同点です。Moonshotによると、最も得意なのはパラメトリックな作業で、機械部品や建築モデルに加え、構成を変更できる製品や家具などです。
金融業務と事実の正確性
金融分野でMoonshotが掲げる主張は、"hallucination down by 65%"です。これは同社内部のKimi Hallu Benchとおおむね一致しており、ツールを使う難しいテストでの誤った主張の割合は、23.4% (K3)から8.3%に低下しました。
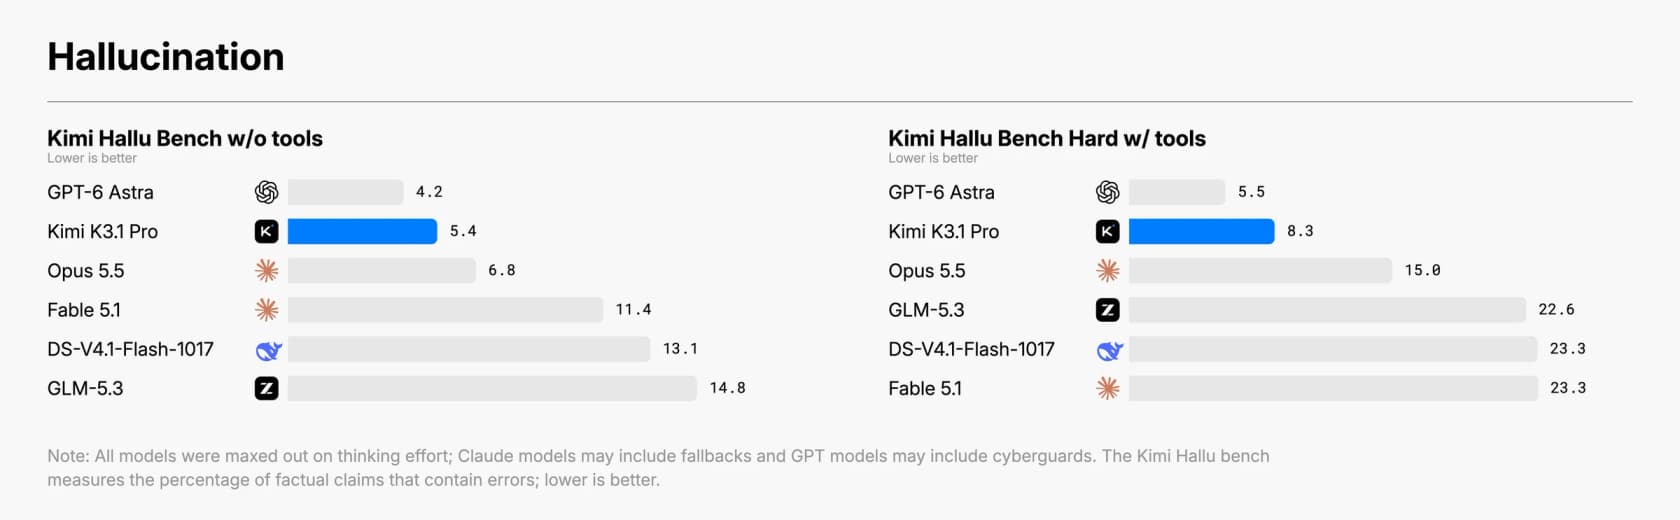
公平に評価すると、Moonshotはこれらの割合について、"do not represent overall error rates in daily use."とも補足しています。独立したAA-Omniscienceテストでは、K3.1 Proのハルシネーション率は43.9%です。Opus 5.5 Max (58.6%)よりは良いものの、Gemini 4 Argon (15.1%)には大きく及びません。スプレッドシートの数字を1つ間違えるだけで損失が出るなら、やはり作業結果を確認すべきです。
Kimi K3.1 Proの料金はいくらですか?
Kimi APIでのKimi K3.1 Proの料金は、入力100万トークンあたり$2、キャッシュ済み入力100万トークンあたり$0.20、出力100万トークンあたり$10で、Highspeedはその2倍です。K3.1 Proクイックスタートによると、"no tiering by context length"で、1Mのコンテキスト全体にわたって料金は一定です。
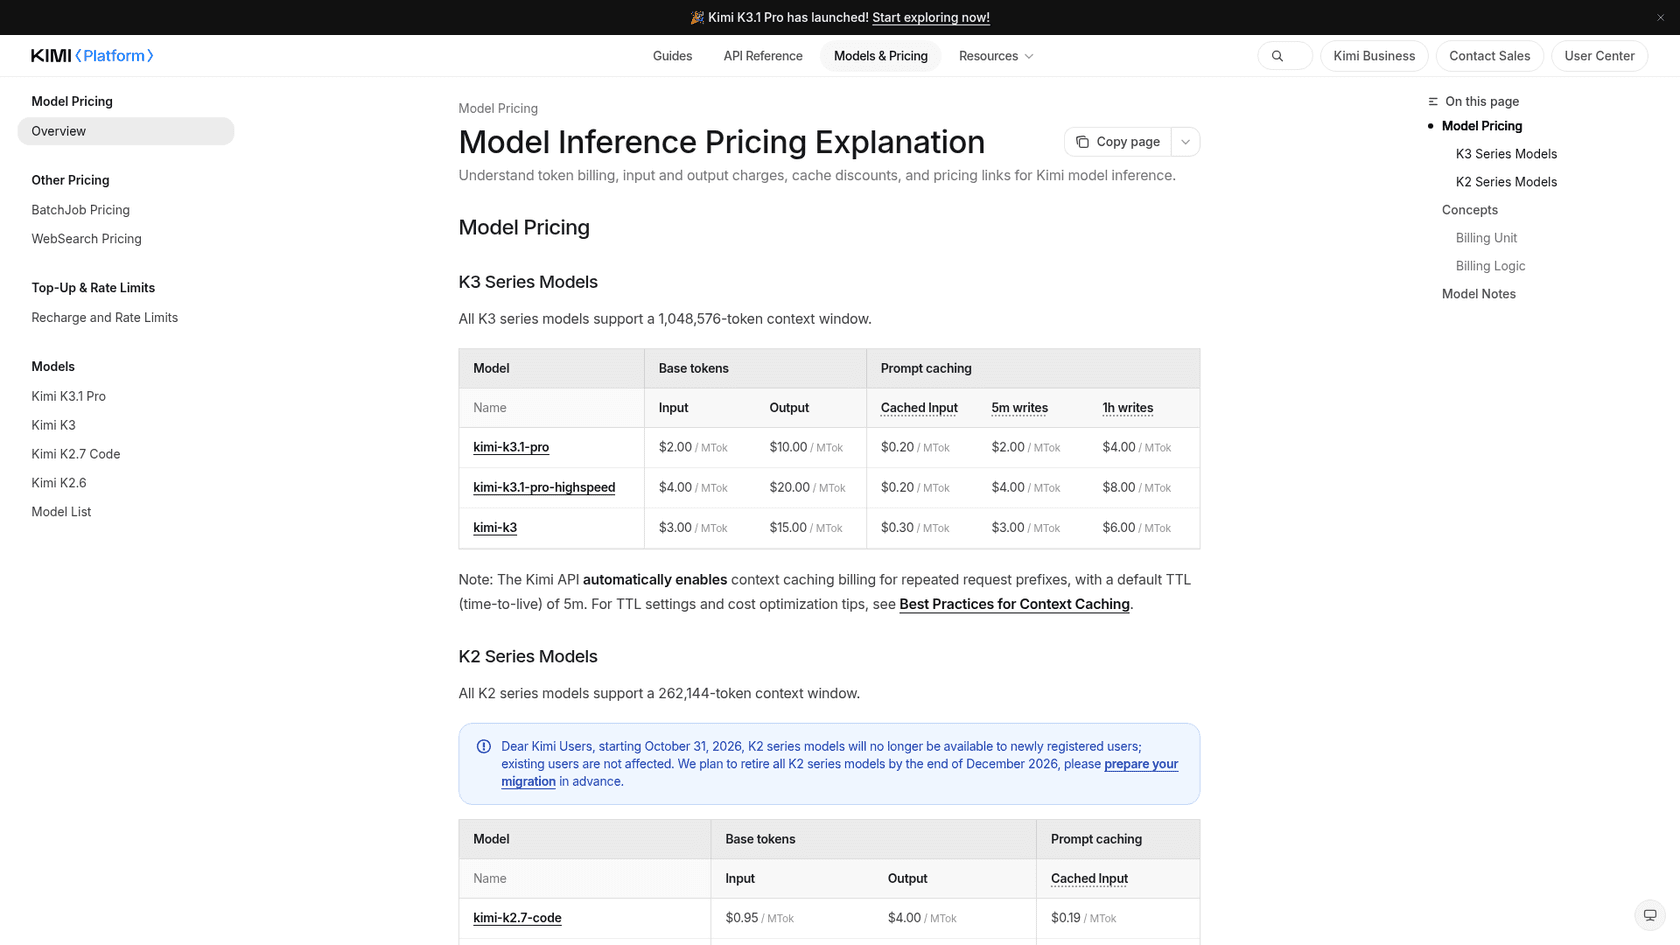
Kimiの料金ページに記載されている、100万トークンあたりの料金です。
| モデルID | 入力 | キャッシュ済み入力 | 出力 | キャッシュ書き込み (5分) | キャッシュ書き込み (1時間) |
|---|---|---|---|---|---|
kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | $2.00 | $4.00 |
kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | $4.00 | $8.00 |
kimi-k3 | $3.00 | $0.30 | $15.00 | $3.00 | $3.00 |
実際の支払額に影響する課金上の詳細もあります。
- 繰り返し使うプロンプトの先頭部分は、デフォルトで5分間、自動的にキャッシュされます。キャッシュヒット時の料金は90%安くなります。エージェントが長いシステムプロンプトを再利用する場合、表に出ている単価よりもこちらのほうが重要になります。
- K3.1 Proを利用可能にするには、$1のチャージが必要です。レート制限のティアは、累計チャージ額で決まります。
- バッチ割引はまだありません。 60%のバッチ料金が適用されるのは旧K2モデルだけで、これらは2026年10月31日に新規ユーザーの受け付けを終了します。
- K3の料金は今も$3 / $15です。そのため、新しい作業でK3を使い続ける理由はあまりありません。
Artificial Analysisが追跡している定価では、Claude Sonnet 5.5の料金、Gemini 4 Argonの料金、GPT-6.1 Solとまったく同じです。$4 / $20のClaude Opus 5.5の料金の半額です。
KimiアプリとKimi Codeのプラン
トークンごとの支払いよりもサブスクリプションを希望する場合、K3.1 ProはKimiのメンバーシッププランに含まれています。以下の料金はKimi Codeページに掲載されているものです。
| プラン | 月払い | 年払い (月あたり) | K3.1 Proの利用範囲 |
|---|---|---|---|
| Plus | $19 | $15 | 標準版 |
| Pro | $39 | $31 | 標準版とHighspeed |
| Max | $99 | $79 | 標準版とHighspeed |
| Ultra | $199 | $159 | 標準版とHighspeed |
Highspeedは2倍のペースでクレジットを消費します。Kimiは最近、"with pricing unchanged"でプラン名を変更しました。Kimi Codeは引き続き、メンバーシップのほかの機能と1つの利用枠を共有しています。新プランではKimi Codeの週間上限はなくなりましたが、ローリング方式の5時間上限は残りました。現時点で最も不満が集まっているのがこの上限です(詳しくは後述します)。
トークン単位では安くても、タスク単位ではそうとは限りません
リリース報道の多くが触れていないのが、この点です。トークン単位ではK3.1 ProはK3より3分の1安くなっていますが、よく考え、よく書きます。Artificial Analysisは"very verbose"と評価しています。インデックスの実行に約150Mの出力トークンを使い、類似モデルの中央値は87Mでした。
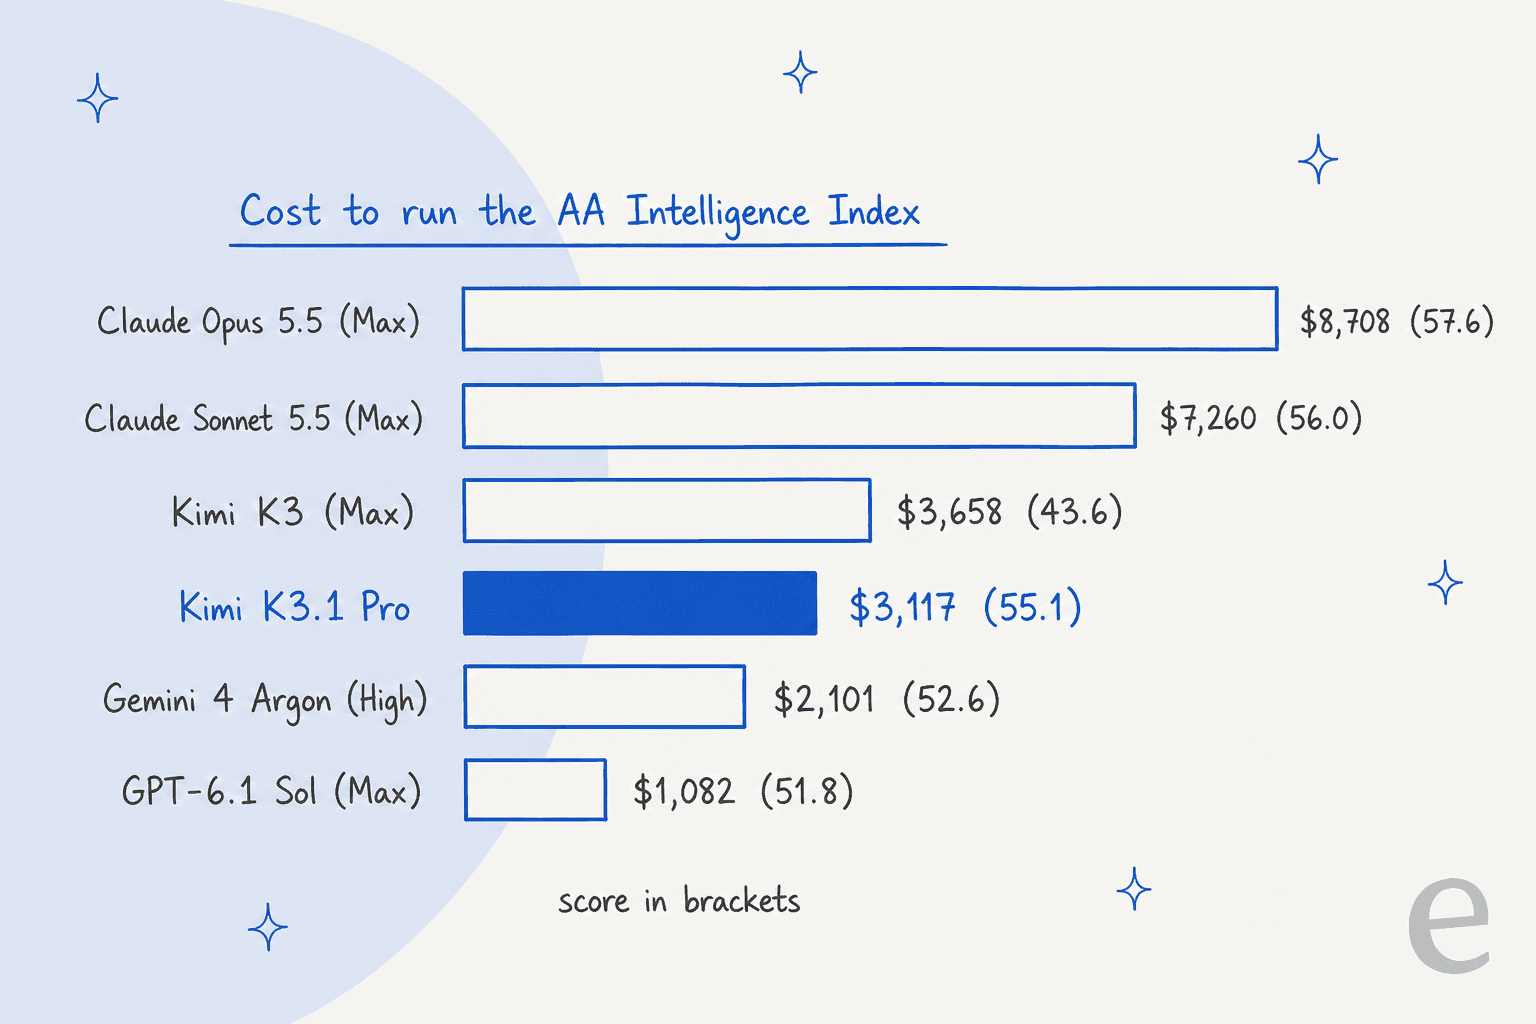
ですから、より実態に即した比較方法は、作業1件あたりのコストです。
- Claudeとの比較では、本当にお得です。 インデックス実行コストがOpus 5.5 (Max)の
36%で、スコア差は2.5ポイント以内です。また、416Mトークンを消費したSonnet 5.5 (Max)と比べると、コストは半分を大きく下回ります。 - K3との比較では、削減幅は見た目ほど大きくありません。
$3,658に対して$3,117なので、約15%安く、そのうえはるかに優れたモデルを使えます。 - 低価格モデルとの比較では、割安とはいえません。 GPT-6.1 Sol (Max)は
$1,082、Gemini 4 Argon (High)は$2,101でインデックスを実行し、スコアはそれぞれ3.3ポイント、2.5ポイント低い結果でした。
Moonshot自身のチャートではTerminal-BenchでClaudeと比較しており、思考の労力を最大にしたK3.1 Proはタスクあたり約$5、Opus 5.5はおよそ$14です。
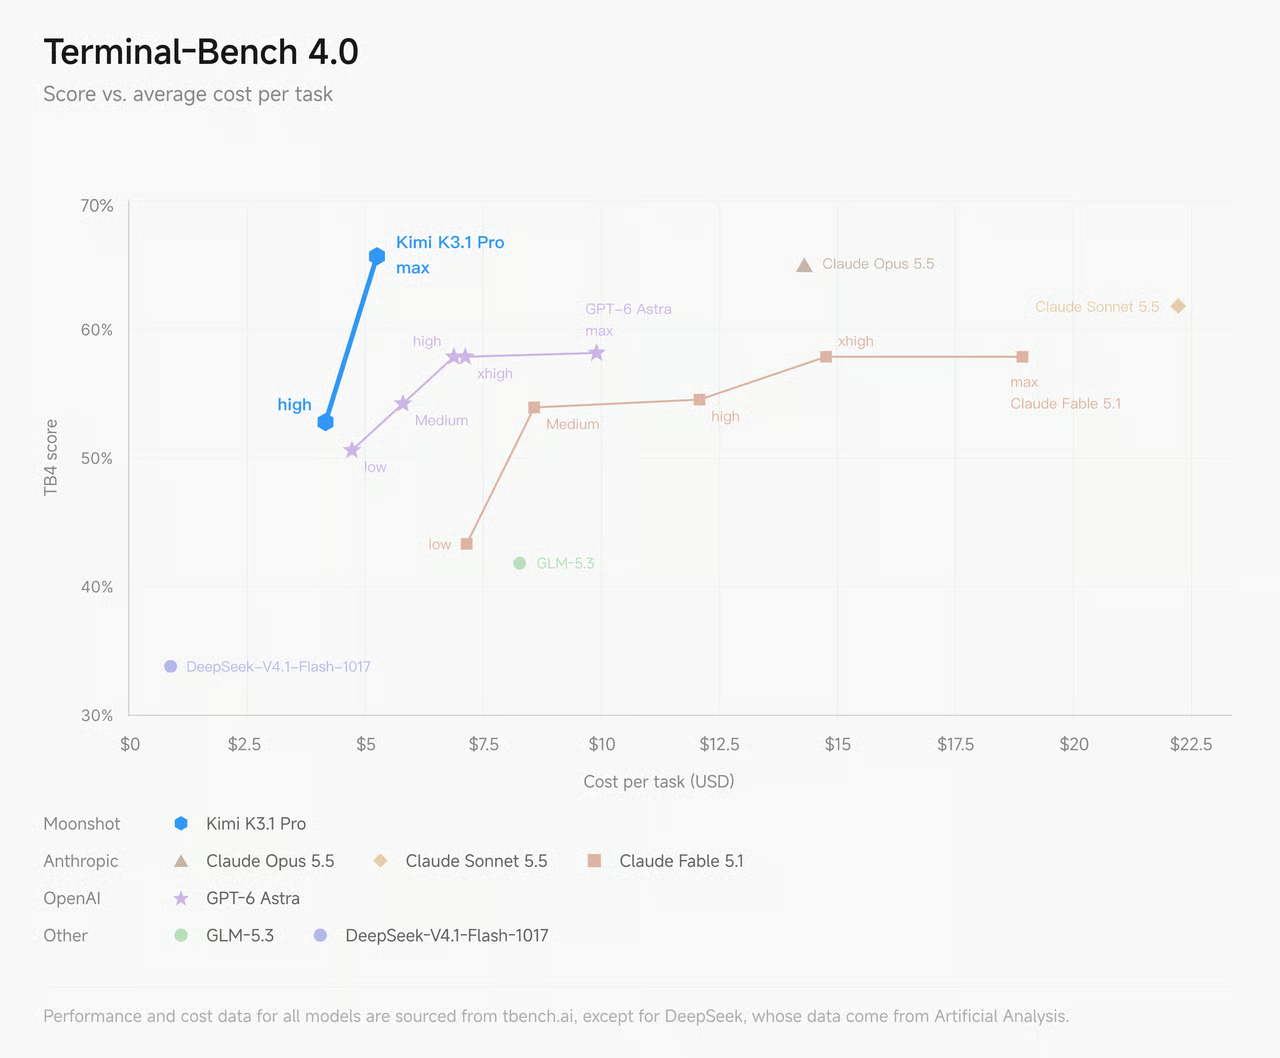
Ai2の研究者Nathan Lambertも、リリース当日に同じトレードオフを指摘しています。
"K3.1 is also cheaper than K3 per token, but some benchmarks in the blog show it uses meaningfully more tokens per answer, so it may be about the same price."
Kimi K3.1 Proはオープンソースですか?
まだ違います。Moonshotは"Full model weights will be released by Nov 4, 2026"と述べていますが、10月27日時点ではHugging Faceのリポジトリもまだありません。現時点でArtificial Analysisはプロプライエタリモデルとして掲載しており、APIを提供しているプロバイダーはK3の20社に対して5社です。
この点では、Moonshotには実績があります。K3のウェイトは実際にHugging Faceに公開されており、K3のリポジトリには8ビットで約2.78Tのパラメータが示されています。K3.1 Proも同程度になると考えられます。つまり、自前で動かすにはノートパソコンではなく、サーバークラスターが必要です。
"a 3T parameter model is still a bit beyond even many enthusiasts for running locally."

K3.1 Proのライセンス条項は、まだ公開されていません。K3のライセンスは一部制限付きで商用利用を認めていたため、これを基盤に構築する前に新しいライセンスを必ず読んでください。今すぐデプロイできるオープンモデルが必要なら、DeepSeek V4.1 Flashは、はるかに低いコストで同じインデックスで45.1を記録しています。
Kimi K3.1 Proの速度はどれくらいですか?
遅いです。Artificial AnalysisによるKimi APIの測定では、出力は毎秒49.7トークンで、182モデル中#165です。同クラスの中央値は約83です。最初のトークンが出るまでの時間は2.95秒と問題ありません。つらいのは出力が長く続くことで、インデックスのタスクは平均で約17分かかりました。
実際の使用では、K3.1 Proは思考に無駄な時間を使わなくなったため、K3より改善しています。ある開発者は次のように測定しています。
"Biggest gripe with K3 was slow responses, partly due to inefficient thinking. So far K3.1 pro is almost twice as fast as k3 on our benchmark."
これに対するMoonshotの答えがHighspeedです。2倍の料金で"2-3× the speed"を提供します。Artificial Analysisはまだベンチマークを行っておらず、リリース当日の反応も控えめでした。
"I'll wait for the openweight... btw double the price for 67 TPS... Hardly 'nitro'."
私の考えはこうです。ほかのことをしている間に1時間動くバックグラウンドエージェントなら、速度はほとんど問題にならないので、標準モデルが適切です。チャットウィンドウのように人が待つ用途では、Highspeedに料金を払うか、もっと速いモデルを選んでください。
開発者はKimi K3.1 Proをどう評価していますか?
Hacker Newsのリリーススレッドには1,089ポイントと674件のコメントが集まり、反応はかなりはっきり分かれました。K3から大きく進歩したこと、そしてこれまでに発表された中で最高のオープンウェイトモデルであることには、ほぼ全員が同意しています。一方、日常的にコーディングする人の多くは、実際の使用ではまだClaude Opus 5.5が上だと述べています。
独立したテストの中で最も肯定的だったものは、コードで生成した180点の絵画で比較していました。
"It also does this while thinking less (~6.5k reasoning tokens vs ~8k for K3). Kimi K3.1 is roughly 2/3 the cost of Kimi K3 and ~1/3 the cost of Opus 5.5."
否定的な側では、あるテスターが2つの実在するリポジトリに埋め込んだ105件のバグに対して実行したところ、Opus 5.5の41.7に対して36でした。
"I'm sorry. Considering the cost, I see no reason to use this model."
個人によるベンチマークはその中間あたりで、Fable 5.1やGemini 4 Argonとほぼ同等という評価です。
"Ran it on my adversarial programming language (KillSwitch) benchmark[1]. Very significant improvement over K3. On par with Gemini 4 Argon and Fable 5.1. Much slower than both though."
そして、モデルの品質以上にスレッドの話題を占めたのが、利用上限です。
"Bought the $100/month subscription and hit my 5-hour limit with one prompt on default settings (max effort) in their CLI harness. It might be smart but it's unusable compared to other subscriptions right now."
Kimi Codeのサブスクリプション経由で使う予定なら、プランを評価する前に推論の労力を下げてください。 APIはlow、high、maxに対応し、デフォルトはmaxです。軽量なサブエージェントと組み合わせて実行したあるコメント投稿者は、8時間のセッションで週間利用枠の22%しか使わなかったと報告しています。設定によって状況は大きく変わります。
Kimi K3.1 Proはどうすれば利用できますか?
方法は全部で4つあり、どれが適しているかは、何を構築するかによって変わります。
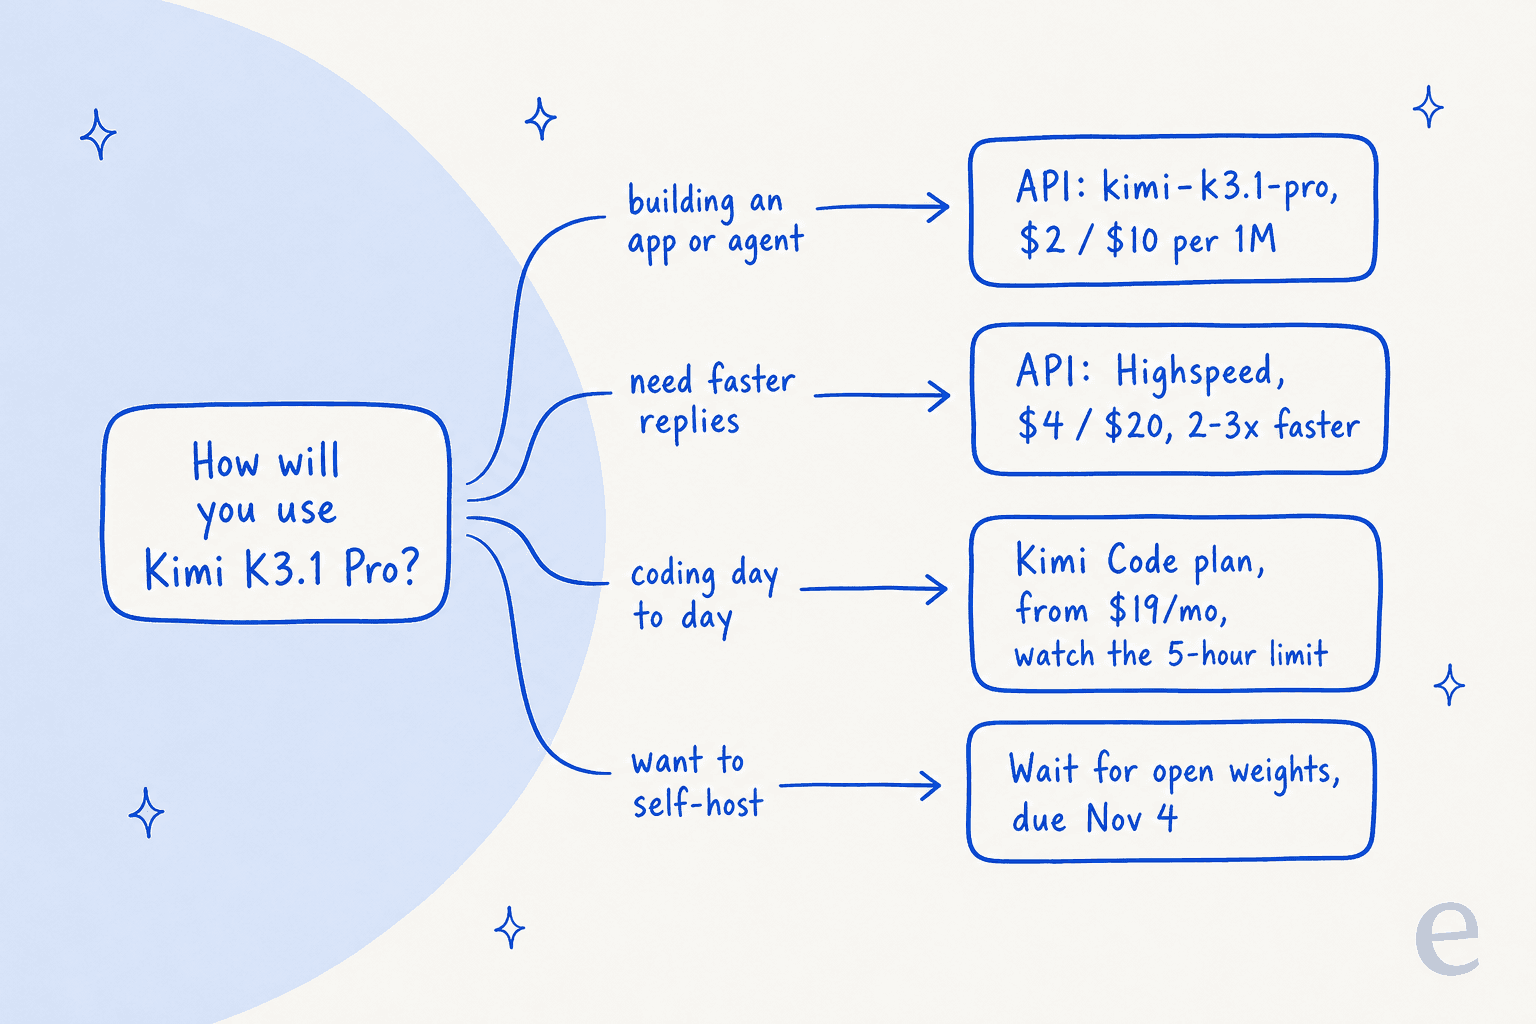
- Kimi API。 Kimi API Platformで、モデルID
kimi-k3.1-proまたはkimi-k3.1-pro-highspeedを使います。推論は常に有効で、reasoning_effortにはlow、high、maxを指定できます。出力のデフォルトは131,072トークンで、最大1Mまで設定できます。APIの顧客はZero Data Retentionを利用できます。 - OpenRouter。
moonshotai/kimi-k3.1-proとして掲載されており、現時点のプロバイダーはMoonshotのみです。すでにモデル間でルーティングしている場合に便利で、無料AI APIのティアと比較する際にも役立ちます。 - Kimi Code。
/modelで選択します。これはMoonshot独自のコーディングエージェントで、デスクトップ、CLI、IDEプラグインで動作します。Claude Codeや、Moonshotの以前のKimi K2.7 Codeモデルと直接競合します。 - KimiアプリとKimi Work。 一般ユーザー向けの方法で、3D Makeも含まれます。Kimi Workにはデスクトップ版
3.1.0以降が必要です。Kimi EnterpriseではK3.1 Proはデフォルトで無効になっているため、管理者が有効にする必要があります。
Kimi K3.1 Proはどんな人に向いていますか?
ドキュメントとベンチマーク、さらに開発者から寄せられた最初の数百件の反応を確認したうえで、私の結論はこうです。
選ぶとよいのは、長時間、無人で動かすエージェントの仕事(コーディング、リサーチ、スプレッドシートを多用する金融業務)があり、そうでなければClaudeの料金を払うことになり、結果を待てる場合です。品質はOpusに近く、実行コストはおよそ3分の1で、1Mのコンテキストに長いプロンプトの追加料金はありません。将来的に自前でホストできる最先端クラスのモデルが必要な場合にも、注目しておきたいモデルです。
見送るとよいのは、毎回の返信を人が待つ場合です。毎秒50トークンでは、ライブチャットや素早くやり取りするコーディングはもたついて感じられます。品質よりコストを優先する場合も、見送ってよいでしょう。GPT-6.1 SolとGemini 4 Argonは、同じベンチマークの作業をより安く完了します。また、ほかのオープンモデルと比較しているなら、私のQwen 3.8 MaxとK3の比較とKimi K3の代替モデルの一覧は、より広い選択肢を見るうえで今も役立ちます。
決め手は、ワークロードが長時間で待てるものか、短時間で対話的なものかです。K3.1 Proは前者のために作られています。
サポートチームにとってKimi K3.1 Proが意味すること
このようなリリース記事を読む人の多くは、もっと絞り込んだ疑問を持っています。「自分のサポートエージェントをこれで動かすべきか?」という疑問です。私は、最初に問うべきことはそれではないと思います。Kimi K3.1 Proのようなモデルはエンジンです。それを使ってチケットに回答するには、ヘルプデスクに接続し、ヘルプセンターと過去のチケットを同期したうえで、何を単独で行ってよいか、何を人に引き継ぐかを決め、顧客の目に触れる前にテストする必要があります。私は、自信ありげなボットが実際のキューで誤った回答をするのを見てきました。だからこそ、eeselではすべての導入前に、まずチーム自身の過去のチケットを使ってシミュレーションします。
そのレイヤーこそがeeselです。すぐに働けるAIヘルプデスクのチームメイトを雇うと、Zendesk、Freshdesk、Gorgiasの既存のキューに加わり、ドキュメントと過去のチケットから学習し、普段の英語で書いた引き継ぎルールに従います。より広いカテゴリーで比較しているなら、私のAI従業員の解説では、チームメイトを雇うことと自分で作ることの違いを取り上げています。

SE Rankingを見ると、本番環境でどのように機能するかがよくわかります。同社は1つのZendeskチームで3つの製品(SE Ranking、Planable、SE Visible)を運用し、製品ごとに1つのeeselエージェントを配置しています。各エージェントは回答前に、ヘルプセンターとWebサイトの約16,800ページのコンテンツを検索し、顧客の言語でライブチャットに返信します。返金、トライアル延長、Tier 2の質問は、顧客の詳細情報を添えて人に引き継ぎます。2026年8月8日から9月8日までの間に、約4,650件の会話に対応しました。これらはどれも、先週たまたまどのモデルが最高スコアを出したかには左右されません。
Kimiのエージェント優先という方向性に魅力を感じるなら、eesel CLIはそれをサポート業務に持ち込みます。同じチームメイトをターミナルから動かすことができ、たとえばeesel activityで最近の仕事を確認したり、eesel approvalsで保留中のアクションを承認または却下したりできます。eesel instructionsで常設のルールを編集することもできます。コマンドはJSONを出力し、書き込みコマンドは--dry-runに対応しているため、スクリプトやClaude Codeのようなコーディングエージェントから操作できます。MCPサーバーもあります。この幅広いパターンについては、AIエージェントCLIのガイドで解説しています。
モデル選びをせずに成果を得たいですか? ご自身のヘルプデスクでeeselを無料で試して、先週のチケットにどう対応するかを確認してください。まず選択肢を比較したい場合は、おすすめのAIチームメイトをご覧ください。
よくある質問
Kimi K3.1 Proとは何ですか?
Kimi K3.1 Proは、2026年10月23日にリリースされたMoonshot AIのフラッグシップモデルです。Kimi K3と同じ2.8Tパラメータのベースモデルに、はるかに多くの事後学習を施しています。1Mトークンのコンテキストウィンドウを備え、より高速なHighspeed版もあります。Artificial Analysis Intelligence Indexで55を記録し、Claude Opus 5.5に近いスコアを出しています。
Kimi K3.1 Proの料金はいくらですか?
Kimi APIでのKimi K3.1 Proの料金は、入力100万トークンあたり$2、キャッシュ済み入力は$0.20、出力100万トークンあたり$10です。Highspeed版は$4と$20です。これはKimi K3の料金より3分の1安く、Claude Sonnet 5.5と同じ定価です。
Kimi K3.1 Proはオープンソースですか?
まだオープンソースではありません。Moonshotによると、Kimi K3.1 Proの全ウェイトは2026年11月4日までに公開され、それまではAPIとアプリでのみ利用できます。2.8Tパラメータのモデルなので、ノートパソコンではなくサーバークラスターが必要になります。今すぐ実行できるオープンモデルを探しているなら、私がまとめたオープンソースAIエージェントの記事で選択肢を紹介しています。
Kimi K3.1 ProはClaude Opus 5.5より優れていますか?
Moonshot自身が公開した比較表では、Kimi K3.1 Proは14のベンチマークのうち6で勝ち、Terminal-Bench 4.0ではOpus 5.5に0.7ポイント差をつけられています。Artificial Analysisでのスコアは55.1対57.6です。独立したテスターの多くは、日常的な利用では依然としてOpusが上だとしていますが、Kimiの実行コストは約3分の1です。私のClaude Opus 5.5レビューでは、比較相手の側を取り上げています。
Kimi K3.1 Pro Highspeedとは何ですか?
Kimi K3.1 Pro Highspeedは、同じモデルを2倍の料金で2〜3倍速く利用できるものです。100万トークンあたり入力$4、出力$20です。Kimiの個人向けプランではPro以上が必要で、クレジットの消費速度も2倍になります。特に役立つのは、Claude Codeでの作業のように、待ち時間が支障になるチャットやコーディングの反復作業です。
Kimi CodeでKimi K3.1 Proを使うにはどうすればよいですか?
Kimi K3.1 Proは、Plusプラン(月額$19)以上のKimi Codeで利用できます。Kimi Codeを起動し、/modelコマンドで切り替えてください。直近5時間の利用制限には注意が必要です。テスターは推論の労力を最大に設定すると、すぐに上限に達しています。ほかの選択肢については、私がまとめたAIコーディングアシスタントの一覧をご覧ください。
Kimi K3.1 Proをカスタマーサポートに使えますか?
使えますが、Kimi K3.1 Proはモデルそのものなので、ヘルプデスクとの接続、ナレッジの同期、引き継ぎルール、テストは自分で構築する必要があります。また、毎秒50トークンという速度はライブチャットには遅めです。eeselのような、すぐに使えるAIカスタマーサポートのチームメイトなら、その部分を担ってくれます。サポートチケットに最適なAIモデルについての私のガイドでは、各エンジンを比較しています。