

要点
Kimi K3.1 Proに最も近い代替モデルはClaude Sonnet 5.5です。100万トークンあたりの料金は同じ$2/$10で、出力速度は約3倍、ベンチマークスコアもほぼ同等です。Gemini 4 Argonも$2/$10ですが、この料金は2026年11月30日までで、その後は2倍になります。
請求額が問題なら、より安い選択肢はGemini 3.8 Flash(一般的なリクエスト1,000件あたり約$15、Kimiは$40)とDeepSeek V4.1 Flash(オフピーク時で約$2.70)です。今すぐダウンロードできるオープンウェイトを求めるなら、DeepSeek V4.1 FlashとMiMo-V2.6-ProはいずれもMITライセンスです。
意外なのはClaude Opus 5.5です。定価は2倍ですが、推論強度をHighにすると、完了したタスクあたりのコストは安くなります(Artificial Analysisでは$1.82に対して$2.11)。また、モデルの用途がサポートチケットへの回答なら、そもそもモデルを選ぶ必要はないかもしれません。eeselのようなAIヘルプデスクのチームメイトは、すでに最先端モデルで動作しており、まず過去のチケットでテストされます。
なぜKimi K3.1 Pro以外を検討するのでしょうか?
Kimi K3.1 Proは非常に優れたモデルです。まず何よりも先に、それを伝えておきたいです。Artificial Analysis Intelligence Indexでは55.1を記録し、215モデル中4位にランクインしています。Kimi APIの料金は100万トークンあたり入力$2、出力$10です。Terminal-Bench 4.0では、そのページに掲載されている全モデルで最高の67.2%を記録しました。
それでは、なぜリリースから1週間で代替モデルが検討されているのでしょうか?リリース時のスレッドと数値を読んだ限り、繰り返し挙がっている理由は4つあります。
- 遅いです。 Artificial Analysisの測定では、出力は毎秒49.7トークンで、同等モデルの中央値は83.1でした。速度の順位は182モデル中165位です。チャットの返答を待つユーザーには、この差が伝わります。
- 出力量が多いです。 インデックスの実行に148Mの出力トークンを使っており、同等モデルの中央値は約87Mでした。そのため、トークン単価の安さが請求額では相殺されます。インデックスのタスクあたり平均コストは
$2.11で、Kimi K3の$2.00より少し高くなっています。 - ウェイトがまだ公開されていません。 MoonshotのK3.1 Proクイックスタートでは、11月4日までに公開するとしています。私が確認した日には、Hugging FaceにK3.1 Proのリポジトリはありませんでした。
- 購入方法が少ないです。 KimiのBatch APIはK3.1 Proに対応しておらず、個人向けプランは5時間枠の上限にすぐ達してしまいます。ある購入者はこう述べています。
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."

どれも、単独で決定的な欠点になるわけではありません。ただ、それぞれの理由によって適した代替モデルは異なります。そのため、このリストは単一のランキングではなく、乗り換える理由別に整理しました。そもそも乗り換えるべきか迷っているなら、私のKimi K3.1 Proレビューに評価の全体像をまとめています。
どのように比較したのでしょうか?
私はeeselでAIエージェントを開発しています。チームは長年、最先端モデルを実際のサポートキューで運用してきました。そこで身に染みた教訓は、トークン単価だけでは請求額はほとんどわからないということです。重要なのは、成功したタスクあたりのコストです。つまり、実際のタスク群にかかった総費用を、正しく処理できたタスク数で割ったものです。定価が半分でも、出力トークン数が2倍だったり、4件に1件失敗したりするモデルは、安いとはいえません。
そこで、各代替モデルについて3つの数値を確認しました。
- 定価。ベンダー自身の料金ページまたはドキュメントのみを参照しています。
- 1,000リクエストあたりのコスト。入力10,000トークン、出力2,000トークン、キャッシュなしの一般的な呼び出しを想定しています。推論モデルは通常2,000トークンよりはるかに多く出力するため、これは最低ラインです。
- Artificial Analysis Intelligence Indexでのタスクあたりのコストとスコア。すべてのモデルに同じ10種類の評価を実施しており、成功したタスクあたりのコストに最も近い公開指標です。
選んだ7モデルを、多くの購入者の考え方と同じ3つのカテゴリーに分けました。Kimiとほぼ同じ料金の同クラスの対抗モデル、より安価な大量処理向けモデル、そして自分でホストできるオープンウェイトです。
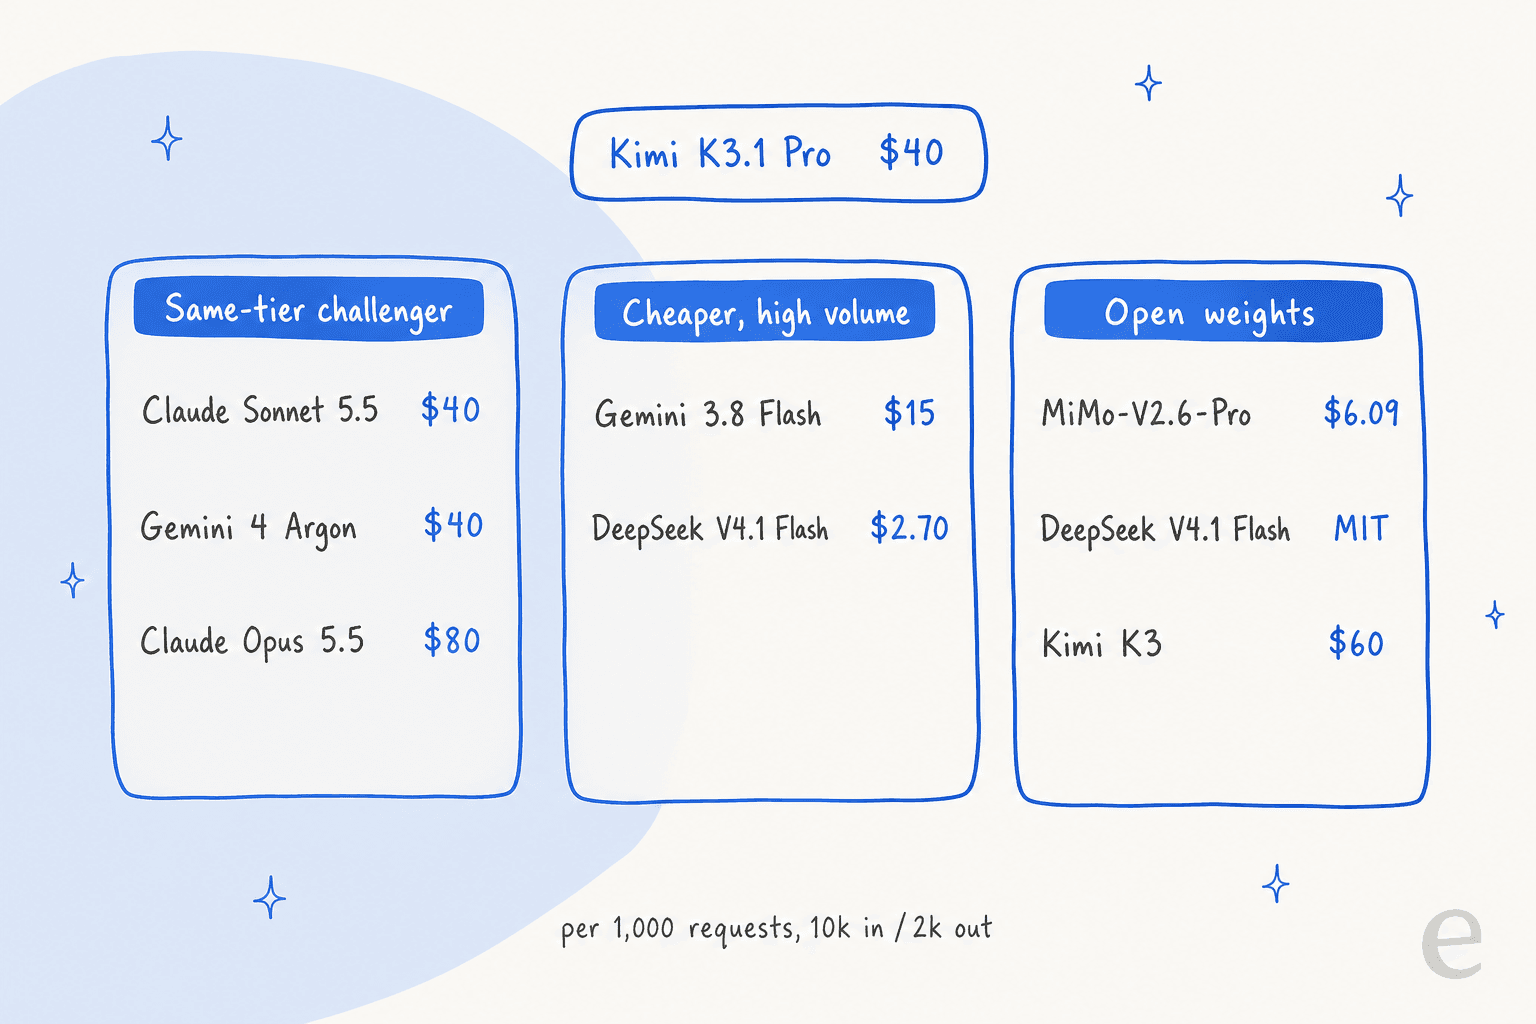
Kimi K3.1 Proの代替モデル早見表
以下の料金はすべて、各ベンダー自身のページから取得しています。ベンチマーク、速度、タスクあたりのコストの各列はArtificial Analysisのデータで、括弧内に記載した推論強度での結果です。
| モデル | カテゴリー | 1Mあたりの入力 / 出力 | 1Mあたりのキャッシュ入力 | コンテキスト | 最大出力 | 1,000リクエストあたり(入力10k / 出力2k) | AA Intelligence Index | AAタスクあたりのコスト | 出力速度(t/s) | ウェイト |
|---|---|---|---|---|---|---|---|---|---|---|
| Kimi K3.1 Pro(基準) | 該当なし | $2 / $10 | $0.20 | 1M | デフォルト131K、最大1M | $40 | 55.1 | $2.11 | 49.7 | 11月4日までの公開を約束 |
| Claude Sonnet 5.5 | 同クラス | $2 / $10 | $0.10 | 1M | 128K | $40 | 56.0 (Max)、51.9 (Xhigh) | $5.46 (Max)、$2.01 (Xhigh) | 141.3 (Max) | 非公開 |
| Gemini 4 Argon | 同クラス | 11月30日まで$2 / $10、その後$4 / $20 | $0.10、その後$0.20 | 1M | デフォルト65K、最大1M | $40、その後$80 | 52.6 (High) | $1.62 (High) | 79.7 (High) | 非公開 |
| Claude Opus 5.5 | 同クラス、プレミアム | $4 / $20 | $0.20 | 1M | 128K | $80 | 57.6 (Max)、53.6 (High) | $5.98 (Max)、$1.82 (High) | 98.1 (Max) | 非公開 |
| Gemini 3.8 Flash | 低価格 | 12月31日まで$0.75 / $3.75、その後$1.50 / $7.50 | $0.075、その後$0.15 | 1M | 65K | $15、その後$30 | 41 (High) | データなし | 133.7 (High) | 非公開 |
| DeepSeek V4.1 Flash | 低価格、オープン | オフピーク$0.15 / $0.60、ピーク$0.30 / $1.20 | オフピーク$0.003 | 1M | 384K | オフピーク$2.70、ピーク$5.40 | 45.1 (Max) | $0.26 (Max) | 169.3 (Max) | MIT |
| MiMo-V2.6-Pro | オープンウェイト | $0.435 / $0.87 | $0.0036 | 1M | 記載なし | $6.09 | 46.3 | 約$0.14 | 54.7 | MIT |
| Kimi K3 | オープン、同じファミリー | $3 / $15 | $0.30 | 1M | デフォルト131K、最大1M | $60 | 43.6 (Max) | $2.00 (Max) | 54.5 (Max) | Kimi K3ライセンス |
目を引く点が2つあります。まず、同クラスの選択肢が充実しています。少なくとも現時点では、3モデルがKimiと同じ1,000リクエストあたり$40です。次に、タスクあたりのコストを見ると順位が変わります。HighのOpus 5.5とHighのGemini 4 Argonは、どちらも平均的なタスクをKimi K3.1 Proより低コストで完了します。Opusのトークン単価は2倍にもかかわらずです。
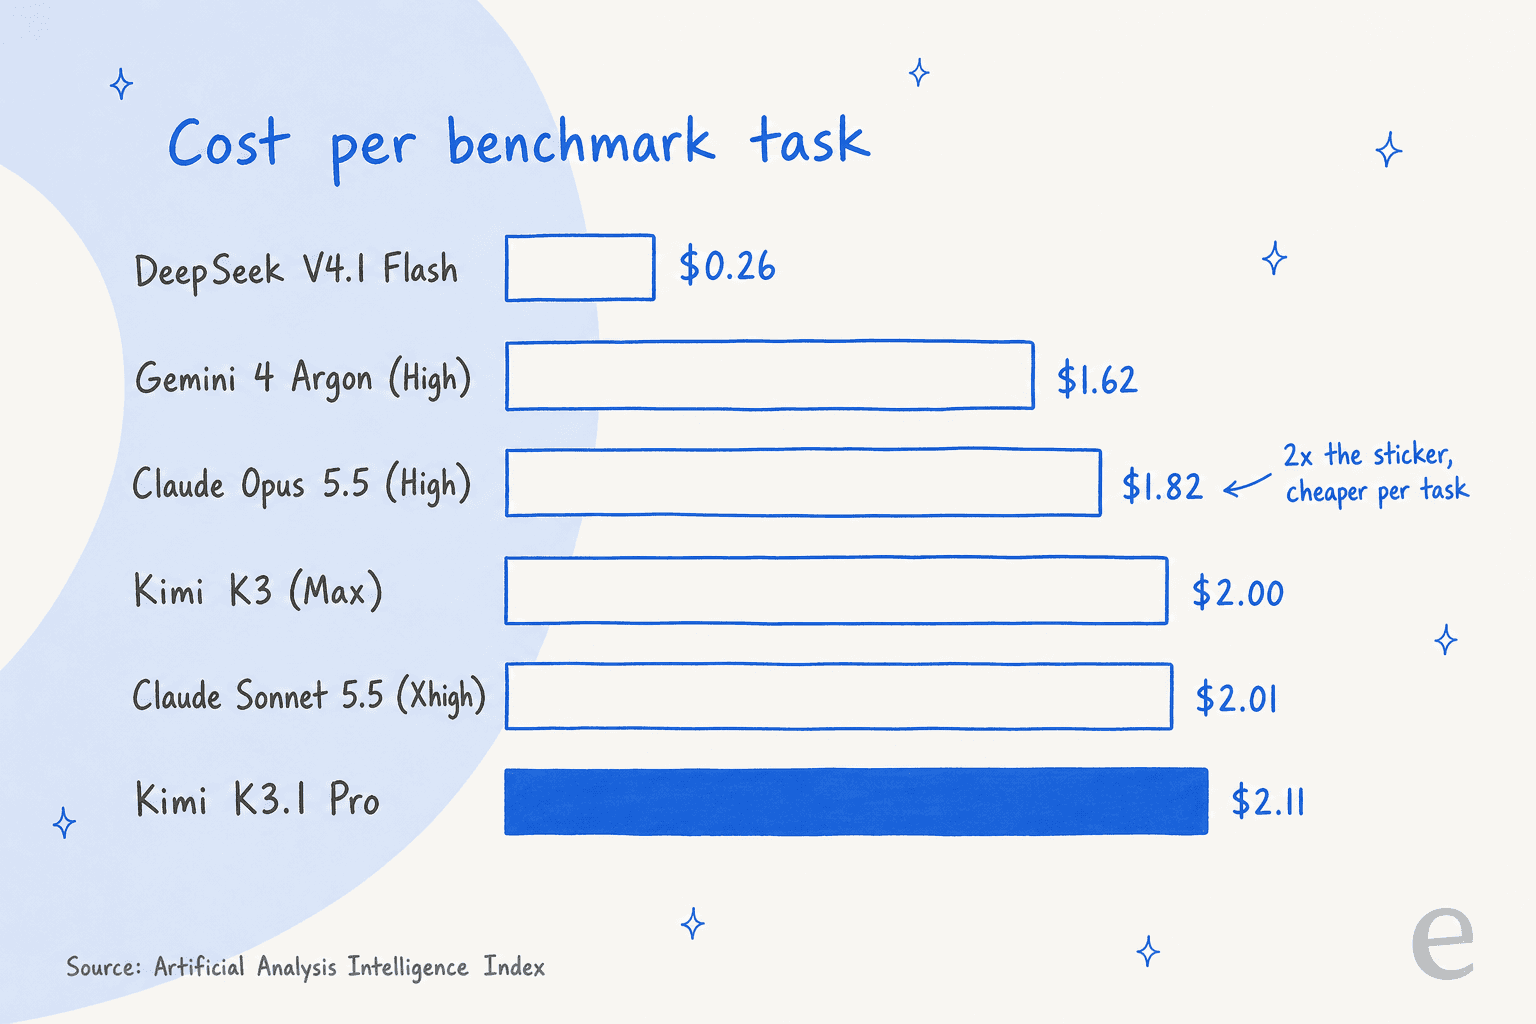
このグラフには1つ注意点があります。Kimi K3.1 Proはデフォルトの最大推論強度で実行され、OpusとArgonはHighで実行されています。ただし、そこが重要なのです。推論強度は調整できる設定であり、優れた回答を最も安く得られるのは、より高性能なモデルを低めの設定で使う場合であることがよくあります。
あなたの製品にはどの代替モデルが合うでしょうか?
製品が行う仕事を選ぶと、私ならどのモデルから比較テストを始めるかがカードに表示されます。
仕事を選ぶと、私がKimi K3.1 Proとの比較で最初にテストするモデルと、入力10k・出力2kトークンの1,000リクエストあたりのコストが表示されます。
1. Claude Sonnet 5.5
最適な用途: Kimiと同じ料金で、より速く安定した出力を求めるチーム。同クラスの対抗モデルです。
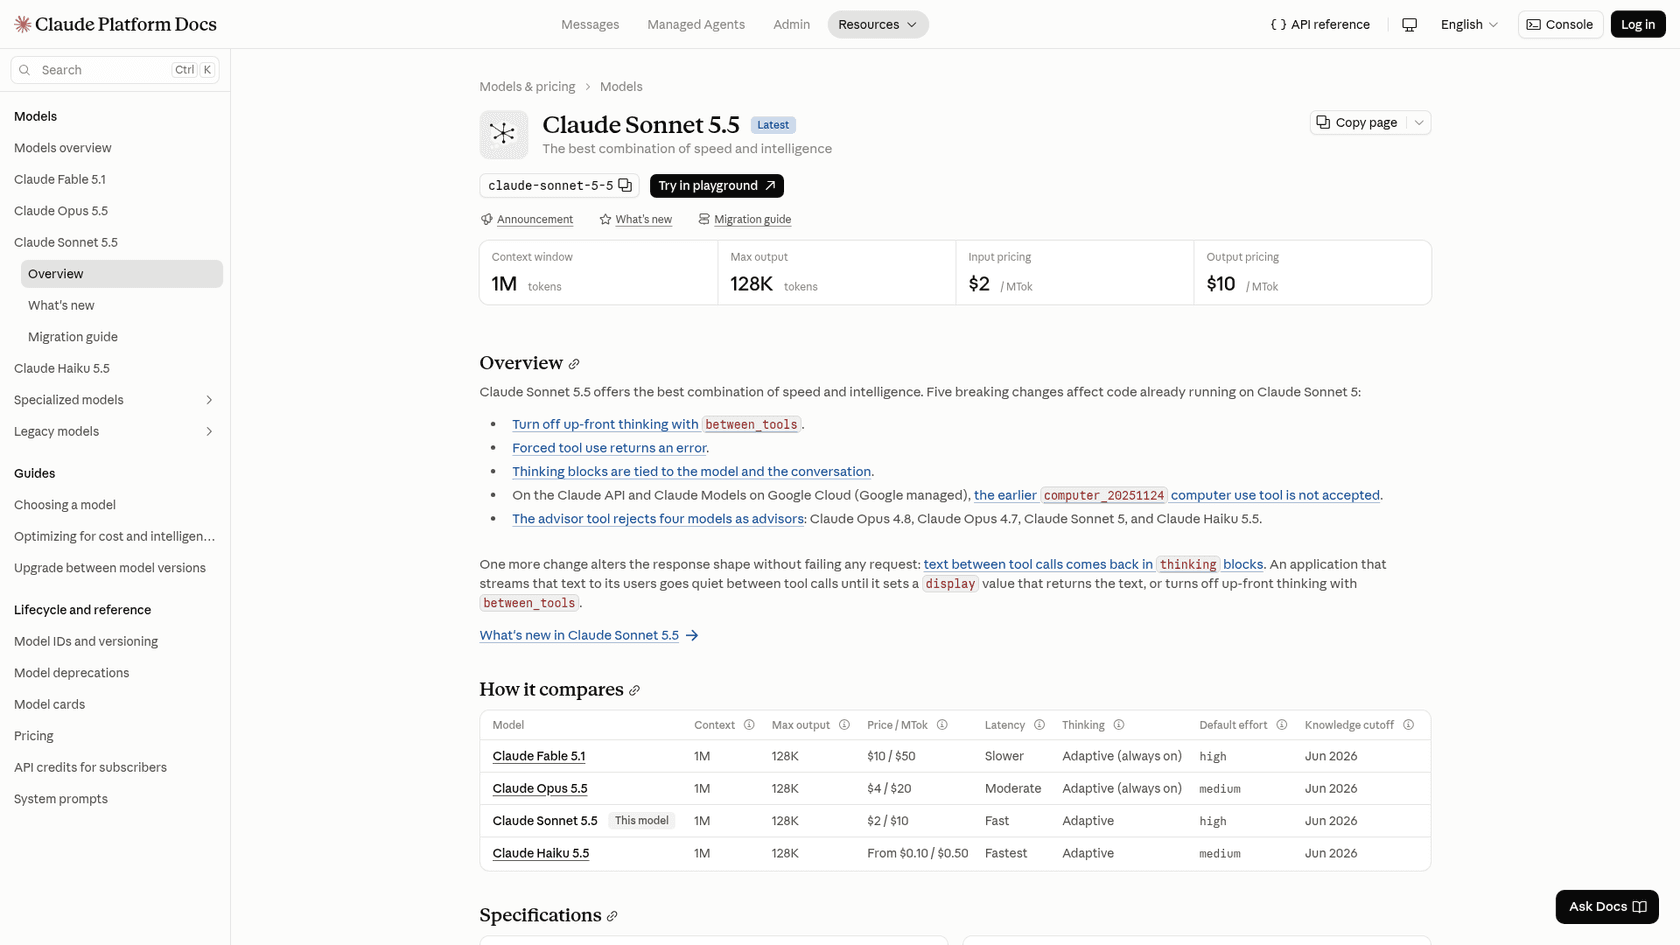
Claude Sonnet 5.5は、このリストで最もそのまま置き換えやすいモデルです。Anthropicのモデル概要によると、料金はKimi K3.1 Proの定価とまったく同じ100万トークンあたり入力$2、出力$10で、コンテキストウィンドウは1M、最大出力は128Kです。
Kimi K3.1 Proよりも選ぶ理由
- 速度。 Artificial Analysisの測定では、最大推論強度で毎秒141.3トークンで、Kimiは49.7でした。
- わずかに高いスコア。 Intelligence IndexではMaxで56.0で、Kimiは55.1です。
- キャッシュ読み取りが安いです。 Anthropicの料金ページでは、Sonnet 5.5のキャッシュ入力100万トークンあたりの料金は$0.10で、Kimiの$0.20の半額です。長く、変更の少ないシステムプロンプトを使うサポートボットでは、この差が積み重なります。
- バッチ。 Sonnet 5.5はAnthropicのバッチAPIで$1 / $5で実行できます。KimiのバッチAPIはK3.1 Proに対応していません。
K3.1のリリーススレッドでは、ある投稿者が自分のベンチマークで両方を実行し、品質は同点だったと報告しています。
"Kimi K3.1 Pro ties Sonnet 5.5 at 93, for $0.68 and 11 min vs Sonnet's $1.61 and 14 min."
弱点
Sonnet 5.5は最大推論強度で出力量が多くなります。インデックスの実行に416Mの出力トークンを使ったため、Maxでのタスクあたりのコストは$5.46とKimiの2倍以上です。Xhighではスコアが51.9に、コストが$2.01に下がります。また、既存のコードとの互換性を損なう変更が5つあります。概要ページによると、ツール使用を強制するとエラーが返り、以前の方法では思考を無効にできません。サポートボットがツール呼び出しの強制に依存している場合は、まずそこを確認してください。
料金
| 項目 | 1Mトークンあたりの料金 |
|---|---|
| 入力 | $2 |
| 出力 | $10 |
| キャッシュ読み取り | $0.10 |
| 5分間キャッシュ書き込み | $2.50 |
| 1時間キャッシュ書き込み | $4 |
| バッチ入力 / 出力 | $1 / $5 |
詳しい内訳は、私のSonnet 5.5料金ガイドにまとめています。
私の見解
Kimiの速度が乗り換えの理由ならSonnet 5.5を選び、推論強度を最大より低くして実行しましょう。最大推論強度でエージェントを長時間実行するワークロードなら、避けたほうがよいです。その場合はトークン数が少ないKimiのほうが請求額を抑えられます。Sonnet 5.5レビューでは、推論強度のトレードオフを詳しく解説しています。
2. Gemini 4 Argon
最適な用途: 12月より前に移行する場合に、Kimiと同じ料金で行う長文コンテキストの処理や正確性が重要な業務。同クラスの対抗モデルです。
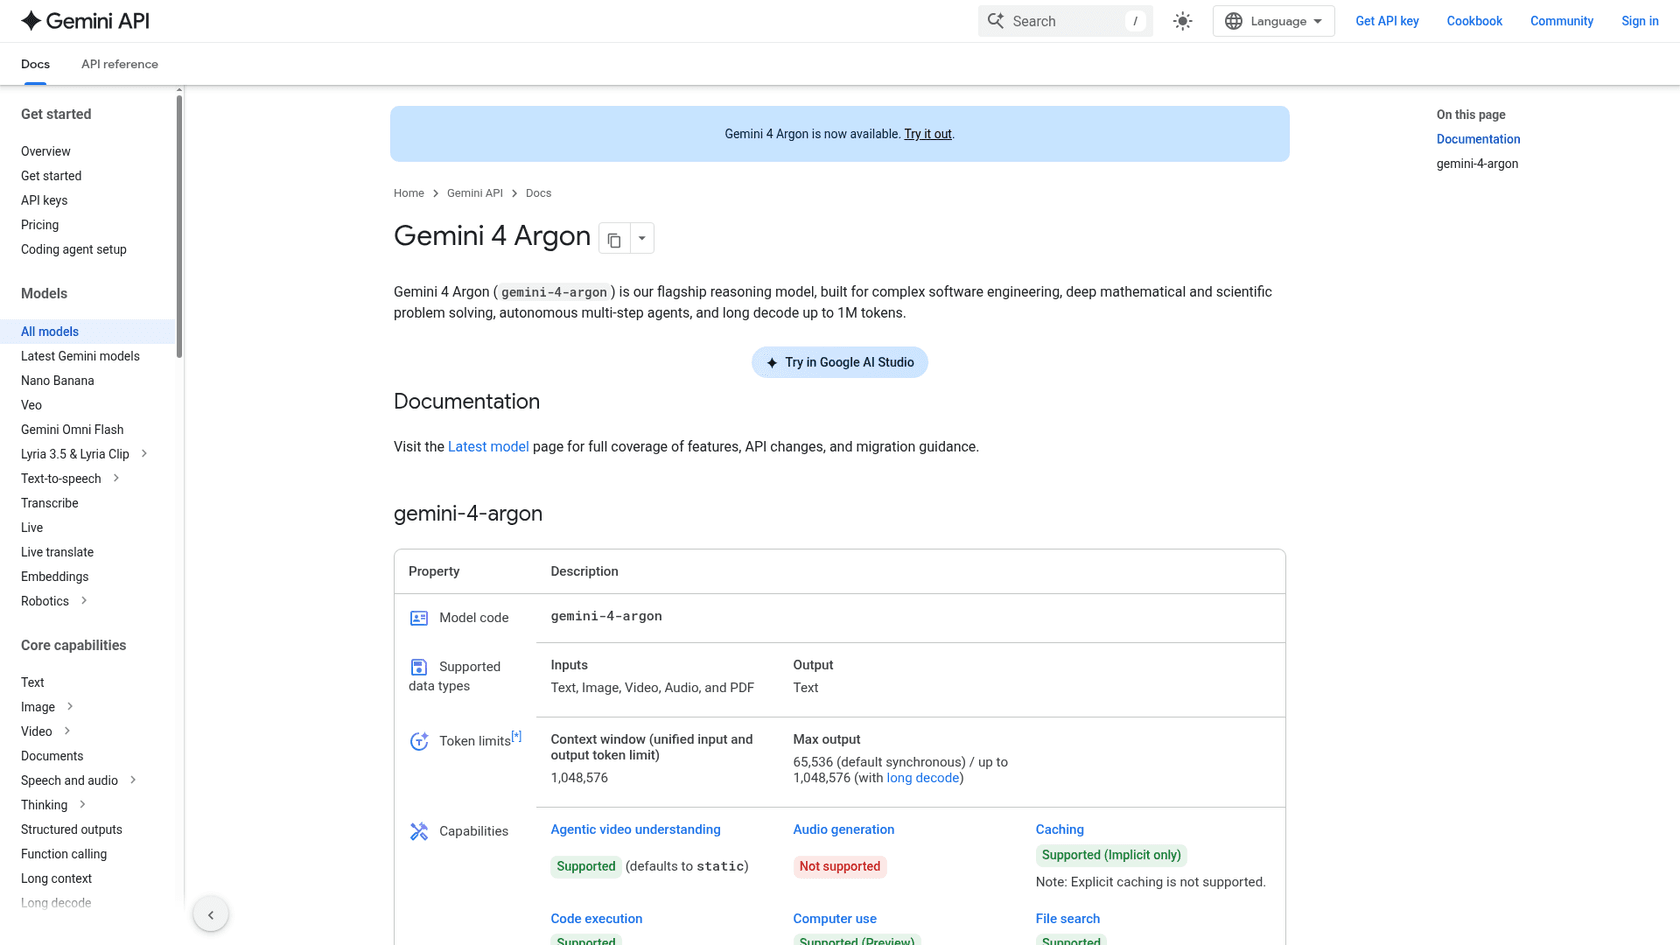
Gemini 4 ArgonはGoogleのフラッグシップ推論モデルで、現在はGemini APIで利用できます。今後数週間はKimi K3.1 Proとまったく同じ料金なので、同クラスで最も試しやすいモデルです。
Kimi K3.1 Proよりも選ぶ理由
- でたらめな回答が少ないです。 Artificial Analysisによるハルシネーション率は15.1%で、Kimi K3.1 Proは43.9%です。顧客向けの用途なら、私が最も重視するのはこの数値です。
- タスクあたりのコストが安いです。 推論強度Highでは、インデックスのタスクあたり平均
$1.62で、スコアは52.6でした。 - 長い出力。 モデルページには、デフォルトの出力が65,536トークン、ロングデコードでは最大1,048,576と記載されています。
- データが学習に使われません。 Googleの料金ページでは、有料枠の利用データは製品の改善に使われないとしています。
弱点
この料金はプロモーション価格です。Googleは2026年11月30日まで$2 / $10、12月1日から$4 / $20と記載しており、その後はOpus 5.5の定価と同じになります。明示的キャッシュには対応せず、暗黙的キャッシュのみで、無料枠もありません。インデックススコアはHighで52.6と、Kimiを2.5ポイント下回ります。
料金
| 項目 | 2026年11月30日まで | 2026年12月1日から |
|---|---|---|
| 1Mあたりの入力 | $2 | $4 |
| 1Mあたりの出力(思考を含む) | $10 | $20 |
| 1Mあたりのキャッシュ入力 | $0.10 | $0.20 |
| 1Mあたりのバッチ入力 / 出力 | $1 / $5 | $2 / $10 |
| 検索グラウンディング | 月5,000件無料、その後1,000件あたり$14 | 同じ |
詳細は、私のGemini 4 Argon料金の記事をご覧ください。
私の見解
誤回答が最大のリスクならArgonを選び、想定外の出費にならないよう12月の料金で見積もりましょう。今後1年間の固定料金が必要なら避けてください。Gemini 4 Argonレビューでは、優れている点と劣っている点をさらに詳しく紹介しています。
3. Claude Opus 5.5
最適な用途: 実行の失敗がトークン代より高くつく、最難関のコーディングやエージェント業務。プレミアムな同クラスの対抗モデルです。
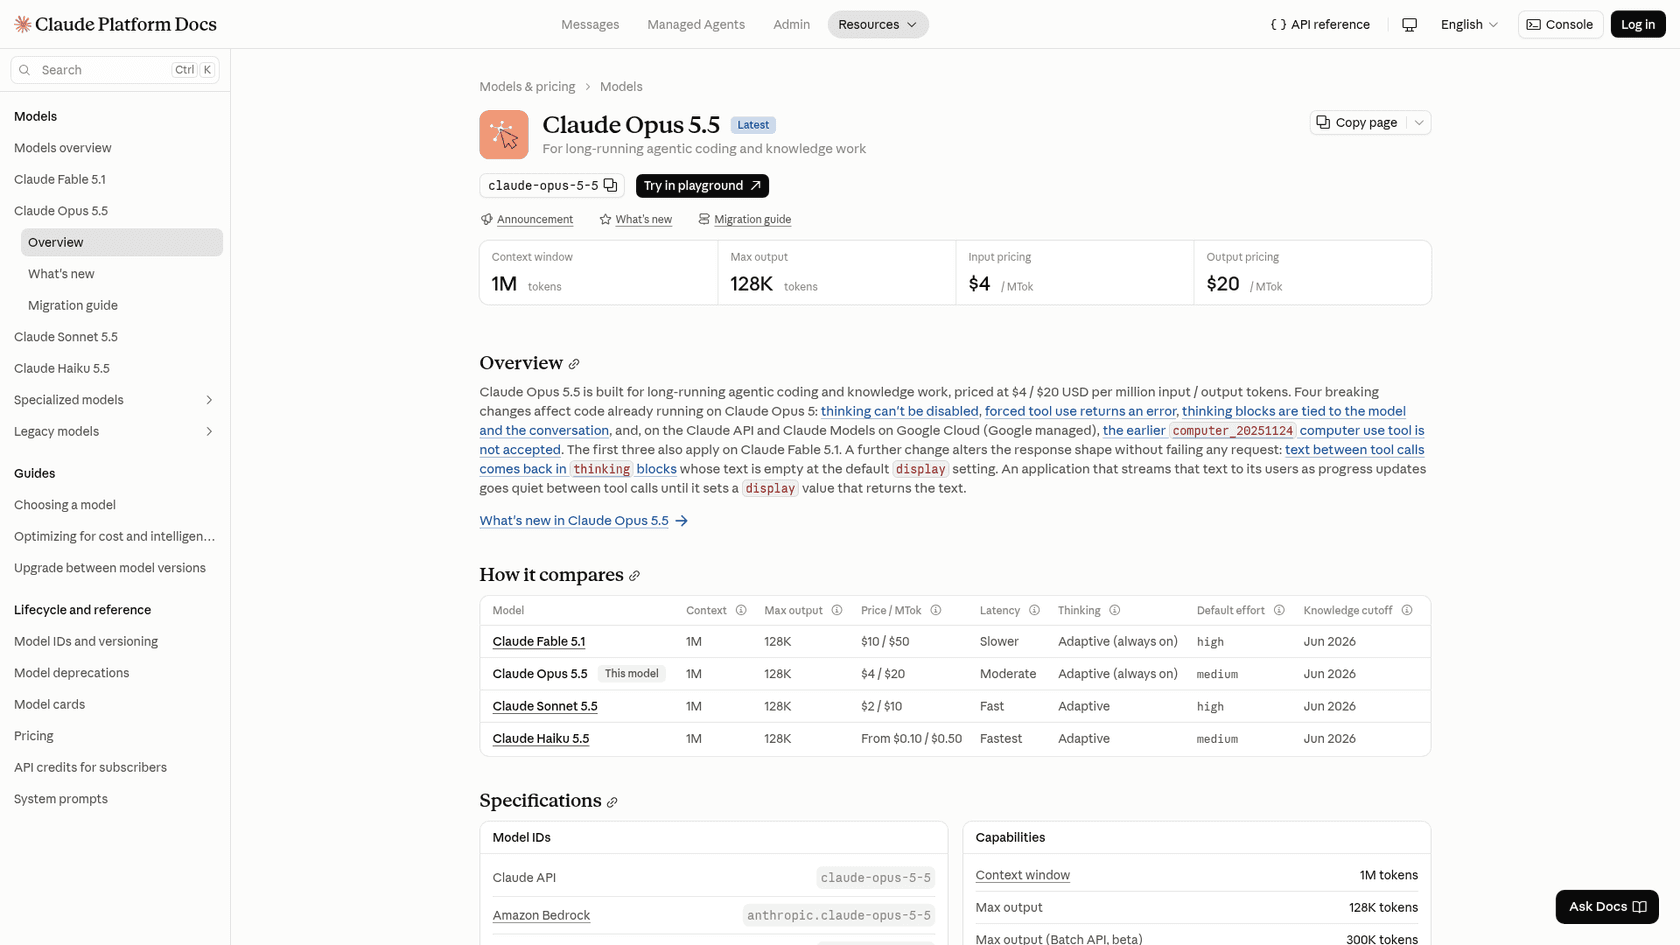
Claude Opus 5.5は、Kimi K3.1 Proが自身を比較する基準にしているモデルです。Anthropic自身のモデル概要では、現在、ほとんどのワークロードでまずこのモデルから始めるよう開発者に勧めています。デフォルトの推論強度はmediumです。
Kimi K3.1 Proよりも選ぶ理由
- ここで最も高いスコアです。 Intelligence IndexのMaxで57.6を記録し、Artificial Analysisの比較で首位です。
- Highではタスクあたりのコストが安いです。 タスクあたり
$1.82で53.6を記録し、Kimiの$2.11を下回ります。 - 日常的に使うユーザーは、依然として高く評価しています。 Xでは、あるテスターが180点のコードで描いた絵で両者を比較しました。
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
弱点
Maxでは、Opusが最も高額な選択肢です。タスクあたり$5.98、インデックス全体の実行に$8,708かかり、Kimiは$3,117です。Artificial AnalysisでのMaxのハルシネーション率は58.6%で、Kimiの43.9%より高くなっています。また、Kimi自身がリリース時に公開した数値では、Terminal-Bench 4.0の差は1ポイント以内です(65.7%に対して66.4%)。
料金
| 項目 | 1Mトークンあたりの料金 |
|---|---|
| 入力 | $4 |
| 出力 | $20 |
| キャッシュ読み取り | $0.20 |
| 5分間キャッシュ書き込み | $5 |
| 1時間キャッシュ書き込み | $8 |
| バッチ入力 / 出力 | $2 / $10 |
| Fast mode入力 / 出力 | $8 / $40 |
すべてAnthropicの料金ページの情報です。Opus 5.5料金の記事では、実際の請求額を計算しています。
私の見解
1回の実行で得られる品質が制約で、推論強度を自分で設定できるなら、HighのOpus 5.5を選びましょう。大量で単純なトラフィックには避けてください。使わない推論能力にお金を払うことになります。私のOpus 5.5レビューでは、各推論強度を詳しく見ています。
4. Gemini 3.8 Flash
最適な用途: 2秒以内に返答する必要がない、大量のAPIトラフィック。低価格カテゴリーです。
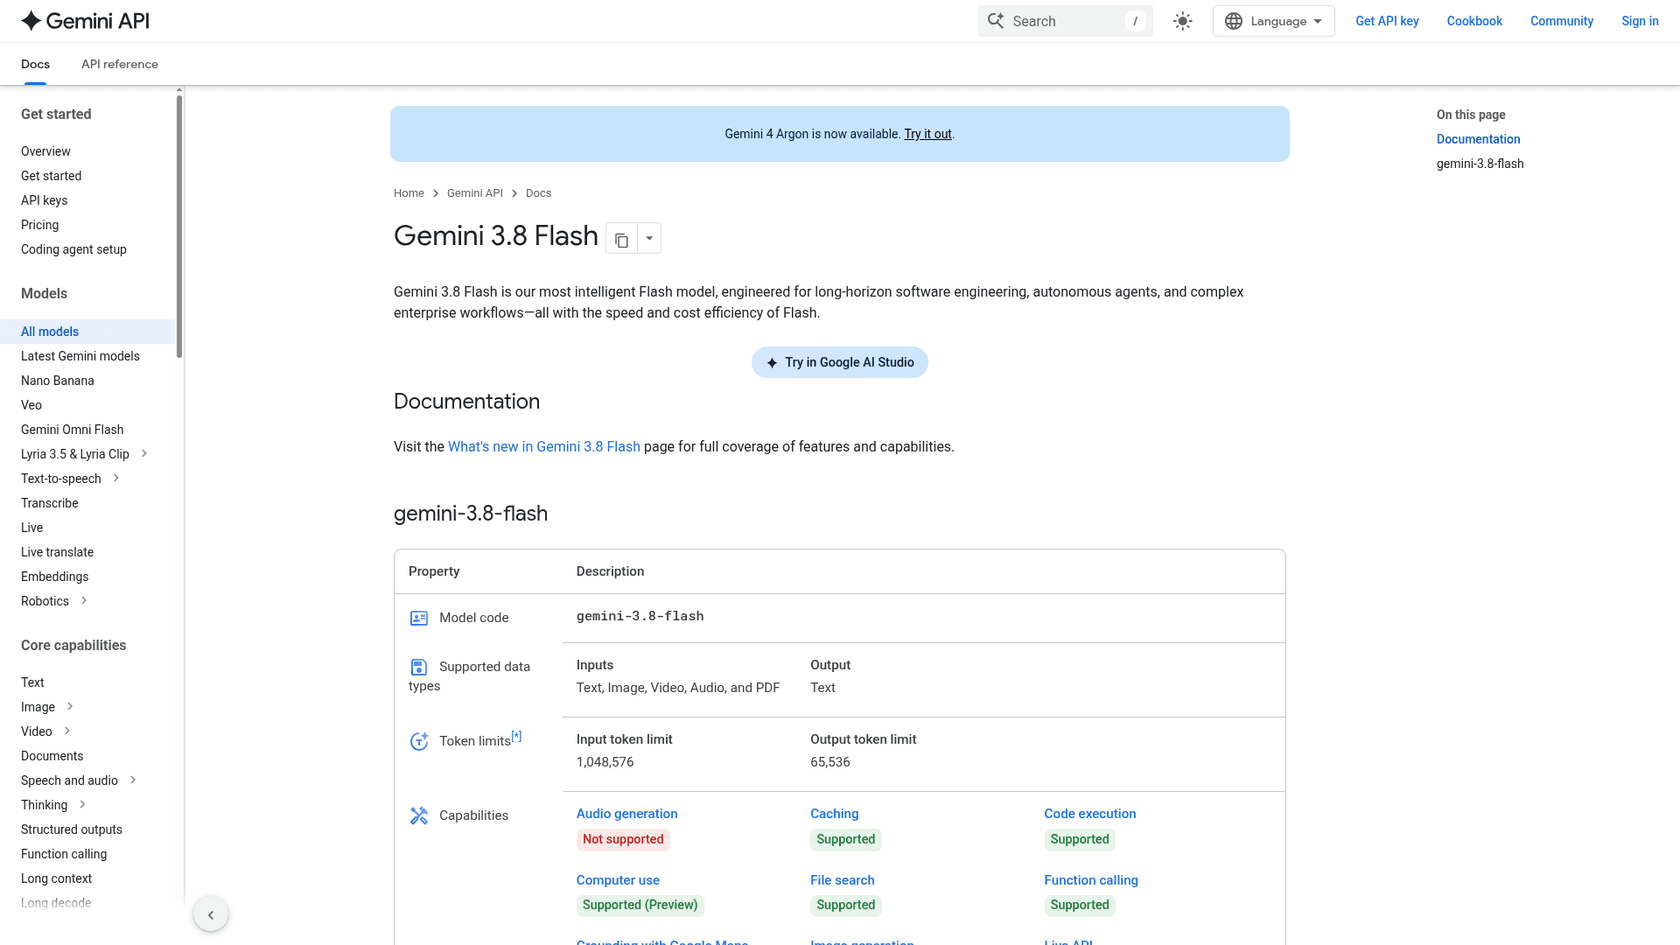
Gemini 3.8 Flashは、ここで紹介する非公開ウェイトのモデルでは最も安価です。Gemini API料金ページでは、2026年12月31日まで、思考トークンを含めて100万トークンあたり入力$0.75、出力$3.75となっています。
Kimi K3.1 Proよりも選ぶ理由
- 請求額は約3分の1です。 一般的なリクエスト1,000件あたり約
$15で、Kimiは$40です。 - 高速な出力。 Artificial Analysisでは毎秒133.7トークンです。
- テスト用の無料枠があり、バッチは有料料金の半額です。
- 幅広い入力。 モデルページによると、テキスト、画像、動画、音声、PDFを入力できます。
弱点
知的能力は一段下がります。Intelligence IndexではHighで41で、Kimiは55.1です。また、Artificial Analysisの測定では、最初のトークンが出るまで28.78秒かかり、同じ価格帯の中央値3.90秒を大きく上回っています。そのため、チャット画面を見つめるユーザーには待ち時間が伝わります。さらに、2027年1月1日には料金が2倍の$1.50 / $7.50になります。
料金
| 項目 | 2026年12月31日まで | 2027年1月1日から |
|---|---|---|
| 1Mあたりの入力 | $0.75 | $1.50 |
| 1Mあたりの出力(思考を含む) | $3.75 | $7.50 |
| 1Mあたりのキャッシュ入力 | $0.075 | $0.15 |
| 1Mあたりのバッチ入力 / 出力 | $0.375 / $1.875 | $0.75 / $3.75 |
| 無料枠 | あり | あり |
私のGemini 3.8 Flash料金の記事には、計算例を載せています。
私の見解
タグ付け、要約、夜間に動かすエージェントなどのバックグラウンド処理には、3.8 Flashを選びましょう。最初のトークンまでの待ち時間を自分で測定するまでは、ライブチャットでの利用は避けてください。Gemini 3.8 Flashレビューでは、このレイテンシの問題を取り上げています。
5. DeepSeek V4.1 Flash
最適な用途: このリストで最も低い請求額と、予備の選択肢としてのオープンウェイト。低価格カテゴリーとオープンウェイトの両方に該当します。
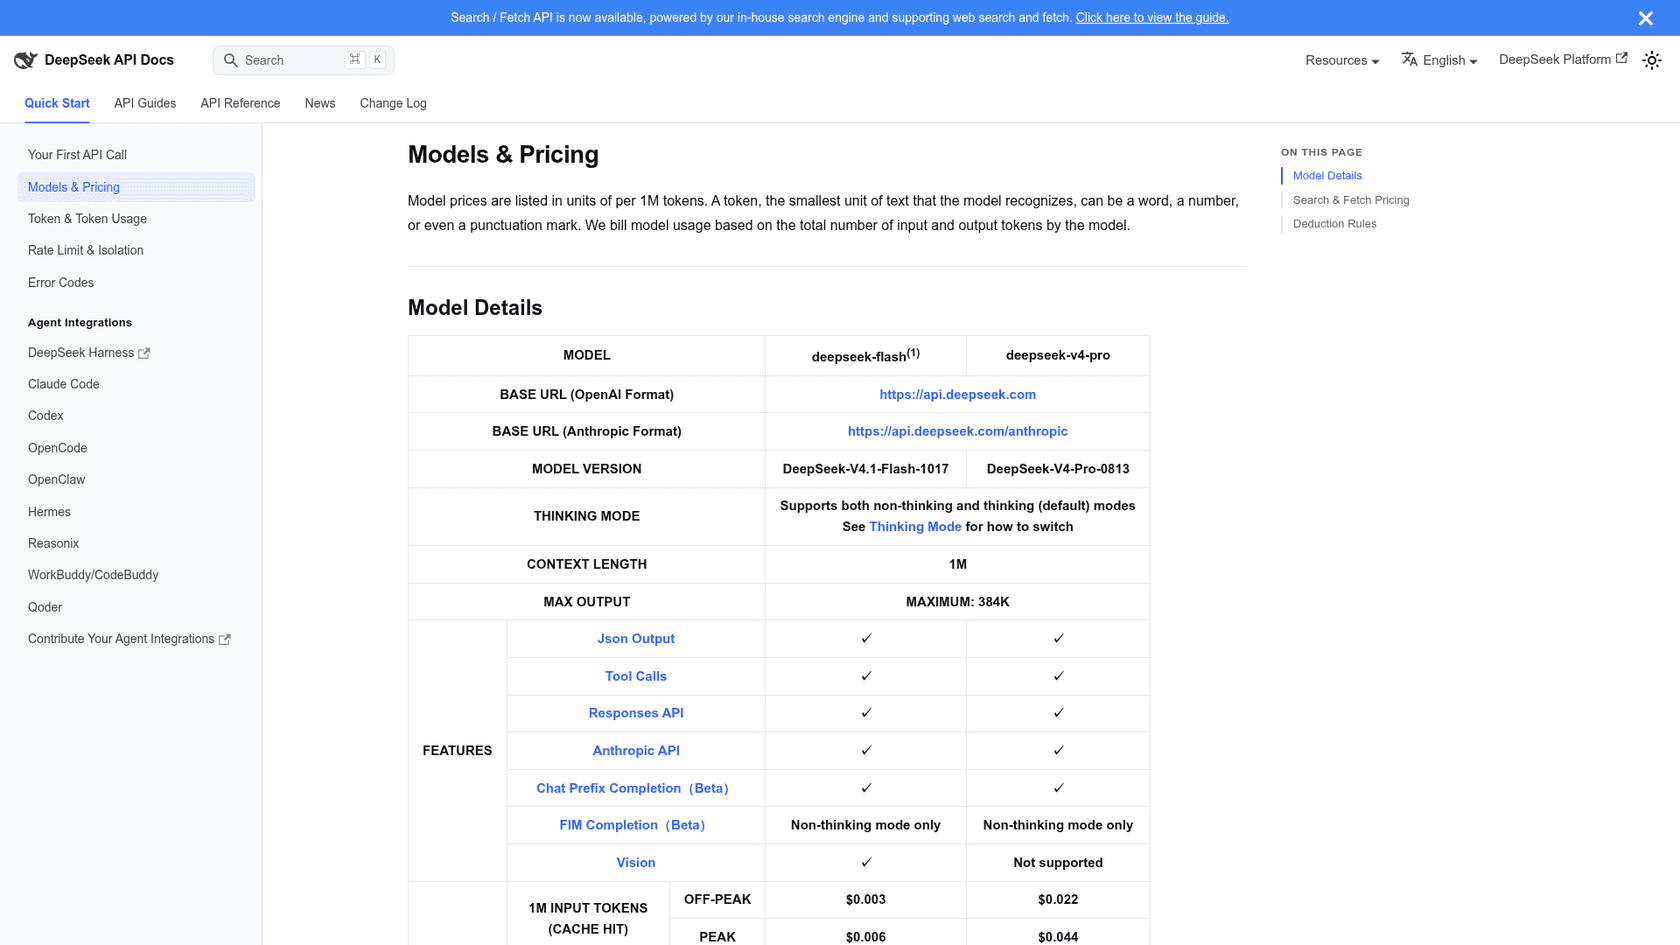
DeepSeek V4.1 Flashは、このグループで最も安価です。DeepSeekのモデルと料金のページによると、deepseek-flashモデル(現在は1017ビルド)はオフピーク時に100万トークンあたり入力$0.15、出力$0.60です。
Kimi K3.1 Proよりも選ぶ理由
- リクエストあたり約15分の1です。 オフピーク時の一般的なリクエスト1,000件あたり約
$2.70で、比較対象は$40です。 - タスクあたり約8分の1です。 Artificial Analysisのタスクあたり
$0.26で、比較対象は$2.11、スコアは45.1です。 - 高速です。 毎秒169.3トークンで、ここでは最速です。
- ウェイトはすでに公開済みです。 Hugging FaceでMITライセンスとして公開されており、約763Bパラメータです。
あるテスターの実際のバグ修正ベンチマークでは、上位に入る結果も出しています。
"So I tested Kimi K3.1 Pro on real work. 2 repos. 105 replanted bugs. Find and fix what you can. The results: DeepSeek V4.1 Flash 1017 (max): 42.7 Muse Wonder Full 1.0 (max): 42 Opus 5.5 (max): 41.7 Kimi K3.1 Pro (max): 36 Muse Spark 1.3 (max): 32.2 I'm sorry. Considering the cost, I see no reason to use this model."
弱点
インデックススコアはKimiより10ポイント低いため、タスクが安い理由の一部は、回答がより単純であることにあります。ピーク時間帯(平日のUTC 01:00から04:00、および06:00から10:00)は料金が2倍になります。また、顧客データについては、DeepSeekのAPI利用規約にデータ処理契約やゼロリテンションの選択肢が公開されていません。サポートチケットを送る前に、法務の確認を受けてください。
料金
| 項目 | オフピーク時の1Mあたり | ピーク時の1Mあたり |
|---|---|---|
| 入力、キャッシュヒット | $0.003 | $0.006 |
| 入力、キャッシュミス | $0.15 | $0.30 |
| 出力 | $0.60 | $1.20 |
| SearchまたはFetch API | 1,000リクエストあたり$0.75 | 同じ |
詳しくは、私のDeepSeek V4.1 Flash料金ガイドと1017アップデートのレビューをご覧ください。
私の見解
45ポイントのモデルで十分な大量処理にはDeepSeek V4.1 Flashを選び、難しいタスクは別のモデルに振り分けましょう。規制対象の顧客データには、ウェイトをセルフホストしない限り使わないでください。
6. MiMo-V2.6-Pro
最適な用途: 別のベンダーによるオープンウェイトと、非常に安いAPI料金。オープンウェイトカテゴリーです。
MiMo-V2.6-Proは、9月にMITライセンスのウェイトとともにリリースされたXiaomiの1兆パラメータ級モデルです。Xiaomiのリリース記事では、公開時点で利用できる最も強力なオープンソースモデルとされ、Artificial Analysisのインデックスで46を記録しています。
Kimi K3.1 Proよりも選ぶ理由
- リクエストあたりの料金は約6分の1です。 Xiaomiの海外向け料金では100万トークンあたり入力$0.435、出力$0.87で、一般的なリクエスト1,000件あたり約
$6.09です。 - インデックス全体の費用が非常に小さいです。 Artificial AnalysisがMiMo-V2.6-Proでインデックス全体を実行するのに使った費用は約
$207で、Kimi K3.1 Proでは$3,117でした。 - 今すぐダウンロードできるウェイトが、MITライセンスでHugging Faceにあります。
- 半額のバッチAPIがあります。KimiはK3.1 Pro向けに提供していません。
弱点
スコアは46.3で、Kimiより9ポイント低くなっています。速度も同じくらい遅く(毎秒54.7トークン)、最初のトークンまで3.29秒かかります。Xiaomiは出力が最大20倍速くなるUltraSpeedモードを販売していますが、料金は10倍($4.35 / $8.70)です。また、パラメータ数が約1.02Tなので、セルフホスティングにはやはり複数GPUのクラスターが必要です。
料金
| 項目 | リアルタイムの1Mあたり | バッチの1Mあたり |
|---|---|---|
| 入力、キャッシュヒット | $0.0036 | $0.0018 |
| 入力、キャッシュミス | $0.435 | $0.2175 |
| 出力 | $0.87 | $0.435 |
| UltraSpeed入力 / 出力 | $4.35 / $8.70 | 提供なし |
詳しくは、私のMiMo V2.6料金の解説をご覧ください。
私の見解
同じベンダーからオープンウェイトと安価なホスト型APIの両方を利用したく、タスクにKimi並みの推論能力が必要ないなら、MiMo-V2.6-Proを選びましょう。UltraSpeedに料金を払わない限り、レイテンシが重要な用途には避けてください。MiMo V2.6レビューにベンチマークを載せています。
7. Kimi K3
最適な用途: Moonshotを使い続けながら、すでに公開されているウェイトを利用する場合。同じファミリーのオープンウェイトです。
Kimi K3はK3.1 Proのベースモデルです。Moonshotのクイックスタートでは、現在これを"previous-generation flagship"と呼んでおり、ウェイトはすでにHugging Faceで公開されています。
Kimi K3.1 Proよりも選ぶ理由
- 11月4日まで待たずに、今すぐウェイトを使えます。 公開リポジトリには約2.78Tパラメータがあります。
- 同じAPI、同じツールです。 Kimi API上で構築済みなら、モデルIDの変更だけで移行は完了です。
- タスクあたりのコストは同等です。 Artificial Analysisのタスクあたり
$2.00で、K3.1 Proは$2.11です。
弱点
正直なところ、新しいホスト型の用途で選ぶ理由はあまりありません。トークン単価は高く($3 / $15)、スコアは55.1に対して43.6で、Terminal-Bench 4.0ではK3.1 Proの67.2%に対して12.6%にとどまりました。ライセンスには、非常に大規模な製品やモデルホスティング事業に対する追加条件もあります。K3.1 Proのウェイトだけが必要なら、1週間か2週間待つほうがよいでしょう。
料金
| 項目 | 1Mトークンあたりの料金 |
|---|---|
| 入力、キャッシュミス | $3 |
| 入力、キャッシュヒット | $0.30 |
| 出力 | $15 |
| 5分間キャッシュ書き込み | $3 |
| 1時間キャッシュ書き込み | $6 |
Kimiの料金ページに基づいています。私のKimi K3料金の記事では、その変遷を紹介しています。
私の見解
今週中にKimiのオープンウェイトが必要な場合に限って、K3を選びましょう。それ以外ならK3.1 Proを使い続けるか、上の6モデルから選んでください。Kimi K3レビューと私のDeepSeek対Kimi K3の比較で、さらに詳しく取り上げています。
各モデルで1,000リクエストはいくらかかるのでしょうか?
同じ一般的なリクエスト、つまり入力10,000トークン、出力2,000トークン、キャッシュなしの条件で、各ベンダーの定価を使って計算した結果です。ほとんどのコスト見積もりは、この数値を出発点にしています。
| モデル | 1Mあたりの入力 / 出力 | リクエストあたりのコスト | 1,000リクエストあたりのコスト |
|---|---|---|---|
| DeepSeek V4.1 Flash(オフピーク) | $0.15 / $0.60 | $0.0027 | $2.70 |
| DeepSeek V4.1 Flash(ピーク) | $0.30 / $1.20 | $0.0054 | $5.40 |
| MiMo-V2.6-Pro | $0.435 / $0.87 | $0.0061 | $6.09 |
| Gemini 3.8 Flash(12月31日まで) | $0.75 / $3.75 | $0.015 | $15 |
| Gemini 3.8 Flash(2027年1月1日から) | $1.50 / $7.50 | $0.030 | $30 |
| Kimi K3.1 Pro | $2 / $10 | $0.040 | $40 |
| Claude Sonnet 5.5 | $2 / $10 | $0.040 | $40 |
| Gemini 4 Argon(11月30日まで) | $2 / $10 | $0.040 | $40 |
| Kimi K3 | $3 / $15 | $0.060 | $60 |
| Claude Opus 5.5 | $4 / $20 | $0.080 | $80 |
| Gemini 4 Argon(12月1日から) | $4 / $20 | $0.080 | $80 |
| Kimi K3.1 Pro Highspeed | $4 / $20 | $0.080 | $80 |
ここで注意点です。推論モデルが出力2,000トークンで止まることはめったにありません。Artificial Analysisのインデックスでは、Kimi K3.1 Proはタスクあたり55,195の出力トークンを生成しました。その大半は推論です。そのため、概要表のタスクあたりのコスト列はこの表よりも重要で、乗り換える前に自分のトラフィックで計算し直す必要があります。
私ならこうします。製品の実際のリクエストを100件取り出し、これらのモデルのうち2つか3つで実行して、回答を評価します。その後、各モデルにかかった費用を、実際にユーザーに提供できる回答の数で割ります。これが成功したタスクあたりのコストであり、選択の決め手になる唯一の数値です。私のKimi K3.1 Pro料金ガイドでは、Kimi単体について同じ計算を解説しています。
サポートチームは、そもそもモデルを選ぶべきなのでしょうか?
製品がサポートボットなら、このリスト全体は1つ下のレイヤーの話です。モデルはインフラです。顧客に回答するのは、その周囲に構築された仕組み全体です。どの過去チケットを読むのか、どのルールに従うのか、いつ人に引き継ぐのか、そして公開前にどう確認するのか、ということです。
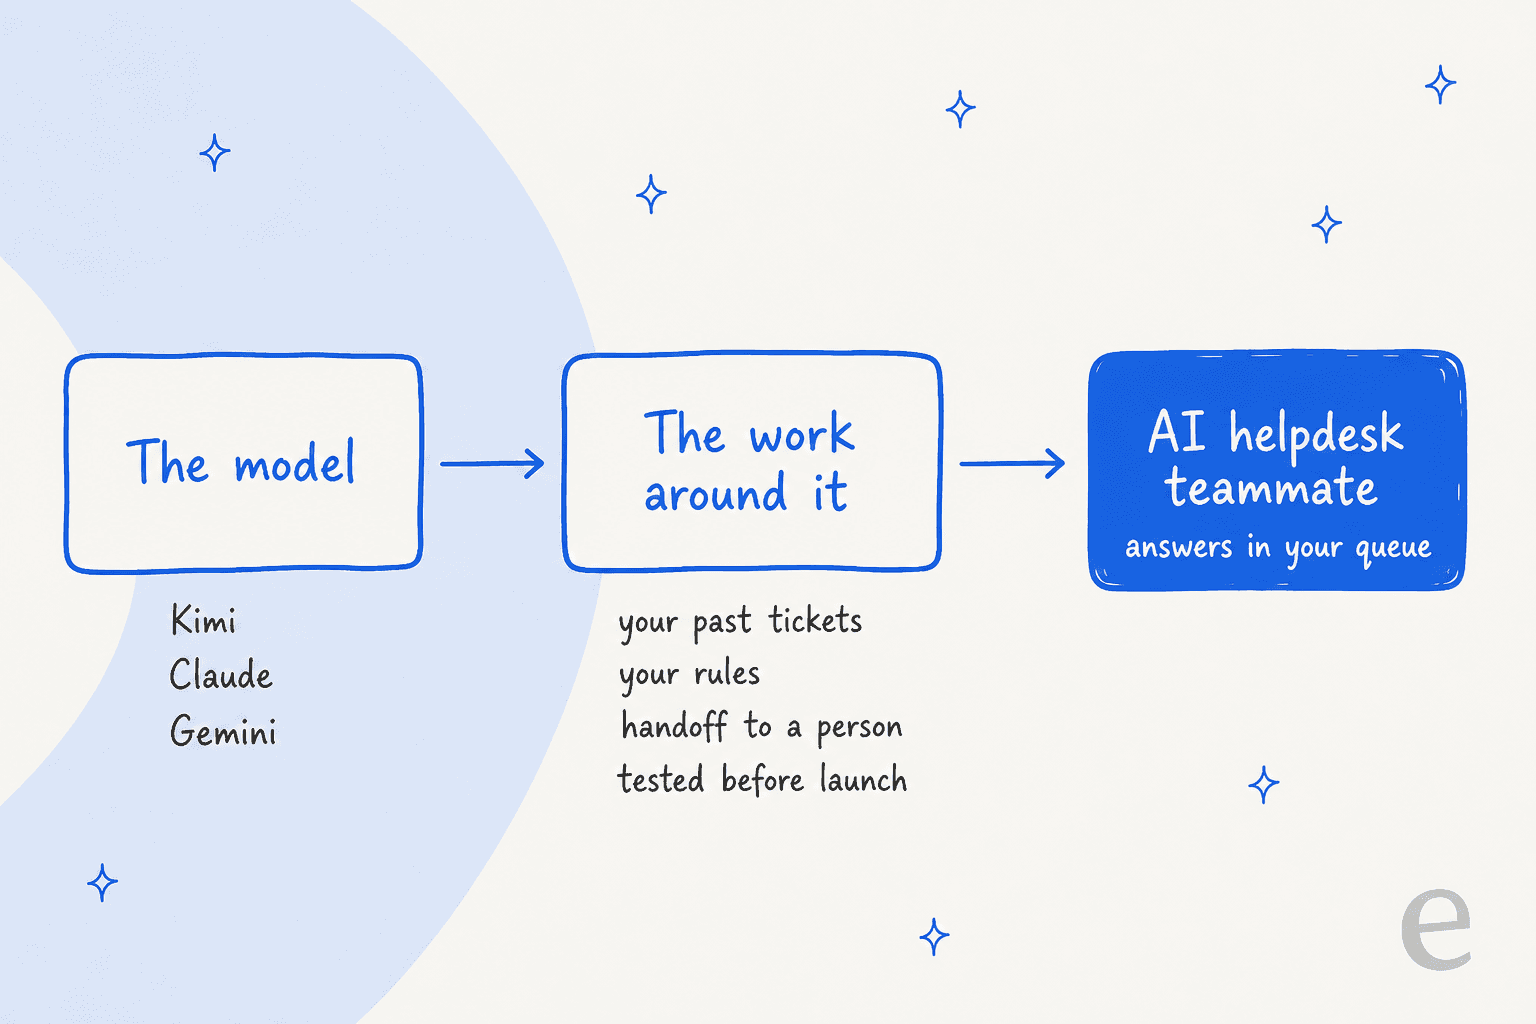
それこそが、私がeeselで日々取り組んでいる部分です。自信たっぷりのモデルが、実際のキューで流暢に誤った回答をする場面を見てきました。だからこそ今では、eeselのすべての導入で、まず数百件の過去チケットを再処理し、チームが実際に送った内容と下書きを比較して評価しています。モデル選びは今でも重要です。ただ、サポートボットの成否を決める判断はそこではありません。
ニュージーランドのERP企業Qontroは、よい例です。同社は2026年7月にFreshdeskをeeselに接続し、過去のチケットとヘルプ記事を約9,800件読み込みました。8月8日から9月8日までの間に、eeselは約190件のチケットへの返信を下書きし、その過程で約400回のナレッジ検索を実行しました。障害、データ消失、請求に関する問い合わせは、直接人に回されます。チームは各下書きを実際に送信した内容と比較し、その差を使ってヘルプセンターを改善しています。ここに至るまで、Qontroの誰もモデルの比較テストをする必要はありませんでした。
ターミナルで作業を続けたい開発者は、eesel CLIで同じチームメイトを操作できます。npx @eesel/cli init chat-bubble --site https://your-site.com は、サイトのページを読み取るウェブサイト用チャットバブル付きエージェントをセットアップし、eesel chatを使うとコマンドラインからテストできます。すべてのコマンドはJSONを出力するため、Claude CodeやCursorなどのコーディングエージェントが代わりにセットアップを実行できます。AIエージェントCLIについての私の記事では、それがなぜ重要なのかを説明しています。
サポートキューでeeselを試してみましょう
顧客のチケットに回答するためにKimi K3.1 Proやこれらのモデルを検討していたなら、まずは別の方法を試してください。eeselは、既存のヘルプデスクに加わり、過去のチケットやヘルプセンターから学習し、誰かに返信する前に履歴データでテストされる、AIヘルプデスクのチームメイトです。Freshdesk、Zendeskなどに対応し、無料プランには100クレジットが含まれています。チケットまたはチャット1件で1クレジットです(料金を参照)。
無料でeeselを試すか、チームがSaaSサポートでどのように活用しているかをご覧ください。このカテゴリーをより広く知りたい方に向けて、私のおすすめのAIヘルプデスクソフトウェアのまとめでは、主な選択肢を比較しています。
よくある質問
Kimi K3.1 Proの最適な代替モデルは何ですか?
ほとんどのチームにとってはClaude Sonnet 5.5です。100万トークンあたりの料金は入力$2、出力$10と同じで、Artificial Analysisでは出力速度が約3倍、最大推論エフォート時のインデックススコアも少し高くなっています。表示価格よりも完了タスクあたりのコストを重視するなら、推論エフォートをHighに設定したClaude Opus 5.5を試してみてください。Artificial Analysisの測定では、タスクあたりのコストはKimi K3.1 Proの$2.11に対して$1.82でした。詳しくはSonnet 5.5の詳細レビューをご覧ください。
Kimi K3.1 Proより安い代替モデルはありますか?
はい。DeepSeek V4.1 Flashのオフピーク時の料金は、100万トークンあたり入力$0.15、出力$0.60です。入力10,000トークン、出力2,000トークンのリクエスト1,000件では約$2.70となり、Kimi K3.1 Proの$40を下回ります。Gemini 3.8 Flashは、2026年12月31日まで、同じ1,000件のリクエストで約$15です。DeepSeek V4.1 Flashの料金ガイドと、Kimi K3.1 Proの料金の内訳をご覧ください。
Kimi K3.1 Proの代替となるオープンウェイトモデルは何ですか?
DeepSeek V4.1 FlashとMiMo-V2.6-Proは、どちらもHugging FaceでMITライセンスのウェイトを公開しています。旧モデルのKimi K3も、独自ライセンスでウェイトを公開しています。MoonshotはKimi K3.1 Proのウェイトを2026年11月4日までに公開するとしていますが、私が確認した時点ではHugging Faceにはありませんでした。私のMiMo V2.6の概要記事で、Xiaomiの選択肢を紹介しています。
Claude Sonnet 5.5はKimi K3.1 Proより優れていますか?
最大推論エフォート時のArtificial Analysis Intelligence Indexでは、Sonnet 5.5は56.0、Kimi K3.1 Proは55.1を記録しています。定価は同じで、出力速度は毎秒50トークンに対して約141トークンです。最大推論エフォート時の完了タスクあたりのコストは、Sonnetの出力トークン数が多いため、Kimiのほうが安くなります($5.46に対して$2.11)。私のKimi K3.1 ProレビューとSonnet 5.5の料金の記事で、さらに詳しく解説しています。
Kimi K3.1 Proの代替モデルをコストで比較するにはどうすればよいですか?
トークン単価ではなく、正常に完了したタスクあたりのコストを比較してください。自分たちのタスクをまとめてテストした際の総費用を、各モデルが正しく完了したタスク数で割ります。表示価格が低いモデルでも、出力トークン数や失敗回数が多ければ、結果的に割高になることがあります。そのため、私はトークン単価と並べてArtificial Analysisのタスクあたりのコストを掲載しています。AIカスタマーサービスのコストガイドでは、サポート向けに同じ考え方を紹介しています。
カスタマーサポートに最適なKimi K3.1 Proの代替モデルはどれですか?
サポートボットでは、ベンチマークの最高スコアよりも速度と誤回答が重要です。Artificial Analysisでは、Gemini 4 Argonのハルシネーション率がこのグループで最も低く(15.1%)、Claude Sonnet 5.5は高速です。そもそもボットを構築したくない場合は、eeselのようなAIヘルプデスクエージェントなら、すでに最先端モデルで動作し、過去のチケットから学習します。
Kimi K3.1 Proのウェイト公開を待つべきですか?
セルフホスティングを予定している場合に限ります。このモデルの総パラメータ数は2.8兆なので、自分たちで動かすには大規模なGPUクラスターが必要です。API経由で呼び出すなら、ウェイトが公開されてもほとんど変わりません。ホスト型の料金はすでに100万トークンあたり入力$2、出力$10です。Kimi K3.1 Proの概要記事で、公開状況を追っています。