私のレビュー方法
私は日々、検索意図と、マーケティングの裏にあるプロダクトをビルダーの目線で見ることに時間を費やしているので、こうしたローンチに対する私のやり方は意図的に地味です。Xiaomiのプレスページは飛ばして、Hugging Face上のモデルカードに直接向かい、独立系のArtificial Analysis指数とスコアを突き合わせ、その後Hacker Newsのローンチ、学習ダッシュボード、価格分析の各スレッドで約670件のコメントを読み、実際にモデルを本気で使っている人たちが何を報告しているかを確認しました。
私が日々作っているツールほど、1年間MiMoと共に暮らしてきたわけではないので、どこまでがリサーチの引用で、どこからが実体験の報告かを明確にします。この違いは、まだ数日しか経っていないモデルにとって重要であり、ローンチから数時間で登場する「レビュー」の大半は、この違いを黙って省いています。
MiMo V2.6とは実際に何なのか
MiMo V2.6は、Xiaomiの MiMoチームによる、オープンウェイトでネイティブにオムニモーダルな言語モデルのファミリーで、2026年9月22日にリリースされました。「ネイティブにオムニモーダル」という表現はここで意味を持ちます。テキストモデルに後付けで視覚アダプターを取り付けるのではなく、同一のモデルがテキスト、画像、動画、音声を扱うのです。すべてのチェックポイントは、MITライセンスのもとで1Mトークンのコンテキストウィンドウを搭載しています。
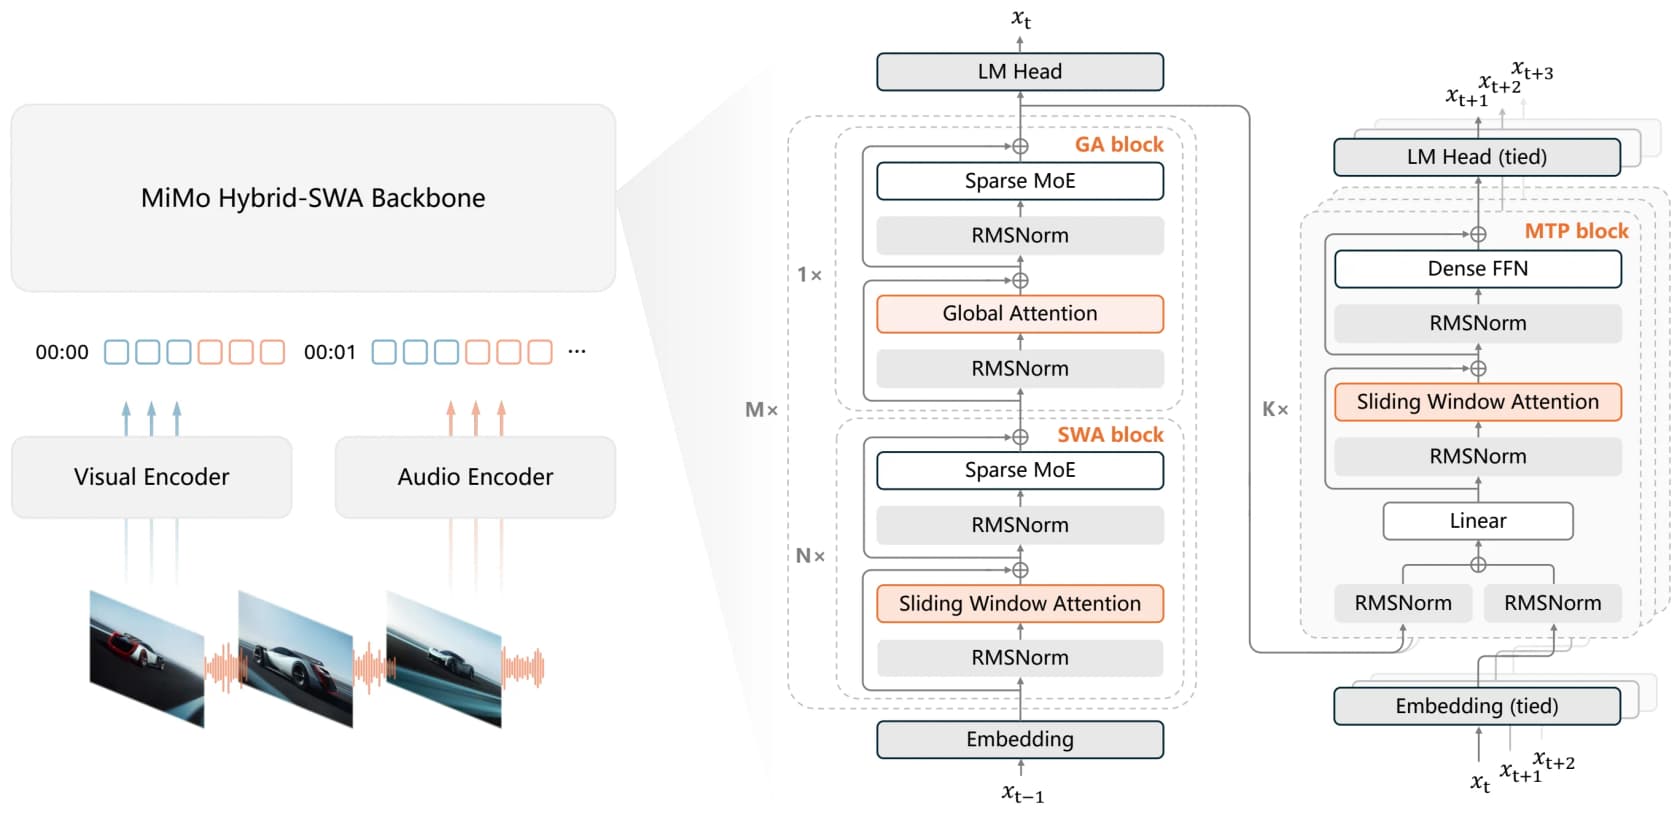
ビルダー視点での一段落まとめ:Proはスパースなミクスチャー・オブ・エキスパートで、総パラメータ数1.02Tのうちトークンごとに稼働するのはわずか42B。70層からなるハイブリッドアテンションバックボーン(ローカルなスライディングウィンドウとグローバルアテンションを交互に配置)、384のルーティング可能なエキスパートのうちトークンごとに8個が発火、681Mの視覚エンコーダー、音声エンコーダー、そして5層のマルチトークン予測デコーダーを備えています。これを使うのにこうした知識は不要ですが、「1兆パラメータ」のモデルがなぜ安価に済むのかを説明してくれます。支払いの対象になるのは稼働パラメータ数であり、総パラメータ数ではないのです。
4つのチェックポイントで展開されており、ネット上の混乱の多くはここに起因しています。
| モデル | 総パラメータ数 | 稼働パラメータ数 | コンテキスト | 最適な用途 |
|---|---|---|---|---|
| MiMo V2.6 Pro | 1.02T | 42B | 1M | 最も要求が厳しい長期的なエージェント作業 |
| MiMo V2.6 Flash | 309B | 15B | 1M | 知能、速度、コストの最良のバランス |
| MiMo V2.6 Pro UltraSpeed | ~1T | 42B | 1M | 高速な出力が必要なときのPro品質 |
| MiMo V2.6 Distill-Qwen-9B | 9B | 9B | n/a | 単一GPU利用とオープンなエージェント系RL研究 |
Flashはほとんどの人が選ぶことになるモデルです。UltraSpeedは同じProチェックポイントを約10倍高速な出力で提供する代わりに価格も10倍になっているため、賢いモデルというよりレイテンシのプレミアムです。9B蒸留版は、MiMo生成データによるQwen3.5-9Bの教師ありファインチューンで、本番用というより研究の出発点です。
ベンチマークを正直に読む
どんなローンチも都合の良いチャートだけを見せるものなので、モデルカード上の評価テーブルを確認し、勝敗に分けてみました。Xiaomiの名誉のために言うと、両方とも公開しています。
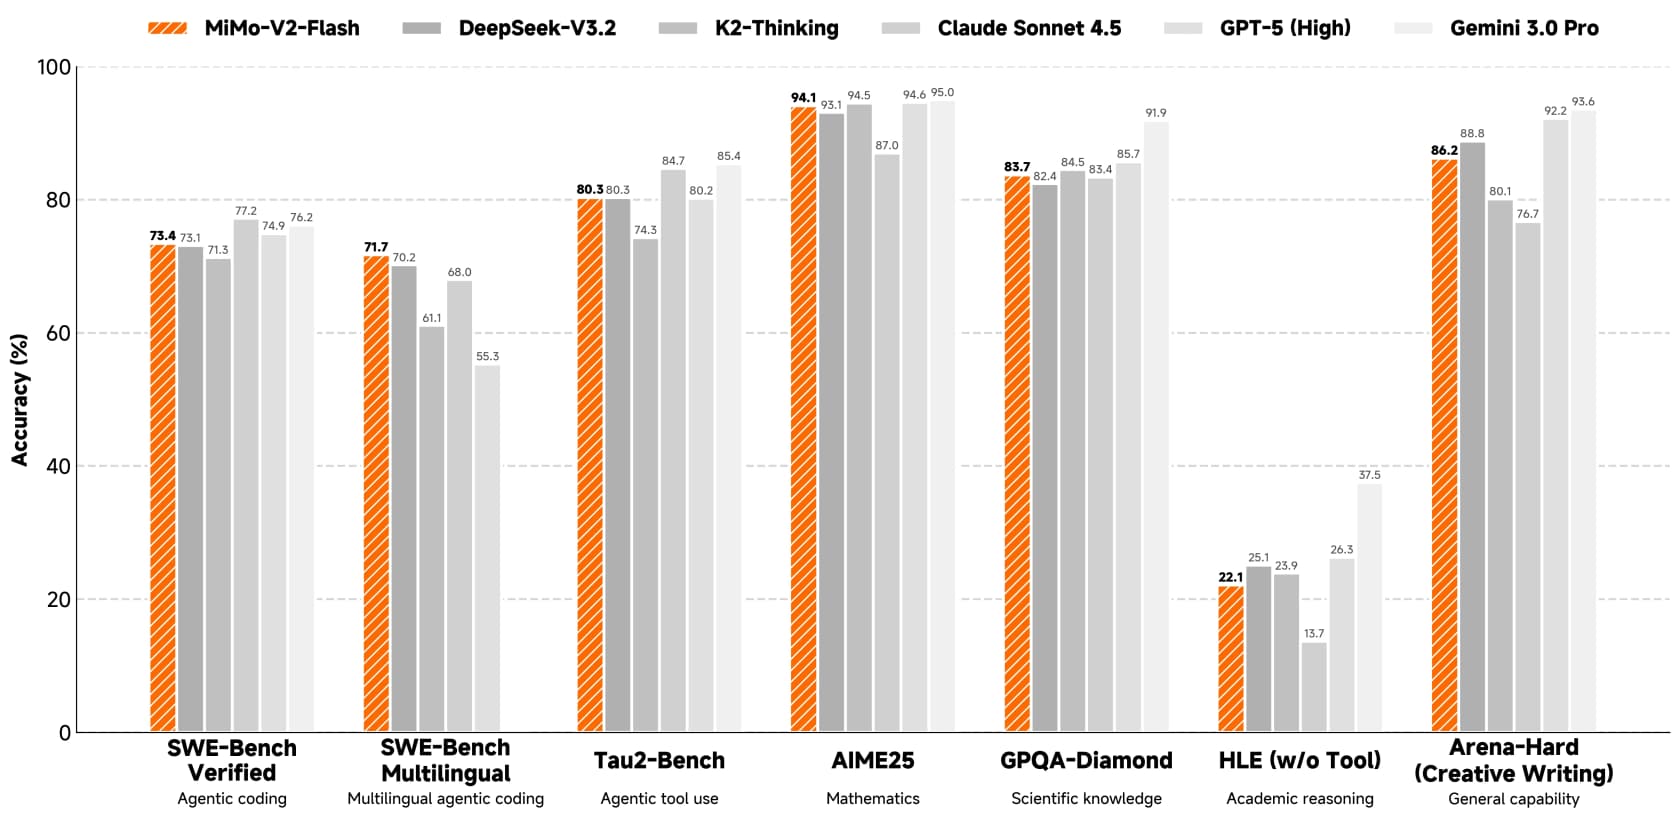
Xiaomiの数値でProがクローズドフロンティアをリードしている部分:
| ベンチマーク | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| AutomationBench v1.0.6 | 53.1 | 50.3 | 45.8 |
| Terminal Bench 2.1 | 89.9 | 89.1 | 88.8 |
| Agents' Last Exam | 31.6 | 31.6 | 30.8 |
| CyberGym | 94.0 | - | - |
そして、及んでいない部分。Terminal Bench 4.0のボードがそれを如実に示しています。
| ベンチマーク | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 37.0 | 25.0 |
| Terminal Bench 4.0 | 34.9 | 49.0 | 39.9 |
| ExploitBench | 47.9 | 70.0 | 78.5 |
このパターンは一貫していて、私の見るところ説得力があります。一般的なエージェント作業やツール利用のタスクではProはフロンティアと肩を並べており、最も難しい長期的なコーディングとエクスプロイト系のベンチマークでは後れを取っています。Xiaomiが比較対象にGPT-6 Astraを加えて範囲を広げても、同じ傾向が続きました。ProはAutomationBenchとTerminal Bench 2.1ではトップ近くに位置し、Terminal Bench 4.0ではAstra(59.6)に後れを取っています。
世代を超えた飛躍こそが、私を実際に感心させた部分です。前世代のMiMo V2.5 ProはDeepSWE v1.1で19.0でしたが、V2.6 Proは71.9を記録しています。Terminal Bench 4.0では1.5から34.9まで伸びました。これは漸進的な進歩ではなく、研究所が学習アプローチを変えたときにしか見られない類の飛躍です。
ある数値は歓声よりも警戒フラグに値します。ProはCyberGymで94.0を記録していますが、V2.5は40.0にとどまっていました。一方、より敵対的なExploitBenchでは47.9とより控えめな結果を示しています。私ならCyberGymの結果は印象的だが、まだ確定していないと読みます。
コスパの計算こそが本当の物語
個々のボードだけを見ると数字はノイズだらけです。私が実際に注視している数値は、Artificial Analysisの集計指数です。これは多数の評価を1つの比較可能なスコアにまとめ、それをコストに対してプロットしてくれるからです。
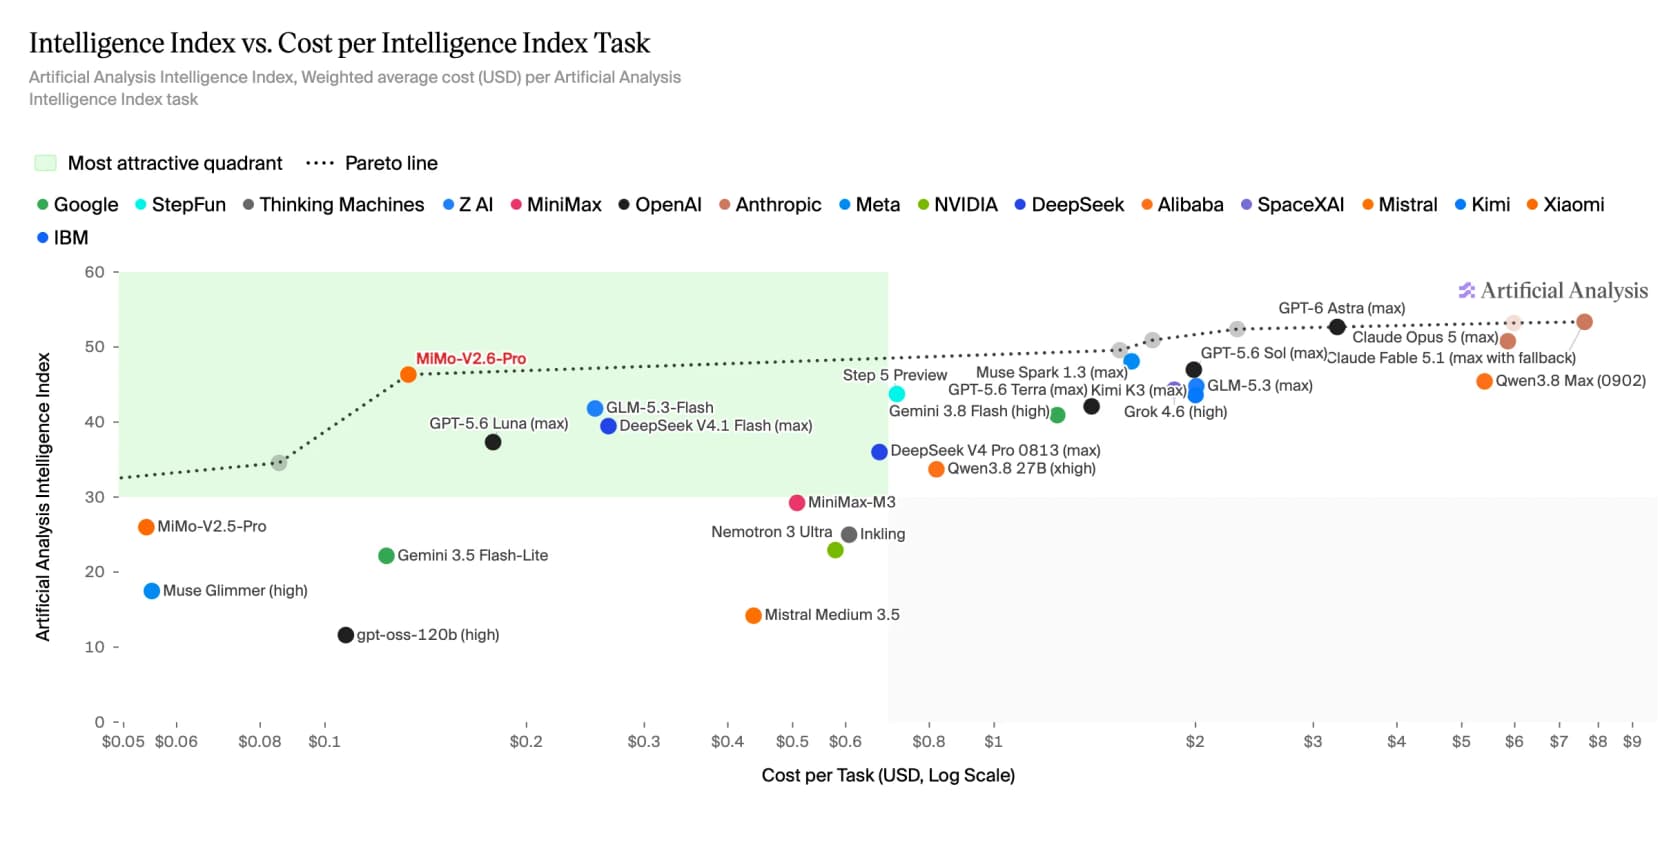
MiMo V2.6 Proは、Artificial Analysisが文字通り「最も魅力的な象限」と呼ぶ位置で、Intelligence Index 46という盤上で最良のオープンウェイトモデルの座に着いています。クローズドフロンティア(Astra、Opus 5、Fable 5.1は50台前半から半ば)は純粋な知能では上回りますが、1タスクあたり$3から$8かかります。MiMoはその46を約$0.13で実現しています。
この価格対知能の比率こそが、すべてのセールスポイントです。以下はOpenRouterのホスト型価格を100万トークンあたりで示したもので、ローンチ週に確認済みです。
| モデル | 入力/1M | 出力/1M | コンテキスト |
|---|---|---|---|
| MiMo V2.6 Flash | $0.14 | $0.28 | 1M |
| MiMo V2.6 Pro | $0.435 | $0.87 | 1M |
| MiMo V2.6 Pro UltraSpeed | $4.35 | $8.70 | 1M |
入力$0.14/出力$0.28のFlashは、1Mコンテキストのオムニモーダルモデルとしては驚くほど安価です。ほとんどのチームにとってFlashがデフォルトであり、Proはそこからエスカレーションする先になります。
どのMiMo V2.6チェックポイントが合っているか
4種類のチェックポイントのラインナップは、このローンチの中で最も混乱を招く要素なので、簡単な判定ツールを用意しました。3つの質問に答えれば、適切なチェックポイント(あるいはMiMo以外の選択肢)を示してくれます。
実際に使った人たちの声
ベンチマークはXiaomiの物語だが、私が知りたかったのはユーザーの物語でした。ローンチスレッドでの支配的な反応は、スコアについてではまったくありませんでした。Xiaomiがどれほどオープンにこのモデルを学習させたか、という点についてでした。
"I really like how transparent they've been about the training of this model. The realtime dashboard they shared during training was an incredible learning and teaching tool for me, and they've been unusually comprehensive in sharing details about their methodology... and benchmark scores (even the stuff they didn't do well on)."

"The best thing they did is being open about all the setbacks they had to deal with. They logged every restart with a reason, talked about dropping a cyber dataset after it degraded coding benchmarks. Also published real time training loss, benchmark scores after every checkpoint and running cost estimates."
コーディングスコアを悪化させたという理由でサイバーデータセットを取り下げたというあの詳細は、研究所がほとんど認めない類のことであり、懐疑的な人々からさえ好感を得た大きな理由になっています。最も鋭い技術的な指摘は、ボードを手作業で数え上げた長年のMiMoユーザーから寄せられました。
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."
賞賛ばかりではありませんでした。中国発の強力なオープンモデルにつきまとう懸念は、いわゆる「ベンチマックス」、つまり素晴らしいスコアと期待外れの実務、というものです。
"No chinese lab has caught up yet. They've tried to fake it by distilling and overfitting on benchmarks to make their models look better than they are, the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."
これに対する反論は、すでに本番環境でこのラインを動かしている人たちから寄せられました。コスパについての意見は、私が最も考えさせられたものでしたが、これは前世代のV2.5についてのものであり、複数の人が難しいタスクでは「速いが賢くない」と評していた点には注意が必要です。
"I been using MiMo-V2.5 to do most of my work as software engineer... I been VERY happy with ROI. The model is very powerful!... The cost is unbelievably low, and the quality of intelligence I get is equivalent to when I was working mostly with Anthropic models... but when I add cost of M-token in the ROI math, Jeez! MiMo is an order of magnitude better."
X(旧Twitter)では、このローンチは主に同日にリリースされたGrok 4.7への当てつけとして受け止められ、"Better than Grok 4.7"という反応から、"let's wait for real-world test performance first."という慎重な意見まで幅がありました。この「実際のテスト結果を待とう」という留保は正しく、まさにこの点こそが、V2.5の「速いが難しいタスクでは賢くない」という評判を、V2.6がチャートの上だけでなく日々の利用において乗り越えなければならないハードルにしています。
私の結論:最良のオープンウェイトのコスパであり、最も賢いモデルではない
リサーチに1週間費やした末の、私の結論はこうです。
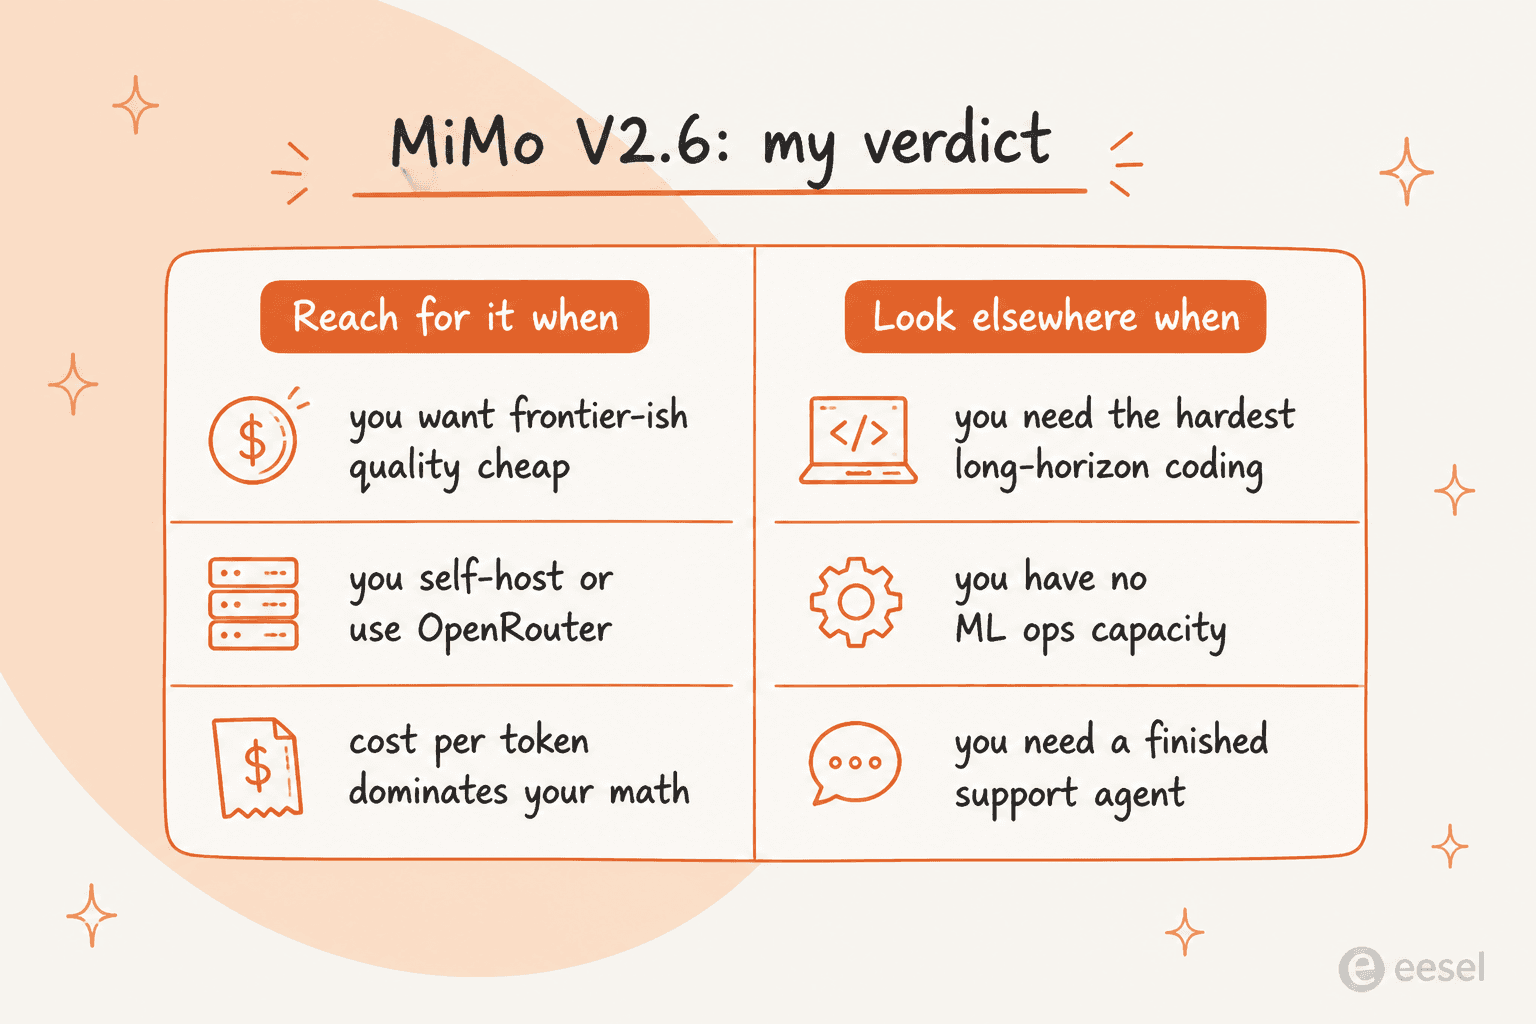
MiMo V2.6を選ぶべきなのは、トークンあたりのコストが計算を左右し、自前ホストやOpenRouterの利用に抵抗がなく、一般的なエージェント作業やツール利用でフロンティア級に近い品質を求めている場合です。特にFlashは、クローズドフロンティアのトークン単価が痛手になるような大量・日常的なタスクに対する強力なデフォルトの選択肢です。
他を検討すべきなのは、業務内容が最も難しい長期的なコーディングやエクスプロイト系の作業であり、そこではProがAstraやOpus 5に対して測定可能なほど後れを取っている場合、モデルのインフラを運用する余力や運用コストの計画がない場合、あるいは実際には仕事をこなす完成されたエージェントが必要で、素のモデルでは足りない場合です。この最後の点については、MiMoはその道具ではなく、単体のどのモデルもそうではありません。
評価としては、オープンウェイトのコスパ枠として、DeepSeek V4.1 FlashやQwen 3.8 Maxと並んで現在の中でもトップクラスに位置づけます。「クローズドフロンティアを超える」という主張については、正直な答えはこうです。価格については、はい。最も難しいベンチマークについては、まだです。より広い視点については、最良のオープンソースAIエージェントのまとめ記事が次に読むのに適しています。
モデルレビューが普段は省く部分:エンジンは従業員ではない
私はこの数年、実際のサポートキューにAIを導入する仕事に携わってきましたが、MiMo V2.6のローンチは、私たちが苦労して学んだあることを裏付けています。モデルはもはやボトルネックではないということです。
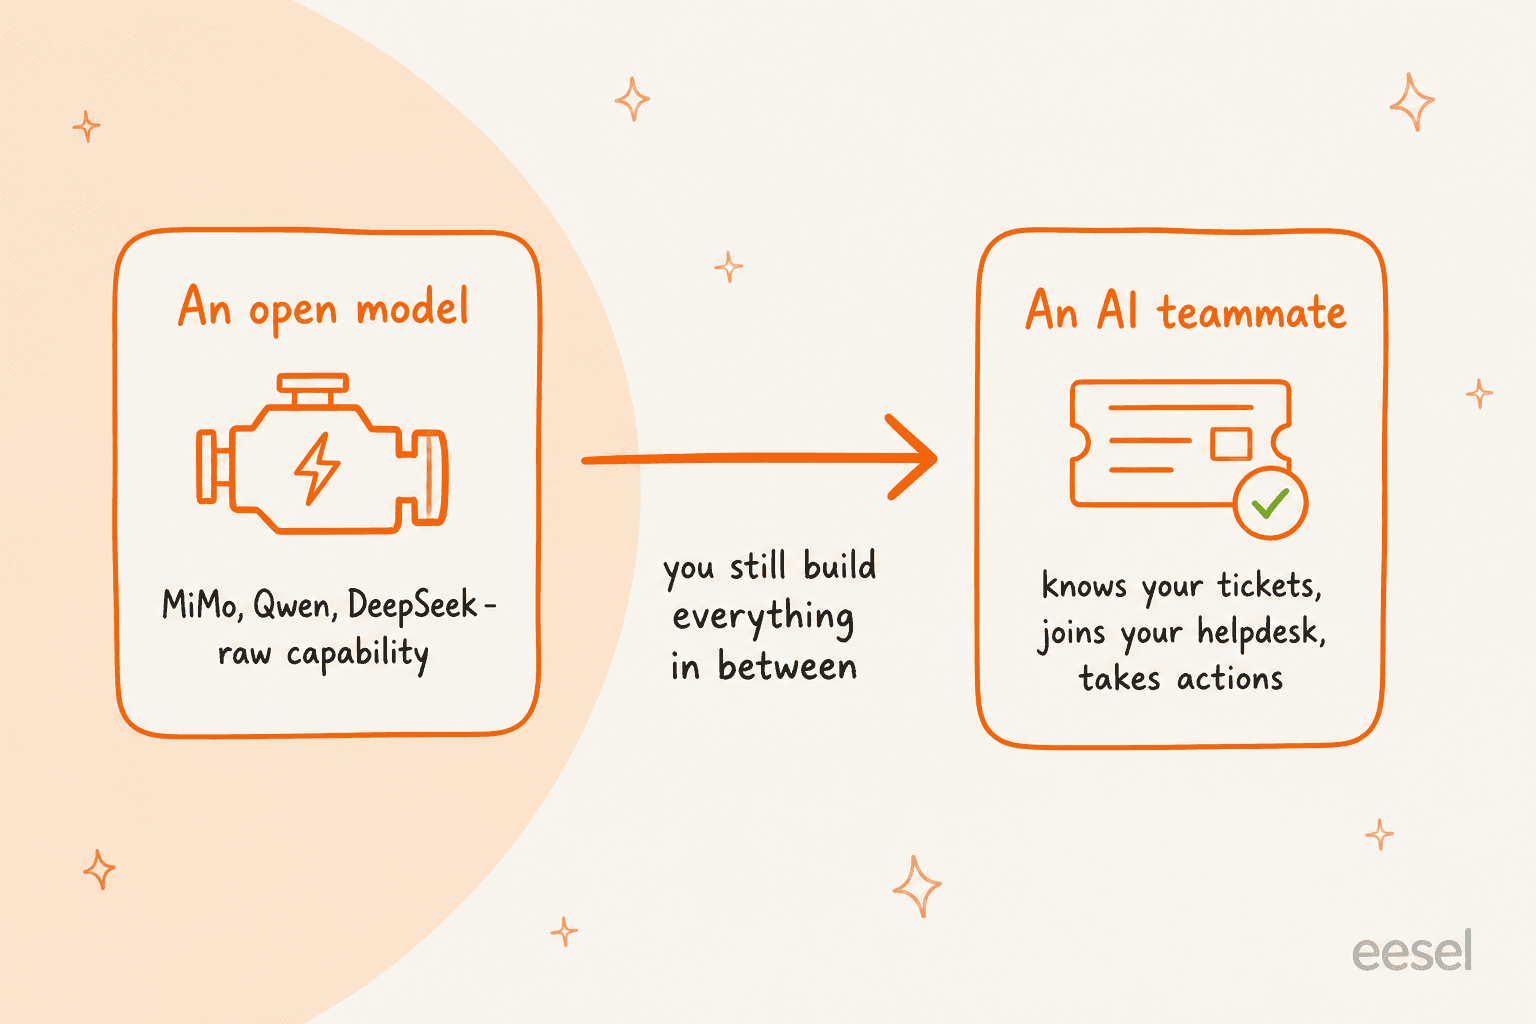
MiMo V2.6、DeepSeek、Qwen、Claude、GPT。そのどれもが、顧客からの質問に対して流暢で正しそうに聞こえる回答を書くことができます。それは2年前には恐ろしいことでした。今ではもう解決済みです。どのモデルも標準では行わないのは、本当の仕事です。あなた固有のヘルプセンターと過去のチケットを読み、もっともらしいでっち上げではなく実際の返金ポリシーに従い、注文を照会し、チケットにタグ付けしてルーティングし、いつエスカレーションすべきかを知り、実際の顧客に応答する前にテストされること。
その最後の点こそ、私が絶対に妥協しない部分です。私たちは、自信たっぷりに聞こえるモデルが実際のキューで間違った回答をするのを見てきました。だからこそ、すべてのロールアウトはまず過去のチケットに対してシミュレーションされます。AA指数の46という数字は、あなたの奇妙なエッジケースの返品ポリシーをモデルがどう扱うかについて何も語りません。過去5,000件のチケットに対するシミュレーションなら語ってくれます。サポート向けに特化してモデルを選んでいるなら、サポートチケット向け最良のAIモデルのガイドと、AIエージェント対人間エージェントのコストの内訳が、次に読むべき2本です。
eeselを試す
このレビューの要点は、MiMo V2.6のようなオープンモデルはインフラであり、仕事をこなす何かに変えるにはまだ手を加える必要がある素のケイパビリティだ、ということです。eeselは、モデルを実際に働くチームメイトへと変える層です。あなたはすぐに働けるAIヘルプデスクエージェントを雇い入れ、それが既に使っているヘルプデスク(Zendesk、Freshdesk、Gorgias、Help Scout、そして1000以上の連携)に接続し、過去のチケットとナレッジベースで学習し、モデル運用の手間なしに返信の下書きや送信を始めます。

差別化要因は、MiMo自身のベンチマークでは決して示せないものです。eeselエージェントが実際の顧客一人に応答する前に、あなたは実際のチケット履歴でそれをシミュレーションし、得られたはずの正確な解決率と回答内容を確認できます。そしてeeselはチームメイトプラットフォームであるため、同じアカウントでAIブログライターも動かせます。MiMoのターミナルとの親和性を気に入った開発者向けに、eeselも同じチームメイトを公開のCLI、API、MCPを通じて公開しているので、人間、スクリプト、コーディングエージェントのいずれもがターミナルから操作できます。
クレジットカードも営業電話も不要で無料で始められ、数分でチームメイトを稼働させられます。モデルは安くなりました。それを実際に仕事へと変えることこそ、今も興味深い部分です。
よくある質問
Xiaomi MiMo V2.6は優秀ですか?
Xiaomi MiMo V2.6の運用コストはいくらですか?
Xiaomi MiMo V2.6はKimi K3やDeepSeekより優れていますか?
Xiaomi MiMo V2.6を自前でホストできますか?
どのMiMo V2.6モデルを使うべきですか?
Xiaomi MiMo V2.6をカスタマーサポートに使うべきですか?
Xiaomi MiMo V2.6のベンチマークの透明性は本物ですか?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.