Xiaomi MiMo V2.6の正体
私は仕事として連携機能やAPIを構築しているので、この種のローンチに対する最初の反応は、マーケティングページを飛ばしてモデルカードを読むことだ。MiMo V2.6のカードはその内容に見合っている。
MiMo V2.6は、XiaomiのMiMoチームが2026年9月22日にリリースした、オープンウェイトでネイティブにオムニモーダルな言語モデルファミリーだ。「ネイティブにオムニモーダル」というのはこの文の中で実質的な意味を持っている。同じモデルがテキスト、画像、動画、音声を扱い、テキストモデルに後付けでビジョンアダプターを取り付けたものではない。ファミリーのすべてのチェックポイントが100万トークンのコンテキストウィンドウを備えている。
リリースのタグラインは「Scaling Reinforcement Learning Toward Self-Improvement」で、Xiaomiはシリーズ全体を再帰的な自己改善パスの一段階として位置づけている。検証可能で複雑なタスクにRLの計算量をスケールさせ、モデル自身に能力の限界を押し広げ続けさせるという発想だ。普段ならこの手の言い回しには思わず目を細めてしまうが、技術レポートにはそれを裏付ける具体的な手法が十分に書かれており、プレスリリースというよりエンジニアリングの記録として読める。
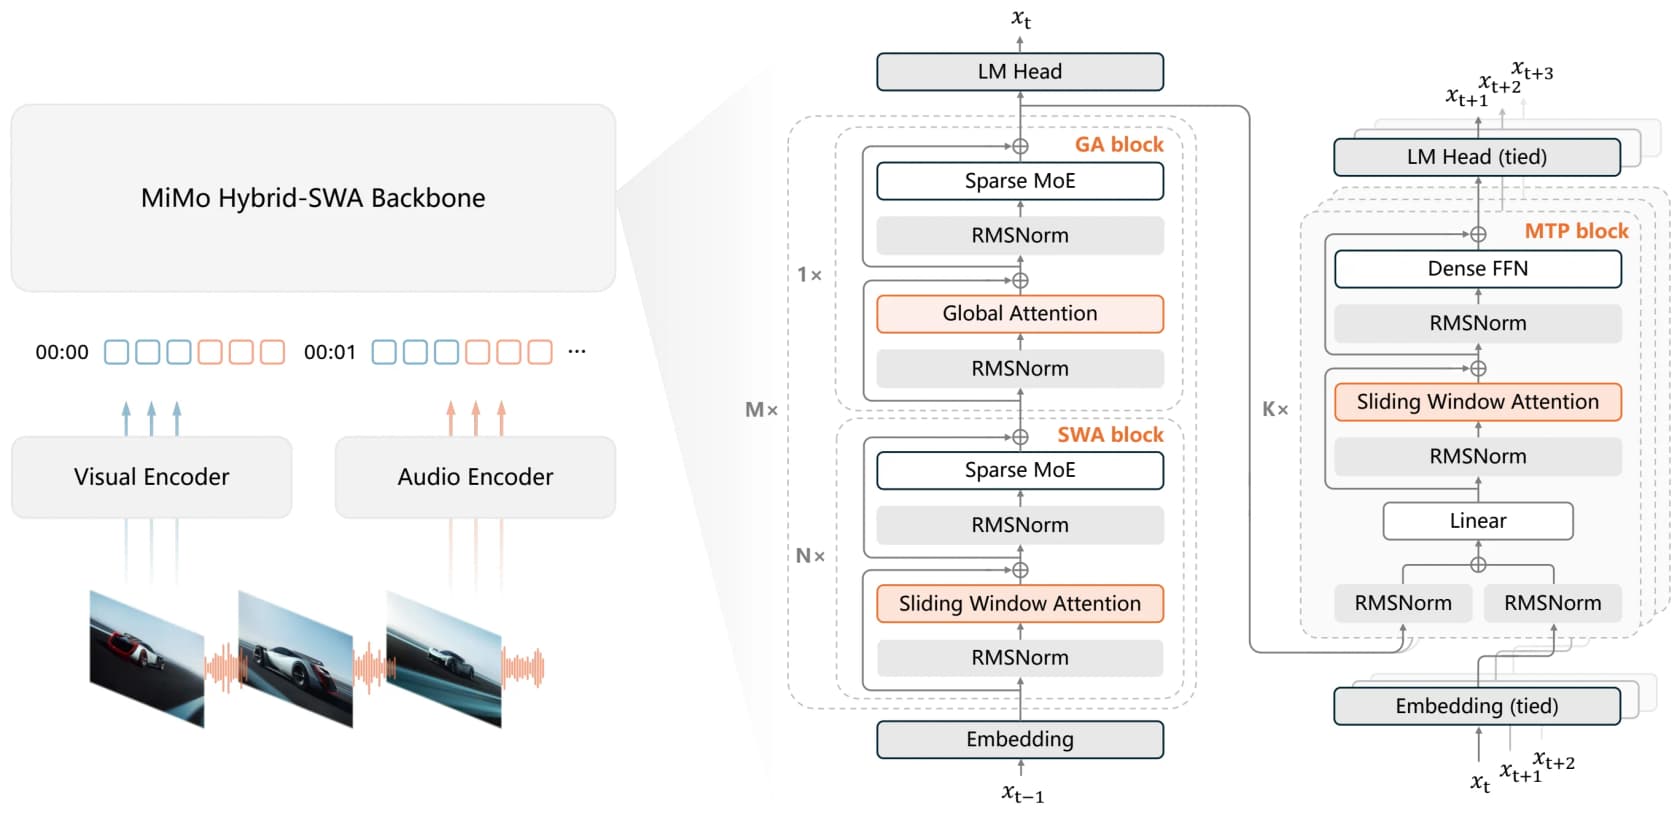
アーキテクチャを一段落で説明すると、Proはハイブリッドアテンションバックボーンを持つスパースMixture-of-Expertsモデルだ。局所的なスライディングウィンドウアテンション(ウィンドウ幅128)とグローバルアテンションを交互に配置した70層、トークンごとに8個が発火する384のルーティング済みエキスパート、6.81億パラメータのビジョンエンコーダー、専用の音声エンコーダー、そしてデコーディングを高速化するために1回のフォワードパスで複数トークンを予測する5層のマルチトークン予測デコーダーを備える。使う分にはこの詳細を気にする必要はないが、なぜ「1兆パラメータ」のモデルが安価に動かせるのかを説明してくれる。任意のトークンで実際にアクティブになっているのは、そのうちの420億パラメータだけなのだ。
Flashから1兆パラメータのProまで、モデルファミリーの全体像
MiMo V2.6は単一のモデルではなく、4つの異なる用途に向けた4つのチェックポイントだ。オンライン上の混乱の多くはここに起因しているので、明確に整理しておく価値がある。
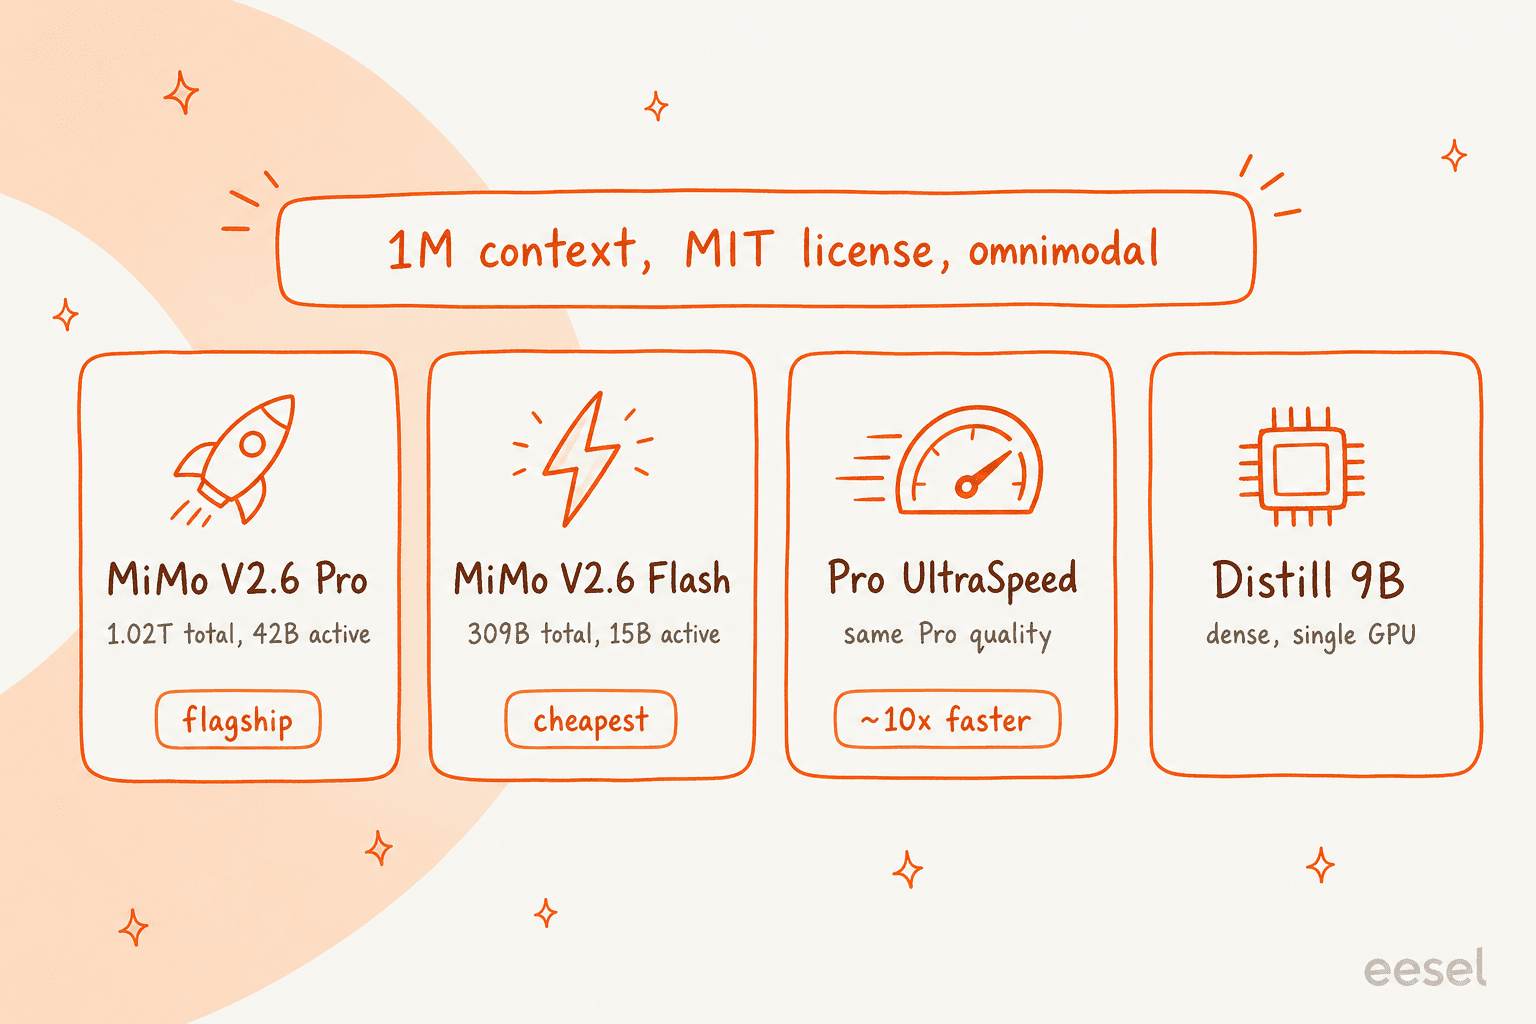
| モデル | アーキテクチャ | 合計パラメータ | アクティブパラメータ | コンテキスト | 最適な用途 |
|---|---|---|---|---|---|
| MiMo V2.6 Pro | スパースMoE | 1.02T | 42B | 1M | 最も要求が厳しい、長時間軸のエージェント作業 |
| MiMo V2.6 Flash | スパースMoE | 309B | 15B | 1M | 知性、速度、コストの最良のバランス |
| MiMo V2.6 Pro UltraSpeed | 同じProチェックポイントの高速版 | ~1T | 42B | 1M | 出力速度が必要な場面でのProレベルの品質 |
| MiMo V2.6 Distill-Qwen-9B | Dense(Qwen3.5-9BのSFT) | 9B | 9B | n/a | シングルGPUでのオープンなエージェント系RL研究 |
いくつか触れておくべき点がある。ProはXiaomi史上最も高性能なモデルと位置づけられている。Flashは、ほとんどのワークロードが求めるバランスを実現しているため、実際に多くの人が選ぶことになるモデルだ。UltraSpeedは同じProチェックポイントを約10倍の出力速度で提供するもので(Xiaomiのブログでは最大20倍とも主張している)、応答をストリーミングで待っているユーザーがいる場合には大きな違いになる。そして9B蒸留版は、MiMo生成データでQwen3.5-9Bを教師ありファインチューニングしたもので、本番用モデルというよりオープンな研究の出発点として公開されている。
ここでの本当の見どころは世代間の飛躍だ。前世代のフラッグシップであるMiMo V2.5 Proは、DeepSWE v1.1コーディングベンチマークで19.0点だった。V2.6 Proは同じボードで71.9点を記録する。Terminal Bench 4.0では1.5から34.9に伸びた。これは漸進的な向上ではなく、研究所がトレーニング手法を変えたときにしか見られない類の飛躍であり、Xiaomiによればまさにそれが起きたという。
Xiaomiが強調するベンチマークと、そうでないもの
どのモデルローンチも自分に都合の良いグラフを選び出すものなので、私は直接モデルカードの評価テーブルを確認した。そこではMiMo V2.6がClaude Opus 5、GPT-5.6 Sol、Claude Fable 5と比較されている。以下が正直な内訳だ。
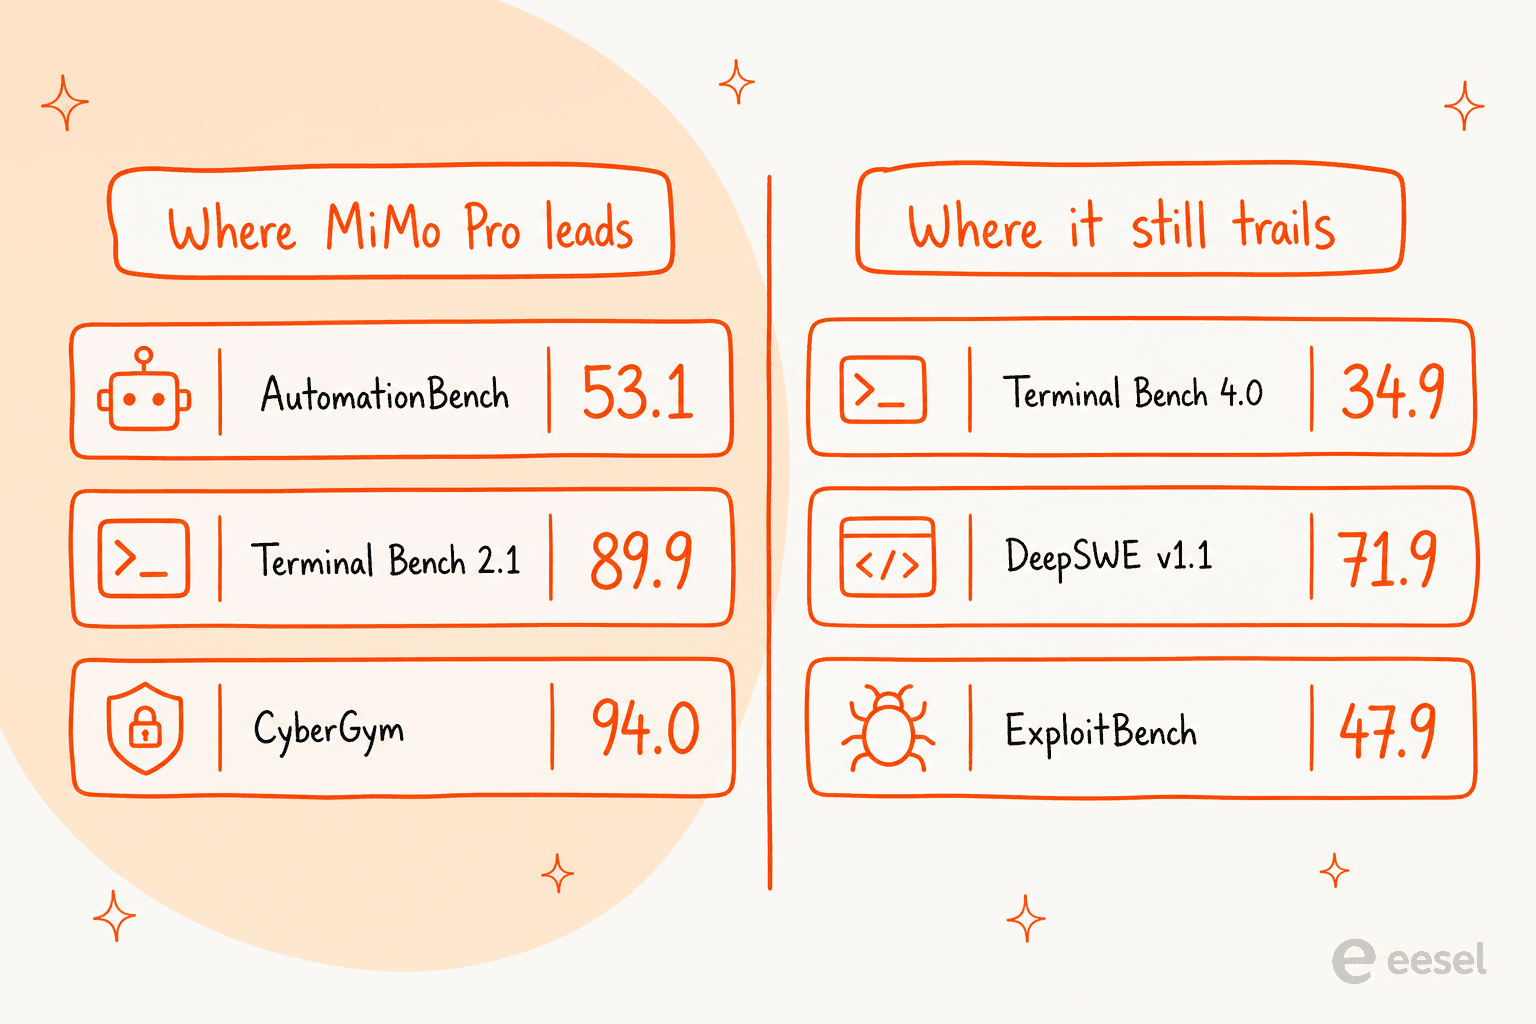
Xiaomiの数値上、Proがクローズドなトップクラスを明確にリードしている領域:
| ベンチマーク | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| AutomationBench v1.0.6 | 53.1 | 50.3 | 45.8 |
| Terminal Bench 2.1 | 89.9 | 89.1 | 88.8 |
| Agents' Last Exam | 31.6 | 31.6 | 30.8 |
| MiMo Visual Coding | 72.3 | 70.0 | 73.4 |
そして後れを取っている領域。Xiaomiはこれを勝ちスコアのすぐ隣に律儀に公表している。
| ベンチマーク | MiMo V2.6 Pro | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 37.0 | 25.0 |
| Terminal Bench 4.0 | 34.9 | 49.0 | 39.9 |
| ExploitBench | 47.9 | 70.0 | 78.5 |
このパターンは一貫していて、私が思うに信頼できるものだ。MiMo V2.6 Proは一般的なエージェント系タスクやツール利用の分野ではトップクラスと肩を並べており、最も難しい長時間軸のコーディングやエクスプロイト系ベンチマークでは後れを取っている。Xiaomiがローンチブログでの比較対象をGPT-6 Astra、DeepSeek V4.1 Flash、GLM 5.3にまで広げても、同じ構図は変わらなかった。ProはAutomationBenchとTerminal Bench 2.1ではトップ集団の近くに位置し、Terminal Bench 4.0(59.6)とExploitGymではGPT-6 Astraに後れを取っている。
ひとつだけ注目に値する数値がある。ProはCyberGymで94.0という際立ったスコアを記録している(Flashはさらに高く95.1)。前世代のV2.5 Proは40.0だった。サイバーセキュリティは明らかにXiaomiが力を入れて訓練した領域だが、より対抗的なExploitBenchはもっと控えめな結果を示しているため、CyberGymの結果は確定的というより印象的なものとして扱うべきだろう。
どのボード単体よりも重要な、独立系の指標
単体のベンチマークにはノイズが多い。私が実際に注目しているのはArtificial Analysisの集約指標だ。多くの評価を1つの比較可能なスコアにまとめ、なおかつそれをコストに対してプロットしてくれる点が重要になる。
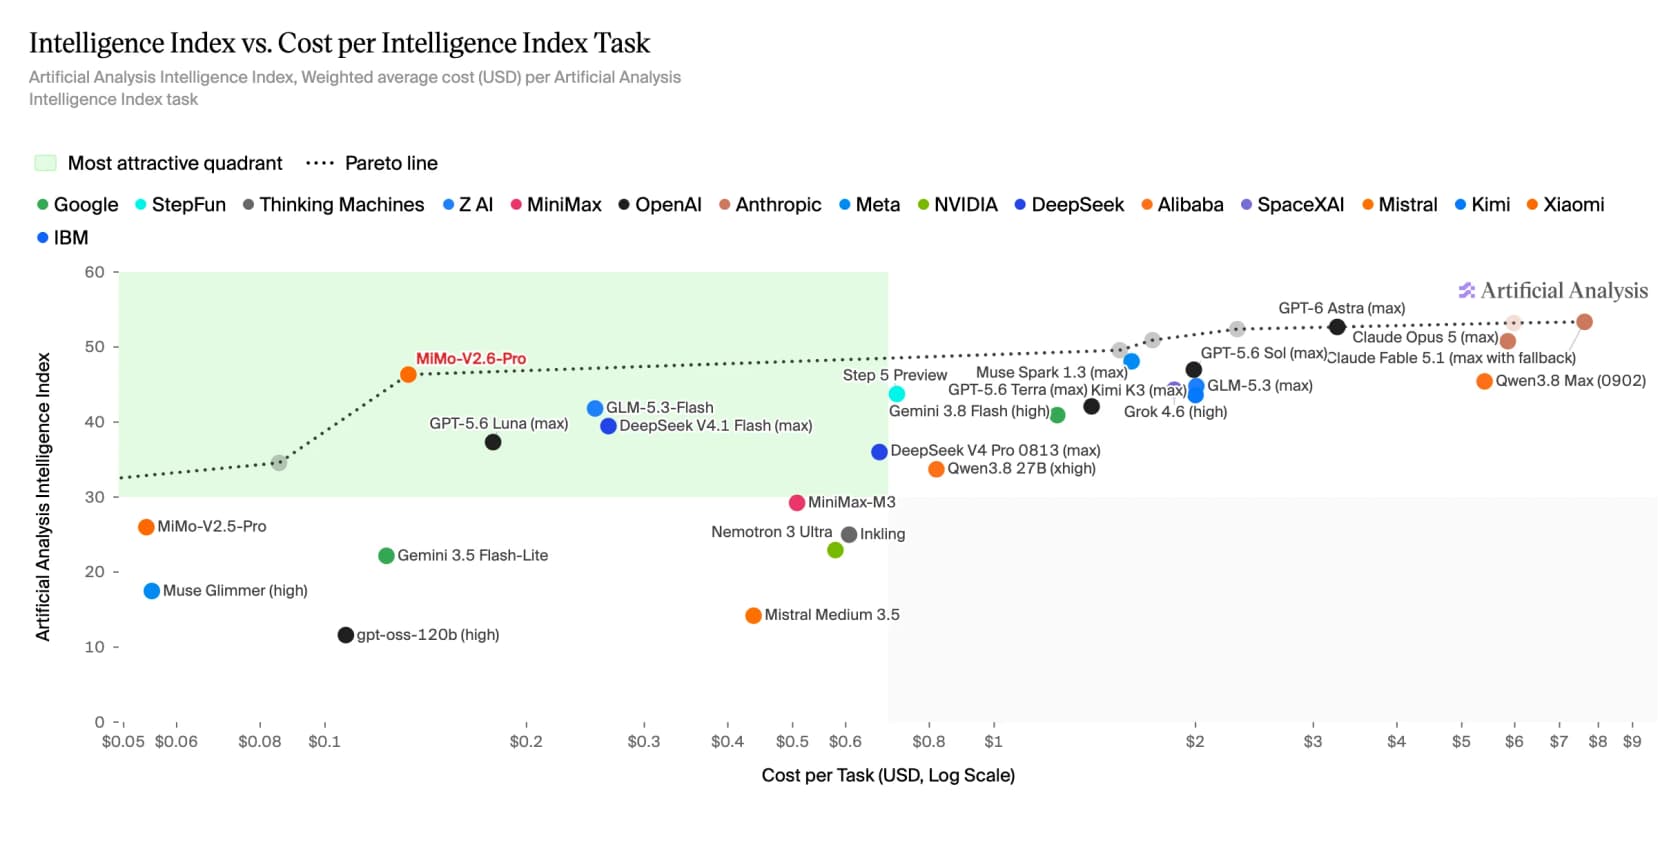
MiMo V2.6 ProはIntelligence Indexで46に達し、このボードではオープンウェイトモデルとしてトップに立っている。これはArtificial Analysisが文字通り「最も魅力的な象限」と呼ぶ位置だ。クローズドなトップクラスモデルは純粋な知性では上回るスコアを出す(GPT-6 Astra、Opus 5、Fable 5.1はいずれも50台前半から半ばに位置する)が、その代償はタスクあたり3〜8ドルだ。MiMoは約0.13ドルで46を達成している。
この価格対知性の比率こそが最大の売り文句であり、だからこそ今回のローンチは多くの神経を逆なでした。あるコメント投稿者がローンチスレッドで述べたように、このモデルは前世代と同じ価格を維持しながら「AAの知性対速度でもっとも緑の象限に着地した」。トップクラスの知性の85〜90%を、その40分の1のコストで手に入れられるなら、多くのユースケースで計算式が変わってくる。
実際にどう動かすか:ウェイト、API、価格
ここが私が最も気にする部分だ。ベンチマークスコアがどれだけ良くても、モデルを自分のスタックに組み込めなければ意味がない。MiMo V2.6は、自前でホストするにせよ、単にエンドポイントを叩くにせよ、うれしいほどアクセスしやすい。
ウェイトはMITライセンスでオープン化されており、これ以上ないほど緩やかなライセンスだ(商用利用可、条件はほぼなし)。Pro、Flash、9B蒸留版はHugging FaceとModelScopeからダウンロードでき、XiaomiはFP8チェックポイントも提供しているため、フル精度を強制されることはない。
ハードウェアについては、Proが何を必要とするかを現実的に見ておく必要がある。モデルカード自身のローンチコマンドは、Proを16-wayテンソル並列の2ノードで動かしている。つまりこれはマルチノードGPUクラスタであり、余っているワークステーションで立ち上げられるようなものではない。Flashは単一の8GPUノードでずっと扱いやすく、9B蒸留版は単一GPUで動作し、llama.cpp、LM Studio、Ollama向けのコミュニティ製GGUF量子化版もすでに用意されている。カスタムAIモデルについての我々の記事を読んでいた読者なら、ここまでは驚かないはずだ。オープンウェイトは無料でも、運用コストは現実のものだ。
インフラをまったく持ちたくないなら、MiMo V2.6はXiaomi自身のAPIプラットフォーム、MiMo StudioとDesktop、そしてOpenRouterでホストされている。以下はローンチ週に確認したOpenRouterの100万トークンあたりの価格だ。
| モデル | 入力 / 1M | 出力 / 1M | コンテキスト |
|---|---|---|---|
| MiMo V2.6 Flash | $0.14 | $0.28 | 1M |
| MiMo V2.6 Pro | $0.435 | $0.87 | 1M |
| MiMo V2.6 Pro UltraSpeed | $4.35 | $8.70 | 1M |
注目すべき点が2つある。Flashは入力0.14ドル/出力0.28ドルで、1Mコンテキストのオムニモーダルモデルとしては安い。そしてUltraSpeedは速度も価格もProのちょうど10倍で、より優れたモデルというよりレイテンシに敏感な作業向けの意図的なプレミアムだ。ほとんどのチームにとってFlashが妥当なデフォルトであり、Proはタスクが本当にそれを必要とするときにエスカレーションする先になる。
実際に使った人々の声
ベンチマークはXiaomiの語る物語だ。私はユーザーの物語が知りたかったので、ローンチ後の議論を読み込んだ。すると、支配的な反応はスコアについてのものではまったくなかった。Xiaomiがどれほどオープンにこのモデルを訓練したか、という点についてのものだった。
"I really like how transparent they've been about the training of this model. The realtime dashboard they shared during training was an incredible learning and teaching tool for me, and they've been unusually comprehensive in sharing details about their methodology... and benchmark scores (even the stuff they didn't do well on)."

"The best thing they did is being open about all the setbacks they had to deal with. They logged every restart with a reason, talked about dropping a cyber dataset after it degraded coding benchmarks. Also published real time training loss, benchmark scores after every checkpoint and running cost estimates."
コーディングスコアを悪化させたという理由でサイバー系データセットを取り除いたというこの詳細は、研究所が公に認めることがほとんどない類の話であり、懐疑派の間でさえ今回のローンチが好意を得た大きな理由になっている。スレッドの中で最も鋭い技術的な指摘は、自らボードを集計した長年のMiMoユーザーから寄せられた。
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!! Good to see they also kept the price the same, and landed in the greenest quadrant of the intelligence vs speed of AA."
賞賛ばかりではなかった。中国発の強力なオープンモデルにはいつも付きまとう懸念、いわゆる「ベンチマックス」も繰り返し語られた。優れたスコアの一方で、実務では期待外れになるという懸念だ。あるコメント投稿者は前世代について率直にこう述べている。
"No chinese lab has caught up yet. They've tried to fake it by distilling and overfitting on benchmarks to make their models look better than they are, the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."
これに対する反論は、すでに本番でこのラインを使っている人々から出された。あるソフトウェアエンジニアの価値計算についてのコメントは、私が今も考え続けているものだ。
"I been using MiMo-V2.5 to do most of my work as software engineer... I been VERY happy with ROI. The model is very powerful!... The cost is unbelievably low, and the quality of intelligence I get is equivalent to when I was working mostly with Anthropic models (late last year/early this year)... but when I add cost of M-token in the ROI math, Jeez! MiMo is an order of magnitude better."
なお、この最後の引用はV2.5についてのものであり、これについては何人もが難しいタスクでは「速いがバカ」だとも評していた。したがってV2.6の本当のテストは、チャート上だけでなく日々の利用でこのギャップを埋められるかどうかだ。Xでは、今回のローンチは主に同日リリースのGrok 4.7への当てつけとして受け止められ、反応は「Grok 4.7より優れている」から、より慎重な「まずは実際の使用でのパフォーマンスを見てから判断しよう」まで幅があった。
MiMo V2.6がオープンモデル競争の中で占める位置
一歩引いてみると、MiMo V2.6は無視しづらくなりつつあるトレンドのもう一つのデータポイントにすぎない。中国の研究所発のオープンウェイトモデルが、はるかに安価なハードウェアで動きながら、トップクラスに次々と近づいているというトレンドだ。DeepSeek V4.1 Flash、GLM 5.3、Qwen 3.8 Max、そして今回のMiMo V2.6は、かつてクローズドモデルだけのものだった知性帯で互いに競い合っている。
ベンチマークの裏には本物の戦略的な推進力があり、あるコメント投稿者はそれをうまく言い表していた。
"Chinese models are increasingly closer to the frontier, while being able to run on much cheaper hardware than what US frontier models run on... the rest of the world is going to see the risks and the availability of good enough open weight models for their purposes and be more likely to lean in favor of self-hosted Chinese models or local inference clouds."
これこそが本当の競争の物語だ。「MiMoがあるボードでOpusを上回るかどうか」ではなく、「自前のハードウェアで、クローズドなトップクラスモデルが贅沢に思えるような価格で、十分な知性を得られるかどうか」という話だ。多くのチームにとって、その答えはもう「イエス」になっている。より広い視野で選択肢を見たいなら、最高のオープンソースAIエージェントのまとめ記事が次に読むのに適しているし、DeepSeekのレビューとKimi K3のレビューでは、最も近いオープン系のライバルを取り上げている。
サポートキューにAIを導入するならこれが意味すること
ここで自分自身の偏りについて正直に言わなければならない。私はここ数年、実際に稼働するサポートキューにAIを導入する手伝いをしてきた。そしてMiMo V2.6のローンチは、私たちが苦労して学んだことを裏付けている。モデルはもはやボトルネックではない。
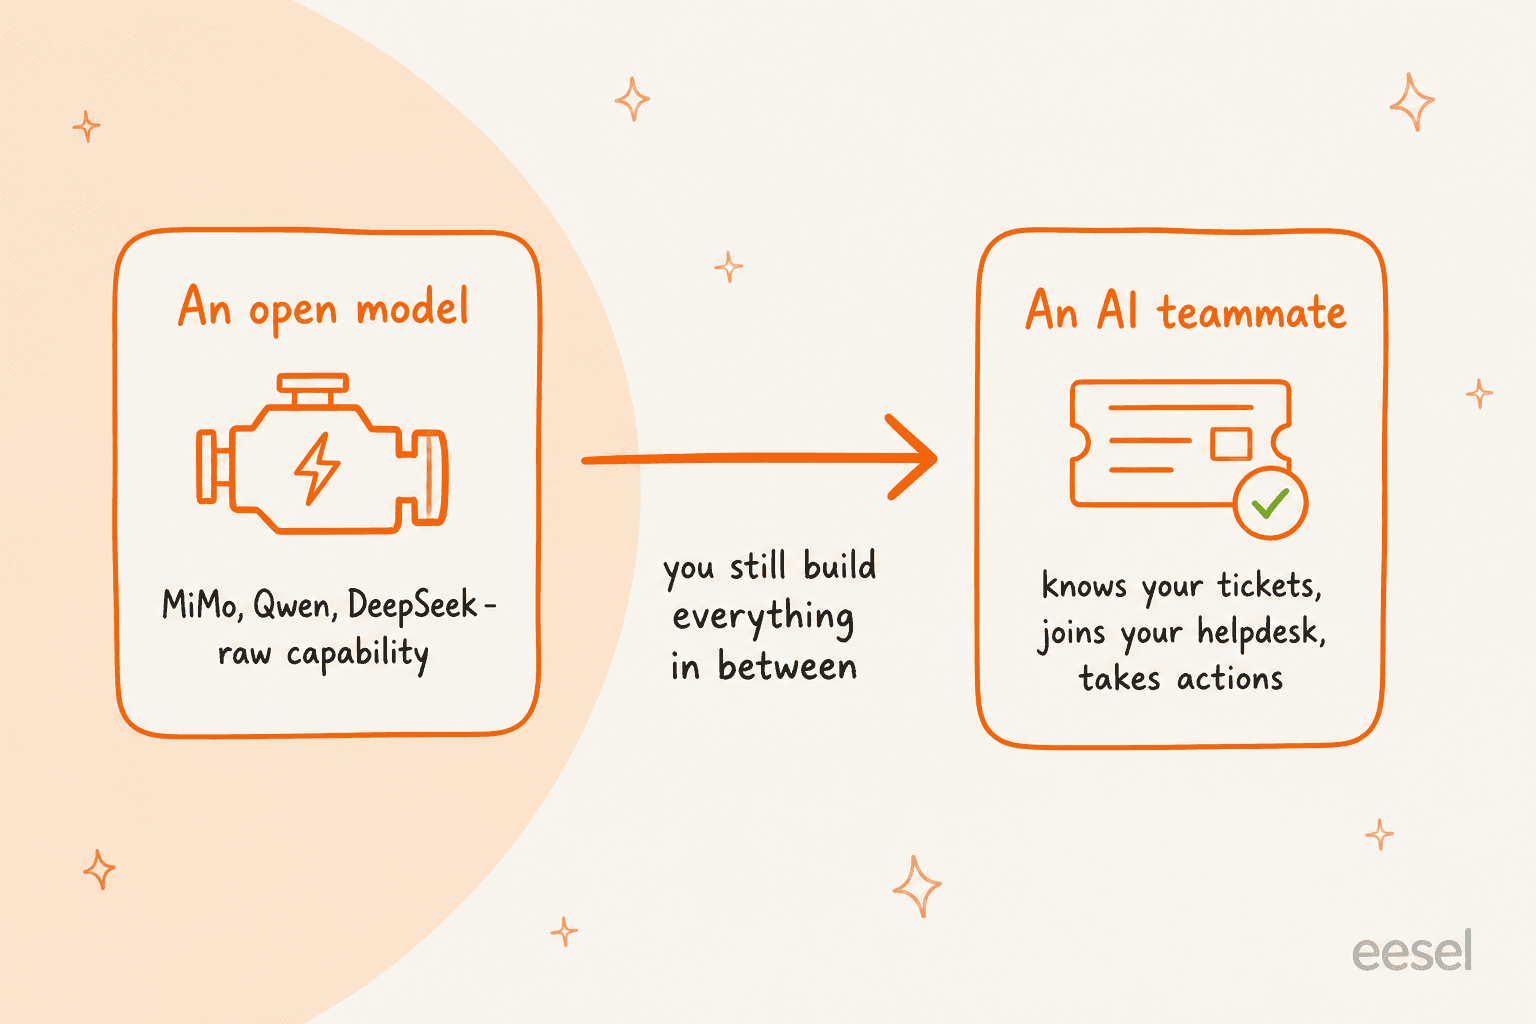
MiMo V2.6、DeepSeek、Qwen、Claude、GPT。どれも顧客の質問に対して流暢で正しそうに聞こえる回答を書ける。それが数年前は怖い部分だった。それはもう解決済みだ。どのモデルも標準では行わないのは、本当の仕事の部分だ。あなた固有のヘルプセンターや過去のチケットを読み、もっともらしいでっち上げのポリシーではなく実際の返金ポリシーに従い、注文を調べ、チケットにタグを付けてルーティングし、いつ人間にエスカレーションすべきかを把握し、そして何より、実際の顧客に応答する前にテストされること。
最後の点だけは妥協するつもりがない。自信ありげに聞こえるモデルが実際のキューで誤った回答をするのを私たちは何度も見てきた。だからこそ、私たちが行うすべてのロールアウトは、まず過去のチケットに対してシミュレーションされる。これにより、実際の会話に触れる前に、過去数千件の自社の会話をどう処理していたかを確認できる。AAインデックスでの46というベンチマークスコアは、あなたの独特な返品ポリシーの微妙なケースをモデルがどう扱うかについては何も教えてくれない。過去5,000件のチケットに対するシミュレーションなら、それを教えてくれる。
だからMiMo V2.6に興奮しているなら(そうあるべきだ、優れたエンジンなのだから)、正しい問いは「どのモデルか」ではなく「モデルを何が包んでいるか」だ。モデルはもはやコモディティになった。その周囲のシステムこそが製品なのだ。
eeselを試す
この記事全体の要点は、MiMo V2.6のようなオープンモデルはインフラであり、あなたが仕事をこなす何かに変えなければならない生の能力にすぎないということだ。eeselは、モデルを実際に機能するチームメイトへと変える層だ。すでに使っているヘルプデスク(Zendesk、Freshdesk、Gorgias、Help Scout、1000以上の連携)に接続し、過去のチケットとヘルプセンターで学習し、モデル運用の手間なしに返信の下書きや送信を始める、すぐに使えるAIヘルプデスクエージェントを雇うことができる。

その差別化要因こそ、MiMo自身のベンチマークでは得られないものだ。eeselのエージェントが実際の顧客に一件でも応答する前に、実際のチケット履歴に対してシミュレーションを行い、正確な解決率と得られたであろう応答内容を確認できる。そしてeeselはチームメイトプラットフォームであるため、同じアカウントでAIブログライターも動かせる。MiMoがエンジニアリングにもたらすものを気に入ったなら、執筆の面にもチームメイトがいるわけだ。開発者向けには、eeselは同じチームメイトを公開のCLI、API、MCPとして提供しており、人間、スクリプト、コーディングエージェントのいずれもがターミナルから操作できる。
クレジットカードも営業電話も不要で無料で始められ、数分でチームメイトを稼働させられる。モデルは安くなった。それを実際に仕事をこなす存在にすることこそが、今も変わらず興味深い部分だ。
よくある質問
Xiaomi MiMo V2.6とは?
Xiaomi MiMo V2.6の料金は?
Xiaomi MiMo V2.6はDeepSeekやKimi K3より優れている?
Xiaomi MiMo V2.6を自前でホストできる?
カスタマーサポートにXiaomi MiMo V2.6を使うべき?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.