2026年版 Xiaomi MiMo V2.6の代替8選

Rama Adi Nugraha

Katelin Teen
最終更新 September 23, 2026
MiMo V2.6の代替を探す理由
まずはMiMoに公平でありたい。注目を集めるだけのことはあるからだ。1兆パラメータのProモデルは、あるコメント投稿者が手作業で集計した15のベンチマークのうち14でKimi K3(パラメータ2.8兆)を上回り、しかもサイズはその何分の一かにすぎない。XiaomiはV2.5から価格を据え置いた。MITライセンスで、ネイティブにオムニモーダル、1Mトークンのコンテキストを備えている。コミュニティの反応は異例なほど好意的で、スコアよりも透明性に対するものが多かった。
ではなぜ他も検討すべきなのか。いくつか正直な理由がある。
- ベンチマークの優位性は、最も重要な部分で最も小さい。 Terminal Bench 4.0では、MiMo-V2.6-Proは34.9で、GPT-6 Astraの59.6やClaude Opus 5の49.0を大きく下回る。最難関の実務的なコーディングボードでは、MiMoは安価にオープン勢を牽引するが、トップクラスモデルには及ばない。あなたの仕事がそうしたタスクに依存しているなら、トップクラスモデルへの追加出費は元が取れるかもしれない。
- データレジデンシーは現実的な制約だ。 MiMoのホスト型APIは中国法の下で運用され、Proチェックポイントの自前ホスティングには2ノード・16GPUのマシンが必要になる。規制対象データや顧客データにとって、これは些細な話ではなく、本物の障壁だ。
- 「ベンチマックス」への懐疑論。 コミュニティで繰り返される懸念は、インデックスでの優位性が本番コードに触れた途端に消えてしまうというものだ。あるHacker Newsのコメント投稿者は、率直にこう述べている。
"No chinese lab has caught up yet... the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them."

これは一つの見方であり、逆の主張もしっかり根拠がある(安価な中国製モデルと監督役のトップクラスモデルを組み合わせれば、高価な米国製モデルよりもROIで勝るというエンジニアの報告も多い)。しかし、この意見の対立自体が、代替を知っておくべき理由になる。
これらの代替をどう選んだか
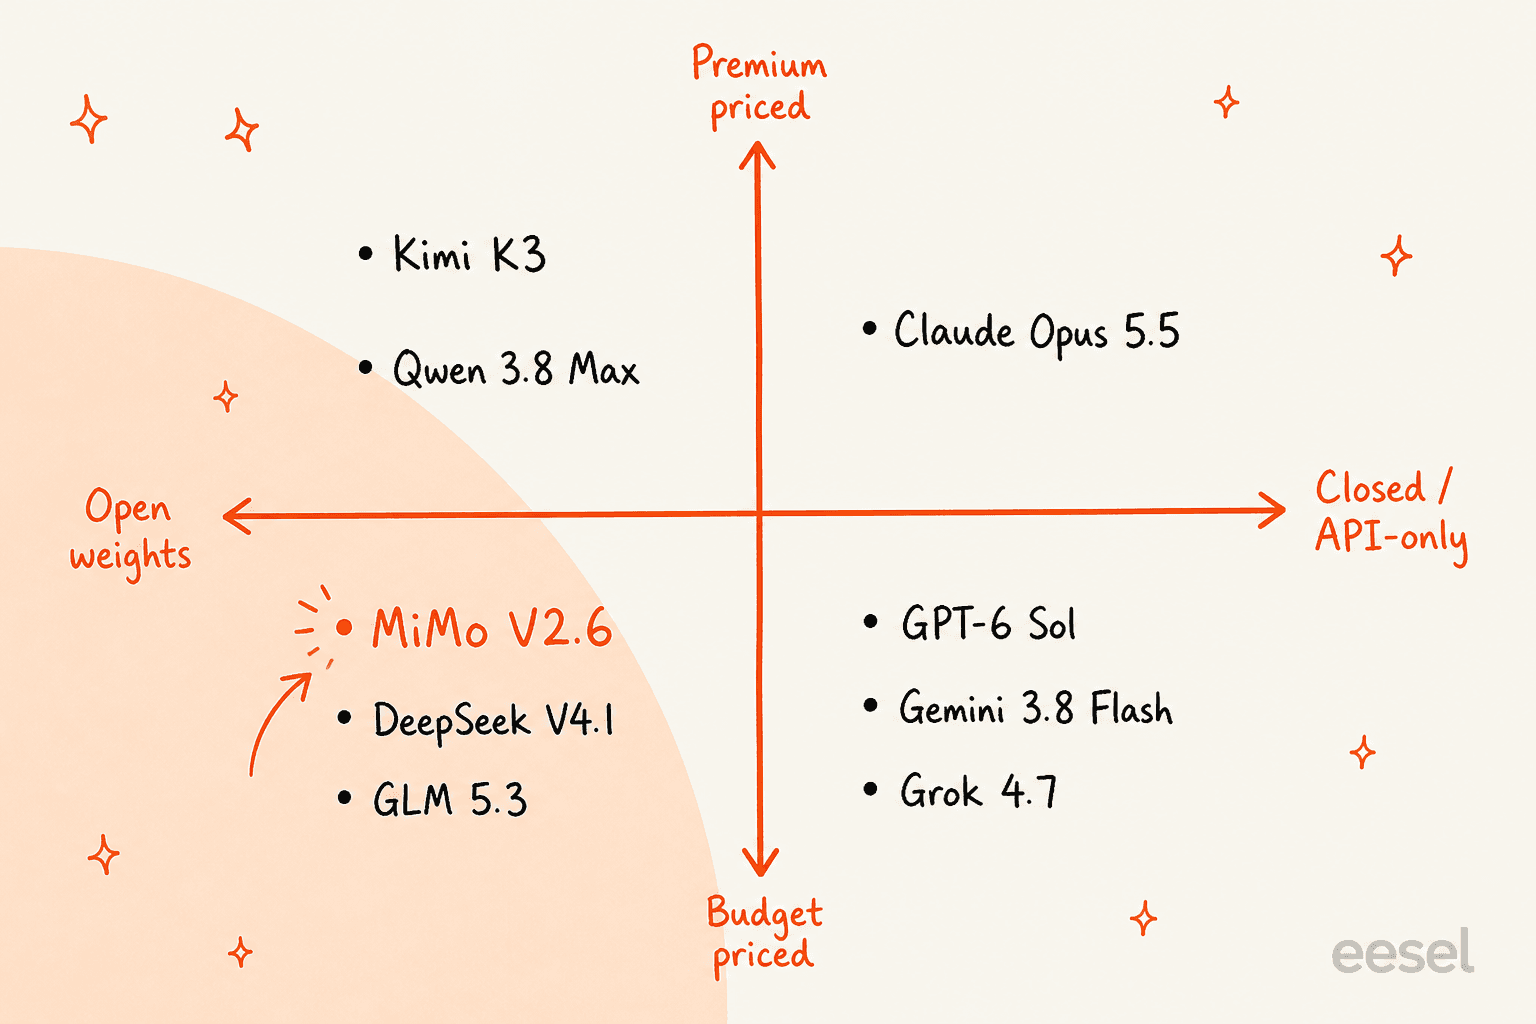
実際に提供されていて、実在のチームがMiMo V2.6と並べて検討するであろうモデルにショートリストを絞り込んだ。そのために3つのフィルターを使った。現行であること(2026年の直近数か月にローンチまたは価格改定されたもの)、比較可能であること(MiMoが測定されるのと同じベンチマーク表に登場すること)、そして独自性があること(それぞれ異なる軸で勝っており、同じトレードオフのバリエーション8つにならないこと)。
各数値については一次情報源に依拠した。ベンダー自身のモデルカードや価格ページ、OpenRouterのリスティング、そして知性対コストを中立的に読み取るためのArtificial Analysisインデックスだ。コミュニティに鋭く検証可能な指摘があった場合は、パーマリンク付きで引用した。以下の価格は、特に注記がない限り100万トークンあたりのものだ。
MiMo V2.6代替モデル一覧
| モデル | 種類 | パラメータ | コンテキスト | 価格 /1M(入力 / 出力) | AA Intelligence | 最適な用途 |
|---|---|---|---|---|---|---|
| MiMo V2.6 Pro | オープン(MIT) | 1.02T / アクティブ42B | 1M | $0.435 / $0.87 | 46 | 最安のトップクラスオープンモデル |
| DeepSeek V4.1 | オープン(MIT) | 552B MoE | 1M | $0.15 / $0.60(オフピーク) | 主力クラス | ツールを使う安価な主力モデル |
| Kimi K3 | オープン | 2.8T / アクティブ104B | 1M | $3 / $15 | 57 | 最大のオープンモデル |
| Qwen 3.8 Max | オープン(ホスト型) | 2.4T / アクティブ95B | 1M | $2 / $6 | 58 | ローカル向きの小型バリアント |
| GLM 5.3 Flash | オープン | 320B / アクティブ18B | 1M | $0.15 / $0.50 | 57 | 実コードに強い安価なオープンモデル |
| Claude Opus 5.5 | クローズド | 非公開 | 1M | $5 / $25 | 58 | 最高水準の推論力 |
| GPT-6 Sol | クローズド | 非公開 | 1.05M | $2 / $10 | 48 | タスク完了あたり最安 |
| Gemini 3.8 Flash | クローズド | 非公開 | 1M | $0.75 / $3.75 | 59 | 巨大なマルチモーダルコンテキスト |
| Grok 4.7 | クローズド | より大きなベースモデル | 500K | $2 / $6 | 46 | 大量のエージェントループ、X のライブデータ |
1. DeepSeek V4.1
最適な用途: 実績ある最安の有能なオープンモデルを求めるチーム。
DeepSeek V4.1 Flashは2026年9月10日にGAとなり、DeepSeekは旧V4 ProをこのモデルへFlash料金でルーティングする形で廃止した。これは中国製オープンモデルのリファレンスと言える存在で、MiMoはその逆ではなく、しばしば「この安価なバックアップ」として位置づけられる。アーキテクチャは本当に新規性がある。552Bパラメータの因果的エンコーダ・デコーダで、入力には8B、出力には16Bのアクティブパラメータを使い、KVキャッシュは前世代の約4分の1に小型化されている。ウェイトはネイティブなビジョン機能を備えたMITライセンスだ。
DeepSeek自身のテーブルでは、V4.1はTerminal-Bench 2.1(90.6)、DeepSWE(74.2)、ツール利用ありのHLE(63.9、Opus 5をわずかに上回る)でトップに立つ。コミュニティのベンチマークでは250〜400トークン/秒を計測しており、多くの人が試した中で最速の選択肢としてGemini Flashを追い抜いている。
長所:
- 最安の本格的なオープンモデル。オフピーク・キャッシュミス時の入力は0.15ドル、出力は0.60ドル(100万トークンあたり)で、オフピーク時間帯は米国・EUの営業時間の大半をカバーする。
- MITウェイト、ネイティブなマルチモーダルビジョン、1Mコンテキスト。
- 実績があり広く導入されている主力モデルで、発表初週のリリースではない。
短所:
- 生の推論力が弱点だ。HLE 36.8はGPT-6 SolやOpus 5を下回る。これはツール利用者であって、推論のチャンピオンではない。
- ピーク時間帯(UTC 01:00〜04:00および06:00〜10:00)は価格が倍になるため、コストは動く標的だ。
- 有料APIの利用規約はトレーニング利用について許可的ではなく沈黙しており、データは中国国内で処理されるため、顧客データを流す前によく考えたほうがよい。
結論: MiMoの価格に惹かれたのであれば、DeepSeek V4.1が最も直接的な乗り換え先であり、成熟度の面でもおそらくより安全な賭けだ。ツール多用の作業向けに安価なエンジンが欲しく、データレジデンシーの留保点と付き合っていけるなら選ぶ価値がある。
2. Kimi K3
最適な用途: 市場最大のオープンモデルが欲しく、その上限のために対価を払う意思があるチーム。
MoonshotのKimi K3は2026年7月16日、2.8Tパラメータ・アクティブ104BのモデルとしてローンチされたMoonshotは期日通りにオープンウェイトを公開しており、これはすべてのラボが行うことではない。Artificial Analysisインデックスで57点を獲得し、全体4位に相当する好成績で、サイズ対性能の議論をする際にMiMoと最も頻繁に比較されるモデルでもある。
問題は、K3が「大きい=安い、ではない」という教訓が牙を剥く場所だという点だ。そのAPIは100万トークンあたり入力3ドル・出力15ドルと、中位クラスのクローズドモデルと同じ価格帯であり、どのレベルでも推論をオフにできない。GodelNumberingによる次の集計は、まさにその緊張関係を捉えているため引用する価値がある。
"Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!"
長所:
- オープンウェイト、1Mコンテキスト、ネイティブビジョン、強力な汎用知性(AAインデックス57)。
- MiMoが手薄な高難度の推論で、本当に高い能力を発揮する。
短所:
- 出力価格は100万トークンあたり15ドルで、MiMoの約50倍。Claude Sonnetクラスの価格帯とほぼ同水準だ。
- 推論は常時オンで、下げることのできないレイテンシコストになっている。
- ウェイトは1,561GBあり、自前ホスティングは本格的なハードウェアプロジェクトになる。
結論: K3は、最大限の能力が欲しく、サイズをいとわない場合に手を伸ばすオープンモデルだが、純粋な知性単価ではMiMoもDeepSeekも上回る。上限が請求額より重要な場合にK3を選ぼう。
3. Qwen 3.8 Max
最適な用途: 本当にローカル向きな小型バリアントを備えたオープンモデルファミリーが欲しいチーム。
AlibabaのQwen 3.8 Maxは2026年8月2日にGAとなった、2.4T/アクティブ95BのMoEで、1Mコンテキストを備える。Artificial Analysisのボードでは58点で6位につけ、LMArenaでも強い(テキスト5位、ビジョン2位)。API価格はQwen Cloud経由で100万トークンあたり入力2ドル・出力6ドルだ。
Qwenが繰り返しMiMoの代替候補に挙がる理由は、フラッグシップだけでなくファミリー全体にある。ローカル推論でコミュニティに人気なのはより小型のQwenモデルで、あるコメント投稿者はそれを「crazy good for how small it is」と評し、ワークステーションクラスのマシンで無期限に動かせるとしている。ホスト型のMaxウェイトは公開されたが非Apacheライセンスの下にあり、許容度の高い真にローカルな選択肢はより小さなQwen3.8-27B(Apache 2.0)だ。
長所:
- 強力な総合知性(AA 58)と優れた人間評価スコア。
- ラップトップ向けの小型モデルからトップクラスに近いフラッグシップまで、本物のサイズのラダーがあり、ローカル実行用に許容度の高いライセンスの小型モデルも含まれる。
- 2ドル/6ドルという理にかなったホスト型価格。
短所:
- ホスト型MaxとオープンなベースはFeatureが同等ではない(ビジョン、非思考モード、デフォルトの1Mコンテキストはホスト版限定)。
- 独自のコーディングハーネスは出力を65Kトークンに制限しており、標準では131Kという本来の上限を求めることはない。
- 自動化された複合スコアと人間の評価は異なる方向を示しており、単一の数値による評価を鵜呑みにしてはいけない。
結論: Qwen 3.8 Maxは、ラップトップ向けの小型モデルからトップクラスに近いフラッグシップまで成長していけるオープンファミリーが欲しい場合の選択肢だ。「ローカル」が絶対条件であれば、Qwenはここで挙げたどのモデルよりもクリーンな道筋を提供する。
4. GLM 5.3 Flash
最適な用途: 実コードでも通用する最安のオープンモデルが欲しいチーム。
Z.aiのGLM 5.3 Flashは2026年8月26日、初のネイティブマルチモーダルGLM-5モデルとしてローンチされた、320B/アクティブ18BのMoEで、1Mコンテキストとオープンウェイトを備える。Artificial Analysisインデックスで57点、1タスクあたり約0.045ドルとなっており、まさにMiMoの予算帯に収まる。API価格は100万トークンあたり入力0.15ドル・出力0.50ドル(ローンチ時のプロモ価格0.075ドル/0.25ドルはすでに終了している)。
GLMは、話題がベンチマークではなく実コーディングに移った際に人々が名指しで挙げるオープンモデルだ。同じ懐疑的なHacker Newsのスレッドでは、GLMに監督役のトップクラスモデルを組み合わせれば、実務では高価な米国製モデルをすでに凌駕しているという反論があった。
"I mean DSv4.1 Flash and GLM 5.3 kept in check by a supervising frontier like Astra or Fable already in my experience clowns massively on ever using Opus or Sonnet."
長所:
- 非常に安価(0.15ドル/0.50ドル)でありながら強力なAAインデックス(57)、オープンウェイト、1Mコンテキストを備える。
- 本番コーディングタスクで通用するという確かな評判がある。
- より重いコーディングやサイバー系の作業向けに、テキスト専用の別フラッグシップ(GLM-5.3、1.40ドル/4.40ドル)もある。
短所:
- ファーストパーティAPIは遅い(約49トークン/秒)。実質的なスループットを得るにはDatabricksのようなサードパーティのホストが必要だ。
- 思考モードは無効化できない。
- 他の中国製オープンモデルと同様、データレジデンシーとトレーニング利用に関する同じ疑問が当てはまる。
結論: GLM 5.3 Flashはコスパ+コーディングの選択肢だ。DeepSeekが安価なジェネラリスト、Kimiが大型モデルだとすれば、GLMはワークロードの大半がコードで、それでも請求額を極小に抑えたい場合に試す価値がある選択肢だ。
5. Claude Opus 5.5
最適な用途: 最難関のエージェント作業で最高水準の推論力を必要とするチーム。
MiMoの弱点が難易度曲線の頂点だとすれば、Claude Opus 5.5はそこを制するモデルだ。AnthropicのフラッグシップはArtificial Analysis Intelligence Indexで1位(58)を獲得し、Terminal Bench 4.0や最難関のコーディングエージェントボードでMiMoを余裕を持って上回る。価格は100万トークンあたり入力5ドル・出力25ドルで、コンテキストは1Mまでフラットな料金(ロングコンテキストの割増なし)、キャッシュ読み取りはその10分の1になる。
正直な弱点はタスクあたりのコストだ。Opusは出力トークンを大量に消費する。Artificial Analysisインデックスでは、最大エフォート時で1タスクあたり約5.98ドルかかり、MiMoの0.13ドルとは対照的だ。トップクラスの上限のために、トップクラスの価格を支払っていることになる。
長所:
- 最高水準の推論・エージェントスコア。最難関のボードでMiMoが届かない上限そのもの。
- 1Mまでフラットな価格設定、成熟したツール群、規制対象業務向けの明確なデータ取り扱い方針。
短所:
- トークンあたり高価であり、高エフォート時は冗長になるためタスク完了あたりではさらに高くつく。
- 最大エフォート時は最初のトークンまでの時間が遅く、人がライブで待つ用途には不利になる。
- ウェイトはクローズドなので、自前ホスティングや真のローカル推論は選択肢にない。
結論: Opus 5.5はMiMoの対極にある存在だ。コスパの選択肢ではなく、能力の選択肢である。タスクが本当に利用可能な最高の推論力を必要とし、予算がそれを吸収できる場合に頼るべきモデルであり、日常的な80%の業務にはより安価なモデルを組み合わせるとよい。
6. GPT-6 Sol
最適な用途: タスク完了あたりのコストを最小限に抑えたホスト型トップクラスモデルが欲しいチーム。
OpenAIのGPT-6 Solは、MiMoと同じ2026年9月22日にローンチされ、その物語はすべてコストパフォーマンスに集約される。価格は100万トークンあたり入力2ドル・出力10ドルで、GPT-5.6 Solから一律50%の値下げとなり、コンテキストは1.05Mだ。Artificial Analysis Intelligence Index(48)は前世代と同水準で、これは能力の飛躍ではなくバージョンアップの皮をかぶった値下げにすぎないが、まさにそれこそがホスト型業務向けの強力なMiMo代替になる理由だ。
重要な数字はタスクあたりのコストで、Solは出力トークンをOpusよりはるかに少なく使うため異例なほど効率的だ。Artificial Analysisインデックスでは、最大エフォート時で1タスクあたり約1.06ドルとなり、Opus 5.5の5.98ドルに対して約5.6倍安く、それでいて知性ではわずか一段階下にすぎない。事実性も改善しており、最大エフォート時のハルシネーション率は92%から60%に低下した。
長所:
- ホスト型トップクラスモデルとしては安価(2ドル/10ドル)で、タスク完了あたりのコストはOpusより劇的に安い。
- 1.05Mという巨大なコンテキスト、フルセットのResponsesツール群、5.6からの事実性の大幅な向上。
- 米国のトップクラスラボとしての信頼性とデータ方針。
短所:
- 知性は前世代と横ばいなので、本当の飛躍を求めていたなら、ここでは見つからない。
- ウェイトはクローズドで、Sol専用の無料枠もない。
- ロングコンテキストのリクエストはより高い料金階層(4ドル/15ドル)で課金される。これはOpenAIとxAIの両方が課している同じ200K規模の崖だ。
結論: GPT-6 Solは「トップクラスラボの信頼性を備えたMiMo並みの経済性」に最も近い存在だ。ホスト型モデルが欲しく、総額を気にしていて、Opus級の推論力が不要なら、Solは標準的なコスパの選択肢になる。
7. Gemini 3.8 Flash
最適な用途: トップクラスラボによる大規模なマルチモーダルコンテキストを安価に使いたいチーム。
GoogleのGemini 3.8 Flashは2026年9月2日にリリースされ、6週間で3回目のFlashリリースとなった。これは新しいベースモデルではなく(モデルカードは3.7 Flashをベースにしていると4回も明記している)、それゆえ価格は変わっていない。2026年末までは100万トークンあたり入力0.75ドル・出力3.75ドル、1月からは1.50ドル/7.50ドルになる。Artificial Analysis Intelligence Indexはトップクラスの59を記録し、テキスト・画像・音声・動画・PDFを入力として受け付ける。
あまり報じられていない弱点は応答性だ。Artificial Analysisの計測では、最初のトークンまでの時間は13.30秒で、同クラスの中央値2.99秒を大きく上回る一方、純粋な出力速度では196モデル中3位にランクしている。スループットとレイテンシは同じではなく、この点で人がライブで待つ用途には不向きだが、夜間バッチのエージェントには適している。興味深いことに、Google自身が効率重視の開発者には3.7 Flashにとどまるよう助言している。
長所:
- トップクラス級のインテリジェンスインデックス(59)を、トップクラスモデルとしては本当に安価な価格で提供。
- ここで紹介したどのモデルよりも幅広いネイティブなマルチモーダル入力に対応し、1Mコンテキストを備える。
- 無料枠に加え、寛容なバッチ割引・フレックス割引。
短所:
- 最初のトークンまでが遅く、ライブチャットやサポート応答には不向き。
- 冗長で(インデックスを実行するのに約1億2000万の出力トークンを使い、中央値の7100万を大きく上回る)、実際の請求額を膨らませる。
- Google自身のアドバイスは3.7 Flashが効率面での選択肢だというもので、アップグレードの根拠を曖昧にしている。
結論: Gemini 3.8 Flashはマルチモーダルなバッチ処理向けの主力モデルだ。あなたのMiMoの用途がドキュメント・画像・動画中心で非同期に実行されるものなら、これが打ち負かすべきトップクラスの代替だ。人が出力を待っているなら、他を探したほうがよい。
8. Grok 4.7
最適な用途: 大量のエージェントループを動かし、Xのライブデータとトップクラスに近い品質を求めるチーム。
xAIのGrok 4.7は2026年9月21日にローンチされ、より大きなベースモデルの上に構築され、数時間にわたるエージェント的タスクのために訓練されている。Artificial Analysisインデックスの上ではMiMoの興味深い鏡写しになっている存在で、両者ともに46点で並び、同日のローンチというタイミングから「MiMo mogged Grok」というフレーズが広まった。価格はプロンプト20万トークン未満では100万トークンあたり入力2ドル・出力6ドルで、それを超えると4ドル/12ドルとなり、ロング料金はリクエスト全体に適用される。
Grokがここに挙げたオープンモデルに対して持つ本当の強みは、ネイティブなツール群だ。ライブのウェブ検索とX検索、コード実行、そして長時間のエージェント実行向けに調整された設計に加え、xAIがこれまでに出した中で最も強力な安全性スタックを備える。トップクラスに近いがトップクラスを牽引する存在ではなく(コーディングの頂点やターミナル作業では依然としてFableが先行している)、実際に大量に運用できるよう価格設定されている。
長所:
- MiMoと同じAAインテリジェンス(46)でありながら、トップクラスラボによるホスト型ツール群とXおよびウェブのライブ検索を備える。
- エージェントループの大量利用向けに2ドル/6ドルで価格設定されており、新しく強力な安全性・拒否スタックを持つ。
- ターミナルおよびコーディングでGrok 4.6から大きく改善されている。
短所:
- 500Kコンテキストはグループ内で最小であり、20万を超えた分の価格の崖はリクエスト内の全トークンに適用される。
- HealthBenchのような一部の専門的ベンチマークではGPT-6 SolやFableに劣る。
- ウェイトはクローズドで、サポート的なテスト向けの過去チケットによる試行(ドライラン)機能もない。
結論: Grok 4.7は「大量運用でトップクラスに近い」選択肢であり、特にリアルタイムのXやウェブデータが業務の一部である場合に向いている。MiMoの価格に惹かれつつも、ホスト型ツール群が欲しく、コンテキストが小さいことに耐えられるなら、これは公平な乗り換え先だ。
これらのベンチマークすべてが見落としていること
ライブのサポートキューにAIを導入してきた3年間で学んだのはこういうことだ。モデルは最も些末な要素にすぎない。上記の選択肢はいずれもエンジンであり、良いエンジンは完成した車ではない。単体では、生のモデルはあなたの製品を知らず、あなたのヘルプデスクを見ることもできず、アクションを実行することもできず、顧客と話す前に実際の履歴に対して安全にテストすることもできない。
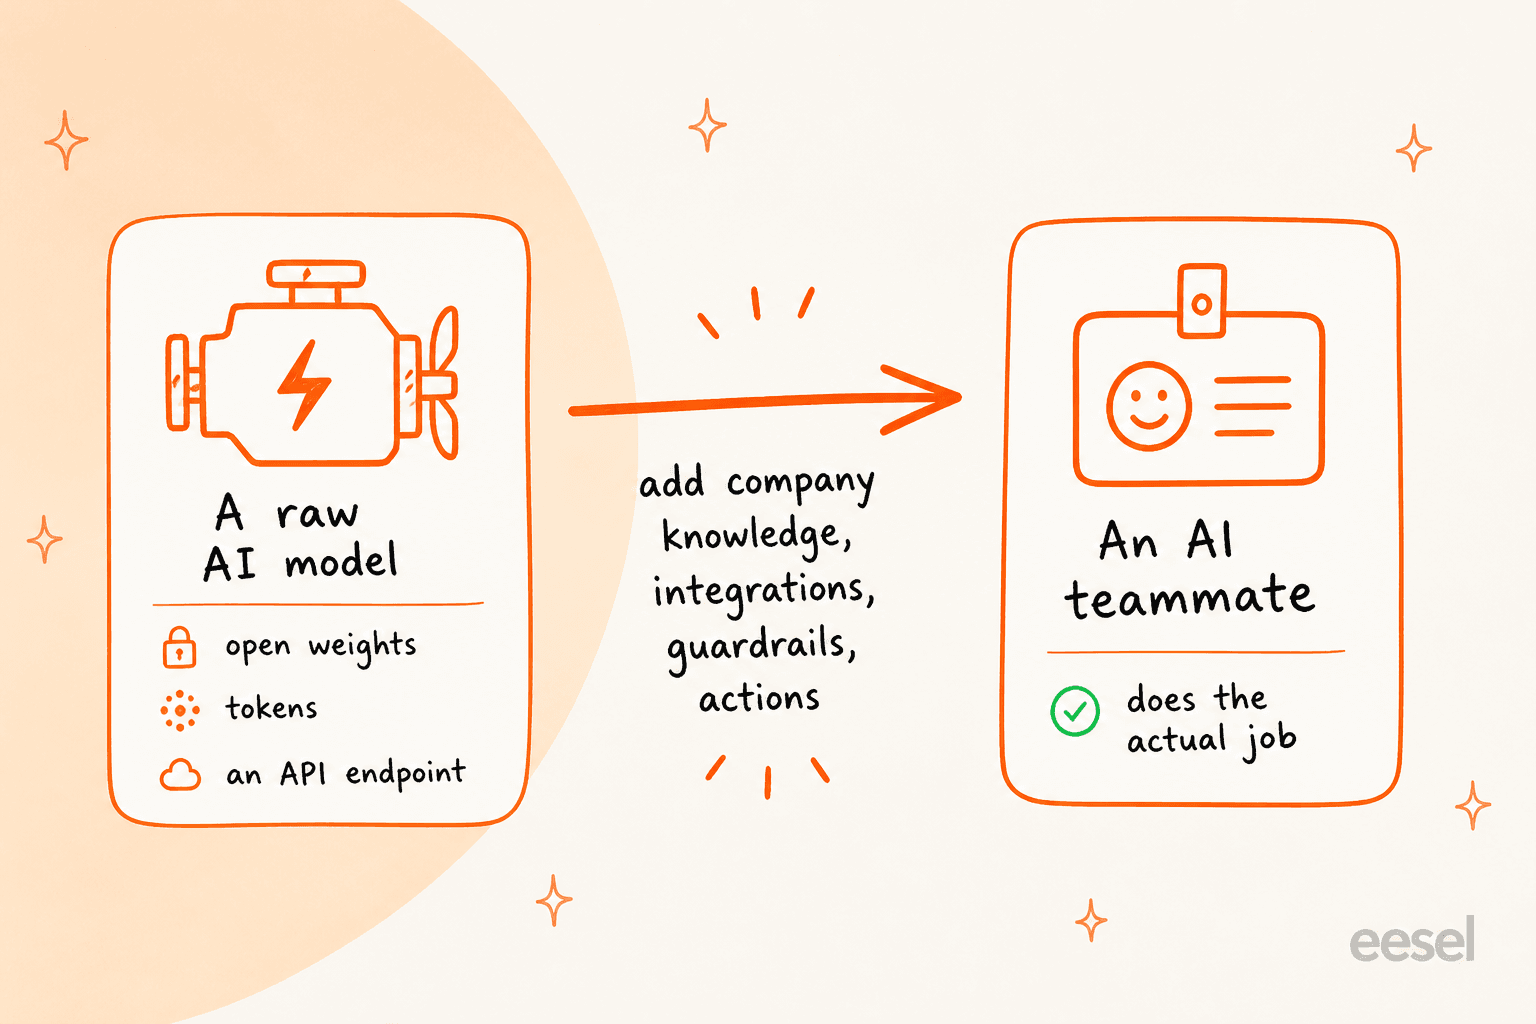
私たちはそれを痛い目にあいながら学んだ。自信ありげに話すボットが静かに間違った答えを返していくのを目の当たりにしたのだ。だからこそ今では、本番投入前に過去のチケットに対してすべてのロールアウトをシミュレーションしている。「賢いモデル」と「仕事を終わらせるチームメイト」の間にあるこのギャップこそ、ベンチマークが測定しないものであり、本当の作業の大半はそこにある。知識をつなぎ、連携を組み込み、ガードレールを設定し、まずは自分たちのデータでうまくいくことを証明する作業だ。
だからこそ、より有用な問いはしばしば「どのモデルか」ではなく「誰がその仕事をするのか」になる。答えがあなたのエンジニアリングチームで、モデルをそのすべてで包み込むのであれば、上記の8つの中から価格・上限・ライセンスに基づいて選べばいい。答えが「結果だけが欲しい」であれば、モデルは実装の詳細にすぎなくなる。
eeselを試す
eeselはこの意思決定の反対側に位置する。エンジンと構築プロジェクトを渡す代わりに、すでにあなたの連携先と会社のコンテキストを把握した、すぐに使えるヘルプデスク向けAIチームメイトを提供し、その下で動くモデルは交換可能なままにしておける。これが「モデルはインフラである」という視点の核心だ。あなたが雇うのはチームメイトであって、エンジンではない。
具体的には、このAIヘルプデスクチームメイトは数分であなたの既存のキューに参加し、過去のチケットとヘルプセンターから学習し、そして何より、ライブの顧客に初めて回答する前にあなたの実際のチケット履歴に対してシミュレーションを行うため、スイッチを入れて祈るのではなく、予測される解決率と品質を事前に確認できる。そしてeeselはプログラムから操作できるように作られているため、フル機能のeesel CLIも用意されている。同じチームメイトとワークスペースをターミナルから操作したり、スクリプトで自動化したり、Claude CodeやCursorのようなコーディングエージェントに操作させたりできる。もともと生のモデルをスクリプトから操作したくて探していたのであれば、これは自然に馴染む選択肢だ。
MiMo V2.6やその代替のいずれかをサポート自動化のために検討しているなら、構築にコミットする前に一度見ておく価値がある。eeselを無料で試して、モデル選びを簡単な部分にしてしまおう。
よくある質問
Xiaomi MiMo V2.6の代替として最適なのは?
Xiaomi MiMo V2.6よりも安い代替はある?
オープンウェイトのMiMo V2.6代替モデルはどれ?
Xiaomi MiMo V2.6は代替を検討しなくてよいほど優秀?
サポートを自動化するのに、そもそもモデルを選ぶ必要はある?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.