llama.cppの代替ツール9選【2026年】ハードウェアとワークロードで選ぶ

Rama Adi

Katelin Teen
最終更新 2026年11月14日
最適なllama.cppの代替は、GPUサーバー上の多くのユーザーにはvLLMまたはSGLang、Apple SiliconのMacにはMLX-LM、NVIDIAカード1枚に最大のモデルを載せるならExLlamaV3だ。Ollama、LM Studio、Jan、LocalAIはより使いやすいが、裏側では今もllama.cppを実行しているため、変わるのはアプリであってエンジンではない。llama.cppはv1.0.0に達した今、1人で1台のマシンを使うなら、そのまま使い続ける方がよいことが多い。目的がサポートチケットへのAI活用なら、eeselはホスト型モデルでそれを実現し、CLIを使えばコーディングエージェントがヘルプ記事をアップロードし、回答を先にテストできる。
なぜ人々はllama.cppの代替を探すのか?
ほとんどの場合、llama.cppが作られた目的を超えて成長したからであり、llama.cppの質が落ちたわけではない。llama.cppは一般的なハードウェアでモデルを実行することを当たり前にしたC/C++エンジンであり、今も最も幅広いエンジンだ。プロジェクトのREADMEにはCUDA、Metal、HIP、Vulkan、SYCL、CPU単体、その他十数種類以上のバックエンドが挙げられ、1.5bitから8bitまでのGGUF量子化、VRAMより大きいモデルのためのCPU+GPUオフロードにも対応する。MITライセンスの下で135,056個のGitHubスターを獲得し、2026年11月13日にはv1.0.0、つまり初のsemverリリースを出し、FP8のKVキャッシュ、mixture-of-expertsモデル用のホストメモリキャッシュ、再設計されたWeb UIを備えた。
私はeeselのインテグレーションとAPIを担当しているので、ローカルエンジンに費やす時間の大半は地味な部分に向かう。公開しているAPI、複数のリクエストが同時に来たときの挙動、モデルを切り替えたときに何が壊れるか、といった点だ。このリストもそれを反映している。各プロジェクトのドキュメント、リリースノート、リポジトリを読み、Hacker Newsからコミュニティの報告も集めたが、9つすべてを1台のマシンでベンチマークしたわけではないので、以下の速度に関する主張はあくまで各プロジェクト自身のものとして扱ってほしい。
移行の理由として挙がるものは、大きく4つに分かれる。
- 多数の同時ユーザー。 llama.cppは1人には最適で、少人数ならまずまずだ。同じサーバーに複数人が集中するチームでは、バッチング型エンジンが優位に立つ。
- Macでの速度。 Apple Siliconでは、Apple自身のMLXフレームワークの方が速い場合が多い。
- 特定のGPUでのピーク速度。 特定ベンダーのハードウェア向けに書かれたカーネルを持つエンジンは、そのハードウェア上では汎用的なエンジンを上回ることがある。
- ビルドではなくアプリ。 誰もがCMakeでコンパイルしてフラグを渡したいわけではない。
最初の3つは実際のエンジンの変更だ。4つ目は多くの場合そうではなく、ほとんどの比較記事が触れない部分だ。
"While I think that llama.cpp is an outstanding project - a one-stop-shop to get almost any model to run on almost any hardware, you get a lot more speed from specialised inference engines with kernels made for your hardware."

Ollamaは本当にllama.cppの代替なのか?
エンジンのレベルでは違う。Ollama、LM Studio、Jan、LocalAIはいずれもGGUFモデルでは裏側でllama.cppを実行しており、そのうちいくつかはMacでMLXも追加している。これらが変えるのはインストール方法、ダウンロード方法、モデル管理の方法だ。トークンの生成方法は変わらない。
その証拠は各プロジェクト自身のページにある。Ollamaのv0.40.16リリースノートには今も"Updated llama.cpp"と記載されている。LM Studioのホームページは"with MLX and llama.cpp under the hood."と述べている。JanのAPIサーバードキュメントは"local models powered by llama.cpp or MLX."と説明している。LocalAIはllama.cppを80以上あるバックエンドの1つとして、vLLMやMLXと並べて挙げている。そしてllama.cppチームは今、Mac・Windows向けに1MBのダウンロードで済む自前のLlamaデスクトップアプリも提供している。
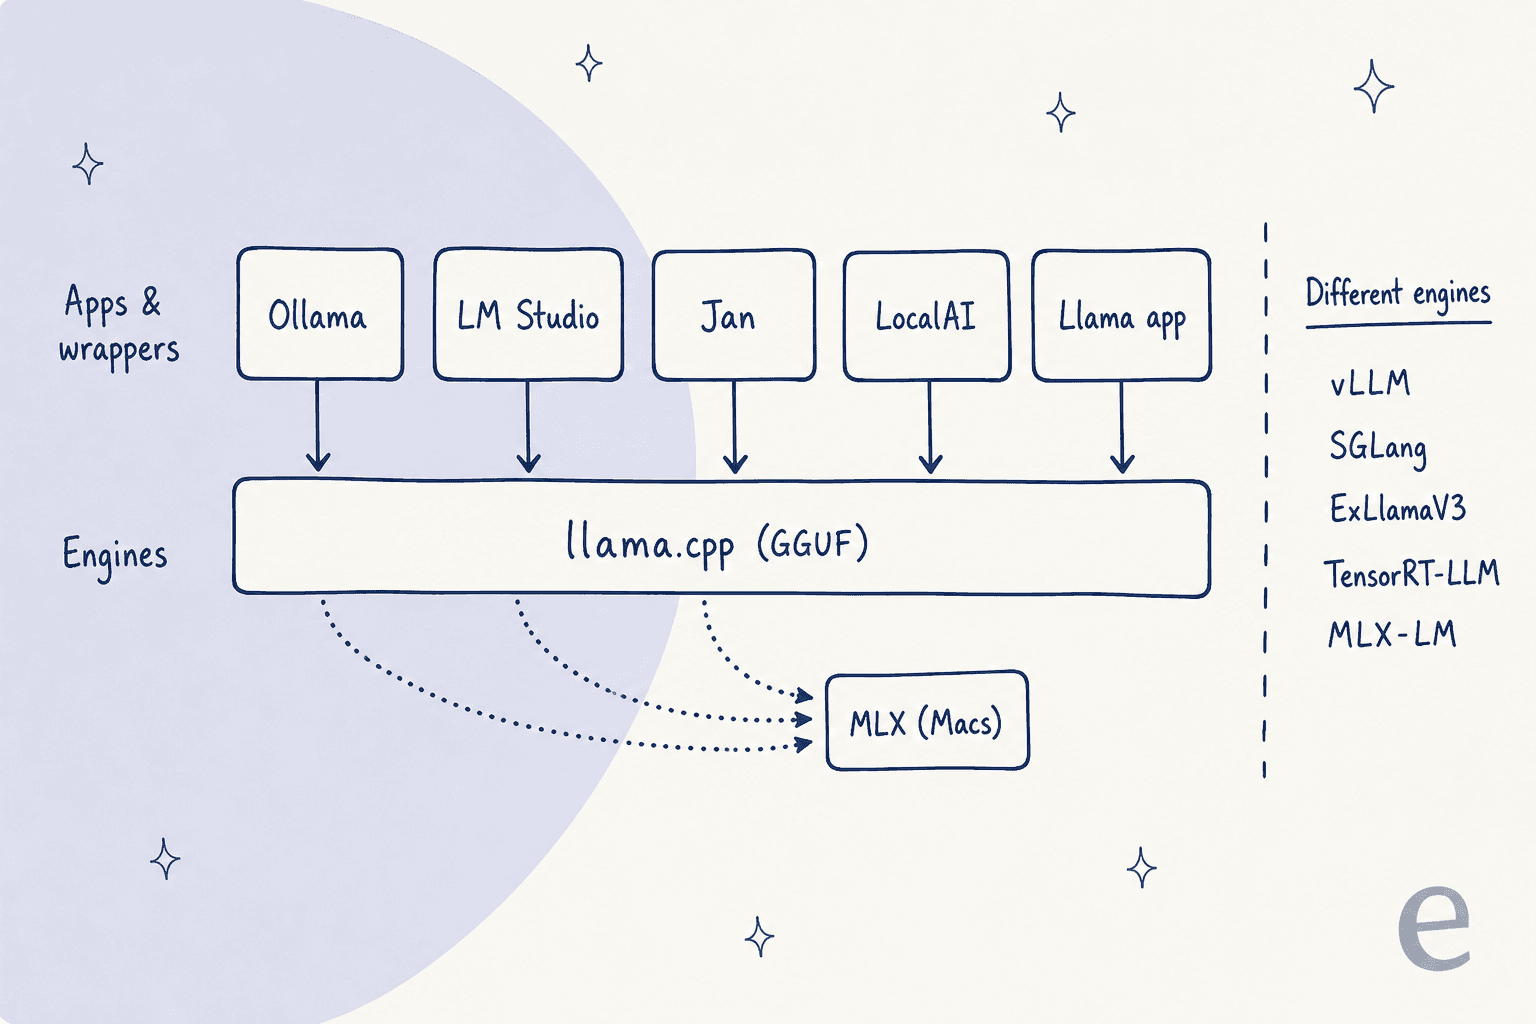
この区別によって、どこを見るべきかが決まる。ビルドやフラグに疲れてllama.cppを離れるのなら、その上に乗るアプリが正しい選択で、すでに動いているものはすべて維持できる。ワークロードに対して遅すぎるから離れるのなら、同じエンジンの上に乗るアプリは助けにならず、右側の列にある5つのうちの1つが必要になる。
"There's also been some controversy over not giving proper credit to llama.cpp which ollama is/was a wrapper around."
これらの代替ツールをどう選んだか
実際に購買者が尋ねることから出発した。新しいチャットでChatGPTに"What are the best llama.cpp alternatives?"と尋ねたところ、9つのプロジェクトが挙げられ、推論エンジンとローカルLLMプラットフォームに分けられたので、その9つすべてをここに載せている。そのうえで、それぞれを次の5点で確認した。
- エンジンかラッパーか。 llama.cppの推論を置き換えるのか、それを包むだけなのか?
- ハードウェアとOS。 NVIDIA、AMD、Apple Silicon、CPU。Linux、Windows、macOS。
- モデル形式。 GGUF、MLXウェイト、EXL3、またはHugging Faceのsafetensors。
- サービング。 OpenAI互換のAPIかどうか、そして多数のリクエストをうまくバッチ処理できるか。
- メンテナンス。 2026年11月15日時点での、各プロジェクトのGitHubリポジトリの最新リリース日、ライセンス、スター数。
並べると次のようになる。
| ツール | 種類 | 裏でllama.cppを実行? | ハードウェア | OS | 主なモデル形式 | OpenAI互換API | 多数の同時ユーザー | ライセンス | GitHubスター | 最新リリース | 有料プラン |
|---|---|---|---|---|---|---|---|---|---|---|---|
| vLLM | エンジン | いいえ | NVIDIA、AMD、Intel、CPU、プラグイン経由でTPU | Linux(WindowsはWSL) | Safetensors、GGUFは実験的 | はい、Anthropic APIも対応 | 強い | Apache-2.0 | 96,936 | v0.33.0 | なし |
| SGLang | エンジン | いいえ | NVIDIA、AMD、TPU、Intel、Ascend、MLX経由でMac | 主にLinux | Safetensors、NVIDIAではGGUF | はい | 強い | Apache-2.0 | 38,874 | v0.5.23 | なし |
| MLX-LM | エンジン | いいえ | Apple Siliconのみ | macOS | MLXウェイト | OpenAI風、基本的 | 軽量 | MIT | 7,656 | v0.32.2 | なし |
| ExLlamaV3 | エンジン | いいえ | NVIDIA、AMD 7900以降 | Linux、Windows | EXL3 | TabbyAPI経由 | 動的バッチング | MIT(TabbyAPIはAGPL) | 1,825 | v1.6.7 | なし |
| TensorRT-LLM | エンジン | いいえ | NVIDIAデータセンター向けGPU | Linux | Safetensors、FP8/FP4 | はい | 強い | NVIDIAのオープンソース | ~15,100 | v1.2.1 stable | なし |
| Ollama | アプリ+サーバー | はい、MLXも | NVIDIA、AMD、Apple | macOS、Windows、Linux | GGUF | サブセット、Anthropic APIも対応 | 中程度 | MIT | 186,973 | v0.40.16 | クラウドは月20ドルから |
| LM Studio | デスクトップアプリ | はい、MLXも | NVIDIA、AMD、Apple Silicon | macOS(Mシリーズ)、Windows、Linux | GGUF、MLX | はい、Anthropic APIも対応 | 中程度 | アプリはクローズド、ツールはMIT | 5,427(lms CLI) | Bionic 1.2.0 | クラウドは月20ドルから |
| Jan | デスクトップアプリ | はい、MLXも | NVIDIA、AMD、Apple | macOS、Windows、Linux | GGUF | はい | 軽量 | Apache 2.0 | ~45,700 | v0.8.8 | なし |
| LocalAI | APIサーバー | はい、80以上あるバックエンドの1つ | CPU、NVIDIA、AMD、Intel、Apple、Jetson | Linux、macOS、Docker、Kubernetes | GGUFほか | はい、Anthropic APIも対応 | 中程度 | MIT | ~50,400 | v4.12.1 | なし |
どのllama.cppの代替が自分のハードウェアに合うか?
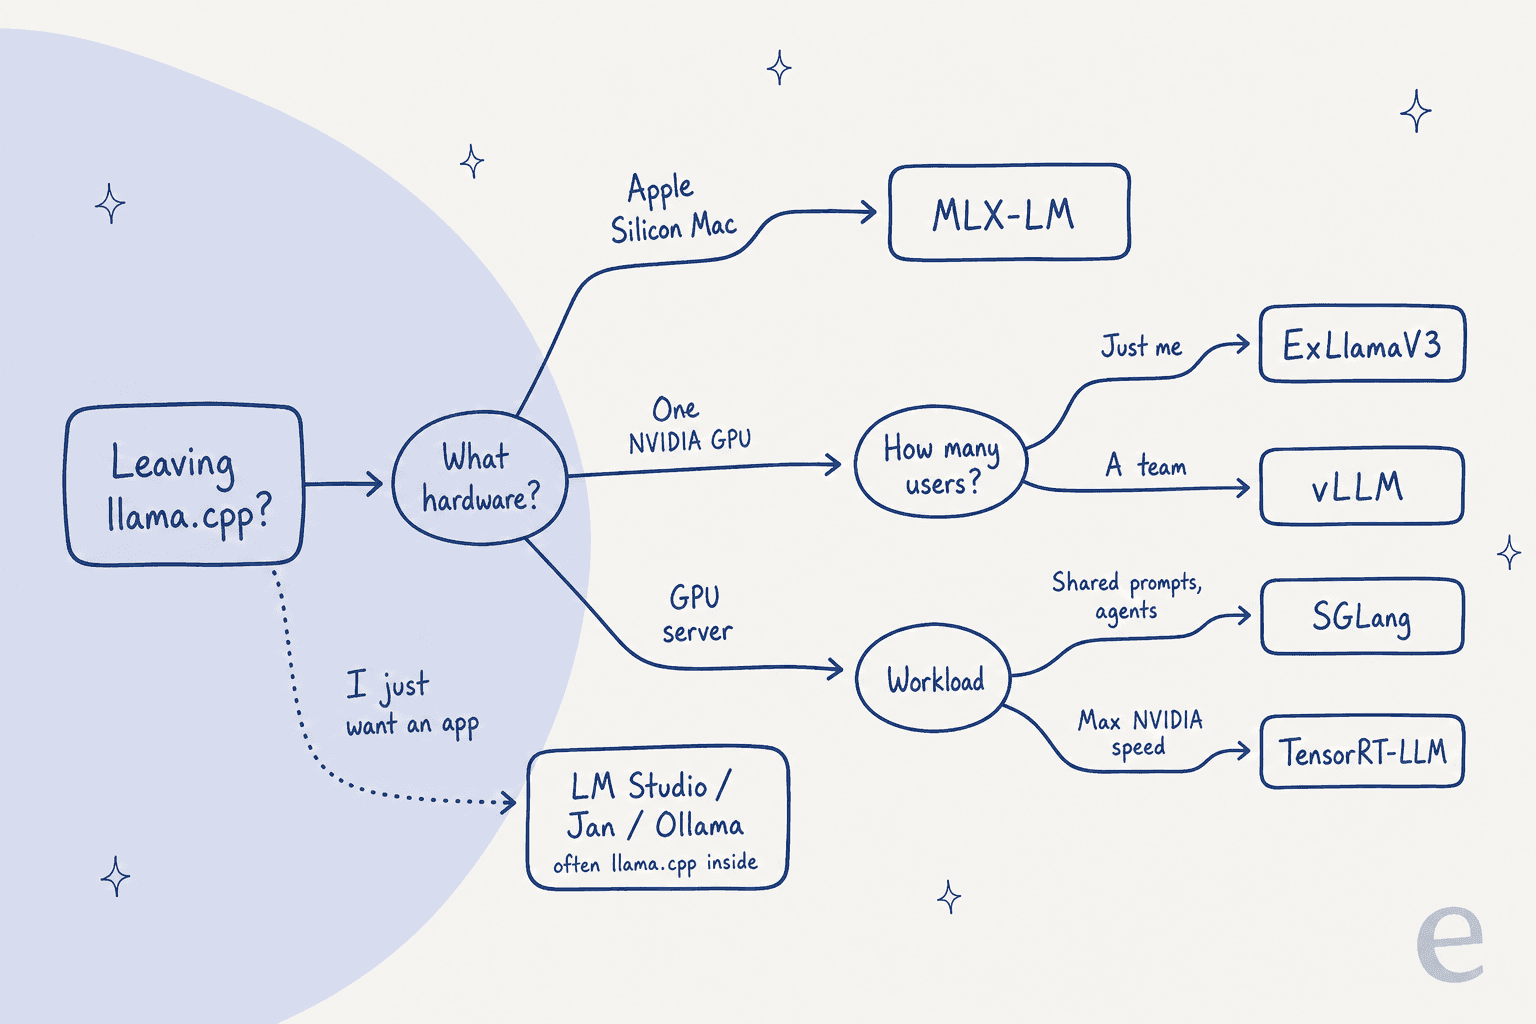
まずマシンから考え、次に使う人数を考える。Macなら MLX-LM。NVIDIAカード1枚なら、1人用ならExLlamaV3、小規模チームならvLLMだ。GPUサーバーなら、プロンプトを共有するエージェントのワークロードにはSGLang、NVIDIAハードウェアで最後の速度を求めるならTensorRT-LLMだ。単に使いやすいアプリが欲しいだけなら、LM Studio、Jan、Ollamaを選び、裏側では今もllama.cppが仕事をしていることを受け入れればいい。
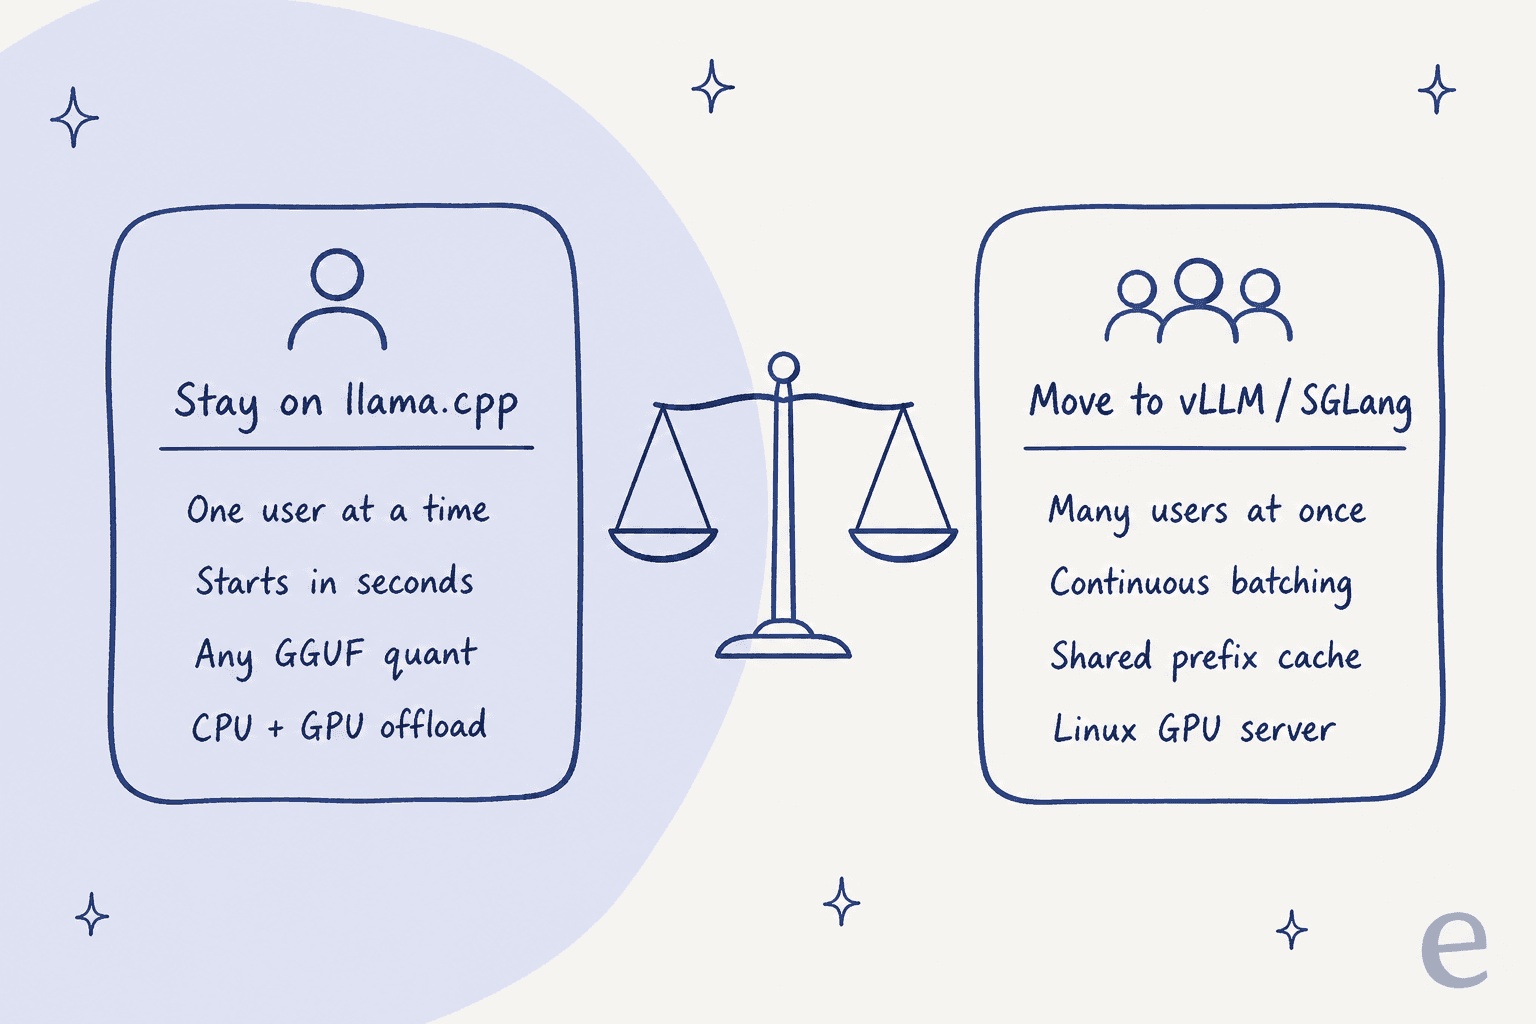
最も役立つ質問は、同時に何人がそのモデルを使うかだ。llama.cppには並列スロットとOpenAI互換のllama-serverがあるが、continuous batchingを中心に構築されたエンジンは、同時リクエストが積み重なってもスループットを維持できる。その代わり、起動は遅くなり、量子化されたファイルを扱う柔軟性は下がる。
"IME vLLM is quite a bit faster than llama.cpp but where it really wipes the floor with it is in batching concurrent load. The downside is that it is dramatically less flexible in terms of tweaking. It gives you very few options for running quantized weights."
1. vLLM
こんな人に向いている: LinuxのGPUサーバーから多数のユーザーに1つのモデルを提供したい人。
vLLMは自らを"a fast and easy-to-use library for LLM inference and serving."と説明している。UC BerkeleyのSky Computing Labで始まり、現在は2,000人以上のコントリビューターを抱える。"サーバー向けのllama.cpp"という文脈で1つだけ名前を聞いたことがあるなら、それはこのツールだろう。
llama.cppより優れている点
- 同時トラフィック。 PagedAttention、continuous batching、chunked prefill、prefix cachingはすべて、多数のリクエストを同時に処理するために作られている。
- 大規模なデプロイ。 テンソル、パイプライン、データ、エキスパート、コンテキストの並列化により、モデルを複数のGPUやマシンに分散できる。
- APIの広さ。 OpenAI互換サーバーに加えて、Anthropic Messages APIとgRPCも備え、Claude Codeのようなツールから接続できる。
- サーバー向けの幅広いハードウェア対応。 NVIDIA、AMD ROCm 6.3+、Intel XPU、CPUに加え、プラグイン経由でTPU、Gaudi、Ascendにも対応する。
弱い点
- Linuxのみ。 GPUインストールガイドは"vLLM does not support Windows natively"と述べ、WSLを案内している。Apple Siliconはコミュニティ製のvLLM-Metalプラグイン経由でしか動かない。
- GGUFは裏口的な存在。 GGUFのドキュメントはこれを"highly experimental and under-optimized"と呼び、今は別のプラグインが必要だ。モデルのライブラリがGGUFファイルなら、safetensors版をダウンロードする計画を立てておくべきだ。
- 起動が遅い。 読み込み時に最適化されたCUDAグラフをコンパイルするため、モデルを頻繁に切り替える場合は不利になる。
"We use all kinds of different models other than Qwen3, and vLLM startup when switching models is prohibitively slow (several times slower than llama.cpp, which is already 5 sec)"
コスト
Apache-2.0の下で無料。uv pip install vllmでインストールし、vllm serve <model>で提供する。本当のコストは対応GPUを備えたLinuxマシンと、それを運用する人だ。
結論
チーム、アプリ、エージェント群が1つのモデルを共有し、起動時間よりスループットが重要なときはvLLMを選ぶ。WindowsやMacを使っている場合、あるいは一日中GGUFモデルを切り替えている場合は見送るべきだ。
2. SGLang
こんな人に向いている: 同じ長いプロンプトを繰り返し送るエージェントのワークロードを扱う人。
SGLangは"optimized for agentic workloads, large-scale serving, and RL rollouts,"と説明されるオープンソースの推論フレームワークで、非営利団体LMSYSがホストしている。そのドキュメントは"low-latency, high-throughput inference with RadixAttention, prefix caching, and multi-GPU parallelism."という説明から始まる。
llama.cppより優れている点
- 共有プレフィックスの再利用。 RadixAttentionは共有されたプロンプトのプレフィックスをキャッシュに保持し、エージェントが毎回同じシステムプロンプトとツールリストを送る場合に効果を発揮する。
- 発売初日からのモデルレシピ。 ドキュメントにはKimi K3.1 Proのような新しいリリース向けのクックブックページがあり、Qwen3.8-Flash-Next向けの初日レシピもある。
- 幅広いアクセラレーター対応。 RTX 30シリーズからGB300までのNVIDIA、AMD Instinct、Google TPU、Intel ArcとXeon、Huawei Ascend、MLX経由のMacに対応する。
- OpenAI互換。 ドキュメントは"compatible with Hugging Face and OpenAI APIs."だと述べている。
弱い点
- CUDA 13が必要。 インストールページによれば、CUDA 12のwheelは0.5.19以降廃止されたため、古いドライバスタックは更新が必要だ。
- Linuxが中心。 メインのインストールガイドはNVIDIA GPUを搭載したLinuxを対象としており、Macでの導入にはmacOS 14以降と環境変数の設定が必要になる。
- メモリオフロード。 ユーザーからは、ウェイトとKVキャッシュをシステムRAMにオフロードする機能がllama.cppより弱いという報告がある。
"My own experience shows that both weight and KV cache offload to ram on sglang and vllm is unavailable or unusable."
コスト
Apache-2.0の下で無料。uv pip install --prerelease=allow sglang、またはDockerイメージlmsysorg/sglangを使う。
結論
トラフィックがエージェントや、長く繰り返されるプレフィックスを持つRAGパイプラインであれば、vLLMよりSGLangを選ぶ。MCPを使ったAIエージェントを構築しているなら、それがトラフィックの大部分を占めるはずだ。オフロードなしではモデルが収まらない単体のデスクトップGPUには向かない。
3. MLX-LM
こんな人に向いている: Apple SiliconのMacでモデルを実行・ファインチューニングしたい人。
MLX-LMはApple自身の"Python package for generating text and fine-tuning large language models on Apple silicon with MLX."だ。Appleの配列フレームワークで、ユニファイドメモリを中心に構築されたMLXの上に成り立っている。
llama.cppより優れている点
- 多くのモデルでのMacの速度。 Hacker Newsのユーザーは、Apple Siliconで打ち勝つべき基準としてMLXを扱っている。あるユーザーは、LM Studio上の同じ8Bモデルで、MLXが1秒あたり約50トークン、llama.cppが約41トークンだったと測定している。
- ファインチューニングが組み込み済み。 LoRA、QLoRA、フル・ファインチューニングに対応し、量子化済みモデルでも使える。複数のMacにまたがる分散推論も可能だ。
- すでにそろった大きなライブラリ。 Hugging FaceのMLX Communityには変換済みモデルが数千件あり、
mlx_lm.convert -qで自分のモデルを量子化できる。
"On a Mac the baseline I'd want is MLX, not llama.cpp. llama.cpp isn't the fast path on Apple Silicon for most models people run locally, so a speedup over llama.cpp could still be slower than mlx_lm."
弱い点
- Macのみ。 このパッケージにはLinuxやWindows向けのGPUパスがない。
- シンプルなサーバー。
mlx_lm.serverはOpenAIに似たAPIを話すが、自身のサーバーに関する注記は"is not recommended for production as it only implements basic security checks."と述べている。 - GGUFに対応しない。 MLX形式のウェイトを使うため、既存のGGUFフォルダはそのまま使えない。
- 常に信頼性が高いわけではない。 あるユーザーは、MLXのセットアップが繰り返しを続けて止まらなくなった後、llama.cppに戻ったと報告している。
コスト
MITの下で無料。pip install mlx-lm、続いてmlx_lm.chat。
結論
MシリーズのMacを使っていて、速度やローカルでのファインチューニングが欲しいならMLX-LMを選ぶ。同じエンジンをGUI付きで使いたいなら、LM Studio、Ollama、JanはいずれもMacでMLXを使っている。Linuxサーバーで動かす必要があるものには向かない。
4. ExLlamaV3
こんな人に向いている: NVIDIAのコンシューマー向けGPU1枚に、できるだけ大きなモデルを詰め込みたい人。
ExLlamaV3は"an inference library for running local LLMs on modern consumer GPUs, with flexible quantization and parallel inference."だ。ExLlamaV2を置き換えるもので、ExLlamaV2のREADMEは今はarchived(アーカイブ済み)と記され、V3への移行を案内している。TabbyAPIはその上で動く公式サーバーだ。
llama.cppより優れている点
- ギガバイトあたりの品質。 QTIPをベースにしたEXL3形式は、小数単位のビットレートと2〜8bitのキャッシュ量子化に対応し、VRAMをぴったり満たすようにモデルを調整できる。
- 自宅でのマルチGPU。 コンシューマー向けカード間でのテンソルおよびエキスパートの並列化に加え、大規模なmixture-of-expertsモデル向けのCPUオフロードも備える。
- 活発な開発。 v1.6.7は2026年11月13日にリリースされ、ほぼ毎日コミットがある。
"ExllamaV3 4.0bpw fits in 12.5G of VRAM and beats IQ4_XS according to the measurements here"
弱い点
- NVIDIAが前提。 CUDA 12.4以降が必要だ。AMD対応は新しく、Radeon RX 7900シリーズに限られる。Macのパスはない。
- 変換が必要。 モデルはEXL3に変換する必要があり、GGUFは読み込めない。
- ホビー規模のサーバー向け。 TabbyAPIのREADMEは"is not meant to run on production servers"だと述べ、ライセンスはAGPL-3.0だ。
コスト
無料。ExLlamaV3はMIT、TabbyAPIはAGPL-3.0だ。リリースページのビルド済みwheelを使えば、pip install exllamav3のためにCUDA toolkitを用意する必要がない。
結論
RTXカードを1枚か2枚持っていて、自分用に収まる最大のモデルが欲しいならExLlamaV3を選ぶ。共有の本番サービングやNVIDIA以外の環境には向かない。
5. TensorRT-LLM
こんな人に向いている: NVIDIAのデータセンター向けGPUで最大のスループットを求める人。
TensorRT-LLMはNVIDIAのオープンソースライブラリで、"for accelerating and optimizing inference performance of the latest large language models (LLMs) on NVIDIA GPUs"のためのものだ。今はPyTorchの上に構築され、Python製のLLM APIを備える。
llama.cppより優れている点
- 新しいカードでの低精度フォーマット。 B200ではネイティブのFP4、H100以降ではFP8に対応し、NVIDIAによれば"can double performance and halve memory consumption compared to 16-bit floating point"だという。
- サービング機能。 In-flight batching、ブロック再利用付きのPaged KVキャッシュ、投機的デコーディング(EAGLE、MTP、NGram)、LoRA、ベータ版の分離型サービングを備える。
- NVIDIAのスタック。 ドキュメントによれば、NVIDIA DynamoやTriton Inference Serverと連携でき、
trtllm-serveはOpenAI互換のエンドポイントを公開する。
弱い点
- NVIDIAのデータセンター向けハードウェアが前提。 対応GPUはAmpere A100からHopper、Blackwellまでだ。ノートPC向けのツールではない。
- リリースのペース。 最新の安定版はv1.2.1で2026年4月20日のもの。ドキュメントはすでに1.4.0のリリース候補を扱っている。
- セットアップが重い。 最も手早い方法はNVIDIAのNGCコンテナだ。
"Some GPUs are still better than others like Nvidia GPUs are still the best for token throughput (via TensorRT-LLM), but AMD GPUs are competitive (via vLLM) and even CPUs can run LLMs at decent speeds (via Llama.cpp)."
コスト
無料で有料プランはない。コストは、これが対象とするH100やB200クラスのハードウェア、あるいはクラウドの利用時間だ。スループットだけが必要なチームは、自前の運用よりGroqのようなホスト型エンジンの方が安いと感じることもある。
結論
NVIDIAのデータセンター向けGPUを所有していて、トークンあたりのサービングコストが主要な指標であればTensorRT-LLMを選ぶ。コンシューマー向けハードウェアでは、vLLMやExLlamaV3の方がシンプルなので見送るべきだ。
6. Ollama
こんな人に向いている: 最も簡単なローカルモデルのセットアップが欲しく、クラウドモデルも選択肢に入れたい人。
Ollamaは自らを"the most popular way to build with open models"と呼んでおり、その数字も人気の部分を裏付けている。GitHubスターは186,973個、自社のホームページによれば月間900万件以上のインストールがある。
llama.cppより優れている点
- ビルドが不要。 macOS、Windows、Linux向けのインストールスクリプトまたはインストーラーに加え、Dockerイメージもある。
- モデルライブラリ。
ollama runはollama.com/libraryからダウンロードし、Kimi K3やDeepSeek V4 Flashのようなモデルも含まれる。 - エージェントとの連携。
ollama launchはローカルモデルをClaude Code、Codex、OpenCodeなどに接続し、OpenAIとAnthropic互換のエンドポイントも備える。 - MacでのMLX。 リポジトリには今、llama.cppと並んでMLXランナーも含まれている。
"When I read the llama.cpp repo and see I have to build it, vs ollama where I just have to get it, the choice is already made."
弱い点
- エンジンは同じ。 GGUFモデルの場合、裏側は今もllama.cppなので、スループットの問題は解決しない。
- OpenAI APIは部分的対応。 互換性ドキュメントは"supports a subset of the OpenAI API."と述べている。
- 調整の幅が少ない。 インストールが簡単になった今、より細かな制御を望むようになったユーザーの一部はllama.cppに戻っている。
コスト
ローカルでは無料。クラウドプランはOllamaの料金ページにある通り、以下の通りだ。
| プラン | 価格 | 内容 |
|---|---|---|
| 従量課金 | サブスク料金0ドル | クラウドでのトークン課金、同時リクエスト3件 |
| Pro | 月20ドル(年200ドル) | 月60ドル分の利用クレジット、より大きなProモデル |
| Max | 月100ドル | 月300ドル分の利用クレジット、同時リクエスト10件 |
| Team(早期アクセス) | 月500ドル | ユーザー数無制限、1,000ドル分の共有クレジット |
| Enterprise | 要相談 | モデルアクセス制御、ユーザー・キー単位の予算 |
結論
5分でローカルモデルを動かしたい、そしてコーディングエージェントに接続する予定があるならOllamaを選ぶ。llama.cppを離れる理由が速度なら、同じエンジンを使い続けることになるので見送るべきだ。
7. LM Studio
こんな人に向いている: VRAMに応じてモデルを選べる、洗練されたデスクトップアプリが欲しい人。
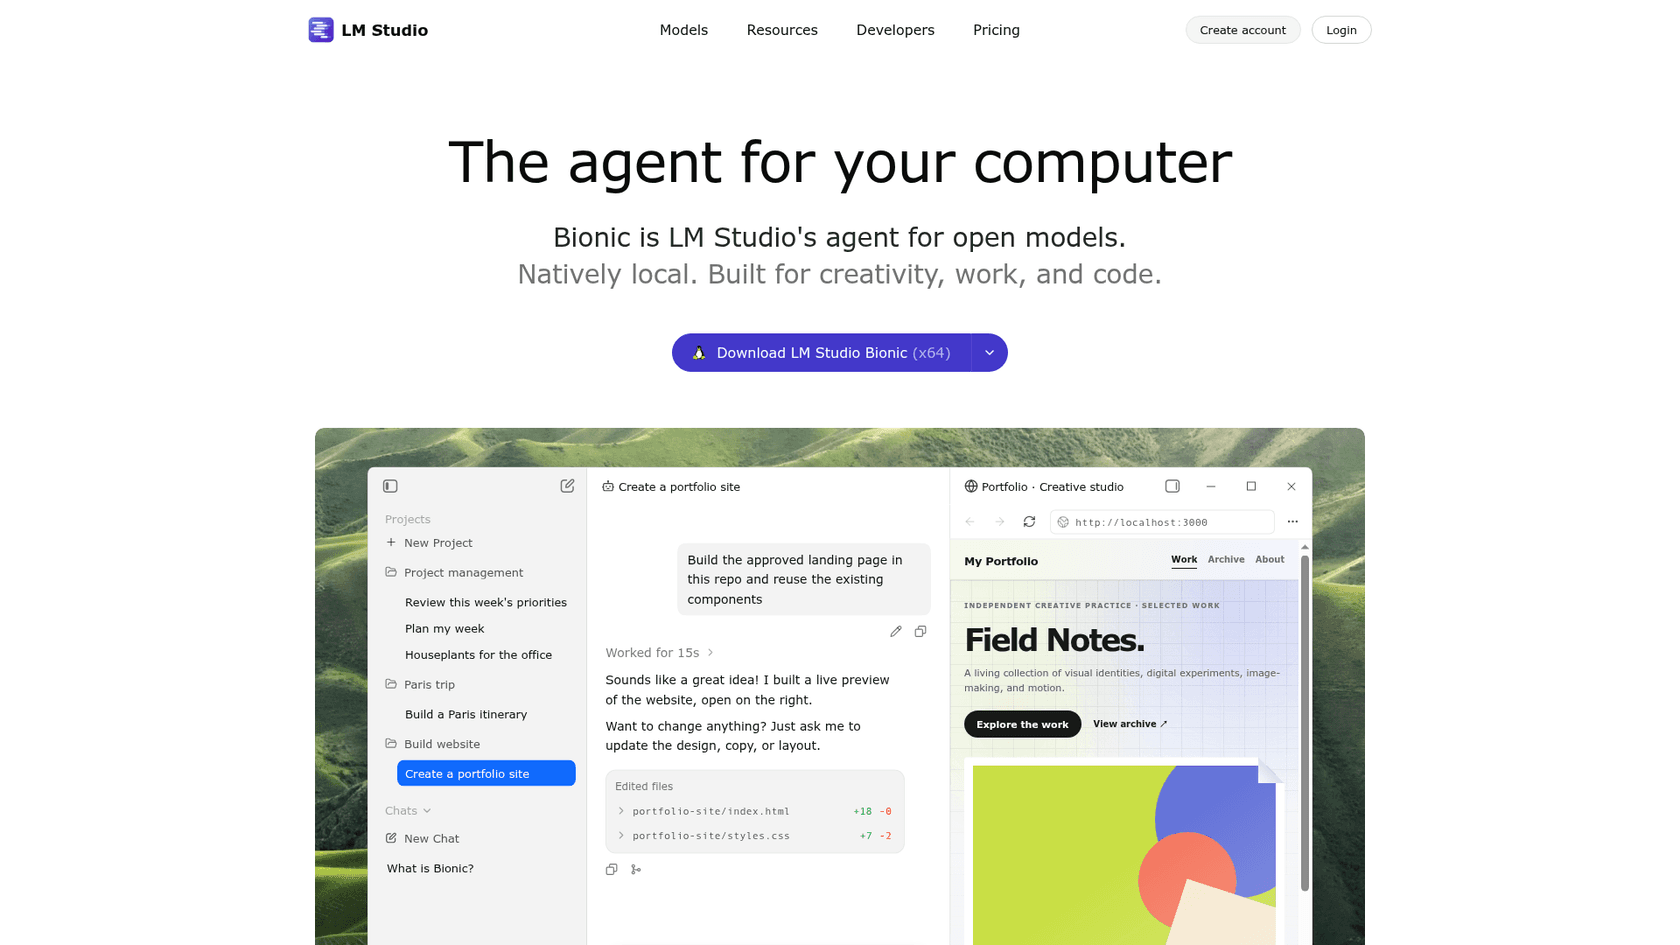
LM Studioはモデルチャットアプリから"Bionic"へと成長した。これを"LM Studio's agent for open models. Natively local."と呼んでいる。裏側では、公式の言葉で"with MLX and llama.cpp under the hood."だという。
llama.cppより優れている点
- モデル探索。 検索によって、ダウンロード前に自分のハードウェアに合うモデルが分かる。
- Macで両方のエンジン。 llama.cppの拡張パック経由のGGUFと、自社のoMLXエンジン経由のMLXを、モデルごとに選べる。
- 開発者向けの機能。 OpenAIとAnthropic互換のエンドポイント、TypeScriptとPythonのSDK、
lmsCLI、そしてGUIなしで動くサーバー・CI向けのヘッドレスデーモンllmsterを備える。
"LM Studio's model search is pretty good at showing what models will fit in your VRAM."
弱い点
- クローズドソースのアプリ。 デスクトップアプリはLM Studio独自の利用規約の下にあり、GitHub上でMITなのはCLIとSDKのみだ。
- llama.cppに遅れをとる。 プリコンパイル済みのエンジンパックを同梱しているため、真新しいモデルへの対応が数日遅れることがある。
- Intel Macには対応しない。 macOSにはApple Siliconとmacos 14以降が必要だ。
コスト
ローカルでは無料。LM Studioの料金ページによれば、Bionic+は米国ホストのオープンモデルとウェブ検索で月20ドル、Proは利用上限が5倍になって月100ドル、チーム向けの料金は公開されていない。
結論
ローカルモデル向けの最も優れたGUIが欲しく、特にMacでGGUFとMLXを自動で切り替えてほしいならLM Studioを選ぶ。オープンソースのアプリや、その日のうちに最新のllama.cppビルドが必要な場合は見送るべきだ。
8. Jan
こんな人に向いている: ローカルにとどまる、ChatGPT風のオープンソースデスクトップアプリが欲しい人。
JanはmacOS、Windows、Linux向けのオープンソースデスクトップアプリだ。そのドキュメントは"the llama.cpp engine is built into Jan and updates together with the app"だと述べ、Apple SiliconではMLXを使用している。
llama.cppより優れている点
- オープンソースで使いやすい。 Apache 2.0ライセンス、約45,700のスター、チャットインターフェース、初回起動時にデフォルトモデルをダウンロードするモデルハブを備える。
- 1つのウィンドウでローカルとクラウドの両方。 ローカルモデルと並べてOpenAI、Anthropic、Googleのキーを追加できるほか、MCPサーバーとウェブ検索も使える。
- ローカルAPI。
127.0.0.1:1337/v1でOpenAI互換サーバーを提供する。
"its open source, has a simple chat interface, it uses llama.cpp, it lets you search for models and downloads them, and it supports .gguf so youre not locked in if you want to use the models with another program later on"
弱い点
- エンジンは同じ。 OllamaやLM Studioと同様、推論速度は変わらない。
- Intel Mac。 内蔵されたllama.cppエンジンは、v0.8.5以降Intel Macでモデルをロードしない。
- 新しい機能はプレビュー中。 自律タスクモードのCoworkは、まだプレビューとされている。
コスト
無料。有料プランはなく、ホスト版プラットフォームは近日公開とされている。
結論
オープンソースライセンスでLM Studioの使いやすさが欲しいならJanを選ぶ。サーバー級のサービングが必要なら見送るべきだ。
9. LocalAI
こんな人に向いている: テキスト、画像、音声などをまとめて扱える、単一のセルフホスト型APIが欲しい人。
LocalAIはMITライセンスのセルフホスト型エンジンで、テキスト、ビジョン、音声、画像、動画のモデルを対象とし、"more than 80 backends"を備え、その中にはllama.cpp、vLLM、MLX、whisper.cppも含まれる。
llama.cppより優れている点
- 多様なモデルタイプ向けの単一API。 OpenAI互換に加え、AnthropicやElevenLabsの形式、リアルタイムAPI、制約付き文法にも対応する。
- 差し替え可能なバックエンド。 各バックエンドは独自のイメージで、モデルが必要とするときだけ読み込まれる。チームはvllm.cppのように、いくつかを自前で構築している。
- 幅広いハードウェア対応。 CPU、NVIDIA CUDA 12・13、AMD ROCm、Intel、Apple Metal、Vulkan、Jetsonに対応する。
弱い点
- 実質的にはルーター。 GGUFのテキストモデルでは、実際の作業をしているのは今もllama.cppだ。
- 新機能は開発版ビルドのみ。 エージェント、ファイル、サンドボックス、チームログインは、v4.12.1時点では開発版ビルドにしかない。
- 可動部分が多い。 バックエンドごとのコンテナは柔軟だが、単一のバイナリより重い。
"And if you want to use WSL, then I'd suggest using something like LocalAI which gives you a lot more control and support for additional formats (GGML, GGUF, GPTQ, ONNX, etc)."
コスト
無料。スクリプト、Docker、macOSアプリ、Kubernetesでインストールできる。
結論
チャット以上のことをするホームラボや社内プラットフォーム向けに、OpenAI風の単一エンドポイントが欲しいならLocalAIを選ぶ。テキストモデルしか動かさないなら、純粋なエンジンの方がシンプルなので見送るべきだ。
いつllama.cppにとどまるべきか?
1人で1台のマシンを使っていて、特に混在した、あるいは珍しいハードウェアを使っている場合だ。ここに挙げたどの代替も、これほど多くのバックエンドをカバーしていない。AMDノートPC向けのVulkanから、Snapdragon、Huawei Ascendまで幅広い。新しいモデルアーキテクチャも、たいていそこに最初に到達する。v1.0.0はリリース当日にKimi-K3.1-ProとRipple-65Bを追加し、llama-serverは既にOpenAI互換API、Web UI、MCPツールを備えている。私の同僚のllama.cppガイドがv1.0.0のセットアップを詳しく解説している。
2つの大きな不満も、以前より小さくなっている。ビルドは今ではLlamaアプリやHomebrew、Wingetによるインストールで不要になり、v1.0.0の新しいMoEキャッシュはリリース内のあるテストで速度を倍増させ、Qwen3.8-Flash-Nextで1秒あたり24.2から47.6トークンになった。エキスパートのキャッシュミスの大半はCPUで処理されている(PR #30966)。
"I have been using llama.app, which is the desktop interface built on top of llama.cpp by the same people. It is an alternative to Ollama that might interest people who want to switch given Ollama's reputation and previous decisions."
主にコーディングエージェントを動かすためにモデルを実行しているなら、ボトルネックを実測していない限りそのまま使い続けるべきだ。ツール呼び出しを待つエージェントは、サーバー型エンジンのバッチングをほとんど必要としない。自宅で動かすオープンソースエージェントについても同じことが言える。
llama.cppからの移行には実際どれくらいのコストがかかるか?
このリストにあるエンジンはすべて無料のソフトウェアなので、価格はハードウェアと時間だ。上のドキュメントから導き出せる目安をいくつか挙げる。
- vLLM、SGLang、TensorRT-LLM。 LinuxのGPUサーバーと、CUDA、ドライバー、コンテナを常に最新に保つ担当者が必要になる。SGLangは既にCUDA 13を要求する。
- MLX-LM。 すでにユニファイドメモリが十分あるMシリーズのMacを持っているなら、追加コストはかからない。
- ExLlamaV3。 モデルをEXL3に変換し、GGUFファイルとは別のモデルフォルダを保持する必要がある。
- OllamaとLM Studio。 ローカルでは無料で、課金されるのはクラウドモデルだけであり、月20ドルからだ。
どれも自前で持ちたくないなら、Together AIのようなホスト型推論が、ハードウェア代をトークンあたりの料金に置き換えてくれる。それでもLLM利用量トラッキングツールで追跡すべきだ。ローカルモデルが本当に安くなるのは、そのマシンが常に稼働している場合だけだからだ。
サポートチケットにAIを使いたいなら、eeselはどこに位置するのか?
多くの人がllama.cppに行き着くのは、データをあちこちに送らずに顧客に返答するAIが欲しいからだ。推論エンジンはそのための基盤であり、完成した仕事そのものではない。それでも、ヘルプデスクとの連携、ナレッジの同期、テスト、人への引き渡し、レポーティングは自分で構築する必要がある。それこそがeeselがやっている仕事だ。エンジンはモデルを動かし、eeselはサポートの仕事をする仲間だ。
eeselのAIヘルプデスク担当は、ZendeskやFreshdeskの既存のキューに加わり、ヘルプセンターと過去のチケットから回答し、実際の顧客に返信する前に過去の会話でテストされる。SE RankingはZendesk上の3つのプロダクトそれぞれにeeselエージェントを運用し、約16,800ページのナレッジから月に4,650件の会話を処理しており、返金や担当者への引き渡しが必要なリクエストはチームに渡している。貴金属業界向けのソフトウェアを開発するOrosoftは、代わりにこれをコパイロットとして使っている。サポート担当者がFreshdeskのチケット上でeeselにメンションすると、約6,100件の過去のチケットに基づいた下書きを受け取れる。
すでにターミナルに慣れているなら、eeselのCLIは気に入ってもらえる部分だ。Claude CodeやCodexのようなコーディングエージェントはこれを使って、エクスポートされたヘルプ記事やマクロのような承認済みのナレッジをアップロードし、エージェントの指示を調整し、本番投入前にテスト用の質問をして回答を確認できる。ヘルプデスク自体の接続には、依然として管理者権限を持つ誰かの承認が必要だ。
eeselを試す
あなたのデスクにあるモデルが、最終的に顧客への返答を目的としていたなら、eeselはエンジンを選んだりGPUを買ったりせずにそこへたどり着かせてくれる。数分でヘルプデスクに接続し、過去のチケットから学習し、SE Rankingが3つのプロダクトで運用しているのと同じように、まず過去の会話でテストされる。気になるなら先に料金を見てほしい。準備ができたら、eeselを無料で試してほしい。