2026年版 Meta Muse Wonder のおすすめ代替9選(用途別・価格別)

Kira

Katelin Teen
最終更新 October 14, 2026
なぜ Muse Wonder 以外も見るのか
まず Meta がうまくやった点から始めます。かなり多いからです。Muse Wonder は Meta Superintelligence Labs 初の最先端モデルファミリーで、10月12日に公開されました。上位版の Wonder Full は公開日に Artificial Analysis のインデックスで2位でした。API モデルは1,048,576トークンのコンテキストウィンドウを持ち、テキスト、画像、動画、音声、PDF を扱え、料金表も明快です。長いコンテキストの割増はなく、初日から毎分3,000リクエストまで使えます。同僚の Muse Wonder レビューで詳しく扱っています。
ほかを探す理由は具体的で、3つとも確認できます。
- 買えるモデルは、グラフに載っているモデルではありません。 Meta 自身のベンチマーク表では、Wonder Full が14行中6行で勝っています。API にある唯一のモデルである通常の Wonder が勝つのは1行(MemoryBench)です。
- 最先端クラスの価格です。 Meta はかつて他社より安く出していました。
$4/$20の Wonder は Opus 5.5 とセント単位まで同じで、GPT-6.1 Sol の2倍です。 - プレビュー版です。 モデルのドキュメントはプレビューと明記し、安全性レポートは「近日公開」、初期のテスターは API の信頼性の問題を指摘しています。
"It's ok, intelligent, almost SOTA, but way too expensive [0], and some issues with API failing sometimes at the moment."

私は eesel で機能と AI エージェントを作っていて、eesel のスタックで最も頻繁に変わると見ているのが下層のモデルです。これは勘ではありません。ある営業電話で、月に約250件のチケットを扱う B2B ハードウェアのサポートチームが、eesel の営業チームに、AI サポートツールを入れ替えなければならないと話しました。理由は価格ではありません。ベンダーがビジネスモデルを変え、移行を余儀なくされたのです。プレビュー版のモデルは、まさにそうした変更が予告なしに起こる場所です。Wonder は試す選択肢のひとつとして扱い、固定の基盤として組み込むのは避けたいところです。
同じ価格、違うスコア
この記事で保存しておく価値があるのはこのグラフです。100万トークンあたりの出力価格では、Muse Wonder は Opus 5.5 と並んでいます。Artificial Analysis のインデックスでは、Meta 自身のローンチ用グラフにあるとおり、6ポイント低くなります。
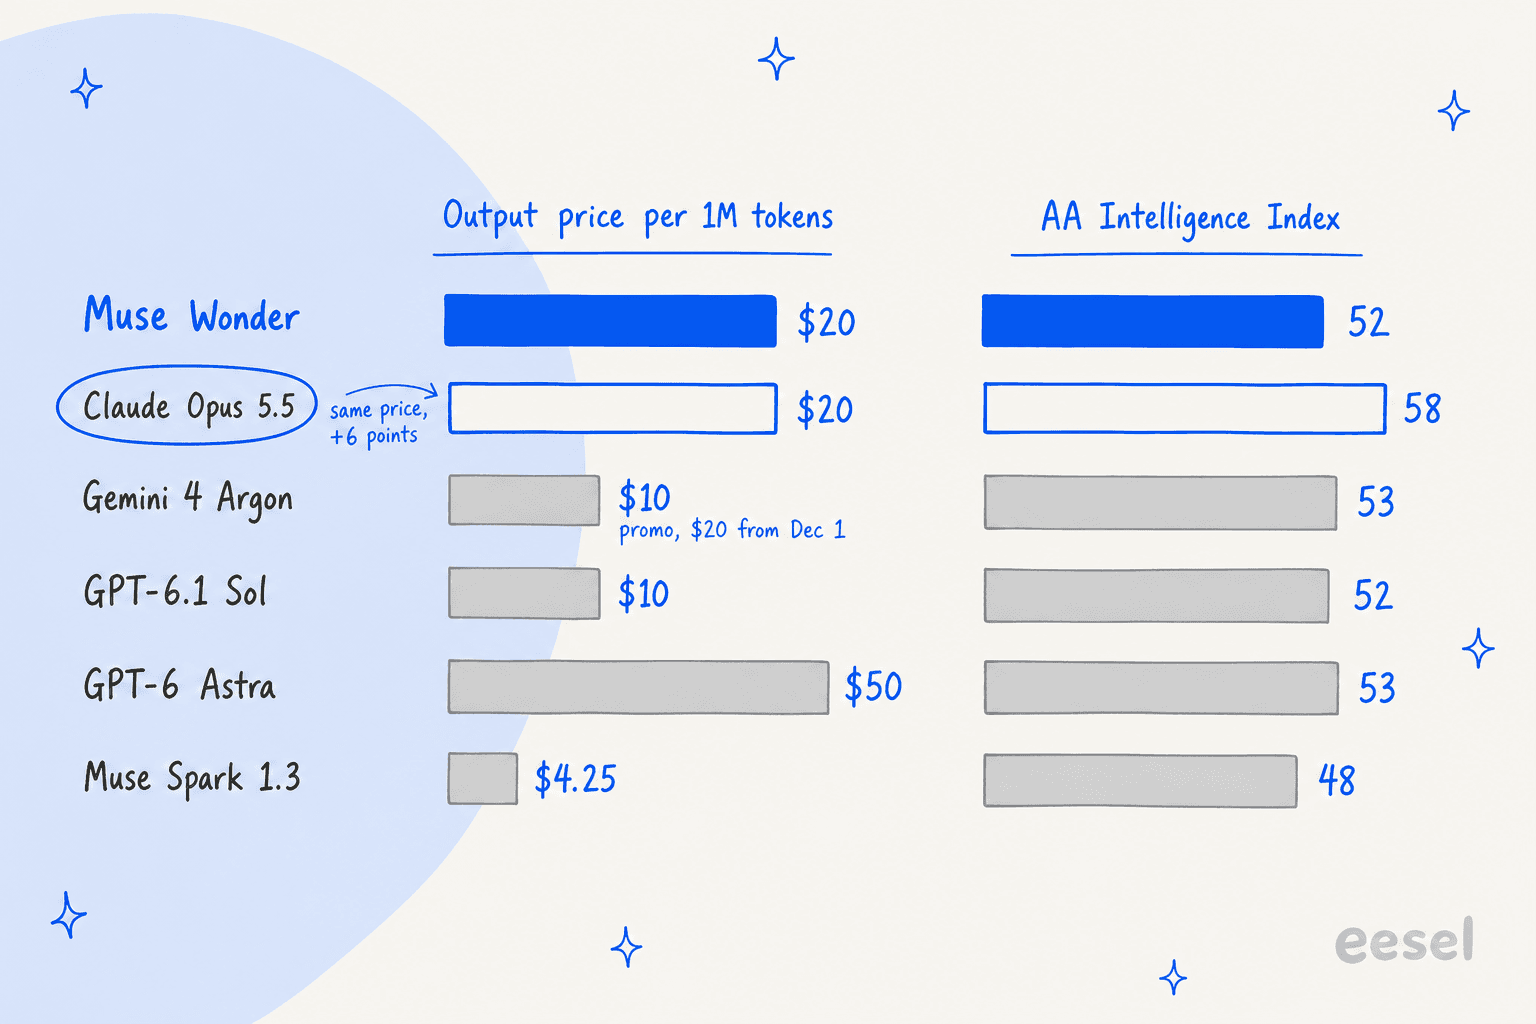
各行を見ると3点が目立ちます。Opus 5.5 は同じ請求額で6ポイント上です。GPT-6.1 Sol は同じスコアで出力価格が半分です。そして GPT-6 Astra は1ポイントのために Wonder の2.5倍を請求します。ベンチマークがすべてではありません(Wonder の MemoryBench の結果は本物で、Meta は長いエージェント実行向けに作りました)。ただ、価格が同じなら、立証責任はスコアの低いモデルにあります。
HN のコメントのひとつは Sol との比較をこう率直に言い表しました。
"sol 6.1 is 50% cheaper than this. sol pricing$2.00 output $10.00 dont know why the f people downvote for saying sol pricing."
Muse Wonder の代替を一覧で
価格は各社の料金ページにある標準 API の100万トークンあたりの料金で、2026年10月14日に確認しました。インデックスのスコアは、モデルが載っている場合は Meta のローンチ用グラフ(10月12日)から、載っていない場合は Artificial Analysis のモデルページから取っています。
| モデル | 向いている用途 | 入力 / キャッシュ / 出力(100万あたり) | AA Intelligence Index | コンテキスト / 最大出力 | オープンウェイト | 既定でデータを学習に使う | 無料枠 | 入手先 |
|---|---|---|---|---|---|---|---|---|
| Muse Wonder(基準) | 長いエージェント実行、メモリ | $4 / $0.20 / $20 | 52 | 1M / 非公開 | いいえ | いいえ(API) | なし | Meta Model API、OpenRouter、Muse Code |
| Claude Opus 5.5 | 同じ請求額で高スコア | $4 / $0.20 / $20 | 58 | 1M / 128K | いいえ | いいえ | なし | Claude API、Bedrock、Vertex、Foundry |
| Gemini 4 Argon | 長い文書、12月まで安い | $2 / $0.10 / $10、その後 $4 / $0.20 / $20 | 53 | 統合1M / 最大1M | いいえ | いいえ(有料) | なし | Gemini API、AI Studio |
| Muse Wonder Full | Meta の最高性能、Muse Code でのコーディング | 月額 $50 または $200 | 56 | 1M / 非公開 | いいえ | はい(Contributor モード) | なし | Muse Code の Power または Max のみ |
| GPT-6.1 Sol | Wonder と同スコアを半額で | $2 / $0.10 / $10 | 52 | 1.05M / 128K | いいえ | いいえ | なし | OpenAI API、ChatGPT Work、Codex |
| GPT-6 Astra | OpenAI の最上位、Ultrafast | $10 / $1 / $50 | 53 | 1.05M / 128K | いいえ | いいえ | なし | OpenAI API、ChatGPT 有料プラン |
| Claude Sonnet 5.5 | Opus の半額でコーディング | $2 / $0.10 / $10 | 56(max)、47(high) | 1M / 128K | いいえ | いいえ | なし | Claude API、クラウド各社 |
| Muse Spark 1.3 | 大量処理、Meta のまま | $1.25 / $0.15 / $4.25 | 48 | 1M / 非公開 | いいえ(約束のみ) | contributor 版のみ | なし | Meta Model API、Muse Code |
| Gemini 3.8 Flash | 安いバッチ処理、無料枠 | $0.75 / $0.075 / $3.75 | 41(high) | 1M / 64K | いいえ | 無料枠のみ | あり | Gemini API、AI Studio |
| DeepSeek V4.1 Flash | オープンウェイト、最安 | $0.15 / $0.003 / $0.60(オフピーク) | 39.5(max) | 1M / 384K | はい、MIT | 規約に記載なし | なし | DeepSeek API、セルフホスト |
どの行が自分に当てはまるか迷ったら、Wonder を見ていた理由にいちばん近いものを選んでください。
Muse Wonder を何に使いたかったですか?
いちばん近い理由を選んでください。
代替の選び方
AI アシスタントに「Wonder と何を比べるべきか」と聞いた買い手に返ってくる候補リストから出発し、各名前を一次情報で確認しました。そのリストは GPT-6 Astra、Claude Opus 5.5、Gemini 4 Argon、Wonder Full、安価な Gemini Flash に偏っていました。そのうち2つは修正が必要でした。Gemini 4 Argon は出たばかりで、提案された Flash の Gemini 3.5 Flash は廃止済みで、リクエストは現在 3.6 Flash に振り分けられているため、最新の 3.8 Flash を使いました。
次に、Wonder を検討する買い手が価格面で実際に比べるモデルを加えました。$2/$10 の GPT-6.1 Sol と Claude Sonnet 5.5、Meta 自身の Muse Spark 1.3、そしてオープンウェイトの選択肢です。以下の価格はすべて10月14日時点の各社の料金ページによるものです。ベンチマークはすべて各社または Artificial Analysis のもので、どちらかを明記しています。
この記事のために9モデルを自前のテスト環境で動かしてはいません。Wonder は公開から3日で、公平な比較にはあなたのタスクが必要で、私のタスクではありません。そこで最後のセクションに、私なら実行する5タスクのテストを載せ、各項目には、そのモデルがどのタスクで勝つはずかを書いています。
1. Claude Opus 5.5:同じ請求額で高いスコア
向いている人: $4/$20 の最先端モデルが欲しかったチームで、その価格でスコアが高いものを選びたい場合。
Claude Opus 5.5 は、予算が何も変わらないので、このリストで最も直接的な乗り換え先です。Anthropic の料金ドキュメントには入力 $4、出力 $20、キャッシュヒット $0.20 とあり、Wonder と同じ3つの数字です。違いはスコアで、Artificial Analysis のインデックスで58、Wonder は52、Wonder 公開時点でこのインデックスの1位でした。
Meta 自身の表が Opus を後押ししています。Opus 5.5 は14行中6行で勝ち、コンピュータ操作(OSWorld は Wonder の 72.6 に対して 81.8)、ターミナルでのコーディング(52.0 に対して 59.6)、ゼロからのプログラミングを含みます。最後のものは表全体で最大の差で、ProgramBench は Opus 5.5 が 70.5、通常の Wonder が 50.0 です。Wonder が踏みとどまるのはメモリと長期のコーディングで、DeepSWE(74.2 に対して 78.8)と SWE-Marathon(46.3 に対して 53.1)では Opus 5.5 を上回ります。
実用面の利点も効きます。Opus 5.5 は Claude API に加えて Bedrock、Vertex、Foundry で動き、Batch なら価格は半分の $2/$10 になり、Anthropic の既定エフォートは現在 medium で、Artificial Analysis では1タスク $1.34 でスコア 51 です。エフォートの各レベルは Opus 5.5 レビューでさらに詳しく扱っています。
長所: Wonder と同じ価格、インデックスが6ポイント上、Meta の表でコンピュータ操作・ターミナル・ゼロからのコーディングでトップ、主要3クラウドで利用可能。
短所: tool_choice の強制指定(any や名前付きツール)はエラーを返すため、エージェントがそれに頼っていると影響します。最大エフォートは Artificial Analysis で1タスク約 $5.98。オープンウェイトではありません。
料金: 100万トークンあたり入力 $4、キャッシュヒット $0.20、出力 $20。5分キャッシュ書き込み $5、1時間 $8。Batch $2/$10。Fast モード $8/$40。全体の表は Opus 5.5 の料金にあります。
私の見方: Wonder を $4/$20 で本番に入れるつもりだったなら、まず Opus 5.5 を入れ、あなた自身のタスクで Wonder に上回らせてください。同じ価格なら、スコアの高いモデルが標準です。
2. Gemini 4 Argon:12月まで Wonder の半額
向いている人: 長い文書、長いエージェント実行、最先端モデル群で最も作り話の少ないモデルを求めるチーム。
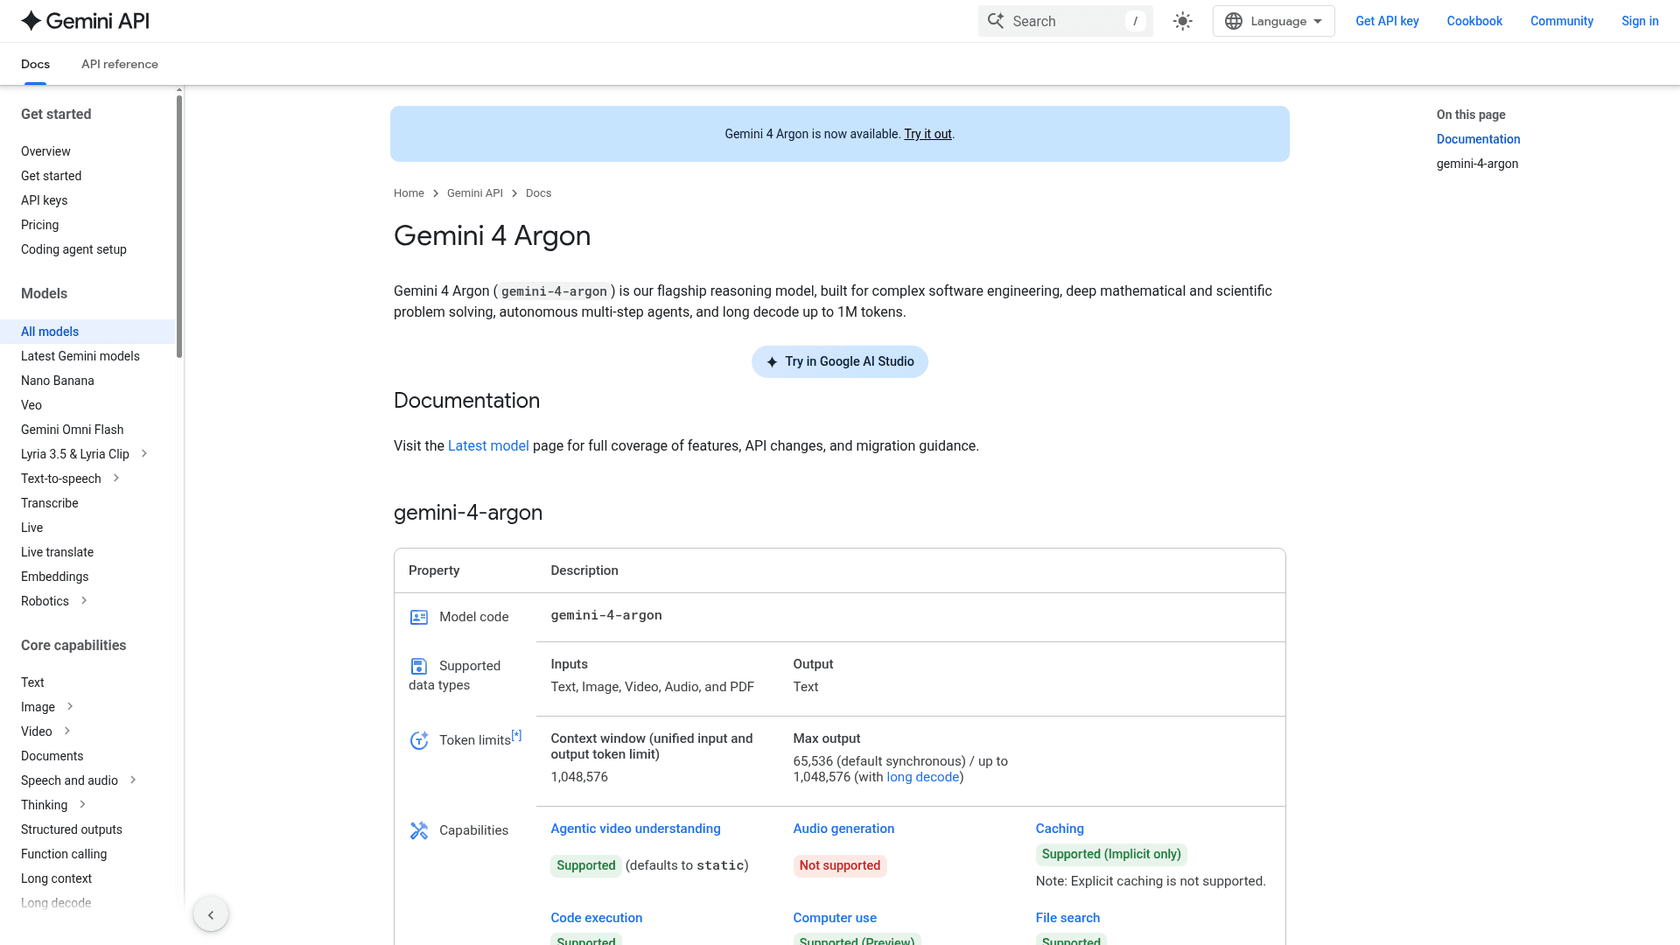
Wonder の公開日に、ある HN のコメントは Wonder を "available unlike Gemini 4 Argon" と褒めました。それは1日しか続きませんでした。Google の変更履歴によると、gemini-4-argon は10月13日に Gemini API で一般提供となり、現在は AI Studio でも使えます。Gemini 4 Argon レビューはまだ招待制だった時期に書かれたもので、以下の事実は Google の最新ドキュメントによります。
注目点は価格です。Google の料金ページでは、11月30日までは入力 $2、キャッシュ $0.10、出力 $10、その後12月1日から$4、$0.20、$20 で、これは Muse Wonder の料金表とまったく同じです。つまり約7週間は、インデックス53(Wonder より1ポイント上)のモデルを半額で使え、その後は同じ価格で使えます。
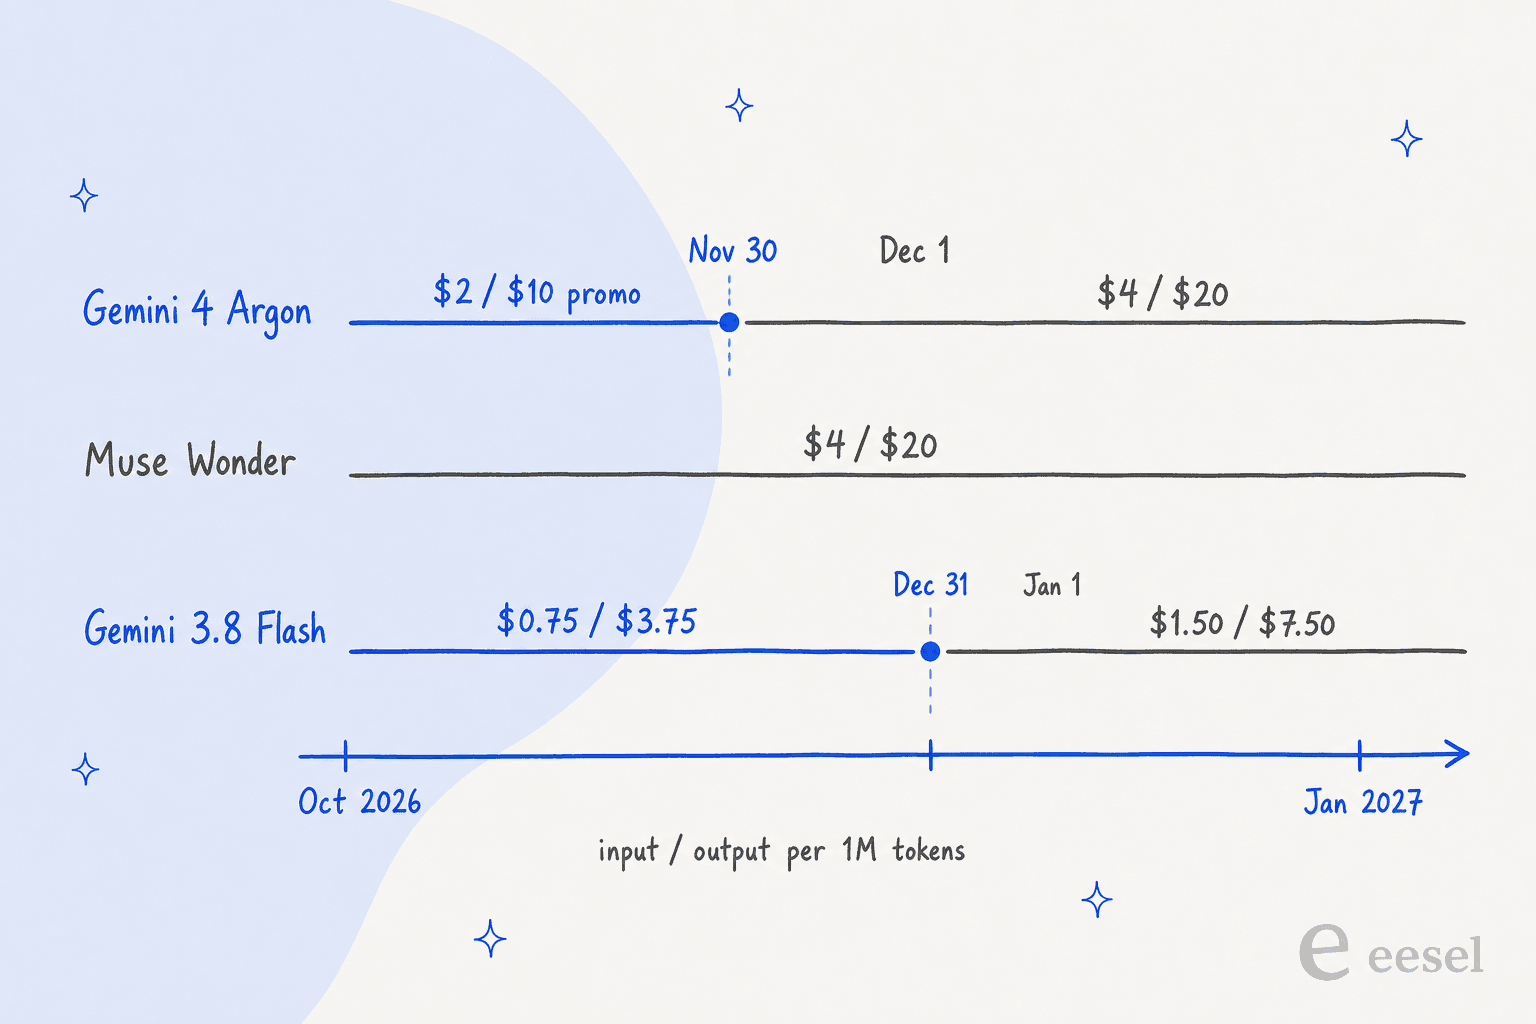
Argon が最も得意なのは長い作業です。モデルページには、統合された1,048,576トークンのウィンドウ、既定で65,536の出力トークン(long decode で最大1,048,576)、プレビューのコンピュータ操作、コード実行、ファイル検索、検索グラウンディングが記載されています。Artificial Analysis でのハルシネーション率は 15% で、私が確認したどの最先端モデルより低い値です。Google 自身のベンチマーク表では、金融、法務、業務ワークフローのタスクで首位ですが、これは Google の実行結果で、Meta の表にある AA 版ではありません。
長所: 11月30日まで Wonder の半額、インデックスが1ポイント上、最先端モデル群で最低のハルシネーション率、最大1Mの出力トークンの long decode、Batch と Flex は半額。
短所: プロモは12月1日に終了。明示的なコンテキストキャッシュは非対応(暗黙のみ)。無料枠なし。出力が多く、プロモ価格でも Artificial Analysis で1タスク約 $1.99。
料金: 11月30日まで $2 / $0.10 / $10、その後 $4 / $0.20 / $20。Batch と Flex は $1 / $5(その後 $2 / $10)。Priority は $3.60 / $18。Gemini 4 Argon の料金を参照してください。
私の見方: 長い文書と正確さが Wonder を求めた理由なら、安いうちに Argon を試してください。ただし12月1日以降の価格は予算に入れてください。その後は Wonder や Opus 5.5 と $4/$20 で真っ向から競うことになります。
3. Muse Wonder Full:同じファミリーの上位版
向いている人: Meta のコーディングエージェント内で、長いコーディングプロジェクト、法務文書の起案、金融リサーチを行う個人開発者や小規模チーム。
Meta のローンチ用グラフが理由で Wonder が気に入ったなら、そのグラフにふさわしいのは Wonder Full です。インデックスは56で、公開時点で Opus 5.5 に次ぐ2位、Meta の14行中6行で勝っています。社内の総合指標、法務(Opus 5.5 の 4.2 に対して 13.1)、金融、業務ワークフロー、DeepSWE、SWE-Marathon(46.3 に対して 57.5)です。この記事のほかのどのモデルも、これほど多くの長く文書量の多いタスクでは首位に立っていません。
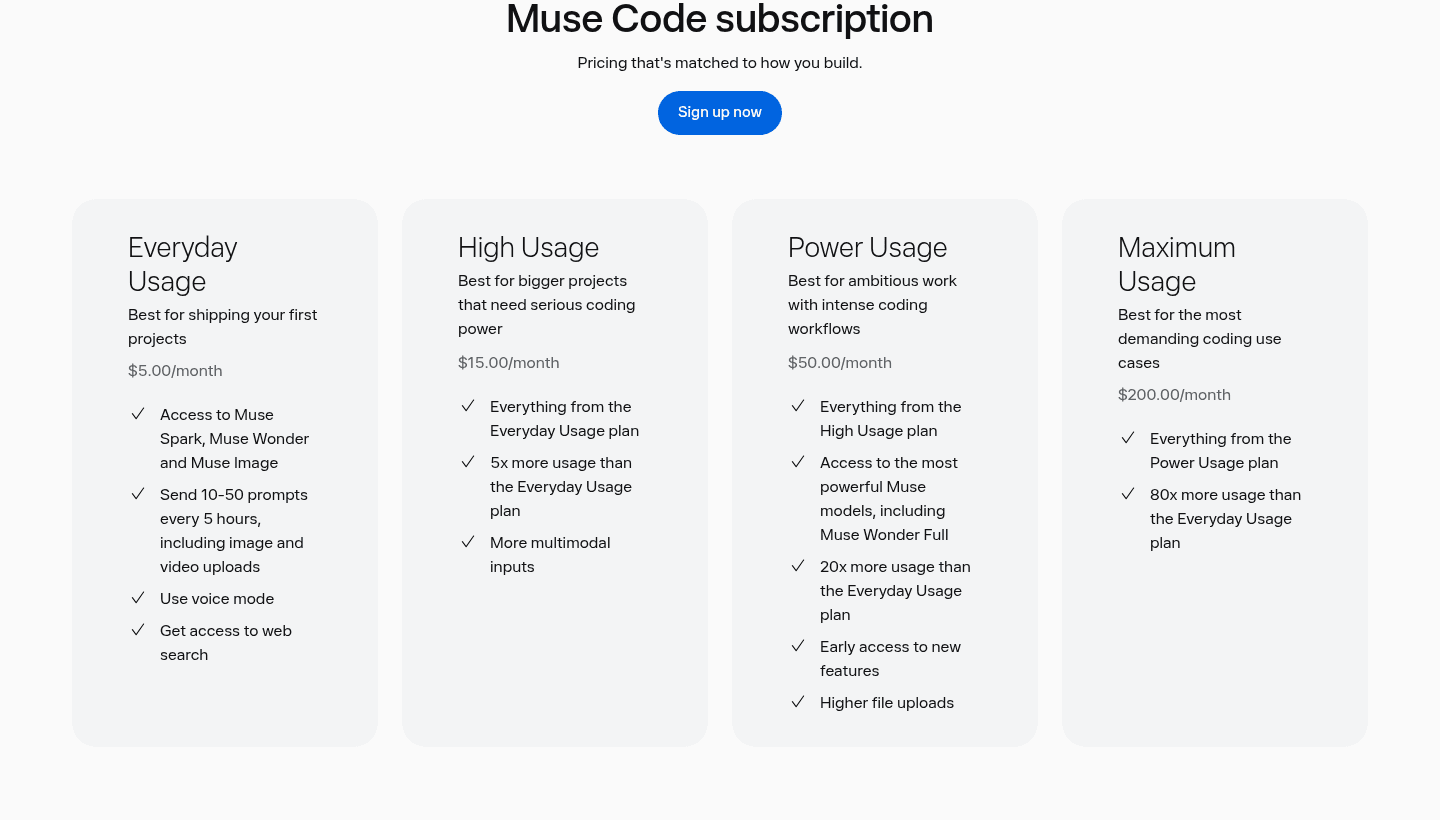
問題はアクセスです。Full は Muse Code の月額 $50 の Power Usage プランと月額 $200 の Maximum Usage プランにしかありません。トークン単価はなく、Meta のモデルドキュメントには、通常の Wonder でエフォートを max にしても選択されないとあります。また、サブスクリプションのキーは Muse Code CLI の中でしか動かないため、自社プロダクトのトラフィックを流すことはできません。
"Super interesting that they're not even making Wonder Full available outside of their own coding harness, and thus not providing an API price to use in comparisons."
支払う前に知っておくべきことが、あと2つあります。サブスクリプションのドキュメントによると、プランは既定で Contributor モードで、オフにするまで Meta があなたのプロンプト、コード、ファイルで学習できます。またプランは18歳以上限定で、返金はなく、提供状況は地域で異なります。あるコメントは、現時点で北米のみだと報告しています。
長所: Meta で最強のモデル、法務・金融・ワークフロー・非常に長いコーディングで首位、トークン課金ではなく月額定額。
短所: サブスクリプション専用で Muse Code 内のみ、Contributor モードが既定でオン、地域制限あり、アプリの動力には使えない。
料金: Power Usage 月額 $50(Everyday の20倍の利用量)、Maximum Usage 月額 $200(80倍)。安い Everyday($5)と High($15)は通常の Wonder のみ。詳しくは Muse Code の料金を参照してください。
私の見方: 自分のコーディング用に Wonder が欲しかったなら、API は飛ばして Full に $50 を払い、初日に Contributor モードをオフにしてください。プロダクトの中で Wonder を使いたかったなら、Full は選択肢になりません。項目1と2を見てください。同じ予算の他のコーディングエージェントは Muse Code の代替の記事で扱っています。
4. GPT-6.1 Sol:Wonder と同スコアを半額で
向いている人: Wonder 水準の品質で足りて、請求額が気になる本番アプリ。
GPT-6.1 Sol は Meta 自身のローンチ用グラフで52、Wonder と同じです。OpenAI の料金ページでは入力 $2、キャッシュ $0.10、出力 $10 で、どの行も Wonder のちょうど半分です。プロダクトチームにとって、このリストで最もすっきりした取引です。同じベンチマーク水準で、請求額は半分です。
タスクあたりの効率も良好です。Artificial Analysis は最大エフォートの 6.1 Sol を1タスク約 $0.72 と測定し、コーディングエージェントのインデックスでは xhigh エフォートが max を上回ります。1,050,000トークンのコンテキストウィンドウ、最大128,000の出力トークン、米国と EU のデータレジデンシーがあります。OpenAI 自身の DevDay での主張は、DeepSWE で GPT-6 Astra に匹敵しつつコストは約5分の1、というものでした。
Wonder と違うのは API の形です。6.1 Sol には none や minimal のエフォートがなく、Chat Completions はツール呼び出しなしでのみ動くため、エージェントは Responses API を使うべきです。入力272Kトークンを超えるプロンプトは、より高い料金で課金されます。
長所: Wonder と同じインデックススコアを半額で、タスクあたりが安い、コーディングエージェントでの結果が強い、EU のデータレジデンシー。
短所: none エフォートがない、ツール呼び出しに Responses API が必要、272Kを超える長いプロンプトは割高、オープンウェイトではない。
料金: 100万トークンあたり $2 / $0.10 / $10、キャッシュ書き込み $2.50。入力272K超は $4 / $0.20 / $15。Batch と Flex は $1 / $5。内訳は GPT-6.1 Sol の料金にあります。
私の見方: Wonder を看板ではなく堅実な働き手として使うつもりなら、これです。タスクを両方に通し、Wonder がはっきり勝たない限り、半額が勝ちます。
5. GPT-6 Astra:OpenAI の最上位、Wonder の2.5倍の価格
向いている人: すでに OpenAI を使っていて、その最上位モデルか Ultrafast の速度ティアが必要なチーム。
GPT-6 Astra は AI アシスタントの候補リストの最初の名前で、強力なモデルです。1,050,000トークンのウィンドウ、ホスト型シェル、apply-patch、コンピュータ操作、MCP が組み込まれ、Meta の専門業務の GDP.pdf の行では最高スコア(34.2)です。サイバーセキュリティで OpenAI が初めて「Critical」と評価したモデルでもあり、高度なサイバー利用は制限されています。
しかし数字は Wonder の置き換えとしては有利ではありません。Meta のグラフでスコアは53と Wonder より1ポイント上ですが、価格は100万トークンあたり入力 $10、出力 $50 で、Wonder の2.5倍です。Meta の表の14行中11行では Wonder Full が上回ります。Artificial Analysis では、最大エフォートの Astra は1タスク約 $3.26 です。
現時点で Astra だけが持っているものは Ultrafast です。OpenAI の料金ページで Ultrafast の料金があるのは Astra だけで、100万トークンあたり入力 $60、出力 $300 です。今月その速度ティアがプロダクトに必要なら、GPT-6 ファミリーで唯一の選択肢です。
長所: OpenAI で最強のモデル、組み込みのエージェントツール、Meta の表で GDP.pdf が最高スコア、唯一の Ultrafast の選択肢。
短所: インデックス1ポイントのために Wonder の2.5倍の価格、272Kを超える長いプロンプトは $20 / $75 で課金、Meta の行の大半で Wonder Full が上回る。
料金: 100万トークンあたり $10 / $1 / $50。Batch と Flex は $5 / $25、Fast は $20 / $100、Ultrafast は $60 / $300。GPT-6 Astra の料金を参照してください。
私の見方: 品質だけを理由に Wonder から Astra へ移ることはしません。OpenAI に統一していて Ultrafast が必要な場合、または自分のテストで専門文書に強いと分かった場合に選んでください。
6. Claude Sonnet 5.5:Opus の半額で、コーディングは近い
向いている人: Opus の半額で Anthropic の品質が欲しい、コーディングエージェントやツールを多用するアプリ。
Claude Sonnet 5.5 は入力 $2、出力 $10 で Wonder の半分、Anthropic の料金ドキュメントではキャッシュヒットも $0.10 と、Wonder の $0.20 の半分になりました。最大エフォートでの Artificial Analysis のスコアは56で、通常の Wonder を上回ります。Anthropic のローンチ時の数値では、Terminal-Bench 4.0 で Opus 5.5 さえ上回ります(66.4 に対して 70.6)。
注意点はエフォートです。その56は最大エフォートでの値で、Artificial Analysis は1タスク約 $7.60 と測定しており、Opus 5.5 より高くなります。high エフォートではスコア47で $1.08、Anthropic 自身も、節約が現れるのは low と medium のエフォートだと述べています。私の Sonnet 5.5 レビューでは、medium では素晴らしく、max では罠でした。
破壊的変更も伴って登場しました。tool_choice の強制指定はエラーを返し、thinking: disabled もエラーを返し、思考ブロックはモデルに紐づくため、会話履歴は追記のみにする必要があります。
長所: トークン単価は Wonder の半分でキャッシュヒットも安い、ターミナルでのコーディングが強い、Opus と同じ1Mウィンドウと128Kの出力。
短所: 最大エフォートではタスクあたり Opus 5.5 より高い、Sonnet 5 以降の API の破壊的変更、ツール使用の強制ができない。
料金: 100万トークンあたり $2 / $0.10 / $10。5分キャッシュ書き込み $2.50、1時間 $4。Batch $1 / $5。内訳は Sonnet 5.5 の料金にあります。
私の見方: low か medium のエフォートで使うなら、コーディングエージェント向けの Wonder の良い置き換えです。max に上げたくなったら、代わりに Opus 5.5 に切り替えてください。
7. Muse Spark 1.3:大量処理に対する Meta 自身の答え
向いている人: 大量処理やレイテンシに敏感な作業で、Meta の API に留まりたいチーム。
これは Meta 自身が勧める代替です。モデルドキュメントでは、Wonder を長時間で複雑なタスク向けとし、大量処理、レイテンシ重視、コスト重視の作業は Muse Spark に振っています。Muse Spark 1.3 は100万トークンあたり入力 $1.25、キャッシュ $0.15、出力 $4.25 で、Wonder の出力価格の4分の1以下、Meta のグラフでのスコアは48です。
日常的に使うユーザーは、価格のわりに評価しています。
"I've been a regular user of muse spark 1.3 ... and I can tell you one thing for sure that this model, muse-spark-1.3 in xhigh mode, is between sol-6-medium and high."
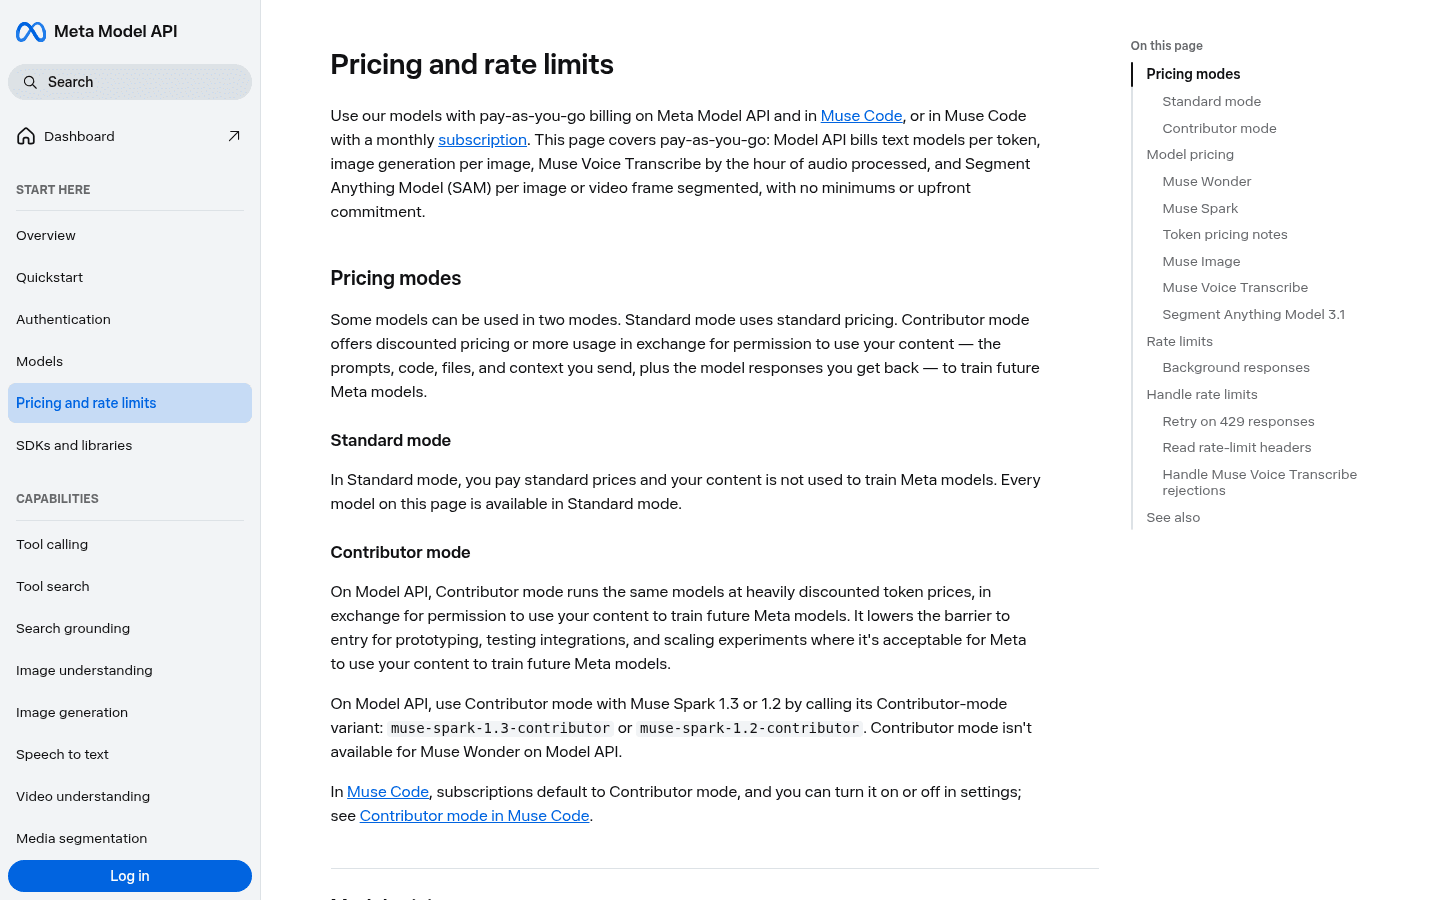
Spark には Wonder にないものもあります。API の Contributor 版です。Meta の料金ページによると、muse-spark-1.3-contributor は、Meta があなたのコンテンツで学習できる代わりに、大幅に割り引かれた価格(約 $0.10/$0.20)で動きます。Contributor モードは API の Wonder では使えません。試作には良い取引ですが、顧客データには悪い取引です。もうひとつ、Spark 1.3 は冗長で、Artificial Analysis のインデックスを完了するのに約1億2,000万の出力トークンを使い、中央値の7,200万を上回ります。
長所: Wonder の出力価格の4分の1以下、同じ API・同じベンダーなので振り分けが簡単、機密でない作業向けの任意の Contributor 割引。
短所: インデックスで Wonder より4ポイント低い、冗長で節約分を食う、Meta が約束した Spark のオープンウェイトは未公開。
料金: Standard は100万トークンあたり $1.25 / $0.15 / $4.25。Contributor 版は約 $0.10 / $0.20 で、データは学習に使われます。Muse Spark 1.3 の料金を参照してください。
私の見方: Meta での賢い構成は、選ぶことではなく振り分けです。大半のリクエストは Spark に、長くて難しいものは Wonder に。トラフィックの大半が単純なら、それだけで請求額は大きく下がります。
8. Gemini 3.8 Flash:無料枠のある安い選択肢
向いている人: バッチ処理、試作、最初のトークンを誰も待たないコスト優先のパイプライン。
これは AI アシスタントが Gemini 3.5 Flash で埋めた「速度とコスト」の枠で、Google はその後これを廃止しました。現行の Gemini 3.8 Flash は100万トークンあたり入力 $0.75、出力 $3.75 で、Wonder の約5分の1、このリストで唯一無料枠があるモデルです。Google は3.7 Flash も10月8日に廃止し、そのリクエストを 3.8 に振り分けています。
Artificial Analysis では high エフォートでスコア41と Wonder をかなり下回り、1タスク約 $1.24 です。注意点は2つあります。まず、価格は2027年1月1日に $1.50/$7.50 へ倍増します。次に、Artificial Analysis は最初のトークンまで13.30秒と測定しており、チャットウィジェットのように人が待つものには向きません。
無料枠については、Google の料金ページに、あなたのコンテンツは同社製品の改善に使われるとあり、有料枠では使われません。
長所: Wonder の約5分の1の価格、テスト用の無料枠、Batch と Flex は半額、1Mウィンドウ。
短所: インデックスで Wonder を大きく下回る、最初のトークンが遅い、1月1日に価格が倍増、無料枠はデータを学習に使う。
料金: 12月31日まで100万トークンあたり $0.75 / $0.075 / $3.75、その後 $1.50 / $0.15 / $7.50。Batch と Flex は50%オフ。Gemini 3.8 Flash の料金を参照してください。
私の見方: Wonder では払いすぎになる夜間のバッチ処理に向いています。Wonder の難しいタスクの代わりにはならず、リアルタイムの用途にも向きません。
9. DeepSeek V4.1 Flash:オープンウェイトで最小の請求額
向いている人: オープンウェイトか、トークンあたり最低のコストが必要なチーム。
Muse Wonder はオープンウェイトではなく、Meta は Muse Spark で約束した重みもまだ公開していません。自分で動かせるモデルが必要なら、ここでは DeepSeek V4.1 Flash が最も強い選択肢です。Hugging Face の MIT ライセンスの重み、1Mのコンテキストウィンドウ、最大384Kの出力トークンがあります。
ホスト型 API は非常に安価です。DeepSeek の料金ページでは、deepseek-flash はオフピークで100万トークンあたり入力 $0.15、出力 $0.60、ピーク時間帯(UTC の平日午前)は $0.30/$1.20 です。オフピークではWonder の出力価格の約3%です。Artificial Analysis は最大エフォートで39.5、1タスク約 $0.27 と評価しています。
トレードオフは現実的です。Artificial Analysis でのハルシネーション率は 96% で、現行モデルで私が見た中で最も高く、厳格なグラウンディングが必要です。ホスト型 API はデータを中国で処理し、有料の規約にはデータが学習に使われるかどうかの記載がありません。セルフホストならデータの問題は解決しますが、5,520億パラメータのモデルには本格的なハードウェアが要ります。
長所: MIT のオープンウェイト、このリストで最安、コストのわりにツール利用の結果が強い、最大出力384K。
短所: インデックスで Wonder より12.5ポイント低い、ハルシネーション率が非常に高い、ホスト型 API のデータ懸念、セルフホストが重い。
料金: オフピークで100万トークンあたりキャッシュヒット $0.003、入力 $0.15、出力 $0.60。ピークは倍。DeepSeek V4.1 Flash の料金を参照してください。Kimi K3 はもうひとつのオープンウェイトの選択肢で、$3/$15 です。
私の見方: オープンウェイトが必要な場合や、機密でないテキストの大量処理に選んでください。自信満々の間違った答えが高くつく用途には近づけないでください。
候補の試し方:全ファイナリストに同じ5タスク
ここは、ベンチマーク表があなたの代わりにはできない部分です。上から2〜3のファイナリストを選び、Wonder 自身も加えて、それぞれに同じ5つのタスクを実行します。実行ごとに3つの数字を記録します。合格か不合格か、コスト、秒数です。
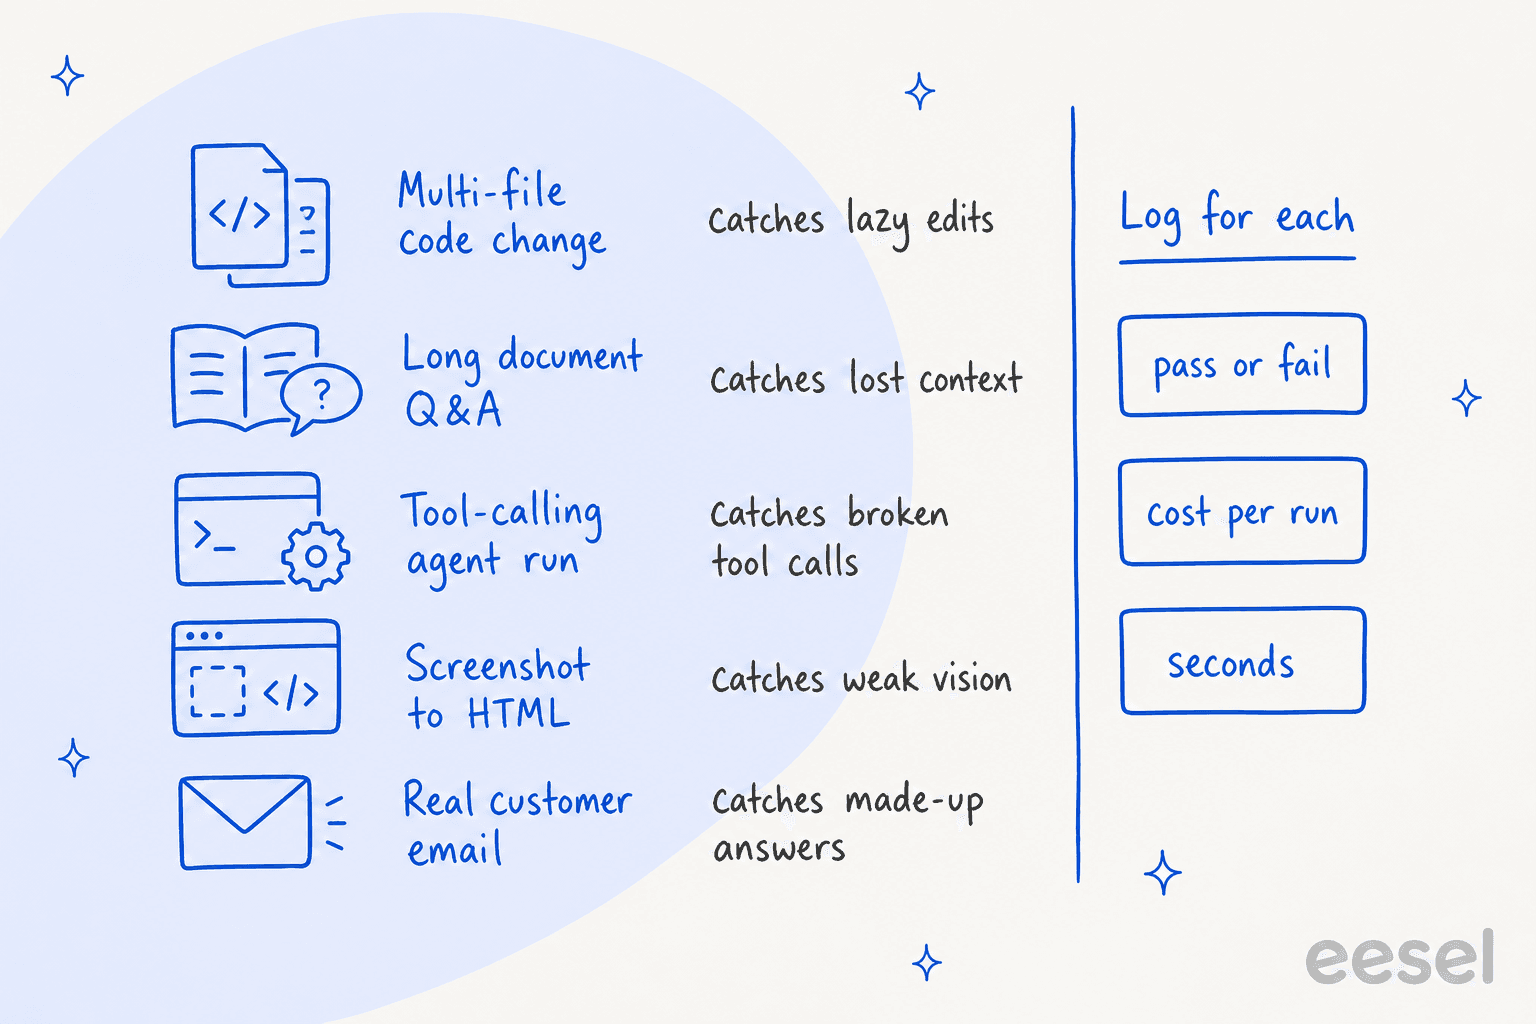
各タスクは特定の失敗を見つけるためにあります。そして各ファイナリストには、ベンチマークが正直なら勝つはずのタスクがあります。
| ファイナリスト | 最初に試すこと | 主な問い |
|---|---|---|
| Claude Opus 5.5 | スクリーンショットから HTML、複数ファイルのコード変更 | 同じ価格で Wonder が何かで上回るか? |
| Gemini 4 Argon | 長い文書への質問 | 500Kトークンでも正確さを保てるか、12月の価格でも筋が通るか? |
| Muse Wonder Full | Muse Code での複数ファイルのコード変更 | 通常の Wonder より月額 $50 多く払う価値があるか? |
| GPT-6.1 Sol | ツール呼び出しを伴うエージェント実行 | 半額で本番に足りる品質か? |
| Muse Spark 1.3 または Gemini 3.8 Flash | 実トラフィックのいちばん簡単な80% | 安いモデルがほとんどのリクエストを引き受けられるか? |
スクリーンショットから HTML のタスクには理由があります。ある開発者が公開日にこれを実行し、通常の Wonder が Opus 5.5 よりずっと弱く、Sonnet や Haiku に近いと感じました。1時間のテストで見つかり、ベンチマーク表には隠れる差がこれです。
テストは繰り返せる小ささに保ってください。モデルの価格とバージョンは数週間ごとに動きます(Argon は12月1日、Flash は1月1日)。適切なモデルに留まる最も安い方法は、何かがリリースされるたびに同じ5タスクを再実行することです。
モデルを替えることがサポートチームにとって意味すること
開発者なら、上のテストが次の一手です。Wonder の公開報道からたどり着いたサポート責任者なら、正直な答えは違います。AI サポートエージェントの中で、モデルは最も小さな部分です。
どのモデルを選んでも、誰かがそれをヘルプデスクにつなぎ、承認済みナレッジの範囲に回答を収め、いつ人に引き継ぐかを決め、顧客の目に触れる前に正しいと証明しなければなりません。これらは私が最も時間をかけて作っている仕事で、モデルが変わってもどれも変わりません。カスタマーサポート向け Muse と Zendesk 向け Muse の記事は、素のモデルでどれだけのつなぎ込みが必要かを示しています。
だからこそ、上の DeepSeek と Gemini Flash のハルシネーションの数字は、コードよりサポートで重要です。間違ったコード1行はテストを落とすだけです。間違った返金ポリシーは顧客に届きます。どのみち自分で構築するなら、サポートチケットに最適なモデルのガイドがこの仕事に絞ってモデルを比較し、AIエージェントとチャットボットの解説がエージェント層が加えるものを扱っています。
eesel を試す
Muse Wonder とこのリストのすべてのモデルはインフラで、eesel は従業員です。eesel は、特定の仕事に就ける即戦力のチームメイトを迎える AI チームメイトのプラットフォームで、現在は2つの役割があります。AIヘルプデスク用チームメイトと AIブログライターです。どちらも最先端モデルで動くため、毎月モデルの比較をやり直さなくても、モデルの進化の恩恵を受けられます。
ヘルプデスク用チームメイトは Zendesk、Freshdesk、Gorgias に接続し、過去のチケットとヘルプセンターから学び、あなたが承認した内容だけから回答します。誰かに返信する前に、過去のチケットで実行して、何と答えたかを確認できます。プランは月額定額で、1チケットが1クレジットです。月額 $299 から500クレジット、開始時に100クレジット無料で、eesel の料金ページに基づきます。

ここまで読んだ方はおそらく開発者でしょうから、eesel CLI も知っておく価値があります。npm パッケージ(@eesel/cli)で、ダッシュボードと同じチームメイトとワークスペースを、ターミナル、スクリプト、または Claude Code のようなコーディングエージェントから操作できます。eesel activity はチームメイトが行ったことを一覧し、任意の実行を詳しく読めます。eesel approvals list は人の判断を待つアクションを表示し、--dry-run は変更が行う呼び出しを送信せずにそのまま出力します。すべてのコマンドは JSON を出力し、ワークスペースは MCP サーバーとしても動くため、エージェントがあなたと同じように管理できます。ターミナルからエージェントを管理するガイドで手順を説明しています。
Wonder に目が留まったのが、AI にサポートキューを任せたいからなら、モデル選びは飛ばして、ご自身のチケットで eesel を試してください。