2026年版 MAI-Transcribe-2のおすすめ代替サービス8選

Kira

Katelin Teen
最終更新 September 8, 2026
MAI-Transcribe-2はMicrosoft AIの新しい音声認識モデルで、非常に優れています。60言語の平均単語誤り率は5.2%、ローンチ価格は1時間あたり0.10ドルです。自社のスタックに合うなら、現時点で最も強力な選択肢の一つです。ただし、その価格はプロモーションで、バッチ専用のプレビュー版でSLAもなく、Azureの中で動くため、別の選択肢を望むチームも多いでしょう。
ここでは8つの代替サービスと、それぞれを選ぶ理由を一言で紹介します。
- Google Gemini 3.5 Transcribe - 最も精度が近く、すでにGoogleを使っているなら当然の選択。
- ElevenLabs Scribe v2 - メディアや吹き替え向けで、32人の話者分離と音声イベントのタグ付けに対応。
- Deepgram - リアルタイムの音声エージェントや電話ストリーミング向け。
- AssemblyAI - 文字起こしに加え、要約・感情分析・マスキングの機能を内蔵。
- OpenAI GPT-Transcribe - 既存のOpenAIパイプラインに最も簡単に組み込める。
- Speechmatics - 最も幅広い言語対応と、本格的なオンプレミス導入。
- Amazon Transcribe - データがすでにAWSにあるなら標準的な選択。
- OpenAI Whisper - 自前でホストする無料のオープンソースモデル。
先にひとつ言っておくと、私はeeselでAIエージェントを作っており、それがこのカテゴリ全体の見方を形作っています。正確な文字起こしは、誰かが本当に欲しかったものではありません。それは原材料です。どのモデルを選んでも、誰かがテキストを読み、答えを見つけ、チケットを解決する必要があり、それは文字起こしとは別の仕事です。
なぜMAI-Transcribe-2の先を見るのか
まず現行の本命に公平であるべきです。それだけの実力があります。MAI-Transcribe-2はMicrosoftのFLEURS精度比較でトップにあり、1時間の音声を約10秒で文字起こしし、1時間0.10ドルで他をすべて下回ります。初期の開発者の声を読むと、作り物ではない反応が並んでいました。あるインディー開発者は、難しい実環境のクリップを試しました。
「エコーの多いスロバキア語の説教を通してみました... ElevenLabsよりずっと良い結果で、価格は45%でした。」
ノイズやエコーの多い非英語の音声は、力の弱いモデルを確実に壊します。つまりこれは本物のシグナルです。それでも、なぜ他を探すのか。モデル自体への批判ではない、3つの具体的な理由があります。
第一に、価格は動く的です。0.10ドルは「年末まで」のローンチプロモーションで、その後どうなるかMicrosoftは明言していません。参考までに、旧世代のMAI-Transcribe-1.5は今も1時間0.36ドルで掲載されているため、v2の通常料金がその範囲に落ち着いても誰も驚きません。Hacker Newsのコメント投稿者は、Microsoftが答えていない点をそのまま尋ねています。
「これはストリーミングで使えるの?それともバッチだけ?(年末までの)ローンチ割引が終わった後の価格は出てる?」

第二に、これはパブリックプレビューでSLAなしで公開されており、Microsoftも本番利用には向かないと明記しています。主なAPIはバッチ専用でファイル上限は300MBです。ライブ音声には別途Voice Liveの設定が必要です。第三に、これはAzureのモデルなので、Azure Speech、開発者プレイグラウンド、またはサードパーティのルーター経由で使い、単独のアプリではありません。他の環境で構築しているなら、そのエコシステムの引力は現実のコストです。
これらはMAI-Transcribe-2が悪い選択だという意味ではありません。「今日いちばん安くて正確」であることと「あなたのプロジェクトに最適」であることは違う、というだけで、その隙間にこれらの代替サービスがあります。
比較の方法
私はこれらのAPIの中で多くの時間を過ごし、ドキュメント、料金ページ、パラメーター一覧を読み込みました。そのため、マーケティングの箇条書きではなく、アーキテクチャを実際に左右する観点を選びました。重要なのは次の5点です。
- 精度:単語誤り率(WER、モデルが間違える単語の割合)で測定。低いほど良い。
- 音声1時間あたりの価格:同じ条件で比較できるよう正規化。
- バッチかリアルタイムか:バッチ専用のモデルは、どれだけ正確でもライブの電話エージェントを動かせないため。
- 話者分離とタイムスタンプ:文字の壁を使えるものに変える、話者ラベルと単語単位のタイミング。
- 導入形態:自社のハードウェアで動かせるか、ベンダーのクラウドに音声を送る必要があるか。
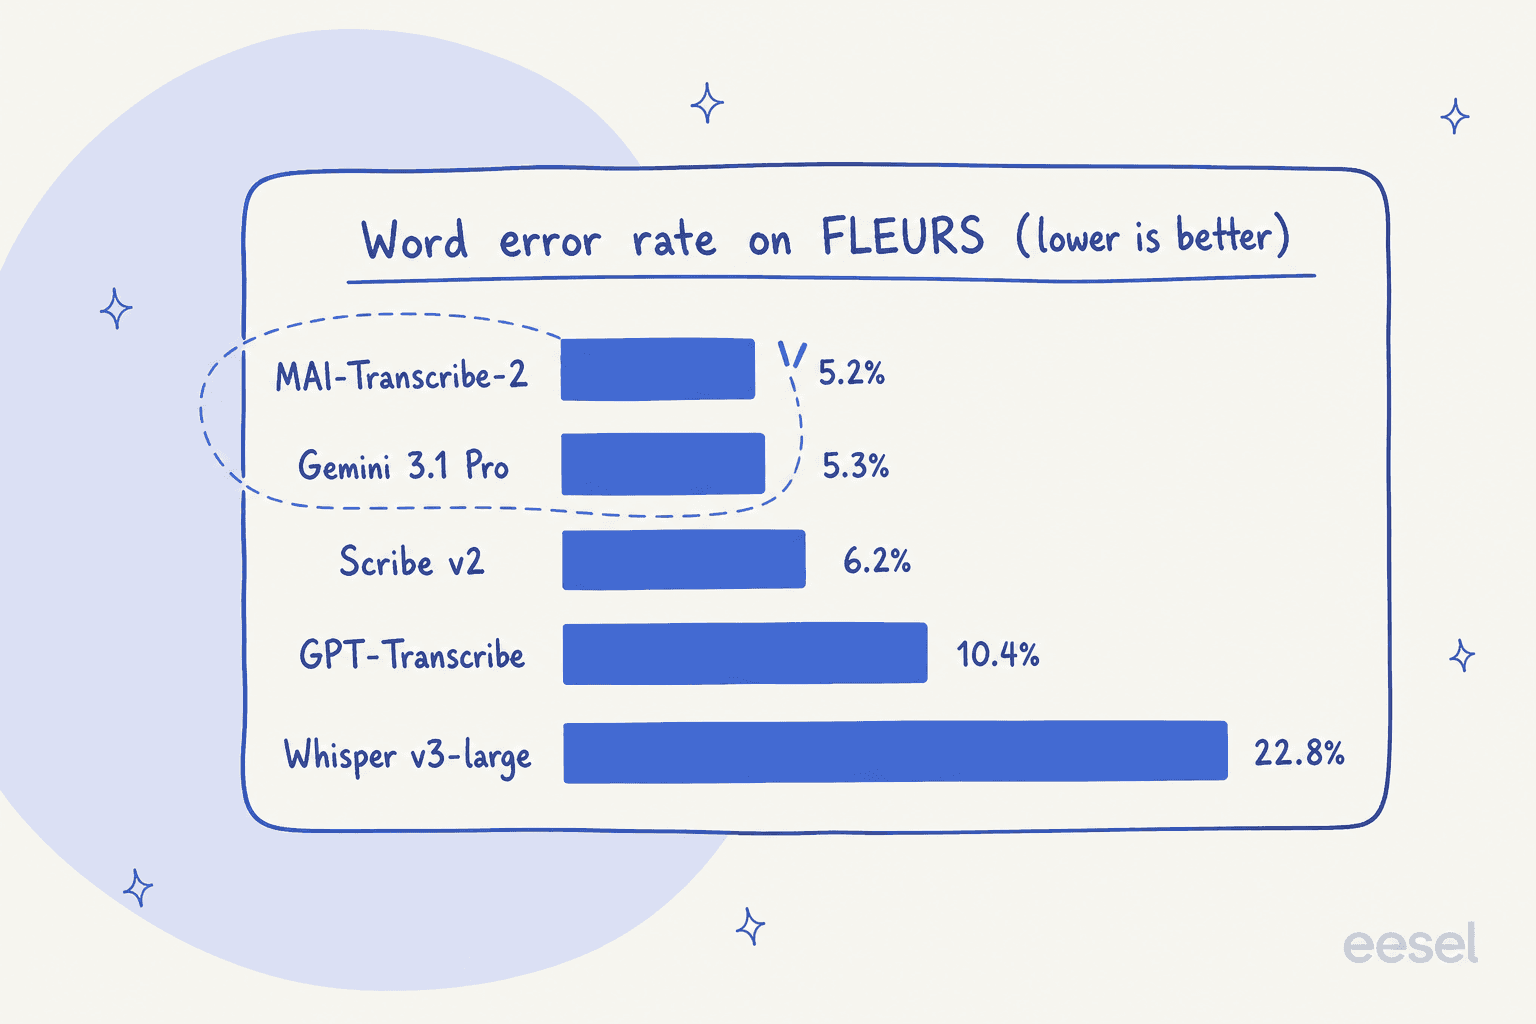
純粋な精度では、Microsoft自身のFLEURS比較での各モデルの位置は次のとおりです。このグラフで押さえておくべき点は、上位はほぼ同率で、本当の差は上位勢と古いオープンなWhisperの間にあるということです。
MAI-Transcribe-2の代替サービス一覧
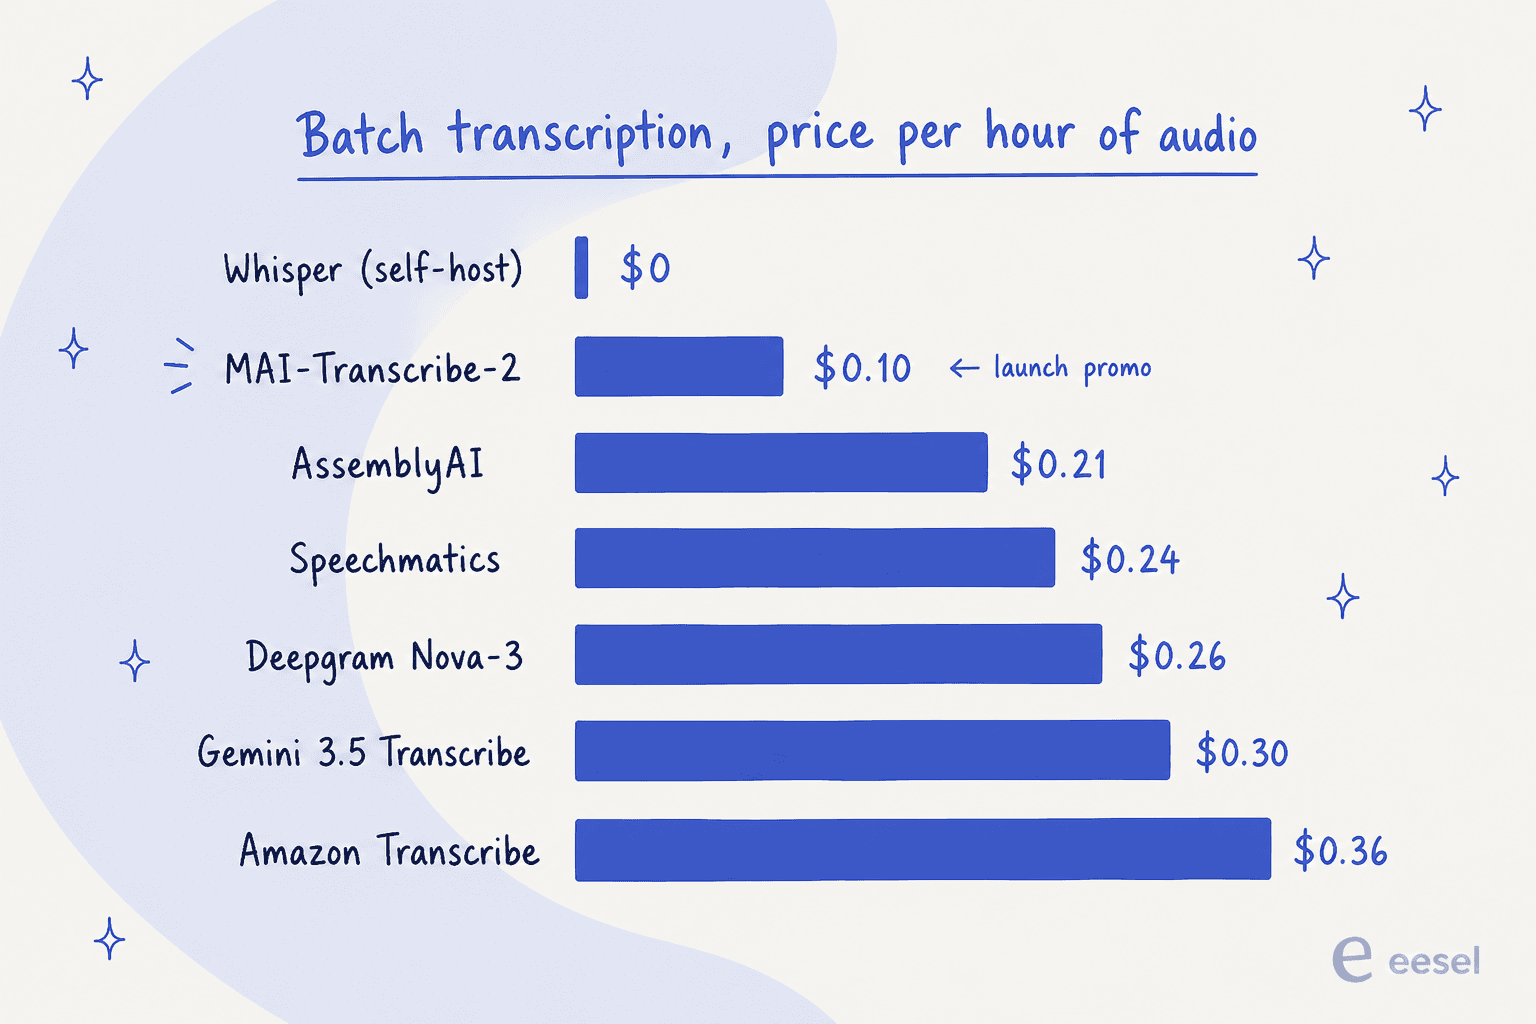
詳細に入る前に、全体を一つの表にまとめます。価格は標準的なバッチ文字起こしの音声1時間あたりで、各ベンダーが公表している分単価またはトークン単価から換算しています。
| モデル | 最適な用途 | バッチ価格/時間 | リアルタイムストリーミング | 言語数 | 話者分離 | 自前ホスト | 無料枠 |
|---|---|---|---|---|---|---|---|
| MAI-Transcribe-2 | 最安の多言語バッチ | $0.10(プロモ) | Voice Live経由のみ | 60+ | あり | 不可 | なし |
| Gemini 3.5 Transcribe | 最も近い精度 | 約$0.30 | あり(ライブモデル) | 85+ | 最大8人 | 不可 | あり |
| ElevenLabs Scribe v2 | メディアと吹き替え | $0.22 | あり(リアルタイム) | 90+ | 最大32人 | 不可 | 月10,000クレジット |
| Deepgram | リアルタイム音声エージェント | $0.26 | あり(強み) | 40+ | あり | 可(Enterprise) | $200クレジット |
| AssemblyAI | 音声インテリジェンス | $0.21 | あり | 99+ | あり | 不可 | 185時間 |
| OpenAI GPT-Transcribe | OpenAIネイティブのパイプライン | $0.27 | ストリーミング出力 | 99+ | 別モデル | 不可 | なし |
| Speechmatics | 言語の幅、オンプレミス | $0.24 | あり(1秒未満) | 55+ | あり | 可(Enterprise) | $100クレジット |
| Amazon Transcribe | すでにAWSを使うチーム | $0.36 | あり | 100+ | あり | 不可 | 月60分(12か月) |
| Whisper(オープンソース) | API費用ゼロ | $0(自前ホスト) | なし(バッチ) | 99+ | アドオン | 可 | 無料 |
有料のバッチ価格は、多くの人が想像するよりずっと狭い範囲に集まっています。MAI-Transcribe-2のプロモーションが終われば、全体が数セント差に収まります。
1. Google Gemini 3.5 Transcribe
最適な用途: MAI-Transcribe-2に最も近い精度を求め、すでにGoogle上で構築しているチーム。
GoogleはMAI-Transcribe-2と真っ向から渡り合える代替です。Microsoft自身のFLEURS表では、Gemini 3.1 Proが5.3%で0.1ポイント差であり、Googleは専用の音声認識モデルgemini-3.5-transcribeと、ストリーミング版のgemini-3.5-transcribe-liveも提供しています。この分け方が重要です。ファイル用モデルは1リクエストあたり最大1時間の音声を扱え(話者分離や単語単位のタイムスタンプを有効にすると30分)、ライブ用モデルはWebSocketによる低遅延ストリーミングを行います。
機能は一通り揃っています。文の途中での言語切り替えに対応する85以上の言語、最大8人の話者分離、単語単位のタイムスタンプ、最大1,000語のカスタム語彙の重み付けです。単なる文字起こしのエンドポイントというより、音声理解のスタック全体に近い印象です。
価格面では、専用モデルはトークン課金です。音声入力は100万トークンあたり2.00ドル、テキスト出力は100万トークンあたり12.00ドルで、合算すると1分あたり約0.005ドル、1時間あたり約0.30ドルになります。試せる無料枠もあり、入り口としても良好です。
私たちの見解: 精度が唯一の決め手で、Azureにこだわらないなら、これが最有力です。ベンチマークでMAI-Transcribe-2と互角に渡り合う唯一のモデルであり、自社提供のストリーミング版があることで、MAIが残している最大の穴も埋まります。注意点は、Google自身はWERの数値を公表していないため、正確な数値はMicrosoftの比較を信頼することになる点です。
2. ElevenLabs Scribe v2
最適な用途: 豊富な話者ラベルと音声イベントのタグ付けが必要な、メディア、ポッドキャスト、吹き替えのチーム。
ElevenLabsは音声生成で名を上げた会社で、Scribeはその音声認識側です。現行の主力はscribe_v2で、遅延が約150msのscribe_v2_realtimeというバリアントもあります。MicrosoftのFLEURS比較では6.2%で、上位勢の一歩後ろですが十分に強い位置です。ElevenLabs自身は言語別のWER内訳とともに98%超の文字起こし精度を掲げています。
Scribeが抜きん出ているのは出力の豊かさです。90以上の言語に対応し、最大32人の話者を分離し(ここでは最多)、笑い声や音楽といった動的な音声イベントにタグを付け、65種類のエンティティを認識します。字幕を作る人や複数話者の録音を文字起こしする人にとっては、この細やかさこそが要点です。
料金は時間課金です。Scribe v2はバッチで1時間0.22ドル、リアルタイムで0.39ドルで、エンティティ検出(+0.070ドル/時間)やキーターム指定(+0.050ドル/時間)などのアドオンがあります。無料枠は月10,000クレジットですが、商用ライセンスは含まれません。ある開発者はHacker Newsで実用面の魅力をこうまとめています。
「ElevenLabsのScribeモデルも精度が特に高く、高品質な文字起こしに使っていますし、話者分離とタイムスタンプが欲しいときはファイルを手動でAPIにアップロードしています。」
私たちの見解: Scribe v2は、32人の話者分離と音声タグ付けが活きるメディア用途で、まず打ち勝つべき存在です。生のWERではやや劣り、最安の選択肢より高価ですが、コンテンツチームには出力品質がそれに見合います。単純なサポート通話の文字起こしなら、より安いモデルでも同じ中核の仕事ができます。
3. Deepgram
最適な用途: リアルタイムの音声エージェント、電話システム、ライブ音声をストリーミングするあらゆる製品。
Deepgramはリアルタイム文字起こしで開発者に人気があり、MAI-Transcribe-2が標準では得意としないライブストリーミングへの最も明快な答えです。AI音声企業のまとめ記事の多くに登場するのも当然です。主力のNova-3はバッチとストリーミングの両方に対応し、新しいFluxというモデルはターン検出を組み込んだ、音声エージェント専用の設計です。電話の自動応答や、ライブのエージェントに音声をつなぐなら、開発者はまずここから始めます。
価格は攻めた設定で、しかも驚くほど透明です。Nova-3は録音済み音声で1分0.0043ドル(1時間約0.26ドル)、ストリーミングで1分0.0048ドルで、端数処理なしの秒単位課金です。試用には約750時間分にあたる200ドルの無料クレジットがあります。40以上の言語に対応し、話者分離と単語のタイムスタンプを備え、専門用語向けのキーターム指定もサポートします。
もう一つ触れておきたいのは導入形態です。DeepgramはEnterpriseプランで自前ホストのコンテナを提供し、SOC 2、HIPAA、GDPR、EUデータレジデンシーに対応しているため、規制のあるチームも音声を自社インフラ内に置けます。ここに挙げたクラウド専用のAPIにはない、本物の差別化要素です。
私たちの見解: リアルタイム用途なら、MAI-Transcribe-2よりDeepgramが私のデフォルトの推薦です。言語数はGeminiやWhisperより少ないものの、ストリーミング遅延、秒単位課金、自前ホストの選択肢が、ライブ音声製品の実用的な選択にしています。音声がすべて録音済みファイルなら、精度上位のモデルが勝る場合もあります。
4. AssemblyAI
最適な用途: 1回のAPI呼び出しで、文字起こしに加えて要約・感情分析・マスキングも欲しいチーム。
AssemblyAIの主張は、文字起こしは最初の一歩にすぎないということです。主力のUniversal-3.5 Proが音声認識を行い、その上にAudio Intelligenceの層が載ります。要約、感情分析、トピック検出、エンティティ検出、PIIのマスキング、そして音声に対して言語モデルのプロンプトを実行するLLM Gatewayです。本来なら3つのサービスをつなぐところを、AssemblyAIなら1つで済みます。
価格は時間単位で、ここでは最も低い部類です。Universal-3.5 Proは非同期で1時間0.21ドル、リアルタイムで0.45ドルで、旧世代のUniversal-2は1時間0.15ドルまで下がります。インテリジェンス機能は時間単位で別料金のため、有効にした分だけ支払います。無料枠は豊富で、録音済み185時間とストリーミング333時間がカード不要で使えます。
正直な注記を一つ。AssemblyAIは「実世界の音声で業界トップクラスの精度」を掲げていますが、主要ページにFLEURSの数値は一つも載せておらず、Microsoftの比較には登場しません。選ぶ理由はインテリジェンス層と価格であり、確認できるWERの見出しではありません。
私たちの見解: 通話の要約や感情スコアのように、文字起こしだけでなく分析が必要な製品なら、AssemblyAIは2社目のベンダーを継ぎ足す手間を省いてくれます。生の文字起こしだけなら競争力はありますが、精度上位勢より明確に良いとは言えません。大きな無料枠のおかげで試しやすいです。
5. OpenAI GPT-Transcribe
最適な用途: すでにOpenAIのパイプラインを運用していて、同じSDKで文字起こしをしたいチーム。
OpenAIは文字起こしのラインナップをひっそり刷新しました。gpt-transcribeが今は推奨のデフォルトで、gpt-4o-transcribe、gpt-4o-mini-transcribe、旧世代のwhisper-1も引き続き利用できます。MicrosoftのFLEURS表では、GPT-Transcribeは10.4%で上位勢にかなり後れを取りますが、実世界のレビューはその数字が示すより好意的です。
「UtterはクラウドでのデフォルトにGPT-4o Transcribeを使っていて、私の経験ではクラス最高です。差が最もはっきり出るのは、人名、ニッチな専門用語、技術用語です。」
料金は音声1分あたりで、gpt-transcribeは1分0.0045ドル(1時間約0.27ドル)、gpt-4o-transcribeは0.006ドル、gpt-4o-mini-transcribeは安価な0.003ドルです。ファイルは25MBまでで、約99の言語を自動検出付きでサポートします。
計画に入れておきたい落とし穴が一つあります。基本のモデルには話者ラベルがありません。話者分離は別のモデルgpt-4o-transcribe-diarizeにあり、単語単位のタイムスタンプは旧世代のwhisper-1でしか得られません。必要なメタデータによっては、「ひとつのAPI」という整った話にいくつか注釈が付きます。
私たちの見解: GPT-Transcribeを選ぶ理由は、精度ではなく統合のしやすさです。すでにOpenAIを呼んでいるなら、文字起こしの追加は1行の変更で、人名や専門用語での実用的な品質も評判が良いです。多言語での精度が最優先なら、ベンチマークはまずGeminiかMAIを見るよう示しています。
6. Speechmatics
最適な用途: 最も幅広い言語とアクセントへの対応、およびオンプレミス導入が必要なチーム。
Speechmaticsは、アクセントに左右されない精度と「グローバルファースト」の言語方針を軸にした、エンタープライズ向けの専門ベンダーです。55以上の文字起こし言語と方言、さらに69の翻訳ペアをカバーし、多言語モデルMeliaは会話の途中での言語切り替えにも対応します。複数言語が混ざる音声では大きな強みです。
価格は時間単位のクレジット制で、段階がはっきりしています。バッチはMeliaモデルの1時間0.129ドルからEnhancedモデルの0.40ドルまで、Standardは0.24ドルで、リアルタイムは0.24〜0.43ドルです。100ドルの無料クレジットがあり、月500時間を超えると自動で20%割引されます。G2では70件のレビューで5点満点中4.7点です。
際立つのは導入形態です。Speechmaticsは、プライベートクラウド、コンテナ、仮想アプライアンス、さらにはオンデバイスまで本格的な自前ホストを提供しており、すべてEnterpriseティアで、SOC 2 Type II、ISO 27001、GDPR、HIPAAに対応しています。Adobe PremiereとStenographがデバイス上で動かしていると伝えられています。音声が法的に社外へ出せないなら、ここに挙げた中でそれに対応できる数少ないモデルの一つです。
私たちの見解: コンプライアンスと言語の幅が最安値より重要なときの答えがSpeechmaticsです。最も安いわけでもFLEURSのチャンピオンでもありませんが、オンプレミスの選択肢とアクセントに左右されない精度が、規制のある多言語の大企業にとって安全な選択にしています。最も低い請求額を狙う小規模チームは、他を探すでしょう。
7. Amazon Transcribe
最適な用途: データとインフラがすでにAWS上にあるチーム。
Amazon Transcribeは大手クラウドの定番で、価値の核心はAWSネイティブであることです。バッチジョブはS3を読み書きし、Lambdaのイベントパイプラインに組み込めて、生成AIによる要約のためにBedrockやAmazon Connect Contact Lensにもつながります。すでにAWSを使っているなら、新しいベンダーも、別の請求も、新たなセキュリティ審査も要りません。
料金は秒単位で、ボリュームに応じて安くなる段階制です。標準のバッチは1分0.006ドル(1時間約0.36ドル)、ストリーミングは1分0.01ドルで、話者分離、カスタム語彙、言語識別が込みです。無料枠は最初の12か月間、月60分です。保護対象の医療情報を自動識別する、HIPAA対応のTranscribe Medicalティアもあり、1分あたり約0.075ドルです。
100以上の言語に対応し、標準的な話者分離、カスタム語彙、PIIのマスキング、Call Analyticsのインサイトを提供します。公表していないのは精度の見出し数値で、そのためMicrosoftの比較には載っておらず、実世界での精度は、新しいモデル中心のベンダーと比べて評価が分かれます。
私たちの見解: Amazon Transcribeを選ぶ理由は精度ではなく運用面です。AWSの中では最も抵抗の少ない道で、請求とIAMの一本化には確かな価値があります。AWSの外では、より鋭く安い専門モデルを差し置いてこれを選ぶ理由はほとんどなく、標準料金ではプレミアムを払うことになります。
8. OpenAI Whisper(オープンソース)
最適な用途: 自前のGPUを持ち、時間あたりの費用ゼロと完全な制御を求めるチーム。
Whisperはオープンソースの文字起こしを一般化したモデルで、今も自前ホストの基準点です。コードも重みもMITライセンスで、tiny(3,900万パラメーター)からlarge-v3(15億5,000万)までの6サイズに加えて8億900万パラメーターのturbo版があり、pip installの一行でインストールできます。APIの請求は一切なく、支払うのは計算資源だけで、large-v3の実行にはおよそ10GBのVRAMが必要です。
正直なトレードオフは精度と手間です。MicrosoftのFLEURS比較ではwhisper-large-v3は22.8%で、最新モデルから大きく離れており、この分野がいかに速く進んだかを最もよく示しています。話者分離も内蔵されておらず(pyannoteやWhisperXを追加します)、ネイティブのストリーミングもありません。それでも多くの用途では品質は十分で、自前でホストしているある人はこう述べています。
「whisper large-v3をM2 Maxで自前ホストのエンドポイント経由で動かしていますが、正直、精度は十分で、後処理用のモデルを気にしなくなりました。私にとってもっと厄介だったのは、長めのチャンクでの遅延でした。」
サーバーを動かさずにWhisperを使いたい場合、OpenAIはwhisper-1をAPIとして1分0.006ドルでも提供しています。
私たちの見解: データの管理とゼロの限界費用が、最高水準の精度より重要なときにWhisperを選びます。大規模なら、自前ホストはここに挙げたどの有料APIよりも安くなり得ます。ただし、GPU時間、話者分離のアドオン、そしてMAI-Transcribe-2やGeminiのような2026年のモデルとの精度差は、予算に織り込んでください。
結局どれを選ぶべきか
正直な答えは、文字起こしはコモディティ層になったので、選択は単一の「最良」モデルではなく用途で決まる、ということです。AIヘルプデスクソフトウェア選びがランキングより適合性で決まるのと同じです。私が使う近道は次のとおりです。
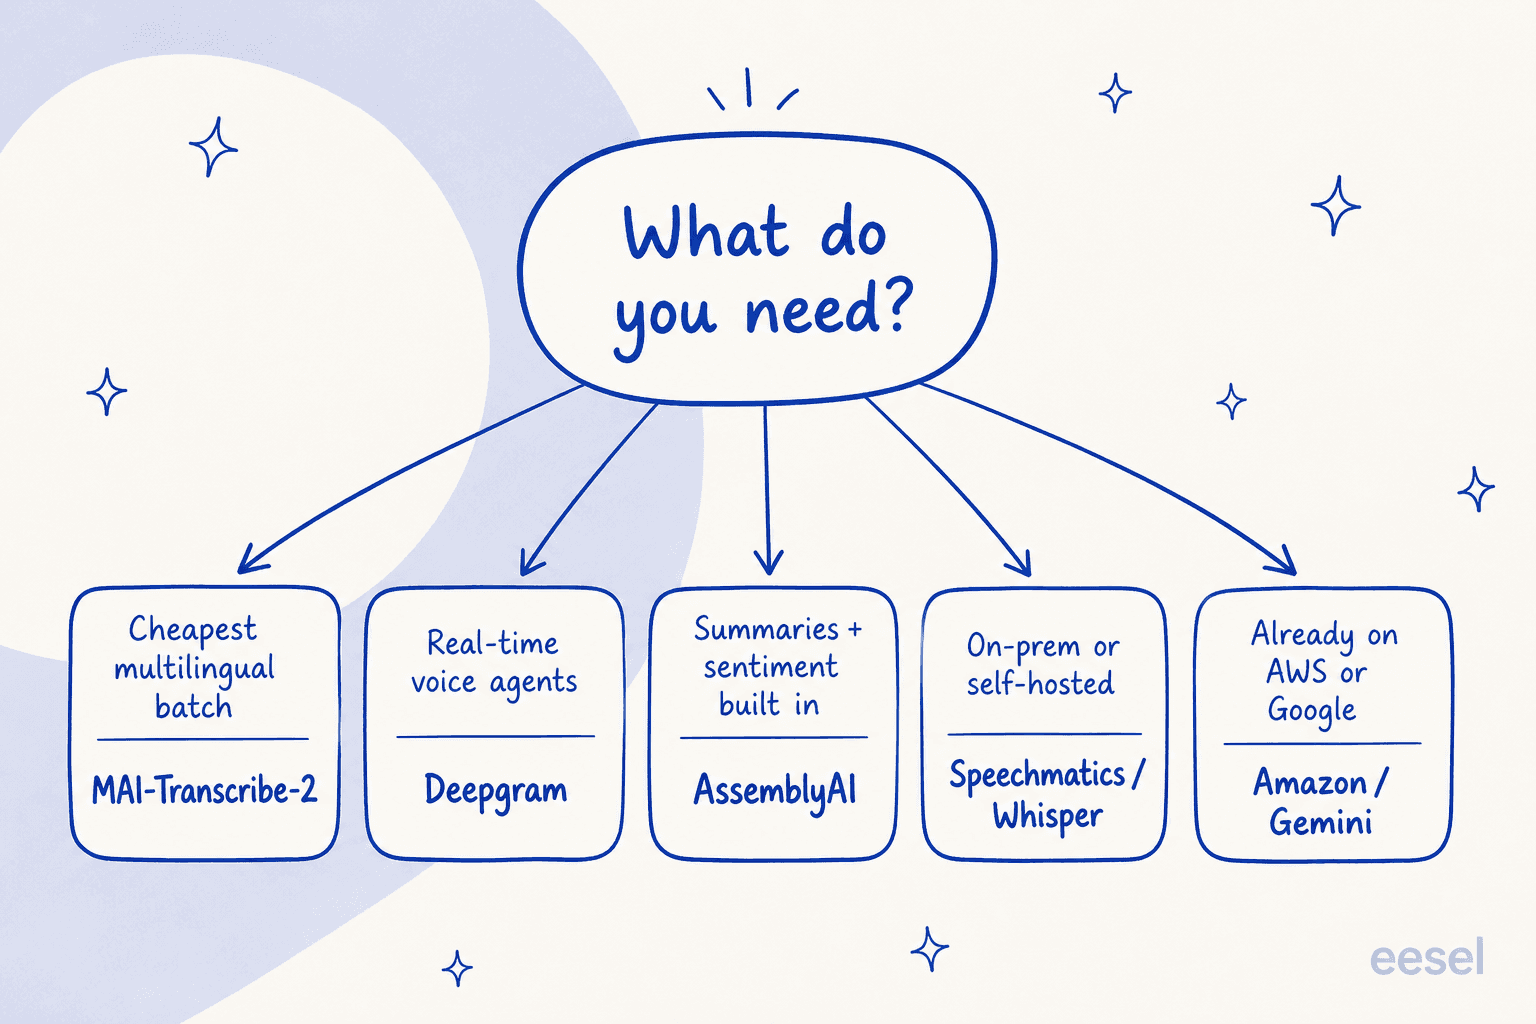
多言語バッチで最も低い請求額を狙うなら、MAI-Transcribe-2かDeepgramが勝ちます。ライブの音声エージェントを作るなら、DeepgramかSpeechmaticsです。要約と感情分析がすぐに欲しいならAssemblyAI。コンプライアンスやオンプレミスの要件があるならSpeechmaticsかWhisper。すでに一つのクラウドの中にいるなら、Amazon TranscribeかGeminiを使って、統合作業を省きましょう。
ランキングには表れない部分
調べている間、私が何度も立ち戻った見方があり、サポートの仕事をしているなら実際に重要なのはこれです。かつて文字起こしは難しくて高価な部分でした。今はそうではありません。MAI-Transcribe-2とこのリストのすべてのモデルが、それを高速で安価な、ほぼ解決済みのコモディティに変えました。それは素晴らしいことですが、価値が別の場所に移ったことも意味します。
サポート通話の正確な文字起こしは、誰かが欲しかったものではありません。テキストは読まれなければならず、答えはドキュメントや過去のチケットから見つけなければならず、返信を書いてチケットを解決しなければなりません。モデルが与えてくれるのは耳です。チームメイトではありません。
eeselではこれを何年も見てきました。私たちは何千件もの実際のチケットにわたってライブのサポートキュー上でAIを運用してきましたが、そこで残った教訓は、ボトルネックは文字起こしの精度ではなく、解決だったということです。だからこそ私たちは、顧客に返信する前に、あらゆる導入をチームの実際の過去チケットに対してシミュレーションし、ベンチマークを信じるのではなく、あなたのキューをどう処理したかを確認できるようにしています。自信ありげに聞こえるのに誤った回答をするモデルは、モデルがないより悪く、そのリスクは文字起こし層ではなく解決層にあります。
eeselで文字起こしを解決に変える
このリストのすべてのモデルはインフラです。eeselは、その上で働く従業員です。私たちは特定の仕事のために採用できるAIチームメイトを作っており、AIヘルプデスクチームメイトは、文字起こしモデルが止まるところから引き継ぎます。テキストを読み、ヘルプセンターや過去のチケットから答えを引き出し、Zendesk、Freshdesk、Slackの中で直接、返信を下書きまたは送信します。MAI-Transcribe-2のようなモデルとeeselを組み合わせれば、文字起こしされた音声チケットは、整った段落で終わらず、解決済みのチケットになります。
これらはすべてAPIファーストのモデルなので、それを選ぶ開発者は、サポート自動化にも同じ制御を求める傾向があります。eeselにはまさにそのための公開CLIがあります。同じチームメイトとワークスペースをターミナルから操作でき、人が手動で実行することも、スクリプトで自動化することも、Claude CodeやCursorのようなコーディングエージェントがヘッドレスで操作することもでき、ダッシュボードは不要です。パイプラインの入口に文字起こしを、解決する出口にeeselをつなぎます。無料で試せ、数分でヘルプデスクに接続でき、顧客に返信する前に実際の過去チケットでシミュレーションします。