

Gemini 4 Neonは100万入力トークンあたり$3.00、100万出力トークンあたり$15.00で、Free tierはなく、Thinkingトークンは出力として課金されます。値札は実際の請求額を隠しています。Artificial Analysisでは、1タスクのコストはlowで$0.75、mediumで$1.90、デフォルトのhighで$3.74、xhighで$6.44です。BatchとFlexは料率を半分にし、Priorityは80%上乗せし、キャッシュヒットは入力を$0.15に下げます。Carbonのローンチ価格$2/$10は11月30日で終わるため、CarbonよりNeonを選ぶ論拠は12月1日から始まります。
eesel CLIを使えば、コーディングエージェントが承認済みのヘルプ記事をeeselヘルプデスクチームメイトにアップロードし、過去のチケットで回答をテストできます。私はこれを使って、どのモデルでも顧客に返信する前にコストと挙動を確認します。
Gemini 4 Neonにどう価格を付けたか
ドル記号のついたものはすべてGoogleの料金ページからの引用で、ローンチの翌日である2026年11月19日に、Batch、Flex、Priorityの各タブも含めて確認しました。キャッシュのルールはGoogleのキャッシュドキュメントから、ティアの定義はFlex推論ページからです。タスクあたりのコストはArtificial Analysisによるもので、ここでの「タスク」はそのインデックスのベンチマークタスク1件であり、あなたのチケットやプルリクエストのことではありません。
私は自分のワークロードでNeonを動かしたことはありません。以下の月額の例では、私が選んで仮定としたトークン数を使っているので、計算機に自分の数字を入れてください。最初のNeon解説記事はこちら、ローンチ当日のレビューに品質面があります。この記事はお金の話だけです。
Gemini 4 Neonの100万トークンあたりの料金はいくらか?
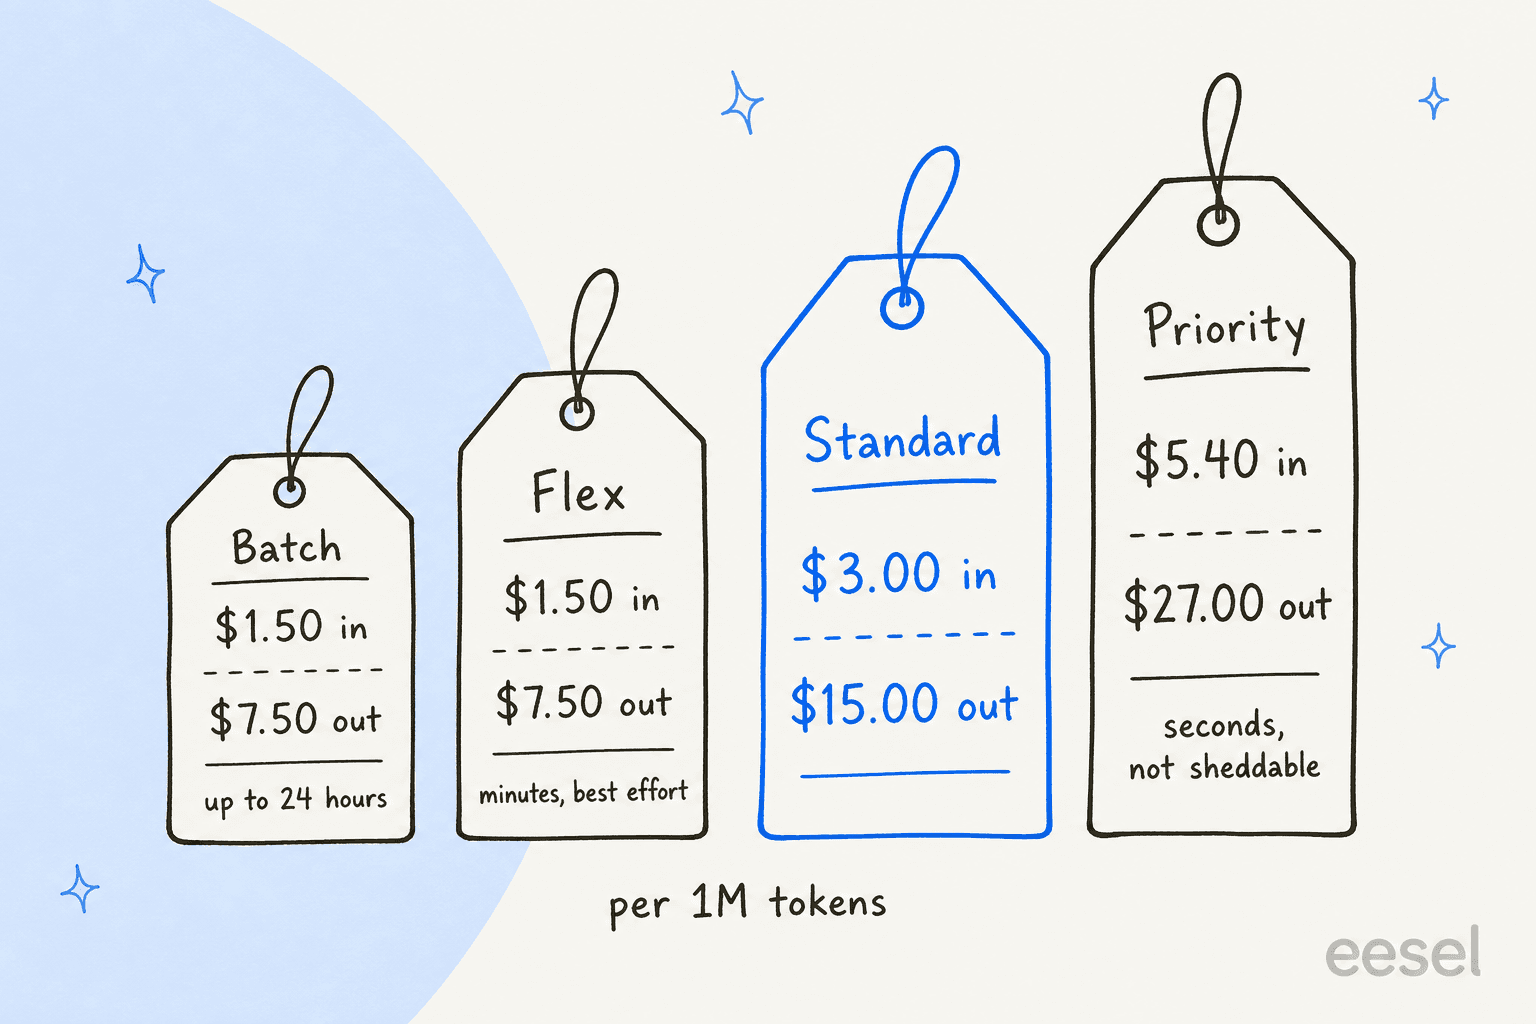
Neonは4つのサービスティアで100万トークンあたりの課金です。Googleのページでは、1,048,576トークンのコンテキストウィンドウ全体で単一の価格を示しており、長いプロンプトに対する高い料率はありません。
| ティア | 入力 | 出力(Thinking含む) | キャッシュ入力 | 速度と信頼性 |
|---|---|---|---|---|
| Batch | $1.50 | $7.50 | $0.075 | 非同期、最大24時間 |
| Flex(プレビュー) | $1.50 | $7.50 | $0.075 | 同期、目標1~15分、ベストエフォート |
| Standard | $3.00 | $15.00 | $0.15 | 数秒~数分 |
| Priority | $5.40 | $27.00 | $0.27 | 数秒、削減不可 |
見逃せない3つの詳細:
- Free tierなし。 Freeの列には「Not available」とあり、Googleはすべてのトークンがカウントされ課金されると述べています。Gemini 4 HydrogenにはFree tierがあるため、試作にはそちらの方が安くつきます。
- Priorityが最も高い。 GoogleはこれをStandardより75~100%高いと説明しています。Neonではページに
$5.40と$27.00と示されており、これは80%増しです。 - Flexはお得だが落とし穴あり。 Batchと同じ
$1.50/$7.50ですが、プレビュー機能でベストエフォートの可用性しかありません。Googleはその節約を「non-production evals, background agents, and data enrichment」向けとしており、私は顧客対応の返信をそこに置きません。
Neonへは有料のGemini APIから、またはGoogleの新着情報ページによればAI StudioのGoogle AI ProおよびUltraプランからアクセスできます。Google AI UltraのようなサブスクリプションアクセスはAPIとは別の請求であるため、ここでの計算には含めていません。
Gemini 4 Neonは実際にタスクあたりいくらかかるか?
トークンあたりの価格は料率を教えてくれますが、請求額は教えてくれません。長く思考するモデルはより多くの出力トークンを書くからです。NeonについてのArtificial Analysisの設定別データは次のとおりです。
| Thinkingレベル | インデックススコア | タスクあたりコスト | タスクあたり分数 | タスクあたり出力トークン |
|---|---|---|---|---|
| low | 44.1 | $0.75 | 3.7 | 21,726 |
| medium | 54.9 | $1.90 | 8.3 | 50,000 |
| high(デフォルト) | 59.6 | $3.74 | 14.8 | 90,188 |
| xhigh | 61.4 | $6.44 | 21.5 | 141,631 |
ドルあたりのスコアは急速に下がります。mediumからhighへは、4.7インデックスポイントのために$1.84多く払います。highからxhighへは、1.8ポイントのために$2.70多く払い、さらに6.7分長く待ちます。Google自身の指針は、4つのレベルすべてで評価を実行し、「pick the lowest thinking_level that meets your quality bar」ことで、これがこの表の正しい読み方です。
ここが私が最も役に立つと感じた部分です。出力トークンに$15を掛けると、highでは$3.74のうち約$1.35、おおよそ36%になります。残りの$2.39は入力、つまりエージェントがターンごとに読み直すコンテキストです。Artificial Analysisがリスト価格で課金していると仮定しているので、この分割はおおまかな目安として扱ってください。しかしどのレベルでも同じ方向を示しています。エージェントの作業では入力側の方が大きな請求額になり、出力価格よりキャッシュ率の方が重要です。
Gemini 4 NeonはCarbonより安いか?
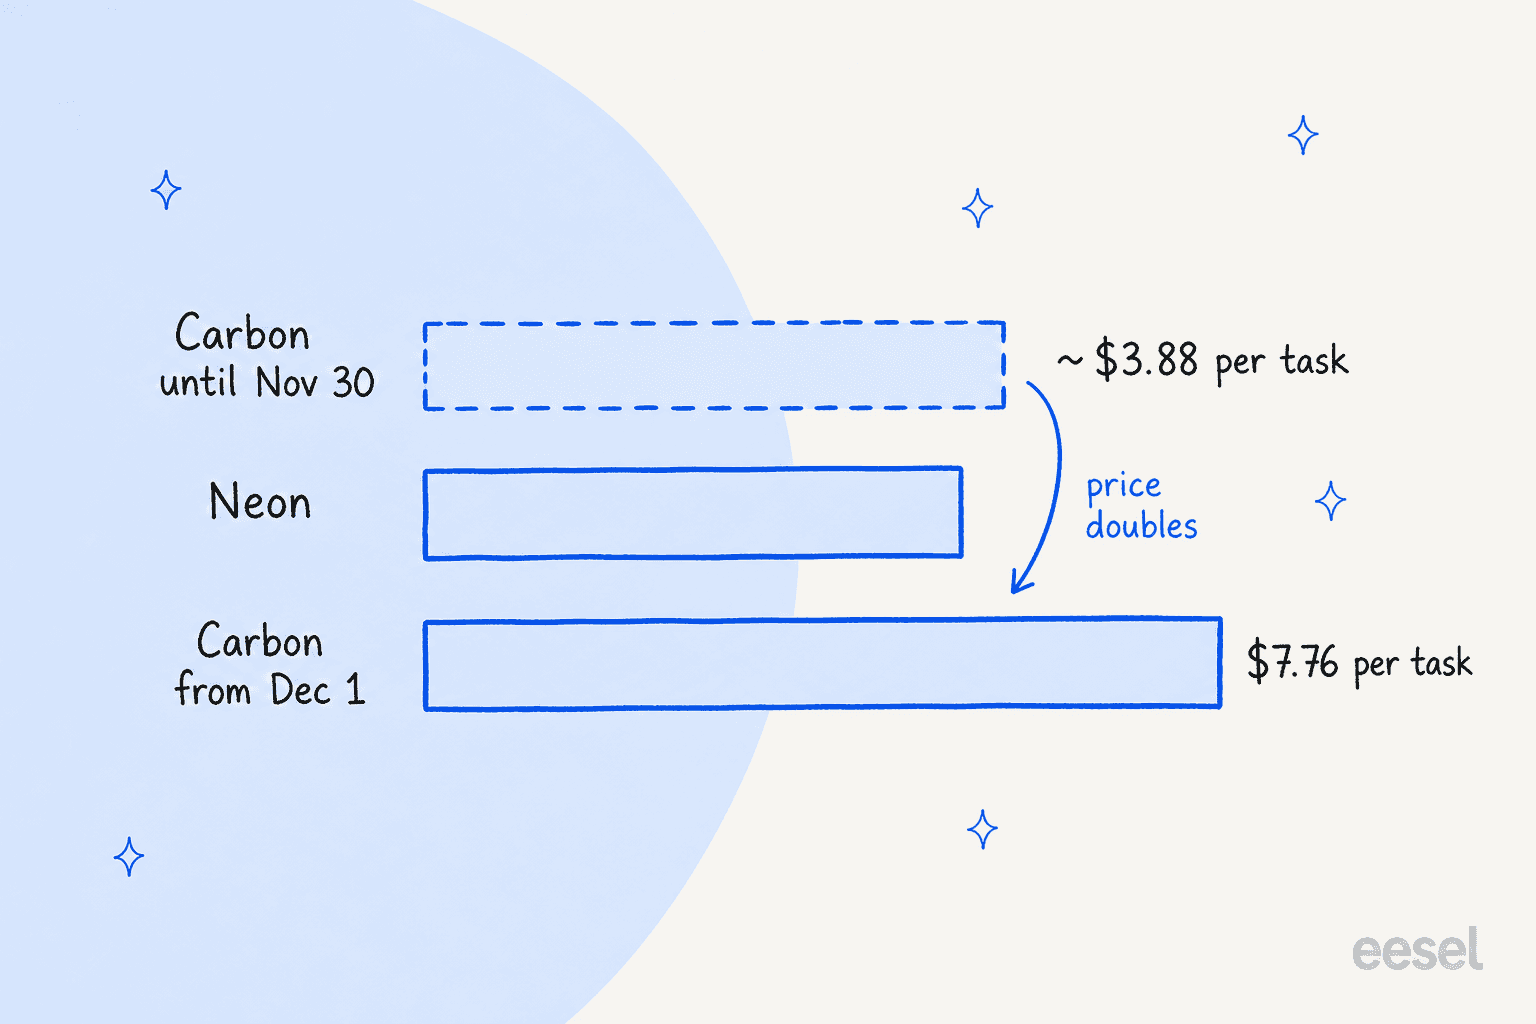
12月1日からは、はい、約半額になります。それまではほぼ同じです。
Gemini 4 CarbonとArgonはGoogleのページでローンチ価格を持っています。$2.00の入力と$10.00の出力が「through November 30, 2026」まで、その後12月1日から$4.00と$20.00になります。Neonの行には終了日もステップもありません。
CarbonのArtificial Analysisのコスト、1タスク$7.76は12月の価格で計算されています。CarbonのページにはCarbonが「costs $4.00 per 1M input tokens and $20.00 per 1M output tokens」だと書かれています。両方の料率は12月1日に2倍になるため、それまでは同じ作業が半額で済みます。私の計算では、11月30日までは1タスクあたり約$3.88で、Neonの$3.74と比べられます。
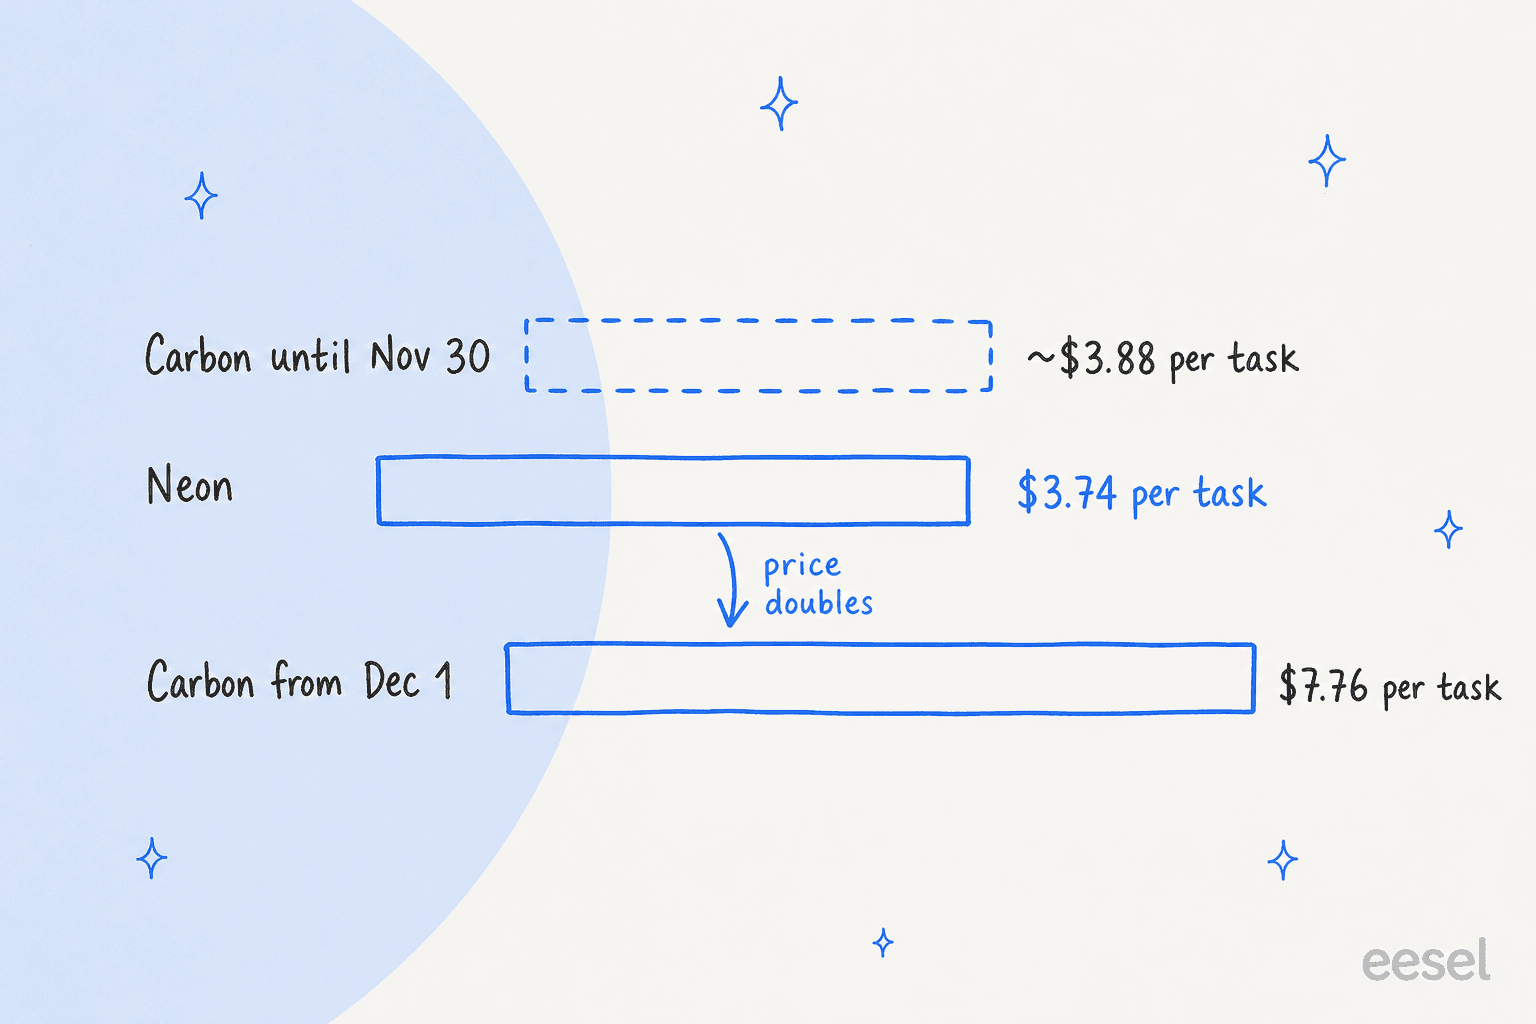
$3.88は私の推定であり、どちらの企業の数字でもありません。これはCarbonが価格変更の前後で同じトークン数をタスクあたりに書くことを前提としており、モデルが変わっていない以上そうなるはずです。Google自身のローンチ時の主張は、Carbonよりタスクあたりコスト32%減であり、12月のリスト価格はその差をさらに広げます。
私ならこうします。今Carbonを試しているなら、プロモ価格ではなく12月の価格で予算を組んでください。あるHacker Newsの読者はローンチ当日にこの気まずい位置づけに気づいていました。
"So it's better and cheaper than the recently released Carbon? So Carbon is already deprecated, or?"

非推奨ではありません。月末までプロモであるように価格設定されており、Neonは価格が安定したモデルです。私のCarbonレビューではCarbonがまだ勝っている点を扱い、Argon料金の記事ではそれがCarbonの価格ステップを共有していることを示しています。
コストの面でNeonはAstra、Sol、Opusと比べてどうか?
価格面ではよくありません。タスクあたりでは、NeonはOpenAIのモデルより高く、Anthropicの最高設定より安いです。その料率はAnthropic APIの料金ガイドにあります。同じArtificial Analysisのデータを、各モデルの最高スコアまたはデフォルトの設定で示します。
| モデルと設定 | インデックススコア | タスクあたりコスト |
|---|---|---|
| GPT-6.2 Sol max | 57.3 | $1.01 |
| GPT-6.2 Astra high | 60.1 | $2.07 |
| Gemini 4 Neon high | 59.6 | $3.74 |
| Gemini 4 Hydrogen xhigh | 53.9 | $3.16 |
| Gemini 4 Carbon high(12月価格) | 60.0 | $7.76 |
| Claude Opus 5.5 max | 59.1 | $10.04 |
Astraのトークンあたり価格はNeonより高いですが、それでもタスクあたりでは安くつきます。Neonが約90,200トークンを書くのに対し、Astraは約17,800トークンしか書かないからです。安い料金表は安いモデルを意味しません。あるHacker Newsの読者は買い手の視点をはっきりと述べています。
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
コストだけで見れば私も同意します。Neonの強みは低いハルシネーション率であり、これはレビューで扱いました。価格が気になる方には、GPT-6.2 Solレビュー、より広いGeminiの代替まとめ、OpenAIとGemini APIの比較が良い出発点です。
Neonのキャッシュはどれだけ節約になるか?
キャッシュヒットは$3.00ではなく100万トークンあたり$0.15で課金され、そのトークン分で95%安くなります。落とし穴は、オンにしたり制御したりできないことです。Googleのドキュメントによると、明示的キャッシュはGemini 4モデルで未対応であり、暗黙的キャッシュは「is enabled by default」です。割引を受けられるかどうかは3つのルールで決まります。
- 最低4,096トークン。 これより短いプロンプトはキャッシュに一切ヒットしません。
- 順序が重要です。 Googleは「large and common contents at the beginning of your prompt」を置き、似たプレフィックスを時間的に近づけて送るよう述べています。
- エージェントのループには下限があります。 マルチターン利用では、Geminiは新しいリクエストが少なくとも2,050トークンを追加する場合にのみ、前のリクエスト全体をキャッシュします。それより小さい追加の場合は「re-processes the last 2,050 tokens of the previous request at the standard input rate」します。ほとんどのエージェントターンはこの基準を超えますが、返信の短いおしゃべりなボットは超えないかもしれません。
長い文書ではこれがどれほどの価値になるか見てみましょう。500,000トークンの契約書バンドルを読み込み、それぞれ2,000トークンで回答する100件の質問をするとします。これは私の仮定で、Standardの料率で計算しています。
| シナリオ | 入力コスト | 出力コスト | 100件の質問の合計 |
|---|---|---|---|
| 毎回キャッシュなし | $150.00 | $3.00 | $153.00 |
| 最初だけキャッシュなし、99回キャッシュヒット | $1.50 + $7.43 | $3.00 | $11.93 |
これは92%の節約ですが、それはすべてのフォローアップがキャッシュにヒットする場合のみで、暗黙的キャッシュはそれを保証しません。計画を立てる前に、最初の数回の実行でusage.total_cached_tokensを確認して、実際に何が得られているかを見てください。
現実的な1か月のコストはどれくらいか?
これはあなたが管理する3つの数字、つまり入力トークン、出力トークン、キャッシュ比率によって決まります。自分の数字を入れられるように計算機を作りました。これはNeon、Hydrogen、Carbonの両方の価格で同じワークロードを計算します。
デフォルト値は私の例示的なサポートチケットのワークロードです。月5,000件のリクエスト、それぞれ入力トークン6,000、キャッシュされたプレフィックスが75%、Thinkingを含む出力トークン1,500です。Standardでは、これは1リクエストあたり約$0.028、Neonで月$138になります。同じチケットはHydrogenで約$0.014、12月以降のCarbonでは約$0.037になります。
同じ方法を使った他の3つのワークロードです。
| ワークロード(私の仮定) | Neon、Standard | Batch/Flexでの同じ内容 |
|---|---|---|
| サポート返信5,000件、入力6,000(75%キャッシュ)、出力1,500 | $138 | $69 |
| サポート返信5,000件、キャッシュヒットなし | $202 | $101 |
highでのエージェントタスク200件、Artificial Analysisの$3.74で | $748 | $374(私の半額計算) |
注目すべきはキャッシュなしの行です。これはチケットあたりコストと同じ論理で、割る単位の方が見出しの料率より重要です。キャッシュを失うとサポートの請求額に46%が追加され、プロンプトが4,096トークン未満だったり、システムプロンプトがリクエストごとに変わったりすると、静かにそれが起こります。
Neonの請求書には他に何が出てくるか?
4つのものがトークン料率の外にあります。
- 検索Grounding。 Googleは月5,000回の無料検索リクエストを提供し、これはGemini 3以降のすべてのモデルで共有され、それを超えると
1,000件あたり$14、1日1,500件の上限があります。Googleはまた、1件のプロンプトが複数の検索を発生させる可能性があり、それぞれが課金されると述べています。Maps Groundingにも同じことが当てはまります。 - ツールのオーバーヘッド。 Googleは、モデルが処理するすべてのトークンが課金されると述べています。「including thinking tokens and internal tool system instructions and function declarations when using grounding」。長いツールリストも入力トークンです。
- 読まなかった出力。 短い回答しか見ない場合でも、Thinkingトークンは課金されます。
max_output_tokensを十分高く設定して、推論の実行が途中で切られないようにしつつ、usageフィールドを見ておきましょう。 - 長いデコード。 出力は65,536トークンを超えてウィンドウ全体まで続くことがあり、それらのトークンはすべて100万あたり
$15です。
Neonのどのティアとレベルを選ぶべきか?
品質基準を満たす最も安い組み合わせを選び、それから1週間測定してください。私の出発点はこうです。
- ライブの顧客チャットやインタラクティブなコーディングツール:
mediumのStandard。Priorityは80%高くつき、信頼性しか買いません。 - 夜間の評価、バックフィル、データ拡充: 1日待てるものはBatch、分単位で答えが必要なものはFlex。どちらも
50%オフです。 highでは不十分な難しいエージェントタスク:xhigh、1.8ポイント多いインデックスのために72%高いタスクあたりコストです。まず試してください。- 品質がさほど重要でない場合: Gemini 3.8 FlashかHydrogenを使ってください。Neonは安い作業向けのモデルではありません。
サポート用のAIエージェント向けにモデルを選んでいるなら、トークンの請求額は小さな決定です。AIカスタマーサービスのコストについての私のガイドでは、モデルの行を、通常は支配的なソフトウェア、人材、レビュー時間のそばに置いています。英国の自動車ナンバープレート販売業者であるSwiftregは、Zendesk上で2つのeeselエージェントを運用し、2026年8月8日から9月8日の間に約2,100件のチケットを処理し、1,494件の公開返信を送信しました。そのエージェントはチームが書いたライブの注文照会から回答し、何を人に渡すべきかについての厳格なルールを持っています。その設定こそが、モデルではなく、返信が正しいかどうかを決めており、より良いモデルに料金を払う前に過去のチケットでシミュレートする価値があります。サポートチケット向け最良のAIモデルの私のリストが次のステップです。
チームがターミナルで作業するなら、eesel CLIを使えば、コーディングエージェントがエクスポートされたヘルプ記事やマクロをアップロードし、エージェントの指示を調整し、本番公開前にテストの質問をすることができます。ヘルプデスク自体の接続には、依然として管理者権限を持つ誰かの承認が必要です。より広いパターンは、エージェント型コーディングCLIについての私の記事にあります。
Gemini 4 Neonの料金についての私の結論
Neonは適正に価格設定されていますが、安くはありません。料率は安定しており、ティアは明確で、半額のBatchやFlexのレーンはバックグラウンド作業に便利です。しかしタスクあたりコストは選ぶThinkingレベルと、プロンプトがキャッシュにヒットするかどうかに左右されるため、決める前に両方を測ってください。Carbonと比較しているなら、リスト価格を比べるために12月1日まで待ってください。タスクあたりコストだけが制約であれば、GPT-6.2 AstraとSolの方が安いです。全体像をつかむには、Geminiの料金の概要から始めて、ChatGPTとGeminiの比較に進んでください。
eeselを試す
キューでより良い回答が欲しくてモデルに価格を付けているなら、eeselのAIヘルプデスクチームメイトはモデルを決めることなくそれを実現します。過去のチケットとヘルプセンターから学習し、答えがドキュメントにない場合は人に引き継ぎ、誰にも返信する前に実際のチケット履歴でテストできます。Zendesk、Freshdesk、その他のヘルプデスクの中で動作します。以下はZendeskの例です。
価格は月額固定のクレジットプランで、カード不要の無料プラン100クレジットがあるため、モデルの価格変更があなたの請求額を動かすことはありません。キューの一部でeeselを試してみてください。