

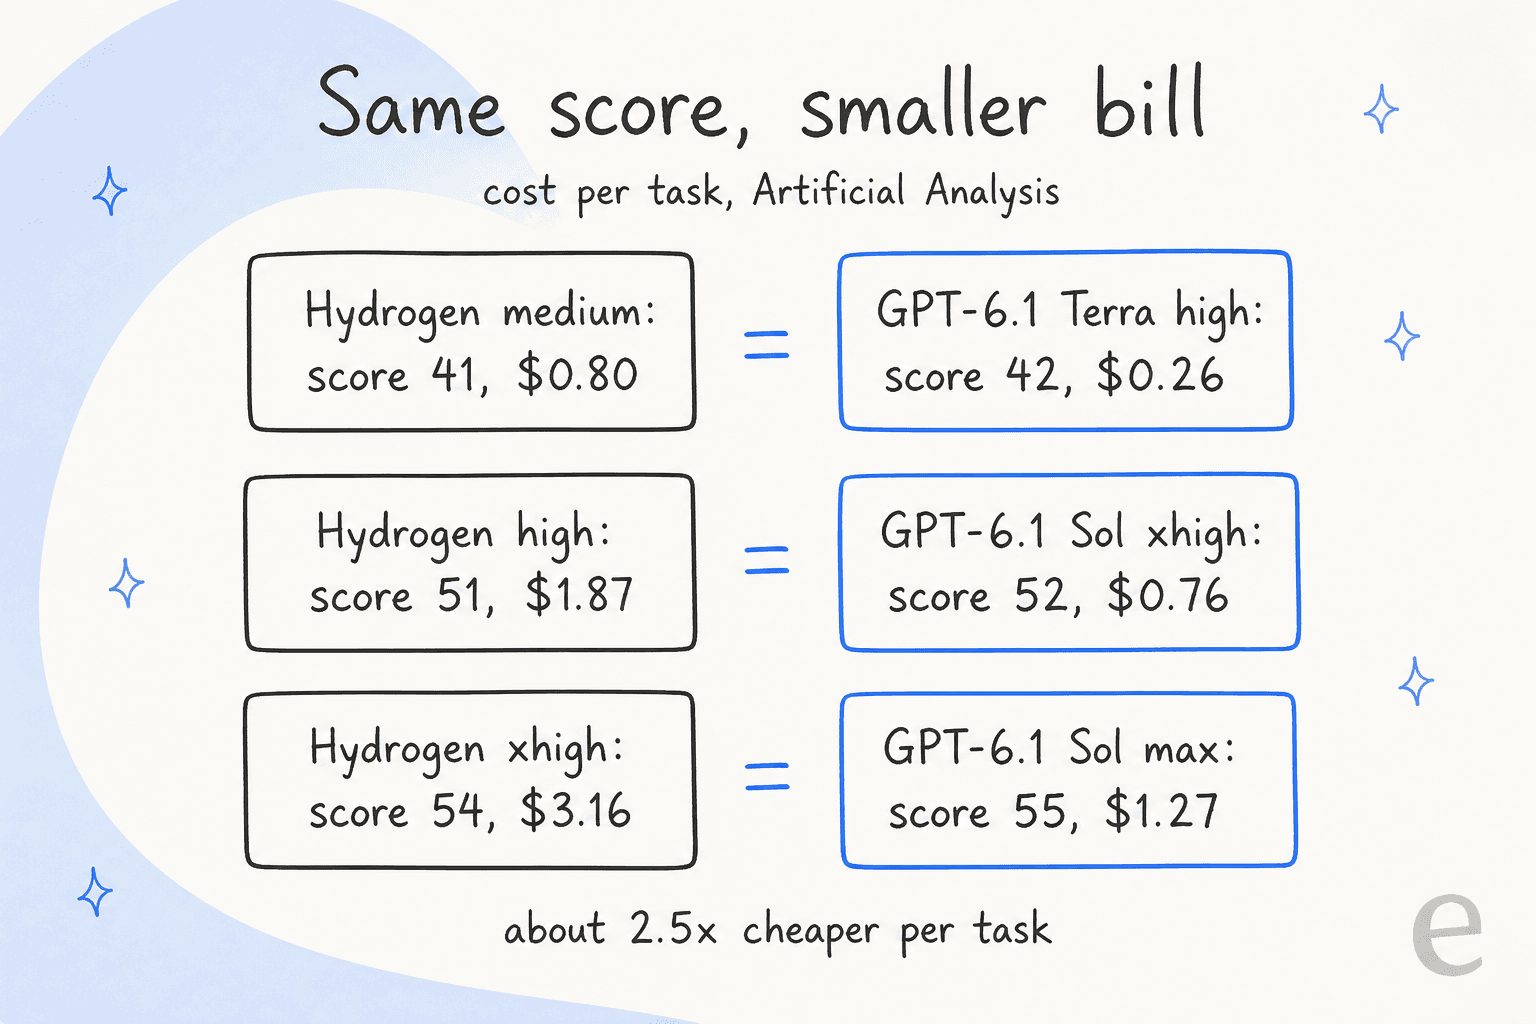
多くのビルダーにとってのGemini 4 Hydrogenの最良の代替は、xhigh設定のGPT-6.1 Solです。トークンあたりの価格はHydrogenより高いですが、Artificial Analysisは1タスクあたり$0.76で52点と評価しており、標準設定highのHydrogenは$1.87で51点です。Hydrogenは答える前にたくさん考え、そのトークン1つひとつにお金がかかります。
コーディングとコンピュータ操作のエージェントにはClaude Sonnet 5.5を、最小の請求額にはDeepSeek V4.1 Flashを、最も難しい問題にだけGemini 4 Carbonを選びましょう。サポートエージェントを作っているなら、eeselはこうしたモデルの上に乗る既成のヘルプデスクチームメイトで、そのCLIを使えば、コーディングエージェントが御社のヘルプ記事を読み込み、公開前に回答をテストできます。
そもそもなぜGemini 4 Hydrogenの先を見るのか?
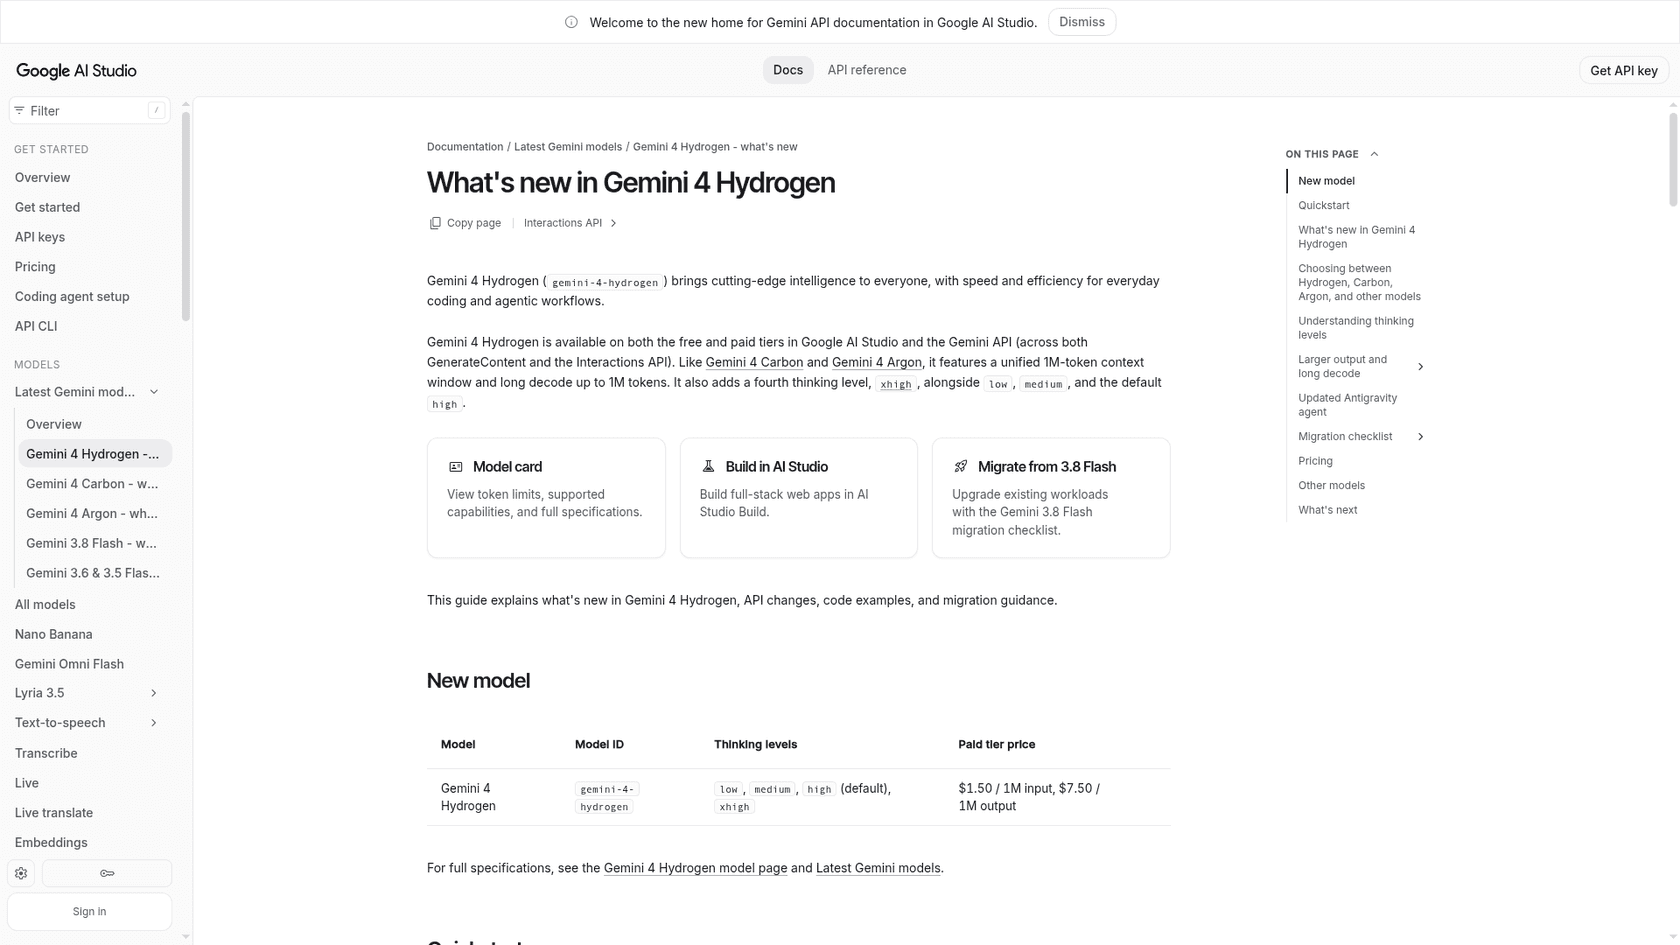
まずは良い部分から話します。良い部分は多いので。Gemini 4 Hydrogenは2026年11月12日に、100万入力トークンあたり$1.50、100万出力トークンあたり$7.50で、100万トークンのウィンドウ全体でフラット料金で登場しました。レート制限付きの無料ティアがあり、テキスト、画像、音声、動画、PDFに対応し、低・中の思考レベルでは速く、Artificial AnalysisのIntelligence Indexタスクで1.3分と3.7分です。Googleはまた、標準設定でGemini 3.8 Flashより2.5倍速いと発表記事で報告しています。
それでもビルダーは他を探し続けていて、私の経験では理由は次の4つのうちの1つです。
- 思考レベルが高いと請求額が急増する。 トークン単価は変わりませんが、タスクあたりのコストは変わります。Artificial AnalysisはHydrogenを、lowで1タスクあたり
$0.29、mediumで$0.80、high(標準)で$1.87、xhighで$3.16としています。同じモデルで11倍の差があり、これはAAが上限付近を「very verbose」と評しているからです。 - コーディングとコンピュータ操作はClaudeに遅れている。 Google自身のモデルカードでは、Terminal-Bench 4.1(
63.9%対57.0%)とOSWorld-2.1(83.9%対77.6%)でSonnet 5.5が上回っています。 - 移行で動かなくなるものがある。 Googleの移行ノートによると、Hydrogenは
temperature、top_p、top_kを無視し、minimalの思考レベルを拒否し、明示的なコンテキストキャッシュを廃止し、ツールを宣言せずに生のJSONツールコールを書くよう求めるとMALFORMED_FUNCTION_CALLを返すことがあります。 - Googleの価格は今も動いている。 これは下で詳しく説明しますが、Gemini 3.8 Flashを使っている人にとっては計算が変わってきます。
Hacker Newsのローンチスレッドは、このトレードオフをうまく言い表していました。
"My TL;DR is: seems like a better choice than Sonnet in areas outside of coding, and at high reasoning it's smarter than Terra but somewhat more expensive."

次にGeminiの価格はどうなるのか?
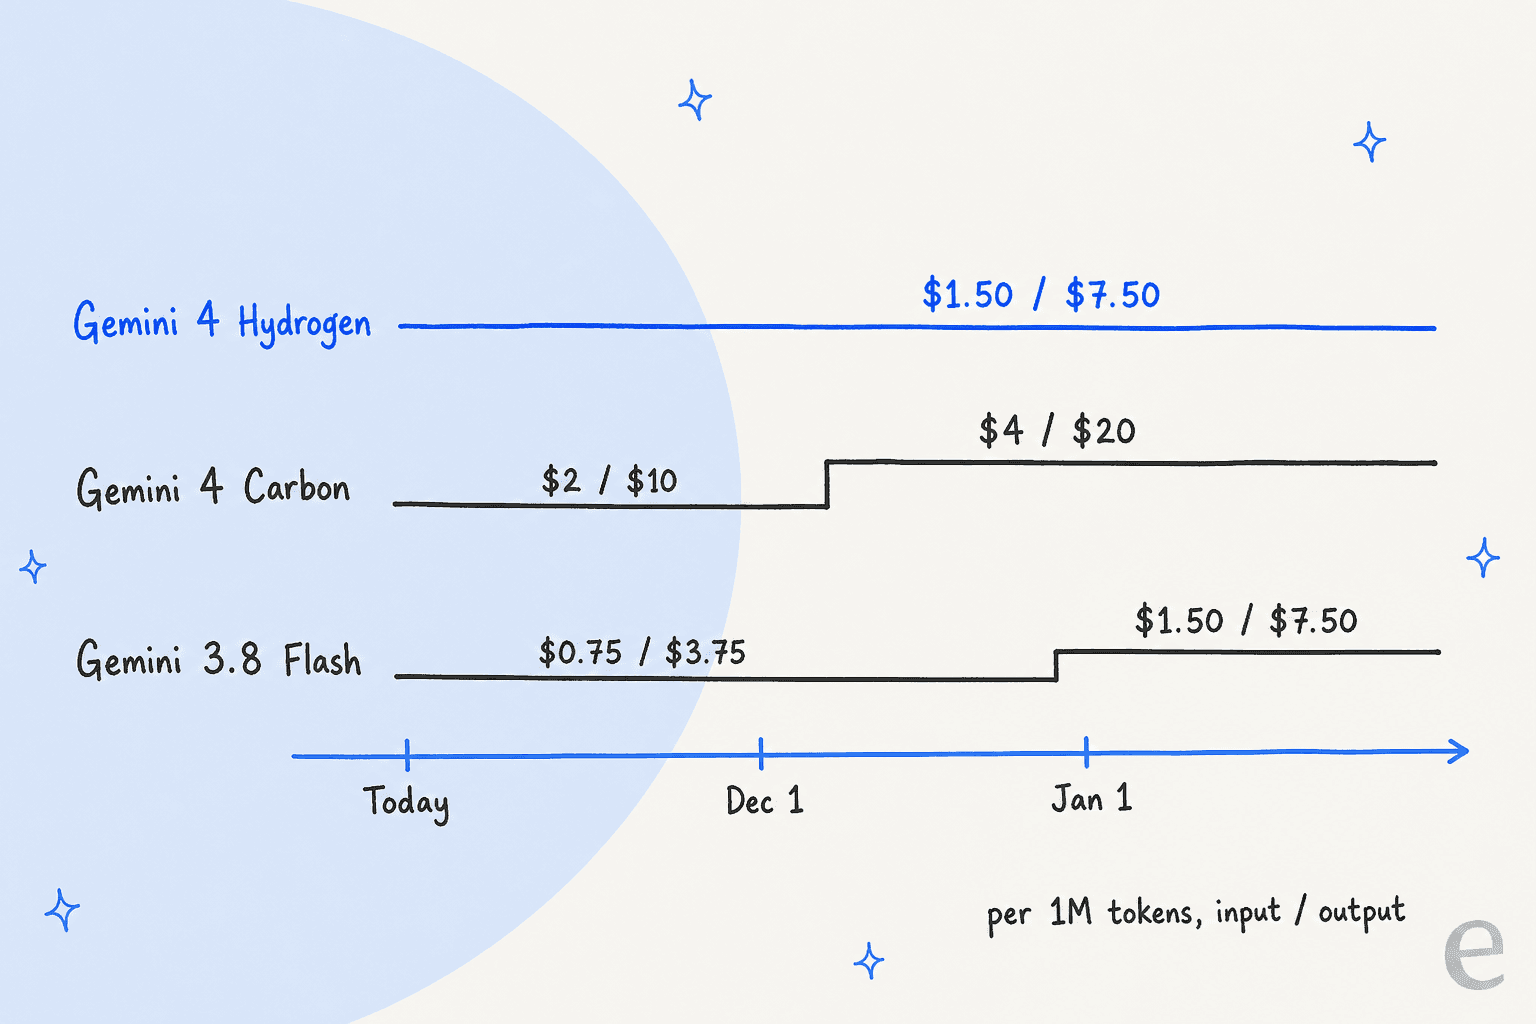
今後7週間で、Googleの価格変更が2件あります。Gemini 4 Carbonは2026年12月1日に$2/$10から$4/$20になり、Gemini 3.8 Flashは2027年1月1日に$0.75/$3.75から$1.50/$7.50になります。いずれもGemini APIの料金ページによるものです。1月以降、FlashとHydrogenは同じ定価になり、そのためGoogleはHydrogenを推奨アップグレードと呼んでいます。
ローンチスレッドにいたあるFlashユーザーは、すでにその計算を済ませていました。
"If this is Google's strategy we'll have to migrate to Luna, because costs are already high for our workload on 3.8 Flash"
サポートチームからも同じ懸念を聞きます。私が話したあるB2Bハードウェアチームは、以前のAIベンダーの価格が「2倍以上」になった経験があり、レートを固定するためだけに年間契約を求めました。価格リスクは、第二のモデルを用意しておく十分な理由です。
どのように選び、価格を調べたか
私はeeselのAIエージェントをヘルプデスクに接続する連携とAPIを作っているので、稼働中のエージェントの下でモデルを入れ替える作業に多くの時間を使っています。何度も繰り返されるのは次の教訓です。安いトークンが高いタスクを生むことがある、ということです。だからこそ、以下の各候補は次の基準で評価しています。
- 100万トークンあたりの定価。2026年11月13日に各ベンダー自身の料金ページで確認。
- タスクあたりのコスト、スコア、タスクあたりの時間。Artificial Analysisが全モデルで同じIntelligence Indexスイートを実行し、思考トークンを含めて各モデルが実際に消費した分を記録しています。エフォートレベルは括弧内に記しており、同じモデルでもこの設定次第で表のどこにでも現れうるためです。
- 1社の購入者の月額。月間100万リクエストを送るエージェントで、各リクエストは入力2,000トークン、出力300トークンとします。キャッシュや思考トークンを除くと、入力20億トークン、出力3億トークンに相当します。これは下限であり、予測ではありません。
さらに、ビルダーが入力しそうな質問で新しくChatGPT検索もしてみました。そこでの候補はClaude Sonnet 5.5、GPT-6.1 Terra、GPT-6.1 Sol、Claude Opus 5.5、DeepSeekで、注目すべき数字は「成功したタスクあたりのコスト」だと述べていました。この5つはすべて残し、同ベンダー、オープンウェイト、予算重視のルートをカバーするために、Gemini 4 Carbon、Kimi K3.1 Pro、GPT-6 Lunaを追加しました。
Gemini 4 Hydrogenの代替比較
| モデル | 入力/出力(100万あたり) | キャッシュ入力 | コンテキスト | オープンウェイト | AAスコア(レベル) | AAタスクあたりコスト | AAタスクあたり時間 | 月額(購入者例) |
|---|---|---|---|---|---|---|---|---|
| Gemini 4 Hydrogen(基準) | $1.50 / $7.50 | $0.075 | 1M | いいえ | 51 (high) | $1.87 | 8.3 min | $5,250 |
| GPT-6.1 Sol | $2 / $10 | $0.10 | 1.05M | いいえ | 52 (xhigh) | $0.76 | 9.8 min | $7,000 |
| GPT-6.1 Terra | $1 / $5 | $0.05 | 1.05M | いいえ | 42 (high) | $0.26 | 4.2 min | $3,500 |
| Claude Sonnet 5.5 | $2 / $10 | $0.10 | 1M | いいえ | 55 (max) | $10.02 | 33.0 min | $7,000 |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | いいえ | 48 (medium) | $2.45 | 7.2 min | $14,000 |
| Gemini 4 Carbon | $2 / $10、12月1日から$4 / $20 | $0.10 | 1M | いいえ | 58 (medium) | $4.68 | 23.8 min | $7,000、その後$14,000 |
| DeepSeek V4.1 Flash | オフピーク$0.15 / $0.60 | $0.003 | 1M | はい(MIT) | 33 (max) | $0.60 | 15.1 min | $480 |
| Kimi K3.1 Pro | $2 / $10 | $0.20 | 1M | はい | 46 | $3.68 | 38.3 min | $7,000 |
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | 1.05M | いいえ | 28 (max) | $0.15 | 11.6 min | $350 |
最初の列より先に、最後の3列を読んでください。定価では、Hydrogenの方がSolより安く見えます。タスクあたりでは、Solはコストの約40%で、やや良い仕事をしていますし、時間も同程度です。スコア、コスト、時間はいずれも、2026年11月13日時点の各モデルのArtificial Analysisページからのものです。
月あたりでは、それぞれいくらかかるのか?
月間のエージェントタスク数を入力し、規模を選んでください。この計算機は各モデルのArtificial Analysisのタスクあたりコストを掛け算するので、上の定価ベースの請求額が含まない思考トークンも含みます。AAのタスクは長めのエージェント的な作業なので、合計額は自分の正確な請求額としてではなく、モデル同士を比較する手段として扱ってください。
1. GPT-6.1 Sol
**最適な用途:**タスクあたりの費用を抑えつつHydrogen並みの仕事を求め、OpenAIのAPIの形に対応できるビルダー。
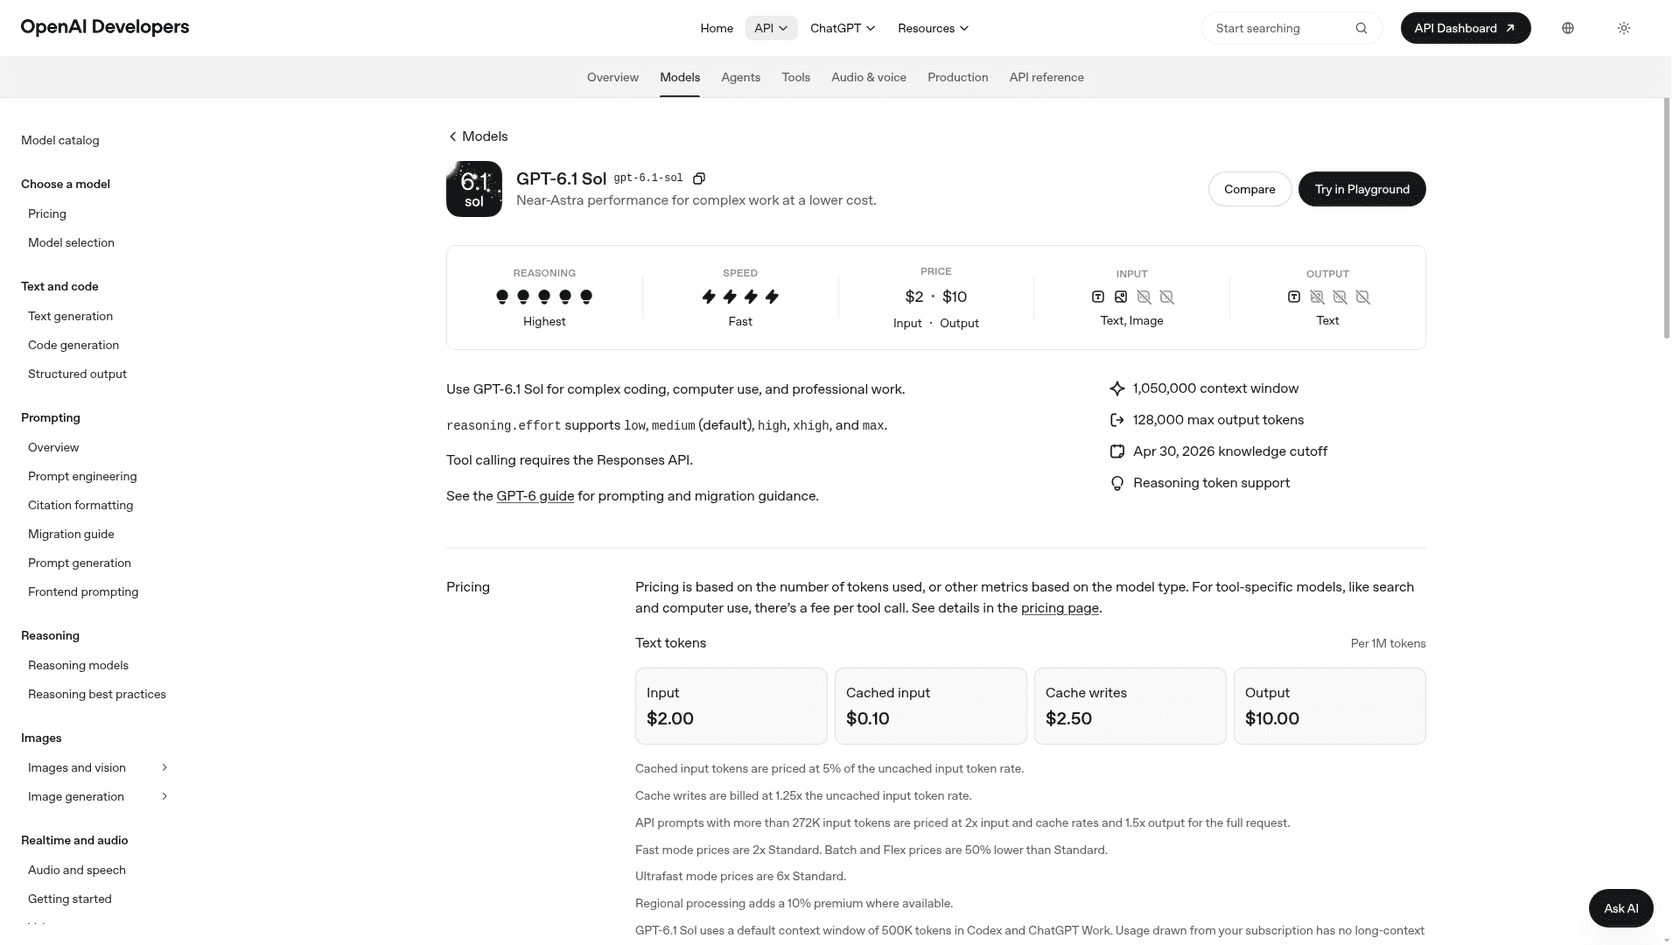
GPT-6.1 Solは、GPT-6 Astraの下に位置するOpenAIの第2段です。OpenAIはこれを「Near-Astra performance for complex work at a lower cost」と説明しており、タスクあたりで見ると、このリストの中でHydrogenからの最も素直なアップグレードに近い存在です。
長所
- xhighで1タスクあたり
$0.76、9.8分で52点。Hydrogenはhighで$1.87、8.3分で51点です。 - maxでは
$1.27で55点と、Hydrogenのxhigh(54点、$3.16)より安いです。 lowからmaxまで5段階のエフォートレベルがあり、Hydrogenの思考レベルを調整するのと同じ感覚で調整できます。
短所
- ツールコールにはResponses APIが必要なので、Gemini向けに作った連携には実質的な改修が必要です。
- 無料ティアはなく、入力272Kトークンを超えるプロンプトはリクエスト全体で入力2倍、出力1.5倍の料金になります。
- ナレッジのカットオフは2026年4月30日です。
**料金:**100万トークンあたり入力$2、キャッシュ$0.10、出力$10。OpenAIの料金ページより。BatchとFlexはその半額です。
**私の見解:**Hydrogenをxhighにしようとしていたなら、まずSolをxhighで試してください。タスクあたりで見れば、同じスコアに安く到達できます。GPT-6.1 Solのレビューには実際のサポートチケットでのテスト結果があります。
2. GPT-6.1 Terra
**最適な用途:**Hydrogenのlowやmediumで十分な、速くて安い作業。
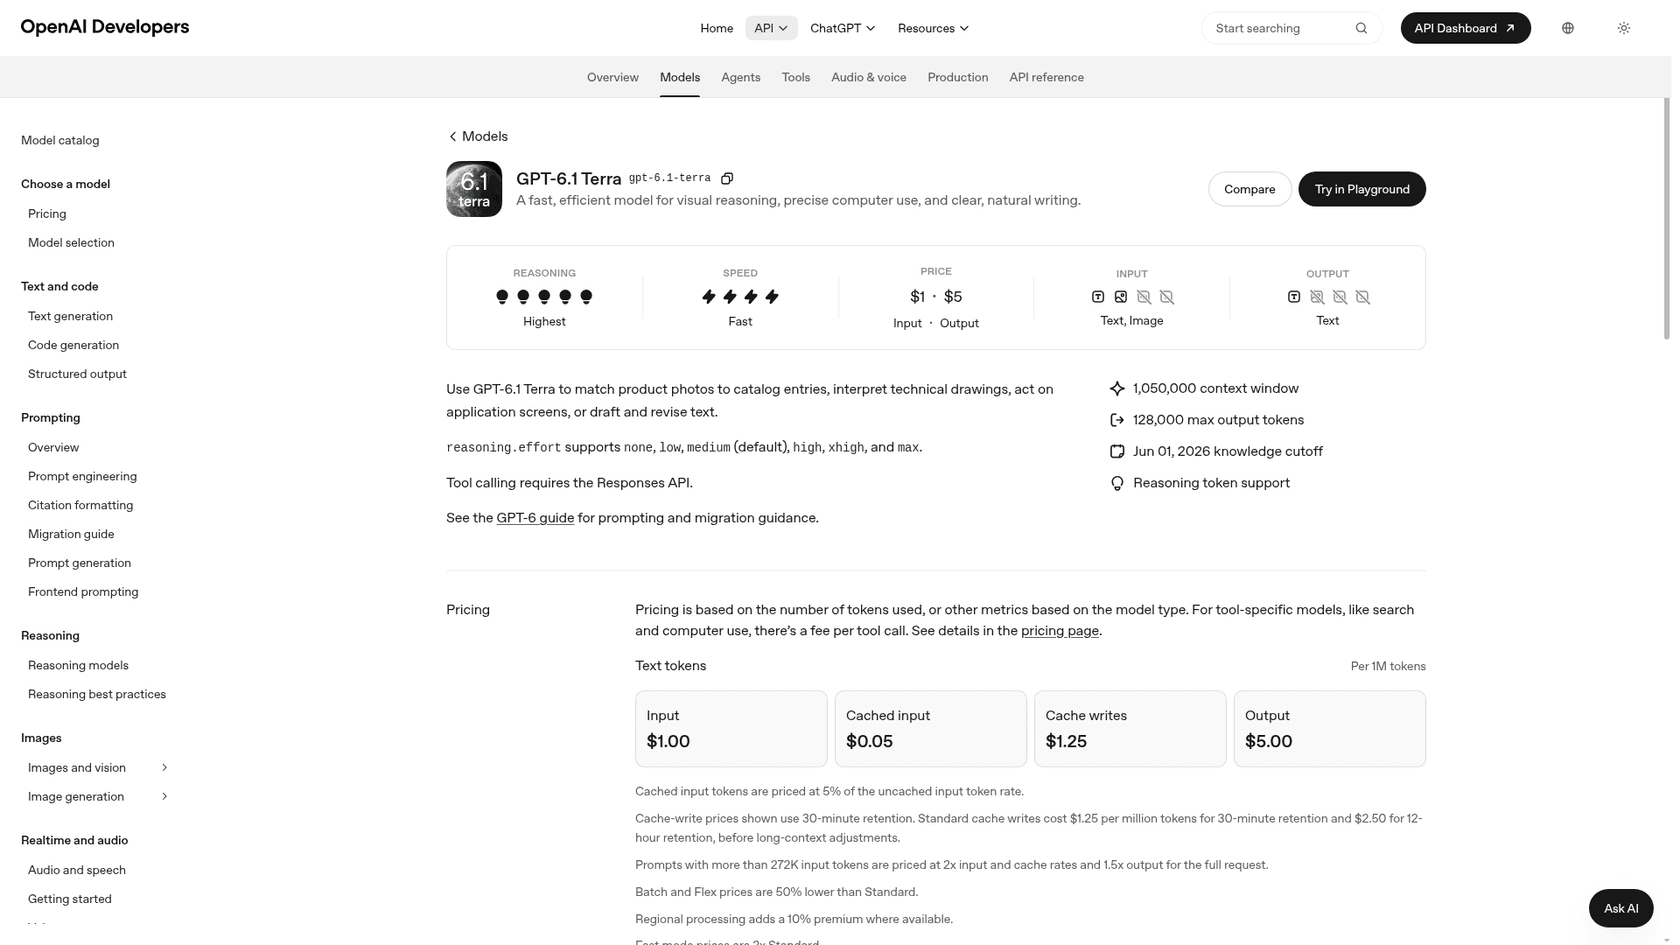
GPT-6.1 TerraはSolの1段下で、Hydrogenの最も直接的なライバルです。Googleは自社の比較表にもこれを載せていて、共有する9行のうち8行でHydrogenが勝っています。
長所
- highで1タスクあたり
$0.26、4.2分で42点。Hydrogenはmediumで$0.80、3.7分で41点です。これは同じスコアでコストが約3分の1ということです。 - Hydrogenにはない、思考なしの高速パス向け
noneエフォートレベルがあります。 - 定価は入力・出力ともにHydrogenより3分の1低いです。
短所
- Googleの表ではSWE-sweep(
13.5%対5.8%)とAutomationBench(76.1%対60.2%)でHydrogenが上回っています。 - maxまで上げる(
51点、$0.96、14.2分)と、Hydrogenのhighより遅くなります。 - ツールコールについてはSolと同じResponses APIの要件があります。
**料金:**100万トークンあたり入力$1、キャッシュ$0.05、出力$5。OpenAIの料金ページより。
**私の見解:**大量かつ中程度の難易度のトラフィック向けの切り替え先です。難しいタスクにはTerraを最大まで上げるのではなく、Solに切り替えてください。GPT-6.1 Terraのレビューでは、実際のチケットでの挙動を紹介しています。
3. Claude Sonnet 5.5
**最適な用途:**コーディングエージェント、ターミナル作業、コンピュータ操作。
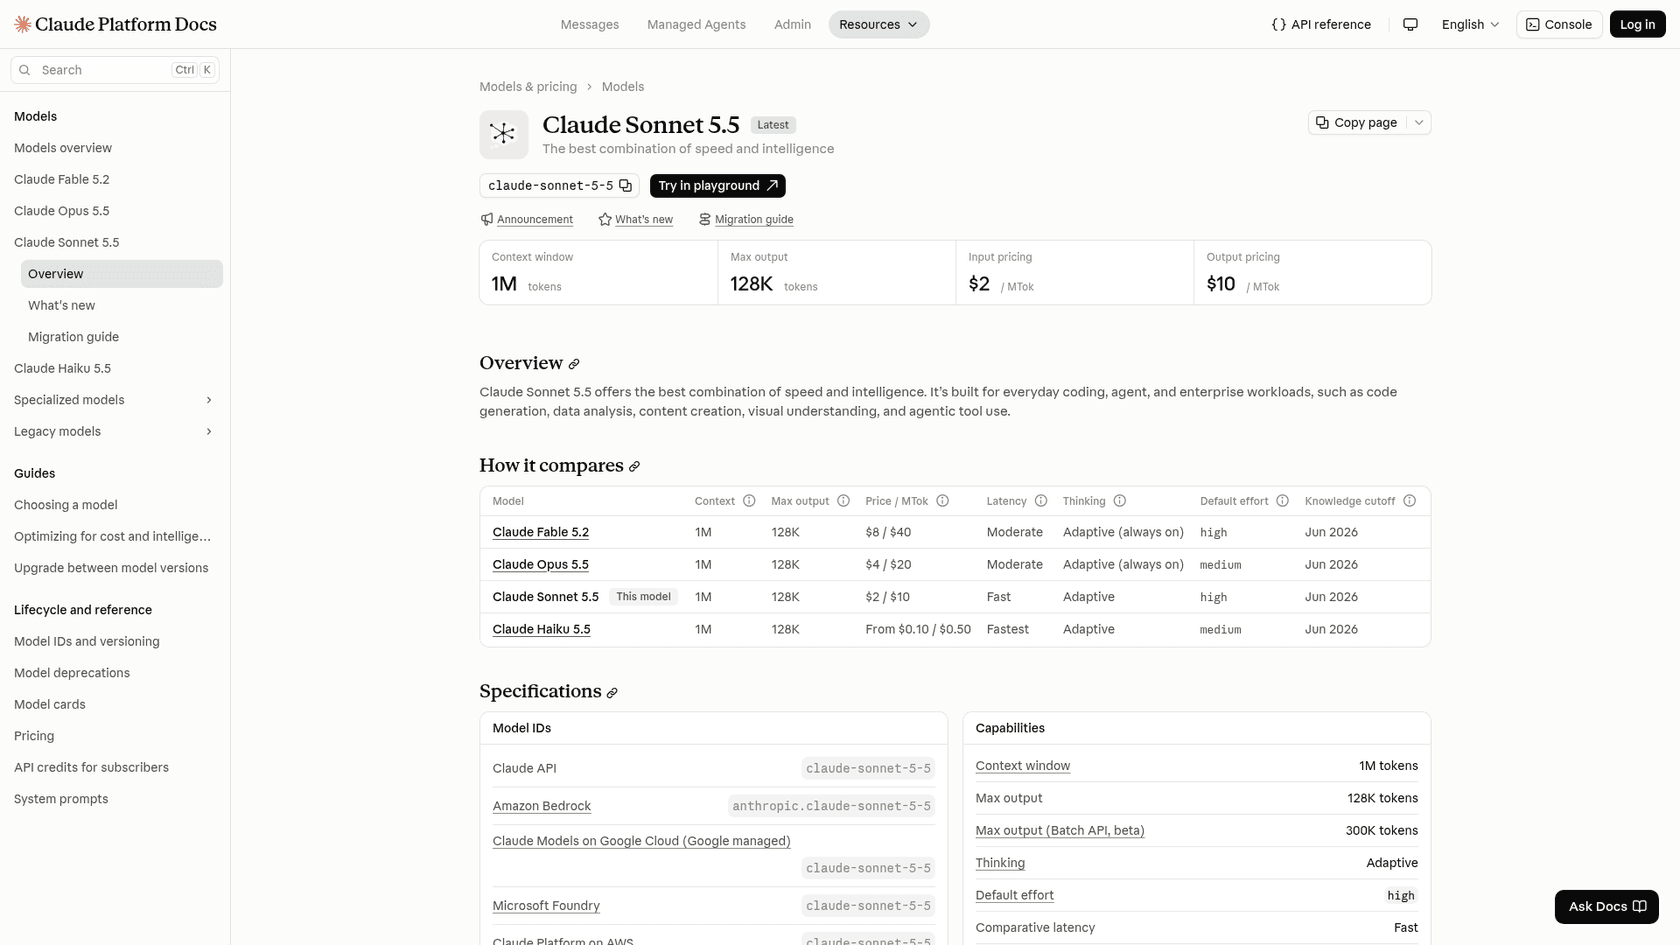
Claude Sonnet 5.5はAnthropicの中間モデルで、Anthropicはこれを「the best combination of speed and intelligence」と呼んでいます。ChatGPTはこれを最有力のHydrogen代替として挙げており、Google自身の数字もそれが話題になる理由を説明しています。
長所
- コーディングツールにとって最も重要な2つのエージェント系の行で、Hydrogenを上回ります。Terminal-Bench 4.1(
63.9%対57.0%)とOSWorld-2.1(83.9%対77.6%)、Googleのモデルカードによるものです。 - maxでは
55点で、Hydrogenの最高(xhighで54点)を上回ります。 - 1Mウィンドウ全体でフラットな価格、キャッシュ読み取りは
$0.10です。
短所
- maxでは1タスクあたり
$10.02、Artificial Analysisで33分かかります。mediumでは$0.78まで下がりますが、スコアも31点まで下がります。 - Googleのベンチマークでは、HydrogenがSWE-sweep(
13.5%対3.1%)とHLE-Diamond(58.8%対53.3%)の行で勝っています。 - 厳格なAPI:標準外の
temperatureと強制的なtool_choiceはどちらもエラーを返します。詳細はSonnet 5.5のレビューにあります。
**料金:**100万トークンあたり入力$2、キャッシュ読み取り$0.10、出力$10。Anthropicの料金ページより。Batchは半額になります。
**私の見解:**エージェントがコードを書く、またはコンピュータを操作する場合に選んでください。一般的な知識作業ではHydrogenの方がお得な買い物で、これはHNスレッドの結論とも一致します。
4. Claude Opus 5.5
**最適な用途:**請求額よりも正しくやり遂げることが重要な、長時間稼働のエージェント。
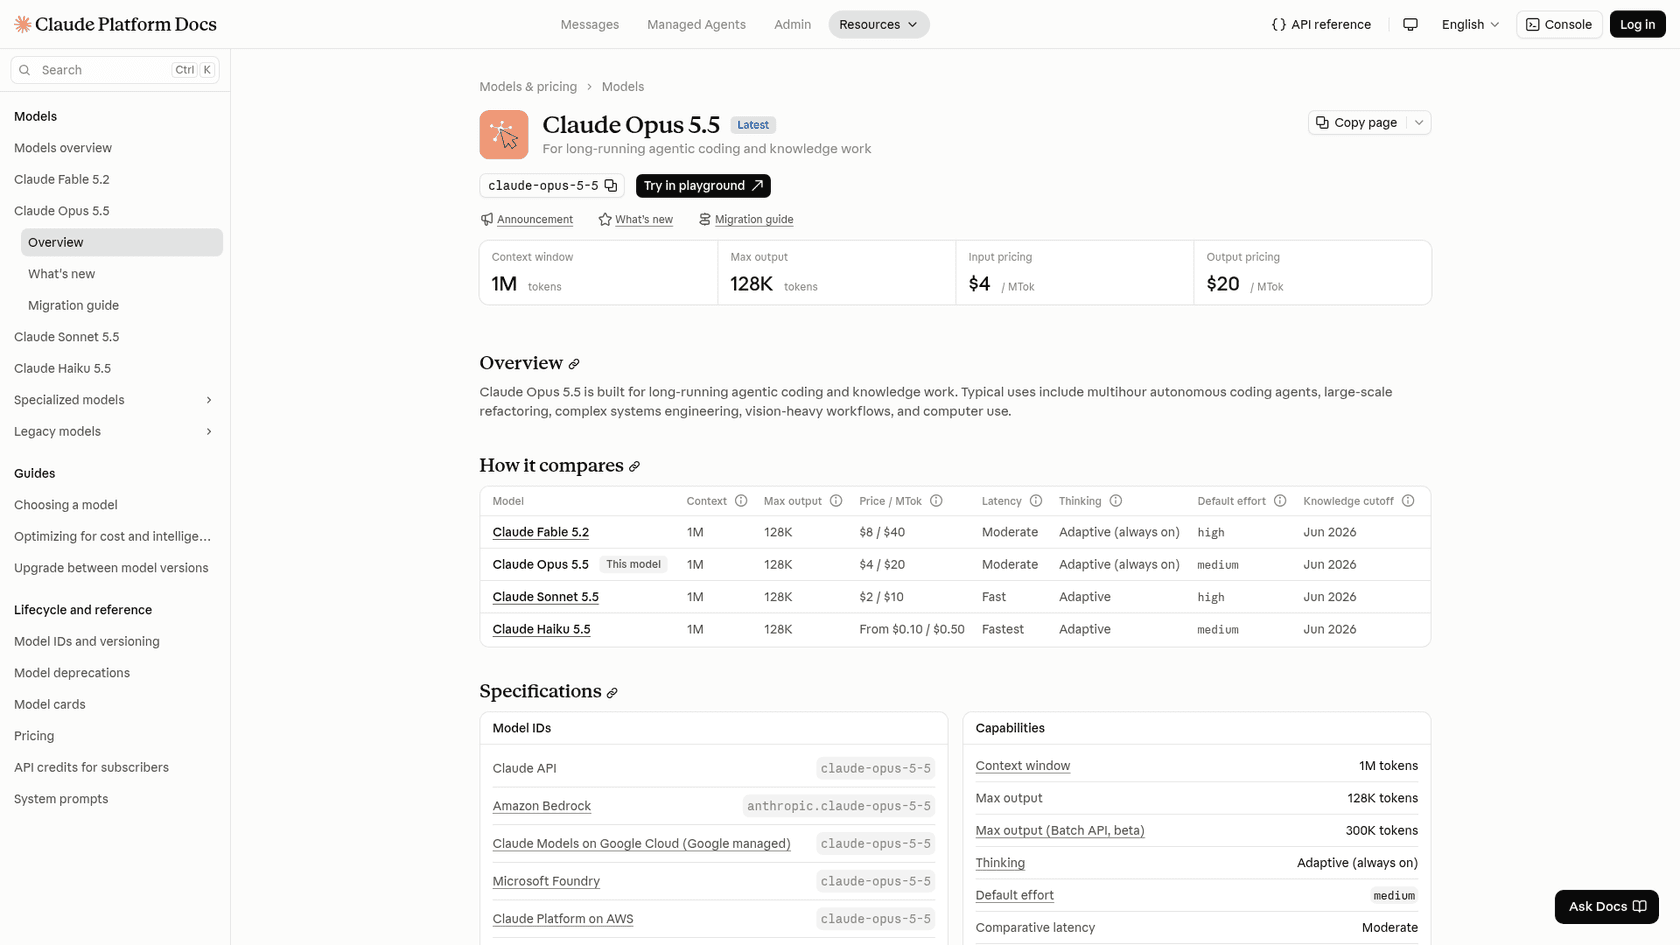
Claude Opus 5.5はAnthropicの大型モデルで、「for long-running agentic coding and knowledge work」向けに作られています。トークンあたりで見るとここでは最も高価な選択肢なので、このリストには標準としてではなく、エスカレーション先として位置づけています。
長所
- maxでは
59点とArtificial Analysisで、highのCarbonに次ぐこの比較の中で2番目に高いスコアです。 - デフォルトのmediumでは、
7.2分で$2.45で48点です。 - キャッシュ読み取りは入力価格のわずか5%にあたる
$0.20で、長いシステムプロンプトを再送するエージェントに有利です。
短所
$4/$20の定価で、例の請求額は$14,000、Hydrogenのほぼ3倍です。- maxでは1タスクあたり
$10.04、25.2分です。 - 思考は常にオンで、Anthropicはこれを「Adaptive (always on)」としてリストし、出力として課金されます。
**料金:**100万トークンあたり入力$4、キャッシュ読み取り$0.20、出力$20。Anthropicの料金ページより。Fastモードは$8/$40です。
**私の見解:**計画役であって、作業役ではありません。Opusには計画やレビューを任せ、ステップの実行はより安いモデルに任せましょう。Opus 5.5のレビューにはエフォート別の数字があります。
5. Gemini 4 Carbon
**最適な用途:**Googleを使い続けたいが、Hydrogen以上の推論力が必要なチーム。
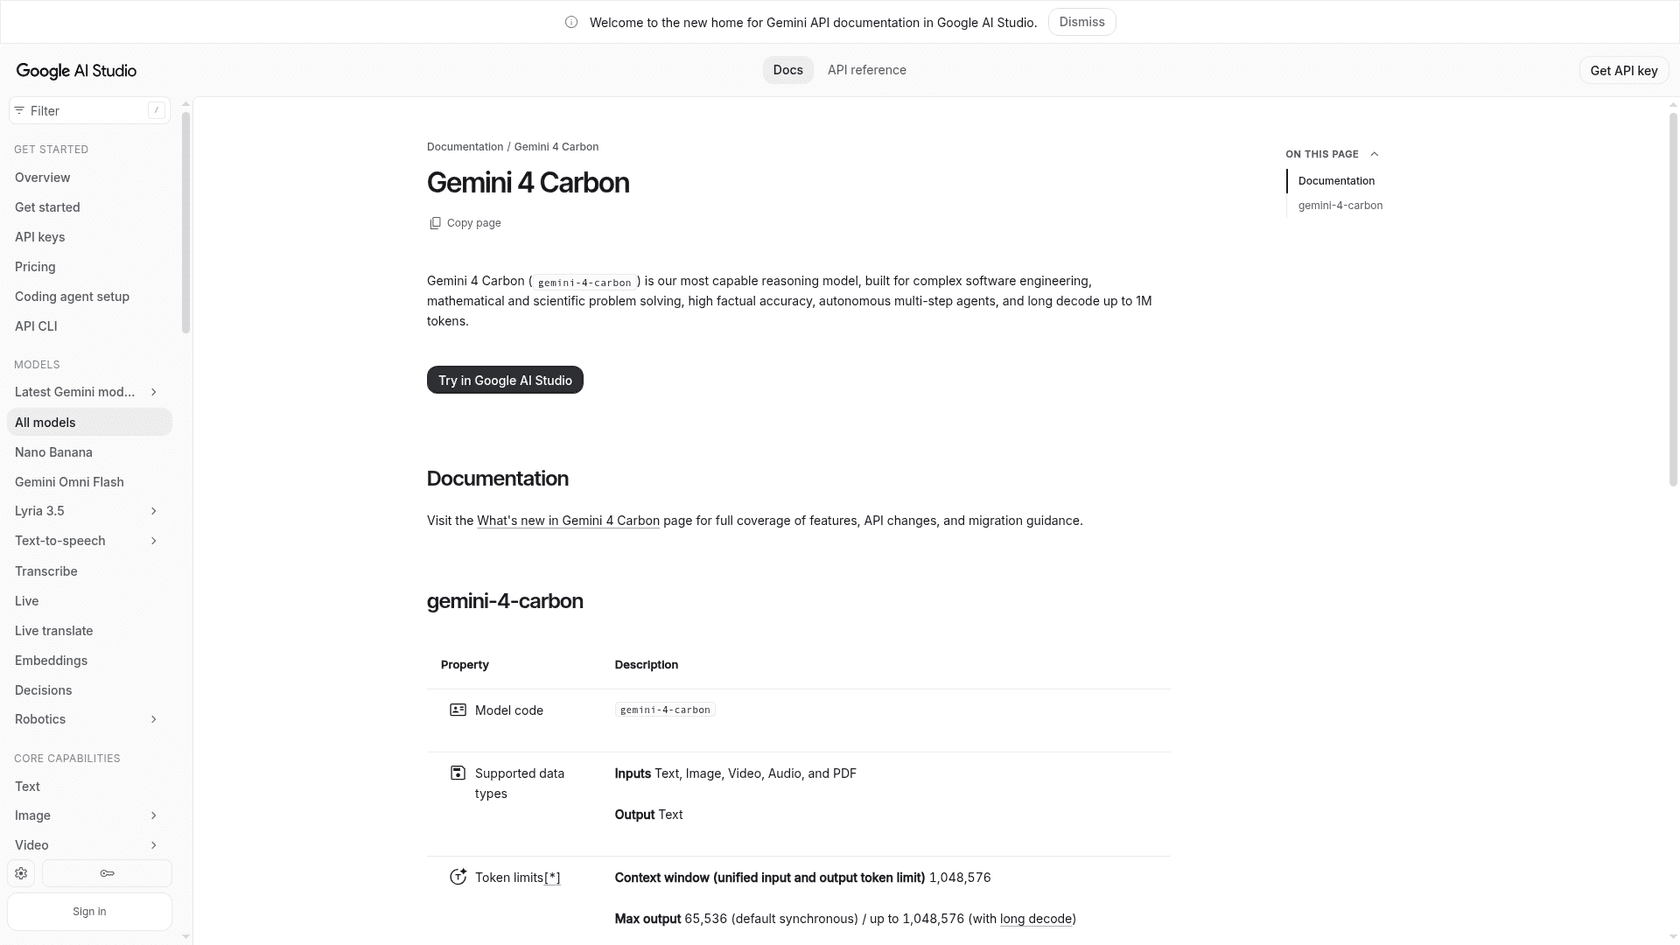
Gemini 4 CarbonはHydrogenの上位モデルで、2026年11月10日に一般提供を開始しました。同じAPI、同じ入力形式なので、このリストの中では最も作業の少ない切り替えです。
長所
- mediumでArtificial Analysisで
58点、highでは60点と、この比較の中で最高スコアです。 - すでに構築済みのGemini SDK、Search grounding、マルチモーダル入力をそのまま使えます。
- GoogleのAntigravity内Orchestratorは、計画にCarbon、実行にHydrogenを組み合わせており、意図された役割分担を示しています。
短所
- mediumで1タスクあたり
$4.68、highで$5.48、タスクあたり23.8分から27.4分です。 - 2026年12月1日に価格が
$4/$20に倍増し、無料ティアもありません。 - デフォルトはmediumで、highが上限なので、xhighはありません。
**料金:**2026年11月30日までは100万トークンあたり入力$2、キャッシュ$0.10、出力$10。それ以降は$4/$0.20/$20です。Gemini APIの料金ページより。詳細はGemini 4 Carbonのレビューにあります。
**私の見解:**最も難しい10%だけをここに回し、残りはHydrogenに任せましょう。12月1日以降にすべてをCarbonに送るのは、わずかなスコアの差に対して高額な請求です。
6. DeepSeek V4.1 Flash
**最適な用途:**最も低い請求額、そしてオープンウェイトを求めるチーム。
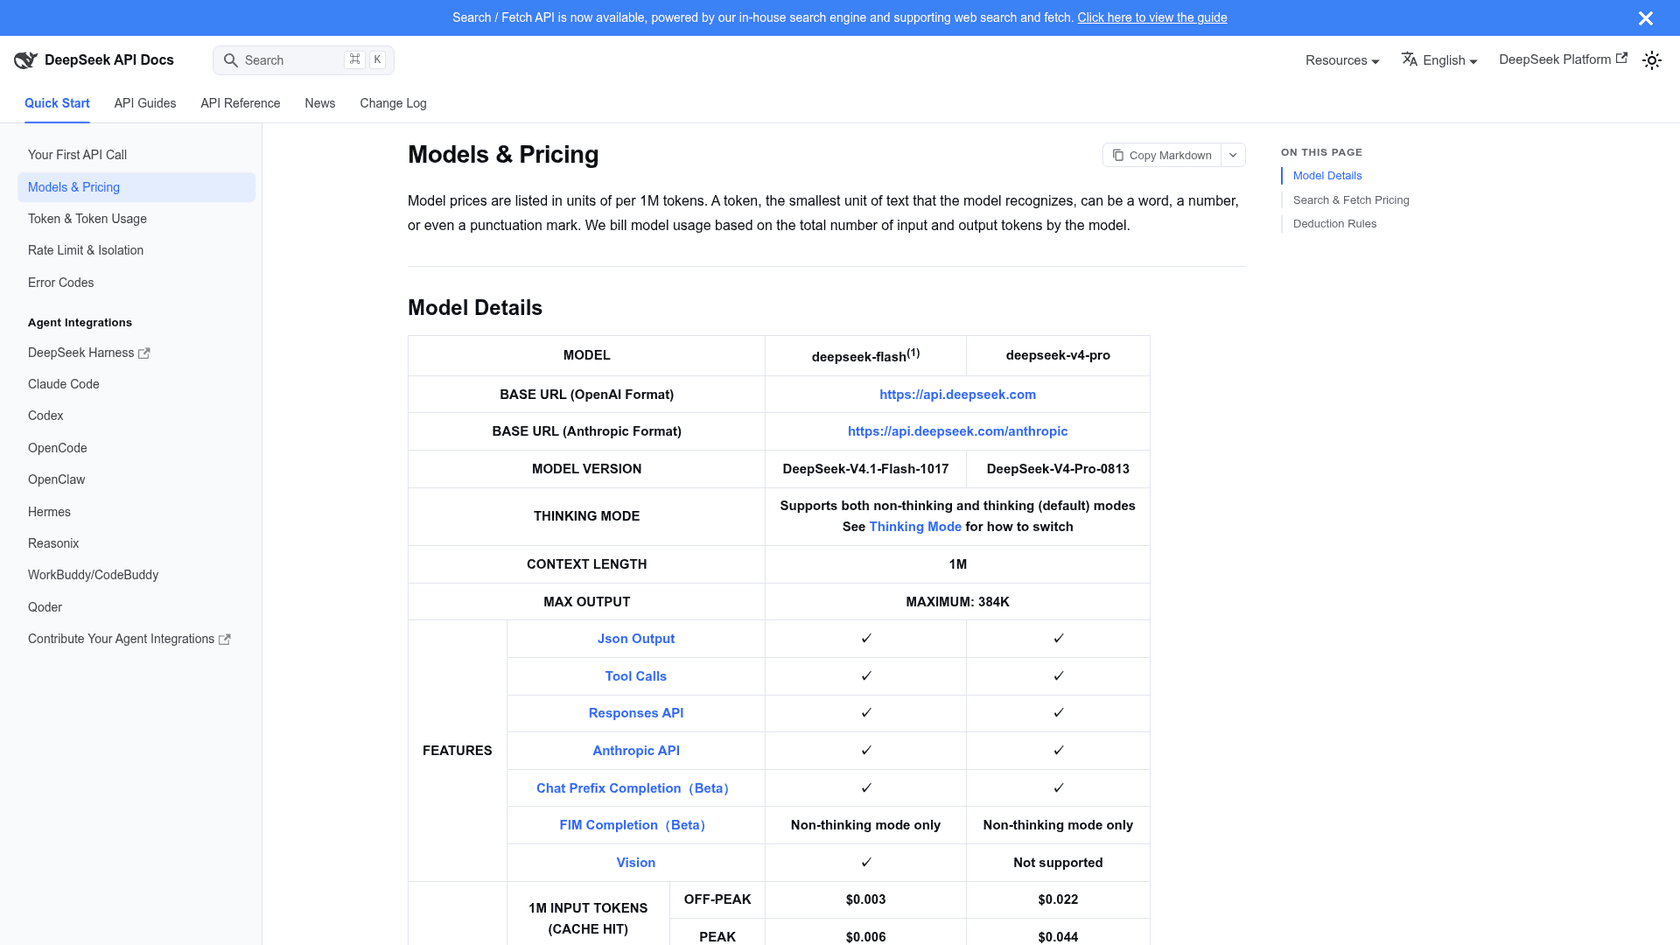
DeepSeek V4.1 Flashは、DeepSeekのAPIではdeepseek-flashとして呼び出され、旧名のdeepseek-v4-flashも今はこれにリダイレクトされます。このリストの中で唯一、Hydrogenの定価の10分の1未満で済むモデルです。
長所
- オフピークで100万トークンあたり
$0.15/$0.60なので、例の請求額はHydrogenの$5,250に対して$480です。 - MITライセンスの重みなので、自社やホスティングプロバイダーが中国国外で動かせます。
- ビジョン入力、ツールコール、JSON出力、そしてOpenAI形式とAnthropic形式両方のエンドポイントに対応しています。
短所
- Artificial Analysisでmaxで
33点と、Hydrogenのmedium(41点)より大きく下回ります。 - ピーク時間(平日UTC
01:00から04:00、06:00から10:00)は価格が2倍になります。 - DeepSeek自身のプラットフォームでは、データは中国に本社を置く企業に送られるので、まずは自社のデータルールと照らして確認してください。
**料金:**オフピークで100万トークンあたり入力$0.15、キャッシュヒット$0.003、出力$0.60。ピーク時は$0.30/$0.006/$1.20です。DeepSeekの料金ページより。
ベンチマークだけでは、ここでは話の全体が見えません。エージェントの直接対決テストを行ったあるビルダーは、こう投稿していました。
"Right now DeepSeek Flash 4.1 Flash has a 64% win rate against GPT 6.1 Sol. Small data still, but it has 33 wins vs. 18 losses"
**私の見解:**Hydrogenの料金を払う前に、大量のジョブであれば比較テストをする価値があります。DeepSeek V4.1 Flashの料金ガイドではピーク時間の計算を扱っています。
7. Kimi K3.1 Pro
**最適な用途:**大規模なオープンウェイトモデルが必要で、応答を待てるチーム。
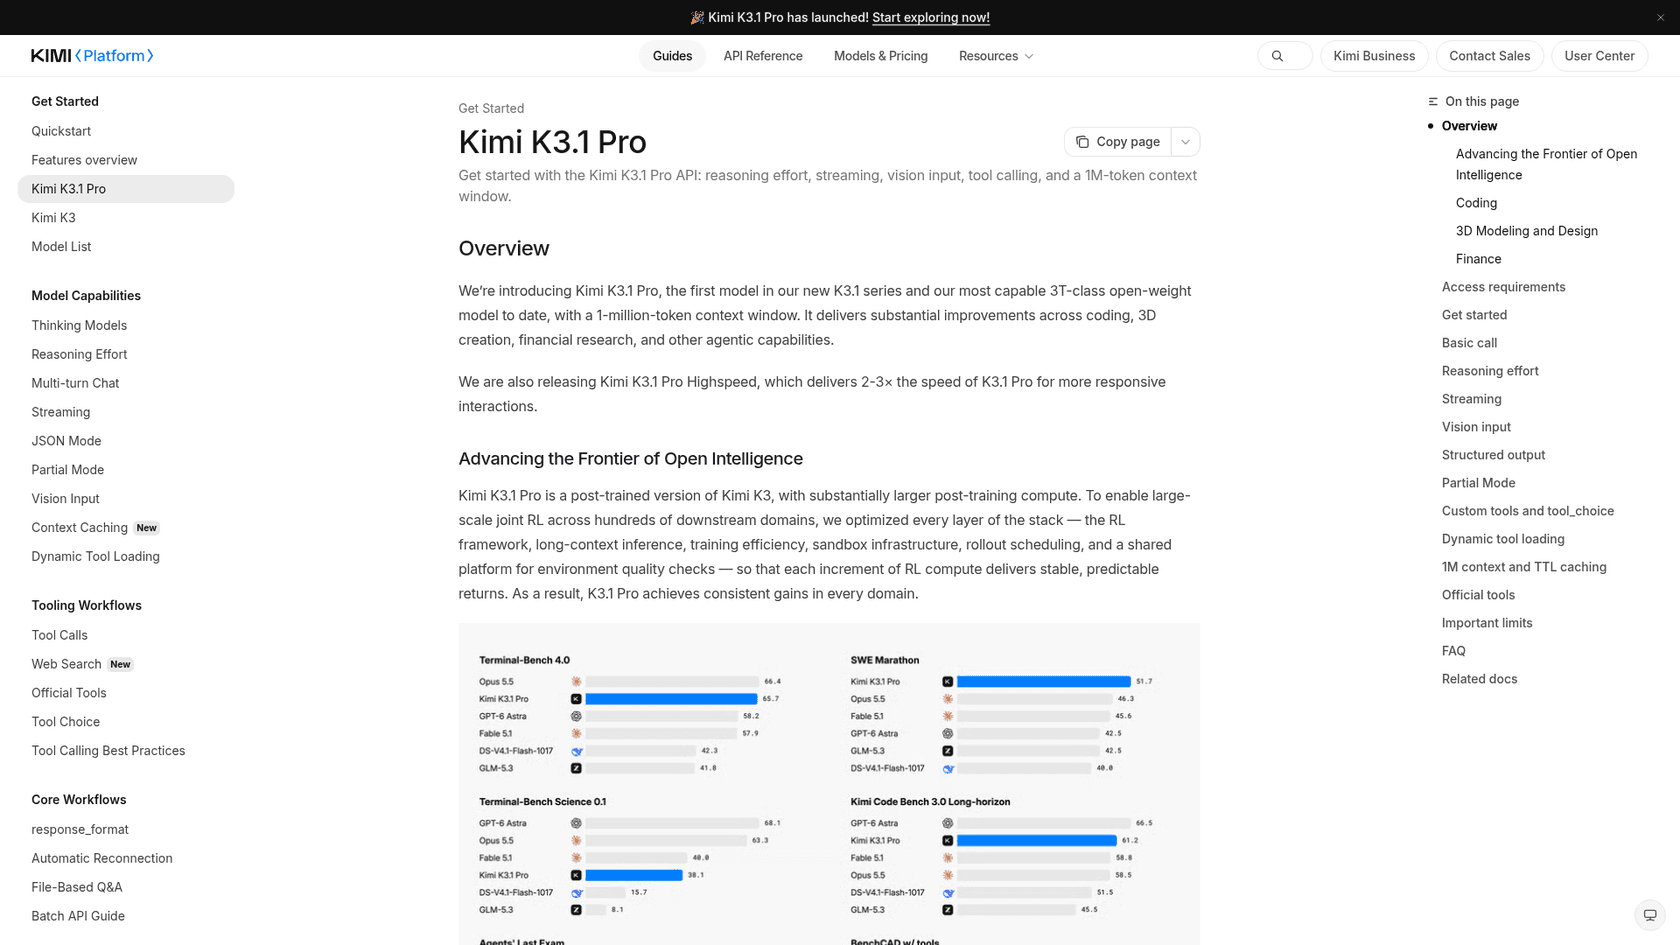
Kimi K3.1 ProはMoonshot AIのフラッグシップで、ドキュメントでは「our most capable 3T-class open-weight model to date」と説明されています。重みは今ではHugging Faceで公開されています。
長所
- Artificial Analysisでは、同じサイズクラスの28のオープンウェイトモデルの中で
46点で1位です。 - 1,048,576トークンのコンテキスト、画像入力、標準価格の60%でのバッチ推論に対応しています。
- Highspeed版(
$4/$20)はMoonshotによると2〜3倍速く動作します。
短所
- Artificial Analysisで1タスクあたり
$3.68、38.3分かかり、オープンウェイトモデルとしては遅くて高いと評されます。 - AAは最初の回答トークンまでの時間を
172秒、約31トークン/秒と測定しています。 - Solと同じ
$2/$10の定価で、スコアはより低いです。
**料金:**100万トークンあたり入力$2、キャッシュヒット$0.20、出力$10。Moonshotの料金ページより。
**私の見解:**オープンウェイトが必須条件のときの選択肢であり、Hydrogenに対する節約手段ではありません。安さだけが必要なら、DeepSeekが勝ちます。Kimi K3.1 Proのレビューでさらに詳しく解説しています。
8. GPT-6 Luna
**最適な用途:**トリアージ、タグ付け、ルーティングを可能な限り最安で。
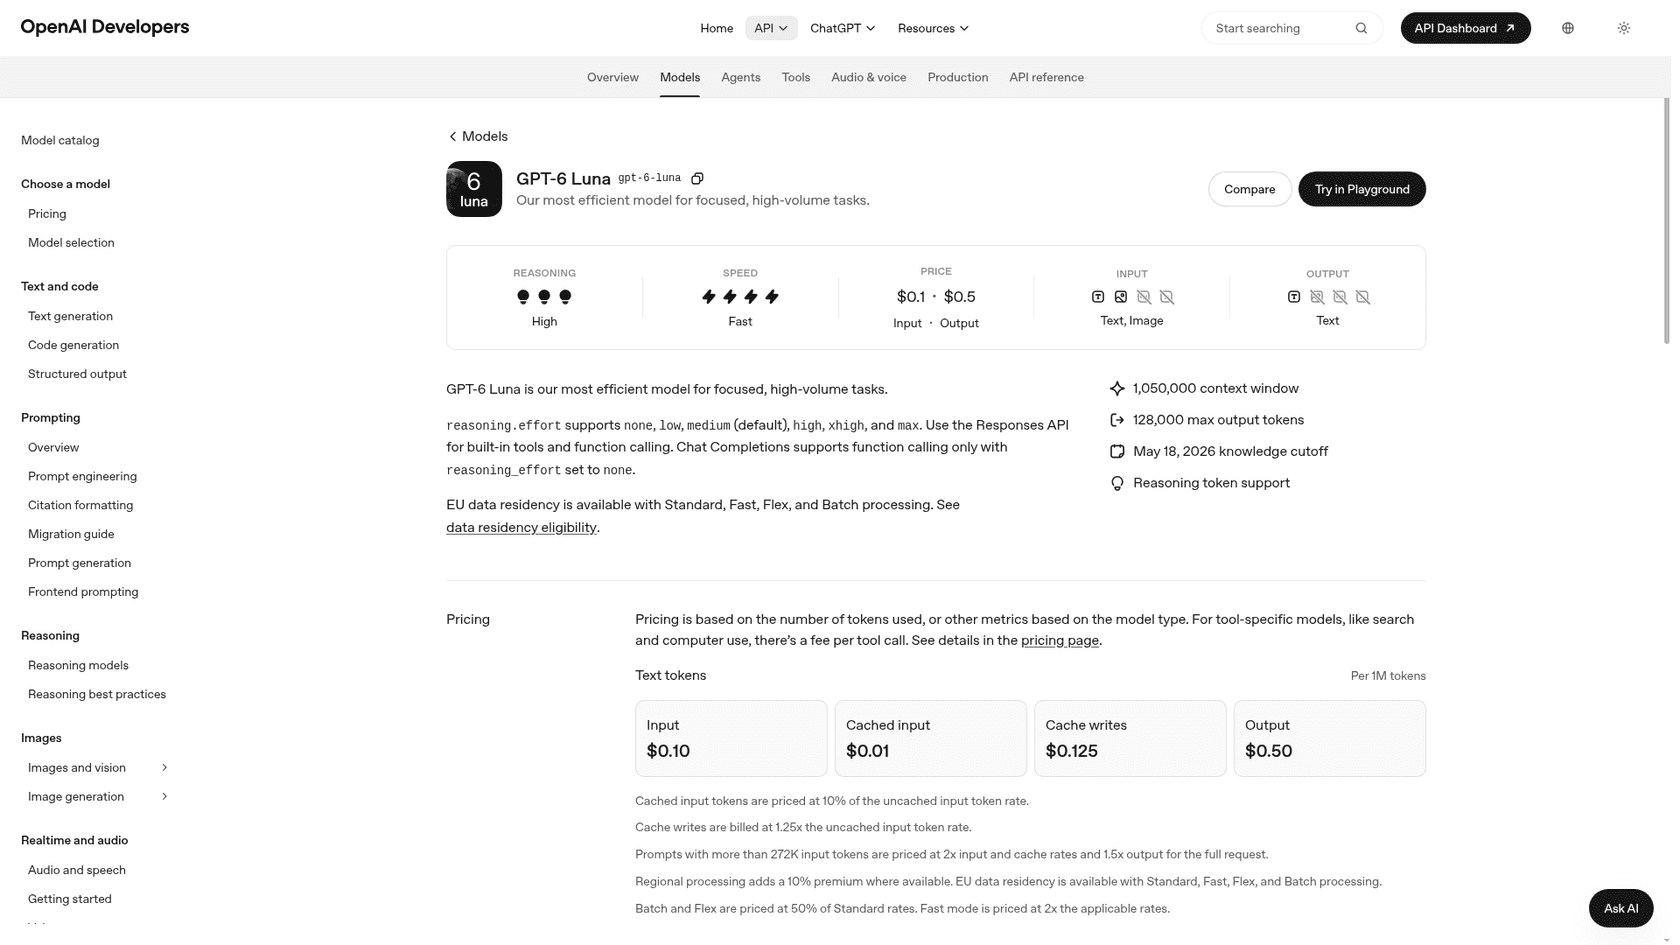
GPT-6 LunaはOpenAIの最小モデルで、「our most efficient model for focused, high-volume tasks」です。Hydrogenが現行のFlashの2倍の価格で登場したとき、Gemini 3.8 Flashのユーザーが最初に目を向けた先です。
長所
- 100万トークンあたり
$0.10/$0.50なので、例の請求額は$350です。 - Artificial Analysisでmaxエフォート時に1タスクあたり
$0.15と、このリストで最安です。 - エフォートが
noneのときはChat Completionsのfunction callingに対応しており、シンプルなルーティングコードの移植が簡単になります。
短所
- maxでも
28点と、Hydrogenのmediumよりさらに大きく下回ります。 - 入力272Kトークンを超える場合の追加料金は、他のOpenAIモデルと同じです。
- 単体では複数ステップのエージェント作業には向きません。
**料金:**100万トークンあたり入力$0.10、キャッシュ$0.01、出力$0.50。OpenAIの料金ページより。
**私の見解:**ルーティング済みの構成の入り口であり、Hydrogenの完全な置き換えではありません。リクエストの振り分けを担わせ、難しいものは上に回しましょう。
どのGemini 4 Hydrogenの代替を選ぶべきか?
ランキングからではなく、離れたい理由から出発しましょう。理由ごとに、指す先のモデルは異なります。
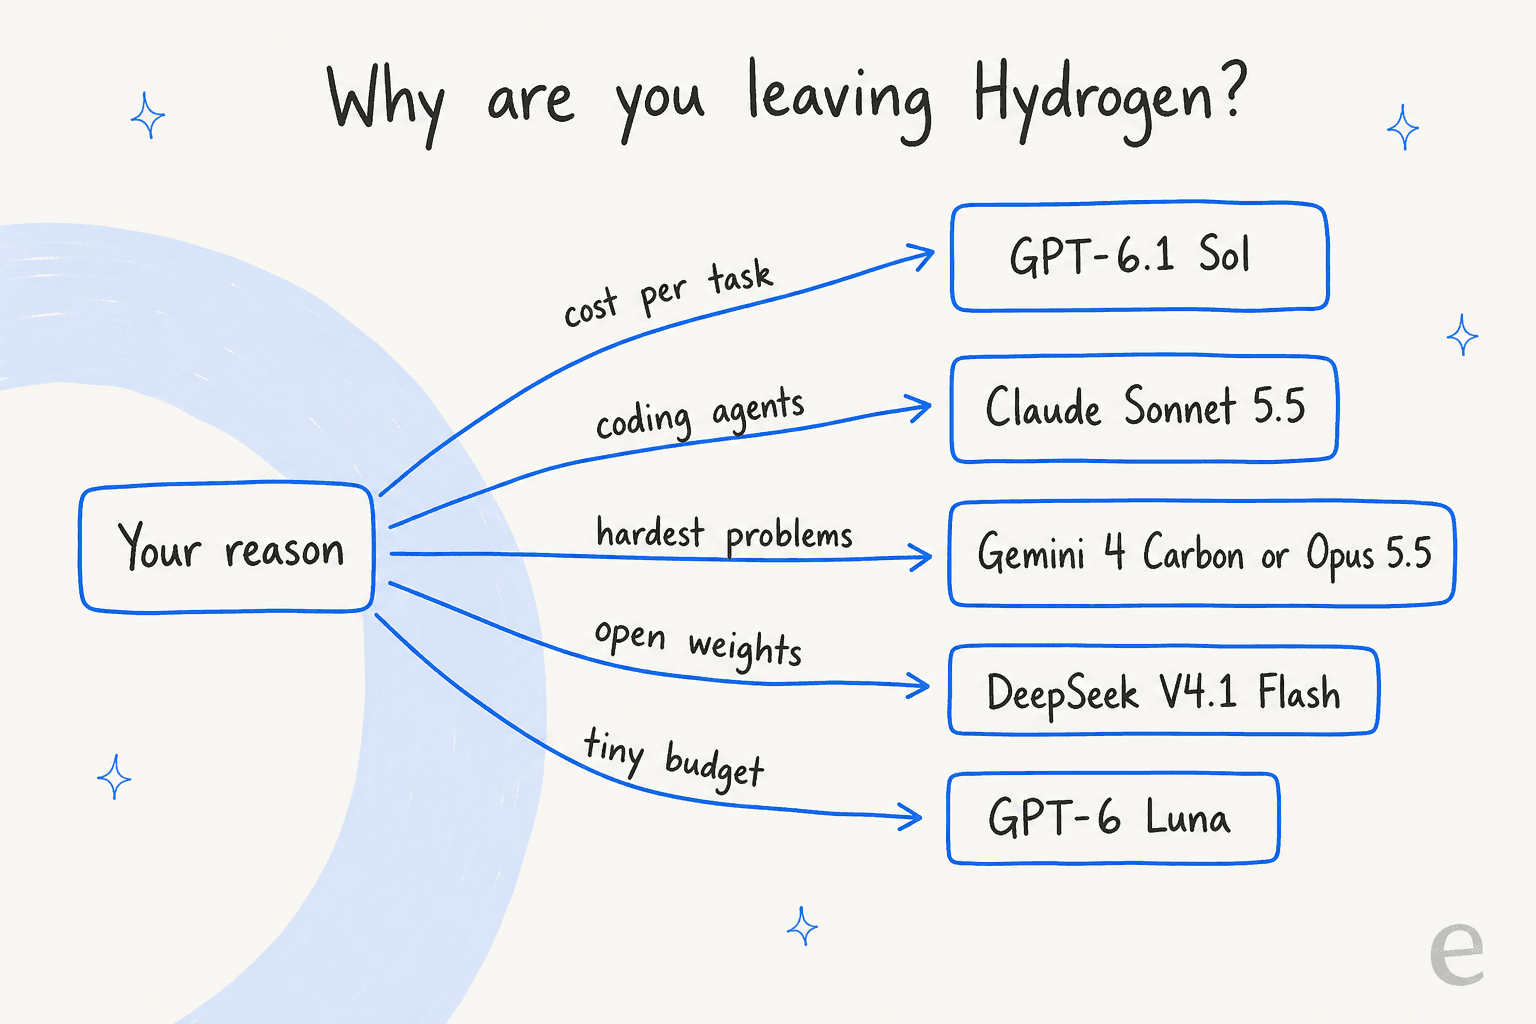
| 理由が... | 選ぶべきは | 理由 |
|---|---|---|
| highやxhighでの請求額 | GPT-6.1 Sol | $1.87のHydrogenの51点に対し$0.76で52点 |
| 速くて安い中程度の作業 | GPT-6.1 Terra | Hydrogen medium の$0.80で41点に対し$0.26で42点 |
| コーディングやコンピュータ操作のエージェント | Claude Sonnet 5.5 | Google自身の表でTerminal-Bench 4.1とOSWorld-2.1に勝つ |
| 最も難しい問題、Googleのまま | Gemini 4 Carbon | mediumで58点、同じAPI |
| 最も難しい問題、ベンダーを問わず | Claude Opus 5.5 | maxで59点、安いキャッシュ読み取り価格 |
| 最も低い請求額 | DeepSeek V4.1 Flash | 例の請求額で$5,250に対し$480 |
| 最上位のオープンウェイト | Kimi K3.1 Pro | AAでそのクラス最高のオープンウェイトモデル |
| トリアージとルーティング | GPT-6 Luna | 1タスクあたり$0.15 |
1つに絞る必要もありません。ローンチスレッドのあるコメンターは、多くのエージェントに私が勧めたい構成を説明していました。
"I have found it a good subagent workhorse for code implementation, with some higher level model doing the spec and review."
これは、Hydrogenを作業役、CarbonやOpusのようなものを計画役にするということで、Googleがオーケストレーターに組み込んだのと同じ役割分担です。請求額が問題なら、作業役をSolやTerraに置き換え、構造はそのまま保ちましょう。
切り替え前に代替モデルをどうテストするか?
ベンチマークは他人のタスクでモデルを順位付けしているだけです。本番トラフィックを移す前に、自分自身のテストを実行しましょう。
- ログから実際のリクエストを50〜100件取り出す。扱いにくいものも含めて。
- 各候補を2つのエフォートレベルでテストする。レベルの方がモデルよりもコストを動かすからです。
- 成功したタスクあたりのコストを測る。リトライも数え、100万トークンあたりのコストでは測りません。
- 移行時の落とし穴を確認する:Hydrogenはサンプリング設定を無視し、Claudeは標準外の
temperatureを拒否し、OpenAIはツールコールにResponses APIを求めます。片方用に調整したプロンプトは、無変更で別のモデルに移りません。 - フォールバックモデルをつないでおく。そうすれば、次の価格変更や障害が設定の切り替えで済み、書き直しにならずに済みます。
Google自身のHydrogenに関するアドバイスも同じことを言っています。1つに決める前に「at all four levels」で評価を実行してください。
モデルがサポートキューのためのものなら
Hydrogenの代替を比較している人の多くは、実際にはサポートボットを作っています。私はAIエージェントを稼働中のヘルプデスクにつなぐ作業を何年もしてきましたが、最初に壊れるのはモデルであることはまれで、その周りのルールであることが多いです。私が見る失敗は、できないことを約束するボットや、引き継ぐべきときに引き継がないボットです。モデルを大きくしてもそれは直りません。明確なエスカレーションルールと、自社のヘルプセンターと過去のチケットに根拠を置いた回答がそれを直します。これは、どのモデルが文章を書くかにかかわらずAIハルシネーションを低く抑える方法でもあります。
SE Rankingは、そのレイヤーの良い例です。Zendeskで3つのプロダクトを、プロダクトごとに1つのeeselエージェントで運用し、約16,800ページのナレッジから回答し、1か月で4,650件の会話を処理しました。返金、トライアルの延長、担当者への依頼は、すでに詳細がまとまった状態でチームに渡ります。プライベートナンバープレートの販売業者であるSwiftregは、ライブの注文データから、自社チームが書いたルールのもとで月に約2,100件のZendeskチケットに回答しています。どちらの構成も、今週どのモデルが最速かには依存していません。
ターミナルから作業したい場合、eesel CLIはダッシュボードと同じチームメイトを操作します。Claude Codeのようなコーディングエージェントは、エクスポート済みのヘルプ記事や保存済みの返信といった承認済みのナレッジをアップロードし、エージェントの指示を調整し、公開前にテストの質問をして回答を確認できます。ヘルプデスク自体の接続には、依然として管理者権限を持つ人の承認が必要で、アップロードされたナレッジはテスト済みのナレッジとは違うため、テストのステップは残ります。
eeselを試す
Hydrogen、Sol、Sonnetはエンジンです。あなたが作っているものがサポートの自動化なら、eeselはこうしたモデルの上でその仕事を行うAIヘルプデスクチームメイトです。ZendeskやFreshdeskなど、すでに使っているヘルプデスクに接続し、過去のチケットやマクロ、ヘルプセンターから学び、あなたが設定した引き継ぎルールに従います。誰かに返信する前に、実際の過去のチケットに対して走らせ、その回答をチームが実際に送った内容と比較できます。
料金は固定の月額クレジットプランで、1件のチケットまたはチャットが1クレジットです。500クレジットで月$299から始まります。トークンあたりの料金はないので、GoogleやOpenAIが価格を変えても請求額は動きません。eeselを試すには、キューの一部で7日間、100クレジットを無料で使えます。