

Gemini 4 Neonは、難しいエージェント作業と長文ドキュメント処理に使うなら私が選ぶGoogleのモデルで、highで実行する。Artificial Analysisは59.6というスコアを記録し、1タスク$3.74で、同じスコアを出すCarbonの$7.76のおよそ半分だ。ただしそのスコアに到達する最安のルートではない。OpenAIのAstraは$2.07で60.1に達し、Neonは1タスクあたり5倍から6倍多くのトークンを書く。Neonの本当の強みは誠実さだ。答えられなかった質問のうち14%で誤った推測をしたのに対し、SolとAstraは54%から61%だった。
eesel CLIを使うと、コーディングエージェントが承認済みのヘルプ記事をeeselのヘルプデスクチームメイトにアップロードし、自社のチケットでその回答をテストできる。これは顧客に返信する前にどのモデルでも私が確認する方法だ。
Gemini 4 Neonをどうレビューしたか
Neonをまだ自分のテストスイートに通していないため、以下の数字はすべて、リリース当日の2026年11月19日に確認できた3つの出典から来ている。
- Google自身のページ: リリース記事、モデルカード、料金ページ。
- Artificial Analysis: Neon、Carbon、Hydrogen、Sol、Astra、Opus 5.5の各モデルページで設定ごとの結果を読んだ。このインデックスは9種類の評価からなるスイートなので、以下の「タスク」は自社のチケットではなく1つのベンチマークタスクを指す。
- Hacker Newsのリリーススレッドは、開始当日に460ポイントを超えた。
ユーザーの声を知るためにRedditとXを試したが、どちらも読み込めなかったため、コミュニティの引用はすべてHacker Newsからだ。自社のワークロードがベンチマークと異なる場合は、この評価を結果ではなく候補リストとして扱ってほしい。Neon解説記事でモデルID、アクセス方法、移行について取り上げているので、ここでは簡潔にまとめる。
Gemini 4 Neonとは何か、1段落で
Neonは、2026年11月18日にgemini-4-neonとしてリリースされたGoogleのGemini 4ファミリーの中間モデルだ。GoogleによればCarbonから派生し、同じ1,048,576トークンのウィンドウを共有し、4段階の思考レベル(low、medium、high(デフォルト)、xhigh)を持つ。100万入力トークンあたり$3、100万出力トークンあたり$15で、無料プランはない。Googleはこれを「深さと効率」のバランスと呼び、自社のチャートではHydrogenとCarbonの間に位置づけている。
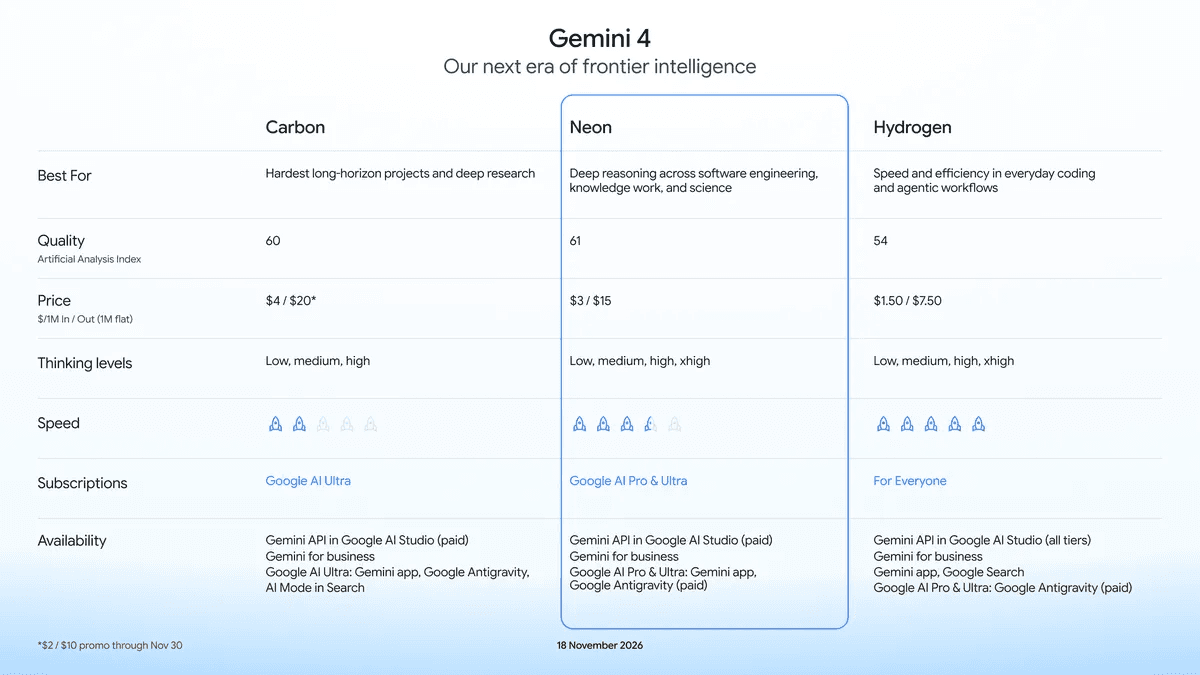
Gemini 4 Neonは難しいタスクに強いか?
強い、そしてその根拠はリリース当日のほとんどの主張より確かだ。理由は、リーダーボードとGoogle自身の表が一致しているからだ。Artificial AnalysisはNeonをxhighで61.4、highで59.6と評価し、Opus 5.5の59.1、Solの57.3(それぞれ最良設定)を上回っている。Google自身が報告した表は、その優位がどこから来ているかを示している。
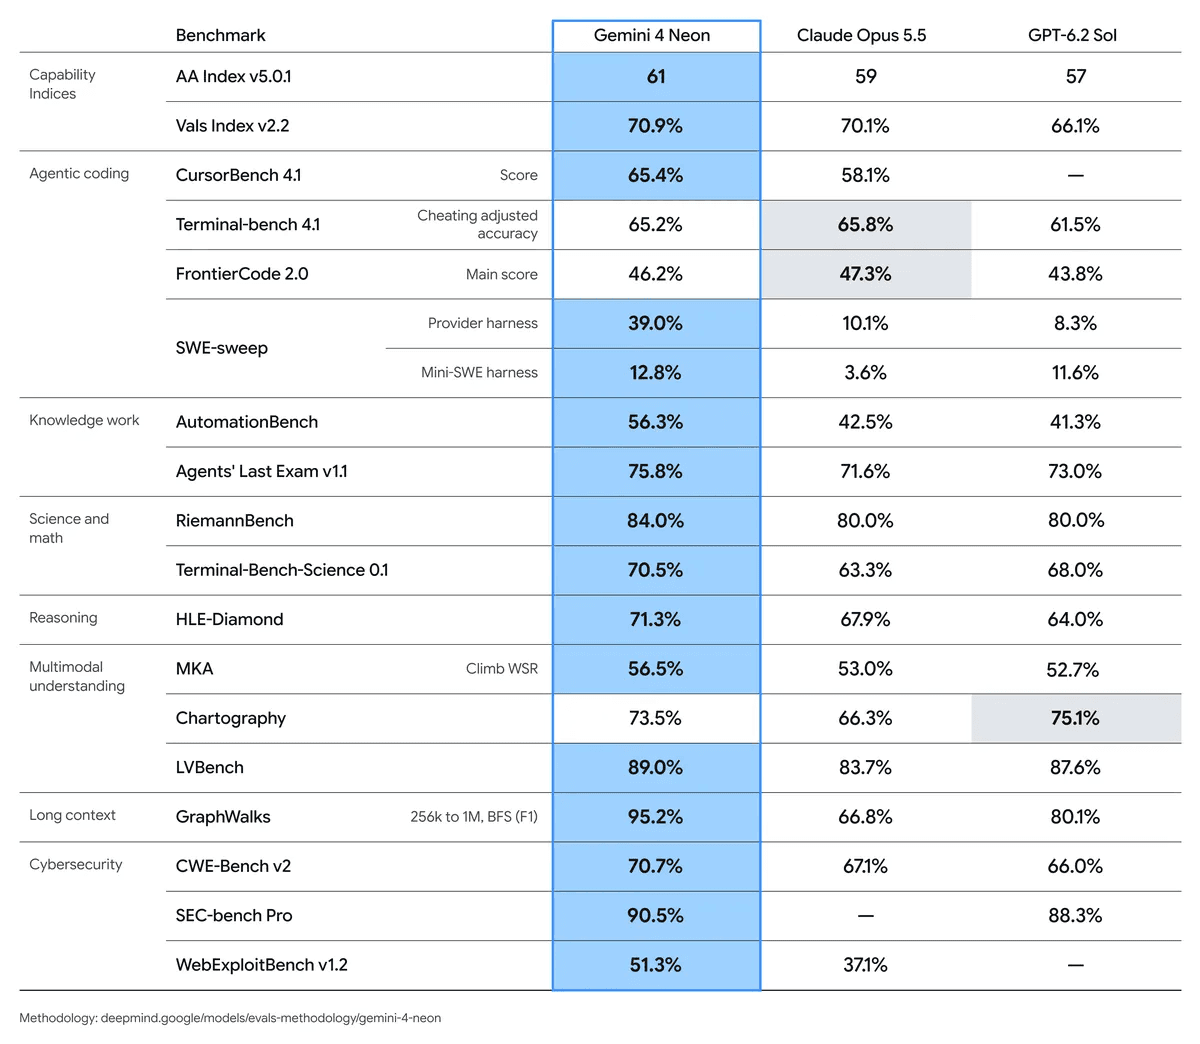
太字のセルではなく列を読むと:
- 知識ワーク系エージェント: AutomationBenchで
56.3%、Opus 5.5の42.5%、Solの41.3%に対して。 - 長文コンテキスト: 256kから1MトークンまでのGraphWalksで
95.2%、66.8%と80.1%に対して。仕事が「非常に長い文書を読み、正確に答える」ことなら、重要なのはこの行だ。 - コーディング、混在: Opus 5.5はTerminal-Bench 4.1でわずかに上(
65.8%対65.2%)、FrontierCode 2.0でも同様(47.3%対46.2%)。NeonのSWE-sweepでの39.0%という優位はAntigravity独自のハーネスを使っているため、あまり信用しないほうがいい。
これらはGoogleが選んだGoogleの数字だ。独立した数字は以下のArtificial Analysisの行で、見出しのスコアよりも興味深い話を語っている。
各設定でNeonのタスク単価はどれくらいか?
トークン単価は請求額の大部分を隠してしまう。思考トークンが出力として課金されるためだ。以下は、2026年11月19日に私が読んだ、Neonとその兄弟モデルの設定ごとのArtificial Analysisデータだ。
| 設定 | インデックススコア | タスク単価 | タスクあたりの分数 | タスクあたりの出力トークン数 |
|---|---|---|---|---|
| Neon low | 44.1 | $0.75 | 3.7 | 21,726 |
| Neon medium | 54.9 | $1.90 | 8.3 | 50,000 |
| Neon high(デフォルト) | 59.6 | $3.74 | 14.8 | 90,188 |
| Neon xhigh | 61.4 | $6.44 | 21.5 | 141,631 |
| Carbon high | 60.0 | $7.76 | 37.2 | 122,768 |
| Hydrogen xhigh | 53.9 | $3.16 | 15.2 | 154,406 |
| Opus 5.5 max | 59.1 | $10.04 | 24.5 | 173,313 |
| Astra high | 60.1 | $2.07 | 5.9 | 17,828 |
| Sol max | 57.3 | $1.01 | 8.5 | 40,360 |
3つの点が目立つ:
- NeonはCarbonの得意分野でCarbonを上回る。 highでは、52%少ないコストと60%少ない時間で、半ポイント以内でCarbonのスコアに並ぶ。GoogleはCarbonに対して32%のコスト削減を主張しているが、このデータによれば実際の差はその宣伝よりも大きい。
- highが最適解だ。 mediumからhighに上げると、$1.84の追加コストで4.7ポイント得られる。highからxhighに上げると、$2.70の追加コストと6.7分の追加時間で1.8ポイントしか得られない。
- 問題はAstraだ。 同じスコアで、Astraは1タスク$2.07、5.9分で完了する。Astraのトークン単価は高い(入力$8、出力$40)にもかかわらず、タスク単価はおよそ45%安い。Neonが90,188トークンを書くところを、Astraは17,828トークンしか書かないためだ。
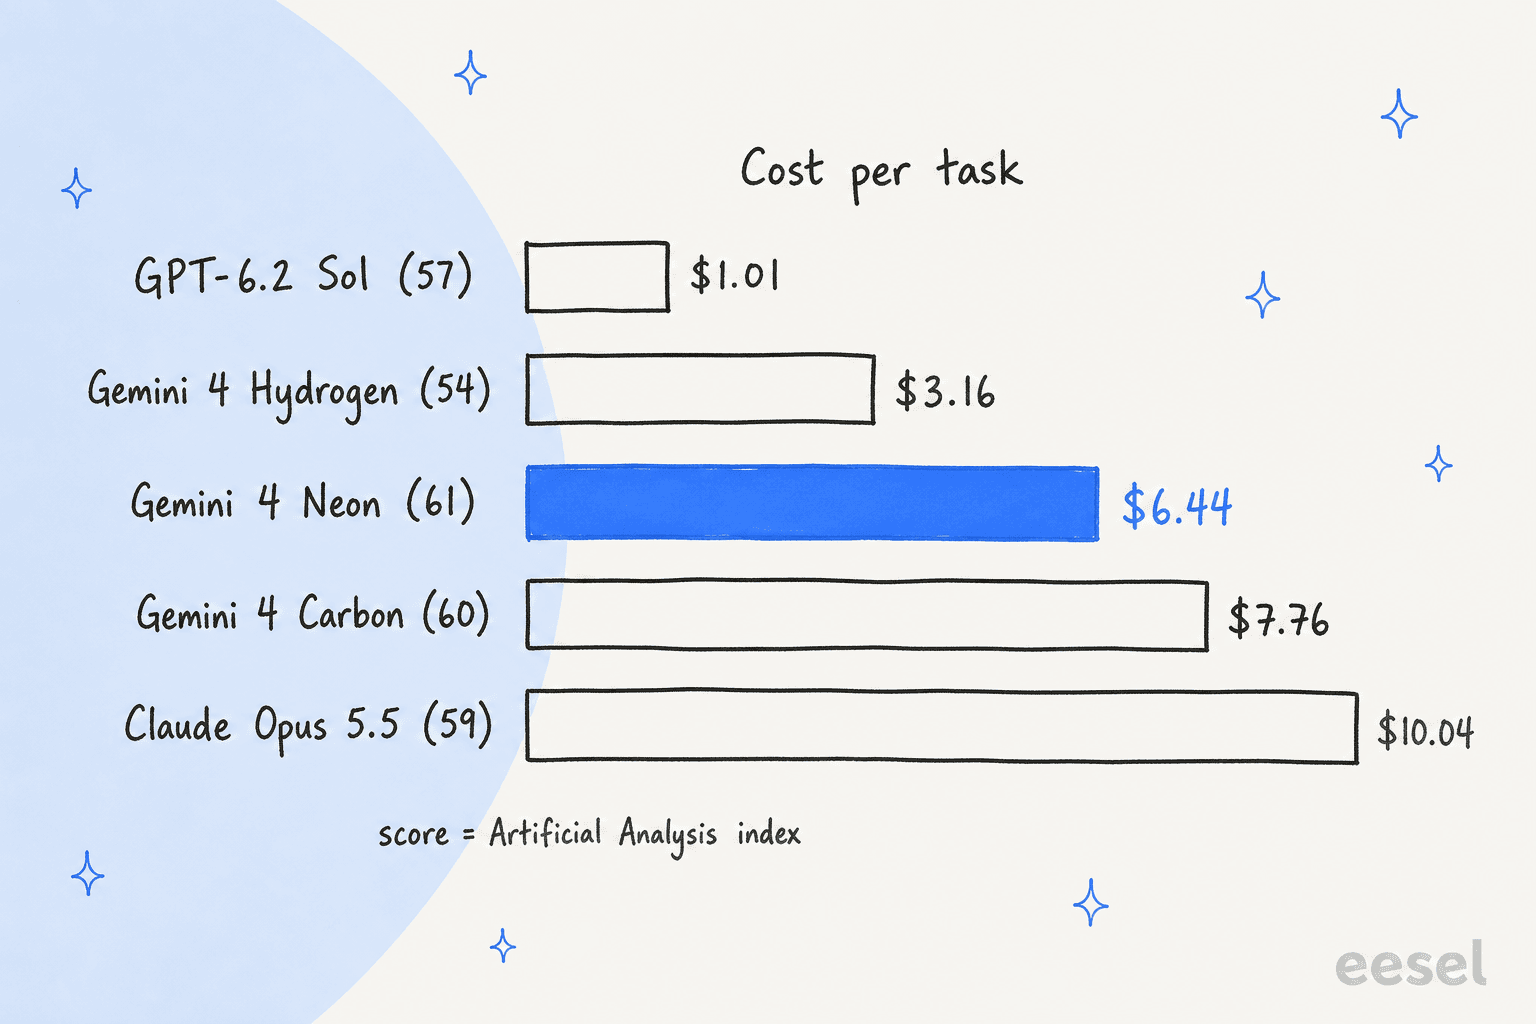
このチャートは各モデルの最良設定を使っている。これは「このモデルが最大でどこまでできるか」を比べるには公平だが、「自分はいくら払うべきか」を比べるには不公平だ。2つ目の問いには表を使ってほしい。
Gemini 4 NeonはSolやOpusより幻覚が少ないか?
これは、このモデルへの見方を変えた発見だ。モデルが知らないときに回答を拒否する代わりに間違った答えを出す頻度を評価するArtificial AnalysisのAA-Omniscienceテストでは、Gemini 4ファミリーは他から大きく離れた位置にいる。
| モデルと設定 | 幻覚率(低いほど良い) | 正答率 |
|---|---|---|
| Gemini 4 Argon high | 4% | 48% |
| Gemini 4 Carbon medium | 4% | 49% |
| Gemini 4 Hydrogen xhigh | 8% | 50% |
| Gemini 4 Carbon high | 11% | 58% |
| Gemini 4 Neon high | 14% | 59% |
| Gemini 4 Neon xhigh | 14% | 60% |
| Claude Opus 5.5 max | 50% | 66% |
| GPT-6.2 Sol max | 55% | 62% |
| GPT-6.2 Astra high | 58% | 66% |
| Claude Fable 5.2 high | 58% | 77% |
Neonは「わからない」とOpus、Sol、Astraよりはるかに頻繁に答える。そしてその代償を生の正答率で払っている。59%から60%の正答率は、Astraの66%やFable 5.2の77%に対してかなり低い。Google自身のモデルの中でも、Carbon medium、Argon、Hydrogenよりも推測しがちだ。
この取引が良いかどうかは仕事内容によって決まる。常に答えを出さなければならないリサーチエージェントにとっては、余分な拒否は摩擦になる。自信がないときに引き渡すべき顧客対応エージェントにとっては、拒否するモデルの方が望むものに近く、それが私が最初に見るふるまいだ。大きな声で言っておきたい注意点が1つある。AA-Omniscienceは一般知識のテストであり、自社のヘルプセンターに対してモデルがどう振る舞うかは測っていない。信じる前に自社のチケットでテストしてほしい。
Gemini 4 Neonはどこで劣るか?
私が見つけた6つの本当の限界を、気になる度合いの順に挙げる。
- 口数が多い。 xhighでは、インデックス全体で2億8,300万の出力トークンを書いた。Solの6,090万に対してだ。出力トークンは$15のほうなので、請求額は料金表だけでなく、このモデルの癖によっても動く。
- 最高設定は遅い。 Artificial Analysisはxhighで、最初の回答トークンまで56.5秒、その後は1秒あたり110トークンと測定した。Carbonは73秒、1秒あたり55トークンを必要とするので、NeonはCarbonより速いが、
mediumを超えるとライブチャット向けのモデルではない。 - AstraとSolはタスク単価が安い。 トークン単価ではNeonはAstraより安い。だが表の通り、タスク単価ではそうではない。Sol maxは$1.01で57.3を記録し、Neon xhighより6.4倍安い。
- 答えるべきときの正確さが低い。 幻覚の表を見てほしい。トレードオフは慎重さと正確さの間にある。
- アクセスには条件がある。 無料のAPIプランはなく、あるHacker Newsの読者が引用したAntigravityのFAQでは、サブスクリプションアクセスをサードパーティ製ツールで使うことを禁止している。彼らはそれを決定的な欠点と呼んだ。
"I'd like to keep my Gmail account, so Google can keep their model and will not get my business."

別の読者は、単純なAPIキーという回避策を指摘した。
"You can't use subsidized tokens in 3rd party apps. Although they just suspend your Gemini account now, not your google account."
- 安全性レポートはまだ出ていない。 Googleのモデルカードには、完全なレポートが数日中に公開されると書かれている。公開されるまでは、規制対象のワークロードは保留すべきだ。
あなたの仕事ではどのモデルがNeonに勝るか?
今日の時点で私が下す判断は以下の通りだ。
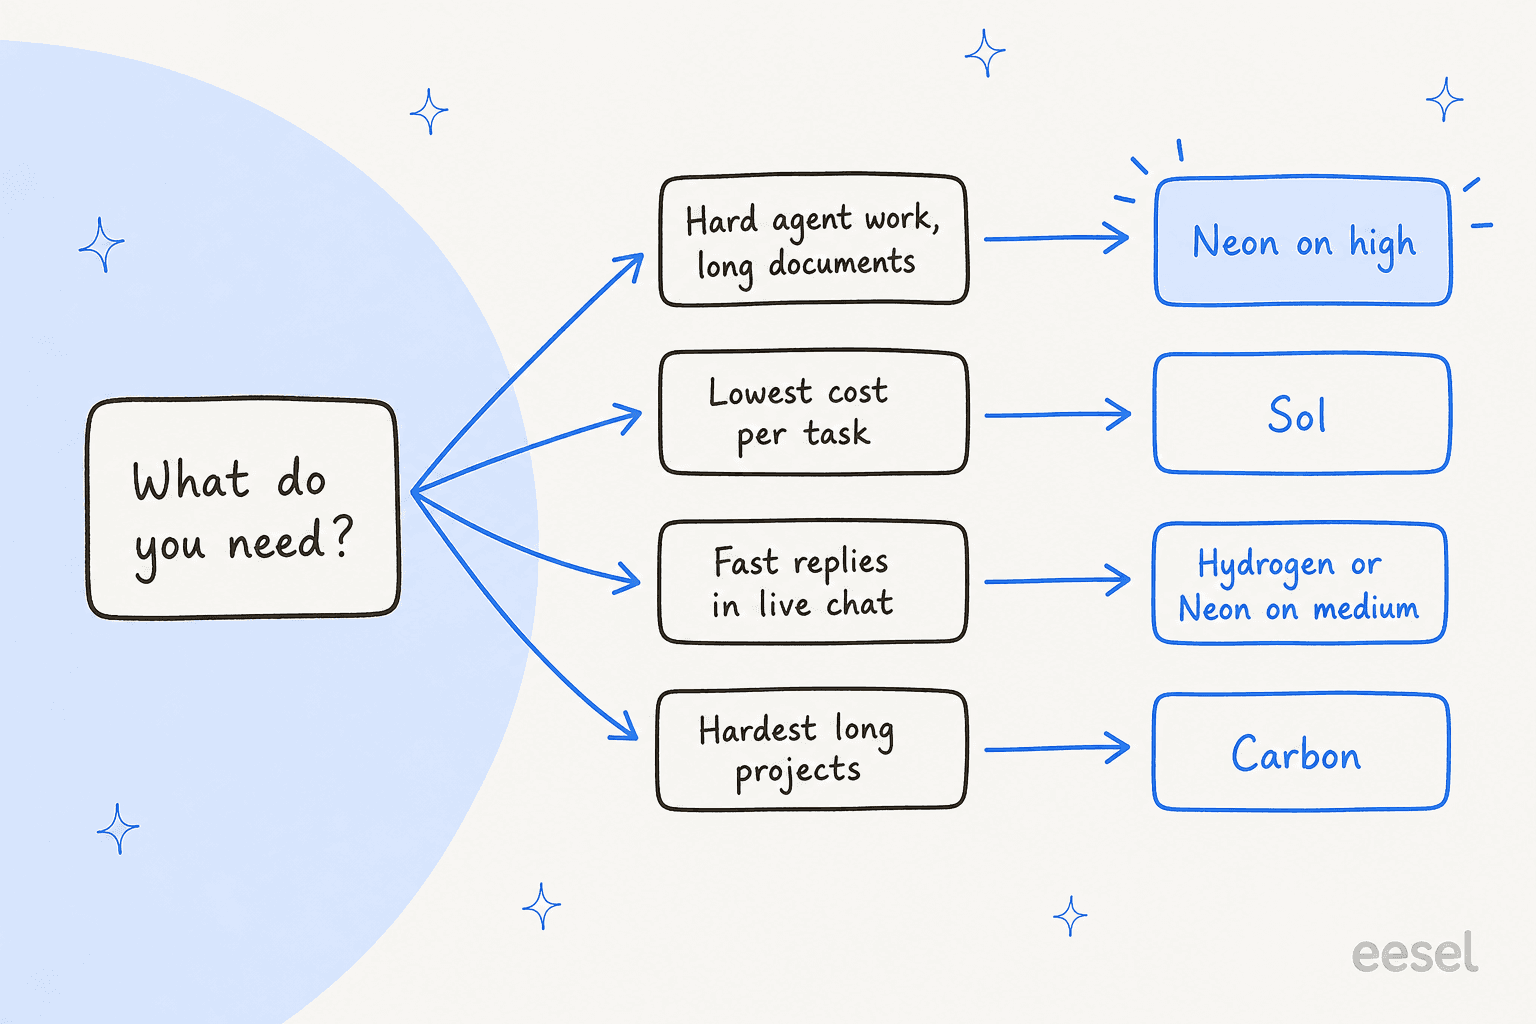
このフローは面白い部分、つまりコストと幻覚が逆方向に引き合っているという事実を隠している。そこで、データを1つのツールにまとめた。許容できる最低のインデックススコアと、許容できる最大の幻覚率を設定すると、私が集めたArtificial Analysisの各設定のうち両方の基準をクリアするものを、安い順にすべて一覧表示する。
極端な値も試してみてほしい。幻覚率の上限なしでスコア55を求めると、Sol xhighが$0.65で価格で勝つ。同じスコアで上限を20%前後にすると、Neon highが$3.74で最安の答えになり、Carbon mediumは4%でより慎重な選択肢になる。スコアを54に下げると、Neon mediumが$1.90で主役になる。高いスコアと低い誤答率を両方同時に得られるのはGemini 4ファミリーだけであり、それがNeonを選ぶ誠実な理由だ。
NeonはCarbon、Hydrogen、Astra、Sol、Opusと比べてどうか?
| モデル | 100万あたり入力/出力価格 | 最良設定スコア | タスク単価(最良) | 幻覚率 | 一言での評価 |
|---|---|---|---|---|---|
| Gemini 4 Neon | $3 / $15 | 61.4 | $6.44 | 14% | 難しい作業に最適なGemini。highで使うべき |
| Gemini 4 Carbon | プロモ終了後は$4 / $20 | 60.0 | $7.76 | 11% | ほとんどの作業でNeonが代替になる |
| Gemini 4 Hydrogen | $1.50 / $7.50 | 53.9 | $3.16 | 8% | 小さなタスクのデフォルト |
| GPT-6.2 Astra | $8 / $40 | 62.1 | $4.00 | 59% | スコアは高いがトークンが少なく、推測も多い |
| GPT-6.2 Sol | $2 / $10 | 57.3 | $1.01 | 55% | タスク単価では圧倒的に最安 |
| Claude Opus 5.5 | $4 / $20 | 59.1 | $10.04 | 50% | Neonはおよそ3分の1のコストで同等のスコアに並ぶ |
Carbonの定価は12月1日から$4/$20、11月30日まで$2/$10だ。これはあと数日だけNeonよりトークン単価が安くなることを意味する。だがタスク単価の計算は変わらない。Carbonははるかに長く考えるためだ。
Gemini 4 Neonについて人々は何と言っているか?
Hacker Newsのリリーススレッドは460ポイントを超えた。最も有用だった返信は、Neonを競合モデルとVals上で比較し、その上で価格を位置づけていた。
"Latency is by far the best for the level of quality. It's about 2x more expensive than Sol 6.2, but significantly better and faster. You get what you pay for."
Solとのトークン単価の差は2倍ではなく1.5倍で、ベンチマークタスク単価では設定によって1.9倍から6.4倍の差になる。つまり「you get what you pay for」は品質の面では成り立つが、響きよりも高価だ。別の読者は同じ価格を損失として読み取った。
"That looks to me like OpenAI equals or beats everything Google offers at half the price."
Artificial Analysisの数字で見ると、これはタスク単価についてはほぼ正しく、幻覚についてはほぼ間違っている。だからこそ私はこのレビューで両者を分けて扱っている。長いエージェント作業をテストする3人目のコメント者は、スコアにはあまり興味を示さなかった。
"Argon and Carbon both made such discoveries such as "it would seem that i need to be pointing at an enemy to shoot them". Its almost entertaining to read, its like its discovering the world on first principles."
このユーザーは投稿時点でちょうどNeonで同じタスクを始めたところだったので、まだ結論は出ていない。そしてある読者は、多くの人がGoogleに望むことをまとめていた。
"Hydrogen has already became my default for 80% of small tasks. If Neon is as fast but smarter that would honestly be very cool"
データ上では、NeonはhighでHydrogenより8.8ポイント賢いが、タスク単価は2倍($3.74対$1.87)だ。これらは個々のコメント者であって調査ではなく、さらに多くの声を知るためにRedditやXにアクセスすることもできなかった。
Gemini 4 Neonを使うべきなのは誰か?
| あなたは... | 私のアドバイス |
|---|---|
| 難しいコーディングや分析にCarbonやArgonを使っている人 | Neonのhighに切り替えて比較してみてほしい。同じスコアで、コストと時間はおよそ半分だ。 |
| Opus 5.5のmaxに料金を払っている人 | Neon highをテストしてほしい。スコアは同水準で、請求額はおよそ3分の1だ。 |
| プランナーとワーカーのエージェントを構築している人 | Neonが計画し、Hydrogenが実行する。 |
| 非常に長いドキュメントを読む人 | GoogleのGraphWalksの行とAAの知識ワーク結果からすると、Neonが向いている。 |
| 何よりもタスク単価を最適化したい人 | Neonは見送ってほしい。SolかAstraを使ってほしい。 |
| ライブチャットの返信を構築している人 | Neonならmediumまでにとどめるべきだ。あるいはHydrogen。 |
| 無料プランが必要な人 | Hydrogen。Neonには無料プランがない。 |
| 簡単な作業にGemini 3.8 Flashを使っている人 | そのままでいい。Neonは過剰で、より口数も多い。 |
ファミリー同士で選んでいるなら、私のChatGPTとGeminiの比較とGeminiの代替候補のまとめがさらに広く取り上げている。このクラス全体についての私のより広い見方は、frontier AIの記事にまとめている。
このレビューはサポートチームにとって何を意味するか?
サポートエージェントは、「推測するより拒否する」という結果が見出しのスコアよりも重要になる場所だ。返金に関する質問への自信満々の誤答は、人への引き渡しよりも高くつく。だがモデルは一部分にすぎない。エージェントが何を知っているか、いつ引き渡すべきか、リリース前に誰かがテストしたかどうかが、その振る舞いを決める。
これは、ドイツのローン比較企業であるsmavaが1つのZendeskでeeselを運用している型だ。2026年8月8日から9月8日の間に、3体のeeselエージェントが約27,000件のチケットを処理した。1体は約14,600件を分類し、1体は820件のマクロとヘルプ記事から約15,300件の返信を作成し、ブランドごとのエージェントが顧客に送れる状態の回答を用意した。各エージェントには1つの仕事と、絶対にしてはならないことのリストがあり、人間がすべての下書きを送信前に承認する。SamCartも同じように分けている。Freshdeskのメール用に1体、ウェブサイトのチャット用に別の1体で、それぞれ異なるトーンを持つ。
モデル選択は、その設計の中にある1つの設定であり、設計そのものではない。自社のキューでモデルを比較したいなら、過去のチケットでエージェントをシミュレートし、正確さだけでなく引き渡し率を見てほしい。私のどのLLMが最適かガイドでは私が行うチェックを取り上げており、AIカスタマーサービスのコストではキュー全体のコストを示している。
チームがターミナルで構築しているなら、eesel CLIを使えばコーディングエージェントが繰り返し作業を担える。エクスポートしたヘルプ記事やマクロのアップロード、エージェントの指示の調整、本番公開前のテスト質問などだ。ヘルプデスク自体の接続には、依然として管理者の承認が必要だ。これらのツールがNeonのようなモデルとどう連携するかについては、エージェント型コーディングCLIとAIエージェントMCPサーバーのガイドを参照してほしい。
Gemini 4 Neonについての私の結論
もともとCarbonやOpus 5.5に料金を払う予定だったなら使うべきだ。highで実行し、トークン単価ではなくタスク単価で測ってほしい。タスク単価だけが制約なら見送るべきだ。SolとAstraの方が安いからだ。無料プランが必要な場合も同様に見送るべきだ。最良の特徴は61.4というスコアではない。これほど有能なモデルがめったに誤って推測しないという点であり、それは判断する前にテストする価値がある。
eeselを試す
キューでより良い回答を得たくてモデルを選んでいるなら、eeselのAIヘルプデスクチームメイトはモデルを決めることなくそれを実現してくれる。過去のチケットとヘルプセンターから学習し、ドキュメントに答えがないときは人に引き渡し、誰かに返信する前に実際のチケット履歴でテストできる。ZendeskとFreshdeskの中で動作し、カスタマーサポートのAI導入でまず試すべきものだと私は思う。
料金は固定の月額クレジットプランで、カード登録不要で100クレジットの無料プランもあるため、モデルの価格変更が請求額を動かすことはない。eeselを試してみる、まずはキューの一部から。