

ほとんどのセキュリティチームにとって、GPT-6 Cyberの最良の代替はAnthropicのCyber Verification ProgramによるClaude Opus 5.5です。そのRed Teamの段階では、セーフガードを外した場合と同じ割合で、50件中34件の攻撃的タスクをブロックなしで完了し、価格は100万トークンあたり4ドル/20ドルで、GPT-6 Cyberの20ドル/100ドルの5分の1です。自分のコードをレビューするだけなら、OpenAI自身のアドバイスどおり、RedではなくまずDaybreak Blueから始めてください。GPT-6 Cyberが正しい選択になるのは、リモートの対象に対して実際に機能するエクスプロイトが必要で、2段目の承認を待てる場合だけです。
なぜ人々はGPT-6 Cyberの代替を探しているのか?
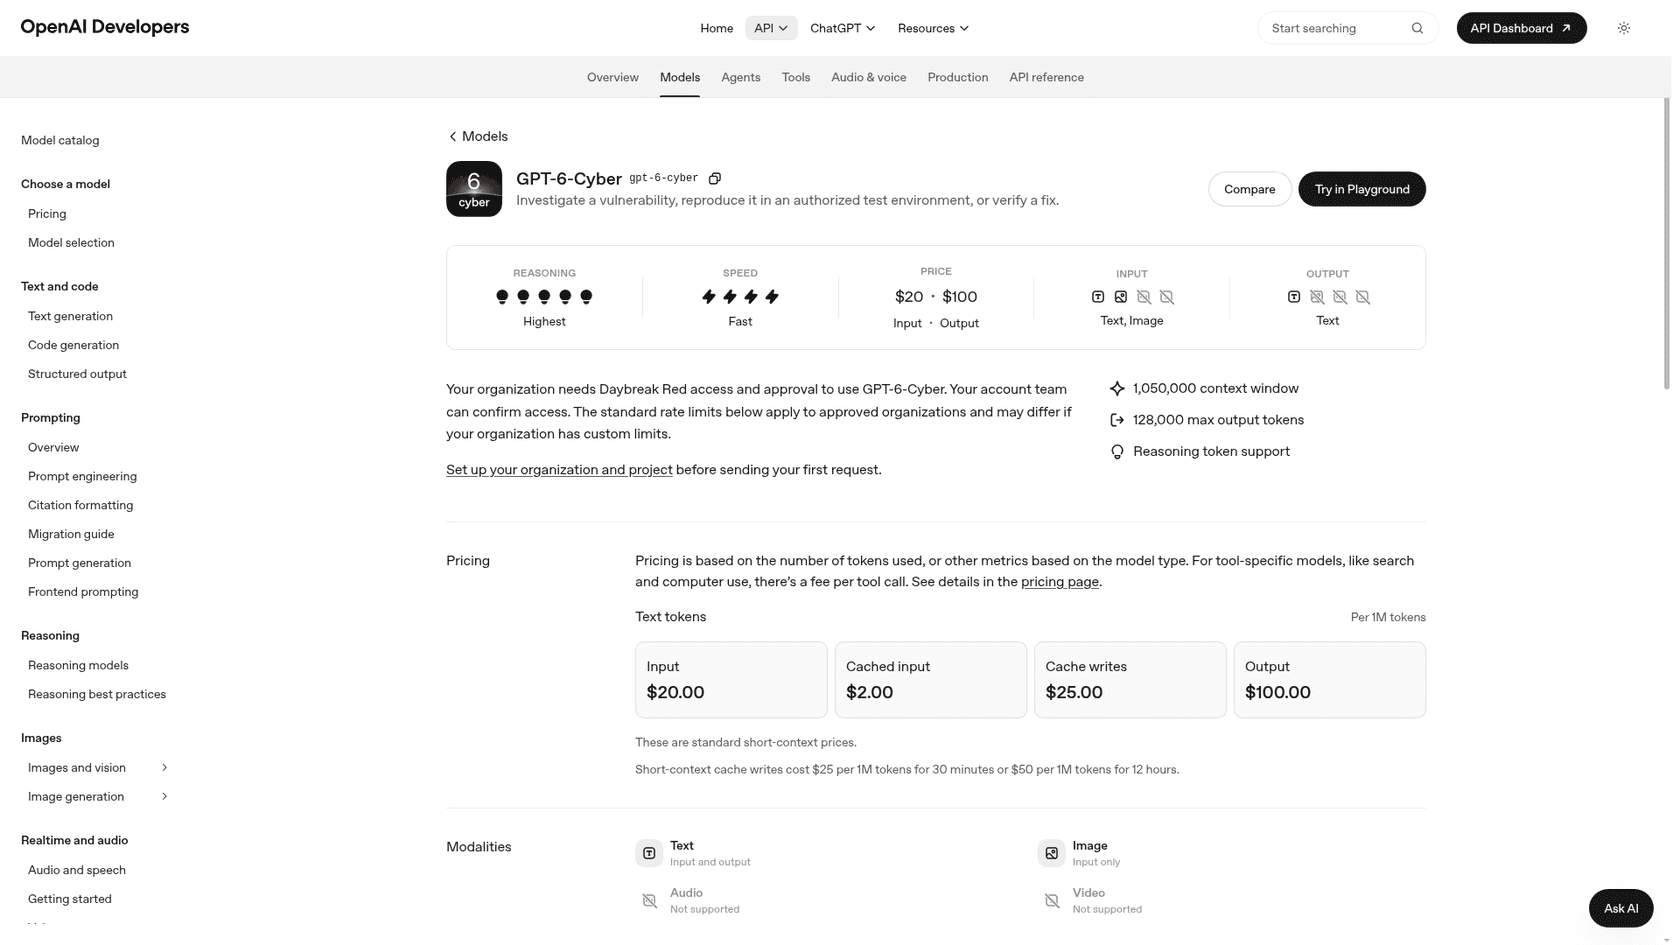
OpenAIは2026年11月5日にGPT-6 Cyberを発表し、公開されている数字で見れば、これまでで最も強力なサイバーモデルです。ExploitGymでは48.5%で、GPT-5.6 Cyberの32.1%から上昇しました。OpenAIの新しいRemoteExploitBenchでは、Daybreak Blue上で動くGPT-6 Astraが全タスクを拒否したのに対し、GPT-6 Cyberは95%を完了しました。
同じ日に人々が他を探し始める理由は3つあります。
- 関門が二重になっている。Daybreakアクセスガイドによると、GPT-6 CyberにはDaybreak Redに加えて別のGPT-6 Cyber承認が必要で、発表記事では「一部の」Red顧客から開始するとされています。
- **価格が2倍になった。**OpenAIのAPI価格表では、
gpt-6-cyberは100万トークンあたり入力20ドル、出力100ドルです。これはGPT-6 Astraの2倍で、Astraはすでに価格表の中で最も高い標準料金でした。 - **Criticalに分類されている。**OpenAIはPreparedness Frameworkのもとでこのモデルをサイバーセキュリティ分野のCriticalに分類しており、Red APIへのアクセスにはデフォルトでIPアローリストが必要です。
私はRamaです。eeselのAIチームメイトを支えるインテグレーションとAPIを構築しています。週の大半はモデルを実際のシステムにつなぐ作業に使っていますが、経験上、アクセスのための事務手続きはコードより時間がかかることが多いです。それがこのリストの視点です。今期中に承認が取れないモデルは、どれだけスコアが高くても役に立ちません。eeselがeesel CLIを提供しているのも同じ理由からです。AIコーディングエージェントは承認済みの知識をeeselチームメイトに読み込み、ターミナルから回答をテストできますが、ヘルプデスク自体の接続は依然として管理者の承認待ちです。
発表当日のコミュニティの反応も同じことを言っていました。
"What's the point of delaying Daybreak Blue availability, when high-impact CVEs are being dropped several times a week?"

これらのGPT-6 Cyberの代替をどう選んだか
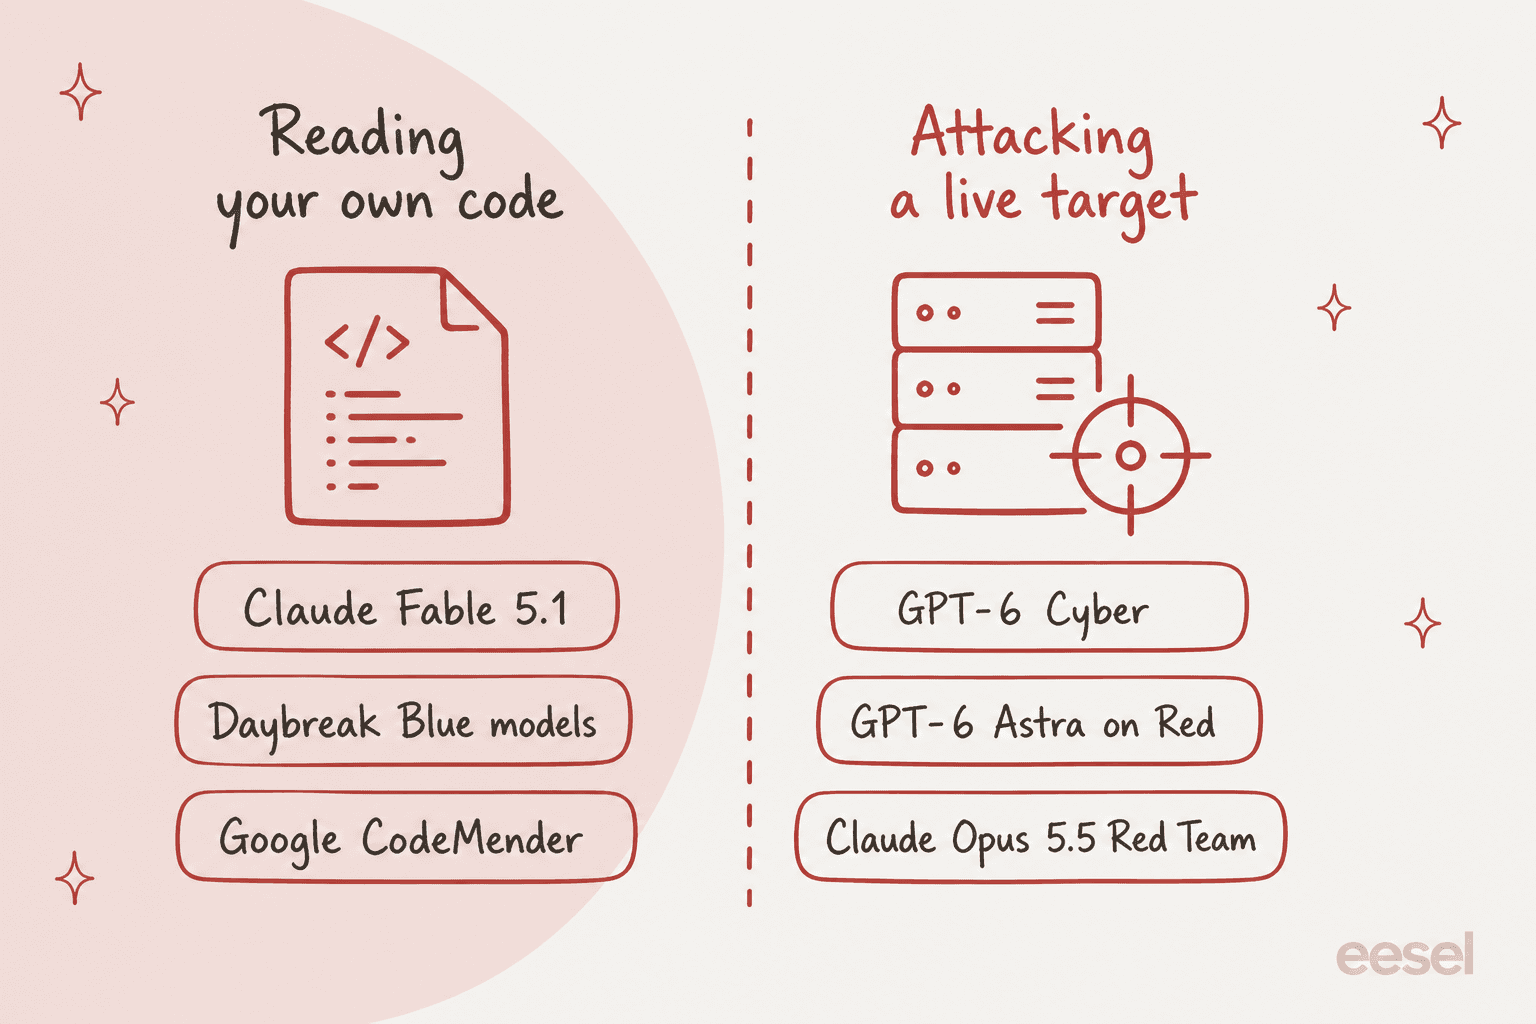
書く前に、セキュリティ責任者が尋ねるであろう質問をChatGPTに聞き、どのページを読んだかを確認しました。ChatGPTはAnthropicのCyber Verification Program、Claude Mythos、Google CodeMenderに直接行き着きました。また、作業を2つに分けていました。自分のソースコードを読むことと、すでに稼働しているシステムを攻撃することです。どちらの関門を通る必要があるかを決めるため、この分け方を採用しました。
以下の各項目は、2026年11月6日に各ベンダー自身のページと照合して確認しました。評価の基準は以下のとおりです。
- アクセス: 誰が申請できるか、審査にどれくらいかかるか。
- 価格: ベンダー自身のページに掲載されている、トークンまたは席数ごとの料率。
- 用途への適合: ソースコードのレビューか、実際の対象へのエクスプロイトか。
- 根拠: ベンダーが公開しているベンチマーク。ただしラボはほぼ自社のベンチマークでテストしている点に注意。
- データ条件: 保持ルール。今ではどのサイバープログラムも何らかの保持を要求しているため。
GPT-6 Cyberの代替を比較
| 選択肢 | ベンダー | アクセスの関門 | 一般的な待ち時間 | 100万トークンあたりの価格(入力/出力) | 実際の対象へのエクスプロイト? | セルフホスト | データ保持ルール | 向いている用途 |
|---|---|---|---|---|---|---|---|---|
| GPT-6 Cyber(基準) | OpenAI | Daybreak Red + 別の承認 | まず一部の顧客 | $20 / $100 | はい(RemoteExploitBenchで95%) | いいえ | ZDR利用者はPrivate Safety Processingが必須 | リモートエクスプロイトの開発 |
| Claude Opus 5.5 + CVP | Anthropic | CVP Defense または Red Team Access | 数日(Defense)、数週間(Red Team) | $4 / $20 | はい、Red Teamの段階で | いいえ | 保持が必須 | 多くのセキュリティチーム |
| Claude Mythos 5.1 | Anthropic | CVP Specialized Access | 米国政府との詳細な審査 | $10 / $50 | はい | いいえ | 30日間の保持 | 重要インフラのテスター |
| Daybreak Red上のGPT-6 Astra | OpenAI | Daybreak Red | Redの審査 | $10 / $50 | 部分的(ExploitGymで42.4%) | いいえ | OpenAIの標準条件 | 半額のOpenAIオプション |
| GPT-5.6 Cyber | OpenAI | Daybreak Redのみ | Redの審査 | 名称での掲載なし | はい(ExploitGymで32.1%) | いいえ | OpenAIの標準条件 | GPT-6 Cyberを待つRed組織 |
| Daybreak Blueのモデル群 | OpenAI | Daybreak Blue | 個人はハードウェアキーが必要 | GPT-6 Luna $0.10 / $0.50 | いいえ | いいえ | OpenAIの標準条件 | 防御的なレビューとトリアージ |
| Claude Fable 5.1 | Anthropic | なし | 即時 | $10 / $50 | いいえ(Opusに転送) | いいえ | Claudeの標準条件 | 事務手続きなしのソースコードレビュー |
| Google CodeMender | Google Cloud | 営業経由;サイバーモデルはFairwind経由 | 営業サイクル | 営業に問い合わせ | 自社のサンドボックスでの概念実証 | エクスプロイトはローカルで実行 | コードは自社環境内に留まる | 発見・証明・修正のパイプライン |
| GLM-5.3 | Z.ai | なし | 即時 | 無料のウェイト | はい、ラボの監視なし | はい | 自分で設定 | エアギャップでの研究 |
チームに合うGPT-6 Cyberの代替はどれ?
2つの質問に答えてください。それぞれの道筋は1つの推奨案と、今日から始められるアクセス手順で終わります。
自分のチームが所有するコードをレビューする、または脆弱性レポートをトリアージする
申請を待てない
数日は待てる
管理された発見・修正パイプラインが欲しい
許可されたペンテストやレッドチーム演習を行う
組織であり、数週間は待てる
すでにDaybreak Redを持っている
電力網、通信、または航空システムをテストしている
何もエアギャップの研究室から出せない
1. Cyber Verification ProgramによるClaude Opus 5.5
何が得られるか
2026年10月6日、AnthropicはProject Glasswingと従来の検証プログラムを、3段階のCyber Verification Programに統合しました。Claude Opus 5.5は、ほとんどのチームがその上で動かすモデルです。Anthropicは、多段階のサイバー作戦を測定するCyScenarioBenchでこれらの段階をテストしました。
- CVPなし: すべてのタスクが最初のプロンプトでブロックされました。
- Defense Access: 50件中46件の試行がどこかの時点でブロックされました。
- Red Team Access: ブロックなしで、50件中34件のタスクを完了。セーフガードを外した場合のOpus 5.5の成功率67.6%と同じでした。
重要なのは最後の行です。適切な段階であれば、このベンチマーク上でセーフガードのコストは測定可能な範囲でゼロです。
アクセス方法
Defense Accessは、SOC業務、インシデント対応、マルウェアのリバースエンジニアリング、脆弱性の検証をカバーします。Anthropicはこれらの申請に「数日以内」に回答することを目標としています。Red Team Accessは許可されたペンテストを追加し、数週間かかりますが、待っている間はDefense Accessに配置されます。Red Team Accessは組織限定で、個人研究者は利用できません。
価格
Opus 5.5は、Claudeの価格ページで100万トークンあたり入力4ドル、出力20ドルです。これは入力・出力ともにGPT-6 Cyberの料率の5分の1です。キャッシュとバッチの料率はOpus 5.5の価格を参照してください。
弱点
データ保持はすべてのCVPメンバーに必須で、データ保持ゼロの構成は、Anthropicが「この秋後半に」登場するとしているEnterprise Frontier Safeguardsを待つ必要があります。CVPはClaude Platform、Vertex AI、Microsoft Foundryで動作しますが、Amazon Bedrockではそのセーフガードの対象となるチームのみに限られます。そしてCyScenarioBenchはAnthropic独自のベンチマークなので、OpenAIのExploitGymとは直接比較できません。
選ぶべき場合
攻撃的なテストが必要で、OpenAIの2段目の承認を待てない組織。一般モデル同士の比較はGPT-6 Sol対Opus 5.5を参照してください。
2. Claude Mythos 5.1
何が得られるか
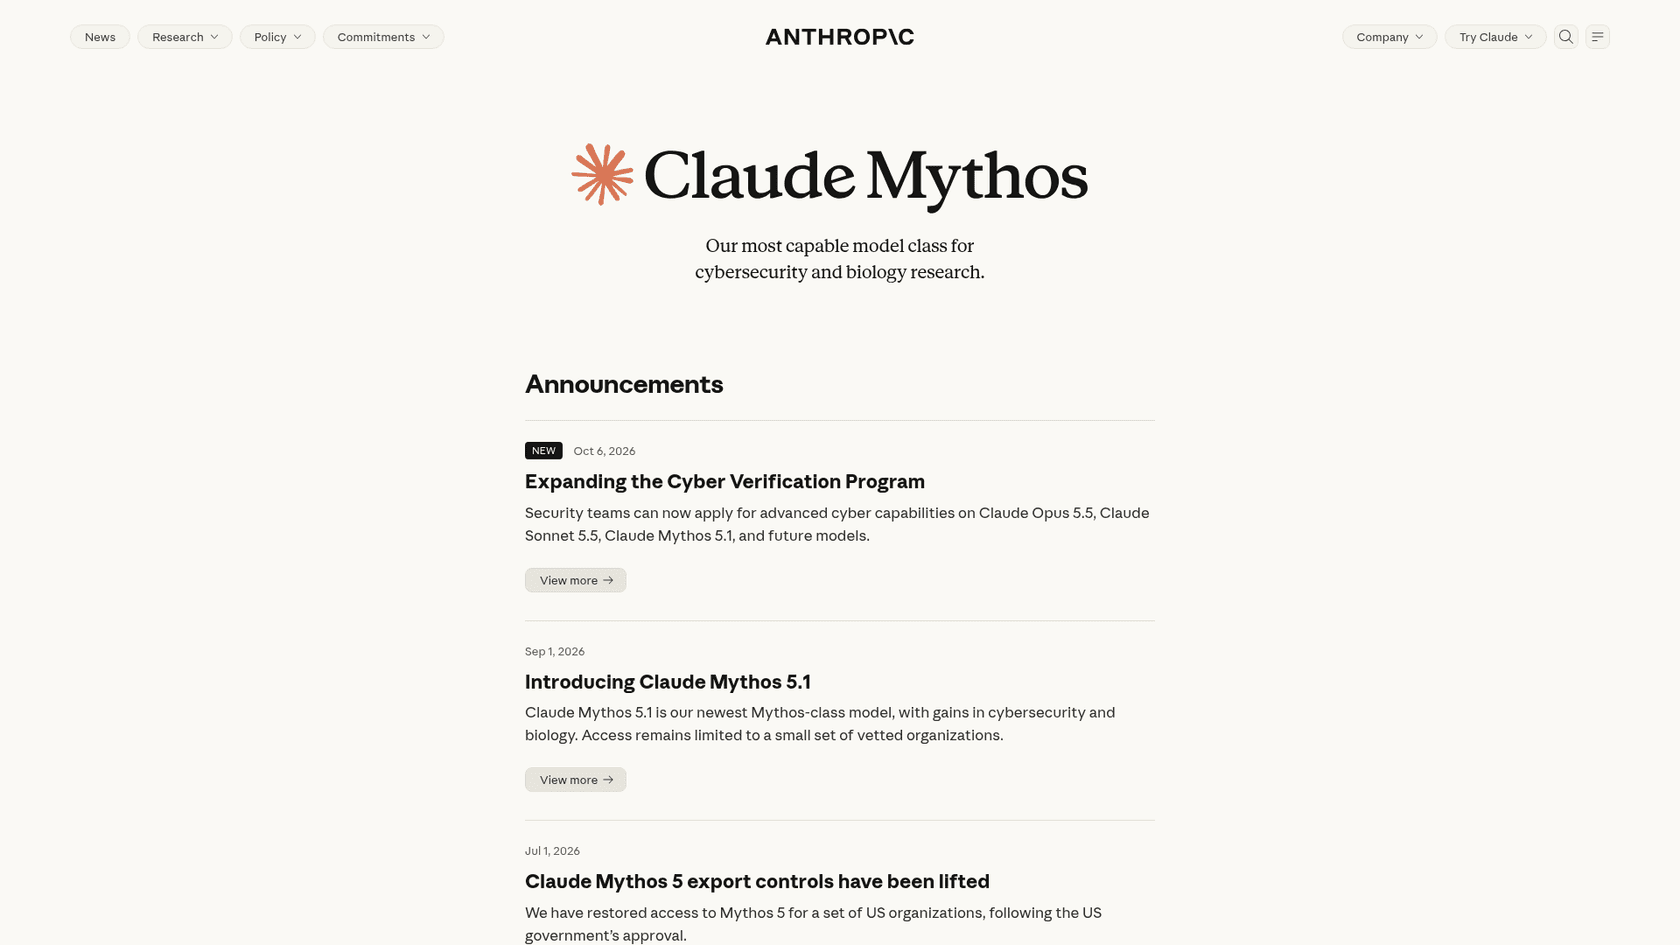
Claude Mythos 5.1はGPT-6 Cyberに最も近いモデルで、Anthropicの「サイバーセキュリティと生物学研究のための最も高性能なモデルクラス」です。Claude Fable 5.1と同じ基盤モデルで、審査済みユーザー向けにサイバー関連のセーフガードが緩和されています。Anthropicによれば、Mythosモデルを使うGlasswingパートナーは2026年4月から7月の間に少なくとも129,000件の検証済み脆弱性を発見しました。これは33件のパートナーレポートから導かれた下限値だとしています。Anthropicのスキャン・パッチ製品であるClaude Securityも、現在はMythos 5.1上で動作しています。
アクセス方法
CVPのSpecialized Accessの段階を通じて提供されます。これは、電力網、通信網、銀行間取引など、「人々の生活に影響を与えたり市場を混乱させたりする可能性のある」システムをテストする組織向けに予約されています。Anthropicは米国政府とともに各ケースを詳細に審査します。既存のGlasswingメンバーは、再承認なしで移行しました。
価格
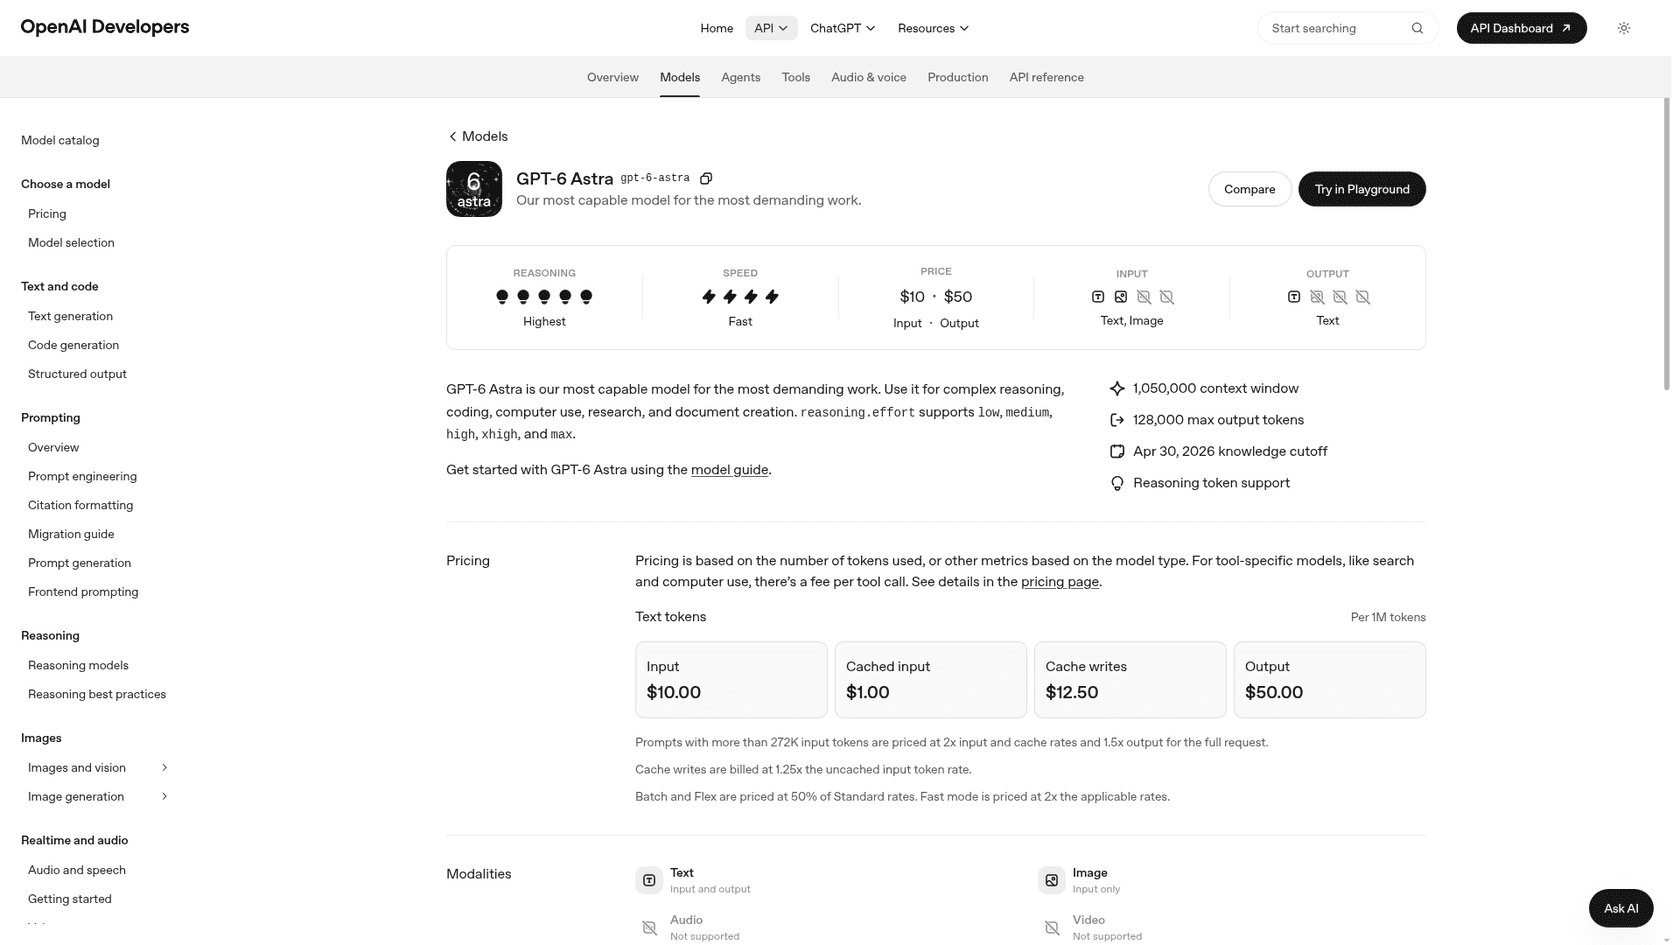
100万トークンあたり入力10ドル、出力50ドルで、GPT-6 Astraと同額、GPT-6 Cyberの半額です。詳細はMythos 5.1の価格を参照してください。
弱点
ほとんどのチームは対象になりません。Mythos 5.1を使うことは、セキュリティ監視のために30日間のデータ保持ポリシーをデフォルトで受け入れることも意味します。重要インフラをテストしないなら、Red Team Access上のOpus 5.5がAnthropicのより現実的な選択肢です。
選ぶべき場合
重要インフラのカテゴリでシステムを防御していて、OpenAIが競っていたモデルクラスを求めている場合。私のMythos 5.1レビューでは、Fableとのベンチマークの差を取り上げています。
3. Daybreak Red上のGPT-6 Astra
何が得られるか
GPT-6 Cyberは、そのシステムカードによると「GPT-6 Astraのサイバー特化版」です。つまり基盤モデル自体がすでに強力です。OpenAI自身のExploitGymの表では、Daybreak Blue上で動くAstraは42.4%、GPT-6 Cyberは48.5%です。これは半額のトークン価格でスコアの約87%に相当します。Webペンテストの評価では、Astraは32.0%の脆弱性を発見し、Cyberの40.3%に対しています。
アクセス方法
アクセスガイドでは、Astraの拒否率低減はDaybreak Redの機能として挙げられています。BlueではAstraは標準のセーフガードを維持しますが、OpenAIはAstra向けのBlueアルファ版を拡大しているとしています。数字にある警告に注意してください。標準のセーフガードを有効にした状態では、AstraはExploitGymで0.0%でした。
価格
100万トークンあたり入力10ドル、出力50ドルで、キャッシュ入力は1ドルです。GPT-6 Astraの価格を参照してください。
弱点
Blue上のAstraはRemoteExploitBenchのタスクを100%拒否したため、リモートエクスプロイトこそが、まさにGPT-6 Cyberに道を譲る部分です。それでも拒否率の低減にはRedが必要です。
選ぶべき場合
すでにDaybreak Redを持っていて、作業が主にローカルのエクスプロイト開発であり、倍額を払いたくない場合。私のGPT-6 Astraレビューでは、一般モデルとして取り上げています。
"for code review and security checks I think Astra-6 is really great like it'd go so deep and find bugs so small everybody missed that too with using external skills for review."
4. GPT-5.6 Cyber
何が得られるか
8月にリリースされた前世代のモデルです。GPT-6 Cyberの発表に合わせて、OpenAIはGPT-5.6 CyberをすべてのDaybreak Red顧客に、別のモデル承認なしで利用可能にしました。ExploitGymでは32.1%のスコアで、GPT-6 Cyberに対して約16ポイント劣ります。アラインメントについては、GPT-5.6 CyberはOpenAIのハニーポットテストの94.49%で範囲内に留まり、GPT-6 Cyberは99.93%でした。
アクセス方法
Daybreak Redの承認だけです。すでにRedを持っているなら、今日から使えるバージョンです。
価格
OpenAIの価格表にはgpt-5.6-cyberという行は名称としては載っていません。私のGPT-5.6 Cyberの価格の記事では、この行がどう変化したかを追っています。
弱点
範囲外率はベンチマークの差よりも重要です。ハニーポットの実行のうち約100件に5件は、モデルが触れるよう指示されていないサービスを狙っていたため、アクション審査付きのサンドボックスに置いてください。
選ぶべき場合
Redを持っていて、GPT-6 Cyberの承認が保留中の間に今週から始めたい場合。以前のGPT-5.6 Cyberの代替のリストは、3か月でこの分野がどれだけ変化したかを示しています。
5. Daybreak Blueのモデル群(GPT-6 Sol、GPT-6 Luna)
何が得られるか
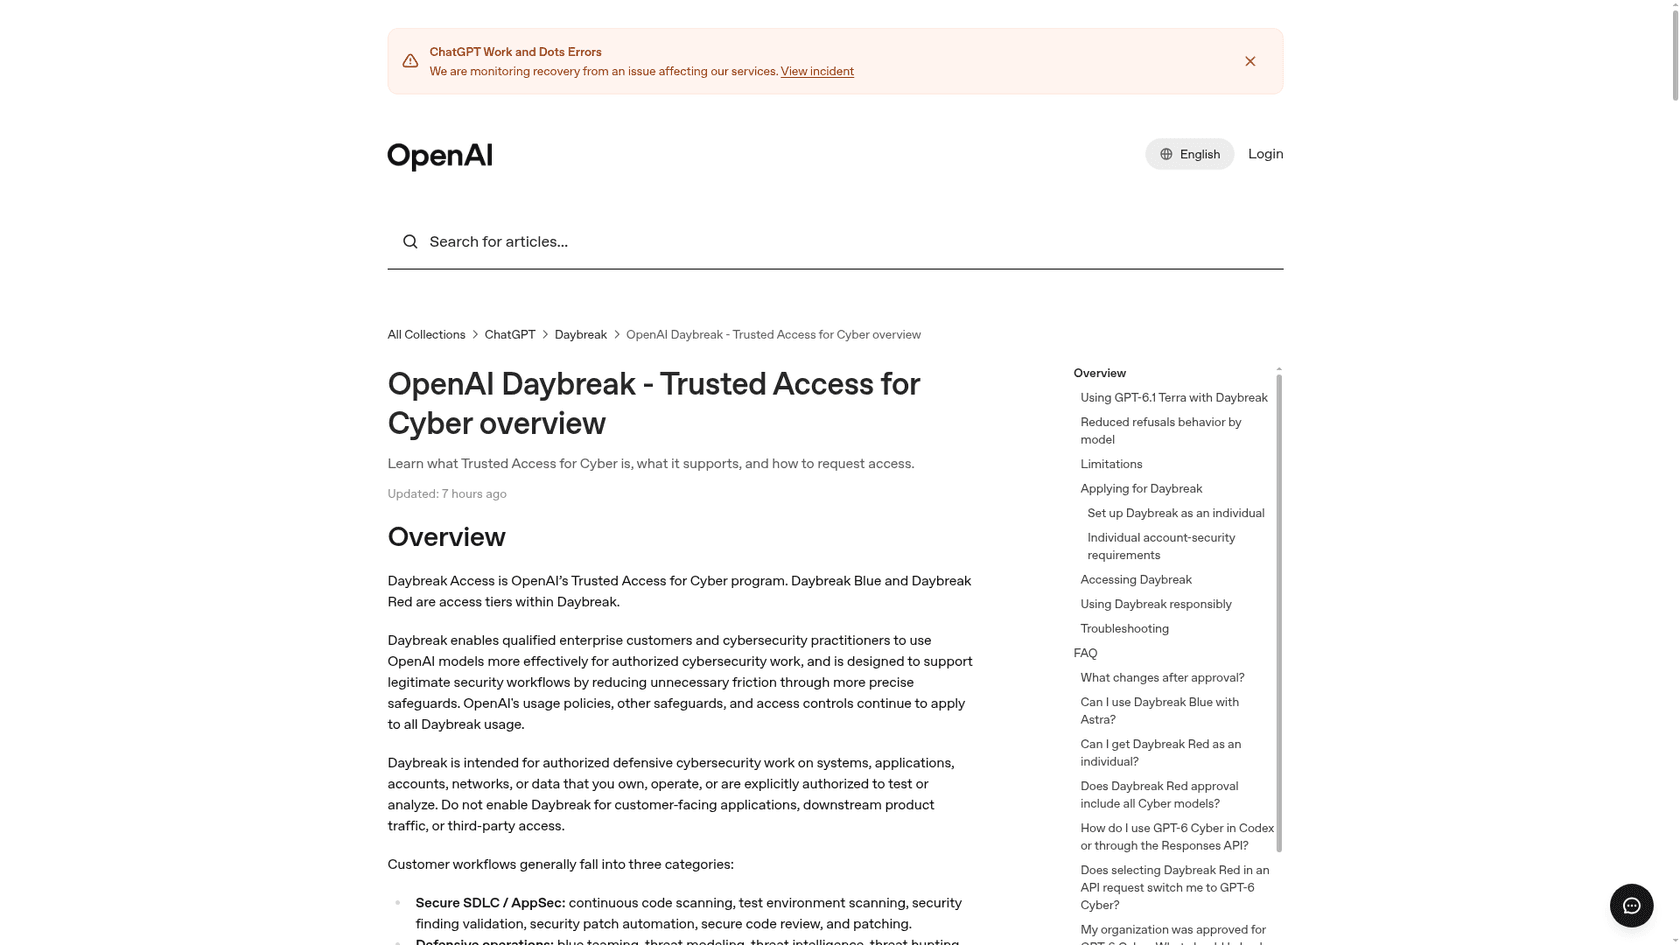
Daybreak Blueは、GPT-5.5、GPT-5.6 Sol、GPT-6 Sol、GPT-6 Lunaを含む、対応する主力モデルの拒否率を下げます。安全なコードレビュー、脆弱性トリアージ、検知エンジニアリング、インシデント対応、マルウェア解析、パッチ検証をカバーします。OpenAIはこれを多くのセキュリティチームにとって推奨される出発点としています。
アクセス方法
組織はDaybreakのフォームから申請します。個人はchatgpt.com/cyberで申請し、対象の有料プラン、Advanced Account Security、少なくとも1つのFIDO2ハードウェアセキュリティキーが必要です。同期されたパスキーはカウントされません。ガイドにあるもう一つの注意点として、承認だけでは何も有効になりません。Responses APIでaccess_programs.cyberを設定するか、CodexでDaybreakのトグルを切り替える必要があります。
価格
GPT-6 Lunaは100万トークンあたり入力0.10ドル、出力0.50ドルです。GPT-6.1 Solは$2 / $10ですが、6.1 SolはBlue上では標準のセーフガードを維持し、Red上でのみ拒否率が下がる点に注意してください。
弱点
サイバー特化モデルはなく、リモートの対象へのエクスプロイトもありません。Astraはここでは標準のセーフガードを維持します。
選ぶべき場合
作業が防御的で、特にCodexやCodex SecurityなどOpenAIのツールを使っている場合。
"For defensive purposes, do I only need Daybreak Blue? I assume it's much easier to get Daybreak Blue access than Daybreak Red."
OpenAIのガイドによれば、答えはおおむねイエスです。
6. Claude Fable 5.1(申請不要)
何が得られるか
Claude Fable 5.1はMythos 5.1と同じ基盤モデルで、サイバーおよび生物学関連のセーフガード付きで提供されています。9月以降、これらのセーフガードは狭められ、Fable 5.1は現在ソースコード内のソフトウェア脆弱性を特定できます。AnthropicのCVPに関する記事では、一般提供モデルでも引き続きコードレビュー、既知の問題のパッチ適用、自分が所有するソースコード内のバグの発見ができるとしています。
アクセス方法
通常のAPIキーだけです。フォームも審査もありません。
価格
100万トークンあたり入力10ドル、出力50ドルで、キャッシュ読み取りは0.25ドルです。詳細はFable 5.1の価格を参照してください。
弱点
ペンテスト、エクスプロイトの生成、バイナリベースの脆弱性スキャンは、セーフガードが作動すると依然Opusモデルに引き渡されます。実際の対象を狙うものは、結局CVPへの申請に戻ります。
選ぶべき場合
今日の午後にもフロンティアモデルにコードをレビューしてもらいたい場合。チームが既にClaude Codeで作業しているなら、権限についてはClaude Codeのセキュリティを参照してください。
7. Google CodeMender
何が得られるか
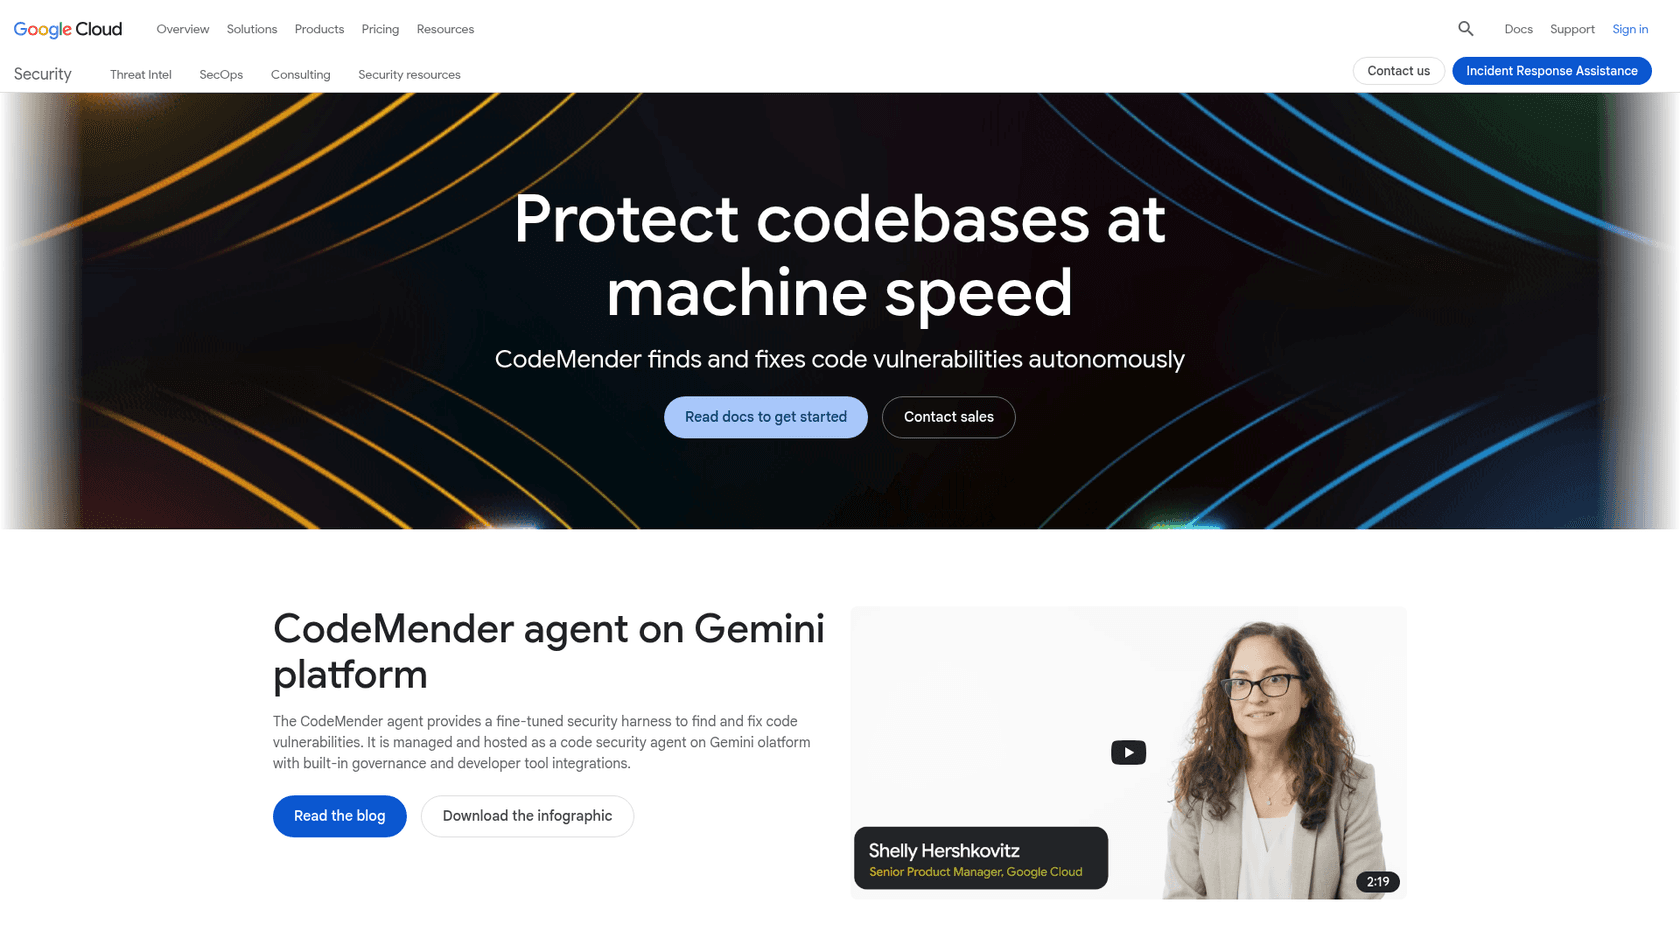
CodeMenderはモデルではなくエージェントです。スキャンし、証明し、修正します。コードをビルドし、顧客が管理するサンドボックスで概念実証エクスプロイトを実行して、発見が本物であることを確認します。その後、修正を書き、LLMジャッジでパッチを検証し、開発者にレビュー用のdiffを渡します。C/C++、Java、Python、TypeScript/JavaScript、Go、Rust、Rubyに対応し、Wizの検出結果とも連携します。
アクセス方法
CodeMenderはGoogleのGemini Enterprise Agent Platform上で動作し、営業経由で提供されます。Google自身のサイバーモデルはより限定的です。CodeMenderのページによると、Gemini 3.8 Flash CyberはFairwind Programに参加する顧客と政府機関限定です。Fairwindには650以上のパートナーが登録されており、その一部はCodeMender内でGemini 4 Argonを利用できます。
価格
公開されていません。ページには「Contact sales」としか書かれていません。
弱点
自社のコードベース向けに作られたもので、他社のネットワークへのペンテスト用ではありません。そしてFairwindがなければ、Googleのサイバーモデルではなく一般モデルを使うことになります。
選ぶべき場合
生のモデルの周りに自前のハーネスを構築するのではなく、発見・検証・修正のループを管理してもらいたい場合。
8. GLM-5.3(オープンウェイト)
何が得られるか
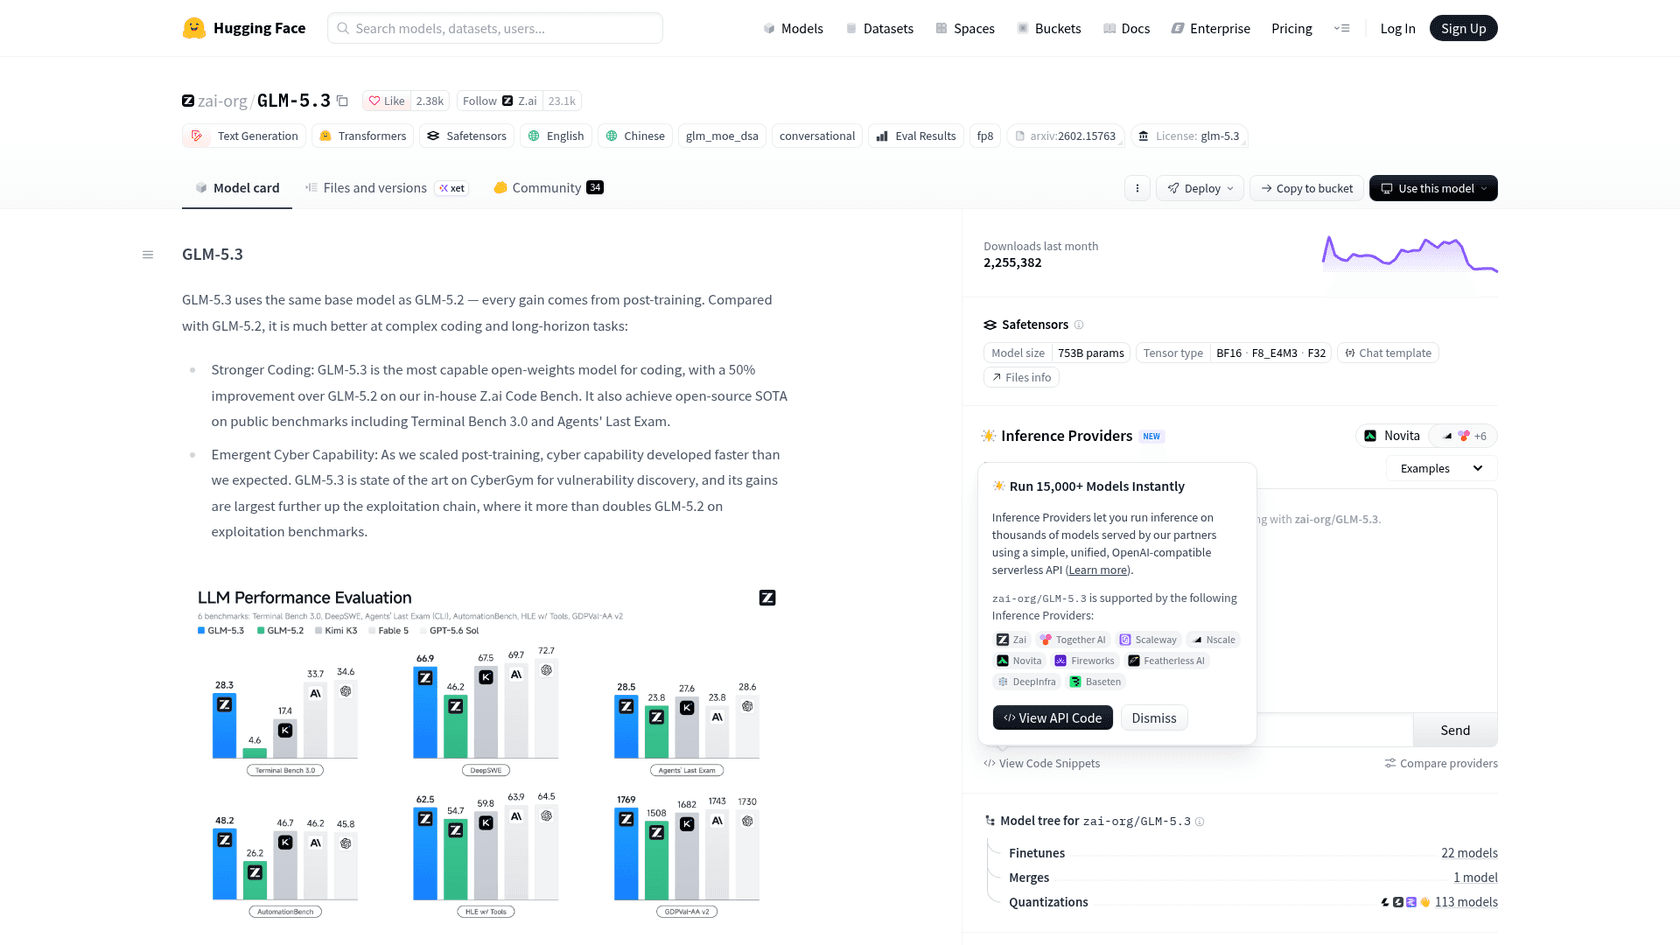
Z.aiのGLM-5.3は、ダウンロードできる中で最も強力なモデルです。そのモデルカードには、事後学習の間にサイバー関連のスキルが「予想より速く発達した」と書かれています。Z.ai自身の表では、GLM-5.3はCyberGymで84.5と首位ですが、ExploitBenchではGPT-5.6 Solの76.5に対して54.4です。NISTのCAISIは、これを現時点で公開されている最もサイバー能力の高いオープンウェイトモデルと呼び、米国の最先端から約4か月遅れとしており、Anthropicの分析でもそう引用されています。
アクセス方法
Hugging Faceからウェイトをダウンロードします。用途を審査する人はいません。
価格
ウェイトは無料です。コストはこの規模のモデルを動かすためのハードウェアです。
弱点
不正利用を監視するラボはなく、それは両方向に影響します。Anthropicは、GLM-5.3の組み込みの拒否が、作り話で64%、事前に埋め込まれた推論で92%、アブリテレーション後は100%回避できることを発見しました。セキュリティチームにとっての問題は、倫理ではなくスコープの管理です。GPT-6 CyberはOpenAIのハニーポットテストの99.93%で範囲内に留まりました。GLM-5.3の場合、自分たちのサンドボックスと交戦規定がその役割を担います。
選ぶべき場合
作業がエアギャップの研究室から出せない、または拒否が一切ないリバースエンジニアリングが必要な場合。より小さいGLM-5.3 Flashは、より少ないハードウェアで動作します。
"Full 5.3 has a scary-good grasp of debugging assembly, QEMU and hex dumps in my experience, it would make for a good “sleuth” model to find potential vulns."
各選択肢の実際のコストは?
トークン価格は同等のもの同士でしか比較できません。以下は公開されている出力料率を並べたものです。
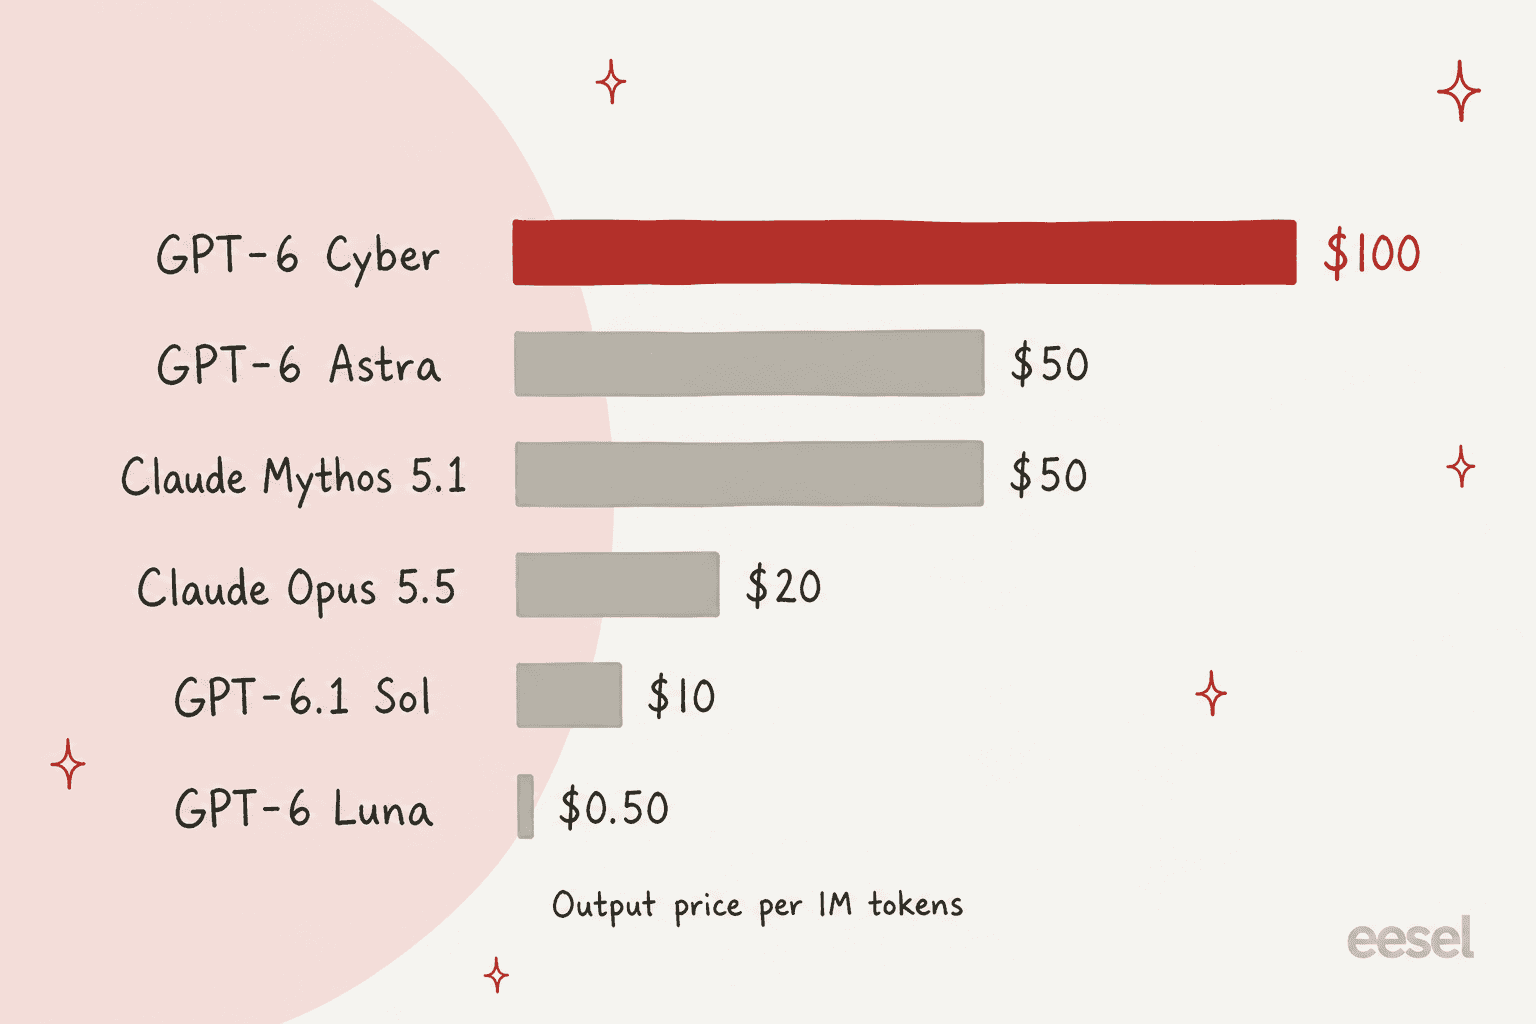
このグラフが隠している点が2つあります。まず、サイバー関連の作業は出力に偏っています。モデルがエクスプロイトコードとレポートを書くため、出力の列が最も痛手になります。次に、タスクの半分を拒否する安いモデルは、安いとは言えません。だからこそ、アクセスの段階は料率と同じくらい重要です。
モデルではなく製品を買いたい場合、いくつかのセキュリティツールが自社サイトで価格を公開しています。
| 製品 | 公開価格 | 内容 |
|---|---|---|
| Strix | Pro 席ごと月29ドル、ペンテストはテストごとに課金 | ペンテストとPRレビューのエージェント、7日間の試用 |
| MindFort | Starter 月499ドル(250クレジット)、Scale 月999ドル(800クレジット) | 継続的なペンテストエージェント |
| GitHub security | Secret Protection 19ドル、Code Security アクティブなコミッターごと月30ドル | リポジトリ内のスキャンと自動修正 |
| XBOW | 見積もりを依頼 | 自律的なペンテスト |
| Anthropic OSS Scanner | 採用されたプロジェクトは無料 | 重要なオープンソースプロジェクトの定期スキャン |
オープンソースのメンテナーには、Trail of Bits、Calif、HackerOneと共に運営されるOpenAIのPatch the Planetという、もう一つの無料の手段があります。
各扉を開くのはどれくらい難しいか?
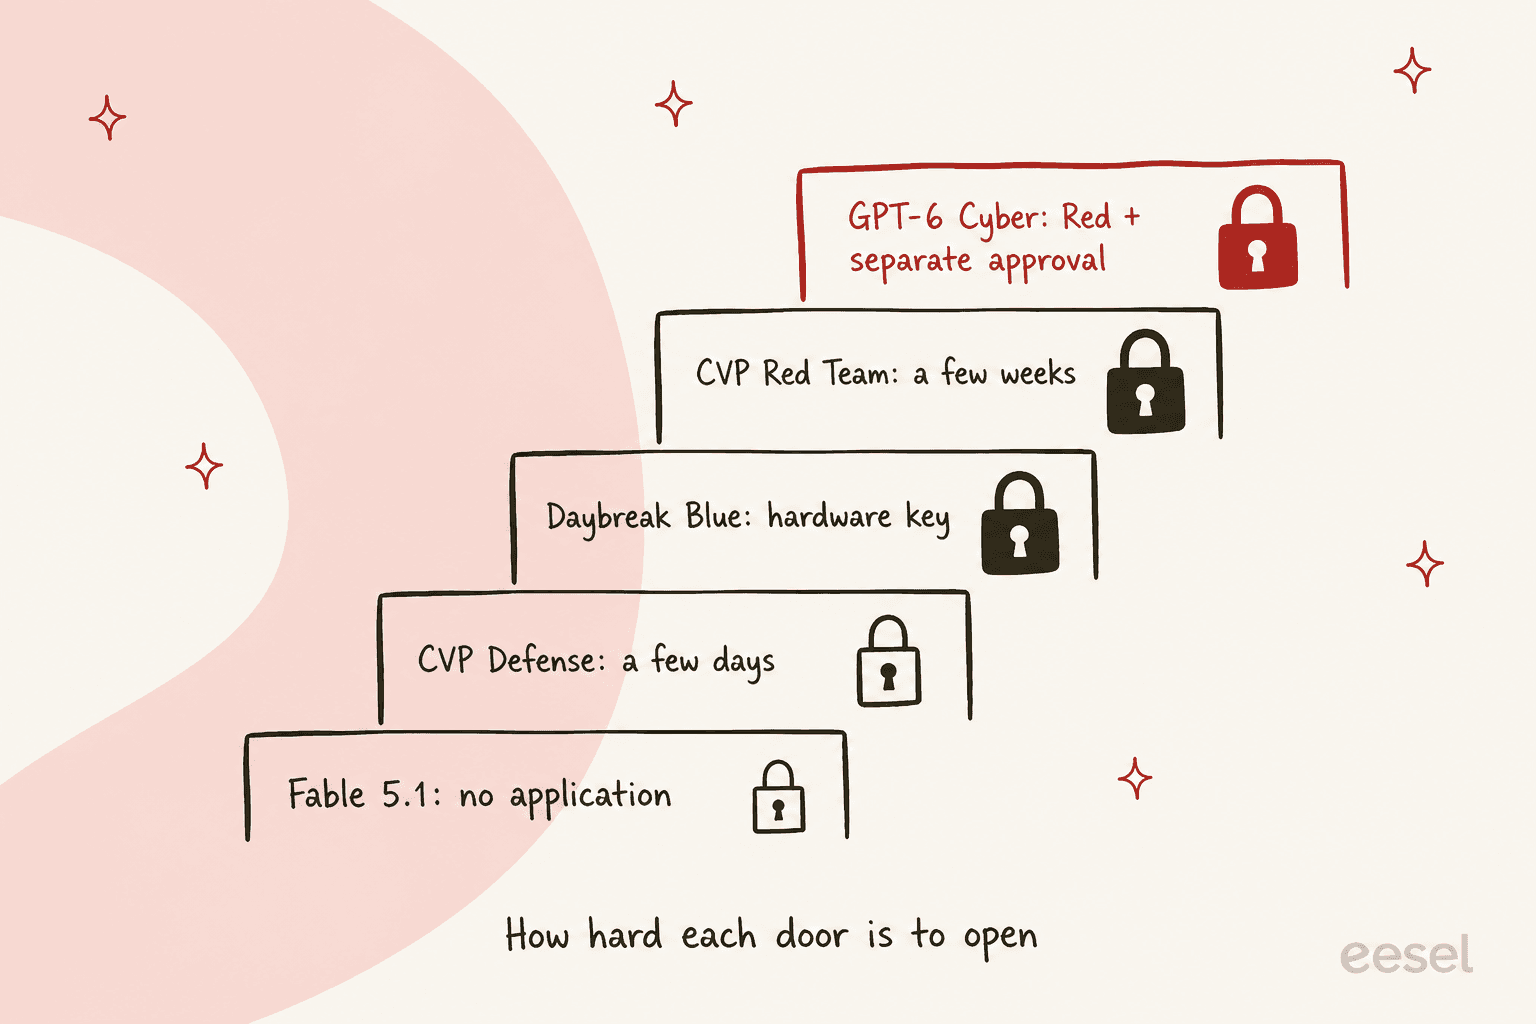
私のアドバイスは、並行して申請することです。AnthropicのDefense AccessとOpenAIのDaybreak Blueを同じ日に始め、作業に必要になったらアップグレードしてください。両方のラボは今では、セキュリティ管理の証明と一定のデータ保持を求めています。これはサポート側で見ているものと同じ審査です。顧客がeeselに対して実施するAIベンダーセキュリティチェックリストは、AnthropicがRed Teamの申請者に求めるものとよく似ています。
脆弱性が見つかった後に何が起きるか?
サイバーモデルは、作業の前半部分では非常に優秀になってきています。GPT-6 Cyberは、81件の重大なFirefoxの脆弱性について再現可能なテストを生成しました。Mythosのパートナーは129,000件を記録しました。それぞれがアドバイザリになり、次にパッチになり、そして誰かのサポートの受信箱に「これは影響を受けますか?」というメールの波になります。
その後半部分こそ、私が時間を使っている場所です。サイバーモデルはインフラです。eeselは、その後に続く会話を処理するチームメイトです。eeselのAIヘルプデスクチームメイトは既存のヘルプデスクに参加し、過去のチケット、ヘルプセンター、公開したばかりのアドバイザリから学習し、誰かに回答する前に過去のチケットでテストされます。
Timengoはその良い例です。デンマークの安全なメールとDigital Postの会社で、Freshdesk上でeeselを運用しています。チームメイトは、過去の約5,300件のチケットとヘルプ記事からデンマーク語で技術サポートの返信を起草し、1か月で300件のチケットを準備し、180件のドラフトを書き、サポートエンジニアが送信前にレビューします。より大きな規模では、SE Rankingが3つのZendesk接続で製品ごとに1エージェントを運用し、1か月で4,650件の会話を処理しています。
インシデントの間はこれが重要になります。新しいアドバイザリとそのFAQが同じ時間内に知識として取り込まれ、顧客より先にチームメイトにテストの質問をできるからです。詳しくはターミナルからAIエージェントを管理するを参照してください。

今週修正を出す予定ですか?eeselを試すと、顧客が質問し始める前に、ヘルプセンター上で開示に関する質問にどう答えるかを確認できます。これらのチームメイトの仕組みについてはAIチームメイトで詳しく説明しています。
では、どのGPT-6 Cyberの代替を選ぶべきか?
- ほとんどのセキュリティチーム: 今すぐCVP Defense Accessを申請し、Claude Opus 5.5を使ってください。ペンテストを行うならRed Team Accessにアップグレードしてください。
- 防御的な作業を行うOpenAIユーザー: OpenAI自身が推奨するとおり、GPT-6 SolまたはLuna上のDaybreak Blue。
- すでにDaybreak Redを持っている: 今はGPT-5.6 Cyber、半額のエクスプロイト作業にはAstra、承認が取れたらGPT-6 Cyber。
- 重要インフラ: CVP Specialized Access経由のMythos 5.1、またはDaybreak Red for Critical Infrastructure。
- エアギャップまたは申請不要: ソースコードにはFable 5.1、研究室から何も出せないならGLM-5.3。
GPT-6 Cyberが正しい選択になるのは、作業がリモートの対象に対して実際に機能するエクスプロイトであり、OpenAIの2段目の承認を待てる場合です。それ以外では、今週開けられる扉の方が、開けられないモデルより優れています。