GPT-5.6-Cyberの代替9選:2026年に使える選択肢

Kira

Katelin Teen
最終更新 August 10, 2026
GPT-5.6-Cyberが越えられない壁の向こうにあるためここに来たのなら、まず知っておくべきことがあります。これはOpenAIだけの特異な話ではありません。業界全体のパターンであり、OpenAIは最初ですらありませんでした。AnthropicのProject Glasswingは、Daybreakより2か月以上前の2026年4月7日に始まりました。GoogleのGemini 3.5 Flash Cyberはさらに厳しく、限定パイロットで「governments and trusted partners」にのみ提供されています。
ほとんどの防御担当者にとって最も有効な一手は、AnthropicのCyber Verification Programです。無料で、2営業日以内に決定され、Claude Opus 5で正当なセキュリティ業務を妨げる高リスクのデュアルユース遮断を調整してくれます。公開価格は100万トークンあたり$5と$25で、今すぐ使えます。期間不明の申請を経て、価格非公開のモデルを待つのとは対照的です。
その下の層に目を向けると、議論が示唆するより実情は良好です。公開価格付きで実際に購入できるAIセキュリティツールがあります。Strixは1席$29、MindFortは月$199から、GitHub Code Securityはコミッター1人あたり$30です。ベンダーを一切使いたくないなら、DeepSeek V4 FlashはMITライセンスで、Cybergymスコア76.7を公表しています。
サイバーの観点ではなく一般的なモデル比較をお探しなら、GPT-5.6 alternativesのほうが適したページです。
どのラボもサイバーモデルを制限した
私はAIエージェントを仕事として作っています。そのため、GPT-5.6-Cyberのローンチで最初に気づいたのは、性能の主張ではなく、その形があまりにも見慣れたものだったことです。
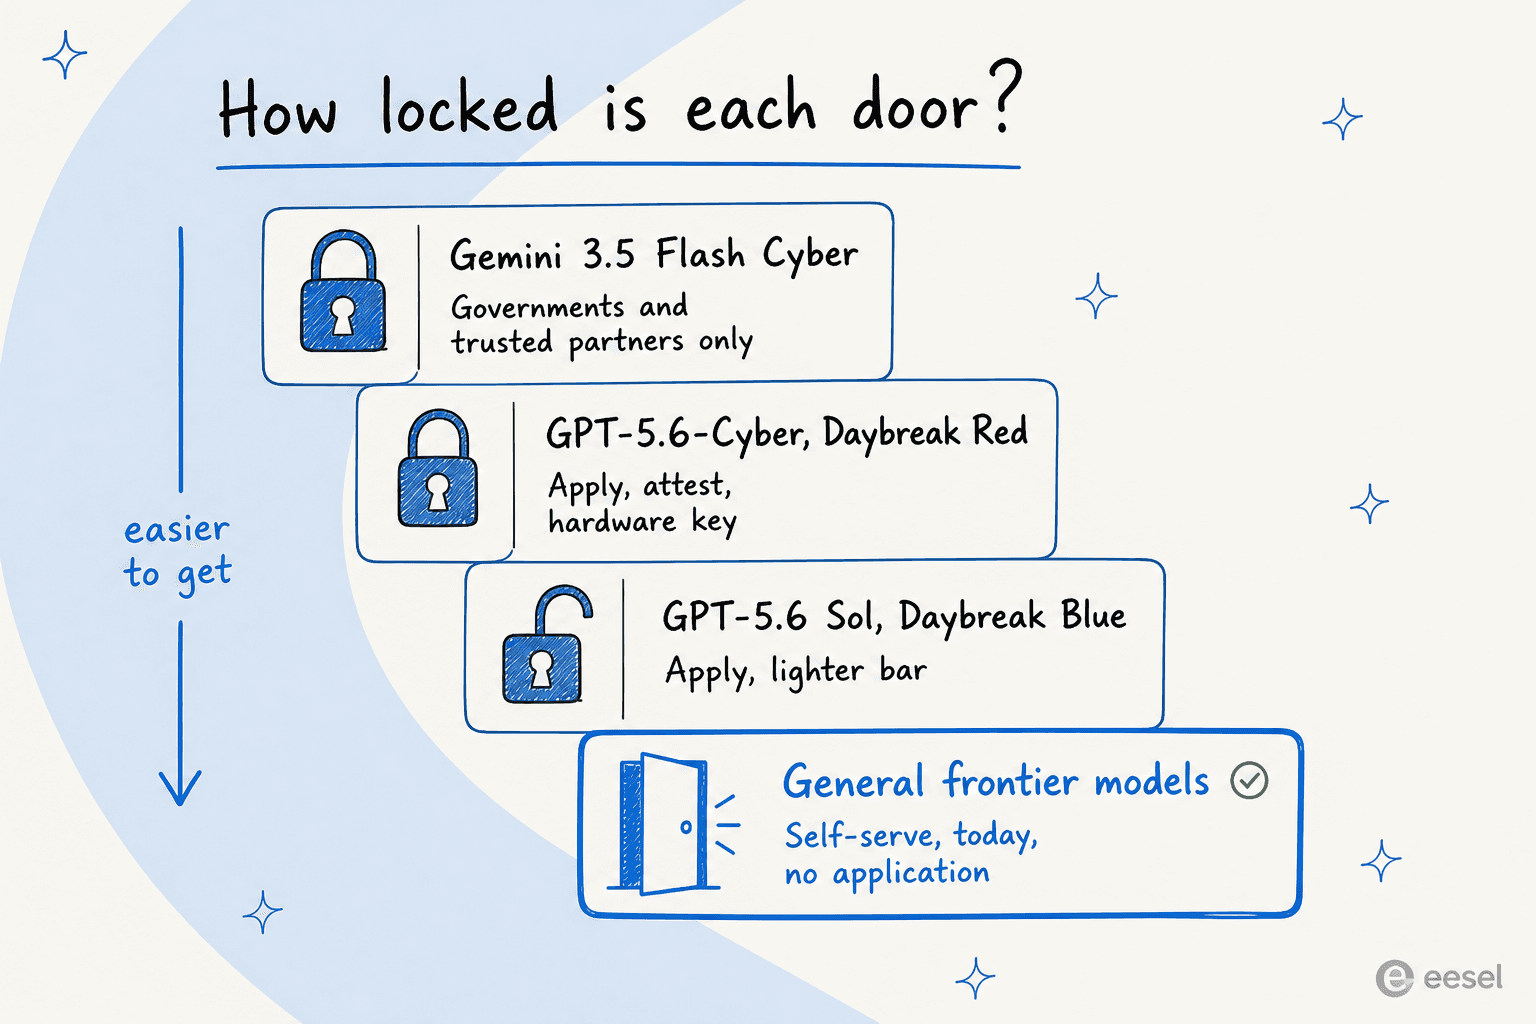
今やすべてのフロンティアラボが同じものを作っています。専用のサイバーモデルを閉じ、その下に他のみんな向けの軽い層を置くという構造です。違いは細部にあり、実際の助言はその細部にあります。
リストの前に、はっきり述べておく価値のある点が2つあります。
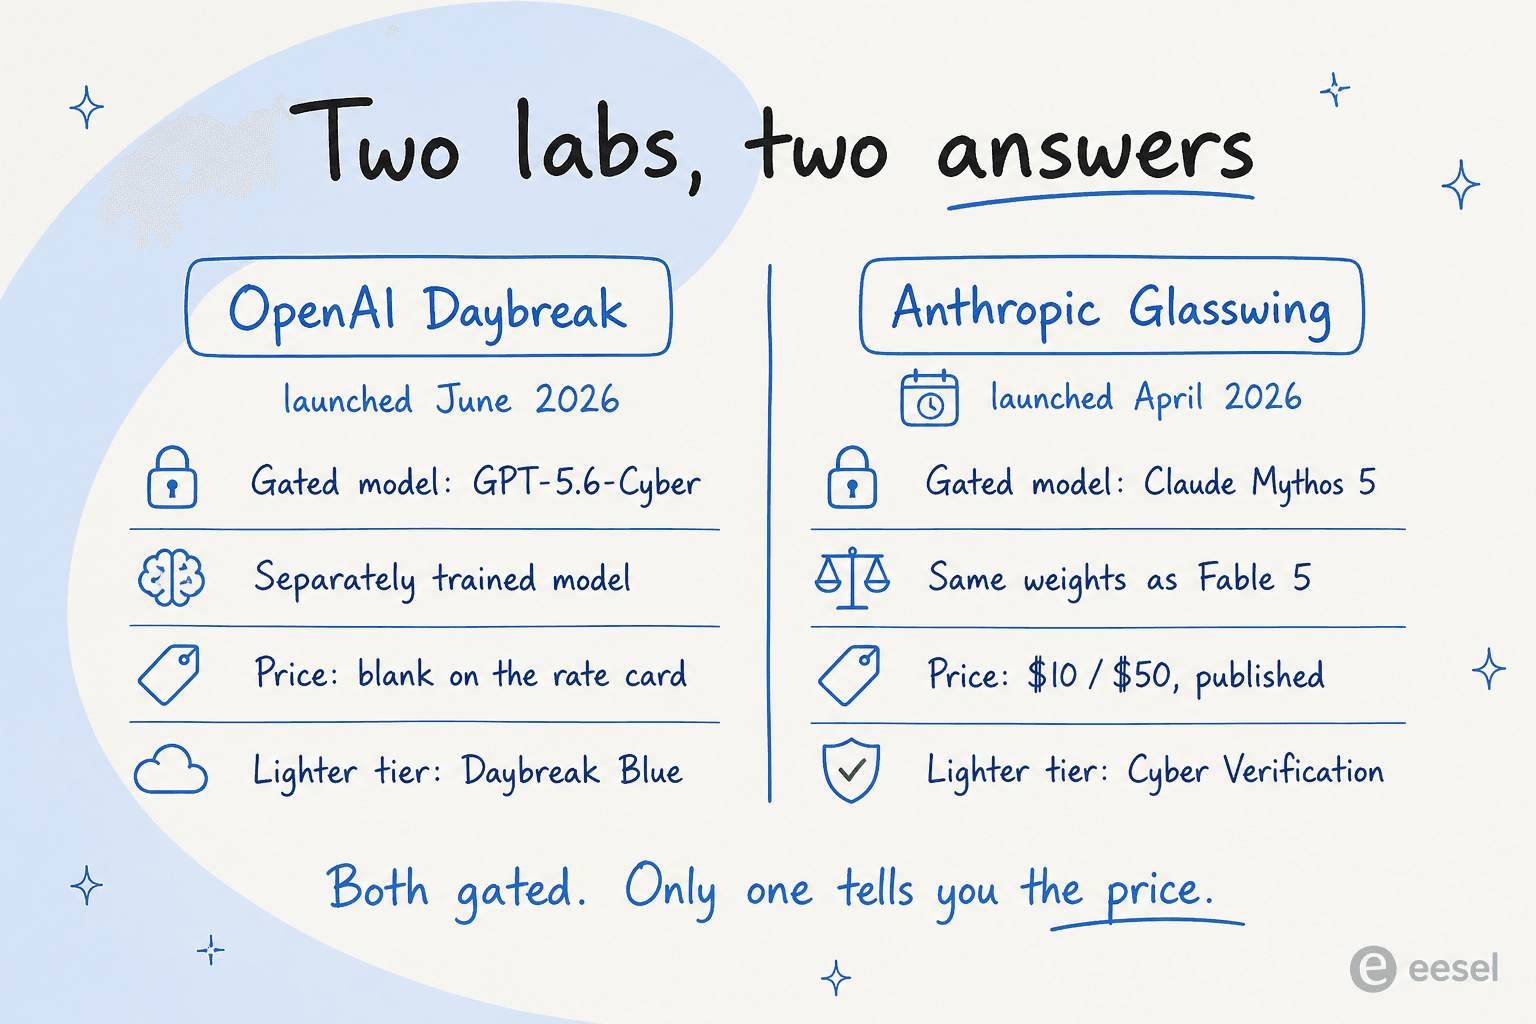
Anthropicのアーキテクチャのほうがすっきりしています。Anthropicの製品ページによると、Claude Mythos 5とClaude Fable 5は同じ基盤の重みを共有しており、違うのはセーフガードだけです。OpenAIはGPT-5.6-Cyberを別個に学習させたため、ゼロデイ発見ではSolを上回り、レポート作成では下回ります。一方の方式は、トレードオフの異なる別のモデルを与えてくれます。もう一方は、ブレーキを外した同じモデルを与えてくれます。
**価格を明かしているのは一方だけです。**AnthropicはMythos 5を100万トークンあたり$10と$50で公開しています。OpenAIの料金表にはCyberの行があり、そこには文字通りダッシュが入っています。これについてはCyber価格の詳細分析で掘り下げました。
この9つを選んだ方法
3つの基準を、正直に適用しました。
**手が届くこと。**今日支払える、今日ダウンロードできる、または所要日数が公開されているプロセスで申請できる、のいずれかです。価格も時期もない「Contact sales」は推奨としてリストに入れていません。ただし、読者がスキップできるよう、そうした方式のものには名前を挙げています。
**価格が確認できること。**以下の数字はすべて、ベンダー自身の料金ページ、モデルカード、またはマーケットプレイスの掲載情報から取ったもので、2026年8月11日に確認しています。
**性能の主張がベンダー自身のものであること。**これらを互いに対戦させて測ったわけではありません。サイバー系のベンチマークがある場合は引用して出典を示し、ない場合は、あるかのように匂わせず、ないと述べています。
比較表
| # | 選択肢 | 種類 | セルフサービス? | 開始価格 | 価格は公開? | セルフホスト? | ベンダーのサイバースコア | 最適な用途 |
|---|---|---|---|---|---|---|---|---|
| 1 | Daybreak Blue | 制限付きモデル層 | 申請 | Solは100万あたり$5 / $30 | はい、Solの料金 | いいえ | ExploitBench 73.5% | OpenAIを使い続ける |
| 2 | Anthropic CVP | 無料アクセスプログラム | 申請、2営業日 | Opus 5は100万あたり$5 / $25 | はい | いいえ | Fable 5よりCyber fallbacksが85%減 | ほとんどの防御担当者 |
| 3 | Claude Mythos 5 | 制限付きモデル | 招待制 | 100万あたり$10 / $50 | はい | いいえ | ExploitBench Cap% 78 | Glasswingパートナー |
| 4 | Gemini 3.6 Flash | 汎用モデル | はい | 100万あたり$1.50 / $7.50 | はい | いいえ | 非公開 | 最も安いフロンティア級に近い選択肢 |
| 5 | DeepSeek V4 Flash | オープンウェイト、MIT | はい | 100万あたり$0.14 / $0.28 | はい | はい、約167 GB | Cybergym 76.7 | ベンダーなし |
| 6 | Strix | 自律型ペンテスト | はい、カード | $29 / 席 / 月 | 一部 | はい、Apache-2.0 | 非公開 | 小規模チーム |
| 7 | MindFort | 継続的ペンテスト | はい | $199 / 月 | はい | いいえ | 非公開 | 公開されている最安の下限 |
| 8 | GitHub Advanced Security | スキャンと自動修正 | はい | $30 / コミッター / 月 | はい | いいえ | 非公開 | すでにGitHubを使っている |
| 9 | Horizon3 NodeZero | 自律型ペンテスト | AWS Marketplace経由 | $25,000 / 12か月 | マーケットプレイスのみ | いいえ | 非公開 | 大企業の調達 |
インタラクティブ
実際に何が壁になっていますか?
いちばん困っている制約を選んでください。これが解決するまで、リストの残りはノイズです。
高リスクのデュアルユースという区分こそがあなたを妨げているもので、CVPが調整するのもその区分です。無料で、2営業日で決定され、Opus 5は100万あたり$5と$25です。
併せて申請:すでにOpenAIを使っているなら、Daybreak Blue。ベンダーは違っても同じ解決策であり、2つの申請を同時に進めない理由はありません。
先に確認:CVPにはデータ保持の有効化が必要で、Google Vertex AIでは利用できず、Amazon BedrockのOpus 5でも利用できません。
<div class="altpick-card ap-b">
  <span class="altpick-tag">おすすめ:GitHub、Strix、またはMindFort</span>
  <p>3つとも、今日引用できる数字を公開しています。コミッター1人あたり$30、1席$29、月$199。電話もスコープ確認の打ち合わせも不要です。</p>
  <p class="altpick-alt"><strong>最も安く実際に変えられるもの:</strong>GitHub Code Security。コードはすでにそこにあり、CodeQLとCopilot Autofixは公開リポジトリなら無料です。</p>
  <p class="altpick-warn"><strong>注意:</strong>Strixは席料金に加えてペンテストを1回ごとに課金し、その1回あたりの料金は公開されていません。</p>
</div>

<div class="altpick-card ap-c">
  <span class="altpick-tag">おすすめ:DeepSeek V4 Flash</span>
  <p>MITライセンスで、ディスク上で約167 GB、4-way GB300ノード1台で提供できます。利用規約も、利用分野の制限も、デュアルユースに関する記述も、ライセンスのどこにもありません。</p>
  <p class="altpick-alt"><strong>併せて検討:</strong>8-way H200ノード上のGLM-5.2も同じくMITです。StrixのApache-2.0のCLIは、自分のモデルキーでローカル実行できます。</p>
  <p class="altpick-warn"><strong>落とし穴:</strong>ライセンスで自由になれるのは、セルフホストする場合だけです。これらのラボのホスト型APIの多くは、認可済みテストの例外なしに脆弱性スキャンを全面的に禁止しています。</p>
</div>

<div class="altpick-card ap-d">
  <span class="altpick-tag">おすすめ:GitHub Advanced Security</span>
  <p>ボトルネックは発見ではなく修正です。Copilot Autofixは、JavaScript、TypeScript、Java、Pythonのアラート種別の90%に対して修正を生成し、レビュー可能な変更として提供します。</p>
  <p class="altpick-alt"><strong>無料の選択肢:</strong>Trail of BitsのButtercupはAGPL-3.0で、自分のモデル利用料以外にコストはかかりません。</p>
  <p class="altpick-warn"><strong>これは違います:</strong>より許容度の高いフロンティアモデル。今必要なのは検出数を増やすことの正反対です。</p>
</div>

<div class="altpick-card ap-e">
  <span class="altpick-tag">おすすめ:MindFortまたはStrix</span>
  <p>どちらも悪用の実証付きで自律型ペンテストを実行し、営業との通話なしで始められます。MindFortは月$199で最大2回のペンテストを公開しており、Strixは$29の席料金に加えて1回ごとに課金します。</p>
  <p class="altpick-alt"><strong>大企業規模なら:</strong>Horizon3 NodeZeroは、AWS Marketplaceで500アセット・12か月が$25,000で、これは実際に公開された契約価格です。</p>
  <p class="altpick-warn"><strong>今は見送り:</strong>XBOW、RunSybil、Terra Security。いずれも高機能ですが、打ち合わせなしには価格を教えてくれません。</p>
</div>
「ベンダーのサイバースコア」の列については注意が必要です。この表の中でいちばん誤読されやすいからです。これらの数字は互いに比較できません。ラボごとに異なるベンチマークを、異なるセーフガード設定で実行したものです。特にAnthropicのCap% 78は、成功率ではなく16個のフラグからなる能力のはしごで、セーフガードをすべて外して実行されています。Anthropic自身がそう述べており、結果は公開リーダーボードの項目と「may not be directly comparable to public leaderboard entries」と注意しています。この列は、ベンダーが何かを公開しているかどうかを見るために使い、順位付けには使わないでください。
1. Daybreak Blue (GPT-5.6 Sol)
**最適な用途:**すでにOpenAIで標準化していて、ベンダーを変えずに摩擦を取り除きたいチーム。
**概要。**同じプログラムのもう半分です。Daybreak Blueでは、Solを含む汎用フロンティアモデルを、システムレベルのサイバーガードレールを外した状態で利用できます。OpenAIはこれを「the recommended starting point for most defenders」と呼び、脆弱性発見、セキュアコードレビュー、マルウェア分析、インシデント対応、パッチ検証といった業務を挙げています。
**アクセス。**個人はChatGPTのcyberページで本人確認を行い、組織はエンタープライズ向けフォームを使います。所要日数は公開されていません。個人アカウントでは、2026年9月1日からハードウェアセキュリティキーが必須になります。
**価格。**Solの標準料金で、短いコンテキストでは100万トークンあたり入力$5・出力$30、長いコンテキストでは$10と$45に倍増します。バッチなら半額です。詳しい内訳はGPT-5.6価格ガイドに、旗艦モデル単体はSol価格の記事にあります。ワークロードが許せば、より安い層もあります。Terraは$2と$12、Lunaは$0.20と$1.20です。
**評価。**OpenAIに留まるなら取る価値がありますが、何が変わり何が変わらないかを理解してください。OpenAIの高度なサイバー用プロンプトセットでは、Blueによって完了率は1.5%から2.0%に動くだけなので、エクスプロイトチェーンの作業は解放されません。解放されるのは、スクリーニング層に引っかかっていた通常の防御業務です。それは実際に解決される問題ですが、層の名前が匂わせるより小さな問題です。
2. Anthropic Cyber Verification Program
**最適な用途:**これを読んでいるほぼ全員。これが推奨です。
**概要。**Anthropicは、遮断されるサイバー業務を2つの区分に分けています。Prohibited useは「almost always used maliciously and have little to no legitimate defensive application such as mass data exfiltration or ransomware code development」に当たるもので、調整はできません。High Risk Dual useは「legitimate defensive applications, such as vulnerability exploitation or offensive security tooling development」を持つ業務で、この区分はCyber Verification Programを通じて調整可能です。
**アクセス。**既存の組織に対する無料の申請で、決定は「within 2 business days」にメールで届きます。対象はOpusとSonnetクラスのモデルで、Mythos 5は含まれません。Anthropicは異議申し立ての手順も公開しており、誤りの発生も率直に認めています。「We expect to occasionally decline eligible applications incorrectly, and approved users may still experience blocks on legitimate work.」
**価格。**プログラム自体は無料です。通常のモデル料金を支払います。Claude Opus 5は100万トークンあたり入力$5・出力$25、Sonnet 5は$2と$10です。手帳に控えておくべき点が1つ。Sonnet 5の料金は導入価格で、2026年8月31日以降は$3と$15になります。Opus 5レビューでは、その価格で実際に何が得られるかを扱っています。
**評価。**ほとんどの人にとってこれが答えで、僅差ではありません。終わりの見えないDaybreakの審査に対して2営業日、無料の申請、すでに優れたモデルに公開価格が付いています。Anthropicはさらに、Opus 5のトラフィックは「ran into cyber fallbacks 85% less than Fable 5」と報告しており、OpenAIの完了率の表に最も近いものを公開しているのはここだけです。本当の落とし穴は、先に確認すべき対応範囲の抜けです。CVPにはデータ保持の有効化が必要で、Google Vertex AIでは一切利用できず、Amazon Bedrock経由のOpus 5でも利用できません。
3. Claude Mythos 5 via Project Glasswing
**最適な用途:**招待されるだけの規模がある組織。これが正直な言い方です。
**概要。**Daybreak Redの本当の対応物であり、先に始まったほうです。Glasswingは2026年4月7日に、AWS、Apple、Cisco、CrowdStrike、Linux Foundationを含む名前を公表した12のパートナーで始まり、6月にはさらに約150の組織へ拡大しました。パートナーは"more than 10,000 high- or critical-severity security flaws"を発見しています。
**アクセス。**招待制のみです。セルフサービスの経路はなく、OpenAIの個人向け経路より厳しい壁になっています。
**価格。**100万トークンあたり入力$10・出力$50で、ローンチ記事とMythosの製品ページの両方に記載されています。Mythos Previewは$25と$125だったので、制限付きのサイバーモデルは4月から6月の間に60%安くなりました。
**評価。**入手できなくても理解しておく価値があります。議論全体の前提を組み替えるからです。Anthropicは、価格を公開し、重みが一般提供モデルと同一のモデルを制限しています。これはごく薄い衣をまとった方針上の判断であり、「能力こそが秘密だ」という説明を維持しにくくします。2つのラボを全般的に比較するなら、ClaudeとGPT-5.6の比較がサイバー以外の面を扱っています。
4. Gemini 3.6 Flash
**最適な用途:**申請なしで、サイバー向けに拒否の挙動が調整された高機能な汎用モデルを使いたいチーム。
**概要。**Googleの主力モデルで、2026年7月21日に出荷されました。関連する点は安全性に関する注記にあります。3.6 Flashは、サイバー攻撃目的の悪用を対象とした強化版のFrontier Safetyセーフガードとともに出荷され、Googleは「the model has been trained to minimize refusals for beneficial uses」と述べています。Daybreakが解決しようとしているのと同じ問題を、申請の向こう側ではなくベースモデル側で扱っているわけです。
アクセス。Google AI StudioとGemini APIから完全にセルフサービスで使えます。フォームも誓約書もありません。
**価格。**100万トークンあたり入力$1.50・出力$7.50で、入力ではSolの半分以下です。Gemini 3.6 Flashの詳細で全体像を、GPT-5.6とGemini 3の比較で直接対決を扱っています。
**評価。**何にも申請したくない場合に、摩擦がない最良の選択肢です。正直な限界が2つあります。Googleは3.6 Flashのサイバーベンチマークを公開していないため、拒否に関する主張を裏付ける数字なしで信頼することになります。また、専用モデルのGemini 3.5 Flash CyberはCodeMender内で政府と信頼できるパートナーに限定されており、OpenAIやAnthropicのどちらの運用よりも厳しい壁です。もう1点、Gemini 3.1 Proのモデルカード自身が、サイバーは「has reached the alert threshold」に達し、Googleは「deploy mitigations in this domain」を続けると述べているため、摩擦は減るどころか増える可能性があります。
5. DeepSeek V4 Flash
**最適な用途:**ベンダーとの関係も、利用規約も、プロンプトを読む相手も望まないチーム。
概要。このリストの中で、安価で、ダウンロードでき、MITライセンスで、ベンダー公表のサイバー数値を持つ唯一のモデルです。そのモデルカードはCybergym 76.7を報告しており、同じ行のClaude Opus 4.8は83.1です。
**アクセス。**重みをダウンロードします。ディスク上で約167 GBで、DeepSeek自身が公開しているコマンドを使えば、4-way GB300ノード1台で提供できます。
**価格。**ホスト型APIで100万トークンあたり入力$0.14・出力$0.28で、Solの出力料金の約107分の1です。計算を変える警告が1つあります。DeepSeekの料金ページには、日付なしで「significant increase」が見込まれると書かれています。これらの数字をもとに組んだ予算には、すでに期限が告知されているということです。
**評価。**ここで最も有力な本物の抜け道ですが、どの扉から入るかについて大きな但し書きがあります。**MITはMITです。**利用分野の制限も、利用規約もなく、デュアルユースに関する記述もライセンスのどこにもありません。これは上記のどのホスト型の選択肢とも、まったく別物です。ただしその自由は、セルフホストした場合にしか存在しません。DeepSeek自身のAPIを経由すれば、再び利用条件の下に戻ります。そしてOpus 4.8とのCybergymの6.4ポイントの差が、あなたが手放すものの正直な物差しです。
一般的な能力の全体像はDeepSeek V4 Flashレビューで、GPT-5.6との直接比較は、これまで公開された中で最も同条件に近い比較です。
6. Strix
**最適な用途:**ランチ代程度の価格で、今日から自律型ペンテストを始めたい小規模セキュリティチーム。
**概要。**API、Webアプリ、コードとプルリクエスト、インフラとクラウドを対象にした自律型ペンテストで、すべての発見に悪用の実証が付き、そのままマージできる自動修正のプルリクエストも出ます。本格的な攻撃ツール群を備えており、HTTP傍受プロキシ、XSSや認証バイパスのためのブラウザ悪用、シェル実行、概念実証エクスプロイト用のPythonサンドボックスが含まれます。
**アクセス。**どちらの扉も開いています。7日間の無料トライアル付きのカード決済か、クローンするかです。StrixのリポジトリはApache-2.0で、スターは50,707、最終プッシュは2026年8月10日です。CLIをローカルで動かすにはDockerと自分のモデルキーが必要です。
**価格。**Proは1席月$29で、「pentests billed separately, pay per test」です。Enterpriseは個別見積もりで、VPCまたはオンプレミスのデプロイと、自社モデルの持ち込み対応が加わります。
**評価。**この分野で最も本当の意味でセルフサービスな製品で、オープンソースの経路があるため、ベンダーと話すことなく評価できます。ただし価格については冷静に見てください。1回あたりのペンテスト料金は公開されていないため、$29は席料金であって請求額ではありません。それ以外は異例なほど透明な掲載内容の中の、本物の空白であり、トライアルで最初に聞くべき質問です。
7. MindFort
**最適な用途:**電話なしで予算の1行に入れられる、公開された月額の数字がほしいチーム。
**概要。**継続的ペンテスト、セキュリティコードレビュー、プルリクエストレビュー、パッチ適用を行うAIエージェントで、すべての発見が、検証・再テスト済みでマージ可能なPRとして届けられます。セキュリティエージェントをSlackに置くこともできます。
**アクセス。**2つの有料プランはどちらもセルフサービスで申し込め、初回の評価は無料で提供されます。デモに誘導されるのはEnterpriseだけです。
**価格。**Growthは月$199から、400クレジットで最大2回のペンテスト。Scaleは月$999から、800クレジットで最大4回のペンテストです。クレジットパックには最大30%のボリューム割引があり、超過課金は任意なので、残りがゼロになっても評価は続行されます。
**評価。**この分野で公開されている最安の下限であり、「月$250未満で何が手に入るか」への最も明快な答えです。2つの留保があります。トップページの偽陽性1%未満や数時間での初回結果という主張はベンダーの主張であり、独立して検証されていません。またGrowthプラン自体の説明に「scope and usage are tailored in the demo」とあるため、セルフサービスの申し込みも結局は会話に誘導される可能性があります。価格が公開されている点だけで、すでにこの分野の大半より先を行っています。
8. GitHub Advanced Security
**最適な用途:**すでにコードがGitHubにある人。つまり大半の人です。
**概要。**現在は、個別に価格設定された2つのアドオンに分かれています。Code Securityは、プライベートリポジトリ向けのCodeQLとCopilot Autofix、依存関係レビュー、Dependabotの自動トリアージルールを含みます。Secret Protectionは、有効性チェック、パスワードのような非構造化シークレットを対象にしたCopilotのシークレットスキャン、プッシュ保護の制御を含みます。
**アクセス。**完全にセルフサービスです。リポジトリ設定から有効化するだけで電話は不要、30日間のトライアルも利用できます。
**価格。**アクティブなコミッター1人あたり月額で、Code Securityは$30、Secret Protectionは$19です。CodeQLとCopilot Autofixは、すべてのプランで公開リポジトリなら無料です。GitHubによれば、AutofixはJavaScript、TypeScript、Java、Pythonのアラート種別の90%に対して修正を生成します。
**評価。**このリストの中で、AI支援による脆弱性修正としては最も安価で信頼でき、コードがすでにそこにあるため導入の摩擦も最小です。ペンテスト製品ではなく、エクスプロイトチェーンを追いかけることもないので、StrixやMindFortとは問題の別の部分を解決します。ギャップが「見つけるだけで修正しない」ことなら、これが直接の答えで、公開コードならゼロから始められます。
9. Horizon3.ai NodeZero
**最適な用途:**本物の契約が必要で、AWS Marketplaceの利用枠を消化したい大企業。
**概要。**大企業規模の自律型ペネトレーションテストで、席ではなくアセット単位で販売されます。
**アクセス。**自社サイトではデモ経由ですが、AWS Marketplaceでは価格が完全に公開されています。この裏口は一般に知っておく価値があります。この分野の複数のベンダーが、自社サイトに載せない数字をそこで公開しているからです。
**価格。**マーケットプレイスの掲載によると、500アセットで12か月分のCore、Pro、Eliteがそれぞれ$25,000、$32,500、$42,500で、単発のFlexテストが$15,000です。
**評価。**問題がアクセスではなく、大企業規模と調達にある場合にのみ、候補リストに入れてください。ここに載せる理由は、それが示すパターンです。ベンダーのサイトに「contact sales」とあったら、価格が秘密だと決めつける前にクラウドのマーケットプレイスを確認してください。XBOWも同じ方法で、Enterprise攻撃クレジット12か月分を$50,000と公開しています。
教訓的な話:XBOW
独立した節にする価値があります。この市場がどこへ向かっているかを最も鮮明に示す例だからです。
XBOWは、フロンティア級のサイバー能力を制限することに公然と反対した側のベンダーです。GPT-5.5に関する2026年4月の投稿は、その主張を直接述べています。"Capability doesn't vanish when you gate it. It gets rediscovered, leaked, replicated." 制限されたアクセスを「private club」と呼び、誰が締め出されるかを挙げています。「the mom-and-pop business, the regional hospital, the mid-market company with a part-time security lead.」
2025年11月、XBOWはPentest On-Demandを、明確に「self-serve, on-demand, self-explanatory」で、「no scoping meeting required」と謳って立ち上げ、価格は、2つの発表ページのどちらを読むかによって$4,000から$6,000の範囲でした。
現在、その両方の投稿が購入先として指しているURLは、デモのリード獲得フォームにリダイレクトされ、料金ページは「Request Pricing」フォームで、価格に関する唯一の記述は「Pricing is scoped to your environment.」です。
公平を期したいのは、XBOWの主張には説得力があり、同社が実際に成果を上げているからです。顧客アプリケーションで14,000件以上のゼロデイを発見し、HackerOneのランキングで1位になったと主張しています。それでも、アクセスの民主化を最も声高に主張したベンダーが、9か月で自らのセルフサービス層を取り下げました。それは、どんな立場表明をもっても変えられない、この分野の経済性について何かを物語っています。
誤解されがちなこと:「Kimi K3を使えばいい」
サイバー制限をめぐるHacker Newsのスレッドで最もよく見る助言で、重要な意味で半分だけ正しいものです。
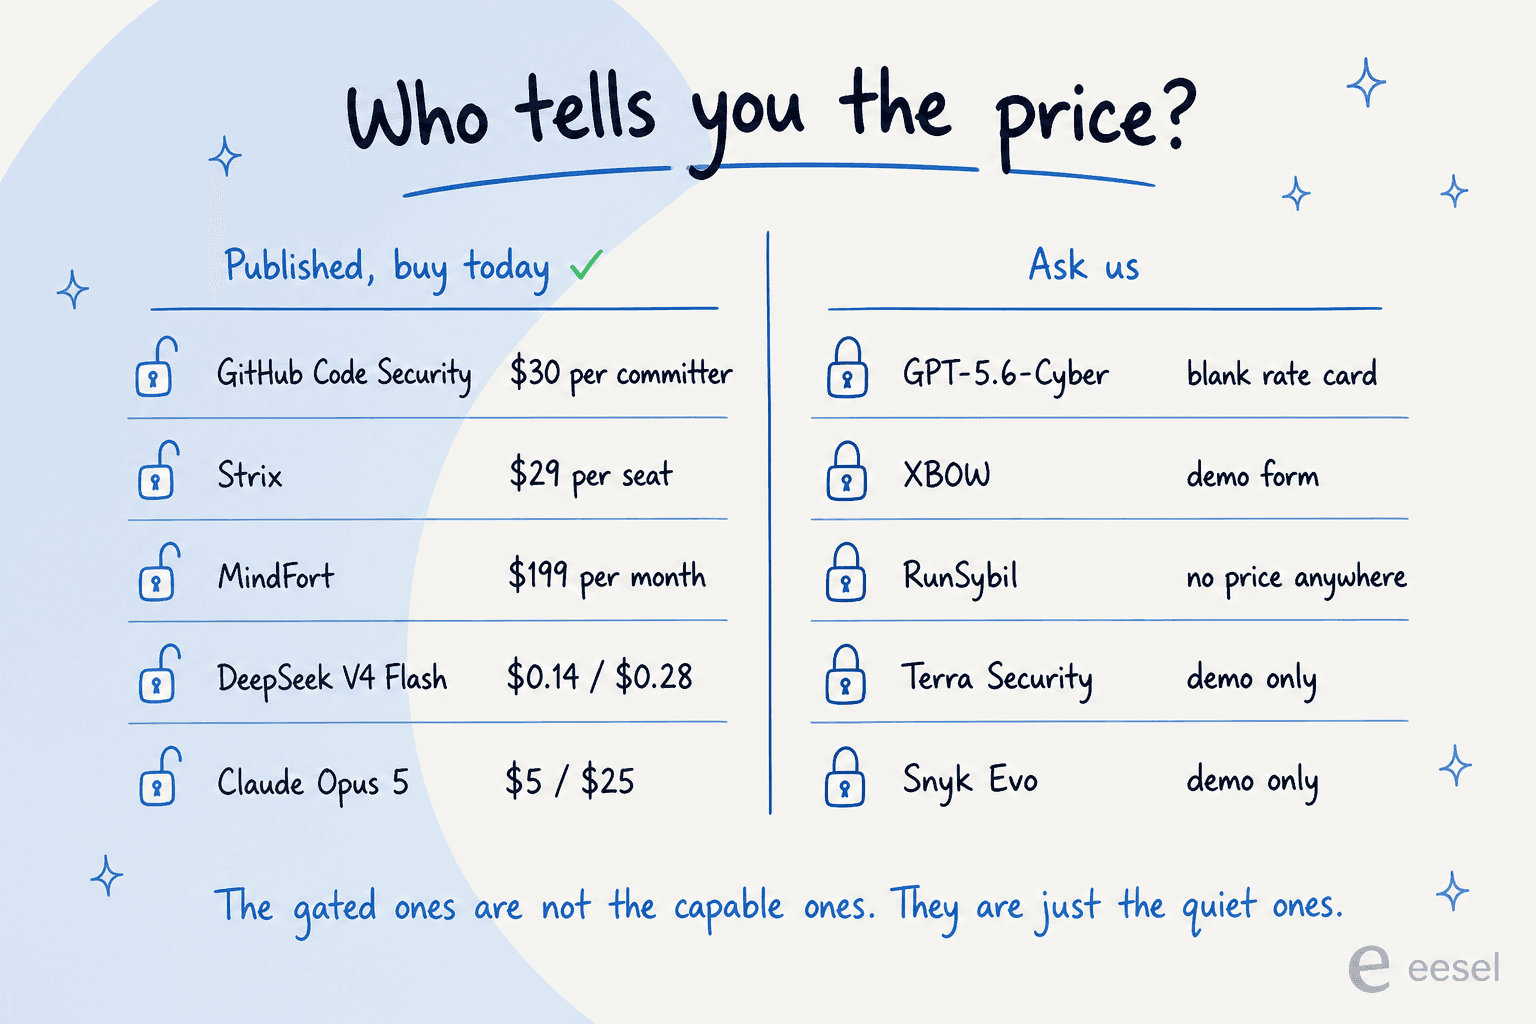
ライセンスに関する主張は完全に正しいです。Kimi K3の独自ライセンス、DeepSeek V4のMIT、GLM-5.2のMITには、利用規約も、利用分野の制限も、サイバーやデュアルユースへの言及もありません。Kimi K3のライセンスファイル全体で唯一の行為に関する文言は「must comply with applicable laws.」です。プロンプトのスキャンと、フラグが立った内容の人間によるレビューがあるホスト型モデルと比べれば、それは程度の差ではなく、本質的な違いです。
実行面の助言は、具体的に2点で間違っています。
第一に、ライセンスで自由になれるのは実際にセルフホストした場合だけで、ホスト型APIの経路は、あなたが離れたものよりも悪いです。Moonshotの規約は「providing programs or tools specifically designed for engaging in activities that endanger network security, such as network intrusion」を禁じており、認可済みテストの例外はありません。AlibabaのQwenCloudの規約は、「probe, test, or scan the vulnerability of any System」というあらゆる試みを禁じており、こちらも例外はありません。どちらも、攻撃用ツールについてはGoogleのポリシーより厳格です。ChatGPTの契約を解約してMoonshotのAPIクレジットに乗り換えても、何からも逃れられません。
第二に、Kimi K3は名前を挙げるモデルとして不適切です。100万トークンあたり$3と$15で、オープンウェイトの選択肢の中で最も高価であり、出力ではGemini 3.6 Flashの2倍、Solの価格帯の内側です。重みは1.56 TBで、Moonshot自身のサービング手順は「at least 8x GB300. Multi-node for real production traffic.」を求めています。推奨されるのは最新だからであって、実用的だからではなく、Kimi K3レビューとK3価格の記事の両方がそれを裏付けています。167 GBのDeepSeek V4 Flashこそ、この主張のうち、ハードウェア予算という現実に耐える版です。
第三に、最も居心地の悪い点ですが、GPT-5.6-Cyberとの差を実際に測れる人は誰もいません。OpenAIがそれについてシステムカードを公開していないからです。「オープンウェイトはもう近い」という主張はすべて、壁の向こうのモデルではなくSolを基準に測られています。
私が実際にやること
実際のセキュリティプログラムがあり、待ってくれない予算サイクルがあるものとして、優先順に挙げます。
- **今日、AnthropicのCyber Verification Programに申請する。**無料、2営業日、モデル価格も公開されています。他のすべてを決めている間、これを動かしておかない理由はありません。
- **すでにOpenAIを使っているなら、並行してDaybreak Blueに申請する。**これも無料で、通常の防御業務を妨げているスクリーニング層を取り除きます。
- **コードがGitHubにあるなら、GitHub Code Securityを有効にする。**コミッター1人あたり$30は、このリストで何かを変えるものとして最も安く、公開リポジトリでは無料です。
- **席課金か月額かの好みに応じて、StrixかMindFortを試す。**どちらもセルフサービスで下限を公開しており、ベンダーなしで評価したいならStrixにはApache-2.0の経路があります。
- セルフホストを検討するのはその後。DeepSeek V4 FlashやGLM-5.2は寛容なライセンスを持つ本物の選択肢ですが、これは設備投資と人員配置の判断であり、サブスクリプションの乗り換えではありません。
そのリストにないのは、Daybreak Redを待つことです。仕事で本当に必要なら申請してください。ただしそれを計画にしないでください。公開された所要日数のない申請で、価格もシステムカードも公開されていないモデルだからです。
eeselを試す
問題は違っても、教訓は同じです。私は日々、実際の顧客データを扱うAIエージェントを作っており、この記事のパターンは常に直面するものです。ボトルネックになるのは能力ではなく、制御の面であることがほとんどです。
eeselが土台にしているのはそこです。AIエージェントが実際の顧客に1度でも回答する前に、自社の過去チケット数千件でシミュレーションし、何と答えていたかを正確に確認します。そのうえで、信頼できるチケットの種類に範囲を絞り、残りはエスカレーションします。
ツールの操作はすべて記録され、機微なものは人間の承認の背後に置かれます。これは、この記事に登場するすべてのラボが勧めるサンドボックスとスコープの規律の、サポートキュー版です。セキュリティレビューを乗り越えられるようにするのもこれで、同じ論理は必要になったときHIPAAレベルの業務にまで拡張できます。
申請も、誓約書も、待機リストもありません。今日の午後にはシミュレーションを動かせます。
