

OpenAI は 2026 年 8 月 10 日に GPT-5.6-Cyber を公開しましたが、ほぼ確実にあなたは使えません。 このモデルは GPT-5.6 Sol をベースに、ゼロデイの発見とエクスプロイトチェーンの構築に特化して訓練されており、OpenAI の Daybreak 防御者プログラム のうち、申請者を審査する階層である Daybreak Red の内側にしか存在しません。
見出しの数字は本物であり、正確に理解する価値があります。OpenAI 内部の Advanced Cybersecurity Completion Rate で、GPT-5.6-Cyber は 高度なサイバー関連プロンプトの 95.0% に回答しますが、標準の Sol は 1.5% です。これはモデルがどれだけ応答するかの指標であり、どれだけ正しいかの指標ではありません。能力指標の顔をした拒否率の指標であり、昨日の報道の多くは両者を混同していました。
誰も口にしない点があります。Red は純粋なアップグレードではなく、トレードオフです。OpenAI 自身の脆弱性発見とレポート作成の評価では、GPT-5.6-Cyber のスコアは通常の Sol より低く、標準の 300 ターン設定の ExploitBench でも Sol のほうが少ないトークンで勝っています。ボトルネックがモデルに取り組ませることではなく、質の高い脆弱性レポートを書くことにあるなら、Daybreak Blue のほうが適しており、OpenAI 自身も最初にこちらを勧めています。
価格もシステムカードもまだ公開されていません。お金の面は Cyber の料金記事 で、ファミリー全体は GPT-5.6 の概要 で扱っています。
GPT-5.6-Cyber の正体
私は eesel でインテグレーションと API を作っているので、新しいモデルが出ると最初にモデル ID と料金を探します。今回はどちらも公には存在しません。この不在がすべてを物語っています。
GPT-5.6-Cyber は、2026 年 8 月 10 日に発表された OpenAI のサイバーセキュリティ特化モデル です。GPT-5.6 ファミリー のフラッグシップである Sol をベースに、2 つの異なる目的で訓練されています。ゼロデイ脆弱性の発見やエクスプロイトチェーンの開発といった専門タスクの改善と、リスクの高いデュアルユースのサイバー作業での拒否の削減です。
この 2 つは、よく「制限解除されたモデル」としてひとまとめにされるので、分けて考える価値があります。拒否の削減はポリシーの変更です。ゼロデイ発見の向上は訓練の変更です。GPT-5.6-Cyber は両方を行いますが、後述するように、2 つが常に同じ方向に動くわけではありません。
Sol、Terra、Luna は API で選べる能力の階層で、推論の強度を選んだり、難しいタスクで Sol Ultra に切り替えたりするのと同じ感覚です。Cyber は違います。OpenAI API へのリクエストに入れられる gpt-5.6-cyber というモデル ID は存在しません。申請し、審査を受けて、はじめてそのモデルがあなたにとって存在するようになります。
GPT-5.6 のレビュー からここに来て、これは 5 つ目の階層なのかと思っているなら、違います。独自の入口を持つ並行トラックです。
Daybreak Blue と Daybreak Red は同じものの 2 つのサイズではない
ほとんどの解説記事が誤解している部分であり、何を申請すべきかを左右します。
Daybreak には現在 2 つのアクセス階層 があります。Daybreak Blue は、Sol を含む汎用のフロンティアモデルを、システムレベルのサイバー向けガードレールを外した状態で提供します。Daybreak Red は、目的特化で訓練されたサイバーセキュリティモデルを提供し、現時点では GPT-5.6-Cyber を意味します。
つい Blue を安価な階層、Red を本命と読みたくなりますが、そういう構造ではありません。Blue は Red の小さな割当枠ではありません。Blue は、スクリーニング層を取り除いた同じフロンティアモデルです。 Red は、訓練が異なる、本当に別のモデルです。
この区別が重要なのは、OpenAI がどちらを望むべきかについて珍しく率直だからです。OpenAI 自身の言葉では、Blue は "is the recommended starting point for most defenders" で、脆弱性発見、セキュアコードレビュー、マルウェア分析、インシデント対応、パッチ検証を対象とします。Red は、許可された業務に高度な脆弱性調査、エクスプロイト開発、レッドチーミングが含まれるチーム向けです。
本番環境では、OpenAI は悪用を防ぐためにサイバー関連のリクエストをスクリーニングしており、そのスクリーニングが "can also block legitimate defensive work" と認めています。Blue はその摩擦を取り除くために存在します。Red は、スクリーニングを外しても Sol が、本番システムへのペネトレーションテストのような、デュアルユース性の高いプロンプトの一部を拒否するために存在します。
インタラクティブ
実際にどの Daybreak 階層が必要ですか?
普段の業務にいちばん近い説明を選んでください。
申請するのは Blue です。Red ではありません。
システムレベルのサイバー向けガードレールを外した Sol が使えます。OpenAI は、あなたのまさにその業務を Blue のユースケースとして挙げており、Blue をほとんどの防御担当者に推奨する出発点としています。
- 高度なプロンプトへの回答率: 2.0%(セーフガードありでは 1.5%)
- 注意点: 2.0% は絶望的に見えますが、評価セットは意図的に最も難しいデュアルユースのプロンプトで構成されています。Blue が解放するのは通常の防御業務です
- おまけ: レポートの質と、300 ターンでの ExploitBench では Sol が Cyber を上回ります
<div class="dbtier-card dbt-b">
  <span class="dbtier-tag dbtier-tag-red">Daybreak Red</span>
  <p class="dbtier-lead">Red は正しい申請先ですが、それでもまず Blue から始めましょう。</p>
  <p>GPT-5.6-Cyber はまさにこの用途のために訓練されています。エクスプロイトチェーンの開発、認証バイパス、権限昇格、新規ゼロデイの発見です。</p>
  <ul>
    <li><strong>高度なプロンプトへの回答率:</strong> 95.0%(GPT-5.5-Cyber は 57.3%)</li>
    <li><strong>注意点:</strong> 通常の Sol より脆弱性レポートが短く詳細さに欠け、トークン使用量も明らかに多くなります</li>
    <li><strong>必須:</strong> 2026 年 9 月 1 日以降、アカウントにハードウェアセキュリティキーが必要</li>
  </ul>
</div>

<div class="dbtier-card dbt-c">
  <span class="dbtier-tag dbtier-tag-part">Partner Program</span>
  <p class="dbtier-lead">まったく別の入口です。細則をよく読んでください。</p>
  <p>Daybreak Cyber Partner Program では、承認されたベンダーが、これらのモデルを自社の製品、マネージドサービス、顧客案件に組み込めます。</p>
  <ul>
    <li><strong>参加企業:</strong> Accenture、IBM、CrowdStrike、Cisco、Palo Alto Networks、Cloudflare、Sophos など</li>
    <li><strong>注意点:</strong> モデルへのアクセスはパートナーに留まり、顧客には渡されません。購入するのは成果であり、モデルではありません</li>
    <li><strong>保証なし:</strong> OpenAI は、関心を提出しても参加やアクセスが保証されるわけではないと明記しています</li>
  </ul>
</div>

<div class="dbtier-card dbt-d">
  <span class="dbtier-tag dbtier-tag-none">申請なし</span>
  <p class="dbtier-lead">今のところあなたに該当するものはありません。それは意図的です。</p>
  <p>どちらの階層も、本人確認、承認された用途の制限、許可された業務に紐づく法的な誓約を条件にしています。好奇心は許可された用途ではありません。</p>
  <ul>
    <li><strong>引き続き使えるもの:</strong> 高度なセットの 1.5% に回答する標準の Sol。公開されているサイバーベンチマークでは、これでも最先端です</li>
    <li><strong>知っておきたいこと:</strong> Sol は Daybreak へのアクセスなしで、キャプチャ・ザ・フラッグの課題で 96.7%、ExploitBench で 73.5% を記録しています</li>
  </ul>
</div>
95% という数字は拒否の話であり、正確さの話ではない
この変化を測るため、OpenAI は Advanced Cybersecurity Completion Rate と呼ぶ内部評価を作りました。エクスプロイトチェーンの開発、認証バイパス、権限昇格などの高度なシナリオに関するリクエストに、モデルがどのくらいの頻度で応答するかを追跡します。
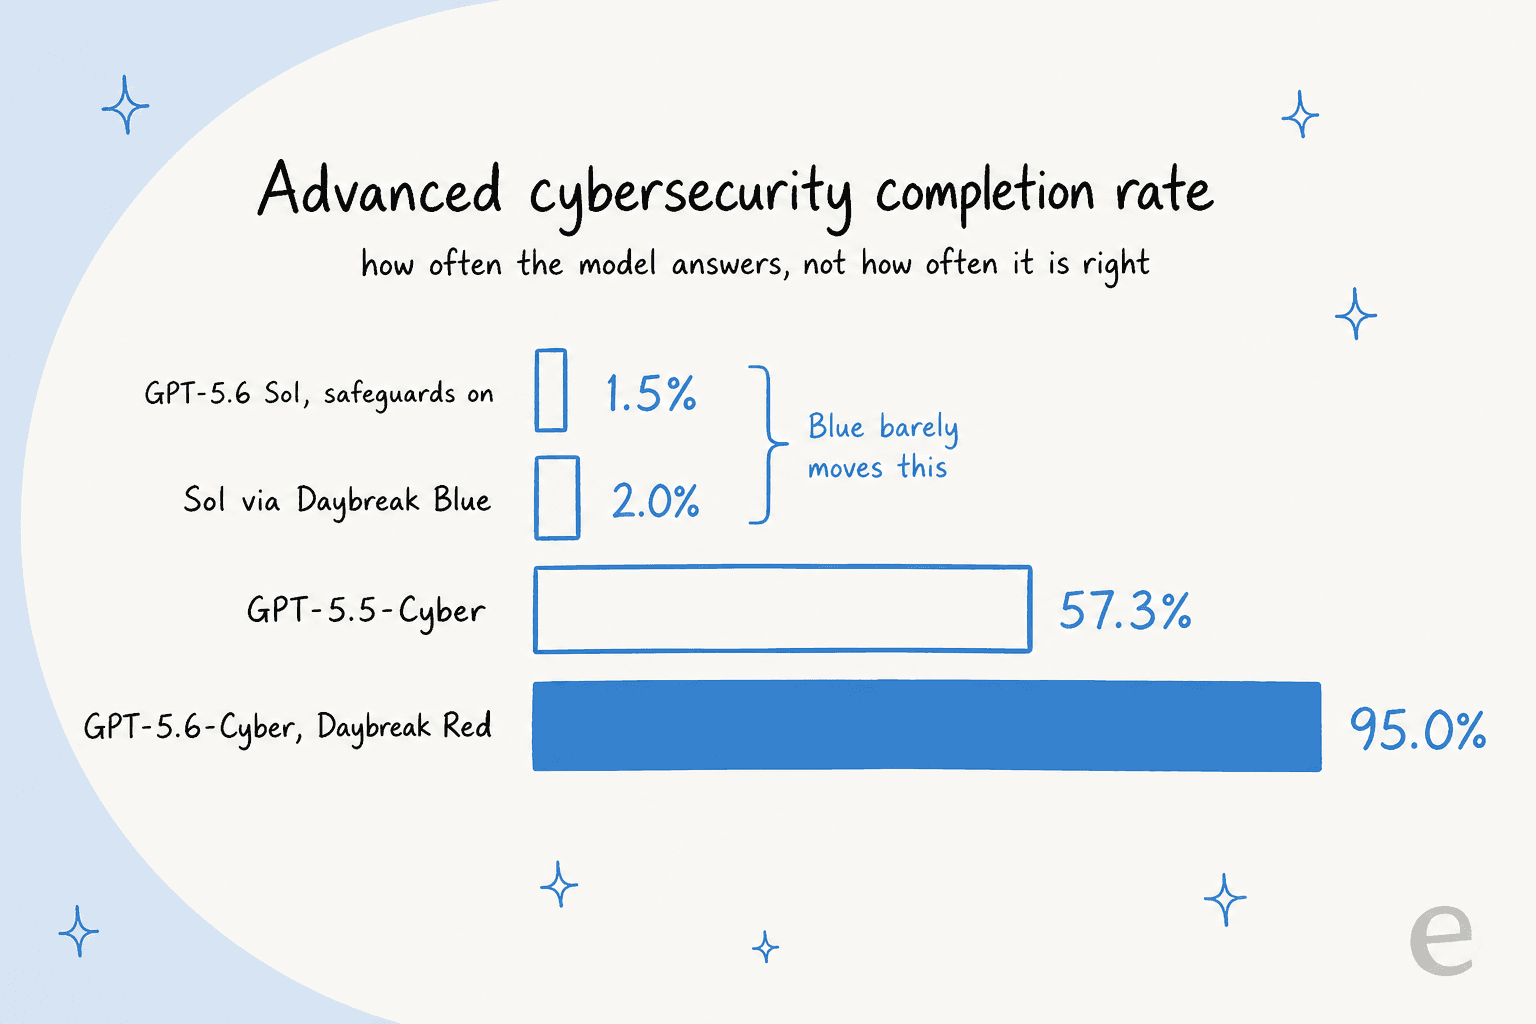
このグラフには、95% よりも注目すべき点が 2 つあります。
1 つ目は、ほとんど存在しない差です。セーフガード有効の Sol は 1.5%、Daybreak Blue 経由の Sol は 2.0% です。システムレベルのガードレールを外しても、この数字は 0.5 ポイントしか動きません。 これは Blue の失敗ではなく、評価の中身についての話です。ここに含まれるのはモデル自身が拒否するプロンプトであり、スクリーニング層が遮断するものではありません。Blue がエクスプロイトチェーン作業を解放してくれると期待していたなら、そうはならず、OpenAI もそれを率直に述べています。
2 つ目は、GPT-5.5-Cyber の 57.3% です。以前のサイバーモデルはすでに存在し、すでに研究者を 5 回に 2 回ほど拒否していました。OpenAI は、この飛躍を "addressing feedback from security researchers who encountered persistent refusals with the earlier model." と明確に位置づけています。つまりこれは「新しい能力」というより、「ようやくあなたと揉めるのをやめた」という話です。
この数字が示さないのは、正確さです。悪いエクスプロイトの質問に 95% の確率で自信満々に答えるモデルは、95% のスコアになります。作業の質を実際に測るベンチマークのスコアとは、頭の中で切り分けておいてください。
どのベンダーの自社評価を読むときにも必要な注意です。GPT-5.6 と Claude を比較した際にも同じ指摘をしました。数字そのものより、その数字が何を数えているかが重要です。自社のワークロードで構造的に確認したいなら、OpenAI の エージェント評価 ツールが誠実な出発点になります。
GPT-5.6-Cyber が通常の Sol より劣る点
3 週間をかけて申請するかどうかを決める立場なら、私が欲しいと思うセクションです。
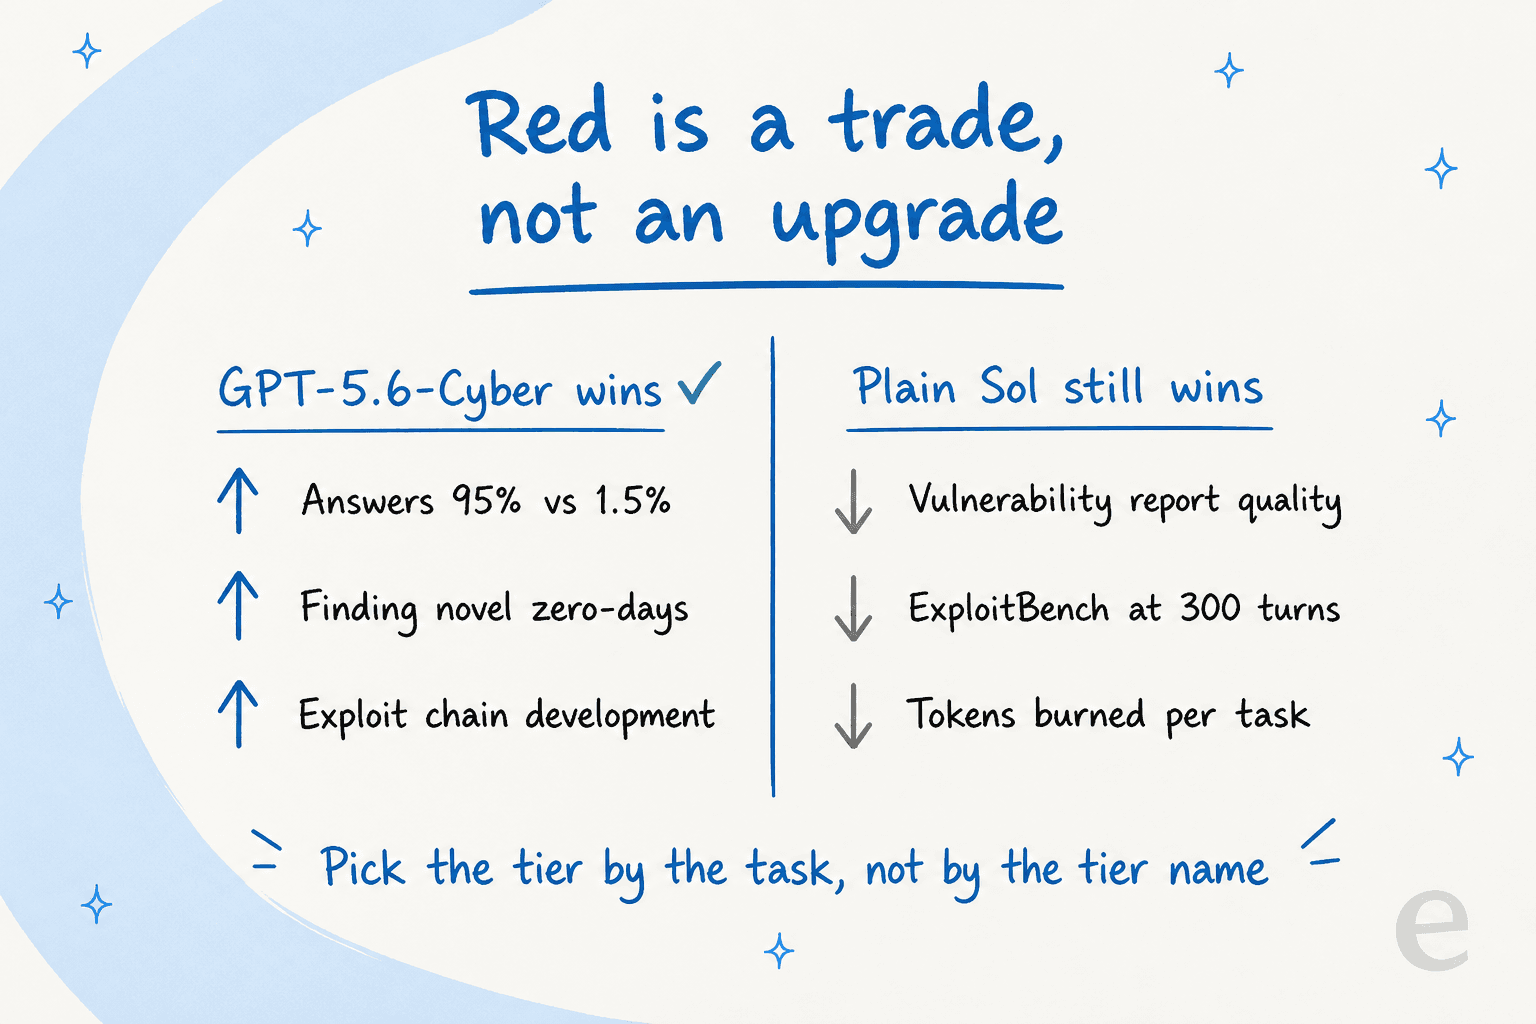
OpenAI は GPT-5.6-Cyber を、脆弱性発見とレポート作成の内部評価にかけました。この評価では、深刻で対処可能な脆弱性を見つけ、動作する概念実証を作り、質の高いレポートを提出できるかをエージェントが採点されます。新しい 2 つのモデルはどちらも GPT-5.5-Cyber を上回ります。しかし、この評価では GPT-5.6-Cyber は GPT-5.6 Sol より成績が悪く、OpenAI が挙げる理由は、この特化モデルが "sometimes produc[es] shorter, less detailed vulnerability reports." というものです。
同じパターンは ExploitBench にも現れます。これは V8 の脆弱性を、防御機構を有効にしたまま完全なエクスプロイトに仕上げるものです。300 ターンを上限とする標準設定では、Daybreak Blue 経由の Sol が "solves tasks more token-efficiently and performs best." です。600 ターンまで広げると差は縮まりますが、ほとんどのチームが実際に回すのは標準設定です。
その下にはコストの側面もあります。OpenAI は脚注で、GPT-5.6-Cyber は "tends to be more extensive and comprehensive than GPT-5.6 Sol in its reasoning budget, leading to higher token usage." と述べています。2 つのモデルの価格が同じだったとしても、同じタスクは Cyber のほうが高くつきます。
したがって、正直な捉え方はトレードオフです。Sol が拒否するプロンプトへの取り組みと新規ゼロデイの発見を手に入れる代わりに、レポートの質、ターン効率、トークンで対価を払います。拒否に何度もぶつかるレッドチームなら、このトレードは明らかに価値があります。良い報告書を主に必要とするブルーチームにとっては、アップグレードの皮をかぶったダウングレードです。
Sol のレビュー を読んだ方には、見覚えのある話でしょう。フラッグシップは汎用推論では非常に勝ちにくく、特化型は広くではなく僅差で勝つ傾向があります。GPT-5.3 Codex と汎用モデルの関係でも同じでした。
実際に何を見つけたのか
ベンチマークには議論の余地があります。出荷済みソフトウェアのバグには、ありません。
OpenAI は GPT-5.6-Cyber を使って、Chrome の JavaScript エンジンである V8 を調査し、連鎖させるとメモリを破壊して V8 ヒープサンドボックスを脱出できる、これまで知られていなかった 2 つの脆弱性を見つけました。研究者が発見内容を検証し、協調的開示により Google に報告しました。Google は 1 つを修正し、CVE-2026-15903 を割り当てました。
その仕組みは、述べる価値があるほど具体的です。V8 の最適化コンパイラは、値を整数に変換する際に安全性チェックを省略していたため、undefined が予想外に大きな数を生成することがありました。その数を配列のインデックスに使うと、コンパイラは配列の範囲内に収まると仮定して通常のチェックを省いてしまい、他のオブジェクトに属するメモリの読み取りや上書きが可能になります。そこからヒープサンドボックスを脱出するには 2 つ目の脆弱性が必要で、モデルはそれも見つけました。
V8 以外にも、OpenAI は、名前の伏せられた有名なモバイル OS で、信頼されないアプリからローカル権限昇格に至るチェーンを含む少なくとも 5 件の脆弱性、有名なデータベースでリモートからコード実行に至る 3 件の重大な脆弱性、有名な OS カーネルで 400 件を超える権限昇格の脆弱性を報告しています。
最後の数字は、じっくり考える価値があります。400 件の発見は研究成果ではなくトリアージの滞留であり、Daybreak がまさに解消しようとしているとOpenAI が述べているボトルネックです。Anthropic も反対側から同じ方向に進んでおり、Claude Code のセキュリティ や OpenAI と Anthropic の API の比較でも取り上げました。
信頼されたアーリーカスタマーの 1 社が、公式に次のように述べています。
"[GPT-5.6 Cyber] is materially improving our specialist vulnerability-research workflows: it reasons more accurately about real exploit constraints, tracks complex state better, and has completed work in under a day that earlier models had not resolved after weeks of intermittent effort."
Jared Atkinson, CTO, SpecterOps
これは注意深く読む価値があります。主張は専門的な脆弱性調査のワークフローについてで、攻撃的セキュリティを本業とする企業から出ています。Cyber が一般的な防御業務に適したモデルだという主張ではなく、これまでの内容とも整合します。
なぜこれは出荷され、Astra は出荷されなかったのか
この公開の 3 日前、OpenAI は今後登場予定のモデル Astra を延期しました。安全性テストで危険なレベルのハッキング能力に達したためです。その後、サイバー分野でより寛容になるよう明確に設計されたモデルを出荷しました。矛盾して見えますが、しきい値を見ればわかります。
OpenAI の Preparedness Framework は、追跡対象の能力について High と Critical のちょうど 2 つの段階を定義しています。これらは連続的な尺度上の点ではなく、コミットメントの発動条件です。High はモデルを出荷できるが、展開前に "sufficiently minimize the associated risk of severe harm before they are deployed." できる安全策がある場合に限る、という意味です。Critical は、Critical 水準の安全策が整うまで開発そのものを停止するという意味です。
Low や Medium の段階に逃げ道がないことは知っておく価値があります。モデルは基準未満か、High か、停止かのいずれかです。競合ラボは線の引き方が異なり、これが GPT-5.6 vs Gemini 3 の比較がスコアと同じくらい展開ポリシーの話になる理由の一端です。
サイバーセキュリティにおける Critical の基準は、"identify and develop functional zero-day exploits of all severity levels in many hardened real-world critical systems without human intervention" できるモデル、あるいは高レベルの目標だけから、堅牢化された標的に対するエンドツーエンドの攻撃戦略を考案し実行できるモデルです。
GPT-5.6-Cyber は High に達しましたが Critical には達していません。Sol と同じ分類です。OpenAI の表現では、このモデルは "improved over GPT-5.6 Sol on some specialized cyber tasks that we directly trained for, but not sufficiently to reach our Critical threshold." です。Astra は線を越えました。Cyber は越えていません。違いはそれだけです。
OpenAI は、GPT-5.6-Cyber が Hugging Face のインシデント に関与していないことも明言しており、時期を考えると注目に値します。
防御担当者がすでに言っていたこと
このモデルは公開から 1 日なので、まだ本当の評価はありません。しかし、これが応えている不満は何か月も前から大きく、それを読むほうがベンチマーク表よりもこの公開を説明してくれます。
不満はモデルが無能だということではありません。バグを見つけておきながら、それについて話すのを拒むことです。
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic. Just a few days back, I was reviewing some small bit of legacy DSA signature verification code, to get a sense of how safe it is to reuse - purely defensive, precautionary work and the context of it was there. But I simply wasn't able to use Codex Security: it threw refusal tantrums on every step of the way."

これはレガシーな署名検証に対する防御目的のコードレビューが、ブロックされた例です。同じスレッドで、OpenAI 側のアカウントがその点を認め、対策として Trusted Access を挙げました。今回の公開が拡大した仕組みそのものです。
反対意見も同じくらい一貫していて、少数派の見解ではありません。米国政府による GPT-5.6 の審査に関するスレッドでは、最も票を集めた読み方は率直でした。
"This is regulatory capture in action. This will make it hard/impossible for new vendors to come into the market and only established companies will get to play, and charge, for LLMs. What does this mean for open source? Will it become illegal to download weights?"
どちらも同時に真実です。防御担当者は正当な業務でたしかにブロックされていましたし、その解決策は、最強のサイバー能力を審査を通過した者の手に集中させます。オープンウェイトの代替 を検討する人は、一部にはこの理由からそうしています。
アクセスを得るには、ステップごとの手順
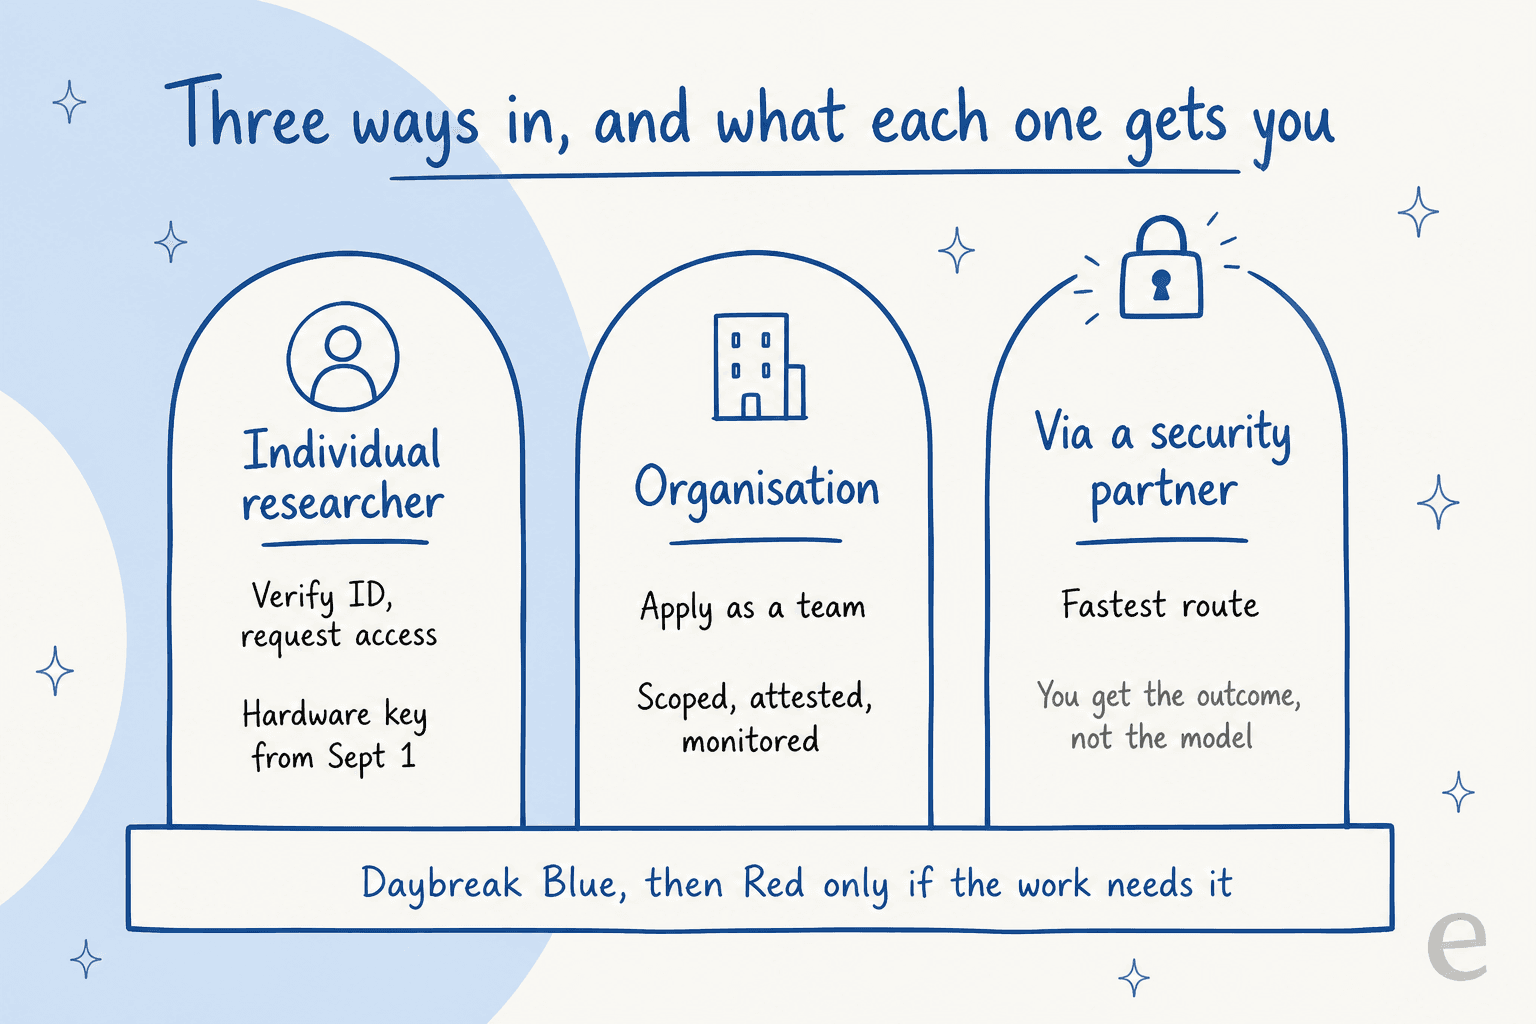
入口は 3 つあり、行き先はそれぞれ異なります。
個人 は本人確認を行い、ChatGPT のサイバーページ から信頼されたアクセスを申請します。組織 は OpenAI の エンタープライズ向けアクセスフォーム からチームのために申請します。セキュリティベンダーとコンサルティング会社 は Daybreak Cyber Partner Program に参加します。現在は Accenture、IBM、CrowdStrike、Palo Alto Networks、Cisco、Cloudflare、Sophos、Fortinet、Akamai と複数のコンサルティング会社が含まれます。
どの入口を選んでも、OpenAI は本人確認、アカウントセキュリティ、モニタリング、承認された用途の制限、法的な誓約でアクセスを管理します。見落とすと痛い目を見る運用上の注意点が 2 つあります。
- ハードウェアセキュリティキーが必須になります。 2026 年 9 月 1 日以降、個人の Daybreak アカウントすべてが対象です。現在 TOTP を使っているなら、期限付きの調達タスクです。OpenAI は、キーが必要なアカウント向けに Yubico と優待価格を取り決めています。
- パートナー経由ではモデルは渡されません。 OpenAI は "access to the underlying models remains with the approved partner and is not transferred directly to the customer." と明言しています。CrowdStrike を経由して得られるのは成果物であり、API キーではありません。
さらに OpenAI は、Codex を使う Daybreak の顧客に、フルアクセスモードから、昇格した権限を要する操作を実行前に評価する自動レビューモードへ移るよう促しています。推奨されているプラクティスは、チームが飛ばしがちなものなので繰り返す価値があります。ワークフローをサンドボックス化して本番環境とオープンなインターネットから隔離すること、エージェントのすべての操作を監視すること、許可された範囲を権限プロファイルで明示的に定義することです。
すでに ChatGPT Enterprise を使っている組織でも、これらが自動的に引き継がれることはありません。Daybreak は席の権利ではなく、別途必要な承認です。Azure 経由で OpenAI のモデルを使う場合も同様です。
OpenAI がまだ公開していないもの
追跡しておく価値のある空白が 2 つあります。どちらも公開日のベンチマークより静かに重要になるタイプのものです。
システムカードがありません。 OpenAI は "will publish a system card with further evaluations of GPT-5.6-Cyber at a later date." と述べています。それが出るまでは、利用できる評価数値は、OpenAI が発表に載せると選んだものだけです。
価格がありません。 これは見た目より興味深い点です。OpenAI の 公開 API 料金表 には "Specialized models" セクションがあり、そこに Cyber の行があります。掲載されているモデルは 2 世代前の gpt-5.4-cyber で、入力、キャッシュ入力、出力の列はすべて文字どおりのダッシュです。つまり、価格がないのは昨日の公開にページが追いついていないからではありません。OpenAI は何世代も前から料金表に Cyber の行を置きながら、一度も数字を入れたことがありません。 この点は GPT-5.6-Cyber の料金解説 できちんと掘り下げました。
参考までに、ファミリーの他のモデルは標準ティアで 100 万トークンあたり通常どおり価格が付いています。
| モデル | 入力 | 出力 |
|---|---|---|
gpt-5.6-sol | $5.00 | $30.00 |
gpt-5.6-terra | $2.00 | $12.00 |
gpt-5.6-luna | $0.20 | $1.20 |
gpt-5.4-cyber | 未公表 | 未公表 |
Terra と Luna は 2026 年 7 月 30 日に、それぞれ 20% と 80% 値下げされています。多くの報道は今も公開当日の $2.50/$15 と $1/$6 を引用していますが、これらはすでに誤りです。GPT-5.6 の料金ガイド には、新しい短いコンテキストと長いコンテキストの区分を含む最新の数字があり、Sol の料金解説 ではフラッグシップを単独で掘り下げています。
アクセス制限が許容できず、今すぐ高性能なセキュリティツールが必要なら、それは別の問いで、きちんとした答えがあります。GPT-5.6-Cyber の代替 で検討しており、候補はほとんどの人の予想とは違います。
セキュリティチームでない場合、これは何を意味するか
GPT-5.6-Cyber の記事を読む人の大半は、Daybreak に申請しないでしょう。それでも、持ち帰れる教訓には価値があります。eesel でも繰り返し学び直していることと同じだからです。
高性能なモデルを出荷するうえで難しいのは、能力ではありませんでした。その周りの制御の仕組みです。 OpenAI がここで実際に作ったものを見てください。制限を外した 1 つのモデルではなく、階層の仕組み、本人確認、範囲の定義、自動レビューモード、モニタリング層、ハードウェアキーの義務化です。モデルは簡単な部分でした。
これは、モデル選びよりも AI エージェントとチャットボット の違いのほうが重要である理由であり、AI と人間のサポート がベンチマークのスコアで決まることがめったにない理由でもあります。
私は、この構図をテーブルの反対側から知っています。3 年間、実際のサポートキューに AI エージェントを導入してきて、商談が次々とデモではなく審査で決まるのを見てきました。デンマークのテレマティクス企業の購入担当者は、カード番号やパスワードを含むデータが自社の環境内に留まると納得するまで、チケットを 1 件も通しませんでした。ブリュッセルの月 400 から 500 件のチケットを扱うサポートチームは、社内の ISO 審査を通過することすらありませんでした。そのどの会話でも、AI が十分賢いかどうかを尋ねた人はいませんでした。
だからこそ、eesel は今の形で作りました。AI エージェント が実際の顧客に 1 件でも回答する前に、過去の数千件のチケットでシミュレーションし、何と答えたかを正確に確認できます。そのうえで、任せられるチケットの種類に絞り込めます。これは Daybreak のサンドボックスと範囲指定のガイダンスと同じ発想で、対象が V8 ヒープではなくサポートキューになっただけです。
類似点はまだ続きます。範囲を絞った権限は チャットボットのコンプライアンス の考え方であり、すべての操作を記録することが ヘルプデスクのセキュリティ審査 を乗り切れるものにし、その最も厳格な形は HIPAA 準拠の AI に現れます。どれもモデルの話ではありません。
eesel を試す
レッドチームではなくサポートチームを運営しているなら、モデルの階層より、その周りにあるものが重要です。eesel は既存のヘルプデスクにつながり、過去のチケットとヘルプセンターから学習し、顧客に近づく前に過去の会話で全体を予行演習できます。
どのチケットの種類を扱うかを選び、残りはエスカレーション するので、スイッチを入れる瞬間はありません。エージェントが行うツール操作はすべて記録され、機密性の高いものは人間の承認の後ろに置けます。これは自動レビューモードのサポートデスク版です。セットアップは審査サイクルではなく数分で済み、無料で試せます。
