Las 10 mejores alternativas a GPT-6.2 Astra en 2026, con precio por tarea

Kurnia Kharisma

Katelin Teen
Última edición 17 de noviembre de 2026
La mejor alternativa a GPT-6.2 Astra para la mayoría de equipos es el propio GPT-6.2 Sol de OpenAI: obtiene 57 frente al 62 de Astra en Artificial Analysis, a aproximadamente un cuarto del costo por tarea. Solo Claude Fable 5.2 puntúa más alto (65), a 6.6 veces el costo por tarea de Astra. La trampa está en el precio de lista: Claude Opus 5.5 cobra la mitad de la tarifa por token de Astra, pero costó 2.5 veces más por tarea de referencia con el máximo esfuerzo. Evalúa las alternativas por el costo por tarea terminada, y enruta en lugar de cambiar por completo. Para una cola de soporte, el conocimiento y las reglas de escalamiento alrededor del modelo importan más, que es justo lo que aporta el compañero de IA para el helpdesk de eesel.
¿Por qué los equipos miran más allá de GPT-6.2 Astra?
GPT-6.2 Astra se lanzó el 17 de noviembre de 2026, y es un modelo potente. Artificial Analysis lo sitúa en 62 en su Intelligence Index, solo detrás de Claude Fable 5.2, y OpenAI bajó el precio un 20% a $8 por millón de tokens de entrada y $40 por millón de salida en su página de precios de la API. El input en caché bajó de $1.00 a $0.40. Si tus agentes hacen trabajo difícil de varios pasos, Astra se gana su lugar.
Entonces, ¿por qué buscar en otro lado? Aparecen tres razones una y otra vez.
- La mayoría de las tareas no lo necesitan. En mi propia prueba de 15 tickets de soporte en tres niveles de esfuerzo, GPT-6.2 Sol respondió bien a todos los tickets a aproximadamente un cuarto del costo de Astra. Más sobre esto abajo.
- Las ejecuciones largas son más difíciles de leer. Varios probadores conocidos elogiaron el resultado de Astra pero no disfrutaron trabajar con él en ejecuciones largas y abiertas. Mi análisis de GPT-6.2 Astra revisa esas quejas.
- Un solo proveedor es un punto único de falla. Los equipos que construyen productos con agentes quieren un respaldo probado de un segundo laboratorio, por si hay cambios de precio, caídas o límites de tasa.
"I care less about the models being good and more on if I can fallback to them if Opus 5.5 gets a massive price hike after the IPO"

Escribo sobre lo que buscan realmente los compradores, y la búsqueda aquí es revelador. Cuando le hice a ChatGPT exactamente esta pregunta en un chat nuevo, fue directo a los documentos del modelo y las páginas de precios de cada laboratorio, y enmarcó toda la respuesta alrededor de un número: el costo por tarea exitosa. Ese es el enfoque correcto, y es el que usé a continuación. Si tus agentes responden tickets de soporte, el CLI de eesel permite que un agente de código cargue artículos de ayuda aprobados en un compañero de eesel y pruebe sus respuestas antes de elegir nada.
Cómo comparé las alternativas
Evalué cada modelo en tres aspectos, todos revisados el 18 de noviembre de 2026.
- Precio de lista de la propia página de precios de cada proveedor, por millón de tokens de entrada y salida, más la tarifa de entrada en caché, ya que los agentes que reenvían un prompt de sistema largo viven de los tokens en caché.
- Inteligencia y costo por tarea de Artificial Analysis, que ejecuta las mismas nueve evaluaciones en cada modelo y reporta lo que costó cada tarea terminada en el ajuste de esfuerzo más alto de ese modelo. Ese número incluye cuántos tokens consume un modelo, algo que el precio de lista esconde.
- Mi propia prueba de soporte. Repetí el banco de pruebas de 15 tickets de mi análisis de GPT-6.2 Astra en Astra y Sol con esfuerzo bajo, medio y alto: 90 ejecuciones que cubren matemáticas de reembolso, un cargo duplicado, una inyección de prompt, tickets en español y alemán, una búsqueda de pedido rota y un número de pedido mal escrito. Solo tuve acceso de API a OpenAI para esta ejecución, así que los demás laboratorios se evalúan con datos del proveedor y de benchmarks.
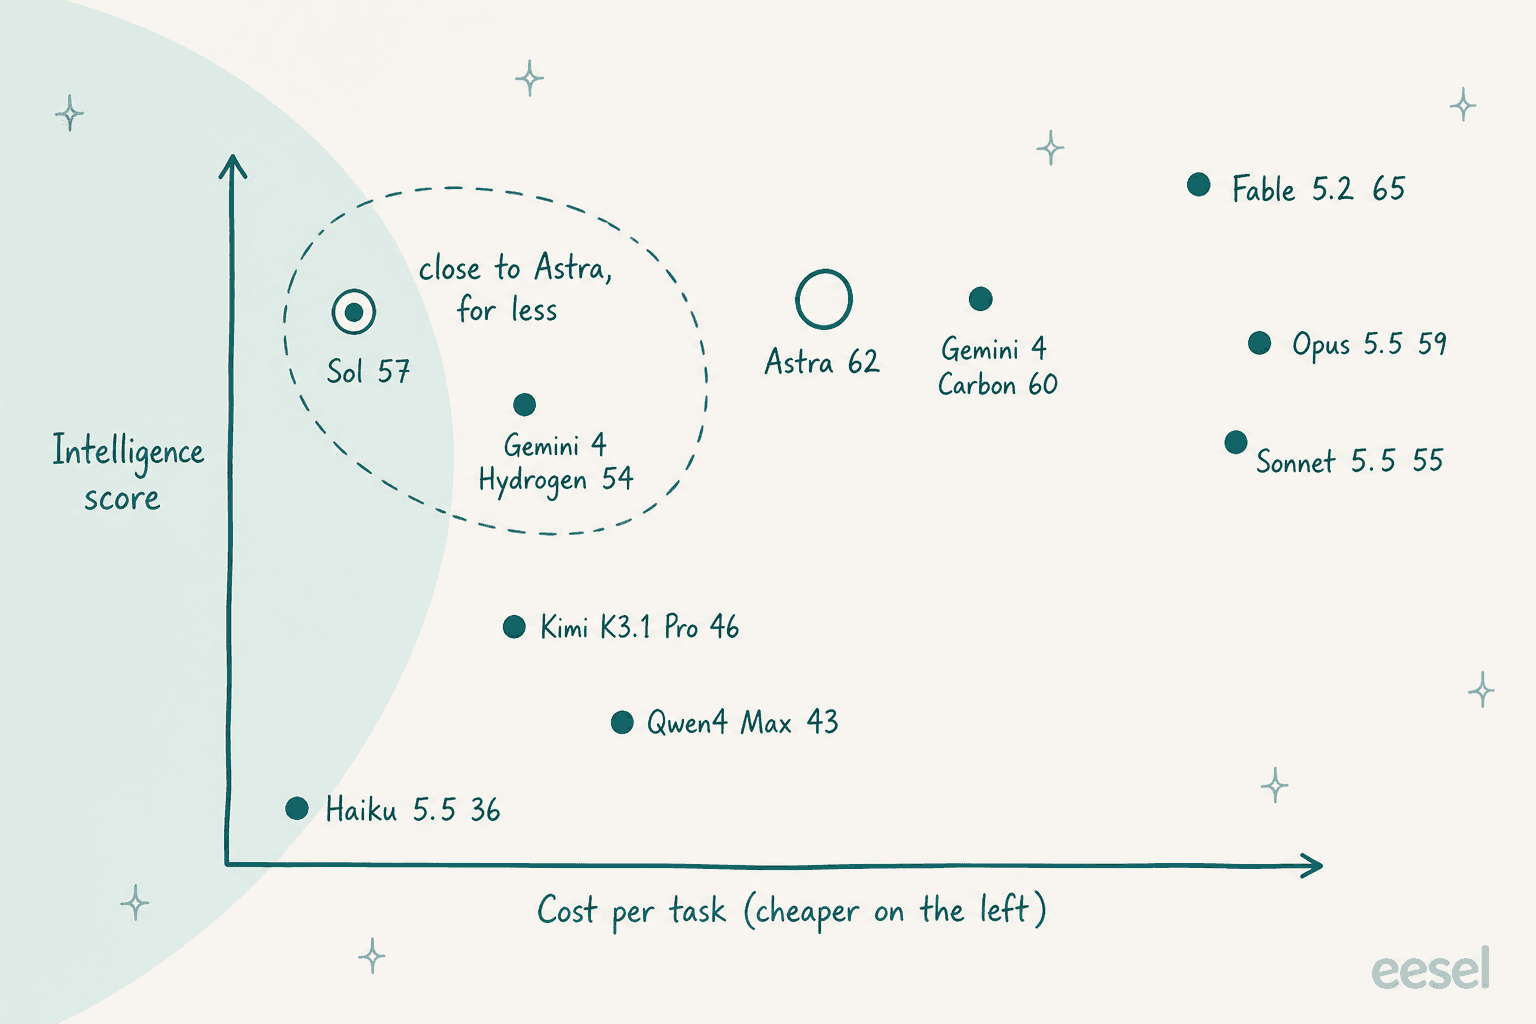
El gráfico es el artículo en una sola imagen. Astra está alto y en el medio. Fable 5.2 es el único modelo por encima, mucho más a la derecha. Sol está casi igual de alto, mucho más a la izquierda.
Alternativas a GPT-6.2 Astra de un vistazo
Los precios son por millón de tokens a tarifas estándar. Los puntajes y costos de Artificial Analysis corresponden al ajuste de esfuerzo más alto de cada modelo.
| Modelo | Fabricante | Entrada / salida | Entrada en caché | Contexto | Puntaje AA | Costo AA por tarea | Tiempo por tarea AA | Mejor para |
|---|---|---|---|---|---|---|---|---|
| GPT-6.2 Astra (base) | OpenAI | $8 / $40 | $0.40 | 1.05M | 62 | $4.00 | 10.4 min | Trabajo difícil de varios pasos con agentes |
| GPT-6.2 Sol | OpenAI | $2 / $10 | $0.10 | 1.05M | 57 | $1.01 | 7.9 min | La mayoría del tráfico de agentes en producción |
| Claude Opus 5.5 | Anthropic | $4 / $20 | $0.20 | 1M | 59 | $10.04 | 24.6 min | Trabajo largo de código y escritura |
| Claude Fable 5.2 | Anthropic | $8 / $40 | $0.20 | 1M | 65 | $26.54 | 40.8 min | El puntaje más alto disponible |
| Claude Sonnet 5.5 | Anthropic | $2 / $10 | $0.10 | 1M | 55 | $10.02 | 32.3 min | Anthropic al precio de Sol |
| Gemini 4 Carbon | $2 / $10 hasta el 30 nov., luego $4 / $20 | $0.10, luego $0.20 | 1M | 60 | $5.48 | 33.4 min | Puntaje casi igual a Astra, segundo proveedor | |
| Gemini 3.8 Flash | $0.75 / $3.75 hasta el 31 dic. | $0.075 | - | 31 | - | 14.1 min | Pasos baratos de alto volumen | |
| Grok 4.7 | xAI | $2 / $6 | $0.50 | 500K | 35 | - | 24.5 min | Bucles de agentes con salida larga |
| DeepSeek V4 Pro y Flash | DeepSeek | $0.66 / $1.98 (Pro, fuera de hora pico) | $0.022 | 1M | 23 (Pro) | $1.77 (Pro) | 17.3 min | La factura de tokens más baja |
| Kimi K3.1 Pro | Moonshot AI | $2 / $10 | $0.20 | 1M | 46 | $3.68 | 38.7 min | Opción no estadounidense al precio de Sol |
| Qwen4 Max | Alibaba (Qwen Cloud) | $1.50 / $4.50 | $0.075 | 1M | 43 | $3.27 | 31.9 min | Precio de salida bajo a gran escala |
Dos líneas para leer antes de la lista. El precio de Gemini 4 Carbon se duplica el 1 de diciembre, así que presupuesta con la tarifa posterior. Y los precios de DeepSeek se duplican durante las horas pico de los días laborables, lo cual cubro en su sección.
¿La mitad del precio por token significa la mitad de la factura?
No, y aquí es donde la mayoría de las comparaciones se equivocan. El precio por token de un modelo te dice lo que cuesta un token. No te dice cuántos tokens gasta el modelo en terminar una tarea, ni cuánto tiempo piensa antes.
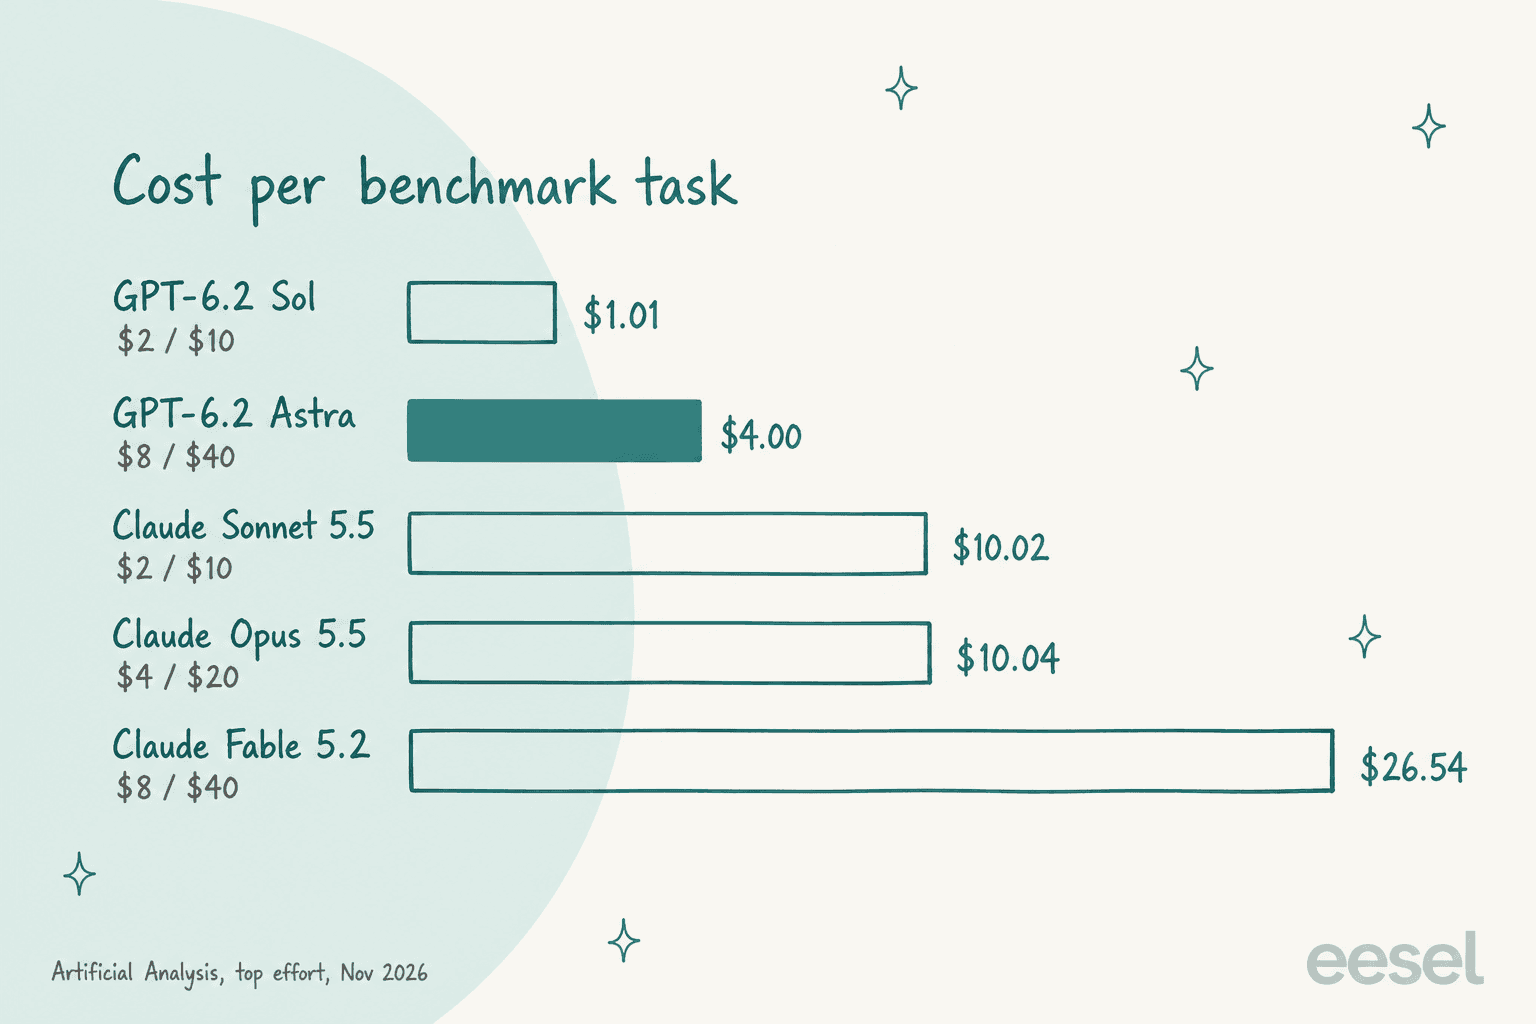
Claude Opus 5.5 cobra la mitad de la tarifa por token de Astra, $4/$20 frente a $8/$40, pero Artificial Analysis lo midió en $10.04 por tarea frente a los $4.00 de Astra. Sonnet 5.5 tiene el mismo precio por token que Sol y costó diez veces más por tarea. La razón aparece en la columna de tiempo: Opus tardó 24.6 minutos por tarea y Sonnet 32.3 minutos con el máximo esfuerzo, frente a los 10.4 de Astra. Más pensamiento significa más tokens de salida, y la salida es el lado caro de cualquier tarjeta de precios.
Dos salvedades mantienen esto justo. Artificial Analysis ejecuta cada modelo con su máximo esfuerzo, y la visión general de modelos de Anthropic envía Opus 5.5 con esfuerzo medio por defecto, así que tu factura con los ajustes predeterminados será más baja que la cifra del benchmark. Y una tarea de benchmark no es tu tarea. Trata el costo por tarea como una advertencia de dirección, y luego mide con tu propio trabajo.
Un comentarista de HN puso números reales a la misma idea desde su propio uso en programación:
"Opus cost me about $1 in tokens per task while Haiku costs about 4.6 cents and Luna is about 2.5 cents."
1. GPT-6.2 Sol
Mejor para: equipos que quieren seguir con OpenAI y recortar la factura en alrededor de un 75%.
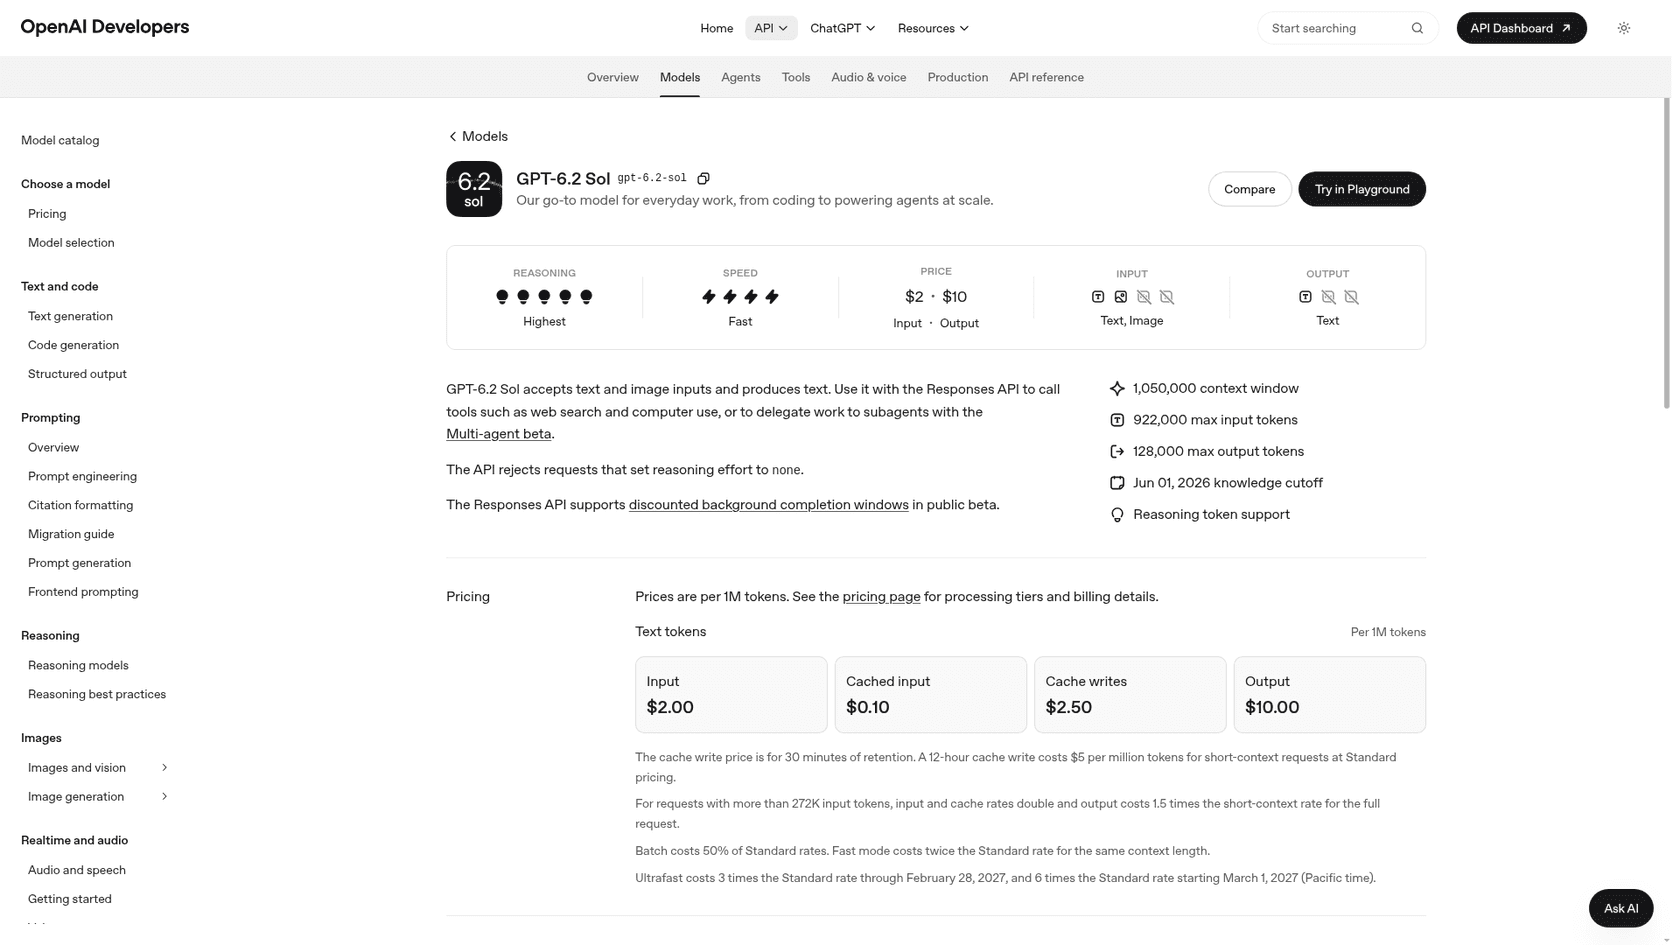
GPT-6.2 Sol se lanzó junto con Astra y usa la misma API, las mismas herramientas y la misma ventana de contexto de 1,050,000 tokens, con 922,000 tokens de entrada y 128,000 de salida. Cambiar el nombre del modelo es toda la migración. Artificial Analysis lo puntúa en 57, al nivel de GPT-6 Astra de la generación anterior, a aproximadamente un 15% del costo por tarea de ese modelo.
En mi prueba fue donde Sol se ganó el primer lugar. A lo largo de 45 ejecuciones con esfuerzo bajo, medio y alto, respondió correctamente a todos los tickets: el reembolso prorrateado salió en $990 todas las veces, la inyección de prompt recibió un no educado, la búsqueda rota se escaló, y los clientes en español y alemán recibieron respuestas en su propio idioma. Astra hizo lo mismo.
| Mi prueba, 15 tickets | Costo por 1,000 tickets | Tiempo medio de respuesta |
|---|---|---|
| GPT-6.2 Astra, bajo / medio / alto | $5.75 / $5.79 / $6.57 | 5.4s / 3.3s / 4.5s |
| GPT-6.2 Sol, bajo / medio / alto | $1.42 / $1.40 / $1.54 | 2.5s / 2.5s / 2.8s |
Las mismas respuestas, a aproximadamente un cuarto del precio, y más rápido. El esfuerzo apenas movió el costo en tickets de esta longitud, algo que vale la pena saber antes de pagar por esfuerzo alto por defecto.
"For just doing things or coding things up, Sol all the way."
Ventajas
- $2/$10 por millón de tokens, con entrada en caché a $0.10
- Misma API, herramientas y ventana de contexto que Astra, así que el cambio es modificar una línea
- Igualó a Astra en los 15 tickets de mi prueba de soporte, en todos los niveles de esfuerzo
Desventajas
- Artificial Analysis dice que perdió 3 puntos en su Coding Agent Index frente a GPT-6.1 Sol, principalmente por omitir datos clave en las respuestas
- En bases de código grandes, algunos desarrolladores siguen enviando el trabajo de Sol de vuelta a Astra para limpiarlo
- La API rechaza el esfuerzo de razonamiento
none
Precios: $2 de entrada, $0.10 en caché, $10 de salida por millón de tokens en el nivel estándar, según la página de precios de OpenAI. El modo por lotes lo reduce a la mitad. La guía precios de la API de OpenAI cubre los niveles.
Veredicto: empieza aquí. Haz de Sol tu opción por defecto y guarda Astra para las tareas en las que Sol falle de forma visible. El análisis de GPT-6.1 Sol cubre la versión anterior si hoy estás en ella.
2. Claude Opus 5.5
Mejor para: trabajo largo de código y escritura donde las explicaciones claras importan más que la velocidad bruta.
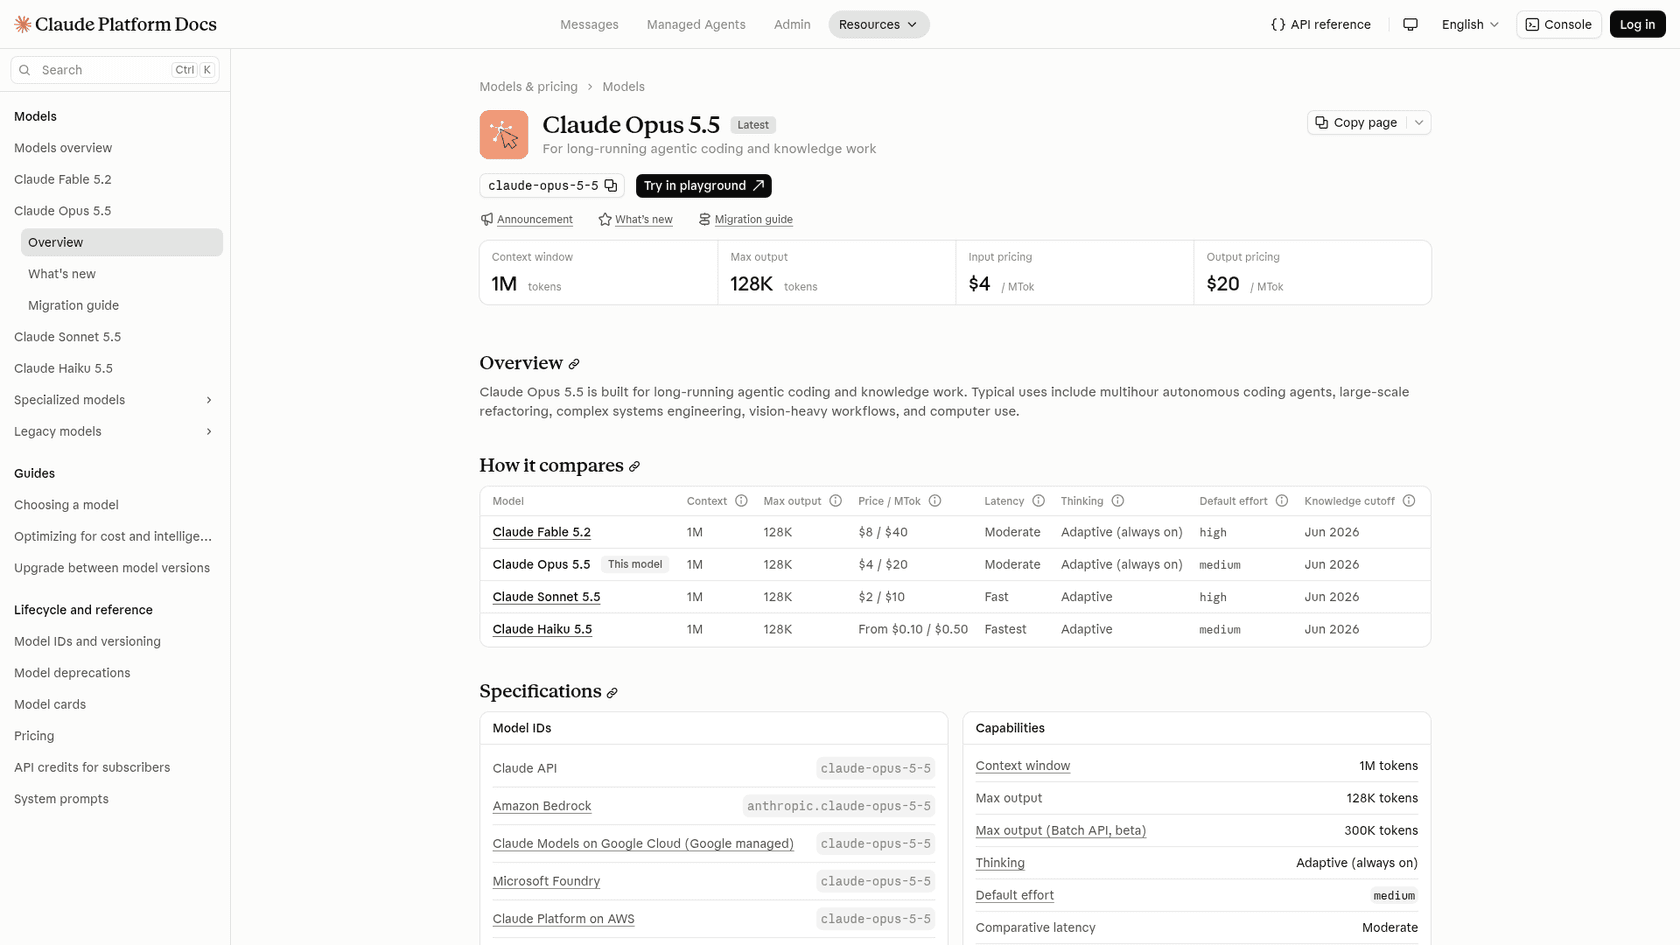
Claude Opus 5.5 es el modelo que Anthropic recomienda a la mayoría de desarrolladores para empezar. Su documentación lo describe como construido "for long-running agentic coding and knowledge work", con una ventana de contexto de 1M tokens, 128K de salida y esfuerzo medio por defecto. Obtiene 59 en Artificial Analysis, tres puntos por debajo de Astra.
El argumento a su favor no es el puntaje. Es cómo comunica. La queja más fuerte sobre Astra es que sus resúmenes de ejecuciones largas son difíciles de seguir, y Opus es a lo que recurren varios probadores para resolver eso.
"I've already built the habit of switching to opus 5.5 at the end of a long 6.2 Astra run, just to get a readable summary of what it said."
Ventajas
- La mitad del precio por token de Astra, a $4/$20, con lecturas de caché a $0.20
- Los probadores prefieren constantemente sus explicaciones y planificación en tareas largas
- El modo rápido ofrece hasta 2.5x la velocidad de salida con un recargo, según la documentación de precios de Anthropic
Desventajas
- $10.04 por tarea de referencia con el máximo esfuerzo, 2.5 veces la cifra de Astra
- 24.6 minutos por tarea con el máximo esfuerzo, más del doble del tiempo de Astra
- Algunos desarrolladores todavía encuentran que su prosa necesita una segunda revisión
Precios: $4 de entrada, $20 de salida, $0.20 lecturas de caché, $5 por escrituras de caché de 5 minutos. La guía precios de Claude Opus 5.5 desglosa el resto.
Veredicto: la mejor opción como segundo proveedor para quienes leen el resultado del agente. Ejecútalo en esfuerzo medio, no máximo, y revisa la factura por tarea antes de asumir que el precio por token más bajo se traslada. Mi análisis de Claude Opus 5.5 tiene el análisis más largo.
3. Claude Fable 5.2
Mejor para: la rara tarea donde el puntaje más alto importa más que la factura.
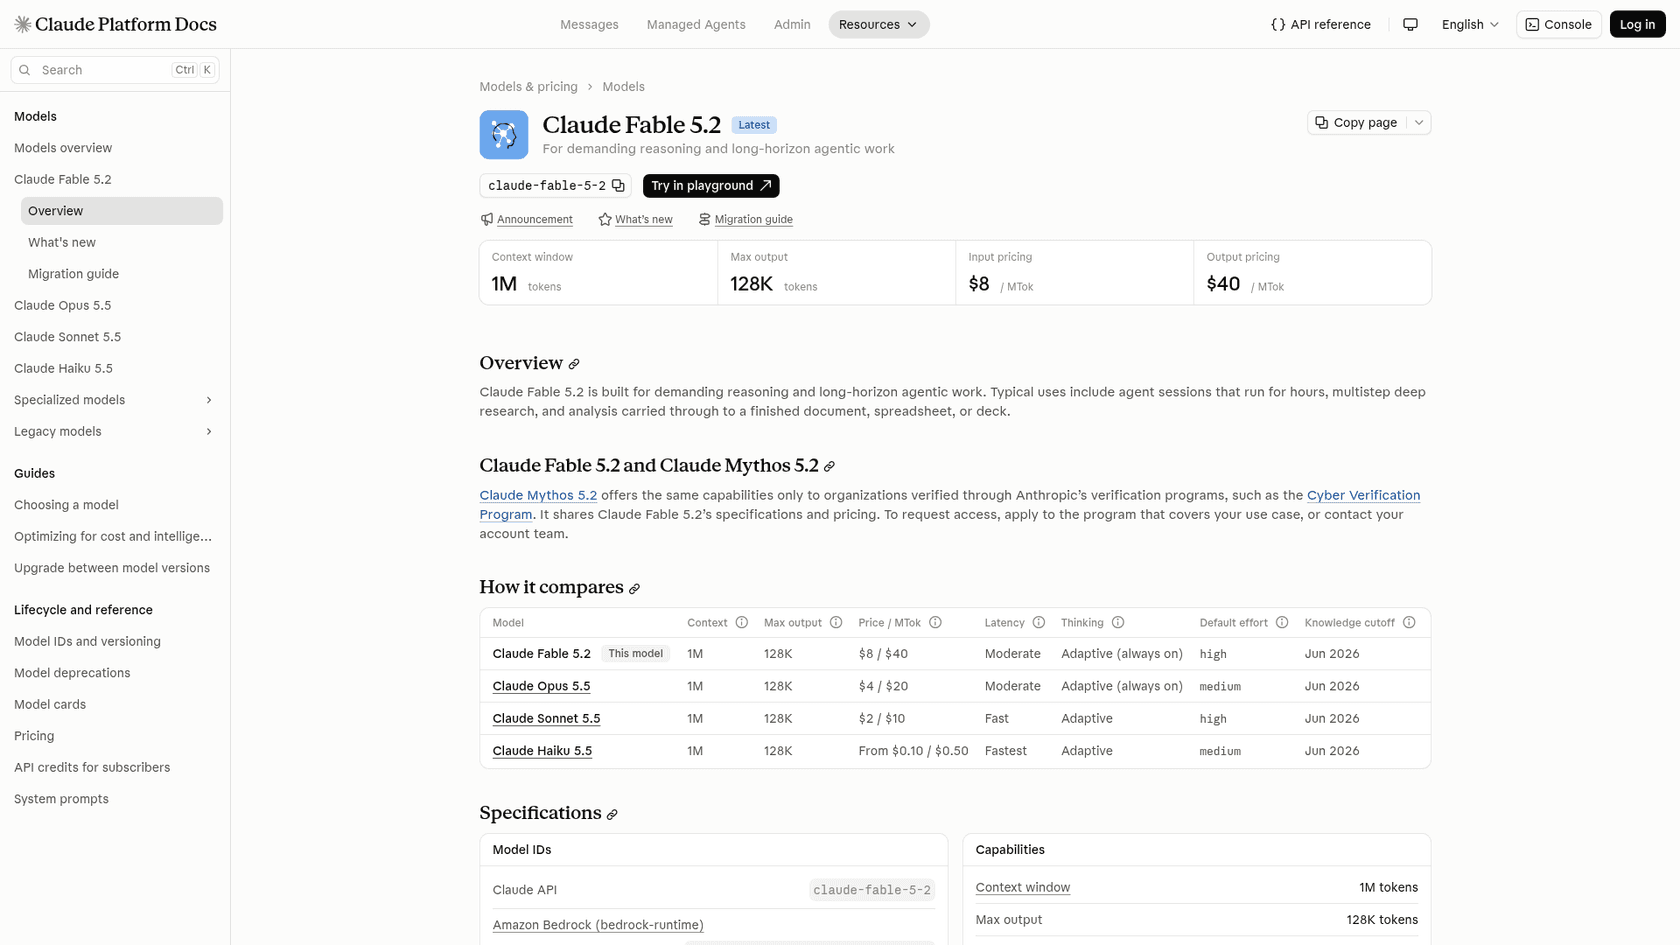
Claude Fable 5.2 es el único modelo de esta lista que supera a Astra en puntaje: 65 frente a 62 en el Artificial Analysis Intelligence Index. Tiene el mismo precio de lista de $8/$40 que Astra, y sus lecturas de caché cuestan la mitad, a $0.20 frente a $0.40. Anthropic lo describe como construido "for demanding reasoning and long-horizon agentic work".
Entonces llega la factura por tarea. Artificial Analysis midió a Fable 5.2 en $26.54 por tarea y 40.8 minutos, frente a los $4.00 y 10.4 minutos de Astra. Mismo precio por token, 6.6 veces el costo por tarea. Un comentarista de HN resumió el lado de Astra en este intercambio:
"Second place at a sixth the price and in a quarter of the time (both according to Artificial Analysis for Astra 6.2 vs. Fable 5.2, both max effort) definitely has a place."
Otros opinaron lo contrario tras semanas de pruebas:
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
Ventajas
- El puntaje más alto de Artificial Analysis de cualquier modelo, con 65
- Mismo precio por token que Astra, con lecturas de caché más baratas
- Fuertes reseñas de probadores en diseño y tareas largas con agentes
Desventajas
- $26.54 por tarea de referencia, el modelo más caro aquí por un amplio margen
- 40.8 minutos por tarea, el más lento de la lista
- El pensamiento siempre está activado, así que no puedes bajarlo a un modo sin razonamiento
Precios: $8 de entrada, $40 de salida, $0.20 lecturas de caché, $10 por escrituras de caché de 5 minutos. El modo por lotes es la mitad. La guía precios de Claude Fable 5.2 cubre el modo rápido.
Veredicto: una mejora, no una alternativa. Úsalo para las pocas tareas en las que Astra se equivoca, y espera que la factura lo demuestre. El análisis de Claude Fable 5.2 tiene el detalle.
4. Claude Sonnet 5.5
Mejor para: equipos que quieren el estilo de Anthropic al precio de Sol.
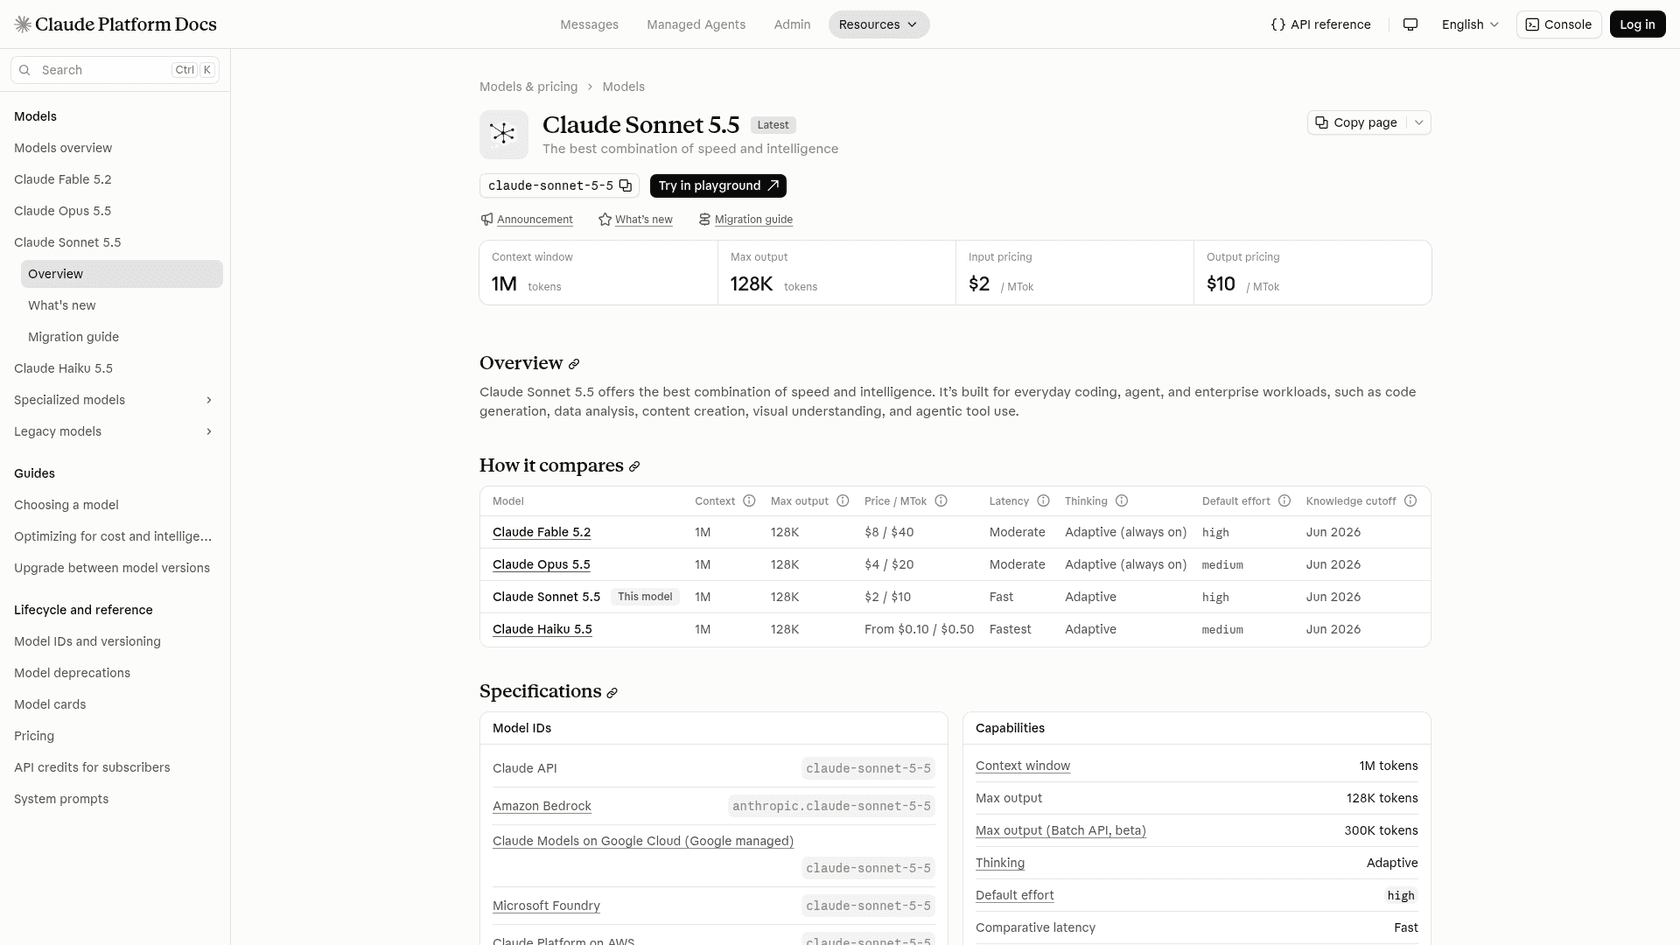
Claude Sonnet 5.5 es lo que Anthropic llama "the best combination of speed and intelligence". Cuesta $2/$10, igual que Sol, con lecturas de caché a $0.10 y un contexto de 1M. A diferencia de Opus y Fable, su pensamiento es adaptativo en vez de estar siempre activado, y el esfuerzo por defecto es alto.
En Artificial Analysis obtiene 55 con el máximo esfuerzo, con un costo por tarea de $10.02 y 32.3 minutos por tarea. Esa es la misma trampa de costo por tarea que Opus, y aquí pesa más, ya que Sol puntúa dos puntos más alto por una décima parte del costo por tarea. La solución es la misma: ejecútalo por debajo del máximo esfuerzo y mide.
Ventajas
- $2/$10 con $0.10 de lecturas de caché, igual que Sol
- Pensamiento adaptativo, así que las solicitudes simples no pagan por un pensamiento largo
- Mismo contexto de 1M y salida de 128K que Opus
Desventajas
- $10.02 por tarea de referencia con el máximo esfuerzo, diez veces la cifra de Sol
- 55 en Artificial Analysis, por debajo del 57 de Sol
- El esfuerzo por defecto es alto, así que el ajuste caro es el predeterminado
Precios: $2 de entrada, $10 de salida, $0.10 lecturas de caché, $2.50 por escrituras de caché de 5 minutos, según los precios de Anthropic. Ver la guía precios de Claude Sonnet 5.5.
Veredicto: elígelo sobre Sol solo si ya trabajas con Anthropic o prefieres su escritura, y fija el nivel de esfuerzo tú mismo. Mi análisis de Claude Sonnet 5.5 cubre los cambios que rompen compatibilidad.
5. Gemini 4 Carbon
Mejor para: un puntaje casi igual a Astra de un segundo proveedor, si presupuestas al precio de diciembre.
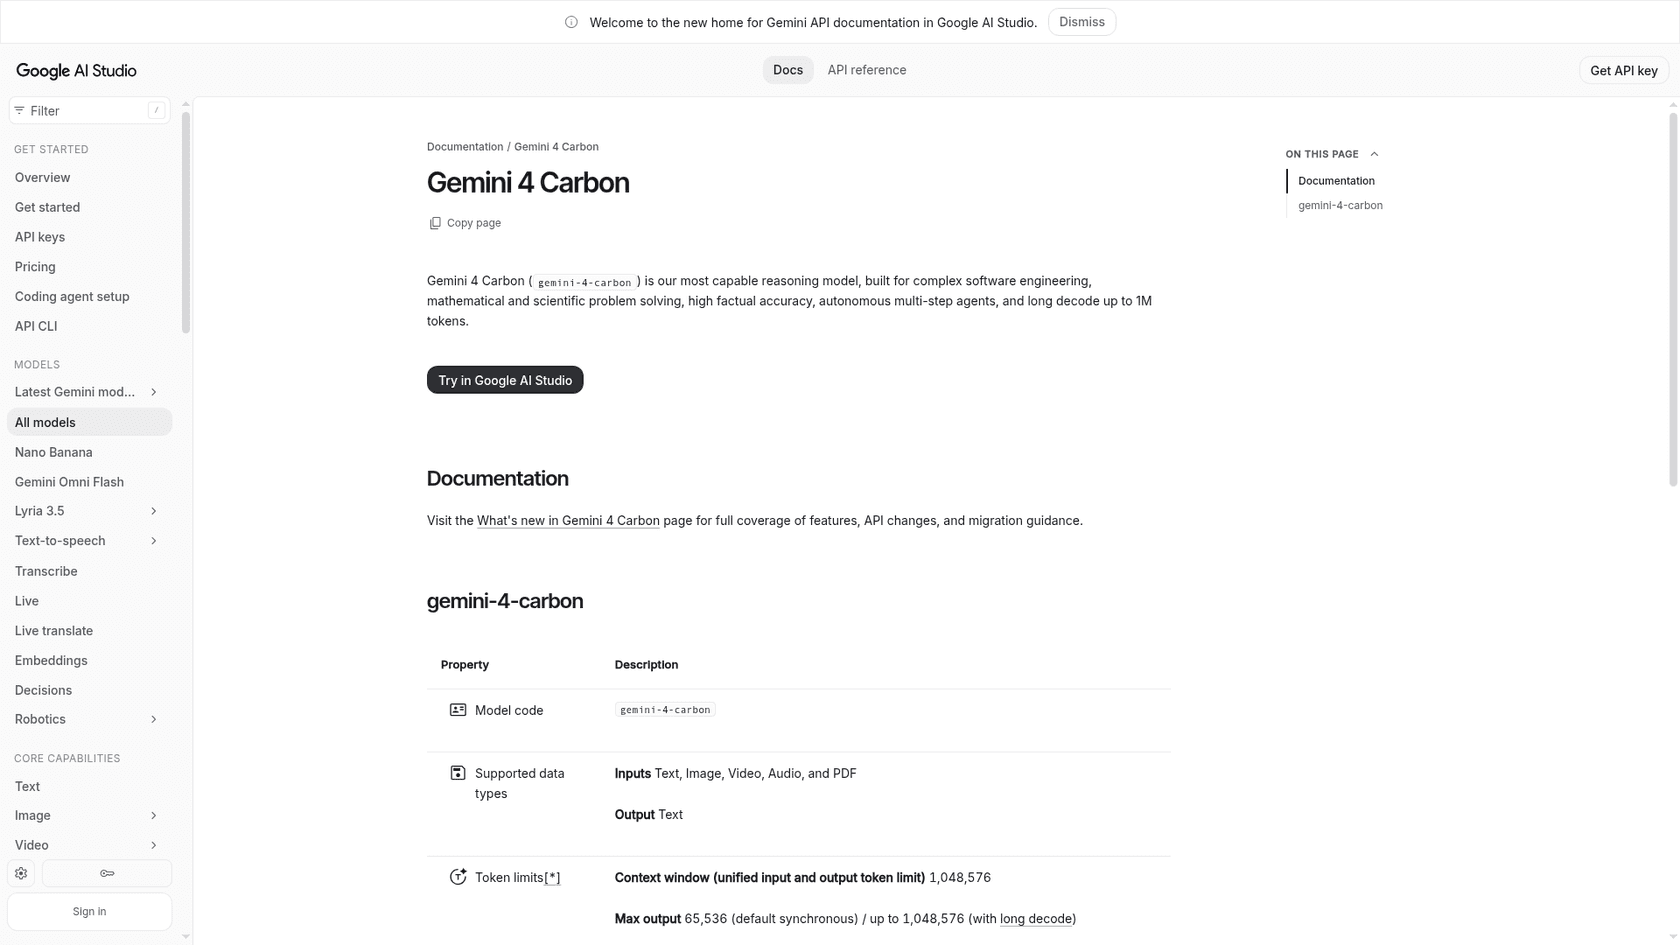
Gemini 4 Carbon es el modelo de razonamiento más capaz de Google, y obtiene 60 en Artificial Analysis, dos puntos por debajo de Astra y uno por encima de Opus 5.5. Su costo por tarea es de $5.48, el más cercano a Astra que logra cualquier modelo que no sea de OpenAI en ambos ejes a la vez. Acepta texto, imágenes, video, audio y PDF, con un contexto de 1,048,576 tokens y hasta 1M tokens de salida mediante decodificación larga.
Vigila el calendario. La página de precios de Google lista a Carbon en $2/$10 hasta el 30 de noviembre de 2026, y luego $4/$20 a partir del 1 de diciembre. El caching solo funciona de forma implícita, y no hay nivel gratuito para Carbon.
Si el precio de Carbon es demasiado alto, Gemini 4 Hydrogen de Google es el hermano más barato: $1.50/$7.50, un nivel gratuito y un puntaje de 54 a $3.16 por tarea. Y un desarrollador en HN encontró una razón distinta para fijarse en la familia:
"My favorite model for this at the moment is Gemini 4 Argon, which writes very naturally and isn't too expensive."
Ventajas
- 60 en Artificial Analysis a $5.48 por tarea, el mejor equilibrio no-OpenAI de esta lista
- Acepta video, audio y PDF además de texto e imágenes
- Hasta 1M tokens de salida con decodificación larga
Desventajas
- El precio se duplica a $4/$20 el 1 de diciembre de 2026
- 33.4 minutos por tarea de referencia, más de tres veces el tiempo de Astra
- Solo caching implícito, y sin nivel gratuito
Precios: $2/$10 y $0.10 de caching hasta el 30 de noviembre, luego $4/$20 y $0.20. El grounding de búsqueda es gratis para 5,000 solicitudes al mes, luego $14 por 1,000. La guía precios de Gemini 4 Carbon tiene los niveles por lotes y flex.
Veredicto: la opción más fuerte como segundo proveedor si necesitas una inteligencia cercana a Astra. Presupuesta a $4/$20 desde el primer día para que diciembre no te sorprenda. Mi análisis de Gemini 4 Carbon cubre los benchmarks.
6. Gemini 3.8 Flash
Mejor para: pasos baratos de alto volumen como clasificación, extracción y primeros borradores.
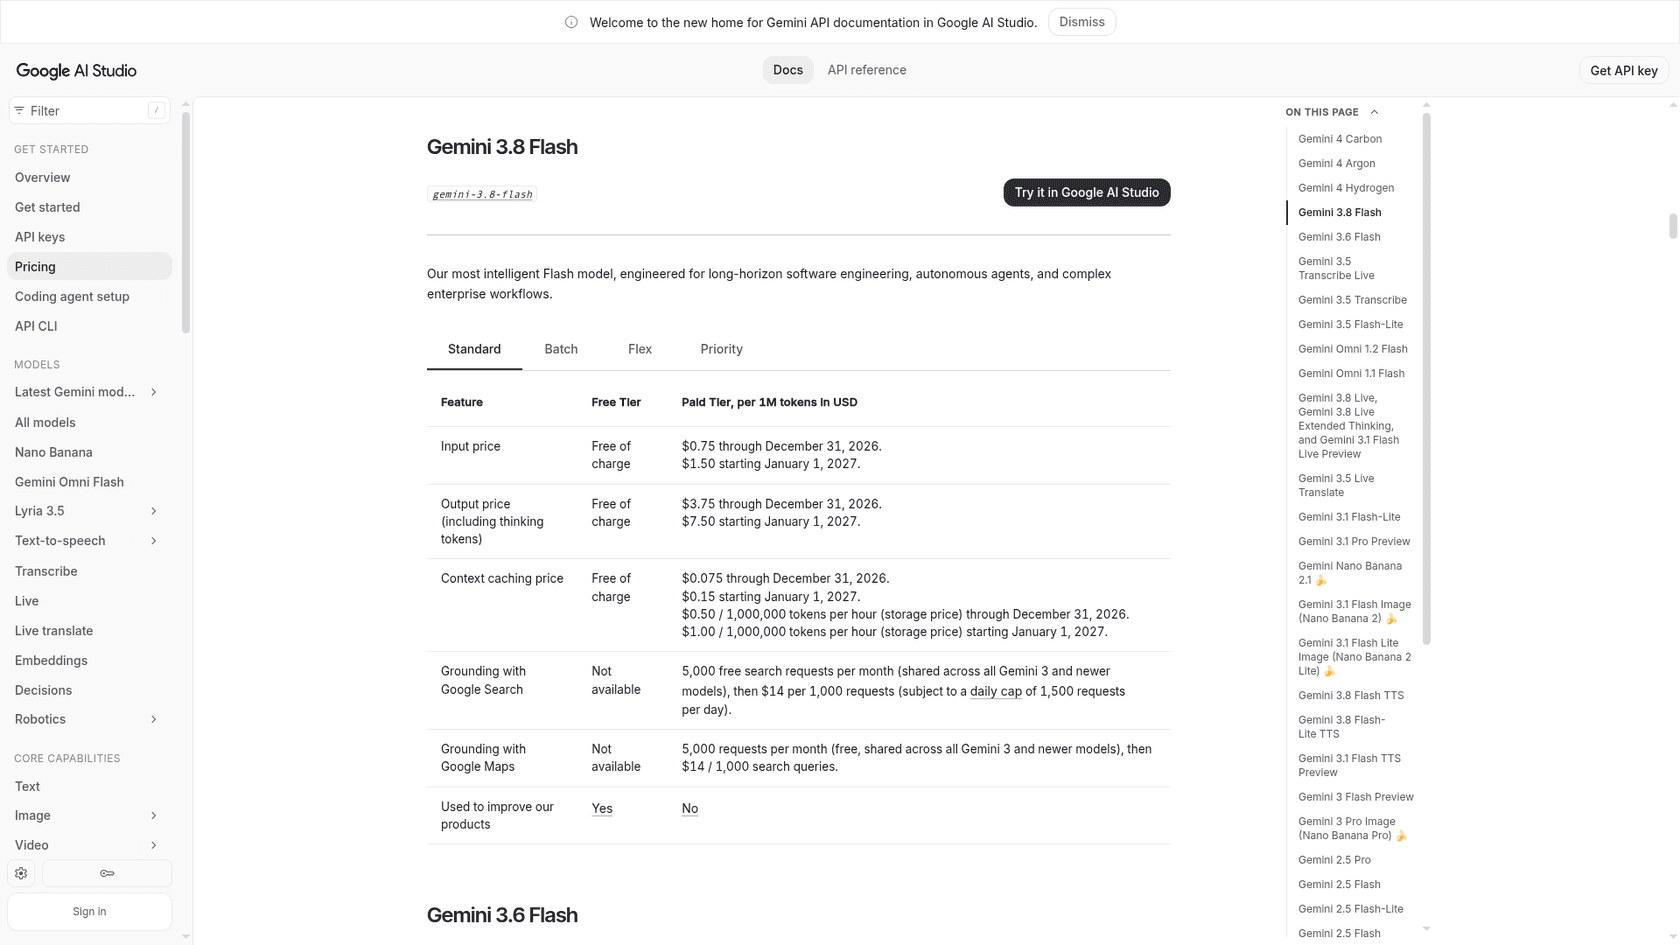
Google describe a Gemini 3.8 Flash como su modelo Flash más inteligente, "engineered for long-horizon software engineering, autonomous agents, and complex enterprise workflows". ChatGPT lo puso cerca de la cima de su propia lista de alternativas a Astra, por el precio: $0.75/$3.75 por millón de tokens, aproximadamente un décimo del de Astra.
El puntaje es la otra mitad de la historia. Se sitúa en 31 en el Artificial Analysis Intelligence Index, la mitad del 62 de Astra. Eso no es un reemplazo para las tareas difíciles de Astra. Es un modelo para el carril barato de un sistema enrutado, donde la tarea es pequeña y está claramente definida.
Ventajas
- $0.75/$3.75, aproximadamente un décimo del precio por token de Astra
- Nivel gratuito para pruebas
- Entrada en caché a $0.075
Desventajas
- 31 en Artificial Analysis, el segundo puntaje más bajo de esta lista
- El precio se duplica a $1.50/$7.50 el 1 de enero de 2027
- 14.1 minutos por tarea de referencia, más lento que Astra a pesar de ser un modelo Flash
Precios: $0.75 de entrada, $3.75 de salida, $0.075 de caching hasta el 31 de diciembre de 2026, según la página de precios de Google. La guía precios de Gemini 3.8 Flash cubre el salto de 2027.
Veredicto: una herramienta de enrutamiento, no un reemplazo. Úsalo para la parte sencilla de tu tráfico y mantén un modelo más fuerte para lo que necesite criterio. La lista alternativas a Gemini 3.8 Flash tiene opciones en la misma banda de precio.
7. Grok 4.7
Mejor para: bucles largos de agentes donde el volumen de salida haría que Astra resultara caro.
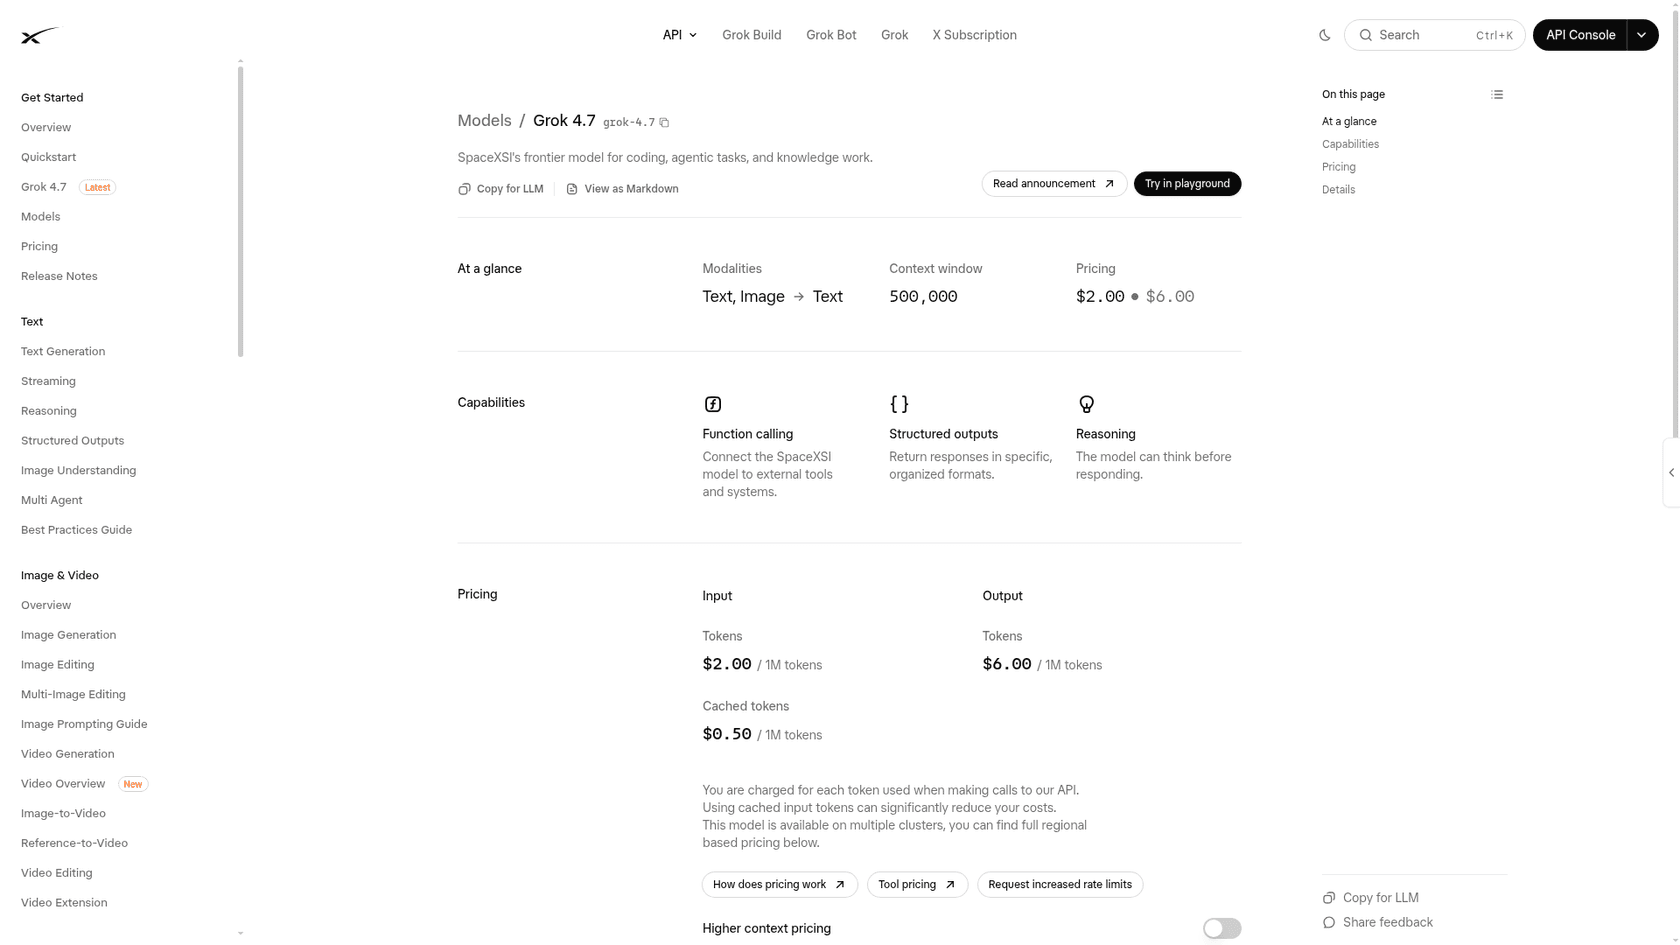
Grok 4.7 cobra $6 por millón de tokens de salida, frente a los $40 de Astra y los $10 de Sol. La entrada cuesta $2 con entrada en caché a $0.50, y la ventana de contexto es de 500K tokens. xAI también soporta function calling, salidas estructuradas y razonamiento en el modelo.
Su puntaje de Artificial Analysis es 35 con esfuerzo xhigh, y tardó 24.5 minutos por tarea de referencia. Eso lo pone muy por debajo de Astra en el índice general. Los propios benchmarks de lanzamiento de xAI cuentan una historia más ajustada, con Grok 4.7 puntuando 64.0 en EEBench frente al 56.4 de Claude Fable 5.1, así que pruébalo en tu propio bucle antes de descartarlo. El análisis de Grok 4.7 tiene más detalles.
Ventajas
- $6 por millón de tokens de salida, menos de un sexto del de Astra
- Ventana de contexto de 500K
- Function calling nativo y salidas estructuradas
Desventajas
- 35 en Artificial Analysis, muy por debajo del 62 de Astra
- Los prompts de 200K tokens o más se facturan a $4/$12
- Las herramientas del lado del servidor como la búsqueda web añaden $5 por 1,000 llamadas
Precios: $2 de entrada, $0.50 en caché, $6 de salida por debajo de 200K tokens, según la página de precios de xAI. La guía precios de Grok 4.7 cubre las tarifas de herramientas.
Veredicto: vale la pena probarlo si los tokens de salida dominan tu factura. No lo elijas solo por el puntaje del índice, en ninguna dirección. El artículo alternativas a Grok 4.7 lo compara con el resto de su banda de precio.
8. DeepSeek V4 Pro y Flash
Mejor para: la factura de tokens más baja, si tu carga de trabajo cabe en horas fuera de pico y es de texto.
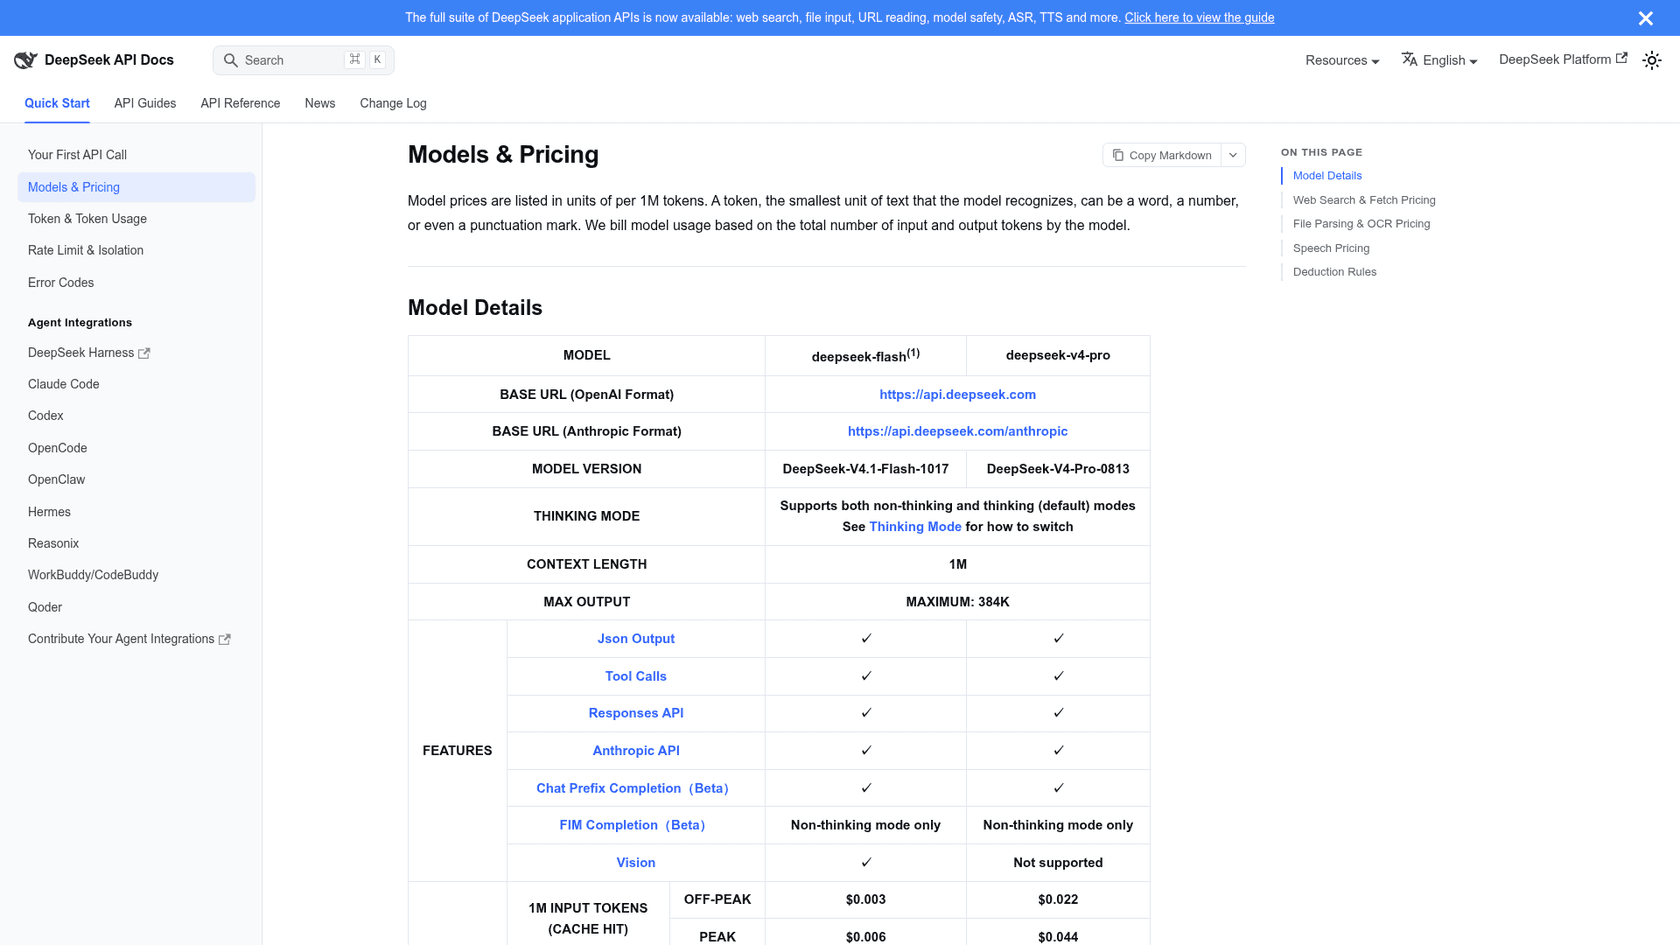
DeepSeek vende dos modelos a través de una API compatible con OpenAI, y también acepta el formato de API de Anthropic. deepseek-flash ahora da servicio a DeepSeek V4.1 Flash a $0.15 de entrada y $0.60 de salida fuera de hora pico. deepseek-v4-pro cuesta $0.66/$1.98 fuera de hora pico. Ambos tienen un contexto de 1M, hasta 384K de salida, llamadas a herramientas y salida en JSON.
El truco está en el reloj. DeepSeek cobra el doble en horas pico de días laborables, de 01:00 a 04:00 y de 06:00 a 10:00 UTC, así que Pro pasa a $1.32/$3.96 y Flash a $0.30/$1.20. Los aciertos de caché son casi gratis, de $0.003 a $0.044 por millón.
En Artificial Analysis, V4 Pro obtiene 23 con el máximo esfuerzo, a $1.77 por tarea. Eso está muy por debajo de cualquier otro modelo aquí, así que trata a DeepSeek como una jugada de costo para trabajo bien definido. Flash tiene sus fans justamente por eso:
"I used Luna Max a lot, until Deepseek 1017. Then never again."
Ventajas
- Flash a $0.15/$0.60 fuera de hora pico es el modelo capaz más barato de esta lista
- Acepta los formatos de API tanto de OpenAI como de Anthropic
- Contexto de 1M y hasta 384K de salida
Desventajas
- Los precios se duplican en horas pico de días laborables (UTC)
- V4 Pro obtiene 23 en Artificial Analysis, el más bajo aquí
- V4 Pro no soporta visión, y la concurrencia está limitada a 500 solicitudes
Precios: por millón de tokens fuera de hora pico, Flash $0.15/$0.60, Pro $0.66/$1.98; en hora pico es el doble. La búsqueda web y el fetch cuestan $0.75 por 1,000 llamadas. La guía precios de DeepSeek V4.1 Flash explica el horario pico.
Veredicto: un carril barato sólido para trabajo de solo texto y alto volumen, programado fuera de hora pico si puedes. No es un sustituto para las tareas difíciles de Astra. Ver V4 Flash frente a V4 Pro para elegir entre ambos.
9. Kimi K3.1 Pro
Mejor para: una opción de frontera no estadounidense al precio de Sol.
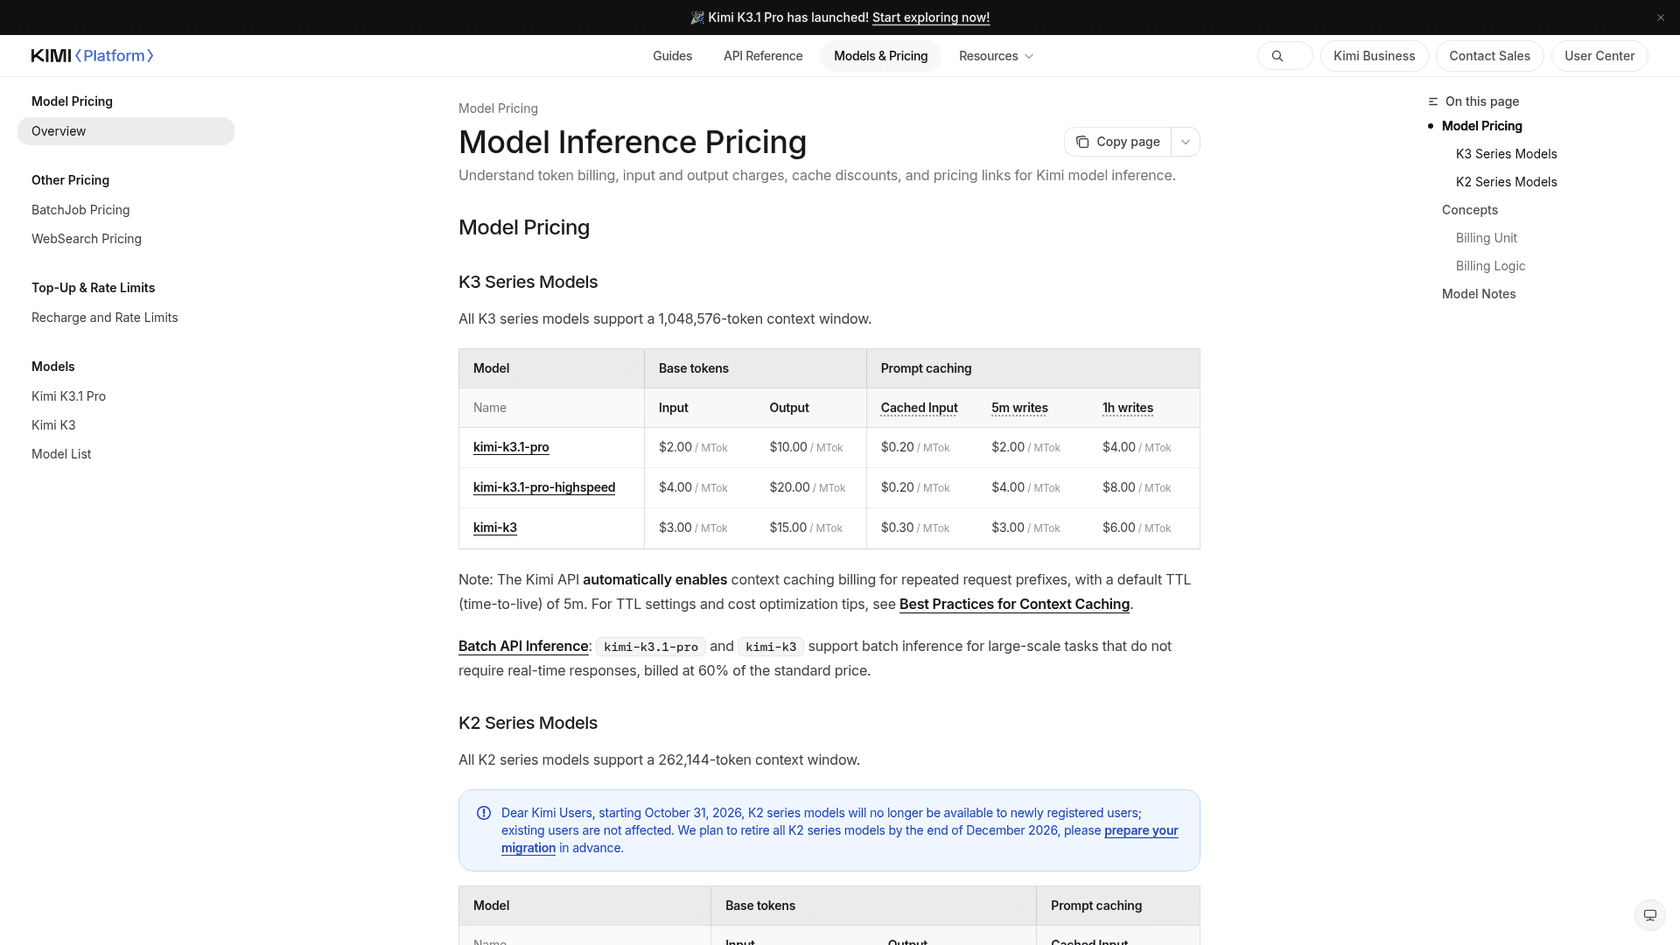
Kimi K3.1 Pro de Moonshot AI cuesta $2/$10, igual que Sol, con $0.20 de entrada en caché y una ventana de contexto de 1,048,576 tokens, según la página de precios de Kimi. Una variante de alta velocidad cuesta el doble. El caching de contexto se activa automáticamente para prefijos repetidos, con una vida útil predeterminada de 5 minutos.
Obtiene 46 en Artificial Analysis a $3.68 por tarea, lo que lo coloca entre los modelos económicos y el grupo de frontera. El tiempo por tarea es largo, 38.7 minutos.
Ventajas
- $2/$10, igual que Sol y Sonnet 5.5
- Caching de contexto automático sin configuración
- Ventana de contexto de 1M tokens
Desventajas
- 46 en Artificial Analysis, 11 puntos por debajo de Sol al mismo precio por token
- 38.7 minutos por tarea de referencia
- Los modelos K2 están cerrados a nuevos usuarios desde el 31 de octubre de 2026, así que las guías más antiguas pueden señalar modelos que no puedes usar
Precios: $2 de entrada, $10 de salida, $0.20 en caché, $2 por escrituras de caché de 5 minutos. Ver precios de Kimi K3.1 Pro.
Veredicto: vale la pena probarlo si necesitas un laboratorio no estadounidense. Al mismo precio, Sol puntúa más alto en el índice compartido. El análisis de Kimi K3.1 Pro profundiza más.
10. Qwen4 Max
Mejor para: precios de salida bajos de un modelo general grande.
Qwen4 Max estuvo disponible de forma general el 16 de noviembre de 2026. En la región de Singapur de Qwen Cloud cuesta $1.50 de entrada y $4.50 de salida por millón de tokens, con lecturas de caché a $0.075, según los precios de modelos de Qwen Cloud. La ventana de contexto es de 1M tokens.
Artificial Analysis lo puntúa en 43 a $3.27 por tarea. Eso es más bajo que Kimi K3.1 Pro y bastante por debajo de Sol, pero su precio de salida es aproximadamente un noveno del de Astra.
Ventajas
- $4.50 de salida, más bajo que cualquier modelo aquí excepto DeepSeek y Gemini 3.8 Flash
- Lecturas de caché a $0.075
- Modos de pensamiento y sin pensamiento al mismo precio
Desventajas
- 43 en Artificial Analysis
- Los precios varían según la región, así que la tarifa de Singapur no es universal
- 31.9 minutos por tarea de referencia
Precios: $1.50/$4.50 en Singapur, con caching explícito a $1.875 por escrituras de 5 minutos. La guía precios de Qwen 4 Max cubre las otras regiones.
Veredicto: una opción económica para trabajo sencillo. Para algo más cercano a Astra, mira más arriba en esta lista. El artículo alternativas a Qwen 4 Max lo compara con sus propios rivales.
¿Deberías enrutar entre modelos en vez de cambiar?
Para la mayoría de productos con agentes, sí. Cambiar por completo de Astra a un modelo más barato significa aceptar sus puntos débiles en cada tarea. Enrutar significa enviar cada tarea al modelo más barato que la maneje bien.
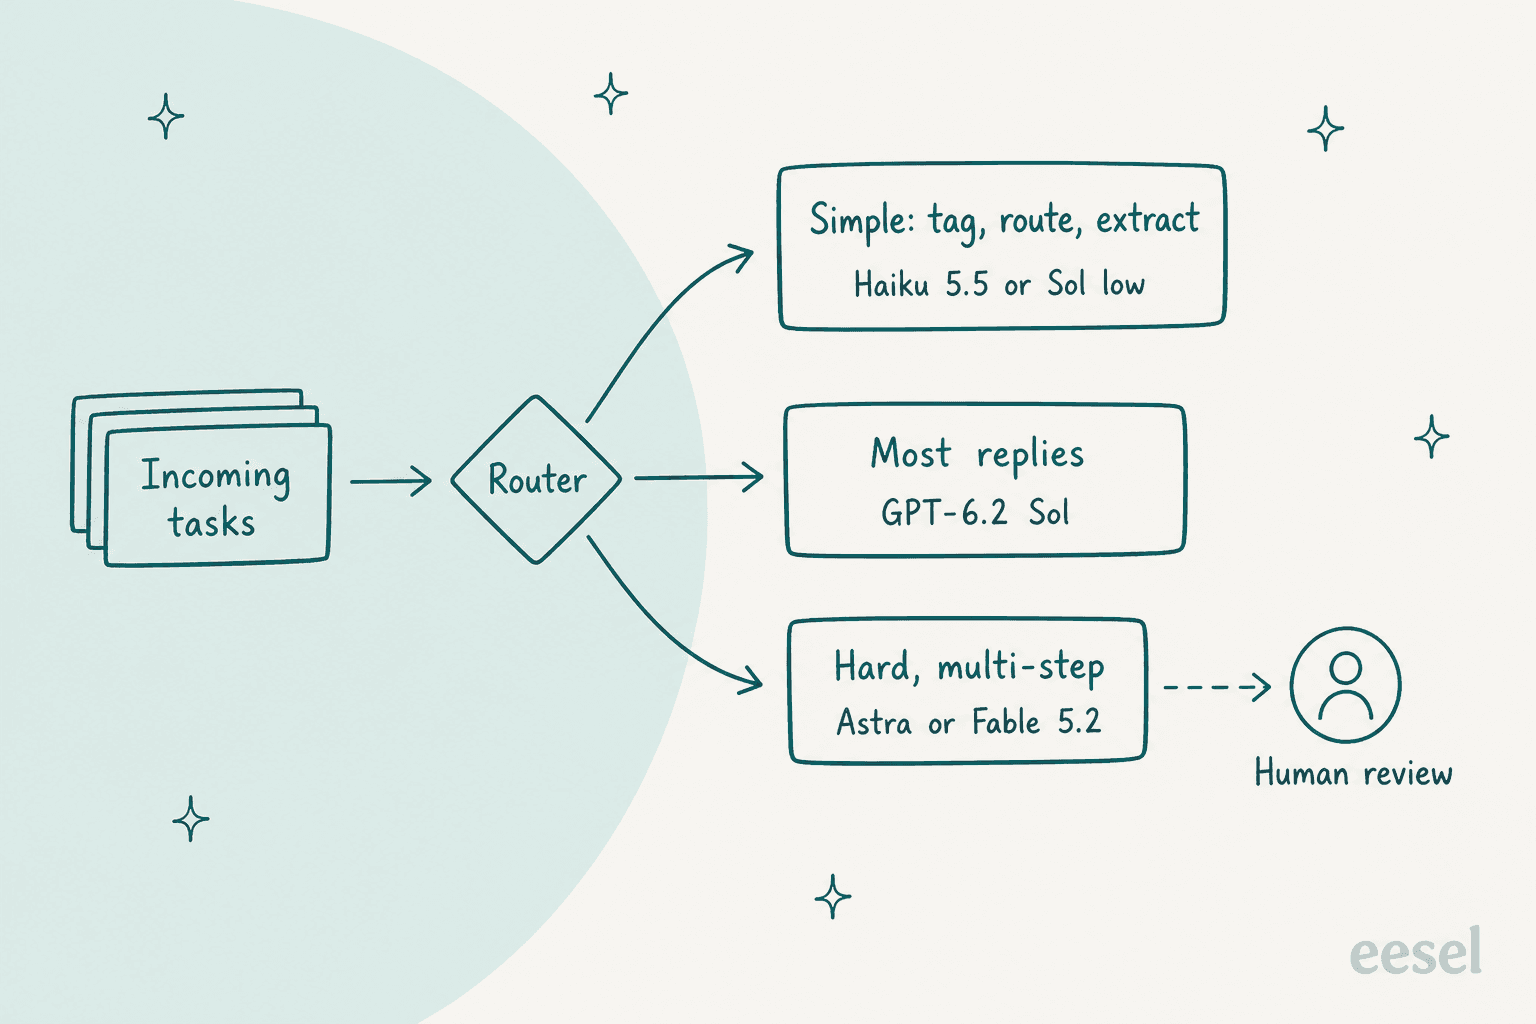
Una configuración con la que empezaría:
- Las tareas simples como etiquetado, enrutamiento y extracción van a un modelo pequeño. Claude Haiku 5.5 cuesta $0.10/$0.50 para prompts de hasta 100,000 tokens y costó $0.41 por tarea de Artificial Analysis, o usa Sol con esfuerzo bajo.
- La mayoría de respuestas y llamadas de herramientas de rutina van a GPT-6.2 Sol, que igualó a Astra en toda mi prueba.
- El trabajo difícil de varios pasos va a Astra, o a Fable 5.2 cuando lo que está en juego justifique $26.54 por tarea.
- Todo lo incierto va a una persona.
Los desarrolladores en el hilo de lanzamiento ya hacían una versión de esto:
"Opus medium as orchestrator and reviewer, Sol(high/medium)/Terra(max) as implementer."
La misma idea aplica en colas de soporte. El enrutamiento inteligente envía los tickets a la persona correcta; el enrutamiento de modelos envía cada paso al modelo correcto. El desglose costo de un agente de IA frente a un agente humano muestra por qué el carril barato importa a gran volumen.
¿Cómo deberías probar una alternativa antes de cambiar?
Los benchmarks te dicen qué modelos preseleccionar. Solo tus propias tareas te dicen cuál debes usar en producción. Aquí está el proceso que usé para la prueba de Sol, llevado a mayor escala.
- Toma de 100 a 300 tareas reales de tus registros, incluyendo las incómodas: llamadas a herramientas fallidas, solicitudes vagas, otros idiomas.
- Mantén todo igual excepto el modelo: mismo prompt de sistema, mismas herramientas, mismos límites.
- Evalúa el costo por tarea exitosa, no el costo por llamada. Un modelo barato que necesita dos reintentos no es barato.
- Ejecuta cada configuración con el esfuerzo que realmente usarías, ya que el esfuerzo cambia la factura más que el precio de lista.
- Lee los fallos a mano. Un monto de reembolso incorrecto importa más que una frase un poco rígida.
Para trabajo de soporte específicamente, pruebas de agentes de soporte con IA explica cómo armar ese conjunto de pruebas a partir de tickets pasados. La guía de benchmarking cubre la evaluación, y revisar conversaciones de IA cubre el control continuo una vez que está en producción.
¿Qué significa esto para un equipo de soporte?
Si tus agentes responden a clientes, la elección del modelo es la decisión menor. Cualquier modelo de esta lista puede escribir una respuesta educada. Lo que decide si es la respuesta correcta es el conocimiento que lee, las acciones que puede tomar y qué pasa cuando no está seguro. Mi prueba lo mostró directamente: tanto Astra como Sol escalaron correctamente la búsqueda de pedido rota porque las instrucciones lo indicaban, y ambos calcularon bien el reembolso porque la política estaba por escrito.
Esa es la capa que construye eesel. eesel es una plataforma de compañeros de IA: contratas compañeros listos para trabajar en tareas específicas, un compañero de IA para el helpdesk para tu cola y un redactor de blog con IA para contenido. El modelo es el motor; el compañero es el empleado que lo conduce, con tus integraciones, tu conocimiento y tus barreras ya implementadas. Antes de responder a un cliente real, se simula contra tus tickets pasados.
Swiftreg, que vende placas de matrícula privadas, muestra cómo se ve esa capa de reglas en la práctica. Sus agentes de eesel manejaron 2,100 tickets de Zendesk en un mes, respondiendo con datos reales de pedidos bajo reglas que Swiftreg escribió por sí mismo. Enviaron 1,500 respuestas públicas y dejaron 1,050 notas internas donde un paso le corresponde al personal. SE Ranking ejecuta un agente de eesel por producto en tres productos sobre Zendesk, y manejó 4,650 conversaciones en un mes buscando en unas 16,800 páginas de ayuda y contenido del sitio antes de responder.
Si prefieres trabajar desde código, el CLI de eesel te permite a ti o a un agente de código como Claude Code o Codex manejar el mismo compañero desde una terminal: subir artículos de ayuda y macros aprobados, ajustar las instrucciones del agente y hacerle preguntas de prueba antes de que algo salga en vivo. Conectar el helpdesk en sí todavía necesita la aprobación de un administrador, y el conocimiento subido se prueba antes de contar como listo.
Es la misma idea que un CLI de agentes de IA, aplicada a un compañero de soporte. Un servidor MCP es la otra ruta común. Si estás evaluando si conectar esto tú mismo sobre Sol o Astra, construir vs. comprar explica lo que la factura del modelo deja fuera.
Prueba eesel
Cambiar Astra por Sol reduce tu factura de tokens. No escribe tus reglas de escalamiento, no fundamenta las respuestas en tu centro de ayuda ni prueba al agente con los tickets del mes pasado. El compañero de IA para el helpdesk de eesel se conecta a Zendesk, funciona igual con Freshdesk y el resto de tu stack, aprende de tus tickets pasados y te muestra cómo los habría respondido antes de salir en vivo.

Prueba eesel gratis en una parte de tu cola, o mira planes y precios.