

GPT-6.2 Astra cuesta 8 $ por millón de tokens de entrada, 0,40 $ en caché y 40 $ de salida, 20 % por debajo del precio de lista de GPT-6 Astra. El cambio mayor es la entrada en caché, que baja 60 %. En un agente de soporte que reutiliza un prompt de 12.500 tokens, eso lo hace un 35 % más barato por ticket (21,80 $ frente a 33,50 $ por 1.000), pero solo si el caché realmente acierta: un fallo cuesta más de 5 veces más.
Vigila tres medidores: los prompts de más de 272.000 tokens, el modo Fast y Ultrafast, que pasa de 3x a 6x Standard el 1 de marzo de 2027. Para la mayoría del trabajo de soporte, GPT-6.2 Sol hace el mismo trabajo por un cuarto del precio.
¿Cuánto cuesta GPT-6.2 Astra?
GPT-6.2 Astra cuesta 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida en el nivel Standard, con la entrada en caché a 0,40 $. OpenAI lo lanzó el 17 de noviembre de 2026 junto con GPT-6.2 Sol, el sucesor de GPT-6.1 Sol. El post de lanzamiento describe el precio como "un descuento del 20 % en tokens de entrada y salida, y un descuento más profundo del 60 % en tokens de entrada en caché" frente a GPT-6 Astra.
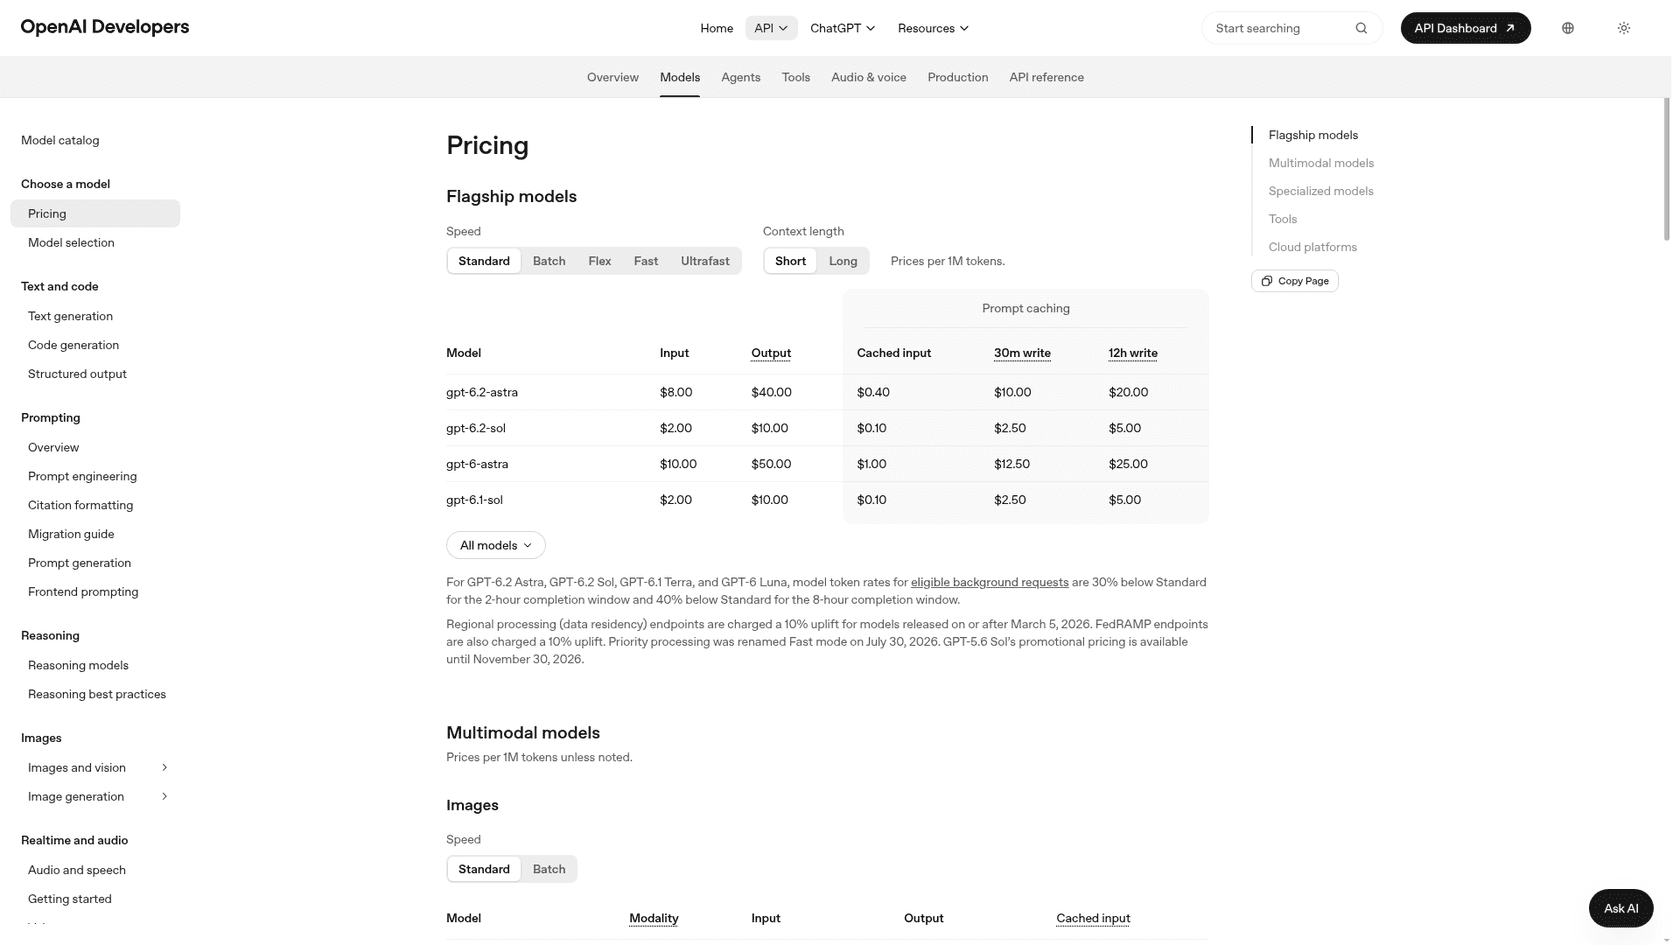
Yo construyo integraciones y la conexión con APIs en eesel, y llevo varios años poniendo agentes de IA en colas de soporte en vivo, así que lo primero que hago con el precio de un modelo nuevo es convertirlo en costo por ticket. El precio de lista por millón de tokens casi no dice nada hasta que sabes en qué medidor cae cada token. Aquí está cada medidor de la página de precios de OpenAI y la página del modelo GPT-6.2 Astra, por millón de tokens:
| Nivel | Entrada | Entrada en caché | Escritura de caché de 30 min | Escritura de caché de 12 h | Salida |
|---|---|---|---|---|---|
| Standard | 8,00 $ | 0,40 $ | 10,00 $ | 20,00 $ | 40,00 $ |
| Standard, más de 272.000 de entrada | 16,00 $ | 0,80 $ | n/a | n/a | 60,00 $ |
| Batch | 4,00 $ | 0,20 $ | 5,00 $ | 10,00 $ | 20,00 $ |
| Fast | 16,00 $ | 0,80 $ | 20,00 $ | 40,00 $ | 80,00 $ |
| Ultrafast (hasta el 28 feb 2027) | 24,00 $ | 1,20 $ | 30,00 $ | 60,00 $ | 120,00 $ |
| Ultrafast (desde el 1 mar 2027) | 48,00 $ | 2,40 $ | 60,00 $ | 120,00 $ | 240,00 $ |
| Flex | No disponible |
La fila de contexto largo viene de la página del modelo, que dice que más allá de 272.000 tokens de entrada "las tarifas de entrada y caché se duplican y la salida cuesta 1,5 veces la tarifa de contexto corto para toda la solicitud". No lista precios de escritura de caché de contexto largo, así que he dejado esos campos en blanco en vez de adivinar.
El modelo en sí tiene una ventana de contexto de 1.050.000 tokens, 922.000 tokens máximos de entrada y 128.000 tokens máximos de salida. Otra línea en la página del modelo afecta el costo: la API rechaza las solicitudes que fijan el esfuerzo de razonamiento en none, así que no puedes apagar el razonamiento para ahorrar tokens de salida como hacían algunos equipos en modelos anteriores. Los tokens de razonamiento se facturan como salida, según la guía de razonamiento de OpenAI.
¿Por qué se te factura exactamente?
Se te factura por token en cuatro medidores distintos, y cuestan cantidades muy distintas. Cada solicitud se divide en:
- Tokens de entrada a 8 $ por millón: todo lo nuevo en el prompt, como el mensaje del cliente.
- Entrada en caché a 0,40 $ por millón: el inicio del prompt que coincide exactamente con una solicitud reciente, como tus instrucciones y el texto del centro de ayuda.
- Escrituras de caché a 10 $ (30 minutos) o 20 $ (12 horas) por millón: la primera vez que se guarda un prefijo reutilizable.
- Tokens de salida a 40 $ por millón: la respuesta, más cualquier razonamiento que el modelo haga antes.
La guía de caché de prompts de OpenAI aclara que una escritura de caché "no es una tarifa adicional". Cada token de entrada se factura una sola vez, a la tarifa sin caché, en caché, o de escritura. El prefijo mínimo cacheable es de 1.024 tokens para GPT-5.6 y modelos posteriores.
La brecha entre esos medidores es toda la historia. Un token en caché cuesta una vigésima parte de un token de entrada fresco y una centésima parte de un token de salida. Así que la forma de tu prompt importa más que el precio de lista.
¿Cuánto más barato es en la práctica que GPT-6 Astra?
En cualquier carga de trabajo que reutiliza un prompt largo, GPT-6.2 Astra es alrededor de un 35 % más barato que GPT-6 Astra, no un 20 %. El ahorro extra viene del recorte en la entrada en caché.
Para comprobarlo, calculé el precio de una llamada típica de un agente de soporte. Cada ticket envía un prefijo de 12.500 tokens (instrucciones más contenido del centro de ayuda, del mismo tamaño que la prueba de caché que hice el día del lanzamiento), 600 tokens de entrada nueva y 300 tokens de salida incluyendo razonamiento. Suponiendo que el prefijo acierta en el caché:
| Modelo | Entrada en caché | Entrada | Salida | Por ticket | Por 1.000 tickets |
|---|---|---|---|---|---|
| GPT-6 Astra | 1,00 $ | 10 $ | 50 $ | 0,0335 $ | 33,50 $ |
| GPT-6.2 Astra | 0,40 $ | 8 $ | 40 $ | 0,0218 $ | 21,80 $ |
| GPT-6.2 Sol | 0,10 $ | 2 $ | 10 $ | 0,0055 $ | 5,45 $ |
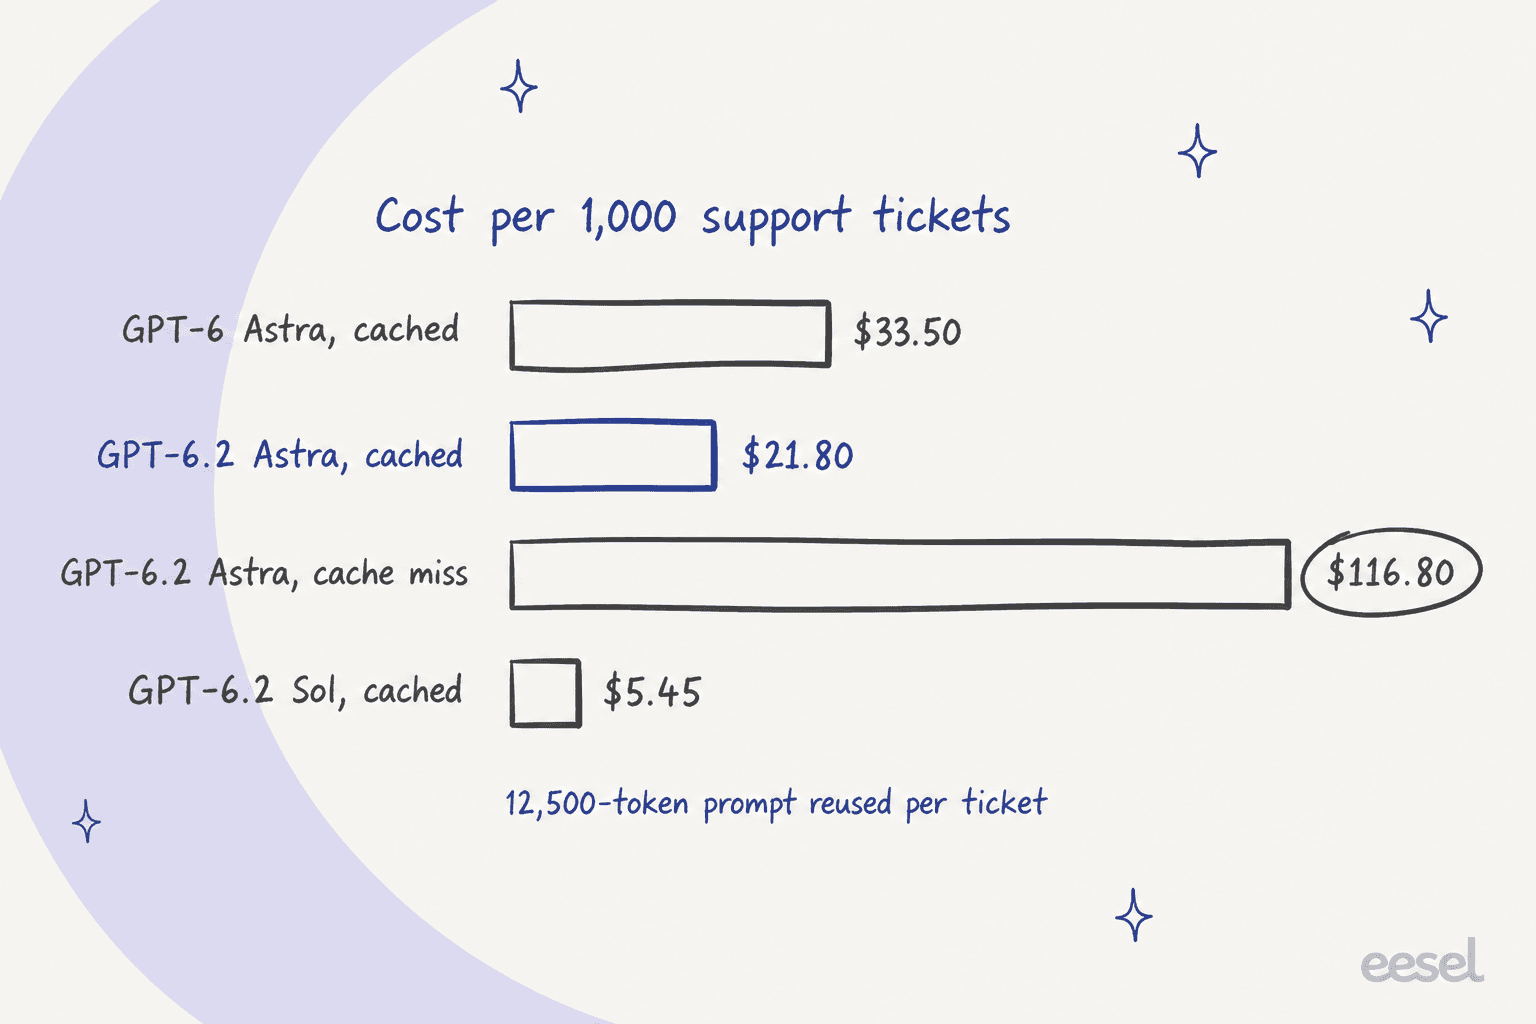
Dos cosas destacan. La primera es que el prompt reutilizado domina la factura. En mi prueba del día de lanzamiento de GPT-6.2 Astra, con un prompt diminuto de 278 tokens y sin centro de ayuda, 1.000 tickets costaron 5,79 $ con esfuerzo medio. Agrega el conocimiento que un agente realmente necesita y el precio sube unas 4 veces, incluso con el caché funcionando.
La segunda es la barra del fallo de caché. Si ese mismo prefijo se factura como entrada fresca en cada ticket, GPT-6.2 Astra cuesta 116,80 $ por 1.000 tickets, más de 5 veces el precio en caché y más que GPT-6 Astra con un caché que funciona. Un caché fallido borra todo el descuento de la actualización y más.
Artificial Analysis ve la misma dirección a nivel de benchmark: su Intelligence Index completo cuesta 4,00 $ por tarea en GPT-6.2 Astra frente a 6,24 $ en GPT-6 Astra, una caída del 36 %. Eso viene de tokens más baratos más menos tokens, ya que OpenAI dice que el modelo usa menos tokens de salida en tareas exigentes.
¿Cuánto cuesta realmente un fallo de caché?
Un fallo de caché cuesta unas 5 veces más por ticket en GPT-6.2 Astra, y es más fácil de provocar de lo que parece. En mi prueba del día de lanzamiento, puse un centro de ayuda de 12.500 tokens en el campo instructions de nivel superior de la API Responses. Tres llamadas consecutivas mostraron cero tokens en caché y cero escrituras de caché. Mover el mismo texto a un mensaje de developer lo arregló: la primera llamada escribió 12.513 tokens en el caché, y las siguientes dos leyeron 12.501 tokens cada una.
La guía de caché de OpenAI explica parte del motivo. "Las instructions de nivel superior no pueden contener un punto de corte explícito", dice, y las instrucciones de developer reutilizables van "en un bloque input_text dentro de un mensaje de developer". El post de lanzamiento también recomienda "mantener los prefijos del prompt sin cambios y añadir las instrucciones nuevas al final" para ambos modelos 6.2. Si tu integración reescribe el prompt del sistema en cada turno para inyectar datos del cliente, estás pagando la tarifa completa de entrada por cada token de eso.
Las escrituras de caché tienen su propia matemática. Una escritura de 30 minutos de un prefijo de 12.500 tokens cuesta 0,125 $, frente a 0,10 $ por enviarlo sin caché una vez. Así que la escritura pierde dinero si nadie reutiliza el prefijo, y se amortiza desde el segundo acierto. Con las tarifas de GPT-6.2 Astra, una escritura y nueve lecturas cuestan 1,70 veces el precio de entrada normal, frente a 10 veces sin caché en absoluto.
La escritura de 12 horas cuesta el doble (0,25 $ para ese prefijo). Vale la pena en una cola tranquila: si los tickets llegan con más de 30 minutos de separación durante la noche, un caché de 30 minutos sigue expirando y pagas por escribirlo de nuevo cada vez. Una cola ocupada no lo necesita, porque cada lectura renueva la ventana de 30 minutos. Puedes observar las tasas de acierto en el panel de caché de prompts de OpenAI antes de decidir.
¿Qué niveles y multiplicadores cambian la factura?
Ocho multiplicadores se suman a la tarifa Standard, y dos son lo bastante grandes como para importar más que la elección del modelo. Aquí están en una sola escalera:
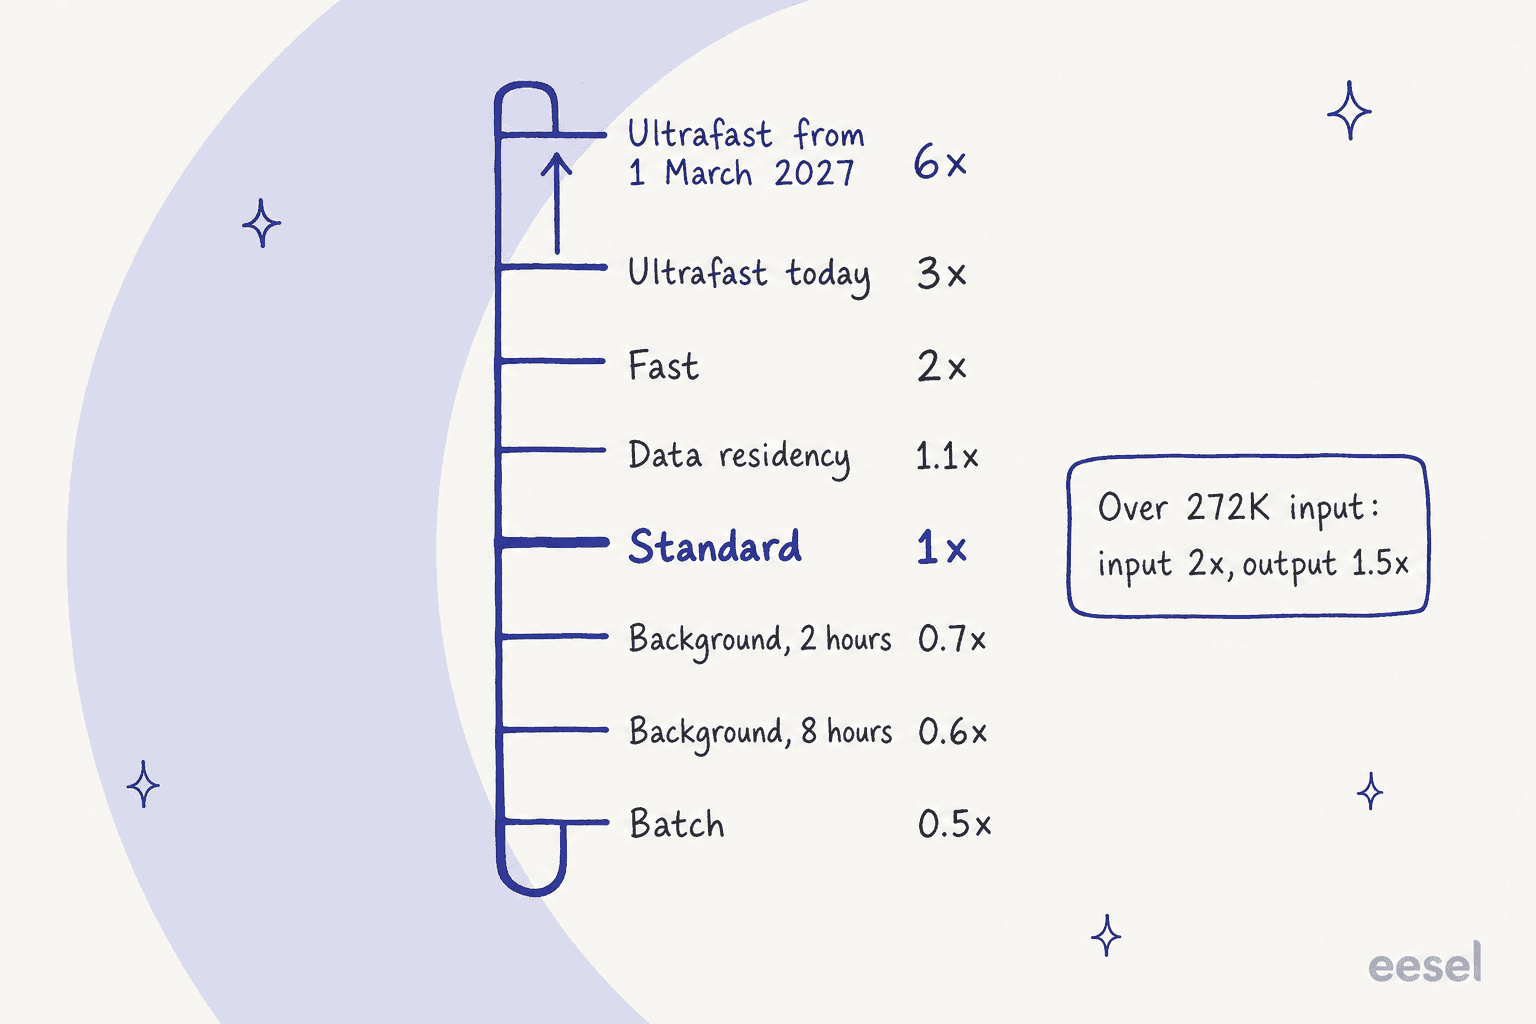
- Batch (0,5x). La API Batch reduce a la mitad cada tarifa, incluyendo la entrada en caché y las escrituras. Sirve para trabajos nocturnos como etiquetar los tickets del mes pasado o reescribir artículos de ayuda, no para respuestas en vivo.
- Solicitudes en segundo plano (0,6x a 0,7x). Según la página de precios, las solicitudes en segundo plano elegibles en la API Responses corren "30 % por debajo de Standard en la ventana de 2 horas y 40 % por debajo de Standard en la ventana de 8 horas". Está en beta pública.
- Residencia de datos (1,1x). Los endpoints de procesamiento regional llevan "un recargo del 10 % para modelos lanzados a partir del 5 de marzo de 2026", lo que incluye a GPT-6.2 Astra. Los endpoints FedRAMP llevan el mismo 10 %.
- Fast (2x). El modo Fast, que OpenAI renombró de Priority Processing el 30 de julio de 2026, duplica cada tarifa.
- Ultrafast (3x, luego 6x). Ultrafast cuesta 3 veces Standard hasta el 28 de febrero de 2027 y 6 veces Standard desde el 1 de marzo de 2027. Si construyes ahora una función sensible a la latencia sobre él, tu factura se duplica en esa fecha sin que cambies nada de código.
- Contexto largo (2x entrada, 1,5x salida). Si cruzas los 272.000 tokens de entrada, toda la solicitud pasa a la tarifa más alta, no solo los tokens que sobran.
El único nivel que podrías esperar y no vas a encontrar es Flex. La página de precios lista Flex para GPT-6 Astra, GPT-6.1 Sol, GPT-6.1 Terra y GPT-6 Luna, pero no para GPT-6.2 Astra. Batch y las solicitudes en segundo plano son, por ahora, las rutas de descuento.
La regla de contexto largo es la más traicionera. Una sola revisión de contrato de 400.000 tokens con una respuesta de 4.000 tokens cuesta 6,64 $ en GPT-6.2 Astra. Los mismos tokens a tarifas de contexto corto costarían 3,36 $. Si puedes dividir un documento en fragmentos de menos de 272.000, reduces a la mitad la factura de entrada.
¿Cuánto costaría GPT-6.2 Astra para tu volumen?
Introduce abajo tu propio volumen de tickets y la forma de tu prompt. Calcula la misma carga de trabajo en GPT-6.2 Astra, GPT-6 Astra y GPT-6.2 Sol, usando las tarifas de la página de precios de OpenAI. Los fallos de caché se facturan como escrituras de caché de 30 minutos, que es lo que pasa con el caché implícito cuando el prefijo aún no está guardado.
Arrastra la tasa de acierto de caché del 95 % al 0 % y la factura de GPT-6.2 Astra a 8.000 tickets salta de 222,40 $ a 1.134,40 $ al mes, unas 5 veces más. Ese único ajuste cambia la factura más que la actualización del modelo.
¿Cuánto cuesta en distintos tamaños de equipo?
Aquí está la misma carga de trabajo de soporte en tres volúmenes mensuales, a tarifas Standard con una tasa de acierto de caché del 95 %. Los fallos se facturan como escrituras de caché de 30 minutos:
| Tickets al mes | GPT-6.2 Astra | GPT-6.2 Astra, Batch | GPT-6 Astra | GPT-6.2 Sol |
|---|---|---|---|---|
| 1.000 | 27,80 $ | 13,90 $ | 40,69 $ | 6,95 $ |
| 8.000 | 222,40 $ | 111,20 $ | 325,50 $ | 55,60 $ |
| 50.000 | 1.390,00 $ | 695,00 $ | 2.034,38 $ | 347,50 $ |
Para darte una idea de escala, el cliente de eesel SamCart opera un agente en los tickets de Freshdesk y otro en el chat de su sitio web, respondiendo desde unos 280 artículos del centro de ayuda, en un plan que cubre 8.000 interacciones al mes. Esa fila del medio es más o menos ese volumen. Solo en tokens, la factura del modelo es de unos pocos cientos de dólares al mes, antes de que nadie haya escrito la recuperación, las llamadas a funciones para buscar pedidos, las reglas de escalamiento, o la observabilidad para ver qué dijo.
Esa es la forma honesta del costo del soporte con IA: los tokens son la línea pequeña, y la capa de recuperación es parte de la grande. La ingeniería y el mantenimiento alrededor de ambas son la parte grande, por lo que el costo de un agente IA depende mucho más de construir versus comprar que de qué modelo elijas.
¿GPT-6.2 Astra es más barato que Claude Fable 5.2?
Token por token, no: tienen el mismo precio de lista, y el caché de Fable es más barato. Por tarea terminada, GPT-6.2 Astra es mucho más barato. La página de precios de Anthropic lista a Claude Fable 5.2 a 8 $ de entrada y 40 $ de salida por millón de tokens, exactamente igual que Astra, con aciertos de caché a 0,20 $.
| Por millón de tokens | GPT-6.2 Astra | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|---|
| Entrada | 8,00 $ | 8,00 $ | 4,00 $ | 2,00 $ |
| Salida | 40,00 $ | 40,00 $ | 20,00 $ | 10,00 $ |
| Lectura de caché | 0,40 $ | 0,20 $ | 0,20 $ | 0,10 $ |
| Escritura de caché más barata | 10,00 $ (30 min) | 10,00 $ (5 min) | 5,00 $ (5 min) | 2,50 $ (30 min) |
| Prompts largos | 2x entrada, 1,5x salida por encima de 272.000 | Misma tarifa hasta 1M | Misma tarifa hasta 1M | 2x entrada, 1,5x salida por encima de 272.000 |
| AA Intelligence Index | 62 | 65 | 59 | 57 |
En mi carga de trabajo de soporte con un prefijo en caché, Fable 5.2 sale ligeramente más barato (19,30 $ frente a 21,80 $ por 1.000 tickets) por esa lectura de caché de 0,20 $. Y para una sola solicitud de 400K tokens, Fable cuesta 3,36 $ donde Astra cuesta 6,64 $, porque Anthropic cobra "la misma tarifa por token" en toda su ventana de contexto de 1M.
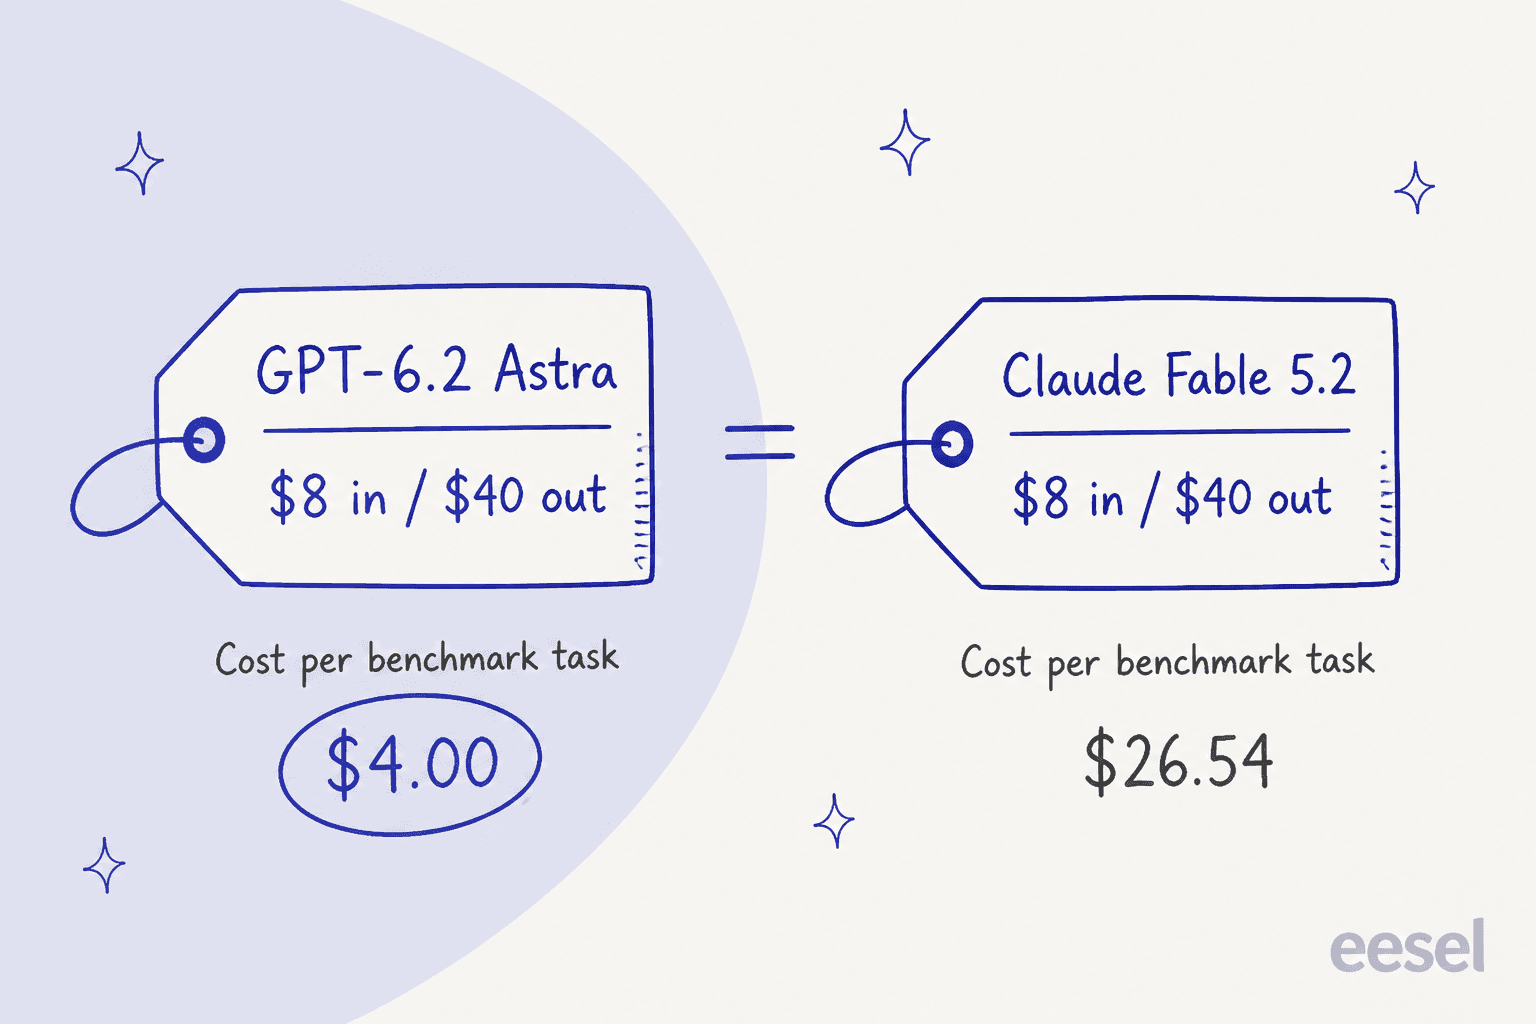
La vista por tarea lo invierte. Artificial Analysis pone el costo de correr su Intelligence Index en 4,00 $ por tarea para GPT-6.2 Astra frente a 26,54 $ para Claude Fable 5.2, porque Astra usa muchos menos tokens para llegar a una respuesta. Fable sigue puntuando más alto, 65 frente a 62 de Astra. En tareas de agente largas donde el modelo escribe y razona mucho, el recuento de tokens importa más que la tarifa. En llamadas cortas y con mucho caché como las respuestas de soporte, la tarifa importa más.
Así que la comparación correcta depende de tu carga de trabajo. Para respuestas cortas con un prompt grande reutilizado, compara las tarifas de caché. Para trabajo largo y abierto, compara el costo por tarea. Claude Opus 5.5 está en medio, a la mitad del precio por token de Astra y con una puntuación menor. El resumen de alternativas a GPT-6 Astra cubre el resto del campo.
¿Cuánto cuesta GPT-6.2 Astra en ChatGPT?
En ChatGPT pagas una suscripción fija, no por token. OpenAI dice que GPT-6.2 Astra y Sol están "disponibles para todos los usuarios Plus, Pro, Enterprise y Edu en ChatGPT Work y Codex", con acceso para Enterprise y Edu una vez que un admin del workspace lo activa.
| Plan | Precio | Acceso a GPT-6.2 Astra |
|---|---|---|
| Free | 0 $ | No listado en el post de lanzamiento |
| Go | 8 $/mes | No listado en el post de lanzamiento |
| Plus | 20 $/mes | Sí, en ChatGPT Work y Codex |
| Pro | Desde 100 $/mes (Pro 100, Pro 200, Pro 500) | Sí; Pro 500 también obtiene Ultrafast con él |
| Enterprise y Edu | Contactar a ventas | Sí, una vez que un admin lo activa |
Los precios vienen de la página de precios de ChatGPT. Los niveles Pro también incluyen créditos de API mensuales: 100 $ con Pro 100, 200 $ con Pro 200, o 500 $ con Pro 500. A mi tarifa de soporte en caché de 21,80 $ por 1.000 tickets, 500 $ de créditos cubren unos 22.900 tickets de GPT-6.2 Astra al mes, siempre que cumplas los términos de elegibilidad de OpenAI para los créditos. El desglose completo de planes está en la guía de precios de ChatGPT.
¿Vale la pena GPT-6.2 Astra para el soporte al cliente?
Para la mayoría de las colas de soporte, GPT-6.2 Astra es más modelo del que el trabajo necesita. En mi prueba del día de lanzamiento, GPT-6.2 Sol y GPT-6.2 Astra manejaron correctamente los 15 tickets de prueba, incluyendo matemáticas de reembolso, una inyección de prompt y una búsqueda de pedido fallida, y Sol costó alrededor de un cuarto de lo mismo. Las herramientas de evaluaciones de agentes de OpenAI pueden correr el mismo tipo de prueba sobre tus propios tickets. Astra se gana su precio en trabajo largo y de varios pasos como modelos financieros, investigación legal y construcción de hojas de cálculo, que es donde OpenAI lo posiciona.
También hay una razón más allá del costo para mantener a Astra lejos de las respuestas a clientes sin supervisión. Artificial Analysis encontró que su tasa de alucinación en hechos desconocidos subió de 50 % a 59 % con esfuerzo máximo comparado con GPT-6 Astra. Eso hace que la capa de fundamentación y prevención de alucinaciones sea más importante que la elección del modelo, cualquiera que uses.
La pregunta de presupuesto más grande es si quieres una factura de tokens en absoluto. El precio de los tokens se mueve con cada cambio de prompt, cada fallo de caché y cada actualización de precios como el cambio de Ultrafast en marzo. Un líder de ingeniería en una empresa de hardware cripto con una base de conocimiento de más de 300 artículos lo resumió así cuando elegimos a eesel:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Esa es la disyuntiva de construir versus comprar en una frase. Si construyes sobre GPT-6.2 Astra, presupuesta los tokens y el mantenimiento. Si compras, presupuesta un número mensual fijo y usa tu tiempo en probar al agente contra tickets reales en su lugar.
Prueba eesel
Si estás viendo el precio de GPT-6.2 Astra porque quieres IA en tu cola de soporte, eesel te da eso sin una factura de tokens que vigilar. El compañero IA del helpdesk se conecta al helpdesk que ya usas, como Zendesk o Freshdesk, aprende de tus tickets pasados y tu centro de ayuda, y funciona con un plan mensual fijo. Antes de que responda a un cliente real, puedes correrlo contra tus tickets históricos y leer cada respuesta.

Los desarrolladores pueden manejar la misma configuración desde la CLI de eesel: un agente de codificación con IA como Claude Code o Codex puede subir conocimiento aprobado como artículos de ayuda y macros exportados, hacerle preguntas de prueba al agente, y revisar las respuestas antes de que algo salga en vivo. Conectar el helpdesk en sí todavía necesita a alguien con acceso de admin que lo apruebe.
Puedes probar eesel gratis en una parte de tu cola, ver planes y precios, o compararlo con usar ChatGPT directamente si todavía estás decidiendo si construirlo tú mismo.