

Precios de Mistral Large 4 de un vistazo
En eesel me encargo de las integraciones de API, y el compañero de helpdesk funciona con modelos de OpenAI, Anthropic y Google, así que buena parte de mi semana consiste en leer tablas de tarifas y mirar más allá del número del titular. La tabla de tarifas de Mistral para Large 4 es corta, pero esconde más de lo que muestra. Aquí está todo lo de la página de precios de la API de Mistral para la familia insignia, nivel Standard, a 8 de octubre de 2026.
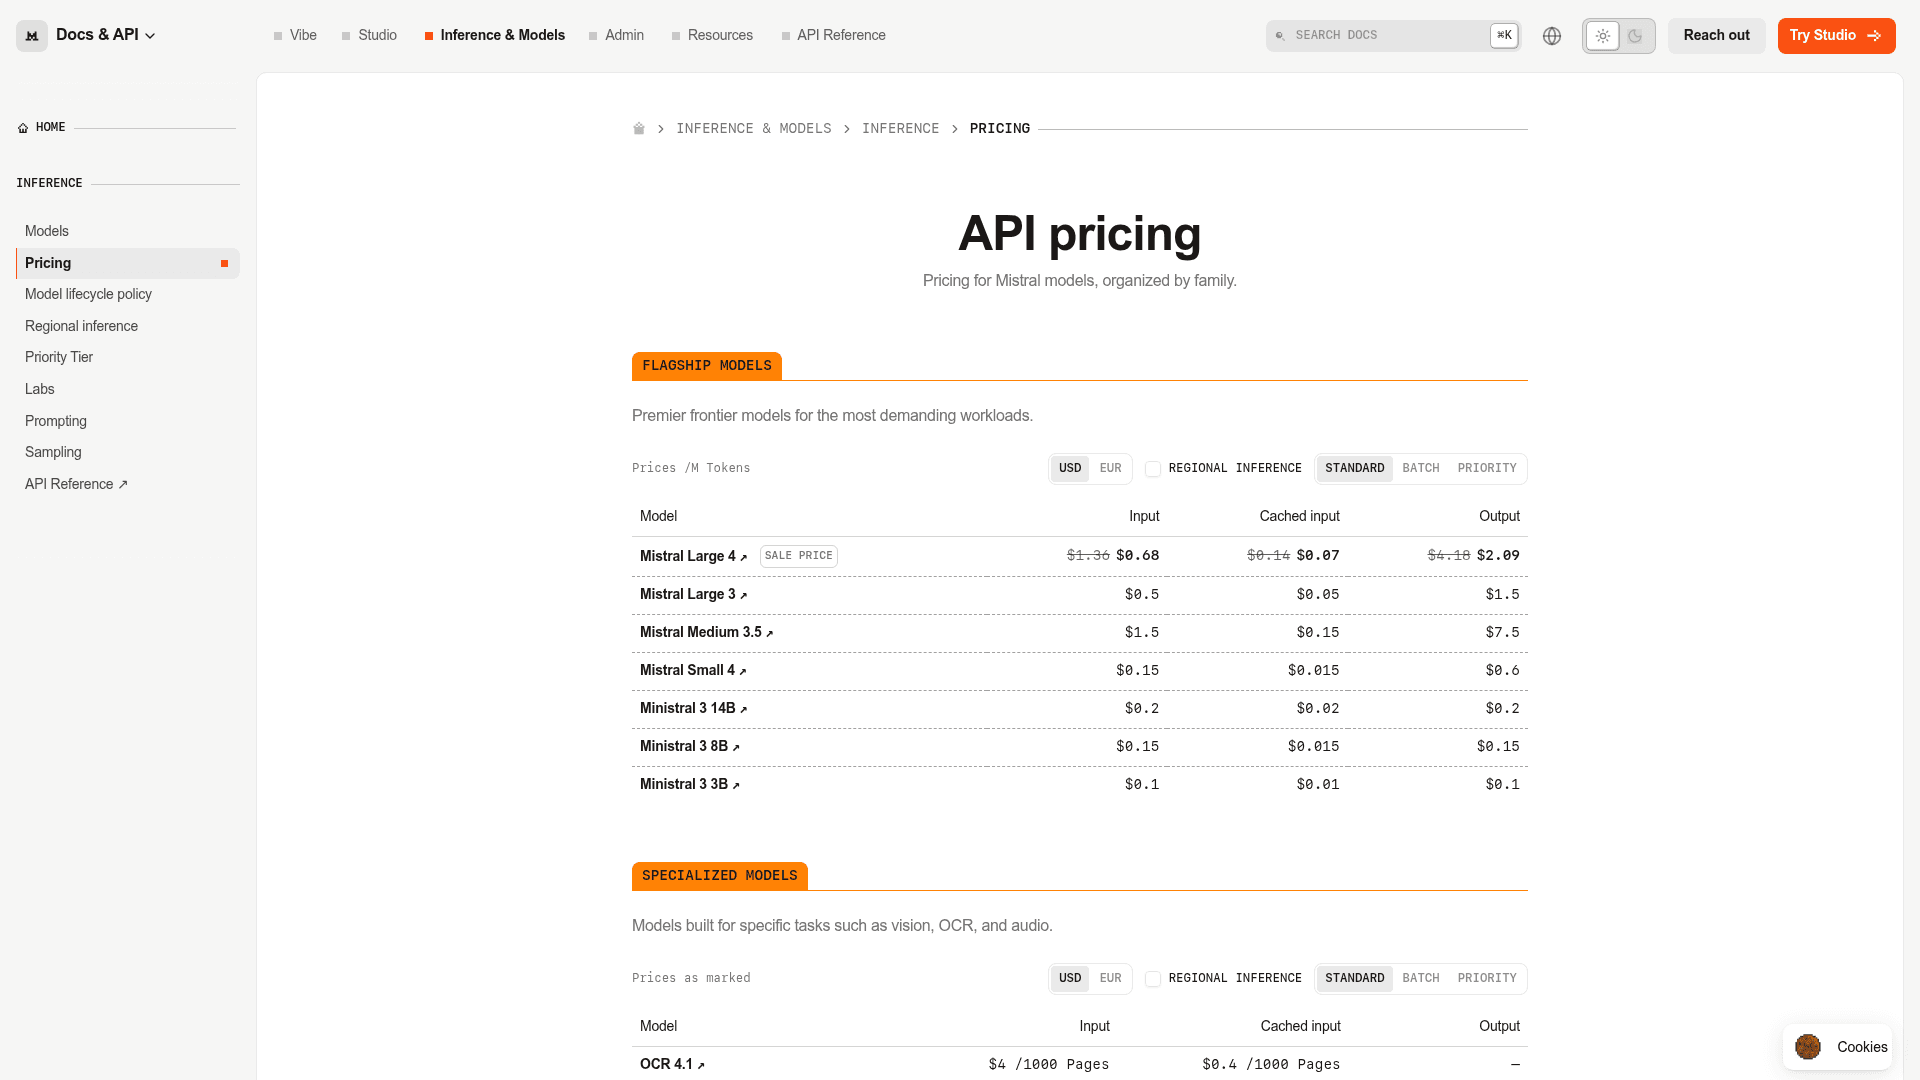
| Modelo | Entrada (por 1M) | Entrada en caché (por 1M) | Salida (por 1M) | Notas |
|---|---|---|---|---|
| Mistral Large 4 (oferta) | $0.68 | $0.07 | $2.09 | Preview pública, contexto de 1M |
| Mistral Large 4 (lista) | $1.36 | $0.14 | $4.18 | Tachado en la página |
| Mistral Large 3 | $0.50 | $0.05 | $1.50 | Anterior insignia, aún listado |
| Mistral Medium 3.5 | $1.50 | $0.15 | $7.50 | Anterior modelo de razonamiento |
| Mistral Small 4 | $0.15 | $0.015 | $0.60 | Nivel económico |
| Ministral 3 14B | $0.20 | $0.02 | $0.20 | Modelo denso pequeño |
| Z.ai GLM 5.3 (alojado por Mistral) | $1.40 | $0.14 | $4.40 | Modelo de terceros |
Hay varias cosas que conviene saber antes de meter estas cifras en una hoja de cálculo:
- La oferta es exactamente un 50% de descuento, en los tres medidores. La ficha del modelo Large 4 muestra el mismo patrón tachado y no da fecha de fin.
- El propio post de lanzamiento de Mistral cita el precio de lista. El anuncio de Mistral Large 4 indica $1.36 / $4.18, así que la oferta es una promoción añadida encima, no el precio "real".
- La entrada en caché es un 90% de descuento. $0.07 frente a $0.68 en oferta. Importa más de lo habitual para este modelo, y explico por qué más abajo.
- Large 4 cuesta más por token que Large 3. El precio de lista pasó de $0.50 / $1.50 a $1.36 / $4.18, aproximadamente 2.7x en entrada y 2.8x en salida. Incluso en oferta es un 36% más en entrada y un 39% más en salida.
Para la historia de cómo llegó Mistral hasta aquí, mi repaso de los nuevos modelos de Mistral cubre los lanzamientos de Large 3 y Medium 3.5.
Qué significa realmente "precio de oferta" en un modelo en preview
Large 4 es una Public Preview en la API de Mistral, y esa etiqueta cambia cómo debes leer el precio. La política de ciclo de vida de modelos de Mistral dice tres cosas sobre los modelos en preview que importan a un comprador:
- Tienen el mismo precio que los modelos con General Availability. Así que la oferta no es un "descuento de preview" que desaparezca en GA por diseño. Es una promoción aparte.
- No tienen un camino garantizado a General Availability, y pueden retirarse antes de llegar.
- El aviso de retirada de un modelo en preview es de 1 mes, frente a 6 meses para un modelo GA. Una vez retirado, las solicitudes devuelven un
404. Todo junto, la cifra segura para planificar es el precio de lista, más un plan de migración que puedas ejecutar en cuatro semanas. El cofundador de Mistral, Guillaume Lample en X, ya ha dicho que la versión final está en camino:
"The RL run behind this preview is still in flight and shows no sign of saturation -- we will release a final version before the end of the month along with the weights of the model."
El documento de ciclo de vida también señala que los modelos en preview no pueden usar un alias -latest, y que los alias "may expose you to silent updates in model behavior and pricing." Mi consejo es el mismo que doy para cualquier modelo en producción: fija el identificador exacto de versión y vuelve a calcular el precio cuando cambies.
Un token, cuatro precios: batch, standard, regional y Priority
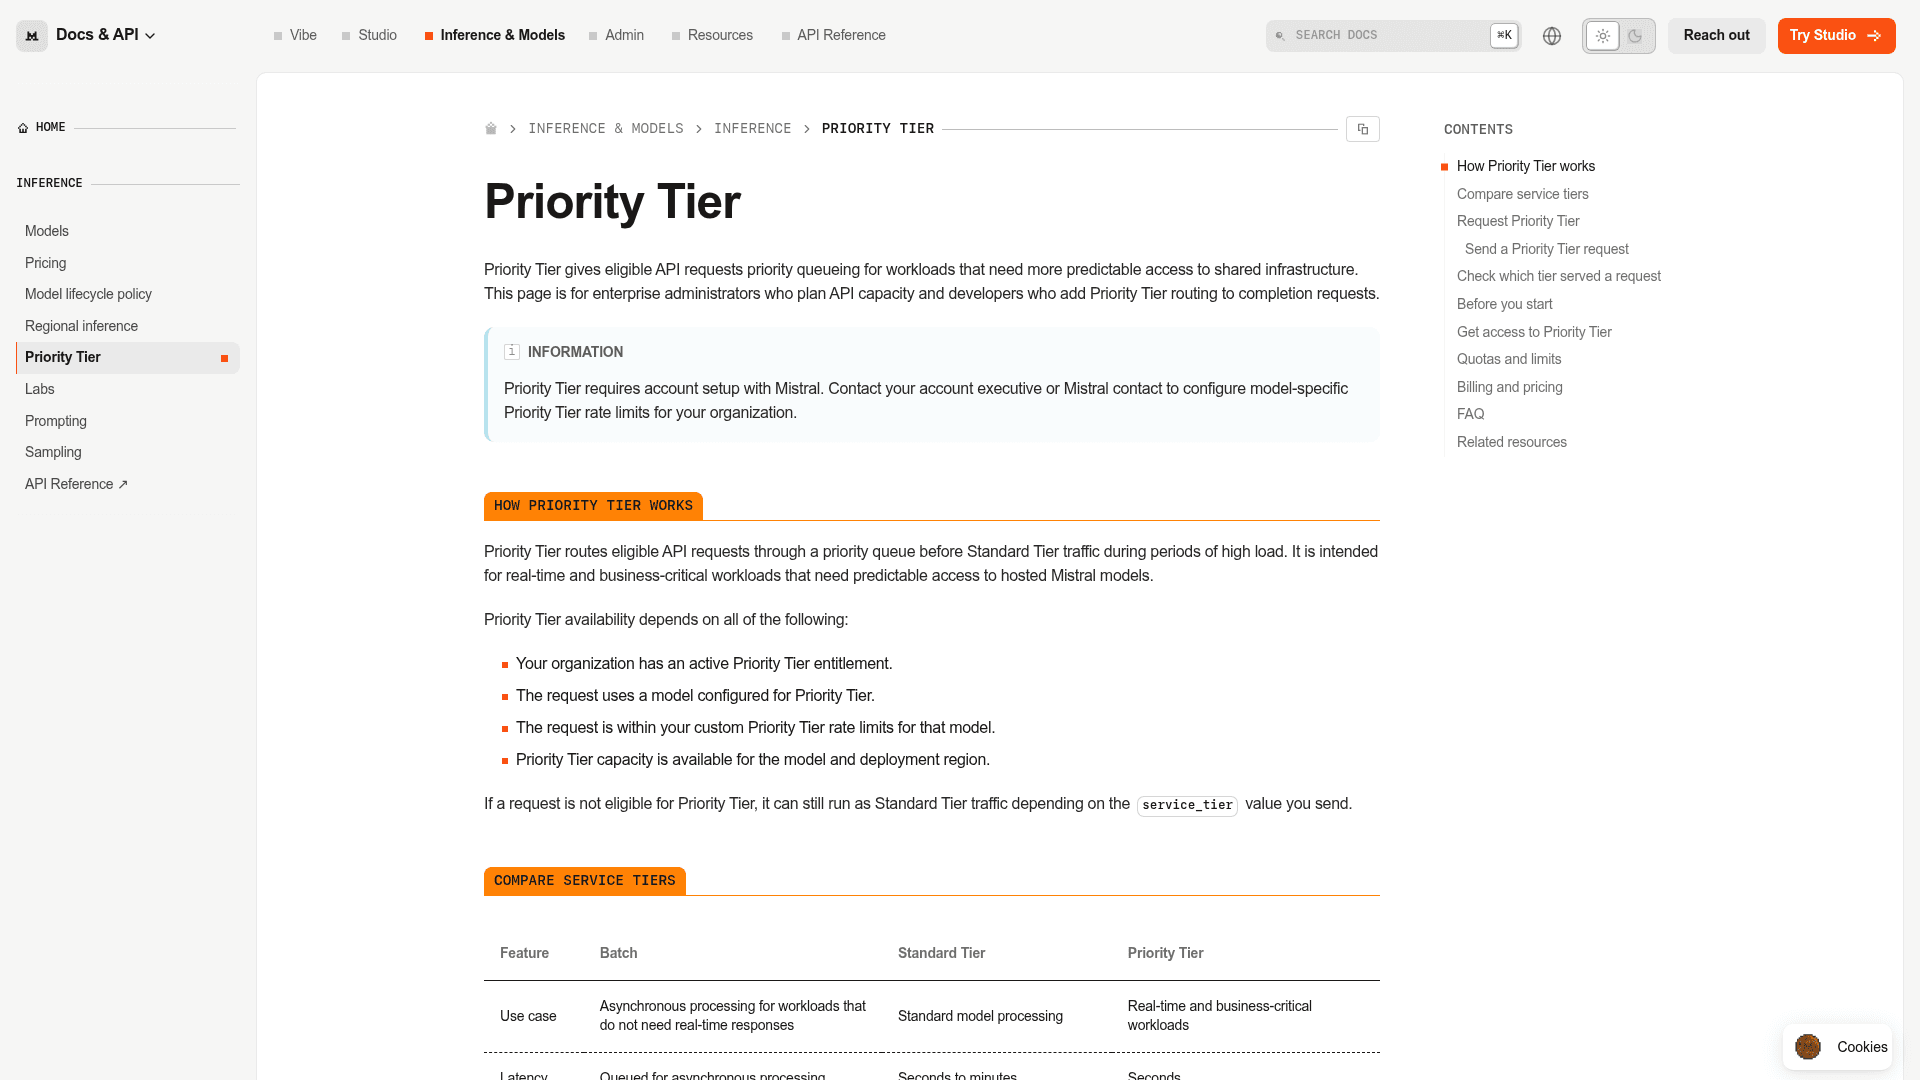
La página de precios tiene pestañas Standard, Batch y Priority, además de un selector de inferencia regional, mientras que los multiplicadores están en páginas de documentación separadas. La mayor parte de la cobertura de los precios de Mistral Large 4 se salta esta parte, y aquí la factura puede más que triplicarse.
| Nivel | Cómo se calcula | Entrada / caché / salida por 1M | Latencia | SLA de disponibilidad |
|---|---|---|---|---|
| Batch | 50% de descuento | $0.34 / $0.035 / $1.045 si se suma a la oferta; $0.68 / $0.07 / $2.09 sobre la lista | En cola, hasta 24 horas | Ninguno |
| Standard (oferta) | Promoción de lanzamiento | $0.68 / $0.07 / $2.09 | De segundos a minutos | Ninguno |
| Standard (lista) | Tabla de tarifas | $1.36 / $0.14 / $4.18 | De segundos a minutos | Ninguno |
| Regional (UE o EE. UU.) | 1.1x lista estándar | $1.496 / $0.154 / $4.598 | De segundos a minutos | Ninguno |
| Priority Tier | 1.75x lista estándar | $2.38 / $0.245 / $7.315 | Segundos | 99.5% |
Las fuentes de cada fila:
- Batch. La documentación de procesamiento batch de Mistral promete "a 50% discount" y hasta 1 millón de solicitudes por lote. La documentación no dice si ese descuento se aplica al precio de oferta o al de lista. Fíjate en que el 50% sobre la lista cae exactamente en el precio de oferta actual.
- Inferencia regional. La página de inferencia regional dice que se factura "billed at 1.1× standard list pricing (a 10% upcharge) for input tokens, output tokens, cached reads, and cache writes." Las regiones actuales son la UE y EE. UU.
- Priority Tier. La página de Priority Tier dice que el multiplicador "is 1.75x standard list pricing." Requiere configurar la cuenta a través de ventas, vuelve a Standard cuando superas tus límites y es el único nivel con SLA de disponibilidad.
Esto importa más para Mistral que para la mayoría de proveedores. La razón más fuerte que da la gente para elegir Mistral es que es europeo. El propio post de lanzamiento de Mistral en X empieza por ahí:
"Forged in Europe end-to-end and is deployable from Europe via our own Mistral Cloud infrastructure."
Pero el endpoint que garantiza que la inferencia se ejecuta dentro de la UE es el regional, y su multiplicador de 1.1x se expresa sobre el precio de lista. Ambas páginas de documentación están redactadas en términos generales y no dicen nada de la oferta de Large 4, así que Mistral podría aplicar en la práctica el multiplicador a la tarifa con descuento. No presupuestaría con eso. Si la residencia es la razón de la compra, presupuesta aproximadamente 2.2x el precio del titular hasta que tu factura diga otra cosa.
La misma lógica vale para un equipo de soporte que necesita un SLA. Priority Tier es la única opción que lo tiene, y a 1.75x de la lista son $7.32 por 1M de tokens de salida y $2.38 de entrada. Esa tarifa de entrada es mayor que los $2 con los que empiezan los precios de Claude Sonnet 5.5, y la de salida está mucho más cerca de los $10 de Sonnet que de los $2.09 del titular.
Por qué el precio por token subestima la factura
Las tablas de tarifas comparan modelos por token, pero tu factura los compara por trabajo. En los modelos de razonamiento, las dos clasificaciones no coinciden. Un modelo de razonamiento escribe un borrador interno largo antes de responder, y pagas tarifa de salida por cada palabra.
Artificial Analysis ejecutó el Intelligence Index completo sobre Mistral Large 4 Preview y publicó un desglose de costes. A precio de lista, toda la ejecución costó $1,601.97, y así se repartió el dinero:
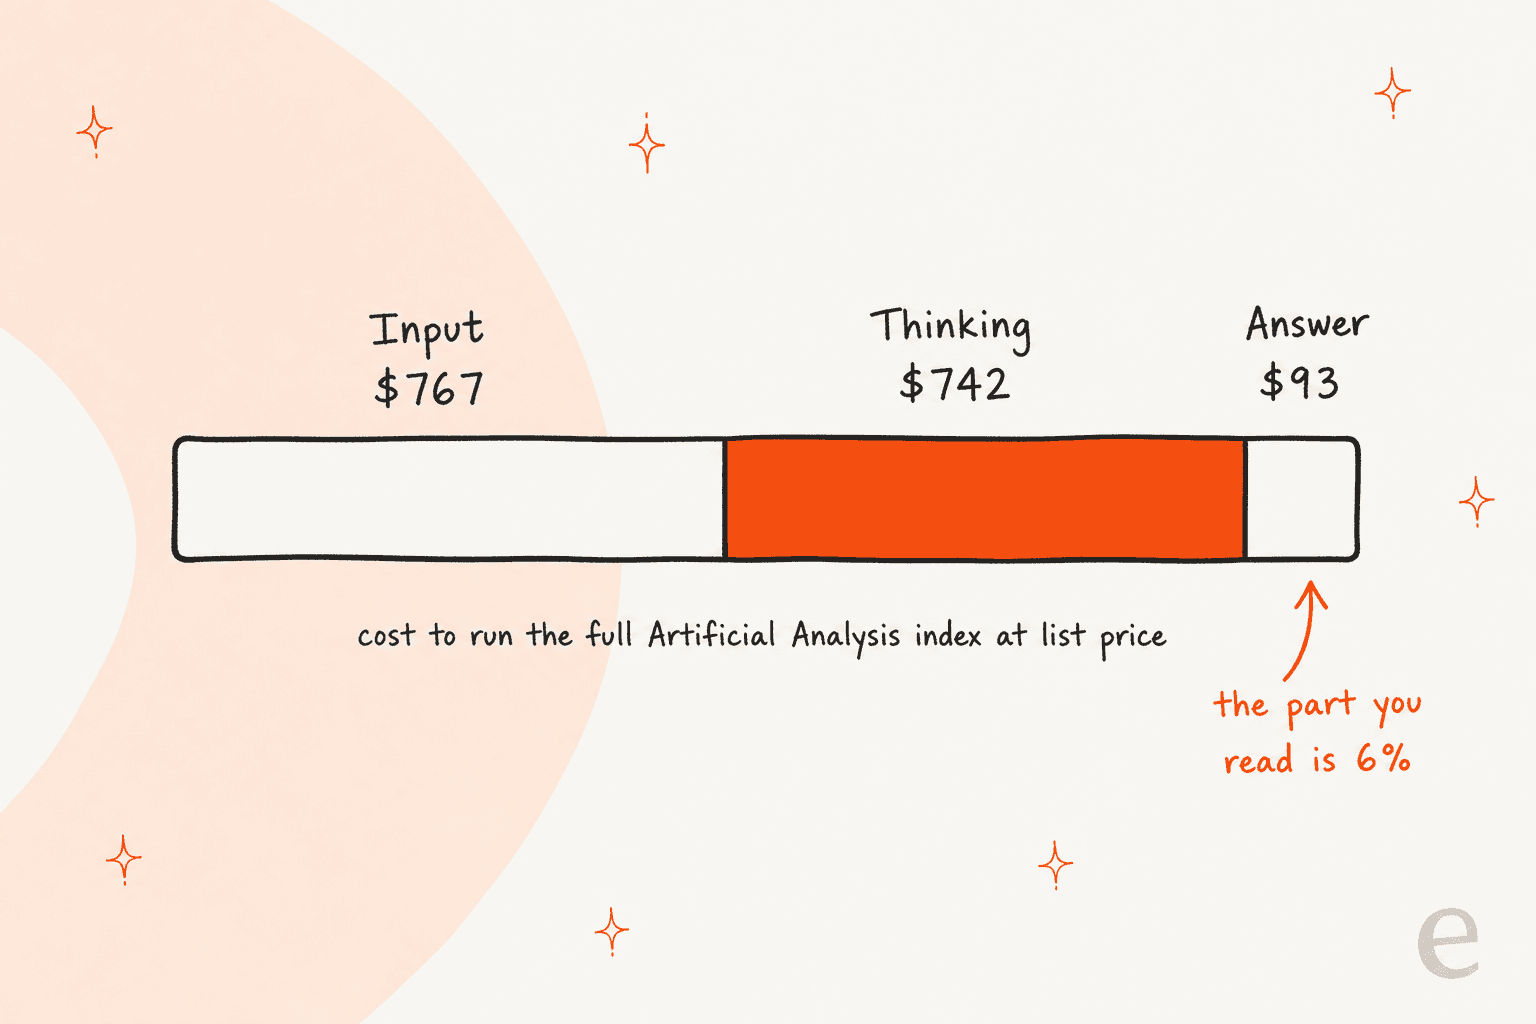
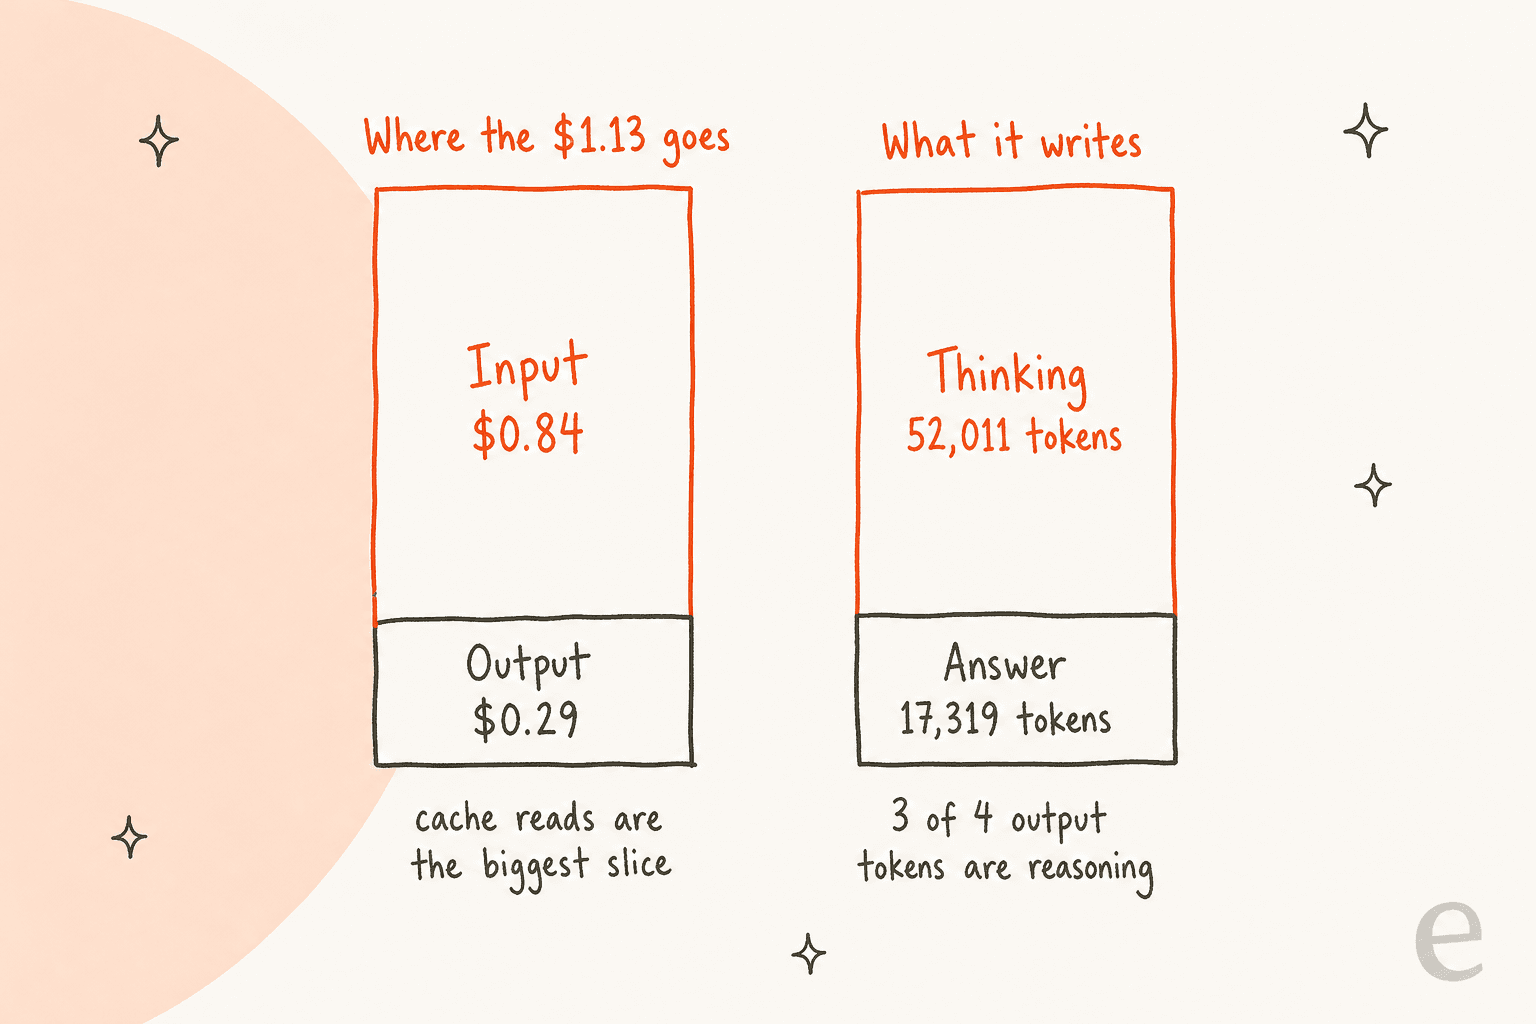
- Salida de razonamiento: $742.45. Large 4 promedió 69,330 tokens de salida por tarea, y 52,011 de ellos, el 75%, eran razonamiento.
- Entrada: $766.79, de los cuales $479.04 fueron lecturas de caché. Las tareas agénticas largas reenvían su contexto en cada turno, y por eso merece la pena diseñar para el descuento de caché del 90%.
- La respuesta que realmente lees: $92.73. Eso es menos del 6% de la factura.
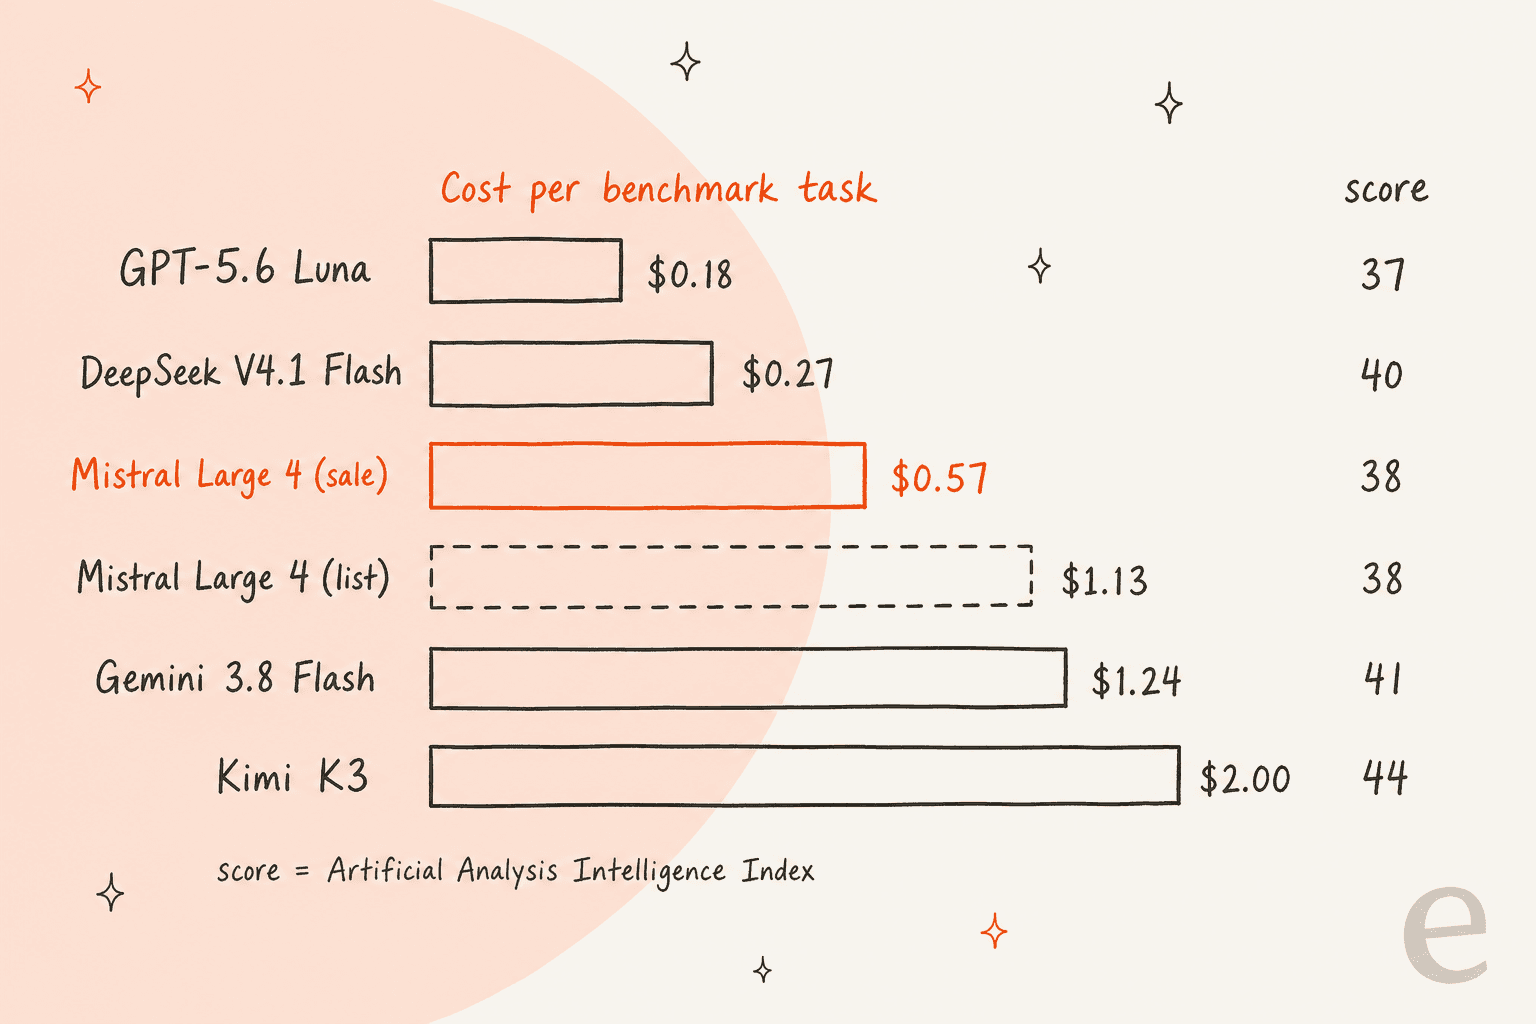
La unidad útil es entonces el coste por tarea. Artificial Analysis sitúa a Large 4 en $1.13 por tarea del índice a precio de lista, lo que equivale a unos $0.57 con la tarifa de oferta si cada medidor se reduce a la mitad. A su lado, la tabla compara modelos que quedan cerca en el mismo índice.
| Modelo | Intelligence Index | Precio entrada / salida por 1M | Coste por tarea del índice | Tokens de salida por tarea |
|---|---|---|---|---|
| GPT-5.6 Luna (Max) | 37.3 | $0.20 / $1.20 | $0.178 | 41,235 |
| DeepSeek V4.1 Flash (Max) | 39.5 | $0.30 / $1.20 | $0.265 | 88,574 |
| Mistral Large 4 Preview (oferta, derivado) | 38.4 | $0.68 / $2.09 | ~$0.57 | 69,330 |
| Mistral Large 4 Preview (lista) | 38.4 | $1.36 / $4.18 | $1.132 | 69,330 |
| Gemini 3.8 Flash (High) | 40.9 | $0.75 / $3.75 | $1.243 | 71,003 |
| Kimi K3 (Max) | 43.6 | $3 / $15 | $2.000 | 48,455 |
| Claude Sonnet 5.5 (Xhigh) | 51.9 | $2 / $10 | $2.012 | 74,810 |
Todas las cifras vienen de la página de Artificial Analysis de cada modelo, consultadas el 8 de octubre de 2026; la fila con la tarifa de oferta es cálculo mío. Mi lectura es que, incluso en oferta, Large 4 cuesta por tarea cerca del doble que DeepSeek V4.1 Flash con una puntuación a un punto de distancia (las tarifas del modelo anterior están en mi guía de precios de DeepSeek V4 Flash). Es más barato por tarea que Kimi K3, pero Kimi puntúa 5 puntos más. Lo mismo vale para Gemini 3.8 Flash, cuyas tarifas están en mi guía de precios de Gemini 3.8 Flash.
Los lectores de Hacker News notaron la misma tensión el día del lanzamiento. Un comentarista valoró la tabla de tarifas pero no quedó convencido:
"The pricing ($.68 in/$.07 cached/$2.09 out) makes it much cheaper than Kimi K3, GLM 5.3, and Meta Muse Spark 1.3. That's great! But also much more expensive than GLM 5.3-flash and Spark 1.3 Contributor (the Meta-takes-your-data pricing of Spark 1.3)."

Otro comentarista señaló un benchmark distinto, donde el coste por prueba fue en sentido contrario incluso frente a un rival más caro por token:
"Otherwise, behind on the broader Pareto frontier, but not by much (Vals Index: 48.05% vs. GLM-5.3's 53.51%; $13.78 vs. $7.25 per test). Many companies will prefer it over Chinease models."
Esa segunda cita es toda la lección en una línea: GLM 5.3 cuesta más por token en la propia lista de precios de Mistral ($1.40 / $4.40 frente a la lista de $1.36 / $4.18) y aun así salió más barato por prueba en esa ejecución, porque usó menos tokens para llegar.
Calculadora de costes de Mistral Large 4
Introduce tu propio tráfico. La calculadora usa las tarifas publicadas por 1M de arriba, aplica los multiplicadores regional y Priority al precio de lista como describe la documentación de Mistral, y trata batch como un 50% sobre la tarifa de oferta. Los tokens de salida deben incluir el razonamiento, que en Large 4 ha rondado unos 3 tokens de razonamiento por cada token de respuesta en Artificial Analysis.
Ejemplos prácticos: cuánto costarían tres cargas de trabajo reales
Los números abstractos son fáciles de asentir sin más. Estas son cargas de trabajo que esperaría que alguien calculara, pasadas por las tarifas publicadas.
| Carga de trabajo | Supuestos | Oferta | Lista | Regional | Priority |
|---|---|---|---|---|---|
| Chatbot de soporte | 20,000 conversaciones/mes, 8,000 tokens de entrada cada una (70% en caché), 1,200 tokens de salida | $90.64 | $181.28 | $199.41 | $317.24 |
| El mismo bot, sin caché | Como arriba, 0% en caché | $158.96 | $317.92 | $349.71 | $556.36 |
| Tareas agénticas | 1,000 tareas/mes del tamaño del índice de Artificial Analysis | ~$566 | $1,132 | ~$1,245 | ~$1,981 |
| Procesamiento batch de documentos | 1M de documentos, 3,000 tokens de entrada + 500 de salida cada uno | $3,085 | $6,170 | n/a | n/a |
Tres conclusiones de esa tabla:
- El caché vale más que la oferta. En el bot de soporte, activar el caché a precio de lista ($181) casi iguala el precio de oferta sin caché ($159). Si estructuras los prompts de modo que el prompt de sistema y los fragmentos de la base de conocimiento estén al principio y se mantengan estables, conservas la mayor parte de ese ahorro cuando termine la oferta.
- La elección del nivel mueve la factura más que la del modelo. El mismo bot va de $91 a $317 al mes solo según qué nivel de Mistral lo sirva.
- El trabajo batch de documentos es donde brilla la oferta de Large 4. Si el descuento batch se suma al precio de oferta, ese trabajo de 1M de documentos baja a unos $1,542. Si no, queda en $3,085, que sigue siendo la tarifa de oferta.
Planes Vibe: ¿necesitas la API siquiera?
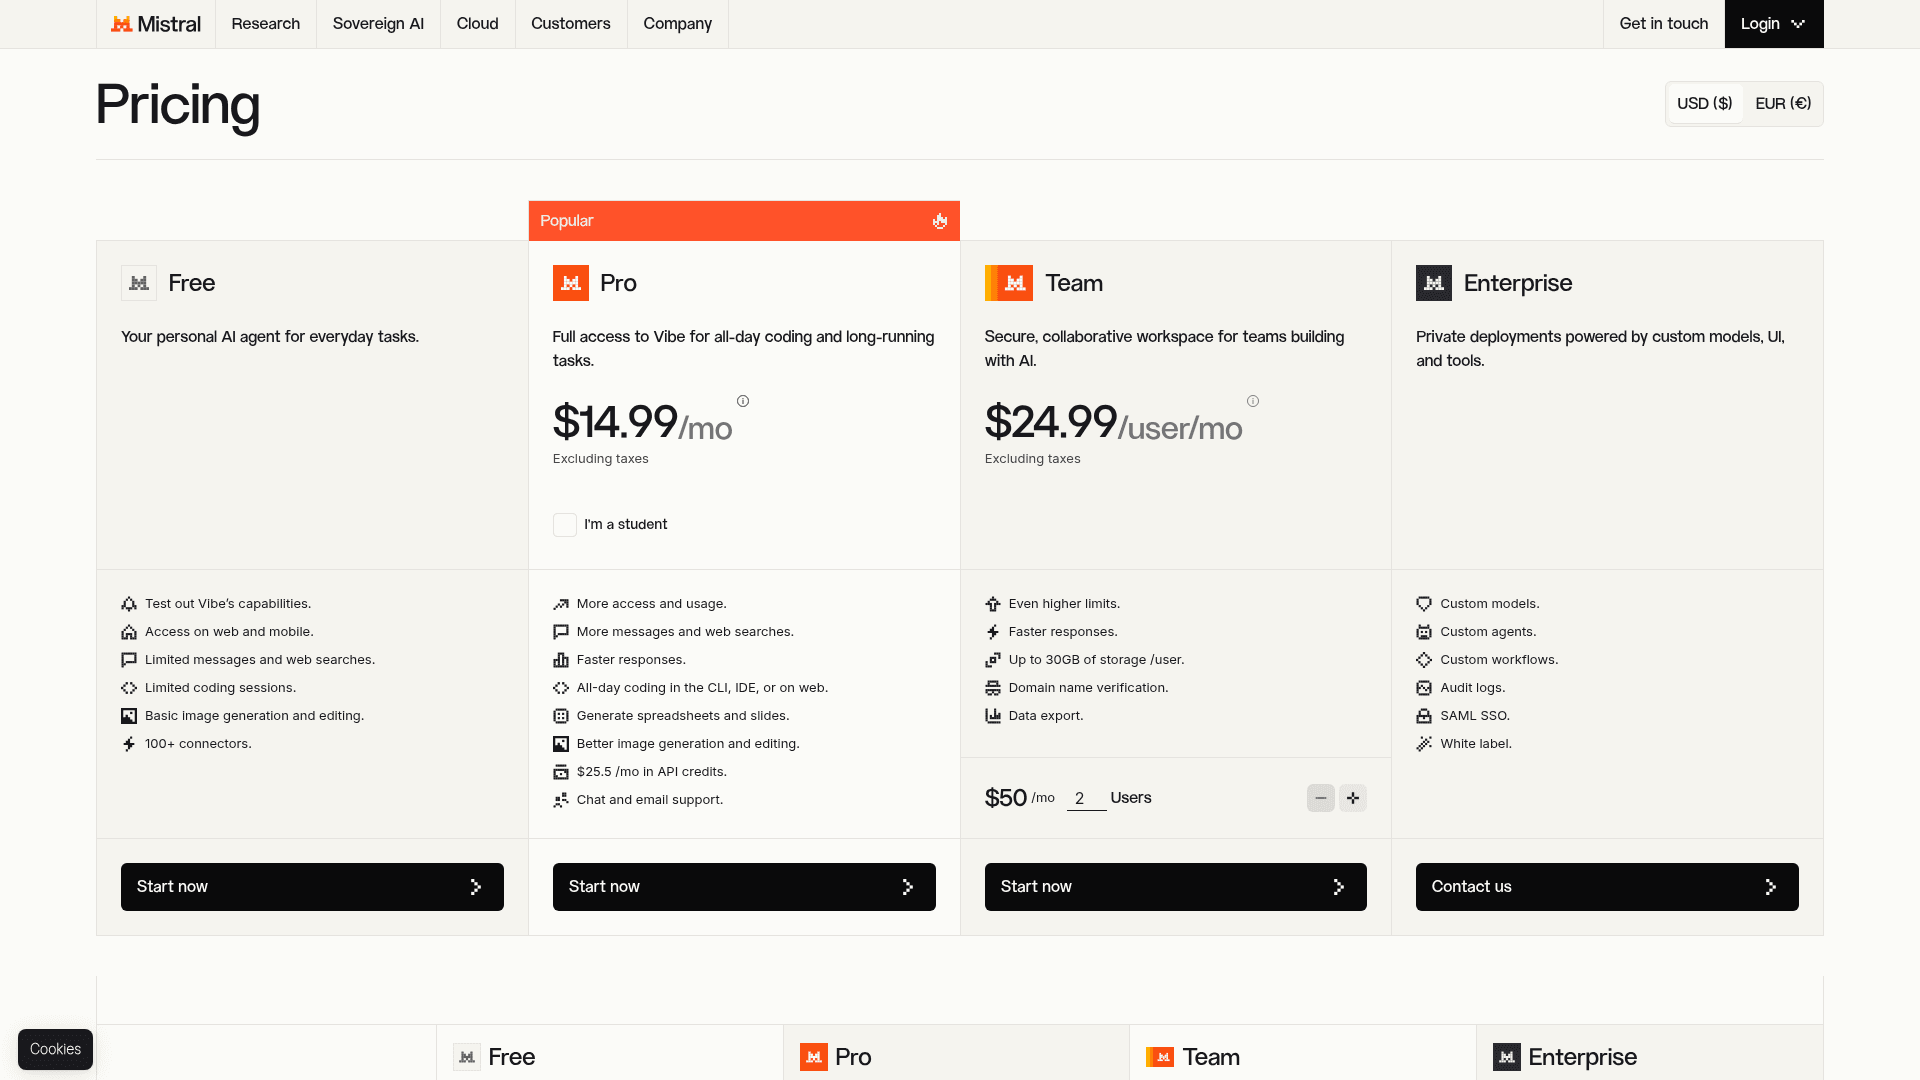
Si solo quieres usar los modelos de Mistral para tu trabajo en lugar de construir sobre ellos, el lado de consumo es Vibe (el producto antes conocido como Le Chat). Precios de la página de precios de Mistral:
| Plan | Precio | Qué incluye |
|---|---|---|
| Free | $0 | Mensajes, búsquedas web y sesiones de programación limitados, más de 100 conectores, acceso a Mistral Studio |
| Pro | $14.99/mes | Más uso, programación todo el día en CLI, IDE o web, $25.50/mes en créditos de API |
| Pro (estudiantes) | $5.99/mes | Estudiantes verificados; $15/mes en créditos de API |
| Team | $24.99/usuario/mes | Límites más altos, hasta 30GB de almacenamiento por usuario, verificación de dominio, exportación de datos; la calculadora de la página empieza en 2 usuarios ($50/mes) |
| Enterprise | Contactar con ventas | Modelos y agentes personalizados, registros de auditoría, SAML SSO, marca blanca |
Un detalle que conviene señalar: el plan Pro incluye $25.50 al mes en créditos de API. A la tarifa de oferta son unos 12M de tokens de salida de Large 4, de sobra para hacer prototipos antes de comprometerte con la API. Lo que la página no dice es qué planes de Vibe ejecutan Large 4 en la propia app de chat, así que no des por hecho que Free recibe el modelo insignia. Mi repaso de opiniones sobre Mistral AI y la comparación ChatGPT vs Mistral cubren Vibe como espacio de trabajo con más detalle.
Autoalojamiento: el precio cuando salgan los pesos
Mistral dice que Large 4 es de pesos abiertos, con los pesos previstos para "end of October." Hoy no hay licencia nombrada ni pesos públicos, así que el precio del autoalojamiento sigue siendo una previsión. Dos hechos la condicionan.
Primero, el tamaño. La ficha del modelo indica 1.05T de parámetros totales y 52B activos, más un codificador de visión de 1.6B. Ejecutar un modelo de 1T de parámetros requiere un servidor multi-GPU, no un portátil. La respuesta con más likes al tuit de lanzamiento de Mistral lo expresó mejor de lo que yo podría:
"me with 12 GB of VRAM reading "open weights, 1.05T parameters""
Segundo, la licencia. Las preguntas frecuentes de precios de Mistral dicen que sus modelos de pesos abiertos son "Apache 2.0 licensed for research/individual use; while commercial deployments require a Mistral license with separate terms." Esa frase está escrita sobre modelos más antiguos como Mistral 7B, y la licencia de Large 4 no se ha publicado, pero es un motivo para no dar por hecho que "pesos abiertos" signifique "gratis para uso comercial". Si tu plan es autoalojar, espera al texto de la licencia antes de calcular las GPU. Mientras tanto, los agentes de IA de código abierto basados en modelos ya publicados son la apuesta más segura.
¿Vale la pena el precio de Mistral Large 4?
La respuesta depende de cuál de las fortalezas de Mistral estés pagando, así que sería concreto.
Vale la pena si:
- Necesitas inferencia alojada en la UE de un proveedor europeo. Es el caso más claro, e incluso a 1.1x de la lista pagas $4.60 por 1M de tokens de salida, que sigue muy por debajo de la mayoría de los modelos de frontera de EE. UU. Un comentarista de Reddit en r/singularity lo planteó con claridad:
"In most corporate workflows, it is probably good enough. And you don't have to sell your soul to Xi or Trump. As a european, I had feared much worse."

- Tu trabajo coincide con sus fortalezas en benchmarks. Los gráficos de Mistral lo muestran liderando en ciberdefensa y en el benchmark de agente legal de Harvey, y Lample dice que puntúa un 82% en reproducción y parcheo de vulnerabilidades. Para esos trabajos, $0.57 por tarea es buen valor.
- Vas a ejecutar grandes trabajos batch durante la oferta. El trabajo con documentos de contexto largo a $0.68 de entrada es barato, y Artificial Analysis puntúa su razonamiento de contexto largo en 81.3%.
Descártalo si:
- Quieres el modelo más barato con este nivel de inteligencia. DeepSeek V4.1 Flash y GPT-5.6 Luna llegan a un punto de distancia por entre un tercio y la mitad del coste por tarea. Mi reseña de DeepSeek V4 Flash cubre el lado de DeepSeek. Para los niveles de OpenAI, consulta los precios de GPT-5.6.
- La precisión factual importa. Artificial Analysis midió una tasa de alucinación del 41.9% en su prueba de conocimiento AA-Omniscience. Para cualquier cosa de cara al cliente, eso significa basar cada respuesta en tus propios documentos con RAG.
- Necesitas precios estables durante un año. Un modelo en preview con aviso de retirada de 1 mes y una oferta sin fecha es un objetivo móvil.
Para una visión más amplia de cómo se compara Large 4, consulta mi resumen de Mistral Large 4 o la lista de alternativas a Mistral.
Si estás eligiendo entre proveedores en lugar de modelos, Claude vs Mistral compara los productos completos. También lo hace mi análisis de Gemini vs Mistral.
Lo que el precio por token deja fuera para los equipos de soporte
Mucha gente que valora Large 4 esta semana lo hace para un solo trabajo: un bot de soporte. Si ese eres tú, la tabla de arriba ya muestra la parte incómoda. Incluso con tarifas Priority, la factura del modelo para 20,000 conversaciones son unos cientos de dólares. Lo caro es todo lo que rodea al modelo: la recuperación de información, los fallbacks, las pruebas, la conexión con el helpdesk y también la persona que mantiene todo.
Ese es el intercambio que describió Karel, de GENERAL BYTES, cliente de eesel, cuando decidieron no construirlo ellos mismos:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Lo otro que un modelo más barato no arreglará es un bot que responde cuando no debería. Con una tasa de alucinación del 41.9% en preguntas de conocimiento, los controles importan más que la tabla de tarifas: responder solo desde tus propios documentos, pasar a una persona cuando hay dudas con un human in the loop y probar con tickets pasados reales antes de salir en producción. Mi artículo sobre las alucinaciones de la IA en soporte cubre los modos de fallo.
Si todavía estás en la fase de elegir modelo, mis guías sobre el mejor LLM para soporte y cómo entrenar un agente de soporte con IA profundizan en ambas mitades del trabajo.
A mi modo de ver, el modelo es infraestructura, y lo que un equipo de soporte quiere contratar es al empleado que lo usa. Para una visión más amplia de esa categoría, consulta el repaso del mejor software de helpdesk con IA.
Prueba eesel
Si llegaste aquí valorando Mistral Large 4 para un bot de soporte, hay un atajo. El compañero de helpdesk con IA de eesel se une a tu cola existente de Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y tu centro de ayuda, y ejecuta una simulación contra cientos de tus tickets pasados antes de responder a un cliente. Se factura por ticket gestionado, desde $299 por 500 créditos en la página de precios, así que si el modelo de debajo piensa 1,000 o 50,000 tokens es problema de eesel, no de tu factura. Dos notas honestas: eesel funciona con modelos de OpenAI, Anthropic y Google, no de Mistral, y la residencia de datos en la UE es un complemento de $500/mes.

Los desarrolladores también pueden configurarlo desde una terminal: la CLI de eesel imprime JSON en cada comando, así que Claude Code o Cursor pueden conectar tu helpdesk, editar instrucciones y ejecutar chats de prueba por ti. El plan gratuito incluye 100 créditos sin tarjeta. Prueba eesel.