

GLM-5.3-Flash es el modelo GLM-5 más barato de Z.ai, y el precio es el titular. Con un 50 % de descuento de lanzamiento cuesta $0.075 por millón de tokens de entrada y $0.25 por millón de tokens de salida, con entrada en caché a $0.015. La unidad de cobro son tokens simples, así que no hay sorpresas por resolución ni por usuario. Dos cosas confunden a la gente: la promo termina el 9 de septiembre de 2026, y después todas las tarifas se duplican al precio de lista de $0.15/$0.50, y GLM-5.3-Flash no es el modelo estrella. El GLM-5.3 solo de texto es otro modelo, a $1.40/$4.40, unas diez veces más caro.
Si prefieres suscribirte en lugar de medir tokens, el GLM Coding Plan empieza en $18/mes (Lite) y llega hasta $168/mes (Max) para usar dentro de Claude Code, Cursor y herramientas similares.
Un detalle que no aparece en la etiqueta: en la API de Z.ai el modelo es lento (~49 tokens/seg). Proveedores externos como Databricks sirven los mismos pesos a 273 tokens/seg, así que dónde lo ejecutas cambia tu costo real tanto como la tarifa publicada. Y recuerda que una tarifa te compra tokens, no un sistema que funcione. Si quieres una IA que realmente responda tickets o escriba artículos dentro de tus propias herramientas, esa es la capa de compañero de equipo de eesel, que se apoya en modelos como este.
El resto de esta publicación recorre la tarifa completa, el precipicio de la promo, los planes de programación y un par de ejemplos prácticos para que veas cuánto cuesta una carga de trabajo real.
GLM-5.3-Flash llegó en agosto de 2026 como el primer modelo nativamente multimodal de la línea GLM-5 de Z.ai (Zhipu AI), y la reacción en línea giró sobre todo en torno a una cosa: la incredulidad ante el costo. Artificial Analysis lo estimó en unos $0.045 por tarea, y los hilos de Reddit lo comparaban favorablemente con modelos varias veces más caros. Así que hagamos lo que las publicaciones de lanzamiento no hicieron: detallar exactamente lo que pagas, dónde están las trampas y qué compra realmente ese número.
Esta es la tarifa real tal como aparece en la documentación de precios de Z.ai.
Precios de GLM-5.3-Flash de un vistazo
El modelo se factura por uso, por millón de tokens, dividido en entrada, entrada en caché y salida. Aquí está el panorama completo, con las tarifas promocionales primero y los precios de lista al lado.
| Concepto | Tarifa promo | Tarifa de lista | Notas |
|---|---|---|---|
| Entrada | $0.075 / M | $0.15 / M | Tokens de prompt estándar |
| Entrada en caché | $0.015 / M | $0.03 / M | ~80 % menos que la entrada estándar |
| Almacenamiento de entrada en caché | Gratis | Gratis | "Limited-time free" |
| Salida | $0.25 / M | $0.50 / M | Incluye tokens de razonamiento |
| Búsqueda web | $0.01 / uso | $0.01 / uso | Herramienta integrada como complemento |
Fuente: la documentación de precios de la API de Z.ai.
Hay varias cosas que destacar. Los tokens de salida cuestan aproximadamente 3,3 veces más que los de entrada, y como GLM-5.3-Flash es un modelo que solo piensa (no se puede desactivar el razonamiento), cada solicitud gasta tokens de salida en su razonamiento interno antes de responder. Es normal en un modelo de razonamiento, pero significa que tu factura vive en la salida. Presupuesta según la tarifa de salida, no según la de entrada del titular.
El otro detalle es qué es GLM-5.3-Flash: un modelo de mezcla de expertos con 320B de parámetros totales y 18B activos, una ventana de contexto de 1M de tokens y visión nativa. Para un modelo que lee imágenes y mantiene un millón de tokens de contexto, un cuarto de dólar por millón de tokens de salida es sorprendentemente bajo.
Flash no es el modelo estrella (y la brecha de precio es enorme)
Esta es la confusión más común, así que conviene ser claros. GLM-5.3 y GLM-5.3-Flash son dos modelos distintos que casualmente comparten número de versión.
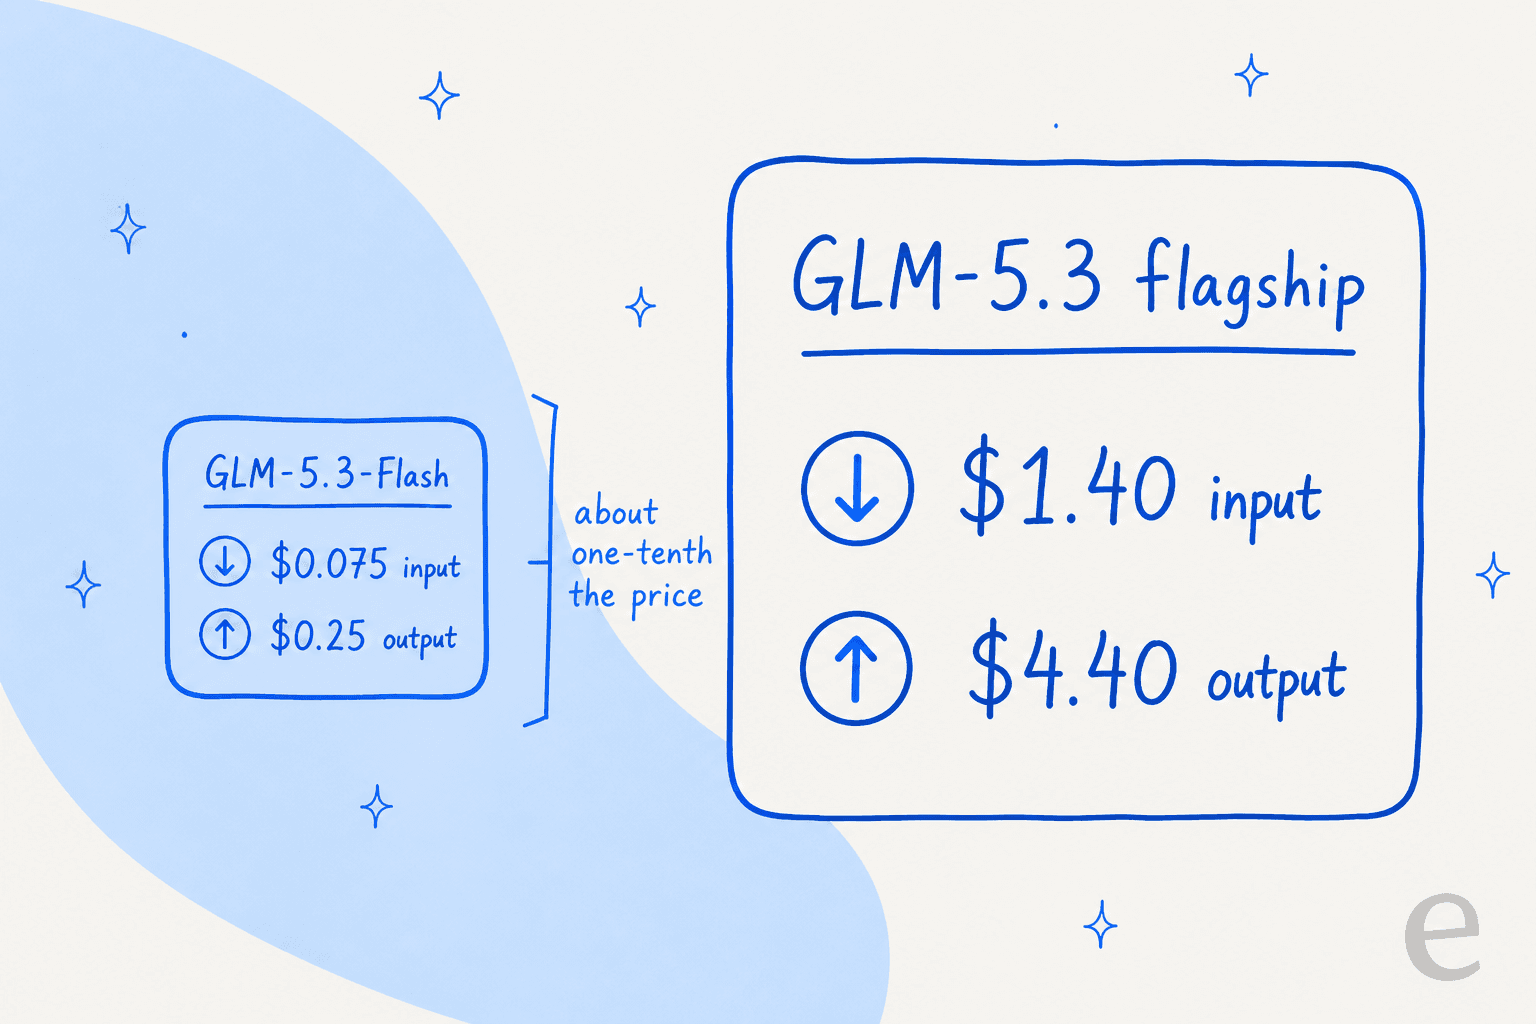
- GLM-5.3-Flash es el hermano barato, multimodal y de alto rendimiento. Es el de $0.075/$0.25.
- GLM-5.3 (el modelo estrella) es un modelo solo de texto para programación y ciberseguridad, y cuesta $1.40 de entrada / $4.40 de salida por millón.
Es una diferencia de aproximadamente diez veces. Si copias un precio de "GLM-5.3" de un sitio y una estimación de tokens de otro, puedes equivocarte por un orden de magnitud. La descripción de Cloudflare sobre Flash es el mejor resumen: "outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price."
Así que al calcular el costo de una carga de trabajo, la primera pregunta no es "¿cuántos tokens?", sino "¿qué GLM-5.3 estoy llamando realmente?". Para la mayoría de las tareas que no son de programación (chat, extracción, visión, resumen), Flash es el que quieres, y el tema de esta publicación. Si haces programación de frontera o investigación de seguridad, existe el modelo estrella, pero pagas tarifas de modelo estrella.
El precipicio de la promo: los precios se duplican el 9 de septiembre
Los números $0.075/$0.25 son un descuento de lanzamiento del 50 %, no el precio habitual. Según la documentación de precios de Z.ai, la promoción termina a las 24:00 del 9 de septiembre de 2026 (UTC+8, hora de Singapur). Después, la tarifa vuelve a los $0.15 de entrada / $0.50 de salida de lista.
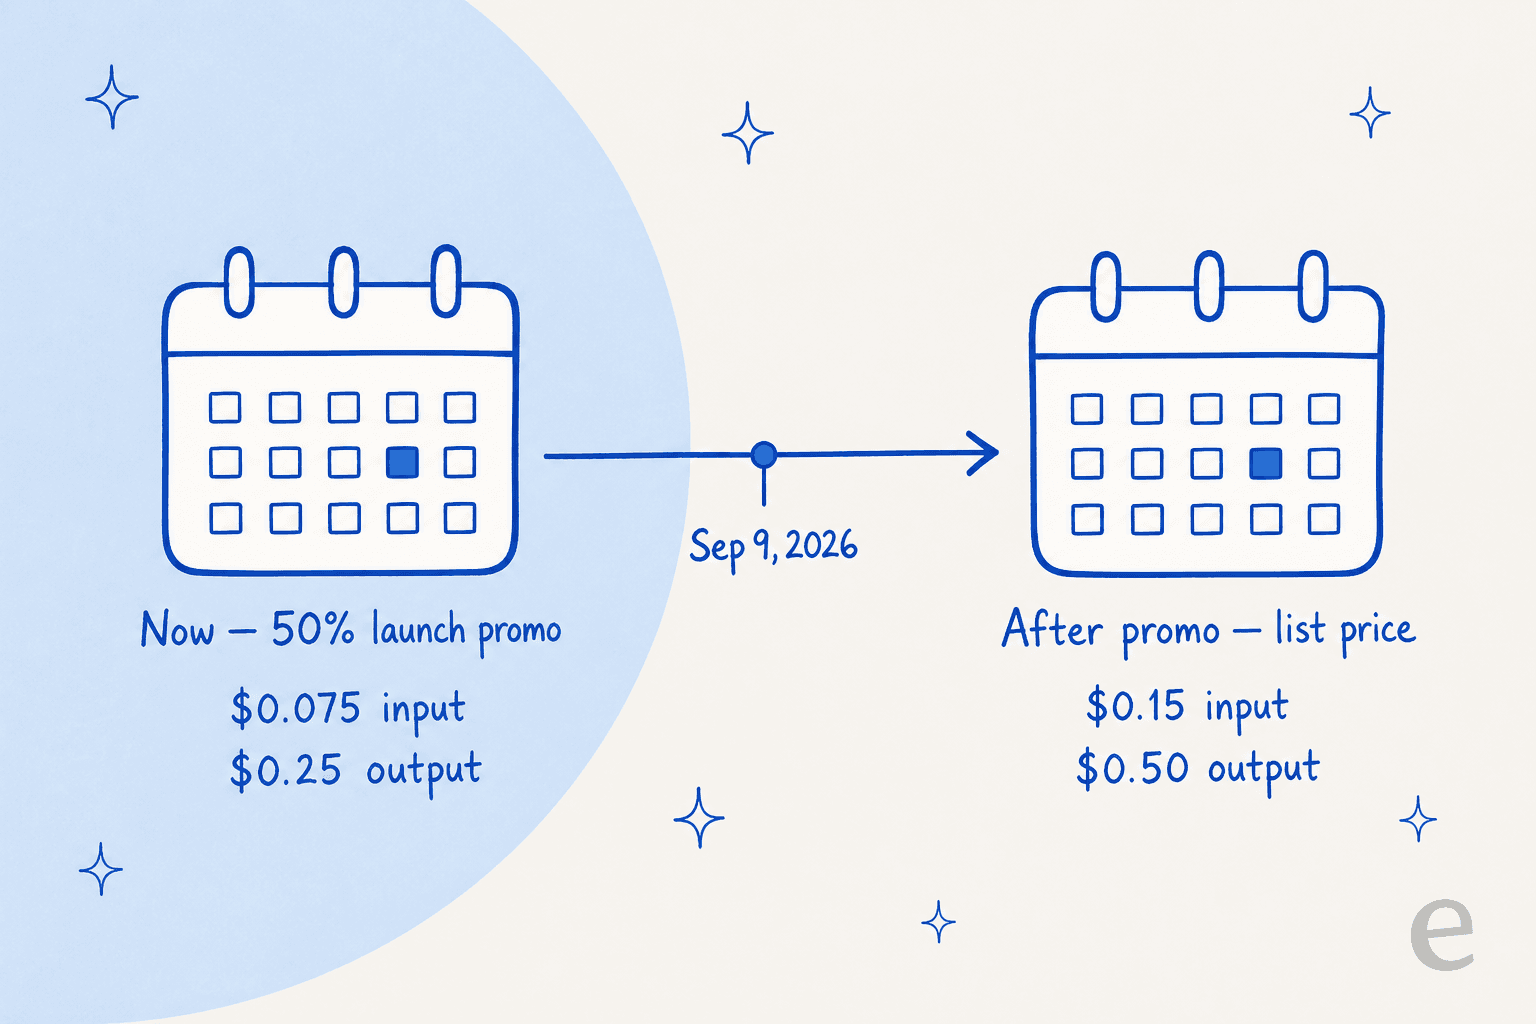
Duplicado, GLM-5.3-Flash sigue siendo barato con cualquier criterio razonable, así que no es motivo de pánico. Pero si construyes un modelo de costos para un producto que sale después de septiembre, usa los precios de lista, no los promocionales. Un presupuesto basado en $0.075 que en silencio necesita $0.15 se ve bien en una hoja de cálculo y duele en la primera factura posterior a la promo.
Entrada en caché y el complemento de búsqueda web
Dos palancas menores cambian tu tarifa efectiva.
La entrada en caché es la grande. Si tus prompts comparten un prefijo grande y estable (un prompt de sistema, una base de conocimiento, un documento largo sobre el que haces muchas preguntas), la parte repetida se factura a la tarifa de caché de $0.015/M durante la promo, aproximadamente un 80 % por debajo de la tarifa de entrada estándar. En cargas con mucha reutilización de prompts, es la diferencia entre una buena factura y una excelente. El almacenamiento de entrada en caché también es gratis por ahora.
La búsqueda web es una herramienta integrada que se factura aparte a $0.01 por uso. Es barata, pero se mide por llamada, así que un agente que busca en cada turno suma de una forma que las tarifas por token no muestran. Conviene vigilarlo si lo integras en un bucle.
El GLM Coding Plan: una suscripción en lugar de medir tokens
Si usas GLM sobre todo dentro de una herramienta de programación, Z.ai vende una suscripción fija que evita por completo la medición de tokens. El GLM Coding Plan ejecuta GLM-5.3 y GLM-5.3-Flash dentro de Claude Code, Cline, OpenCode, Cursor, Roo Code, Kilo Code y más de 20 herramientas de agentes.
Estos son los niveles individuales, con la tarifa mensual efectiva si pagas anualmente.
| Plan | Mensual | Anual (efectivo /mes) | Créditos semanales | Uso relativo |
|---|---|---|---|---|
| Lite | $18/mes | $12.60/mes | 10,000 | 1x |
| Pro | $80/mes | $56.00/mes | ~60,000 | 6x Lite |
| Max | $168/mes | $117.60/mes | ~140,000 | 14x Lite |
También hay dos niveles para equipos: un Standard Seat a $88/puesto/mes (66,000 créditos semanales) y un Premium Seat a $188/puesto/mes (155,000 créditos semanales, más acceso anticipado a modelos), según la página de suscripción de Z.ai.
La mecánica premia la paciencia. Los créditos se gastan mediante un multiplicador por modelo (GLM-5.3-Flash cuesta mucho menos por token que el modelo estrella), y el uso fuera de horas pico se cobra al 50 % de la tarifa estándar de créditos. La hora pico es solo de lunes a viernes, de 14:00 a 18:00 hora de Singapur, así que la mayor parte de la semana es fuera de pico. Z.ai afirma que apoyarse en las horas valle puede ahorrar hasta un 92 % frente a las llamadas de API del modelo estrella pagadas por uso. Es una cifra del proveedor, así que tómala como un techo, no como una promesa, pero la dirección es real: la suscripción apunta directamente a un uso intenso y diario de programación.
Los planes de programación son lo que la mayoría imagina al pensar en GLM en acción: un modelo procesando refactorizaciones y migraciones dentro de un agente.
El costo oculto: qué proveedor eliges
Aquí está lo que la tarifa publicada no te dice. GLM-5.3-Flash tiene pesos abiertos, así que puedes ejecutarlo en muchos lugares, y el rendimiento varía enormemente entre ellos. En la API propia de Z.ai, la salida corre a unos 49 tokens por segundo, algo que un hilo de Reddit llamó "one of the slowest models AA has ever" evaluado. Los proveedores externos son otra historia.
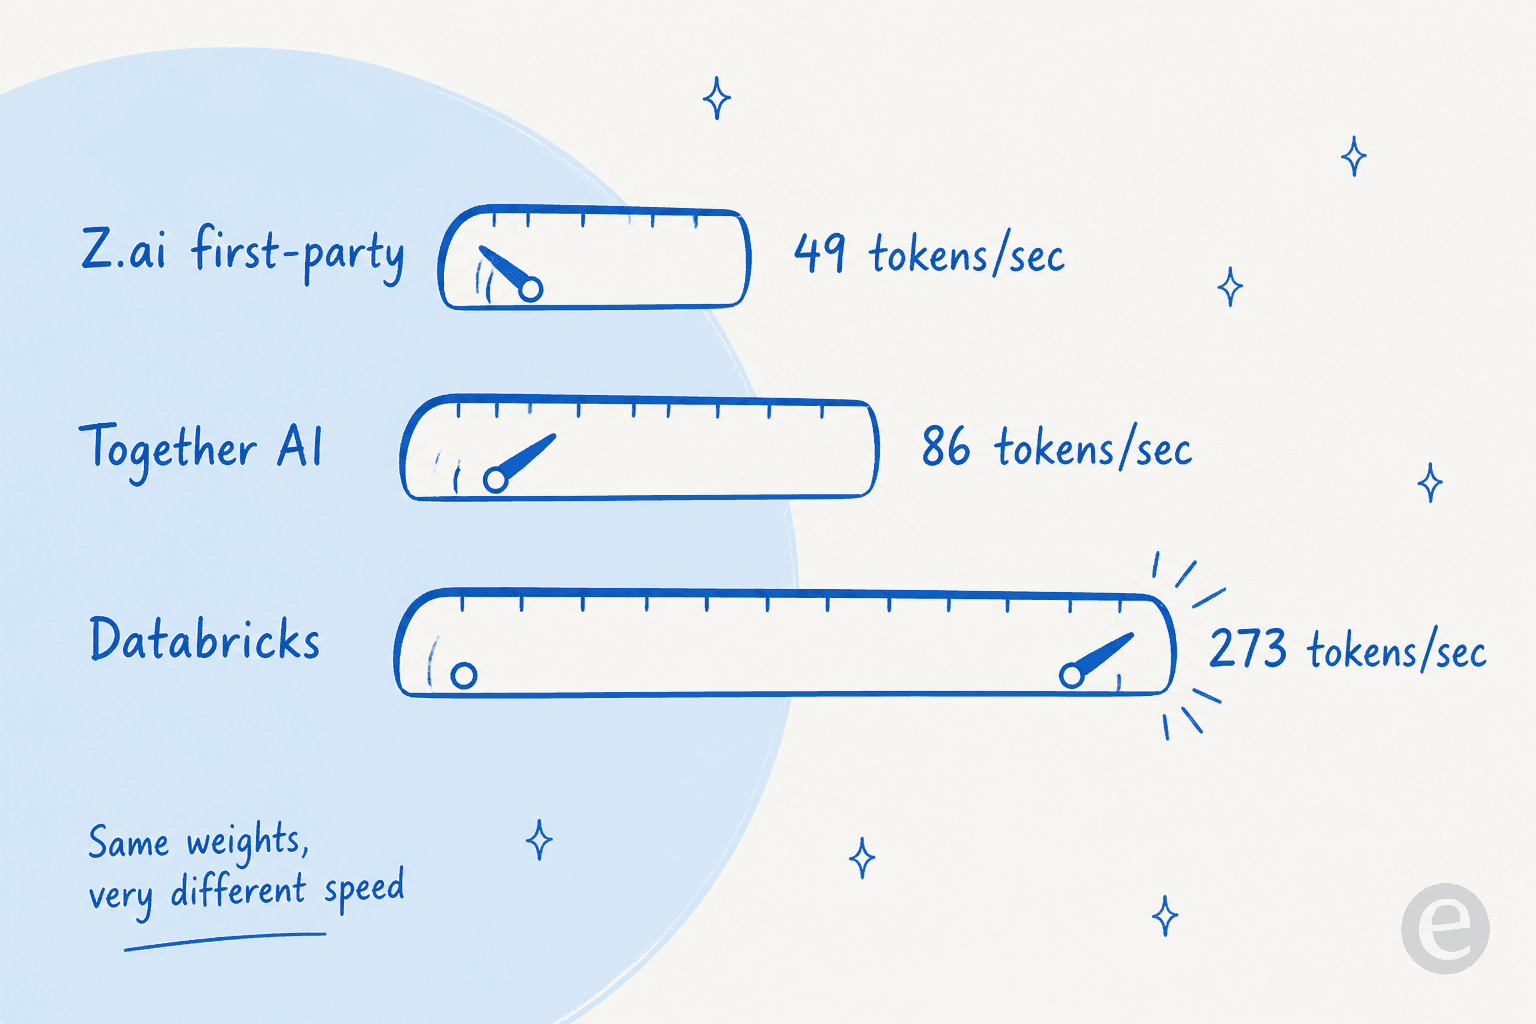
Según Artificial Analysis, entre once proveedores de API, Databricks sirve GLM-5.3-Flash a 272.9 tokens/seg con la latencia más baja (8 segundos hasta el primer token), mientras que los precios de lista más bajos provienen de GMI y Bitdeer, con unos $0.05. El punto no es que un proveedor sea el mejor. Es que "los precios de GLM-5.3-Flash" son en realidad una matriz de precio y velocidad, y para cualquier cosa de cara al usuario, el rendimiento también es un costo. Un modelo que cuesta la mitad pero es cinco veces más lento puede acabar siendo más caro si cuentas la latencia que tus usuarios (o tus agentes) esperan.
Si quieres el piso de precio puro, el proveedor propio o GMI. Si quieres velocidad a una tarifa razonable, un proveedor como Databricks. Elige el proveedor según si tu cuello de botella son los dólares o los segundos.
Qué compra realmente el precio bajo
Barato solo es bueno si el resultado es utilizable, así que conviene anclar la cifra en lo que el modelo puede hacer. En el Artificial Analysis Intelligence Index, GLM-5.3-Flash obtiene 57, frente a 60 del GLM-5.3 completo, lo que lo coloca justo en la frontera de precio-inteligencia. Los probadores lo respaldaron en casos concretos.
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Sobre su nueva capacidad de visión, un probador ejecutó 1,500 muestras y reportó 81 % de precisión, calificándola de razonable para un primer lanzamiento multimodal. Y la reacción sobre el precio frente a sus rivales fue el tema más fuerte de todos.
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Para una lectura más completa de sus capacidades, nuestro resumen de GLM-5.3-Flash profundiza en la arquitectura y los benchmarks, y si estás preseleccionando por costo vale la pena leerlo junto a nuestros desgloses de precios de DeepSeek y precios de Kimi K2.5. Pero a efectos de precios, la conclusión es simple: el modelo no es barato porque sea débil. Es barato porque Z.ai fijó un precio agresivo a un MoE de 18B activos y además subsidia el lanzamiento.
Un ejemplo práctico: cuánto cuesta una carga de trabajo real
Las tarifas por millón de tokens son difíciles de dimensionar, así que introduce tus propios números. Esta calculadora usa las tarifas promocionales ($0.075 de entrada, $0.25 de salida); cambia el interruptor para ver el precio de lista posterior a septiembre.
Para dar contexto a los valores por defecto: un asistente mediano que maneja 500M de tokens de entrada y 150M de salida al mes cuesta cerca de $75/mes con las tarifas promocionales, o unos $150/mes cuando entra el precio de lista. Incluso a precio de lista, es un error de redondeo frente a las herramientas de IA por usuario, y por eso el modelo hizo ruido. Lo que hay que interiorizar es que tu volumen de salida, impulsado por el razonamiento de un modelo que solo piensa, es el dial que realmente mueve la cifra. Si tu objetivo es contenido y no tokens en bruto, nuestro análisis del mejor LLM para escribir blogs sopesa calidad y costo de la misma manera.
Prueba eesel: el modelo es el motor, eesel es el compañero de equipo
Este es el planteamiento honesto. GLM-5.3-Flash es una infraestructura fantástica. Pero una tarifa de $0.075 por millón de tokens no es la respuesta a un ticket de soporte ni un artículo terminado, igual que un barril de petróleo no es un viaje por carretera. Acceder al modelo en bruto te deja construir la recuperación de información, las barreras de seguridad, las integraciones, las pruebas y la maquinaria de "¿qué pasa cuando se equivoca?".
eesel está una capa por encima. En lugar de tokens, contratas compañeros de equipo de IA listos para trabajar: un compañero de IA para el servicio de atención que se une a tu cola existente de Zendesk, Freshdesk o Gorgias y redacta o envía respuestas, y un redactor de blogs con IA que investiga y escribe artículos SEO de principio a fin. Cada uno llega ya conociendo tu centro de ayuda y tus tickets anteriores, y entra en producción en minutos en lugar de un sprint de código de unión.
La diferencia que más importa para quien duda de entregar tickets a una IA: eesel te permite simular un compañero de equipo con tus tickets históricos reales antes de que toque a un cliente en vivo, así ves de antemano la tasa de resolución y las respuestas, en lugar de activar un interruptor y esperar lo mejor. Modelos como GLM-5.3-Flash abaratan los tokens; eesel es lo que los convierte en un compañero de equipo en quien puedes confiar de verdad en la cola. Es gratis para probar, sin tarjeta de crédito y sin llamada de ventas para empezar.