

GLM-5.3 Flash es el modelo con mejor relación inteligencia-precio que puedes llamar ahora mismo, y eso es difícil de discutir. Artificial Analysis le da 57 puntos en su Intelligence Index por unos 0,045 $ por tarea, tres puntos por debajo del GLM-5.3 completo a una fracción del precio. Es el primer modelo nativamente multimodal de la línea GLM-5, supera a GLM-5.2 en todos los benchmarks que Z.ai ha publicado, y los pesos abiertos están en Hugging Face.
El matiz que omiten la mayoría de los análisis: es un modelo barato con dos asteriscos reales. En la API propia de Z.ai es lento, alrededor de 49 tokens por segundo, y la fama de "el modelo más lento que AA ha visto jamás" viene de ese endpoint, no de los pesos. Si pasas a un proveedor como Databricks, el mismo modelo da 273 tokens por segundo. El otro asterisco son los datos: no hay acuerdo firmado, ni nivel de retención cero, y el servicio propio se rige por la ley de la República Popular China.
Mi veredicto breve. Si haces programación de alto volumen, ejecuciones con agentes o trabajo de visión y te importa más el costo que la latencia, GLM-5.3 Flash es un sí fácil, sobre todo autoalojado. Si vas a poner un modelo frente a clientes en tiempo real, el precio nunca fue tu problema difícil, y vuelvo a eso al final.
Primero, ¿qué GLM-5.3 estamos reseñando?
Esto confunde a la gente, así que lo aclaro rápido. Hay dos modelos con "5.3" en el nombre, y no son lo mismo.
El GLM-5.3 insignia es un modelo solo de texto para programación y ciberseguridad con un precio de 1,40 $ de entrada y 4,40 $ de salida por millón de tokens. GLM-5.3 Flash es su hermano más barato y multimodal, lanzado el 26 de agosto de 2026, y es el que trata esta reseña. Tiene 320B de parámetros totales con solo 18B activos en una arquitectura de mezcla de expertos, y antes del lanzamiento Z.ai lo ejecutó de forma anónima como "ox-alpha" en OpenRouter y OpenCode, donde fue brevemente el modelo más usado de la semana, todo servido con chips de IA chinos.
Así que cuando una tabla de benchmarks diga "GLM-5.3", comprueba cuál es. Las puntuaciones que cito abajo son de Flash salvo que diga lo contrario. Si quieres un recorrido más amplio por la familia, la guía de GLM-5.3 Flash explica cómo encajan ambos.
Lo evalué como evalúo cualquier modelo de lenguaje grande que podría poner a trabajar: leí ambos marcadores, saqué la tabla de benchmarks del propio fabricante, la contrasté con Artificial Analysis y la página del modelo en Cloudflare, y comparé las afirmaciones de marketing con lo que dijeron los profesionales después de probarlo ellos mismos.
Los benchmarks: dónde queda realmente
El titular de Z.ai es que GLM-5.3 Flash "outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks." La tabla publicada respalda con claridad la primera mitad.
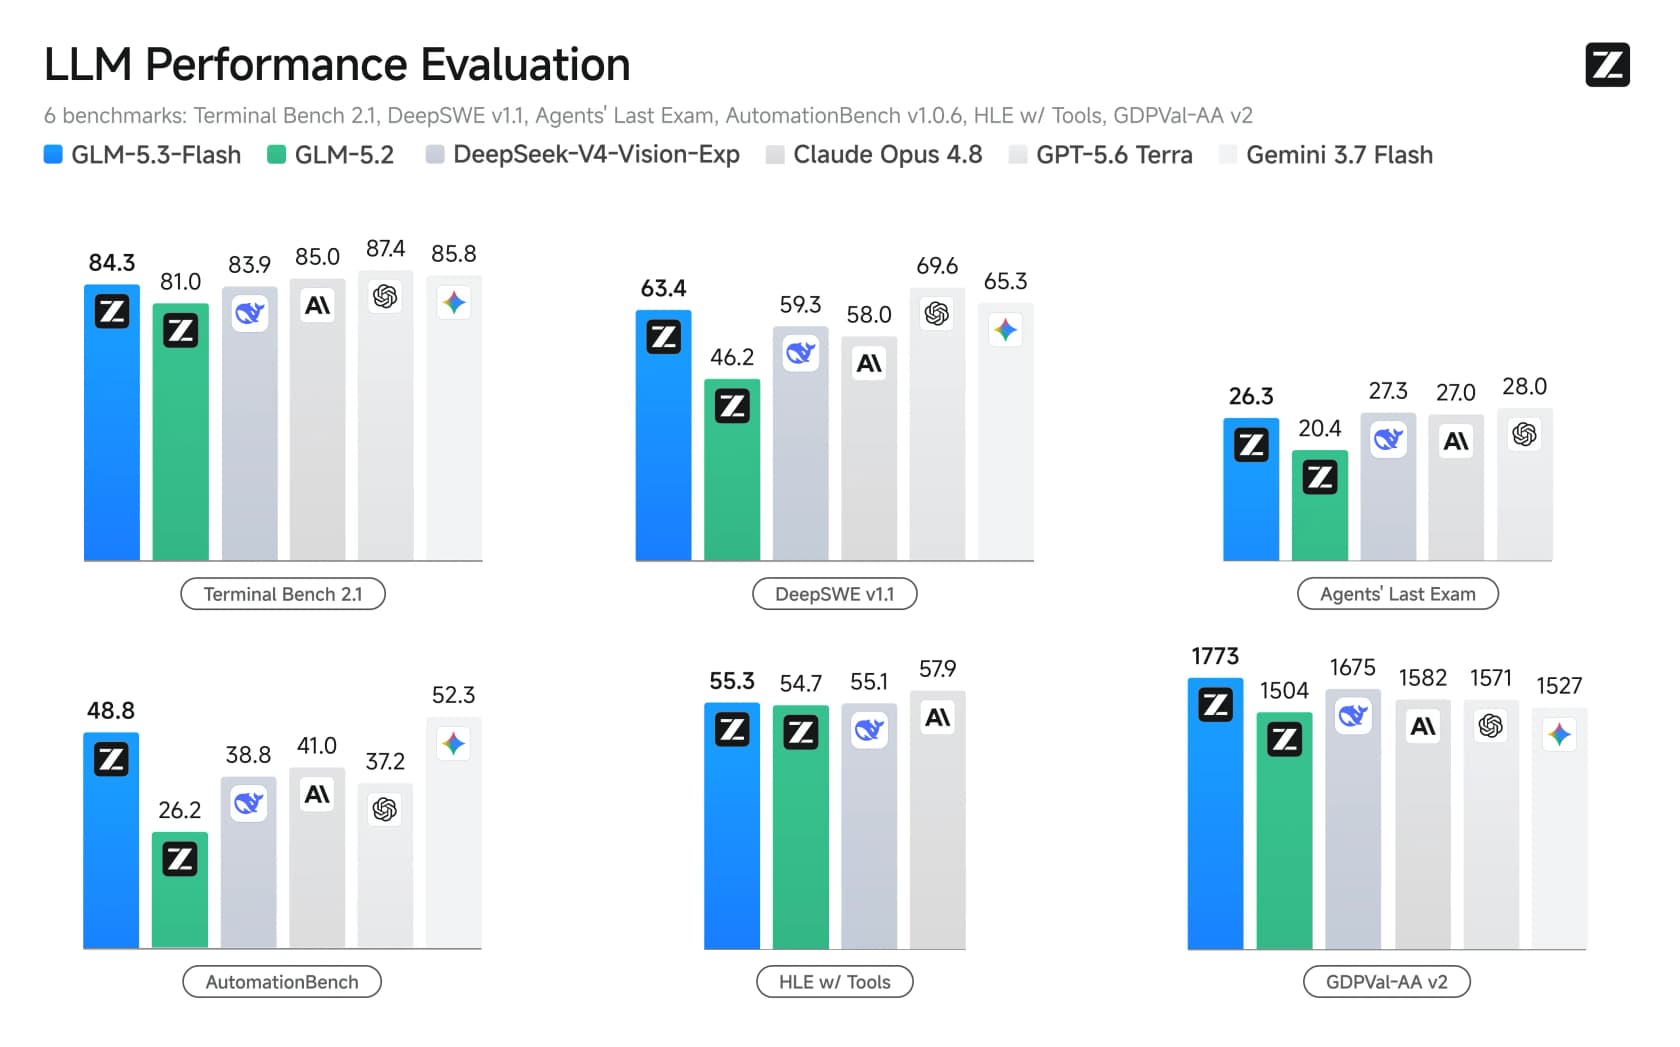
Los saltos sobre GLM-5.2 son grandes y consistentes: DeepSWE v1.1 pasa de 46,2 a 63,4, AutomationBench de 26,2 a 48,8 y GDPval-AA v2 de 1504 a 1773. En Z.ai Code Bench v1.0, ejecutado dentro de Claude Code con esfuerzo máximo, Flash obtiene 29,0 frente a los 29,5 de Claude Opus 4.8, que es la frase "casi iguala a Opus" hecha realidad.
Decir "se acerca a Opus" es justo en programación y tareas con agentes, y es honesto sobre dónde se detiene. Frente a los modelos cerrados de frontera, GPT-5.6 Terra se lleva DeepSWE (69,6) y Gemini 3.7 Flash supera por poco en AutomationBench (52,3). GLM-5.3 Flash no vence de forma rotunda a los mejores modelos cerrados. Aterriza en el mismo vecindario por una décima parte del dinero, que es una afirmación distinta y más interesante.
Donde lidera claramente la tabla es en dos lugares donde nadie espera que lo haga un modelo económico: encabeza GDPval-AA v2 con 1773, y en las filas de visión obtiene 89,4 en CharXiv reasoning y 80,5 en MMVU, por delante de DeepSeek-V4-Vision-Exp y de Opus en ambas. Para un modelo tan barato, esa es la sorpresa.
Una salvedad que conviene decir con claridad: no hay puntuación de MMLU, GPQA ni AIME en ninguna de las dos páginas. Z.ai publica un conjunto de programación, agentes y visión, no una tabla tradicional de conocimiento académico, así que si tu caso de uso depende de un amplio recuerdo de hechos, la evidencia publicada simplemente no dice nada. Tómalo como un vacío en los datos, no como aprobado ni suspenso.
El precio es toda la historia
Este es el número que hace que GLM-5.3 Flash merezca una reseña. En la promoción de lanzamiento cuesta 0,075 $ por millón de tokens de entrada y 0,25 $ de salida, con una tarifa de entrada en caché de 0,015 $. El precio de lista tras la promoción, que termina el 9 de septiembre de 2026, es de 0,15 $ y 0,50 $. En ambos casos es aproximadamente una décima parte del GLM-5.3 insignia, y lo sitúa en la frontera de eficiencia de todo el mercado.
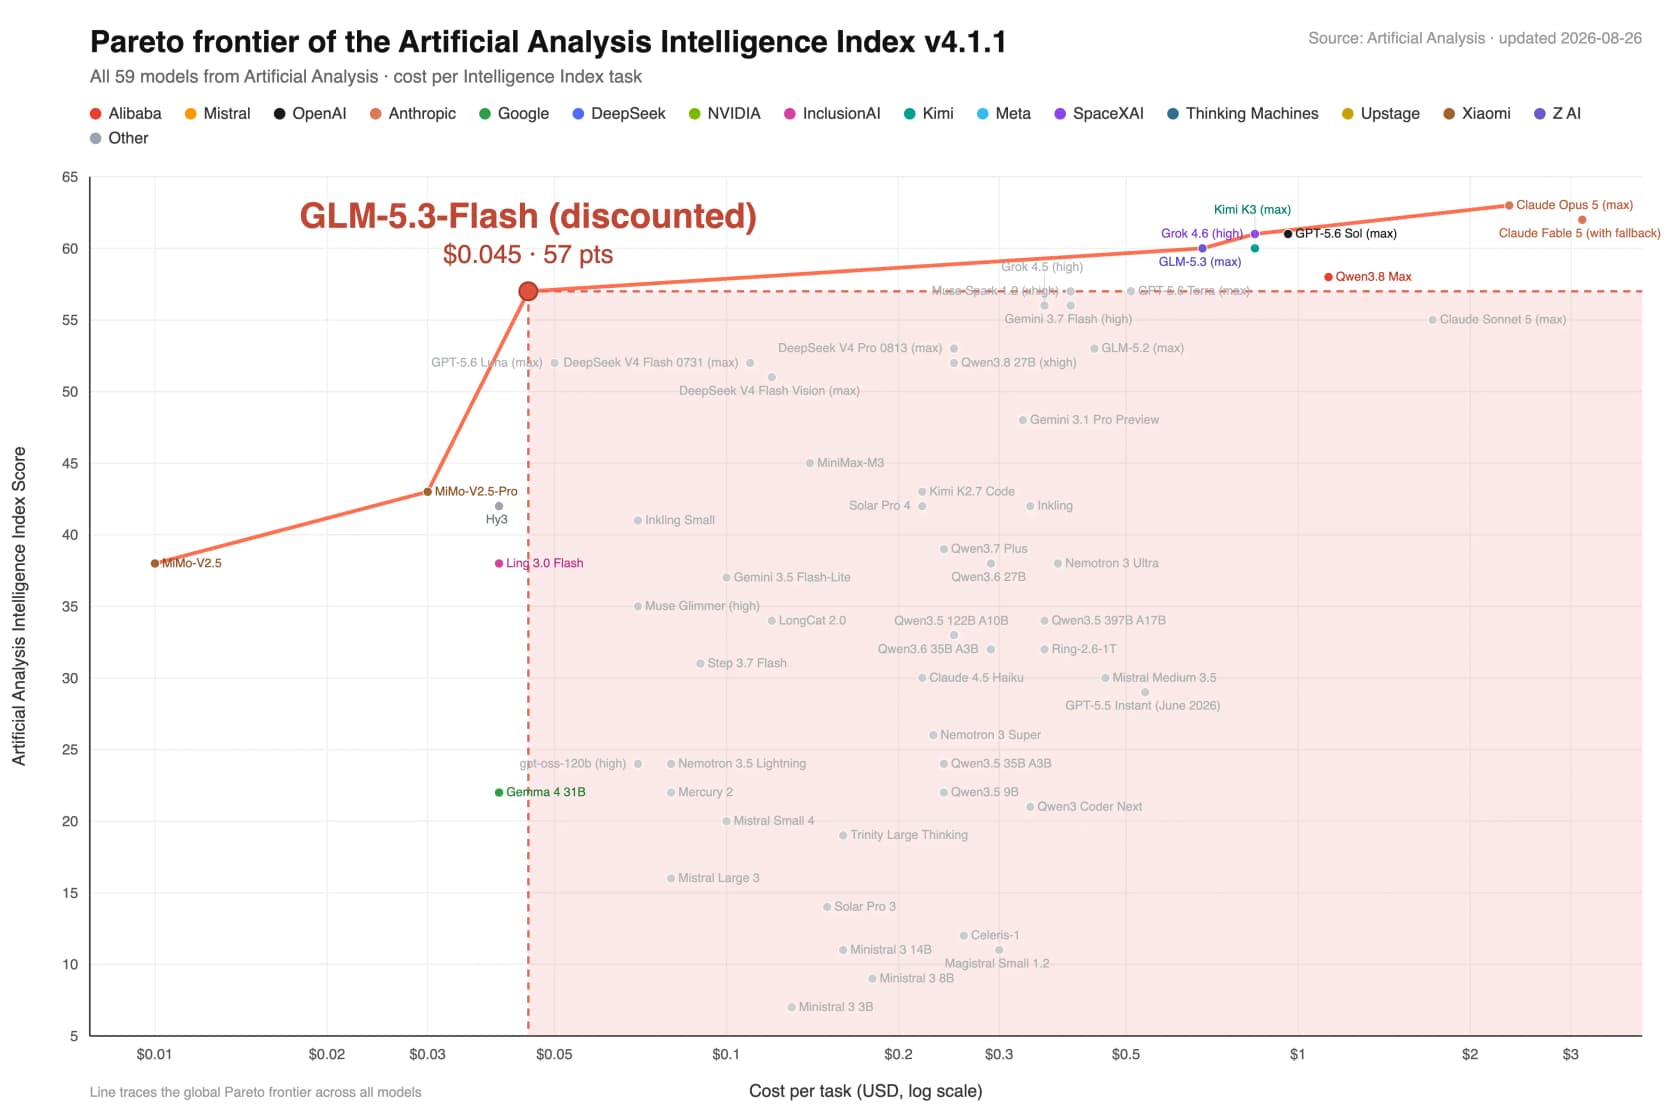
Ese punto rojo es el argumento de venta. GLM-5.3 Flash empuja la frontera de Pareto: para la inteligencia que ofrece, nada en el gráfico es más barato, y la propia frase de Z.ai es que esto es "a level of intelligence previously only available at roughly 10x the cost." La reacción de la comunidad fue sobre todo incredulidad ante exactamente eso.
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Conviene mencionar la vía del Coding Plan porque es donde la mayoría conocerá este modelo. El GLM Coding Plan de Z.ai cuesta 18 $, 80 $ y 168 $ al mes para Lite, Pro y Max, funciona dentro de Claude Code, Cline, OpenCode, Cursor y Roo Code, y Flash te da 3 veces la cuota utilizable de GLM-5.3 en el mismo plan. Si ya pagas una suscripción de programación, Flash es el ajuste que hace que los créditos duren tres veces más. Para ver cómo se compara con otras opciones de frontera económicas, la reseña de DeepSeek V4 Flash y la reseña de Kimi K3 cubren a los rivales más cercanos, y Qwen 3.8 Max es el siguiente escalón de precio.
Elige lo que más te importa y te daré una valoración honesta.
Por qué puede ser tan barato
Un precio tan bajo suele significar un modelo pequeño y torpe. Este no es ninguna de las dos cosas, y la razón es arquitectónica, no un descuento que se evaporará. Según Z.ai, el costo sale de tres capas que trabajan juntas, no de un solo truco.
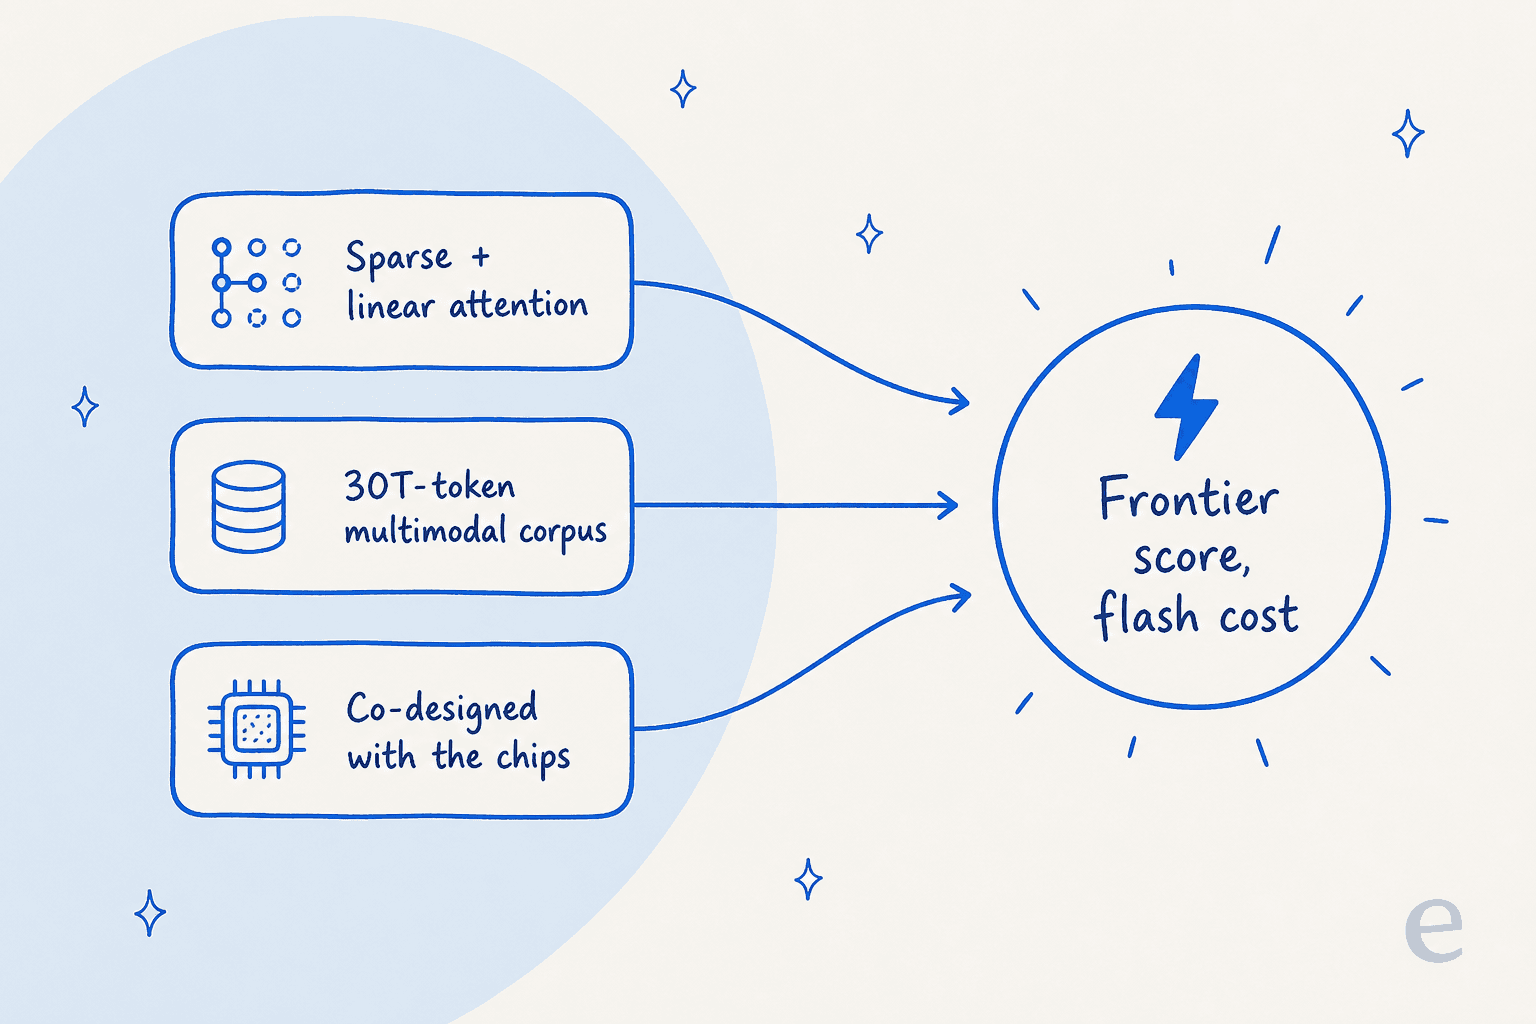
La pieza clave es el diseño de la atención. GLM-5.3 Flash es el primer modelo abierto que combina atención dispersa y lineal: la atención lineal maneja las dependencias locales mediante modelado de estado, mientras que un indexador ligero recupera el contexto global. El resultado, según Z.ai, es 3 veces menos cómputo de atención y una caché KV 4,4 veces más pequeña que el GLM-5.3 insignia, que es la mayor parte de la razón por la que servirlo con 1M de tokens de contexto sigue siendo asequible.
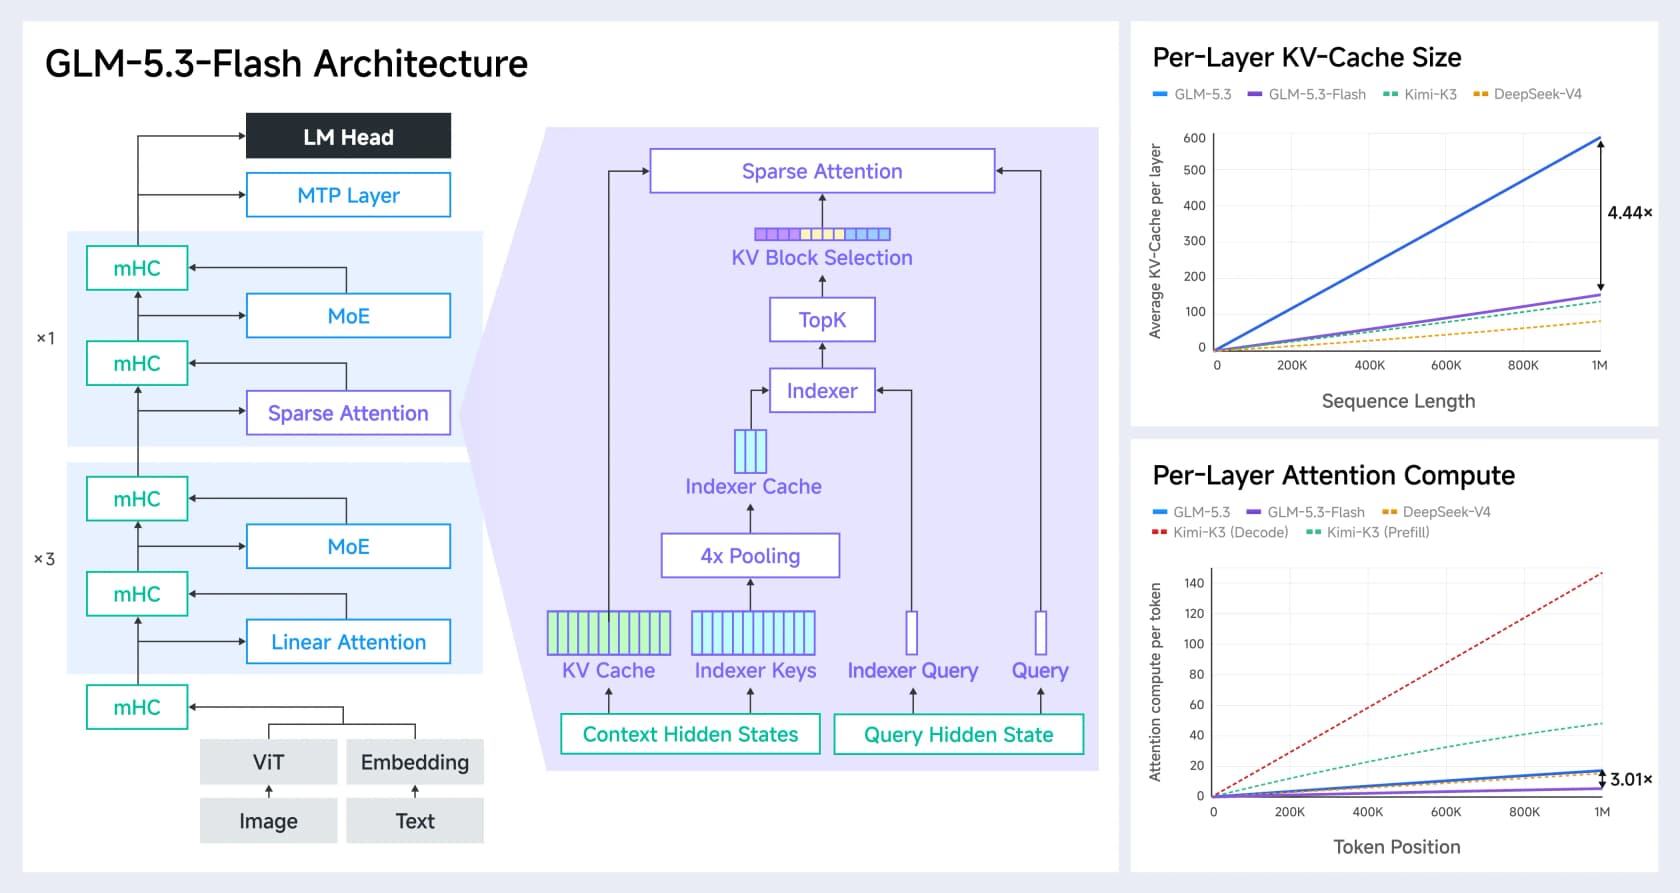
Las otras dos capas importan menos en el día a día, pero conviene conocerlas. Se entrenó con un corpus multimodal de 30 billones de tokens, y todo se codiseñó con hardware de inferencia chino, punto al que Z.ai vuelve una y otra vez: "Chinese chips can support frontier-model inference efficiently and economically at scale." En comparación con el antiguo GLM-4.5, Flash casi reduce a la mitad tanto los parámetros activos (18B frente a 32B) como el número de capas (45 frente a 92) con un tamaño total similar. Es una historia real de eficiencia, no un gancho de la semana de lanzamiento.
La apuesta multimodal: visión dentro del ciclo de programación
Lo más interesante que hace GLM-5.3 Flash no está en la tabla de benchmarks. Integra la visión en el ciclo de programación, de modo que el modelo puede renderizar su propia salida, mirarla y corregir lo que esté mal. La frase de Z.ai es la acertada: "Code lets the model build and change the world. Vision lets it enter the world people see and use."
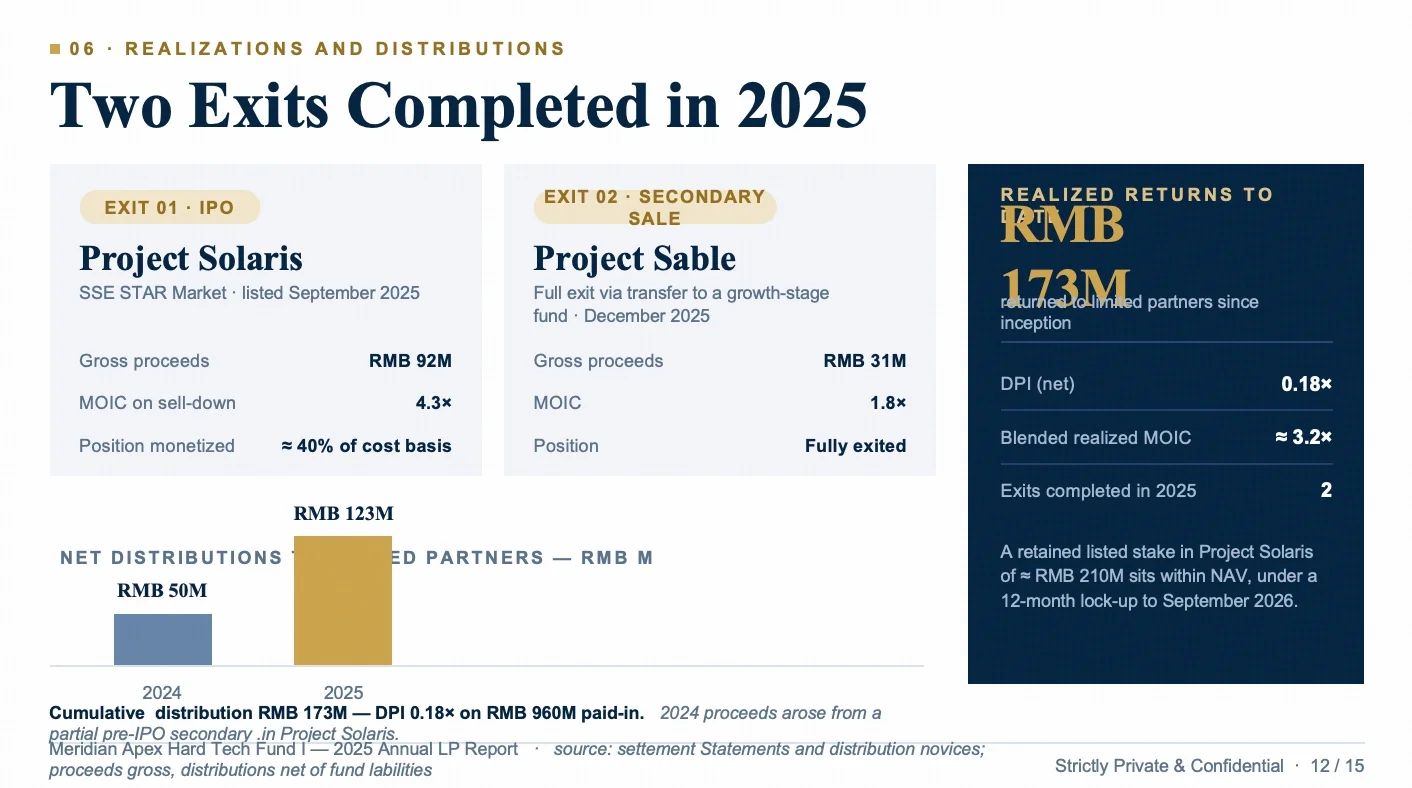
La demostración más clara es una diapositiva que generó y luego reparó por sí mismo. Aquí está el primer intento, con texto superpuesto y un diseño roto:
Y aquí la misma diapositiva después de que el modelo mirara su propio render y corrigiera la colisión:
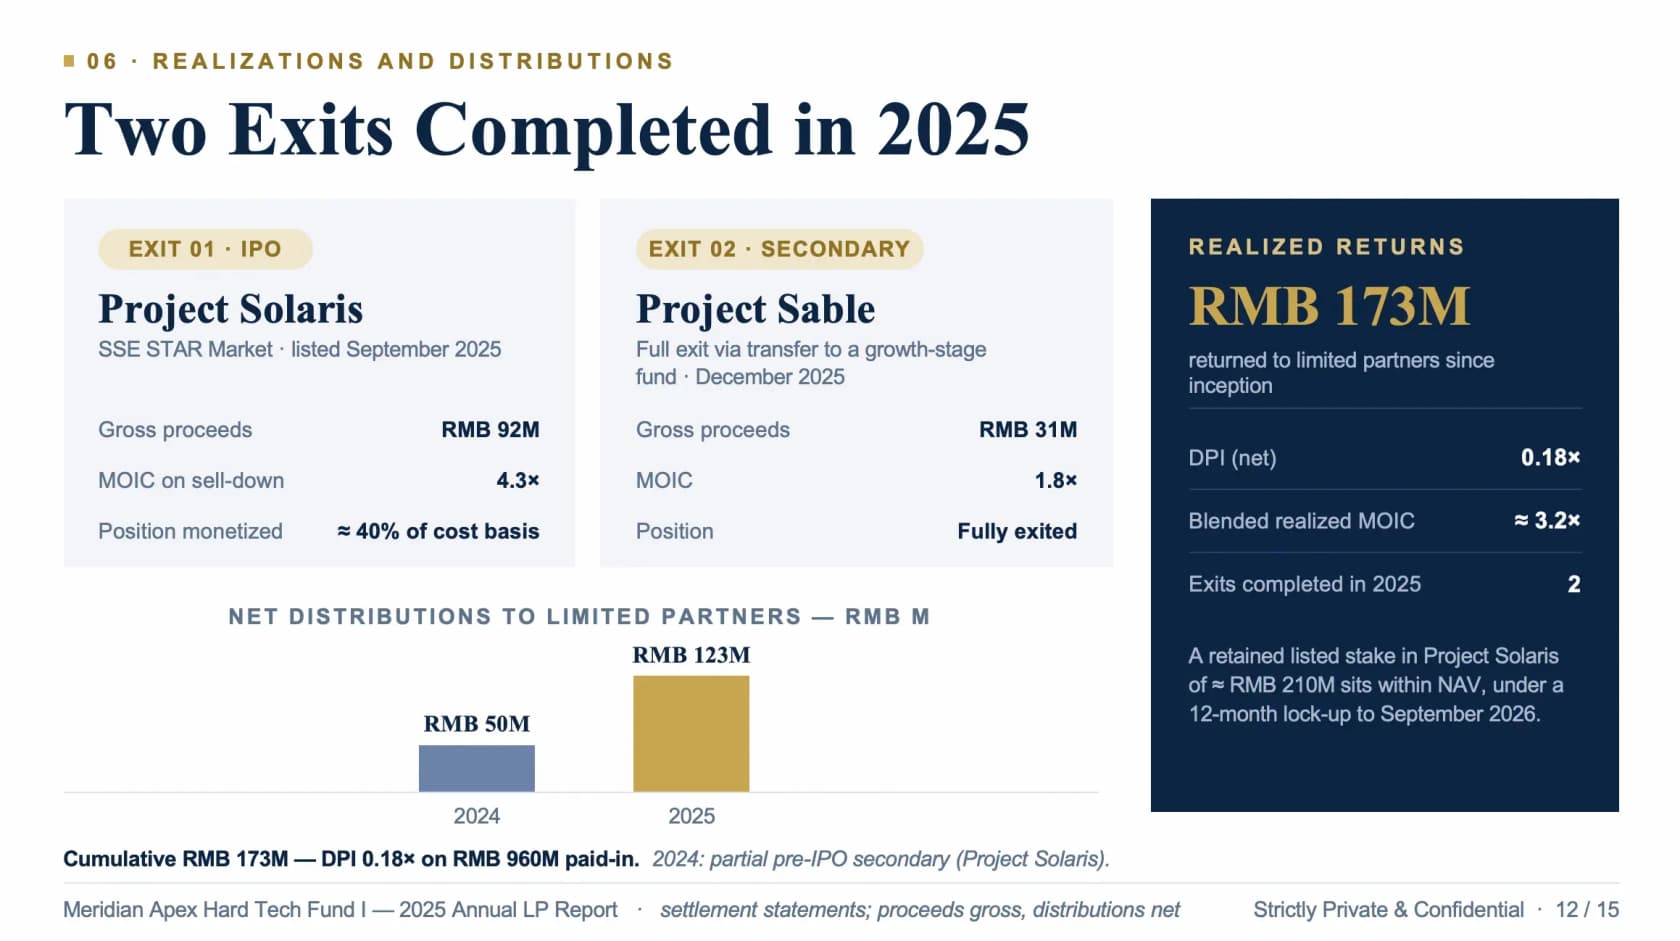
Es un ciclo útil para trabajo de frontend, juegos y 3D, donde "compila" y "se ve bien" son preguntas distintas. También va más allá del código, hasta leer paneles, hojas de cálculo y presentaciones, además de agentes de uso de computadora y de navegador dentro de ZCode. Los profesionales que probaron la parte de visión salieron convencidos:
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
Aun así, trataría la autoverificación como un reflejo útil, no como una garantía. Detecta errores visuales evidentes; no sustituye a una persona que revise lo que se publica. Pero para un primer lanzamiento nativamente multimodal, la calidad de visión está muy por encima de lo que sugiere el precio.
Dónde se queda corto
Una reseña que solo enumera virtudes es una nota de prensa. GLM-5.3 Flash tiene dos puntos débiles que conviene conocer antes de integrarlo en nada.
La API propia es lenta, y la fama es real. En el endpoint de Z.ai funciona a unos 49 tokens por segundo, frente a unos 86 del GLM-5.3 completo, y un hilo lo dijo sin rodeos.
"GLM 5.3 Flash is one of the slowest models AA [has ever seen]. GLM's visible context grows half as fast as Deepseek Flash and is much more precise and direct."
El matiz importante, y la razón por la que no dejaría que esa cita zanje el asunto, es que describe el servicio propio, no los pesos. Artificial Analysis lista 11 proveedores, y la diferencia es enorme.
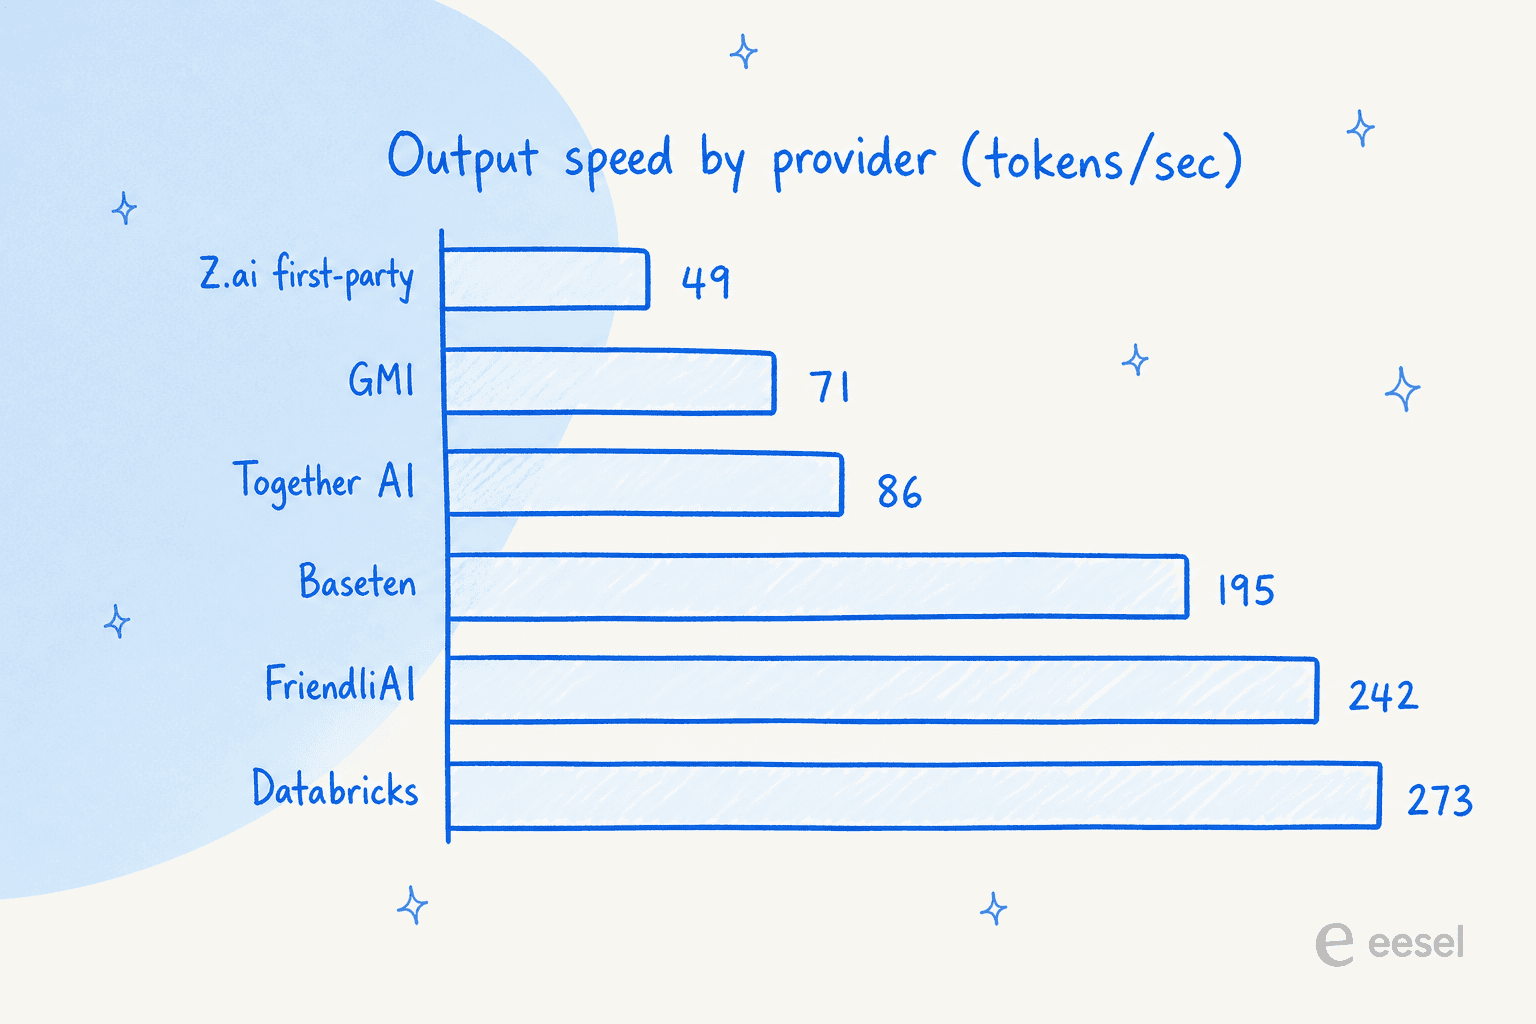
Databricks sirve el mismo modelo a 272,9 tokens por segundo, más de cinco veces la tasa de la API propia, con un tiempo hasta el primer token de 8 segundos. Así que "GLM-5.3 Flash es lento" en realidad significa "la API de Z.ai es lenta". Elige el proveedor con criterio y el problema casi desaparece. La página de benchmarks de proveedores es lo que hay que consultar antes de comprometerte, y si vas a enrutar tráfico real, una buena configuración de seguimiento de uso te ahorrará una sorpresa en la factura.
El panorama de datos es escaso si manejas contenido de clientes. La API propia no ofrece un acuerdo de procesamiento de datos publicado ni retención cero, y el servicio se rige por la ley de la RPC. Es una limitación real, no una crítica al modelo, y la solución honesta son los pesos abiertos: autoalojarlo con SGLang, vLLM o TokenSpeed es la manera de tener una ruta de datos controlada. Si algo de esto toca datos de clientes, lo primero que hay que leer es SOC 2 y RGPD.
Una cosa más que conviene prever: la serie GLM-5.3 prioriza el razonamiento, así que presupuesta los tokens de razonamiento en tus costos. Cloudflare expone un control reasoning_effort con ajustes low, medium y high, de modo que puedes bajarlo en tareas simples, pero no hay un modo gratuito de "no pensar nada" como ofrecen algunos modelos. Es también una nota sobre alucinaciones disfrazada: más razonamiento no equivale a más precisión, y la autocomprobación visual no se extiende a las afirmaciones factuales.
Qué está construyendo la gente con él
La señal más reveladora no es un benchmark, sino que proveedores y desarrolladores lo adoptaron en cuestión de días. James Grugett lo incluyó gratis en un producto desde el lanzamiento:
"GLM 5.3 Flash is 100% free in our [product]. Leading capabilities at a highly competitive price - Natively multimodal with a 1M-token context window. Previously previewed as Ox Alpha."
El caso de uso de revisión de seguridad es donde la relación precio-valor generó la reacción más fuerte. Un equipo lo ejecutó contra un benchmark de vulnerabilidades y sacó la cuenta:
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Esa es la forma de un buen trabajo para GLM-5.3 Flash: alto volumen, tolerante a una ejecución algo más lenta y con un precio tan bajo que puedes dedicarlo a tareas por las que jamás pagarías un modelo de frontera. El resumen de los mejores agentes de IA de código abierto tiene más patrones de este tipo, y si el trabajo es específicamente soporte, el artículo sobre el mejor modelo para tickets de soporte es una lectura más acotada sobre lo que realmente importa ahí.
Mi veredicto, según el trabajo
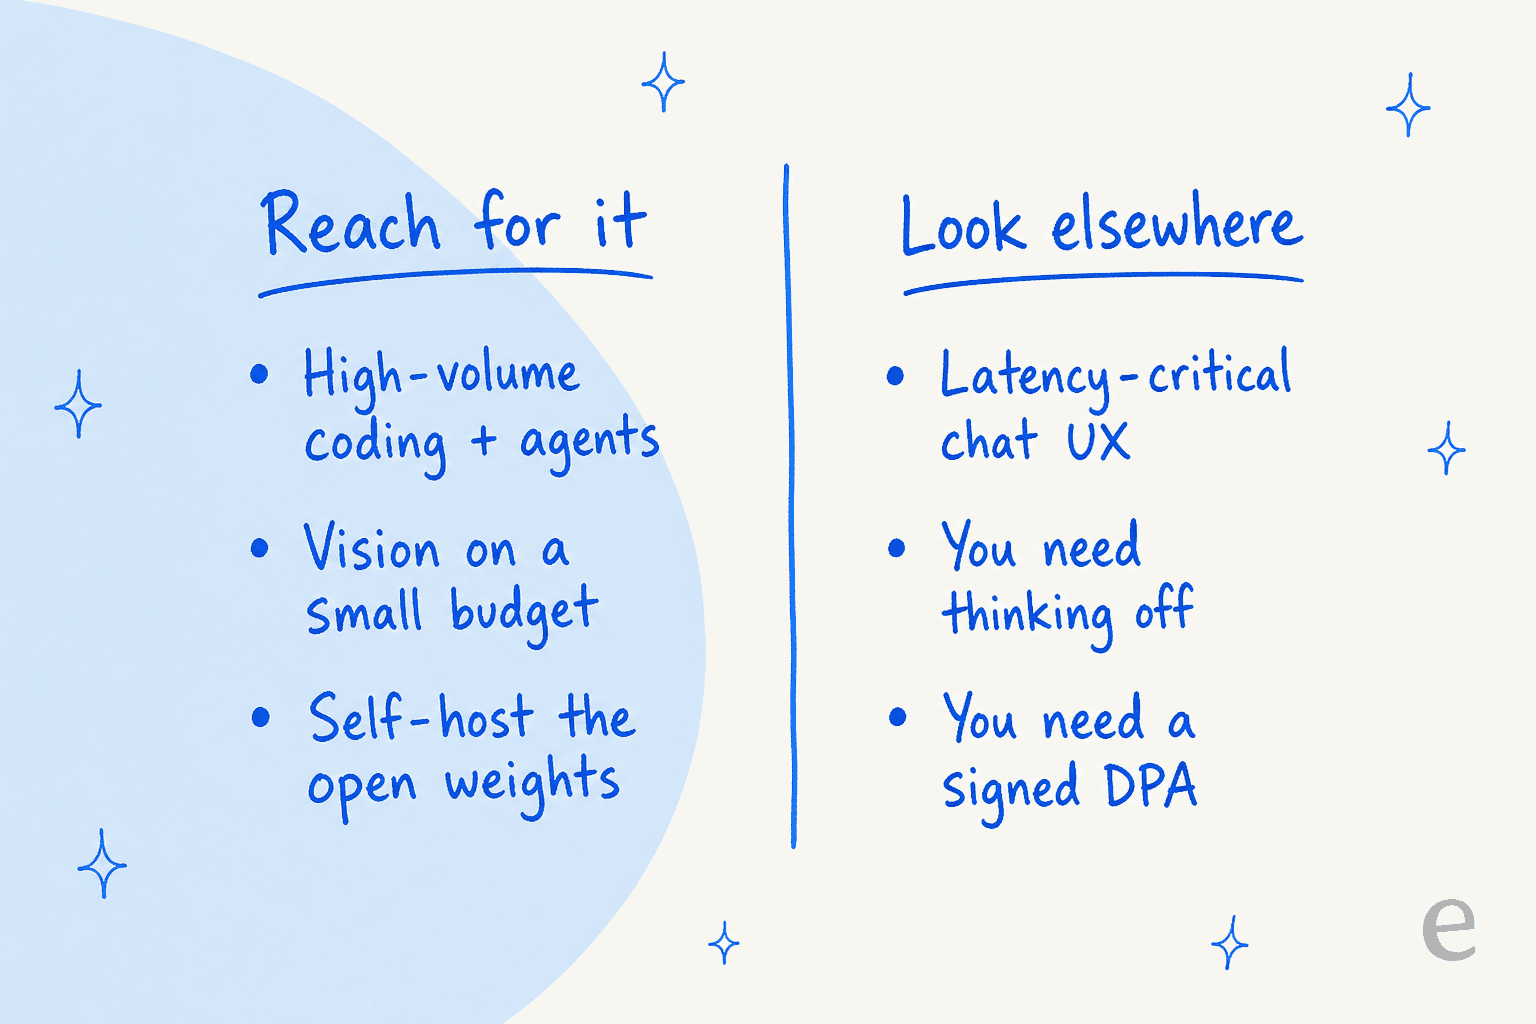
Recurre a GLM-5.3 Flash si haces programación de alto volumen o trabajo con agentes, si quieres calidad de visión real sin precio de frontera, o si quieres autoalojar pesos abiertos y mantener tus datos en casa. En las tres, es una de las mejores opciones calidad-precio disponibles hoy, y la guía de GLM-5.3 Flash es donde te enviaría para configurarlo.
Busca otra opción si la latencia es tu producto y no puedes controlar al proveedor, si necesitas un modo que omita por completo el razonamiento, o si necesitas un acuerdo de datos firmado que no puedes obtener sin autoalojar. Ninguno es fatal, pero son las situaciones en las que un modelo más caro, más rápido o con más gobernanza justifica su sobreprecio. Si lo comparas con una opción cerrada de frontera, los precios de Claude Opus 5 son el punto de referencia en el otro extremo de la escala.
La versión en una línea: GLM-5.3 Flash es el modelo que elegiría por defecto para trabajo barato, de alto volumen y tolerante a la lentitud, y el que probaría con cuidado antes de apostar por él un producto sensible a la latencia.
Try eesel
Si llegaste aquí comparando tarifas por token porque quieres que una IA se encargue del soporte, esto es lo que te diría tomando un café: el precio del token nunca fue la parte difícil. Un modelo como GLM-5.3 Flash es el motor. Conectarlo a tu helpdesk, basarlo en tus macros y tickets anteriores reales, y saber qué dirá antes de que un cliente lo vea, eso es el trabajo de verdad, y es un producto completamente distinto.
Ahí es donde encaja eesel. eesel te da compañeros de equipo de IA listos para trabajar en tareas concretas: un agente de soporte con IA que se conecta a Zendesk o a tu helpdesk actual, y un redactor de blog con IA para contenido. Cada uno llega con las habilidades, integraciones y contexto de empresa para su rol, así que contratas a un compañero de equipo, no alquilas acceso en bruto a un modelo.
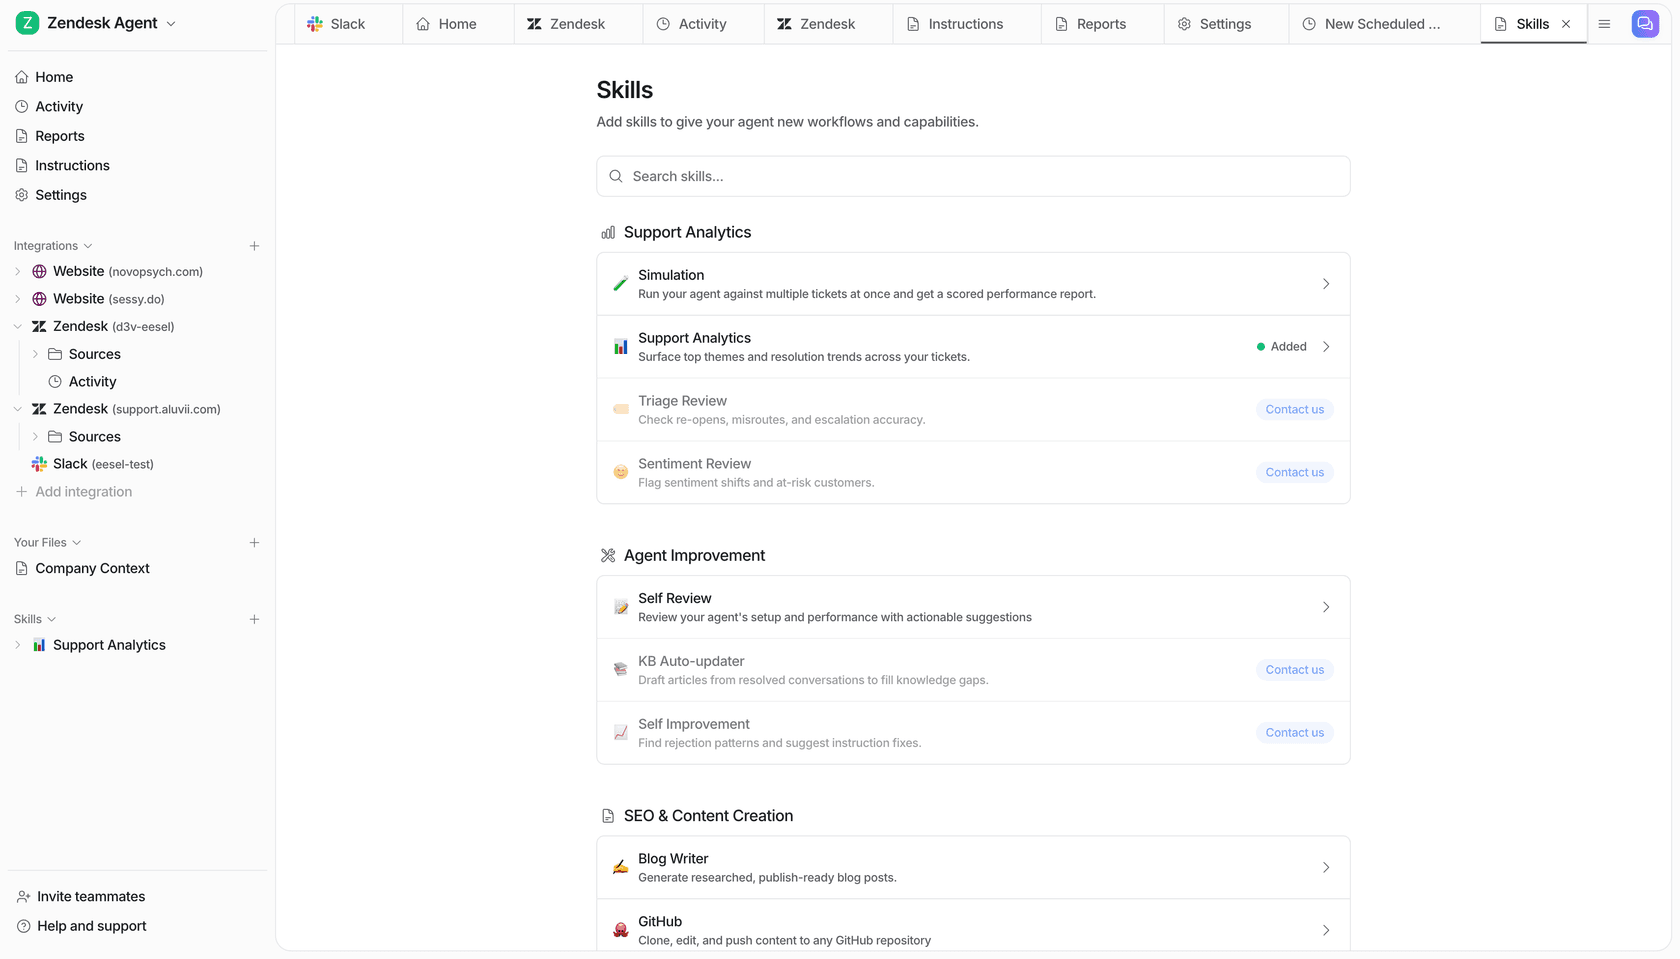
Lo que más importa en soporte: llevamos años poniendo agentes de IA en colas de soporte reales, y hemos visto a un bot de apariencia segura narrar trabajo que nunca hizo. Por eso cada despliegue de eesel se simula con tickets pasados antes de tocar una conversación real. El precio es una tarifa mensual fija ajustada al volumen (1 crédito por ticket o chat) en lugar de por usuario, así que un despliegue gradual es real, y hay 100 créditos gratis para empezar. Ese modelo de créditos es también la razón por la que el costo de la IA en atención al cliente sale distinto de una factura de tokens en bruto. Ejecuta una simulación con los tickets del mes pasado y sabrás en una hora si vale la pena tu tiempo, lo cual es mejor que probar un modelo a ciegas.