Precios de Gemini 3.8 Flash de un vistazo
Aquí están todas las tarifas publicadas para gemini-3.8-flash en la API de Gemini, nivel estándar de pago, por 1M de tokens. He puesto la columna de 2027 justo al lado de la de hoy para que la promoción sea imposible de pasar por alto.
| Medida | Hasta el 31 dic 2026 | Desde el 1 ene 2027 |
|---|---|---|
| Entrada | $0.75 | $1.50 |
| Salida (incluye razonamiento) | $3.75 | $7.50 |
| Caché de contexto, lectura | $0.075 | $0.15 |
| Caché de contexto, almacenamiento (por 1M/hora) | $0.50 | $1.00 |
| Batch y Flex, entrada | $0.375 | $0.75 |
| Batch y Flex, salida | $1.875 | $3.75 |
| Prioridad, entrada | $1.35 | $2.70 |
| Prioridad, salida | $6.75 | $13.50 |
Hay algunas cosas fáciles de pasar por alto al leer la página de Google de arriba a abajo:
- El precio de la salida incluye los tokens de razonamiento. Pagas la tarifa de $3.75 por el razonamiento del modelo, aunque la API solo te devuelve un resumen de él. En un modelo ajustado para razonar más, esa es la línea que mueve tu factura.
- Batch y Flex cuestan exactamente la mitad. Si tu trabajo no es interactivo, un trabajo por lotes nocturno reduce a la mitad cada token que gastas.
- El grounding se factura por separado. Google Search como herramienta te da 5.000 solicitudes gratis al mes, compartidas entre todos los modelos Gemini 3.x que uses, y después $14 por cada 1.000. El grounding de Google Maps usa la misma asignación.
- Existe un nivel gratuito real. Entrada, salida y caché son gratis para uso estándar, lo cual es suficiente para prototipar antes de gastar nada.
Prueba las cifras con tu propia carga de trabajo
La tarifa titular solo te dice hasta cierto punto. Lo que importa es tu volumen mensual, tu proporción de entrada a salida y en qué nivel operas. Introduce tus propias cifras a continuación para ver el coste mensual de hoy frente a lo que costaría la misma carga de trabajo tras la subida de enero de 2027.
El coste oculto: 3.8 Flash es verboso a propósito
La cifra que cambia la decisión de compra no está en la página de precios. Está en cuántos tokens gasta el modelo para hacer una tarea.
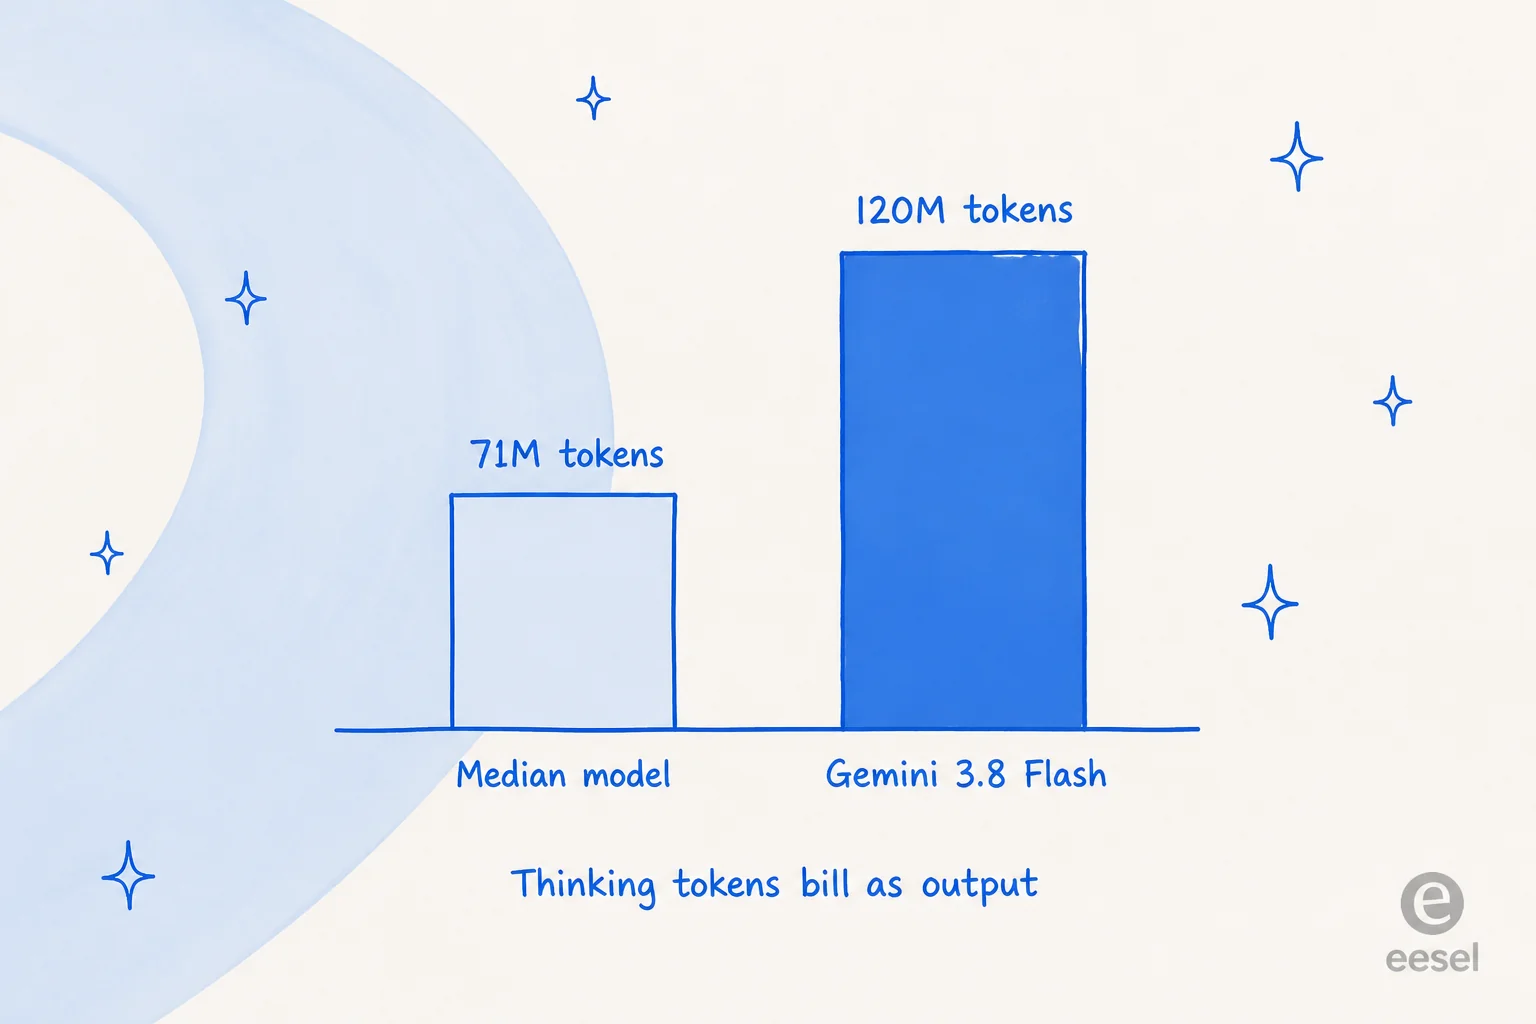
Google expone esta disyuntiva abiertamente en su publicación de lanzamiento: 3.8 Flash "trabaja más duro", ejecutando pasos de razonamiento adicionales y llamando a herramientas de forma iterativa, y "a veces, el modelo puede usar más tokens para maximizar el rendimiento". Eso es una ventaja para la calidad, y un coste para tu factura, porque los tokens de razonamiento se cobran a la tarifa de salida de $3.75.
La medición independiente lo confirma. Artificial Analysis necesitó 120M de tokens de salida para ejecutar todo su Intelligence Index frente a 3.8 Flash, comparado con una mediana de 71M para la clase. El veredicto de una sola palabra de AA fue "very verbose" (muy verboso).
En Hacker News, un comentarista puso una cifra más contundente que la del marketing:
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

Así que el coste real por unidad de trabajo es más alto de lo que sugieren los $3.75 por 1M, porque 3.8 Flash gasta más unidades por tarea. Artificial Analysis situó el coste combinado en $0.58 por tarea en su índice, lo que lo coloca en el puesto 59 de 195 modelos en eficiencia de coste, lejos de la cima que la tarifa bruta por token haría suponer. Si quieres vigilar esto en tu propio tráfico, para eso existen exactamente las herramientas de seguimiento de LLM.
Mismo precio que 3.7 Flash, ¿cuál compras entonces?
Esta es la decisión real, y Google la responde por ti. Como 3.8 y 3.7 Flash cuestan lo mismo hasta el céntimo, el precio no puede desempatar. La propia guía de Google sí lo hace: para las cargas de trabajo "donde la eficiencia de cómputo es la principal limitación", los desarrolladores deberían "seguir confiando en Gemini 3.7 Flash, que sigue totalmente soportado para cargas de trabajo centradas en la eficiencia".
Dicho llanamente:
- Codificación agéntica larga, calidad sobre coste: 3.8 Flash. Supera a 3.7 en cada benchmark publicado por Google, y cambiar es gratis. Si estás explorando la categoría más amplia, mi resumen de asistentes de codificación con IA cubre todo el campo.
- Alto volumen, sensible a la latencia, coste primero: quédate con 3.7 Flash. Consume menos tokens al mismo precio, y un empleado de Google en el hilo de lanzamiento confirmó que el mayor consumo de tokens de 3.8 es el comportamiento previsto, no un error.
También hay un matiz de latencia. 3.8 Flash ocupa el puesto 3 de 195 en velocidad bruta de salida, pero su tiempo hasta el primer token es de 13.30 segundos frente a una mediana de 2.99 segundos. Para todo aquello que un humano espera, el modelo "rápido" es el que más tarda en empezar a responder. Eso es rendimiento (throughput), no capacidad de respuesta, y es fácil malinterpretarlo a partir del titular de velocidad.
Cómo se compara la tarifa con otros modelos de frontera
Si estás comparando opciones, aquí ves dónde se sitúa Gemini 3.8 Flash frente a los modelos con los que realmente compite en precio, por 1M de tokens, nivel estándar, hoy.
| Modelo | Entrada | Salida | Nota |
|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | Se duplica en enero 2027 |
| Gemini 3.7 Flash | $0.75 | $3.75 | Idéntico, menos tokens por tarea |
| Claude Opus 5 | ~$5.00 | ~$25.00 | 4 veces menos tokens de salida por tarea |
| Claude Sonnet 5 | menor que Opus | menor que Opus | Nivel Claude más barato |
El planteamiento honesto del mismo hilo de HN: un desarrollador señaló que Gemini Flash, junto con un par de otros modelos económicos, ofrece "el 90% del rendimiento por una pequeña fracción del coste" del nivel de frontera. Ese es el verdadero argumento de venta, y es justo. Solo recuerda que la fracción se mide sobre la tarifa bruta, antes de añadir el impuesto por verbosidad y la subida de enero. Mi resumen de alternativas a Gemini cubre el resto del campo, y si estás sopesando Google frente a OpenAI, la comparación ChatGPT frente a Gemini es el punto de partida, con la lista completa de modelos de OpenAI para el otro lado de esa comparación.
Dónde puedes usarlo realmente
- Nivel gratuito: entrada, salida y caché gratis a través de Google AI Studio. Suficiente para prototipar.
- Predeterminado en Antigravity: 3.8 Flash es el modelo predeterminado en Google Antigravity, con cuotas generosas, algo que varios desarrolladores en HN señalaron como la forma más barata de someterlo a trabajo real.
- Apps de consumo: la app de Gemini, AI Mode en la Búsqueda y Gemini en Sheets, pero solo con Google AI Pro o Ultra. Si estás decidiendo entre ellos, consulta los planes de Google AI.
- Cómo activarlo o desactivarlo: si gestionas el acceso a Gemini en un Workspace, aquí tienes cómo activar y desactivar Gemini.
Qué significa esto si estás calculando el precio de un bot de soporte
Paso la mayor parte de mi tiempo pensando en cómo los compradores buscan y calculan el precio de la IA para el helpdesk, así que aquí está la parte que importa si el motivo por el que estás leyendo una página de precios de un modelo es automatizar la atención al cliente.
Una tarifa de $0.75 por token parece irresistible junto a un complemento de helpdesk con precio por resolución. Pero tres cosas rompen esa comparación. Un modelo de soporte responde tickets cortos y de alto volumen, donde el tiempo hasta el primer token de 13.30 segundos se siente en cada respuesta. La verbosidad que hace bueno a 3.8 Flash en tareas largas de codificación es la forma equivocada para la desviación de tickets, y se factura a la tarifa de salida. Y la tarifa por token es solo una pequeña parte del coste real de ejecutar la automatización de soporte, que está dominado por el trabajo de recuperación y pruebas alrededor del modelo, no por la llamada al modelo en sí.
He pasado los últimos tres años y medio observando cómo funcionan los agentes de IA en colas de soporte reales, y el patrón es constante: un modelo que suena seguro de sí mismo puede dar respuestas equivocadas sin que se note, y ningún precio por token arregla eso. Por eso cada implementación de eesel se simula con tus tickets reales anteriores antes de responder jamás a un cliente, para que veas la tasa de resolución y el coste por ticket de antemano en lugar de descubrir ambos en la factura.
Si estás eligiendo un modelo para construir tú mismo la automatización de soporte, calcúlalo honestamente incluyendo el impuesto por verbosidad y la tarifa de 2027. Si prefieres no conectar tú mismo un modelo a tu helpdesk, eesel ofrece un compañero de IA para el helpdesk que se integra con tus herramientas existentes, aprende de tus tickets anteriores y es gratis para probar, sin necesidad de calcular tokens. Es la diferencia entre comprar un motor y contratar a alguien que ya sabe conducir.
Preguntas frecuentes
¿Cuánto cuesta Gemini 3.8 Flash?
¿Los precios de Gemini 3.8 Flash son iguales que los de 3.7 Flash?
¿Por qué se duplica el precio de Gemini 3.8 Flash en enero de 2027?
¿Cuáles son los precios de batch y prioridad para Gemini 3.8 Flash?
¿Es Gemini 3.8 Flash más barato que Claude Opus 5?
¿Existe un nivel gratuito para Gemini 3.8 Flash?
¿Son buenos los precios de Gemini 3.8 Flash para atención al cliente?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.