Qué es realmente Gemini 3.8 Flash
Gemini 3.8 Flash es el modelo multimodal más nuevo, rápido y económico de Google, disponible como gemini-3.8-flash en la API de Gemini y como modelo predeterminado en el entorno de desarrollo agéntico Antigravity de Google. Recibe texto, imágenes, audio, video y PDFs, y produce texto, con una ventana de entrada de 1M de tokens y 64K de salida. Si quieres el desglose completo del lanzamiento, lo cubrí en mi resumen de Gemini 3.8 Flash, y el lado del dinero está en el artículo sobre los precios de Gemini 3.8 Flash. Este es el análisis: si vale la pena tu tiempo y dónde encaja realmente.
El dato más útil para un análisis es uno que nadie puso en un titular: este no es un modelo nuevo. La ficha del modelo afirma, textualmente y en cuatro secciones distintas, que "Gemini 3.8 Flash is based on Gemini 3.7 Flash." La arquitectura, los datos de entrenamiento, el hardware y la política de seguridad remiten todos a la ficha de 3.7 Flash. Así que 3.8 es una pasada de post-entrenamiento sobre la base de 3.7. Eso explica el ritmo de tres semanas, y explica por qué el precio no se movió ni un centavo. Lee este análisis como la respuesta a "¿vale la pena cambiar por el post-entrenamiento adicional?", porque esa es la pregunta real.
El único número que decide este análisis
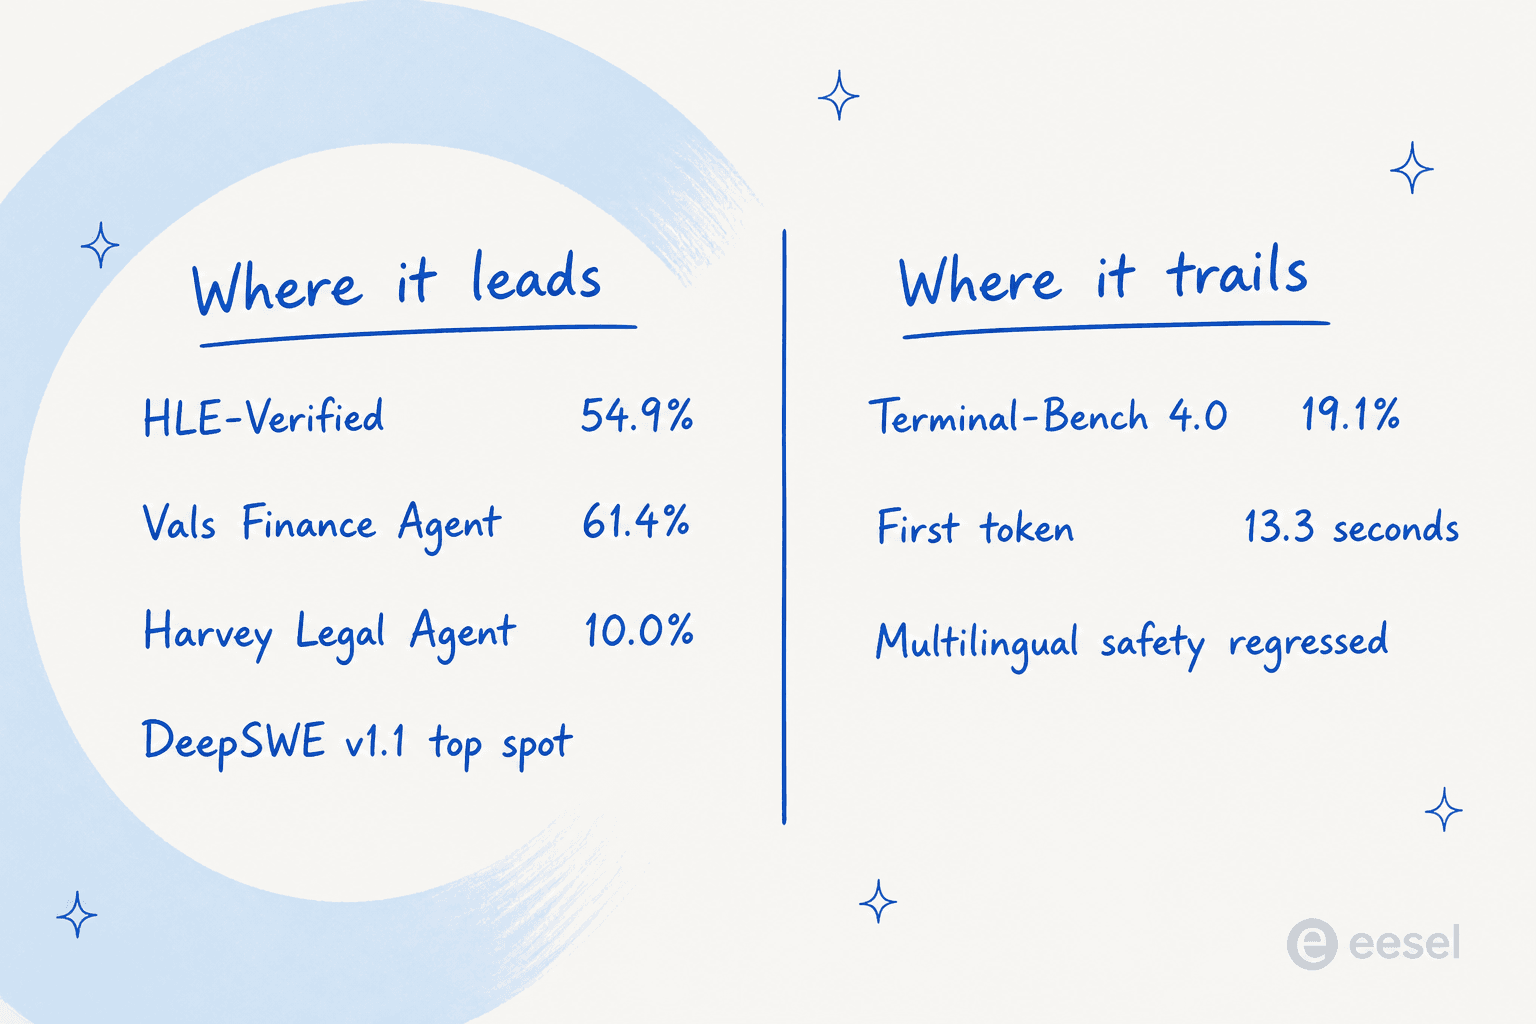
Todos los artículos de lanzamiento destacaron la velocidad. Aquí está el número que lo replantea. Artificial Analysis mide a Gemini 3.8 Flash en 305,1 tokens por segundo, en el puesto #3 de 195 modelos. Eso es real e impresionante. Pero la misma página de medición también reporta un tiempo hasta el primer token de 13,30 segundos, mientras que el modelo de razonamiento mediano en su rango de precio se ubica en 2,99 s.
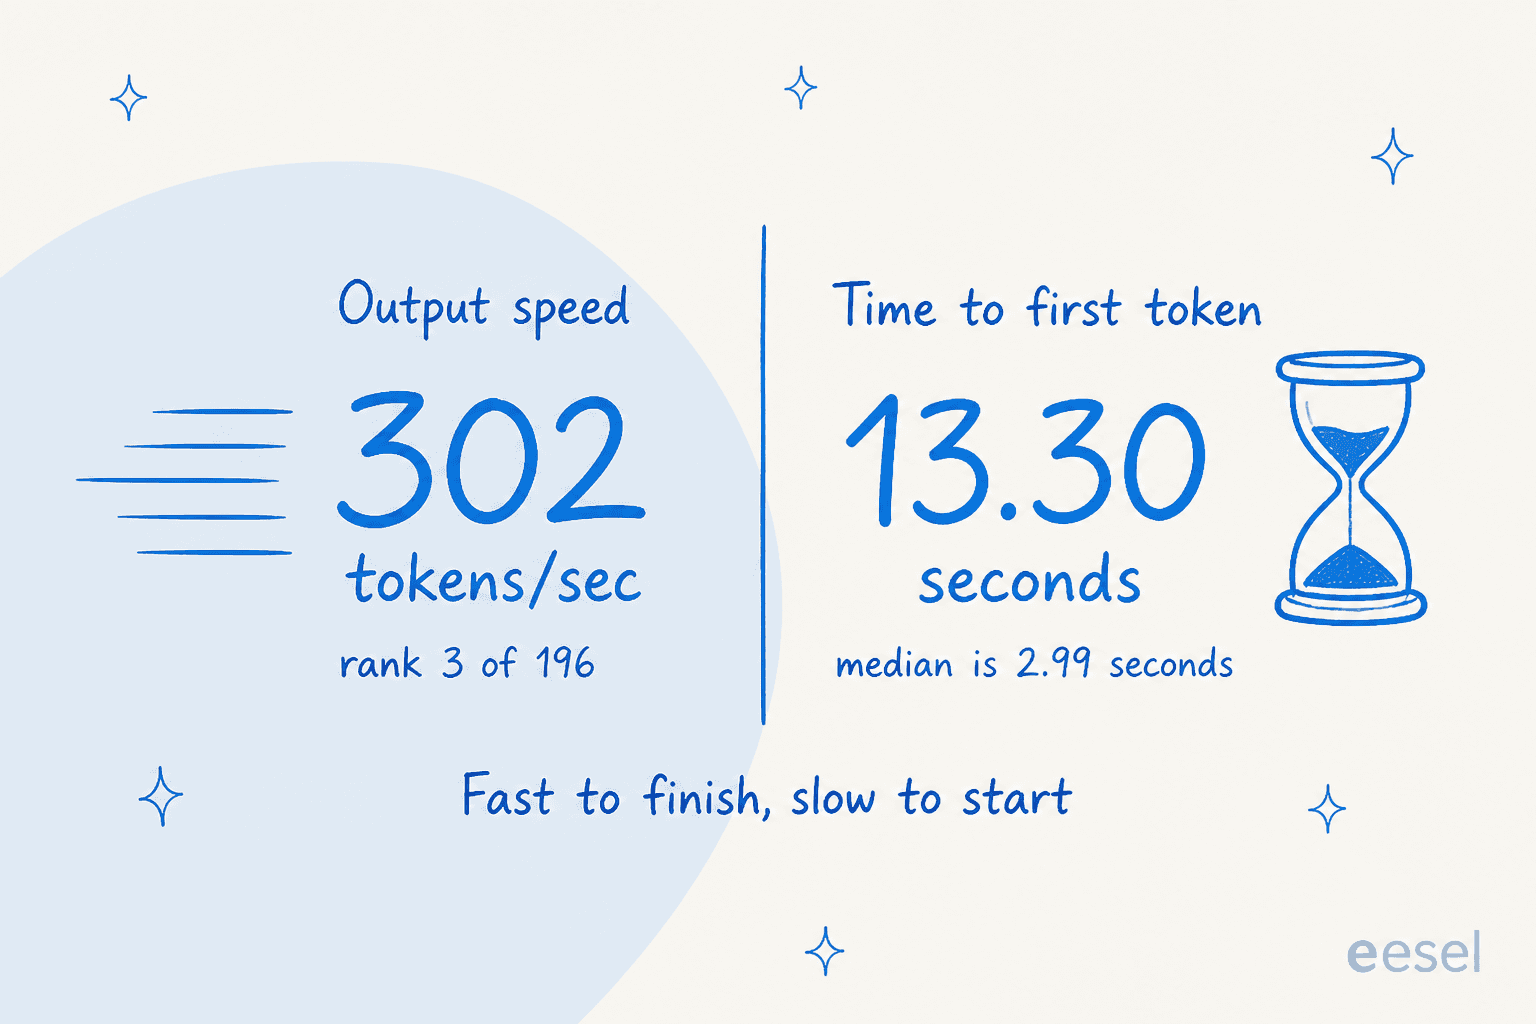
Esos dos números describen experiencias completamente distintas. El rendimiento es la rapidez con la que fluye el texto una vez que empieza. El tiempo hasta el primer token es cuánto tiempo la persona que lee se queda mirando una casilla vacía antes de que aparezca algo. Para un agente por lotes que trabaja durante la noche en un repositorio, 13 segundos de pensamiento previo son invisibles y el rendimiento lo es todo. Para una persona mirando un widget de chat, o un agente de soporte esperando una respuesta sugerida, 13 segundos de silencio son toda la experiencia, y ninguna velocidad posterior lo salva.
Por eso sigo cuestionando la idea de que "3.8 Flash is the fast one". Es el rápido para las máquinas y el lento para los humanos. Esa única distinción clasifica casi todos los casos de uso que puedo imaginar, y es la razón por la que los benchmarks de abajo importan menos de lo que parece.
Dónde es realmente bueno
Dale una tarea de programación agéntica larga y 3.8 Flash se gana el sueldo. Según las propias cifras de Google, lidera HLE-Verified con 54,9 % (por delante de GPT-5.6 Sol, Claude Opus 5 y su propio predecesor), gana el benchmark Vals Finance Agent v2 con 61,4 %, y encabeza DeepSWE para trabajo de software de largo alcance. El proveedor de benchmarks david lo resumió claramente: "5x cheaper and 2x faster than Opus 5 for similar intelligence."
El Intelligence Index respalda la historia de programación: 59 puntos en Artificial Analysis, igualando a Claude Opus 5 en esfuerzo medio, lo cual para un modelo de la clase Flash es un resultado sólido. Y el comportamiento de largo alcance es real, no un artefacto de benchmark. El socio de diseño Thai Tran de Glean reportó que logra "completing more than three times as many tasks as Gemini 3.7 Flash in our evaluations" en flujos de trabajo intensivos en documentos. En Hacker News, simonw generó una visualización en HTML en 13 segundos por 1,8 centavos y calificó la combinación de velocidad y calidad de frontend como "pretty exciting."
Mi patrón favorito del mundo real vino de panarky, que usa Flash como auditor en lugar de constructor:
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus. Can't wait to try 3.8 Flash. If it's good enough, maybe I'll switch Flash to primary and make Opus the auditor."

Ese es el tipo de carga de trabajo para el que está construido 3.8 Flash: económico, rápido, incansable, dispuesto a machacar una tarea larga. Si esto te describe, pertenece a tu lista corta junto a las demás mejores herramientas de asistentes de IA para programar.
Dónde falla
El mismo diseño de "works harder" que gana los benchmarks de programación es lo que lo hace incómodo en todo lo demás. Google es inusualmente honesto sobre esto en el artículo de lanzamiento: 3.8 Flash "exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance." Traducido: piensa mucho, y tú pagas por ese pensamiento.
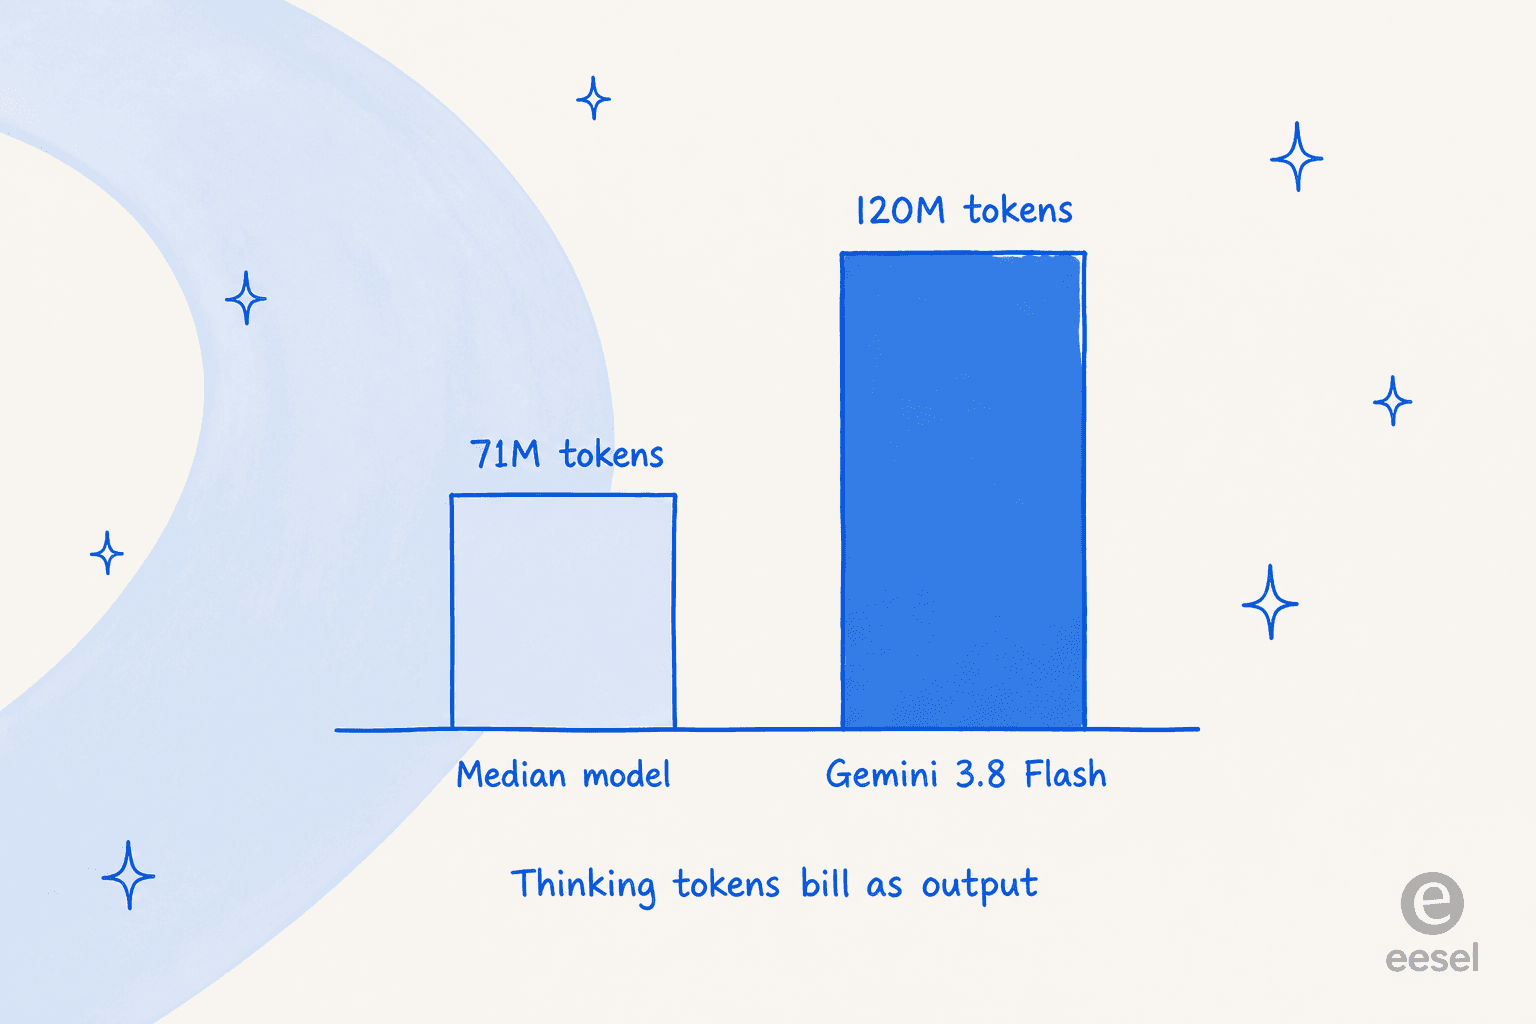
Artificial Analysis lo marcó como "very verbose": 120M de tokens de salida para ejecutar el Index frente a una mediana de 71M. Como Gemini factura los tokens de razonamiento a la tarifa de salida de 3,75 $, esa verborrea es un multiplicador de costo directo que el precio de etiqueta oculta. El usuario de HN bermudi le puso un número: alrededor de 11 mil tokens más por tarea que 3.7 en el mismo benchmark, "making it more expensive and slower in practice than the headline rate suggests." Mi artículo sobre los precios de Gemini 3.8 Flash tiene la aritmética completa, pero la versión corta es que una tarifa por 1M miente cuando el modelo decide emitir más de esos millones.
Luego está la niñera. mythz capturó una frustración que comparto:
"Whilst it's a fast model, having to baby sit through and approve prompts every few seconds ends up making it slower than the Auto approve modes of Claude/ChatGPT."
Y puede excederse en prompts simples. refulgentis reportó haber escrito "Hi" y recibir una app de cuatro paneles con un widget de clima falso y una lista de tareas. Es algo menor, pero es la señal de un modelo ajustado para hacer el máximo trabajo, que es exactamente lo que no quieres en una tarea estrecha y bien delimitada.
Dos advertencias más, con honestidad. En Terminal-Bench 4.0 obtiene 19,1 % frente al 51,8 % de Opus 5, así que "matches Opus 5" solo es cierto en los benchmarks que Google eligió mostrar. Y la ficha del modelo registra dos métricas de seguridad que retrocedieron: seguridad multilingüe en 5,4 puntos porcentuales y negativas injustificadas en 1,1 puntos porcentuales, con Google afirmando llanamente que "safety performance across non-English languages regressed slightly." La evaluación completa de Frontier Safety ni siquiera se volvió a ejecutar; se heredó de 3.7 por inferencia. Ninguna de estas cosas es determinante por sí sola, pero son el tipo de detalle que un análisis justo debe nombrar.
Lo que la gente dijo realmente tras probarlo
La lectura de la comunidad está dividida de una forma útil, y se ajusta casi exactamente a la división máquina-versus-humano de arriba.
Quienes ejecutan trabajos de programación largos en general lo apreciaron. Selta lo llamó "quite a big update," señalando las mejoras en el razonamiento de programación y menos alucinaciones manteniendo la velocidad. Conor Dart dijo "Google is back... this model takes its time to think and work through the tasks." Y scrlk planteó un punto que los benchmarks pasan completamente por alto: "Gemini's speed and quality doesn't degrade badly during weekday working hours compared to OAI, and especially Anthropic." La consistencia bajo carga es una ventaja real.
Quienes esperaban un salto quedaron más fríos. markasoftware señaló que en Artificial Analysis solo iguala a "opus 5 medium effort," y que "opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference." zuzululu llegó a la misma conclusión que yo: "i might consider 3.8 flash for simple side hobby projects or quick scaffolding but would not trust it for long agentic tasks." Y pkos98 ofreció el escepticismo más saludable sobre cualquier benchmark del día de lanzamiento: "Wait a week with your judgement, most likely, Google is just bench-maxing very hard."
También hay una queja estructural que vale la pena mencionar. Kol Tregaskes señaló que este es el cuarto modelo Flash consecutivo "with no Pro model." Eso no es un golpe contra 3.8 Flash en sí, pero es el contexto: los informes sugieren que 3.5 Pro se está omitiendo por completo, así que Flash está cargando el peso insignia mientras falta un modelo de nivel Pro en la alineación. Si estás comparando entre proveedores, ChatGPT vs Gemini y mi resumen de alternativas a Gemini son los dos puntos de partida más útiles.
El veredicto: ¿deberías cambiar desde 3.7 Flash?
Como el precio es idéntico, esta es la única comparación que importa, y es más clara que la mayoría de las decisiones de actualización.
| Si tu carga de trabajo es... | La elección | Por qué |
|---|---|---|
| Programación agéntica de largo alcance, tareas intensivas en documentos, un agente por lotes nocturno | Gemini 3.8 Flash | Genuinamente mejor en los benchmarks que importan aquí, al mismo precio; el pensamiento adicional vale la pena |
| Sensible a la latencia, con humano en el ciclo (chat, asistencia en vivo) | Gemini 3.7 Flash | El costo de 13,30 s hasta el primer token afecta directamente a una persona; la verborrea adicional es pura sobrecarga |
| Centrado en el costo, alto volumen, llamadas simples (clasificación, OCR, extracción) | Gemini 3.7 Flash | Google lo dice directamente: "remains fully supported for efficiency-first workloads" |
| Un auditor para verificar dos veces el trabajo de un modelo más grande | Cualquiera de los dos Flash | Suficientemente económico y rápido como para que usarlo como revisor sea un patrón inteligente |
El veredicto es que 3.8 Flash es una mejora real para exactamente un tipo de trabajo, y un retroceso disimulado para otro. Que Google te entregue ambos al mismo precio no es generosidad, es una admisión de que el modelo más nuevo cambia eficiencia por diligencia, y solo tú sabes en qué lado de ese intercambio está tu carga de trabajo. Una cosa más para tener en cuenta: la tarifa de 0,75 $ es una promoción que se duplica a 1,50 $ el 1 de enero de 2027. Quien presupueste con el número de hoy está presupuestando con un descuento.
Qué significa esto si vas a poner IA en una cola de soporte
Aquí es donde tengo que ser directo, porque pruebo estos modelos específicamente para responder la pregunta que los equipos de soporte no dejan de hacerme: "which model should we point at our tickets?"
La respuesta honesta es que el modelo es lo equivocado para comprar. Una carga de trabajo de soporte es casi el inverso perfecto de en qué es bueno 3.8 Flash. Los tickets son de contexto corto, no de largo alcance. El volumen es alto, así que la latencia se acumula, y un retraso de 13 segundos hasta el primer token multiplicado por miles de conversaciones es un costo real. Y un modelo en crudo no te da ninguna de las partes que realmente hacen funcionar la automatización de soporte: no conoce tu centro de ayuda, no puede leer tus tickets anteriores, no se integra dentro de Zendesk o Freshdesk, y no tiene forma de mostrarte lo que habría dicho antes de decírselo a un cliente.
He visto bots que suenan seguros dar respuestas equivocadas en silencio en colas en vivo, que es la falla de la que una puntuación de benchmark nunca puede advertirte. Por eso lo que me importa no es el Intelligence Index del modelo, sino si el sistema que lo rodea puede simularse primero contra tus tickets reales. Un modelo es infraestructura. Lo que un equipo de soporte realmente necesita es al empleado, conectado al helpdesk con el contexto y las barreras de seguridad ya en su lugar. La elección del modelo debajo de eso es un detalle que debería manejar la plataforma, no una decisión que deberías tomar leyendo benchmarks de lanzamiento.
Prueba eesel
Si lo que realmente quieres es que la IA responda tickets en lugar de un modelo que tú mismo tengas que conectar, eesel es donde yo empezaría. eesel vende compañeros de equipo de IA listos para trabajar en lugar de infraestructura en crudo, y el compañero de helpdesk con IA se une a tu cola existente en Zendesk, Freshdesk o Gorgias, entrenado con tu centro de ayuda y tus tickets pasados, en pocos minutos.

El diferenciador es la parte que los benchmarks de modelos no te pueden dar. Cada implementación de eesel se simula primero contra tus tickets históricos reales, así ves lo que la IA le habría dicho a clientes a los que ya atendiste, antes de que le diga algo a uno en vivo. También se encarga del trabajo poco glamoroso, como la clasificación de tickets y el etiquetado de soporte, y es gratis probarlo. El compañero redactor de blog con IA funciona sobre la misma plataforma si el contenido, y no el soporte, es tu cuello de botella.
En el lado de los números, ahorro de costos con IA en soporte tiene las matemáticas, y costo de agente frente a humano es la comparación que los equipos de finanzas realmente piden. Y si todavía estás comprando modelos en lugar de productos, los mejores agentes de IA y los mejores agentes de IA para pequeñas empresas son los dos resúmenes que leería a continuación.
Preguntas frecuentes
¿Vale la pena cambiar a Gemini 3.8 Flash desde 3.7 Flash?
¿Cuánto cuesta Gemini 3.8 Flash?
¿Por qué Gemini 3.8 Flash es tan verborrágico?
¿Es Gemini 3.8 Flash bueno para un chatbot de atención al cliente?
¿Cómo se compara Gemini 3.8 Flash con Claude Opus 5?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.