Qué es realmente Gemini 3.8 Flash
Gemini 3.8 Flash es el modelo de trabajo de Google, lanzado como gemini-3.8-flash y orientado directamente a la programación de largo alcance y a los agentes autónomos, más que al chat.
Las especificaciones no cambian respecto a la generación anterior. Recibe texto, imagen, audio, video y PDF, entrega texto, y mantiene una ventana de contexto de 1M de tokens con un tope de salida de 64K. Hace llamadas a funciones, búsqueda como herramienta y uso del ordenador. Google publica todo esto en la ficha del modelo.
Dónde puedes acceder a él realmente varía según la audiencia. Los desarrolladores lo tienen en Google AI Studio, la API de Gemini, Android Studio y Google Antigravity, donde ahora es el modelo predeterminado. Eso último importa si estás buscando asistentes de programación con IA, porque significa que puede que ya estés usando 3.8 sin haberlo elegido.
Las empresas lo obtienen a través de Gemini Enterprise. Los consumidores lo tienen en la app de Gemini, AI Mode en Search y Google Sheets, pero solo con Google AI Pro o Ultra. Si estás valorando esos niveles de consumidor, los repasé en el artículo de Google AI Plus, y hay una guía separada sobre cómo desactivar Gemini en Workspace si se activó solo para tu equipo.
Hay un segundo modelo en el mismo anuncio, y la mayoría de la cobertura lo enterró. Gemini 3.8 Flash Cyber es una variante de seguridad con mitigaciones deliberadamente más laxas para trabajo cibernético, y está restringida a defensores de confianza a través del nuevo Fairwind Program. Más sobre eso más abajo, porque las cifras son la parte más impresionante de todo el lanzamiento.
La parte que Google dice en voz alta, y que casi nadie citó
Aquí está la frase que reencuadra el lanzamiento. De la ficha del modelo, repetida en cuatro secciones distintas:
"Gemini 3.8 Flash is based on Gemini 3.7 Flash."
Eso no es una línea sin importancia. Las secciones de Architecture, Training Dataset, Hardware, Software, Safety Policies y Acceptable Usage remiten todas a la ficha del modelo Gemini 3.7 Flash en lugar de describir algo nuevo. 3.8 Flash es 3.7 Flash entrenado más, no un modelo base nuevo.
Una vez que sabes eso, el resto del lanzamiento deja de ser sorprendente. Explica el ritmo de tres semanas. Explica por qué el precio no se movió ni un centavo. Y fija una expectativa realista: esto es una iteración, y se comporta como tal.
El blog de Google es igual de directo sobre el mecanismo detrás de las mejoras. Vale la pena leer la frase con atención, porque es una compensación disfrazada de característica:
"These performance gains stem from a core design choice: 3.8 Flash works harder. On complex tasks, it exhibits greater diligence, executing extra reasoning steps, and calling tools iteratively. At times, the model might use more tokens to maximize performance, especially at higher effort levels."
Luego viene la frase que debería decidir tu actualización: Google recomienda a los desarrolladores a quienes les importa la eficiencia de cómputo "continue to rely on Gemini 3.7 Flash, which remains fully supported for efficiency-first workloads." Que un proveedor diga que su modelo antiguo sigue siendo la elección correcta es lo bastante raro como para tomárselo al pie de la letra.
Precios: idénticos a 3.7 Flash, y se duplican en enero
No hay recargo por el modelo más nuevo. La página de precios de la API de Gemini lista 3.8 Flash y 3.7 Flash con las mismas tarifas, línea por línea.
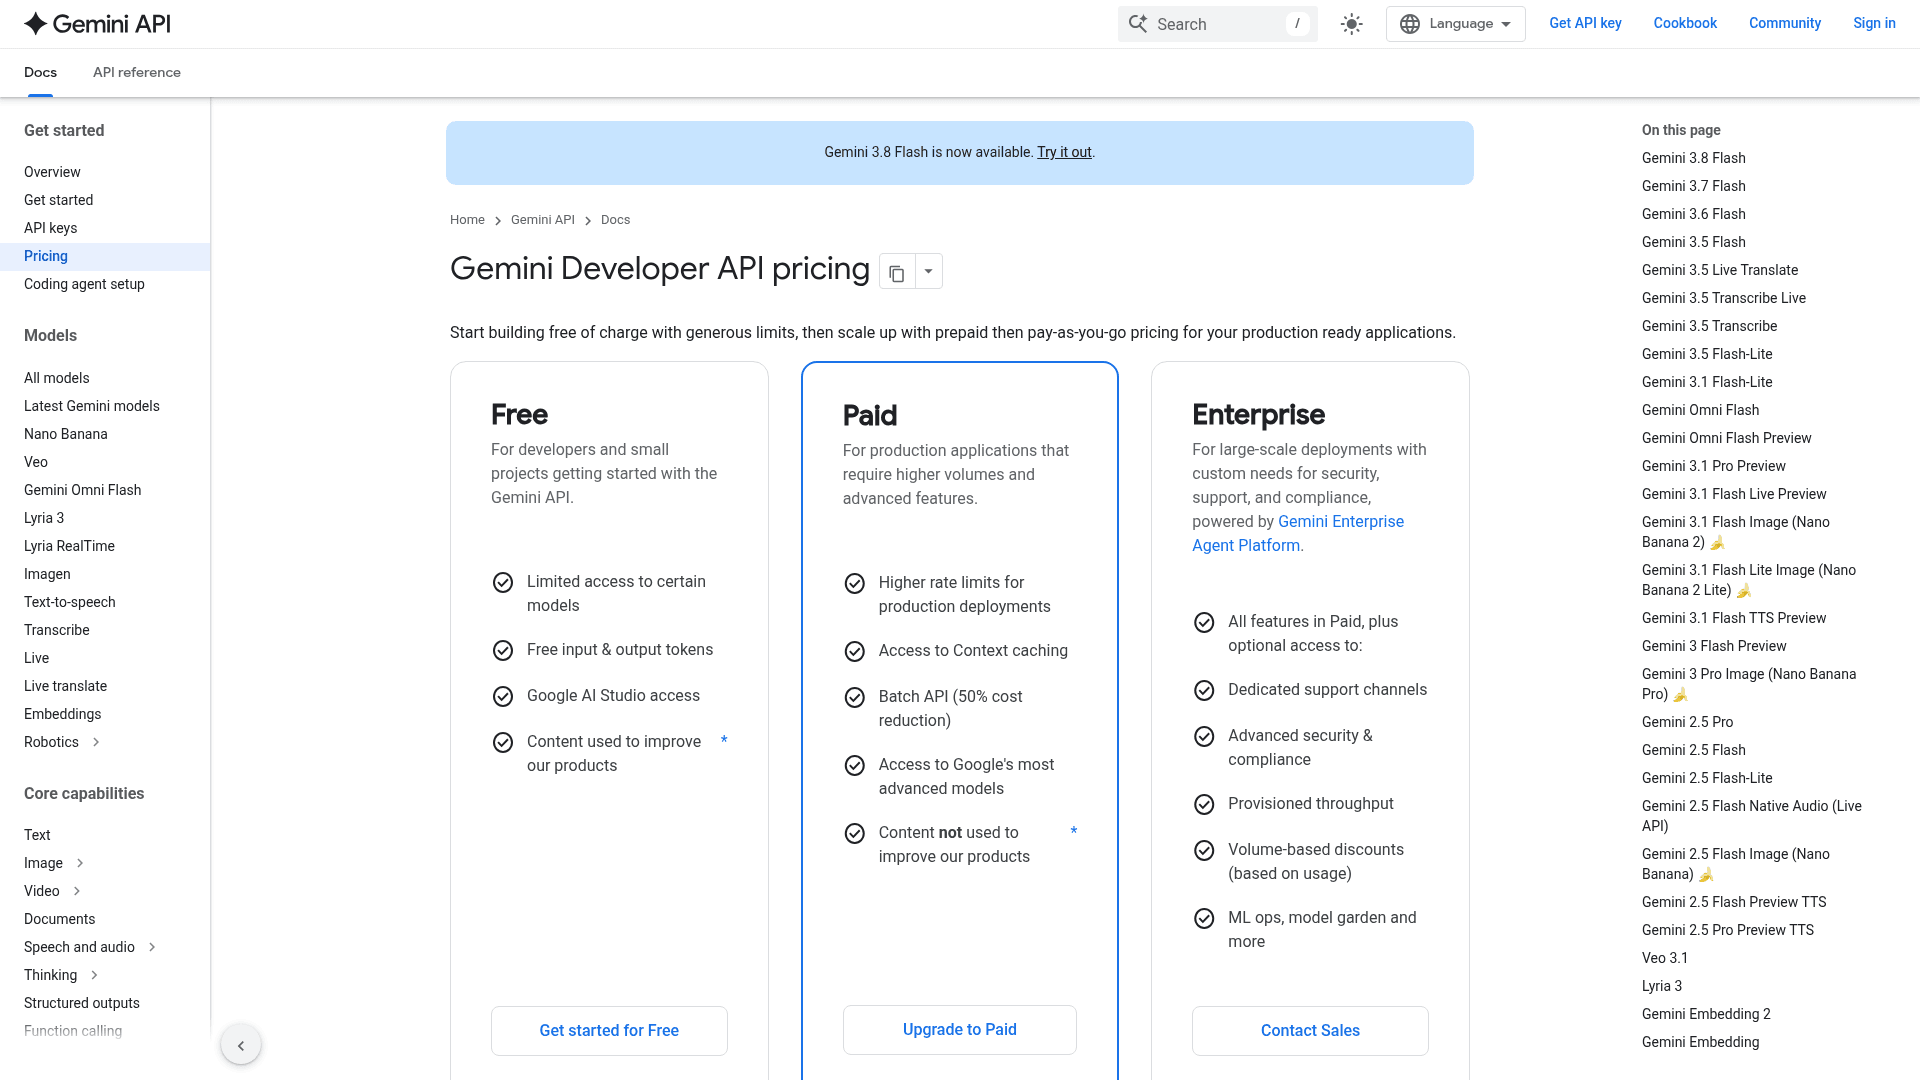
| Nivel | Entrada / 1M | Salida / 1M (incl. razonamiento) | Lectura de caché / 1M | Desde el 1 de enero de 2027 |
|---|---|---|---|---|
| Free | $0 | $0 | $0 | sin cambios |
| Standard | $0.75 | $3.75 | $0.075 | $1.50 / $7.50 |
| Batch | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Flex | $0.375 | $1.875 | $0.0375 | $0.75 / $3.75 |
| Priority | $1.35 | $6.75 | $0.135 | $2.70 / $13.50 |
Hay tres cosas en esa tabla que merecen más atención de la que suelen recibir.
El precio de salida incluye los tokens de razonamiento. Pagas $3.75 por millón por un razonamiento que nunca ves, solo un resumen de él. En un modelo cuya característica principal es que piensa más, ese es el medidor que se mueve.
El almacenamiento de caché se factura por separado. Las lecturas cuestan $0.075 por millón, pero el almacenamiento cuesta $0.50 por 1M de tokens por hora, también duplicándose en enero.
El grounding es compartido, no por modelo. Obtienes 5,000 solicitudes gratuitas de Google Search al mes en total entre todos los modelos Gemini 3.x, y luego $14 por 1,000. Misma asignación para el grounding de Google Maps.
Y la cifra destacada es una promoción. Cada tarifa aquí se duplica el 1 de enero de 2027. Si estás dimensionando un presupuesto de 2027 sobre $0.75, lo estás dimensionando con la cifra equivocada, un error que he visto cometer a equipos con los costos de LLM más de una vez. Merece la pena combinarlo con herramientas reales de seguimiento de LLM en lugar de una hoja de cálculo, porque la sobrecarga de tokens de razonamiento es la parte que nadie proyecta correctamente.
Para contexto sobre lo que cobra la competencia, precios de Claude Opus y límites de tasa de OpenAI son las dos comparaciones que más aparecen cuando los equipos modelan un cambio.
Los benchmarks con los que Google encabeza
Google publicó cuatro resultados destacados, y 3.8 Flash lidera en los cuatro. Aquí está el conjunto completo de la página de modelos de DeepMind, que es la fuente primaria en lugar de un resumen de prensa.
| Benchmark | Gemini 3.8 Flash | Gemini 3.7 Flash | Claude Opus 5 | GPT-5.6 Sol | GPT-5.6 Terra | Claude Sonnet 5 |
|---|---|---|---|---|---|---|
| HLE-Verified | 54.9% | 53.6% | 54.4% | 54.5% | 51.1% | 31.0% |
| Vals Finance Agent v2 | 61.4% | 59.0% | 58.6% | 53.8% | 54.4% | 53.9% |
| Harvey's Legal Agent | 10.0% | 8.8% | 6.7% | 2.5% | 0.8% | 5.0% |
| DeepSWE v1.1 | primer puesto | menor | menor | n/a | n/a | n/a |
Dos advertencias honestas antes de que alguien capture esa tabla en una imagen.
La fila de Harvey Legal Agent parece una paliza, pero la puntuación ganadora es 10.0%. Todos los modelos de esa columna fallan el benchmark; 3.8 Flash es el que falla menos. Superar a Opus 5 por 3.3 puntos en una prueba que nadie aprueba es un resultado real y pequeño a la vez.
Y en HLE-Verified, la brecha sobre Opus 5 es de medio punto. Google está reclamando un empate con un modelo de frontera a una fracción del precio, que es la historia real, no un nocaut. Si quieres la versión generación-contra-generación de ese argumento, Gemini vs Claude Opus y ChatGPT vs Gemini se sostienen ambos.
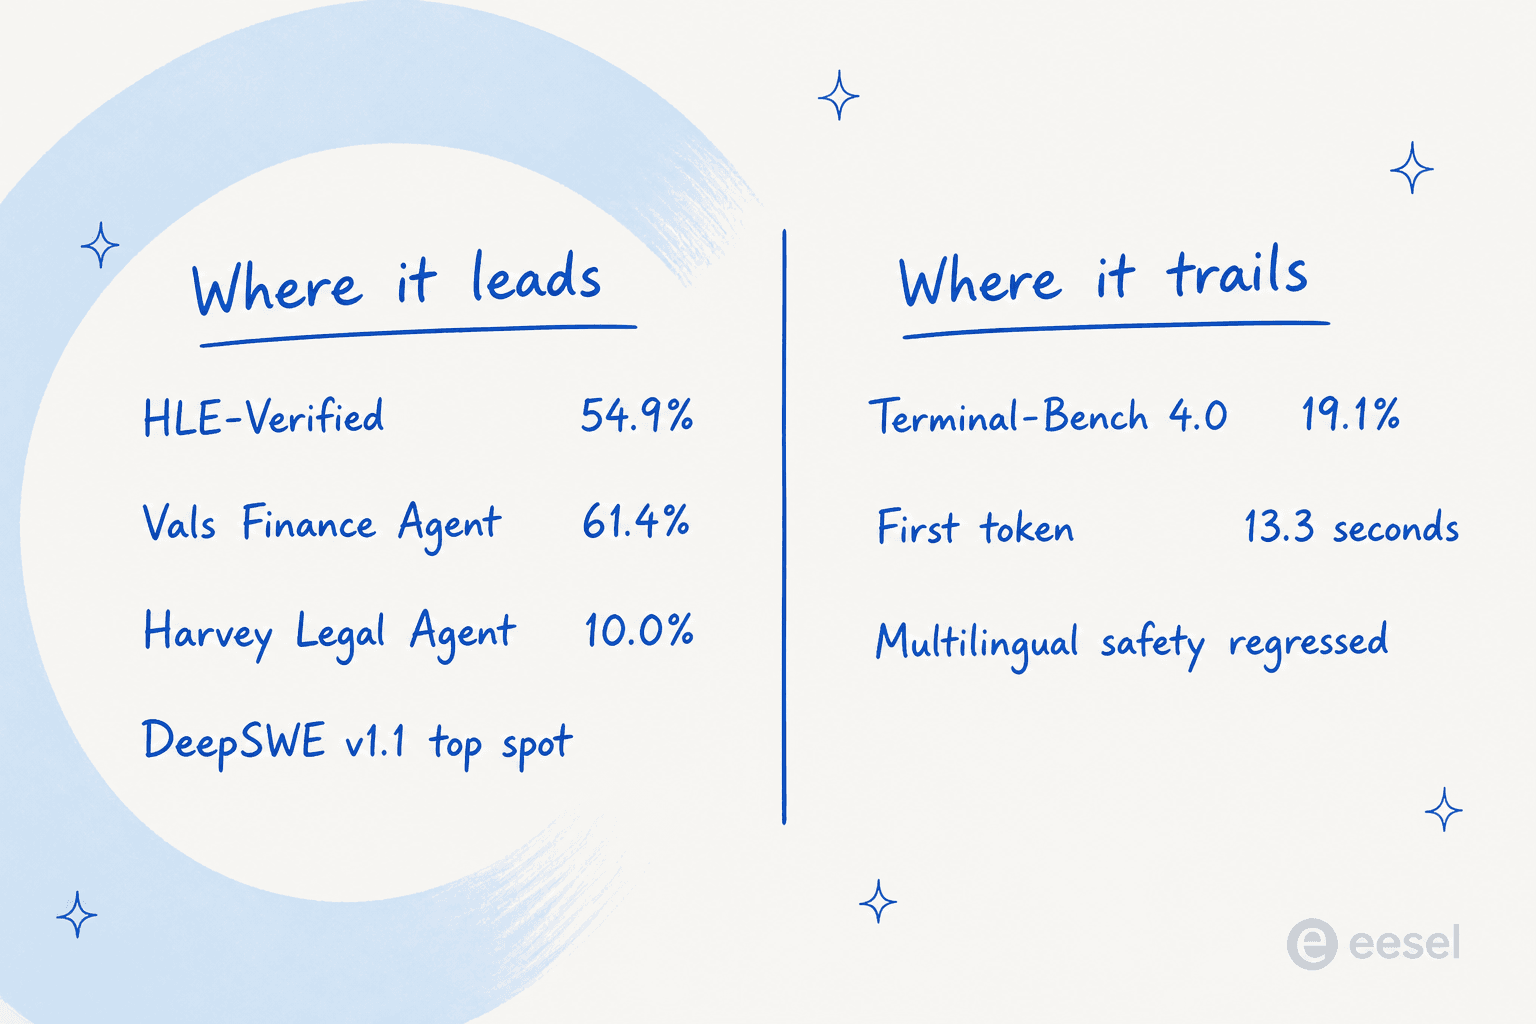
La columna de la derecha es la parte que la publicación de Google no cubre, y proviene de gente que ejecutó el modelo en lugar de solo anunciarlo.
Las cifras independientes cuentan una historia más útil
Artificial Analysis ejecutó 3.8 Flash con esfuerzo alto a lo largo de su Intelligence Index de nueve benchmarks, y las cuatro tarjetas resumen son más útiles para decidir que cualquier cosa en la publicación de lanzamiento.
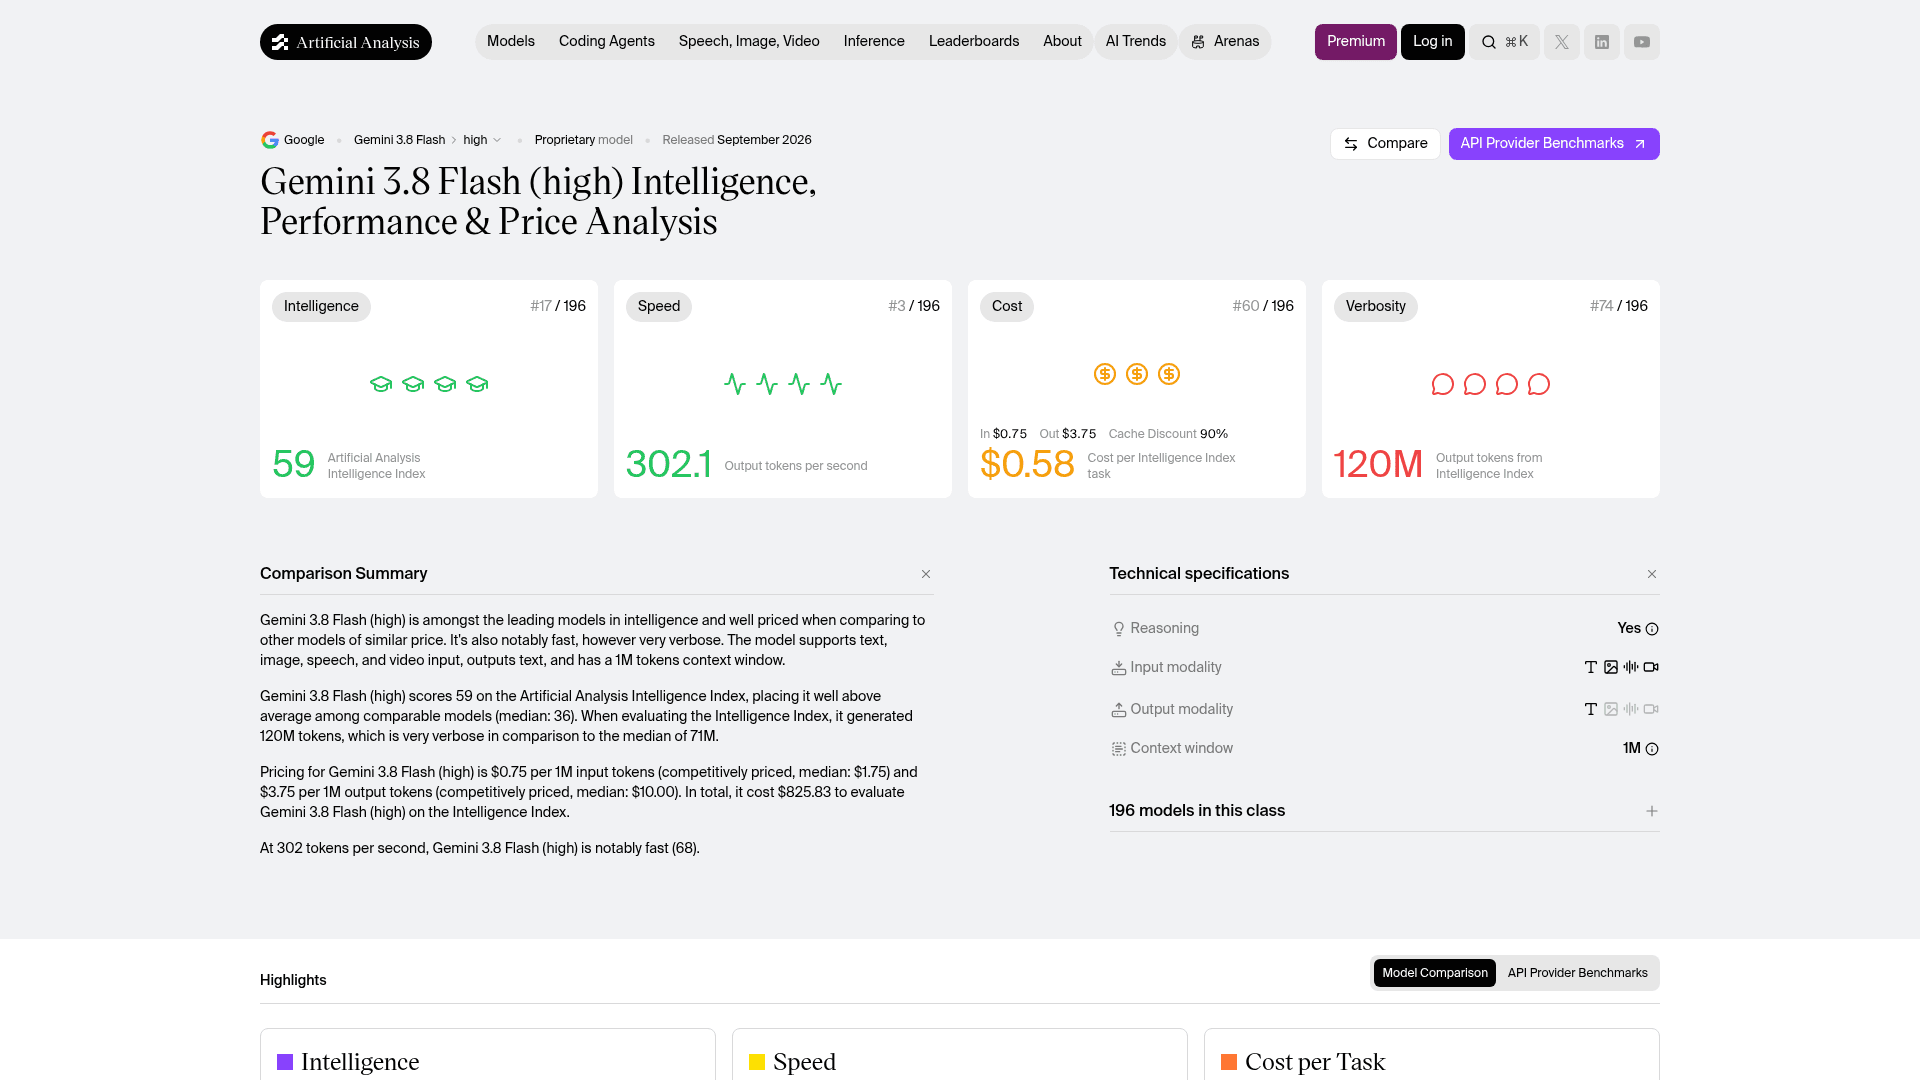
Inteligencia de 59, en el puesto 17 de 196, frente a una mediana de clase de 36. Costo de $0.58 por tarea del índice, en el puesto 60. Velocidad de 302.1 tokens de salida por segundo, en el puesto 3. Y verbosidad de 120M de tokens de salida para completar el índice, en el puesto 74, frente a una mediana de 71M. Artificial Analysis lo llama "very verbose" en su propio resumen. Ejecutar todo el índice con él costó $825.83.
Esa cifra de verbosidad es la historia de los precios en una sola cifra.
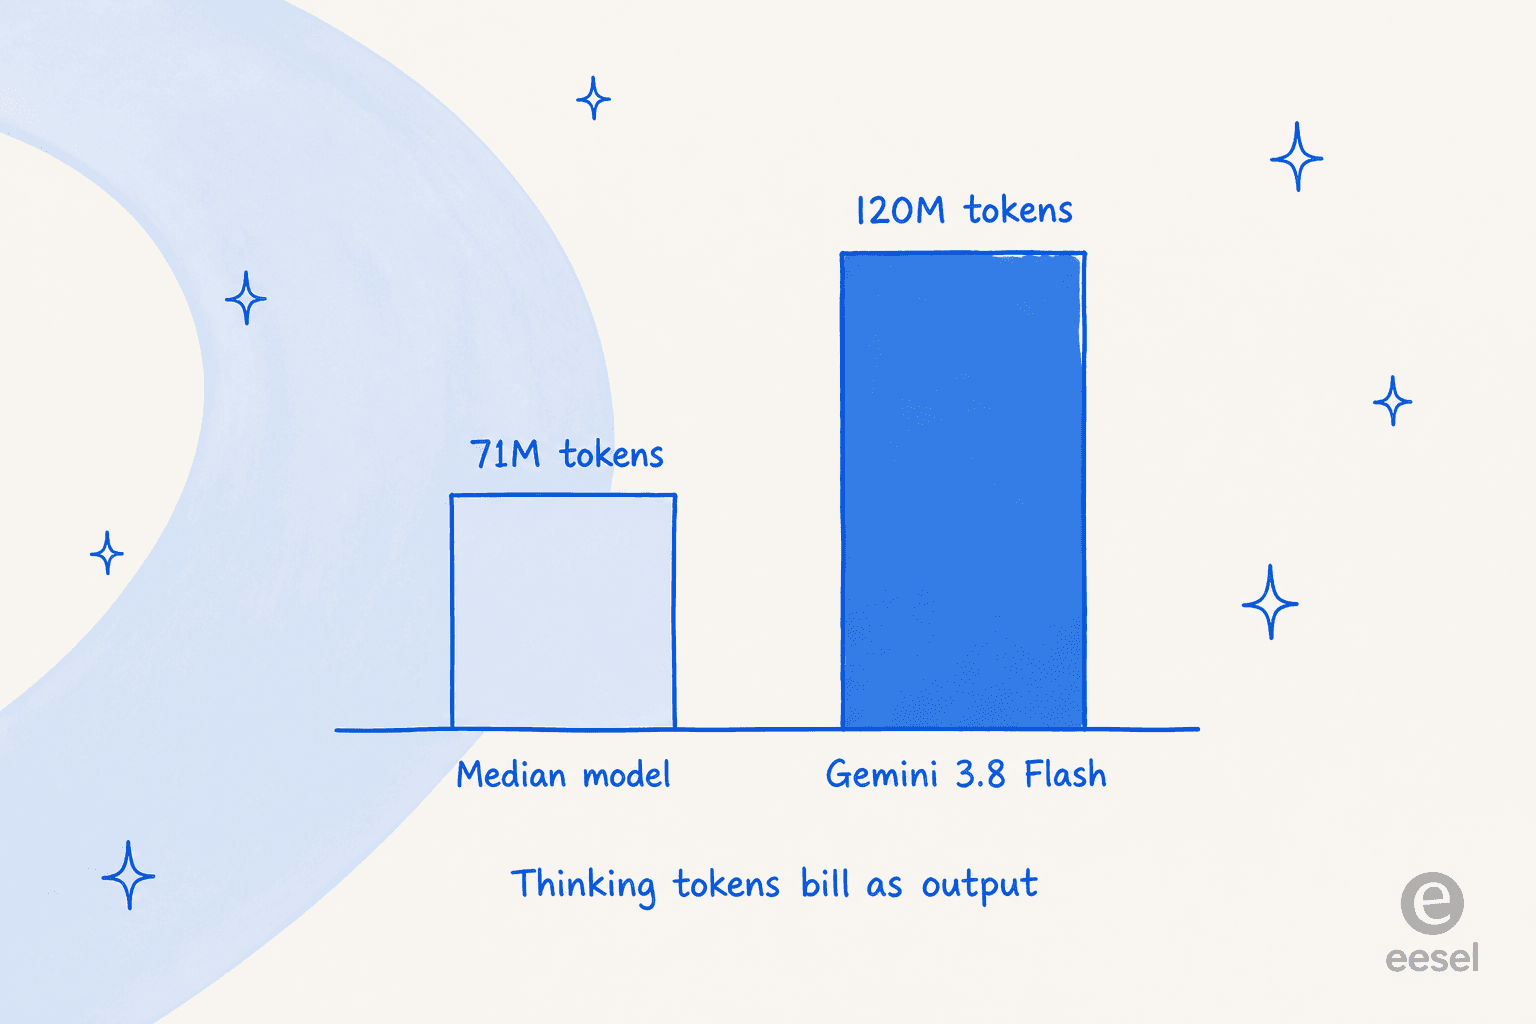
Un modelo que usa un 70% más de tokens de salida que la mediana, a $3.75 por millón, no es tan barato como sugiere su tarifa. Esa fue la corrección más aguda en el hilo de Hacker News, que llegó a 775 puntos el día del lanzamiento:
"On artificial analysis it's only equal to opus 5 medium effort. Opus 5 max scores 63. Further, opus 5 medium outputs 4x fewer tokens to achieve the same result, negating a lot of the speed difference."

Luego está la cifra que creo que casi todos pasaron por alto, y es la que cambiaría mi propia decisión de arquitectura.
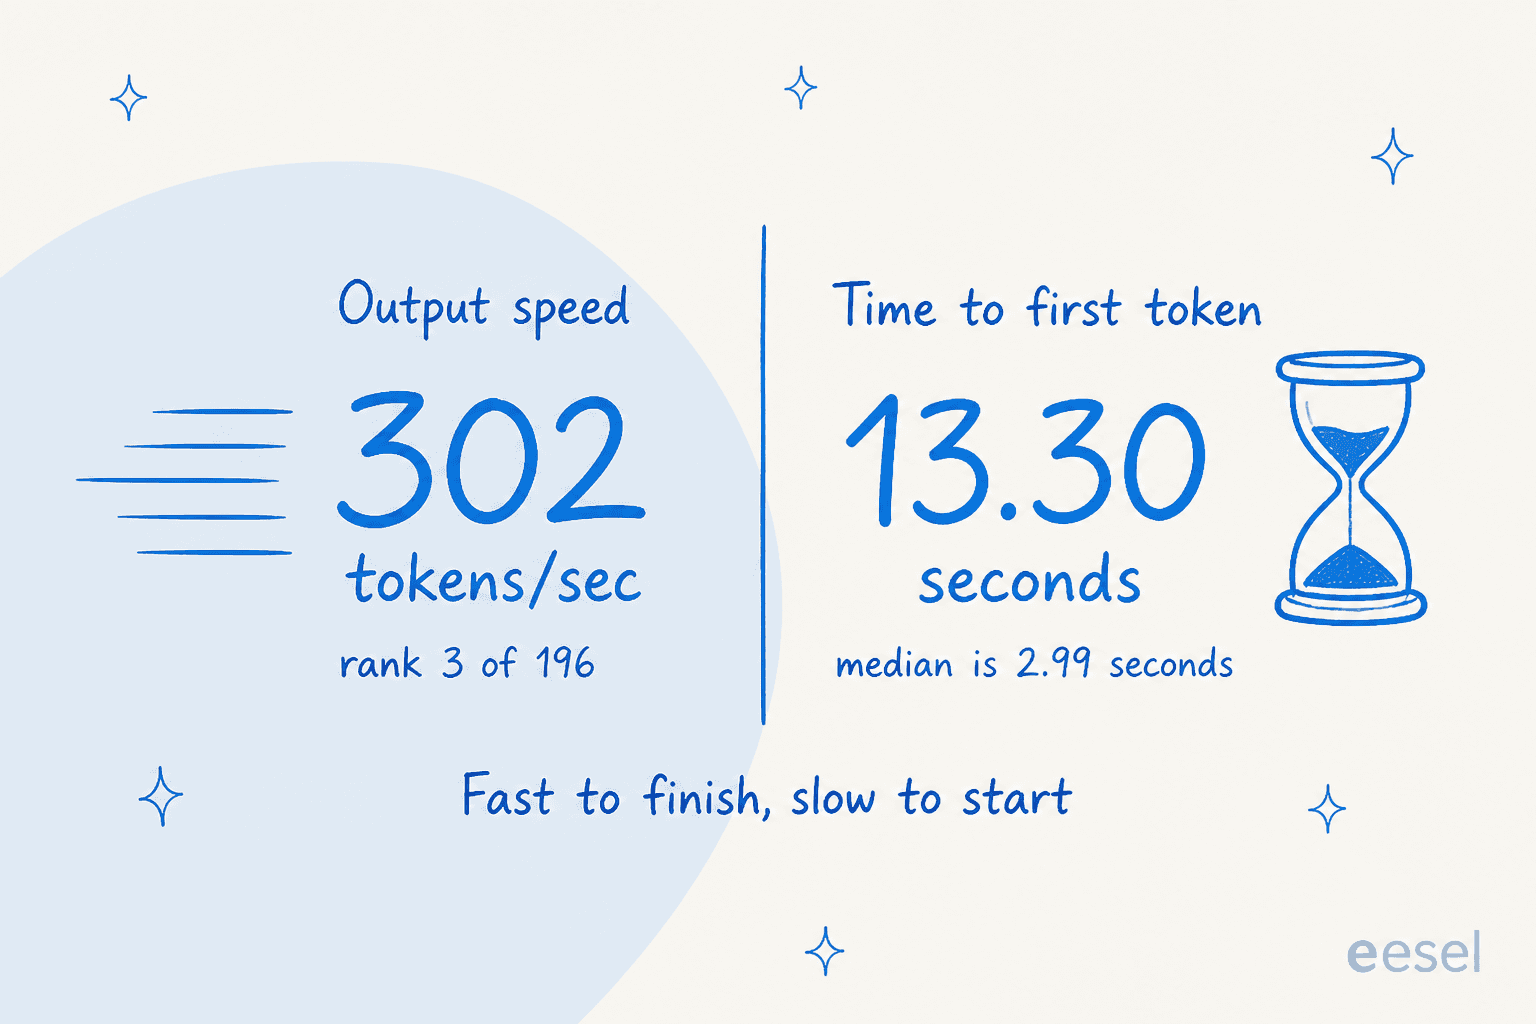
Artificial Analysis mide el tiempo hasta el primer token en 13.30 segundos, frente a una mediana de clase de 2.99 segundos. El tercer modelo más rápido del mundo en throughput es aproximadamente cuatro y media veces más lento de lo habitual para decir su primera palabra, porque primero está pensando.
Esa distinción importa enormemente y se aplana constantemente. El throughput es la rapidez con la que termina un trabajo largo. El tiempo hasta el primer token es cuánto tiempo mira una persona una pantalla en blanco. Para un agente por lotes que procesa un repositorio durante toda la noche, gana el throughput y el TTFT es irrelevante. Para cualquier cosa que una persona esté esperando, como una respuesta de soporte o un widget de chat, esos 13 segundos son toda la experiencia de usuario.
Lo que dijo la gente después de probarlo realmente
La reacción del día de lanzamiento se dividió claramente, y la división coincide con esa brecha entre throughput y latencia.
El propio defensor de desarrolladores de Google enmarcó el consumo de tokens como una característica en lugar de un costo, que es la versión más honesta del argumento del proveedor:
"It takes smaller steps and verifies its work more often. This can leads to higher token usage but it uses those extra tokens effectively to run tests and verify changes, giving you much higher quality work overall, especially for more complex and long-running goals."
Vale la pena notar que trabaja en Google DeepMind, así que trátalo como el encuadre del proveedor más que como una prueba independiente. Su publicación obtuvo 308 me gusta y, dos respuestas más abajo, una contradicción rotunda de alguien que lo había probado en trabajo real:
"Do not want to be negative, but it is absolutely not usable for SWE. Same very negative experience as it is with Gemini 3.7 Flash. Cost more than Fable on a really simple SWE tasks."
La reseña más útil que encontré vino de un desarrollador que hizo pasar un prompt de benchmark largo y publicó esa misma noche una lista clara de pros y contras:
"This model takes its time to think and work through the tasks you have given it, at a really great price and speed. Plus - long thinking, not a airhead model anymore there is subsistence here. Cons - I want to be able to have a better chat with the model before it begins it work, can't test its own work, and cant run and view in its own browser in antigravity."
Para chat en lugar de código, la lectura fue más positiva, y específicamente sobre lo que los modelos Flash siempre han hecho mal:
"The context window remains the same at 1 million tokens, but its coding reasoning ability has improved significantly, and hallucinations have been greatly reduced, so the issues where it would hallucinate or make grammatical missteps have decreased a lot."
En Hacker News, la idea de flujo de trabajo más práctica del hilo no era sobre reemplazar nada. Era sobre emparejar:
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green. Then I tell Opus to read the audit report and implement what it agrees with. Flash is really good at this, and it is blazing fast in Antigravity CLI."
Los escépticos tenían una objeción específica y verificable en lugar de una sensación. Un comentarista señaló el benchmark que Google omitió:
"There are important gaps in that hot take. For example, it's not even close to Opus 5 on Terminal-bench 4.0, 19.1% vs. 51.8%."
Y varios señalaron la saturación de benchmark en DeepSWE, lo cual es justo dado lo rápido que ahora todos los laboratorios lo superan. Como dijo uno, el benchmark ya ha sido "claramente 'resuelto'". Mi propio consejo es el mismo que el de zuzululu en ese hilo: mantén tu propio conjunto de evaluación, porque las tablas de clasificación públicas dejaron de diferenciar entre estos modelos hace tiempo.
Dos cosas en la ficha del modelo que nadie cita
Leí la ficha del modelo con detenimiento, y dos detalles ahí no aparecieron en ninguna cobertura que haya visto.
Dos métricas de seguridad retrocedieron. La propia tabla de Google lista Multilingual Safety en +5.4pp, donde menos es mejor, y Unjustified-refusals en +1.1pp, también donde menos es mejor. Google lo dice claramente en lugar de ocultarlo: "Safety performance across non-English languages regressed slightly relative to 3.7 Flash." Si atiendes a usuarios que no hablan inglés, esa es una consideración real, y es el tipo de cosa que solo se manifiesta en producción.
Relacionado, y vale la pena saberlo: Google no volvió a ejecutar la evaluación completa de Frontier Safety en 3.8 Flash. La ficha dice que el equipo evaluó 3.7 Flash y luego concluyó que, dado que 3.8 Flash no tiene "meaningful new capabilities", los resultados de 3.7 se mantienen vigentes. Razonable dado la base compartida, pero es inferencia, no medición.
La tabla de comparación tiene una línea base mal etiquetada. La tabla de seguridad se titula "Gemini 3.8 Flash vs. Gemini 3.7 Flash", pero la nota al pie 1 dice que la fila de Tone se mide "compared to Gemini 3 Flash". Ese es un modelo diferente y más antiguo sentado en una columna que afirma ser una comparación con 3.7. Un lector de Hacker News lo detectó primero y lo llamó "Chartcrime, the major AI lab tradition". Revisé la ficha en vivo y la nota al pie todavía dice eso.
Ninguno de los dos es un escándalo. Ambos son el tipo de detalle que separa leer la fuente primaria de reescribir el comunicado de prensa.
Gemini 3.8 Flash Cyber, el lanzamiento más impresionante
La variante de seguridad recibió una fracción de la atención y tiene las cifras más fuertes.
En CyberGym, el benchmark estándar para el descubrimiento autónomo de vulnerabilidades, Google dice que 3.8 Flash Cyber supera tanto a 3.5 Flash Cyber como a "significantly larger frontier models". En un benchmark interno que abarca 20 lenguajes de programación, supera una tasa de éxito del 70%. En CWE-Bench, un benchmark externo de parcheo ejecutado por Collinear, obtiene 47.2% pass@1 frente al 47.8% de un modelo de frontera líder, a un costo mucho más bajo.
Las cifras de despliegue son mejores que los benchmarks. El equipo de Chrome Security de Google descubrió que producía 2.6 veces más parches correctos para vulnerabilidades de Chrome que los mejores modelos comerciales, mucho más grandes. Wiz midió un recall entre 7.5 y 9.7 puntos porcentuales más alto en su benchmark interno de pruebas de penetración, a un costo entre 2.3 y 5.2 veces menor. Y el equipo de Cloud Vulnerability Research de Google lo usó para encontrar una vulnerabilidad fundamental crítica en menos de dos horas, un trabajo que normalmente lleva meses, según dicen ellos mismos.
El truco está en el acceso. No se puede comprar. Solo se distribuye a defensores de confianza a través del Fairwind Program, es decir, autoridades gubernamentales, operadores de infraestructuras críticas y mantenedores de software que solicitan acceso y son aprobados. Todos los demás obtienen el modelo estándar con las salvaguardas de CBRN y cibero-fensivas intactas.
Entonces, ¿deberías realmente cambiar?
Como el precio es idéntico, esto es puramente una cuestión de la forma de tu carga de trabajo.
Cambia a 3.8 Flash si ejecutas programación agéntica de largo alcance, investigación de múltiples pasos, o trabajo intensivo en documentos donde la calidad importa más que el número de tokens. El líder de producto de IA de Glean informó que "completing more than three times as many tasks as Gemini 3.7 Flash" en flujos de trabajo de documentos de larga duración en sus evaluaciones. Ahora es el modelo predeterminado en Antigravity, así que puede que ya lo estés usando.
Quédate con 3.7 Flash si tu carga de trabajo es de gran volumen, contexto corto o sensible a la latencia. Google lo dice él mismo. La brecha de verbosidad significa que 3.8 puede costar más por tarea completada a pesar de la tarifa idéntica, y los 13.30 segundos de TTFT descalifican a cualquier cosa interactiva.
No consideres ninguno de los dos si estás eligiendo un modelo para impulsar una característica de producto en lugar de para programar con él. Vale la pena decirlo explícitamente, y es la misma conclusión a la que llegué al escribir sobre los mejores agentes de IA y agentes de IA para pequeñas empresas: el modelo rara vez decide el resultado.
Qué significa esto si estás poniendo IA en una cola de soporte
Aquí quiero ser directo, porque es el error que veo con más frecuencia.
Los equipos que evalúan IA para atención al cliente pasan semanas comparando benchmarks de modelos, y luego lanzan algo que igualmente da respuestas equivocadas con total confianza. Un equipo de soporte con el que trabajé se topó exactamente con esto. Su bot les decía a los clientes "yes, we support your car model" para marcas de vehículos que no estaban en su base de datos, porque su base de conocimiento decía "we support all models". Ninguna puntuación de benchmark arregla eso. Nunca fue un fallo del modelo. Fue un fallo de recuperación de información y de alcance, y un modelo más inteligente habría dado la respuesta equivocada con más fluidez.
El patrón se repite. Un cliente planteó el requisito con tanta claridad como cualquiera podría:
"The AI will never be able to answer 100% of the questions. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
a DTC supplements CX lead, eesel customer research
Eso es un requisito de producto, no de modelo. El control de confianza, las reglas de escalado, la cobertura de temas delimitada y una prueba en seco contra tickets que ya has respondido son lo que determina si el soporte con IA funciona. Nada de eso aparece en una tabla de clasificación. Si quieres la versión más larga, escribí por separado sobre por qué los chatbots de IA responden incorrectamente.
El trabajo previo importa igual de mucho. Hacer bien la clasificación de tickets y el etiquetado de soporte es lo que permite a un bot saber qué tickets no debería tocar, y una base de conocimiento bien mantenida es lo que le impide inventar una respuesta desde el principio.
La versión de construir versus comprar de todo esto también surge constantemente:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES
Modelos como 3.8 Flash son infraestructura. Son el motor, no el empleado. Conectar uno a un helpdesk significa construir recuperación de información sobre tus documentos y tickets pasados, llamadas a herramientas hacia tu sistema de tickets, umbrales de confianza, rutas de escalado y una forma de probar todo eso antes de que un cliente lo vea. Ese es el proyecto real, y es el mismo proyecto sin importar si el modelo debajo es Gemini, Claude o un modelo de OpenAI.
Prueba eesel
Si lo que realmente quieres es que la IA responda tickets en lugar de conectar un modelo tú mismo, eesel es donde yo empezaría. eesel vende compañeros de equipo de IA listos para trabajar en lugar de infraestructura sin procesar, y el agente de helpdesk con IA se une a tu cola existente en Zendesk, Freshdesk o Gorgias, entrenado con tu centro de ayuda y tus tickets pasados, en unos minutos.

El diferenciador es la parte que los benchmarks de modelos no pueden darte. Cada implementación de eesel se simula primero contra tus tickets históricos reales, así que ves lo que la IA le habría dicho a clientes a los que ya atendiste, antes de que le diga algo a uno en vivo. Ese es el control que detecta el fallo de "we support all models", y existe porque eesel ha observado durante años a bots confiados equivocarse en colas reales. Es gratis probarlo, y el compañero escritor de blog con IA funciona en la misma plataforma si el contenido es tu cuello de botella en lugar del soporte.
Para más sobre las decisiones relacionadas, mi resumen de software de helpdesk con IA cubre el mercado, y automatización de tickets cubre la capa de flujo de trabajo debajo de eso.
En el aspecto monetario, ahorro de costos en soporte con IA tiene las cuentas, y costo de agente versus humano es la comparación que realmente piden los equipos de finanzas.
Y si todavía estás comprando modelos en lugar de comprando producto, alternativas a Gemini y los mejores agentes de IA son los dos puntos de partida más útiles.
Preguntas frecuentes
¿Qué es Gemini 3.8 Flash?
gemini-3.8-flash. Maneja entradas de texto, imagen, audio, video y PDF con una ventana de contexto de 1M de tokens y 64K de salida, y está ajustado para programación de largo alcance y agentes autónomos. La propia ficha del modelo de Google dice que se basa en Gemini 3.7 Flash en lugar de un modelo base nuevo. Si lo estás comparando con el resto del panorama, mi resumen de alternativas a Gemini cubre el resto.¿Cuánto cuesta Gemini 3.8 Flash?
¿Es Gemini 3.8 Flash mejor que Gemini 3.7 Flash?
¿Es Gemini 3.8 Flash mejor que Claude Opus 5?
¿Qué es Gemini 3.8 Flash Cyber y puedo usarlo?
¿Es Gemini 3.8 Flash bueno para el soporte al cliente?
¿Dónde puedo probar Gemini 3.8 Flash gratis?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.