

GLM-5.3-Flash es el primer modelo nativamente multimodal de Z.ai de la familia GLM-5, lanzado el 26 de agosto de 2026. Es un modelo de mezcla de expertos de 320B parámetros con solo 18B activos, una ventana de contexto de 1M de tokens, entrada de imagen y vídeo, y pesos abiertos en HuggingFace.
El titular es el precio. Obtiene 57 en el Artificial Analysis Intelligence Index a unos $0,045 por tarea, y los precios de la API empiezan en $0,075 por millón de tokens de entrada (una promoción de lanzamiento hasta el 9 de septiembre de 2026; precio de lista $0,15/$0,50). Es aproximadamente inteligencia de nivel GLM-5.2 a una décima parte del coste.
No lo confundas con el modelo estrella GLM-5.3. Flash es el hermano barato, multimodal y de alto rendimiento; el modelo estrella es el modelo solo de texto para programación y ciberseguridad, a $1,40/$4,40 por millón de tokens.
Para equipos de soporte y de contenido, el modelo es el motor, no el producto terminado. Un modelo barato y capaz sigue necesitando recuperación, integraciones, el conocimiento de tu empresa y pruebas antes de poder responder con seguridad a un cliente. Esa última milla es justo lo que resuelve eesel.
Qué es realmente GLM-5.3-Flash
Me dedico a construir agentes de IA, y casi cada semana aparece un nuevo modelo de "nivel frontera a una fracción del coste". GLM-5.3-Flash es uno de los pocos recientes en los que la afirmación se sostiene en gran medida al mirar los números.
Z.ai (la empresa antes conocida como Zhipu AI, con sede en Pekín) lo lanzó en el lanzamiento de GLM-5.3-Flash el 26 de agosto de 2026, con el lema "Frontier Intelligence, Flash Cost". Es el primer modelo de la serie GLM-5 que es nativamente multimodal: la imagen y el vídeo entran junto con el texto, y sale texto. Por dentro es un modelo de mezcla de expertos con 320B parámetros en total pero solo 18B activos en cada token, que es el truco que lo mantiene rápido y barato de servir.
Algunas especificaciones que conviene tener claras antes de nada, todas de la documentación del modelo de Z.ai:
- Ventana de contexto: 1M de tokens, con 128K de salida máxima.
- Entradas: texto, imagen, vídeo y archivos. La salida es solo texto.
- Razonamiento: el modo de pensamiento siempre está activado y, a diferencia de los modelos GLM anteriores, no se puede desactivar.
- Herramientas: admite llamadas a funciones, salida JSON estructurada, streaming y caché de contexto.
- Pesos: públicos en HuggingFace, se pueden alojar por cuenta propia con SGLang, vLLM o TokenSpeed.
El gráfico que resume por qué todo el mundo habla de este modelo es el de coste frente a inteligencia de Artificial Analysis. GLM-5.3-Flash cae en la esquina superior izquierda de "barato e inteligente", que casi nada más ocupa.
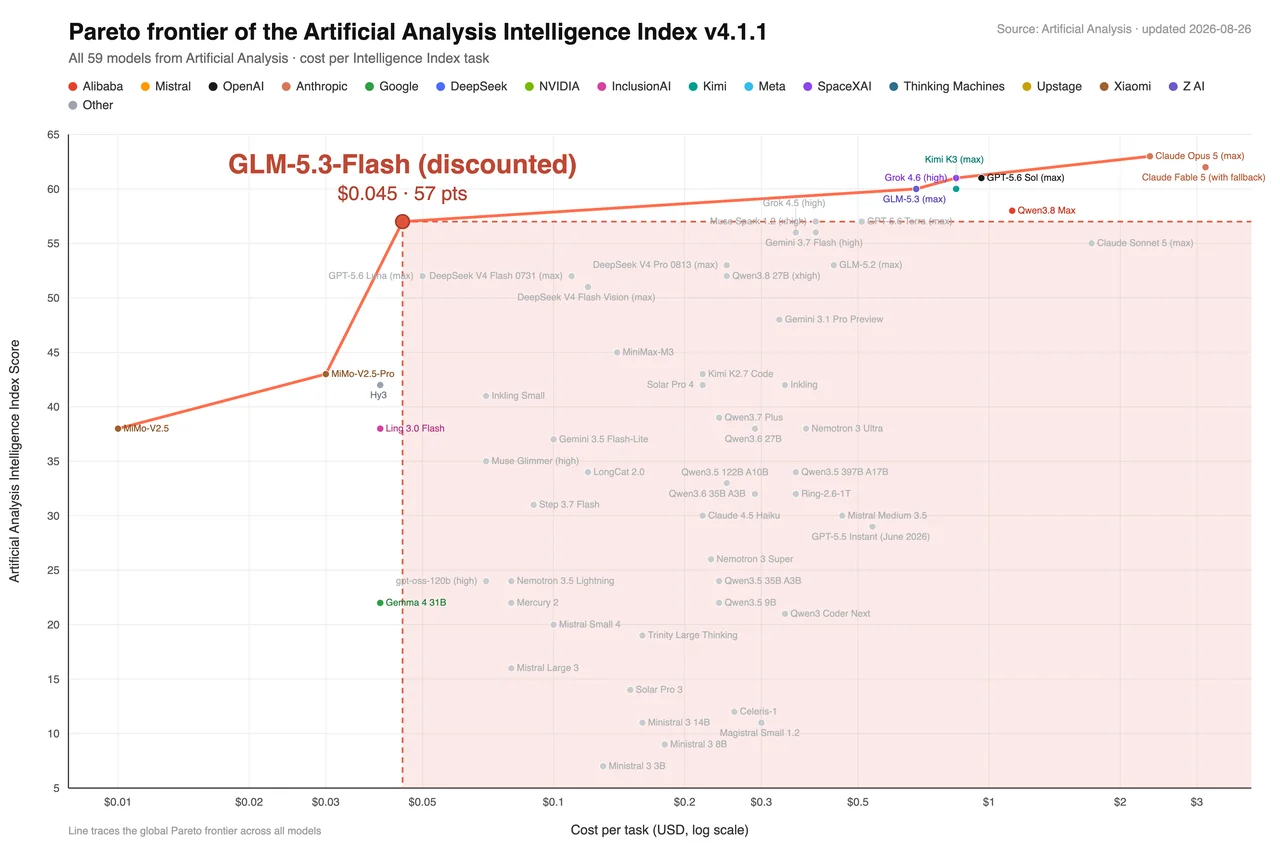
El planteamiento de la propia Z.ai es que ofrece "un nivel de inteligencia que antes solo estaba disponible a aproximadamente 10 veces el coste". Lo interesante es que no es márketing de un agregador, sino la cifra de un agregador de benchmarks independiente, algo mucho más difícil de falsear.
El lanzamiento sigiloso de "Ox Alpha"
Este es el detalle que más me llamó la atención. Antes del lanzamiento oficial, Z.ai lo ejecutó de forma anónima en OpenCode y OpenRouter como "ox-alpha" para recoger comentarios de uso real. Se convirtió discretamente en el modelo más usado de la semana, procesando más del doble de tokens que el siguiente modelo, todo servido en chips de IA chinos y no en hardware de Nvidia.
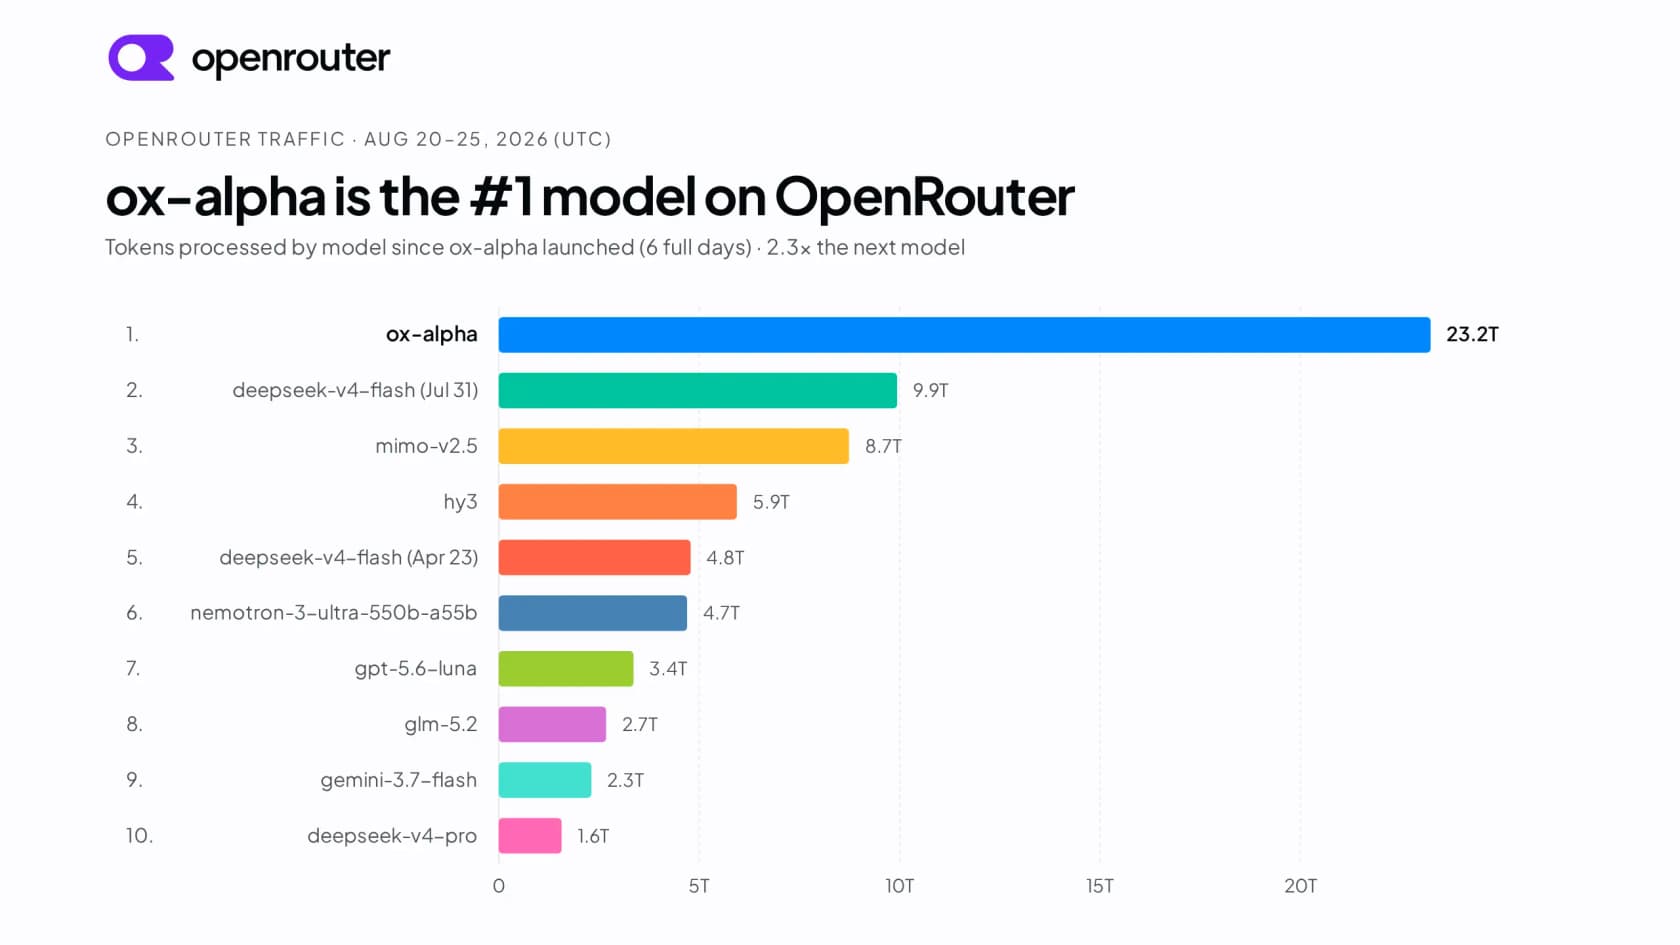
Aquí importan dos cosas. Primero, una prueba a ciegas en plataformas públicas es casi la señal más honesta que puede generar un laboratorio, porque nadie elegía el modelo por su marca. Segundo, el ángulo de los chips chinos es una historia real. Z.ai afirma que esto "demuestra que los chips chinos pueden respaldar la inferencia de modelos de frontera de forma eficiente y económica a escala", lo cual, si se sostiene, cambia las cuentas de gran parte del mercado que asumía que la inferencia de frontera significaba las GPU de un proveedor muy concreto.
Cómo GLM-5.3-Flash mantiene los costes bajos
Esta es la parte que de verdad me importa, porque "es barato" solo es interesante si el precio bajo es estructural y no una subvención que desaparece en seis meses.
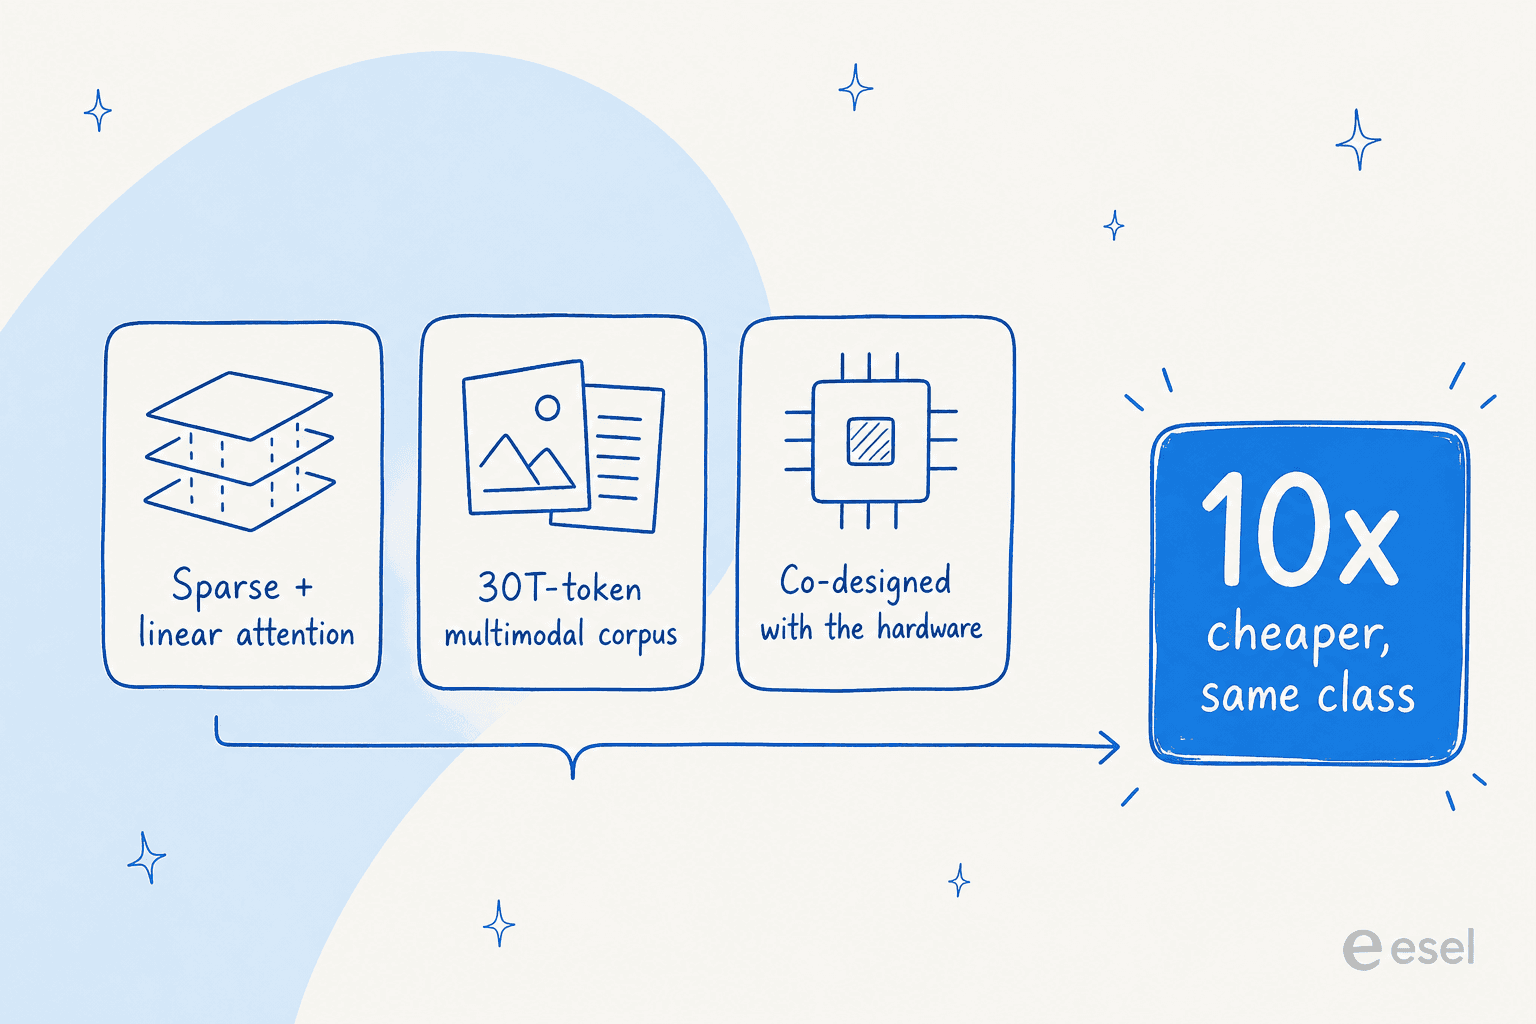
Z.ai divide el ahorro en tres capas, y el diagrama de arquitectura merece un momento de atención.
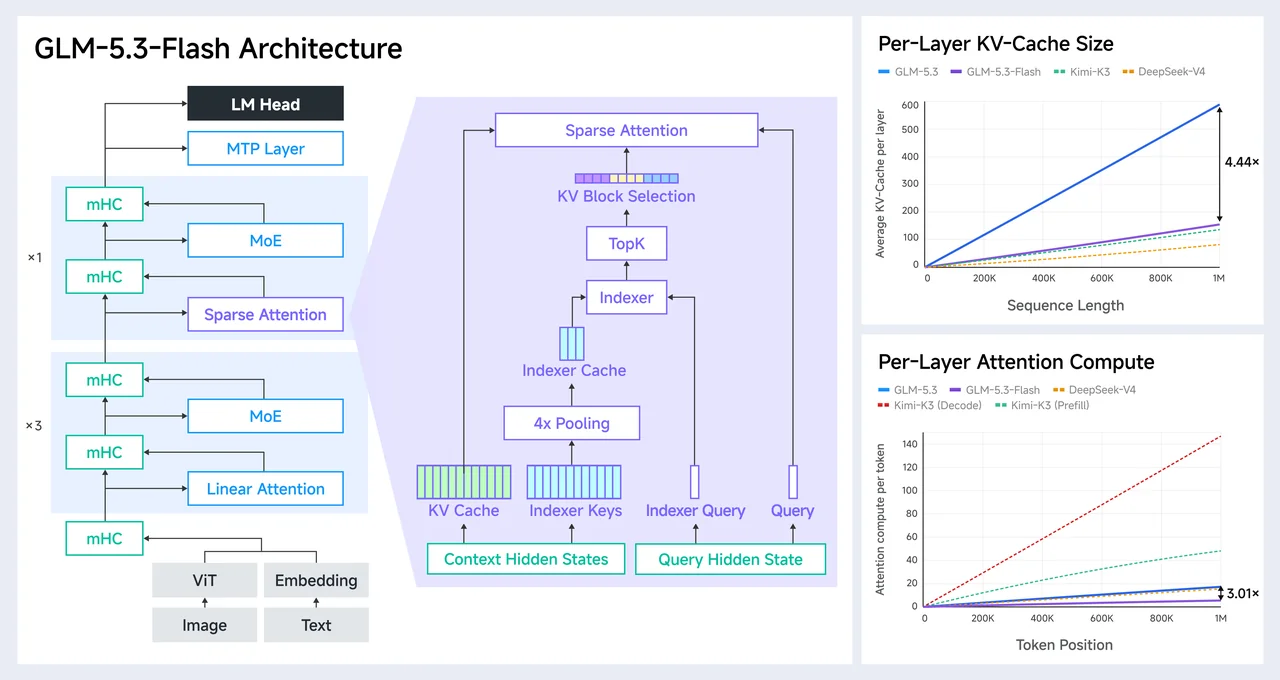
La primera capa es el diseño de la atención. GLM-5.3-Flash combina atención dispersa y lineal: la atención lineal maneja el contexto local mediante modelado de estado, y un indexador ligero recupera el contexto global que realmente importa. El resultado es concreto: frente al modelo estrella GLM-5.3, reduce el cómputo de atención 3,0 veces y el tamaño de la caché KV 4,4 veces. El contexto largo es donde los costes de servicio suelen dispararse, así que reducir la caché KV marca la diferencia entre que una ventana de 1M de tokens sea una función de demostración o algo asequible.
La segunda capa son los datos de entrenamiento, un corpus multimodal de 30 billones de tokens que incorpora la comprensión de imagen y vídeo desde el principio en lugar de añadir un codificador de visión después. La tercera es el codiseño de todo con el hardware de inferencia en el que se ejecuta.
Como comparación, GLM-5.3-Flash reduce casi a la mitad tanto el número de parámetros activos (18B frente a 32B) como el número de capas (45 frente a 92) de la serie GLM-4.5 anterior, manteniendo un tamaño total similar. Menos parámetros activos por token es la palanca más directa sobre el coste, y por eso un modelo de 320B puede tener el precio de uno pequeño.
Benchmarks de GLM-5.3-Flash
Los benchmarks son donde lo "barato" suele quedar al descubierto, así que esta es la sección que leería dos veces. La comparación de la propia Z.ai enfrenta a GLM-5.3-Flash con GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra y Gemini 3.7 Flash.
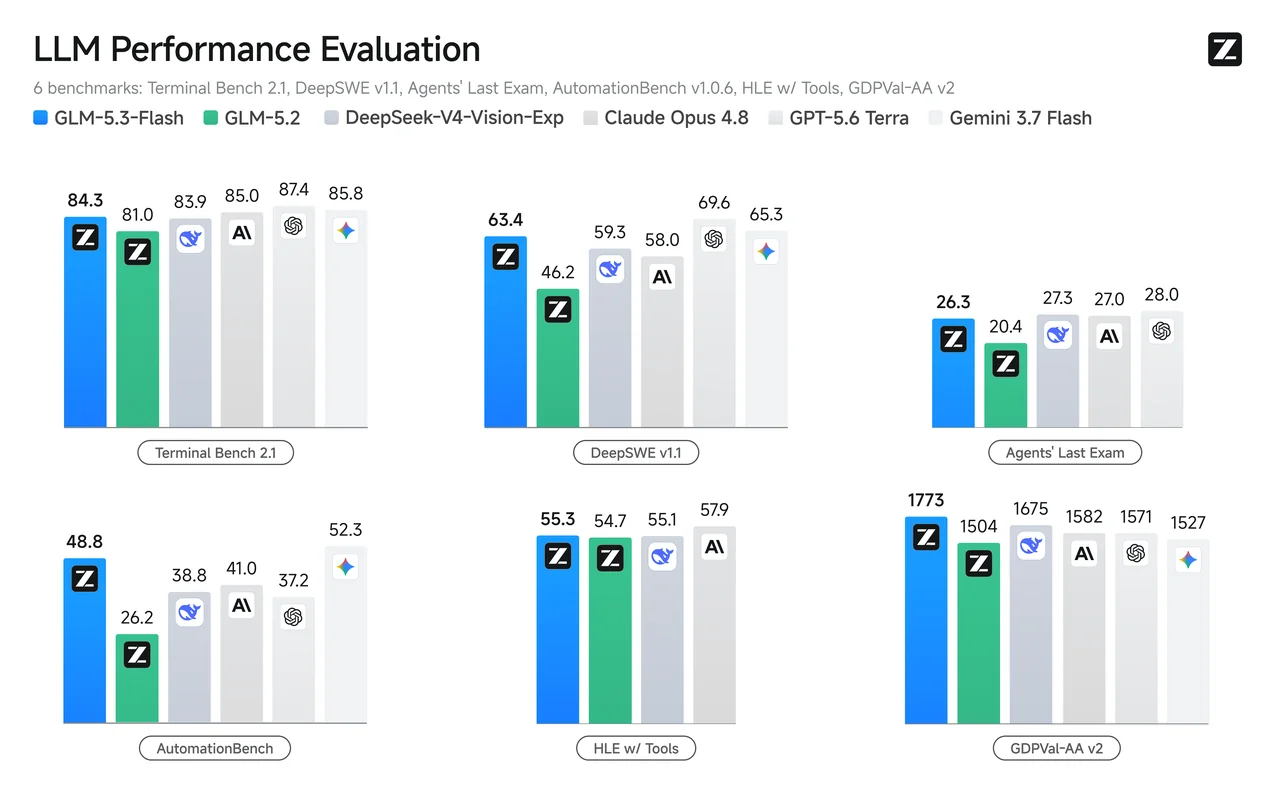
El salto respecto a la generación anterior es la verdadera historia:
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Opus 4.8 | GPT-5.6 Terra |
|---|---|---|---|---|
| DeepSWE v1.1 (programación) | 63.4 | 46.2 | 58.0 | 69.6 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | 41.0 | 37.2 |
| Toolathlon Verified | 78.4 | 59.9 | 76.2 | 74.9 |
| Terminal Bench 2.1 | 84.3 | 81.0 | 85.0 | 87.4 |
| GDPval-AA v2 | 1773 | 1504 | 1582 | 1571 |
Fuente: benchmarks de GLM-5.3-Flash de Z.ai.
Leído con honestidad, dos cosas son ciertas a la vez. GLM-5.3-Flash supera a GLM-5.2 en todos los frentes, a menudo por márgenes enormes (casi lo duplica en AutomationBench), y adelanta a Claude Opus 4.8 en varias tareas de agentes. También sigue por detrás de los mejores modelos de frontera cerrados, como GPT-5.6 Terra, en programación pura. En el Code Bench de la propia Z.ai con el máximo esfuerzo obtuvo 29,0 frente a 29,5 de Opus 4.8, así que "casi iguala a Opus 4.8" es una descripción justa, no una exageración. Para un modelo a una décima parte del precio, igualar a los modelos estrella de la generación anterior es justo el objetivo.
En el lado multimodal el panorama es más mixto. Logra puntuaciones sólidas en razonamiento sobre gráficos y documentos (89,4 en CharXiv, 78,0 en Chartography), pero queda por detrás de Gemini 3.7 Flash en benchmarks de vídeo puro como MVbench y MMVU. Si tu carga de trabajo es la comprensión de documentos e interfaces, es alentador; si es análisis de vídeo intensivo, pruébalo primero contra Gemini.
Precios de GLM-5.3-Flash
Aquí está la tarifa completa, directamente de la documentación de precios de Z.ai. Los precios son por millón de tokens.
| Modelo | Entrada | Entrada en caché | Salida | Notas |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 (lista $0.15) | $0.015 | $0.25 (lista $0.50) | 50 % de descuento de lanzamiento hasta el 9 sep 2026 |
| GLM-5.3 (modelo estrella) | $1.40 | $0.26 | $4.40 | Programación y ciber |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | 1M de contexto |
| GLM-4.7-FlashX | $0.07 | $0.01 | $0.40 | Texto |
| GLM-4.7-Flash | Gratis | Gratis | Gratis | Texto, totalmente gratis |
Un par de avisos para que nadie se lleve sorpresas. El precio de entrada de $0,075 es una promoción de lanzamiento que termina a medianoche del 9 de septiembre de 2026 (hora de Singapur), tras lo cual vuelve a $0,15. Incluso a precio de lista es, con mucha diferencia, el modelo de pago más barato de la serie GLM-5. La entrada en caché es otro ~80 % de descuento, lo cual importa mucho en cargas de trabajo de agentes que reenvían el mismo prompt de sistema en cada turno. La búsqueda web integrada se factura aparte a $0,01 por llamada.
También hay una vía de suscripción. El GLM Coding Plan empieza en $18/mes (Lite), $80/mes (Pro) y $168/mes (Max), funciona dentro de Claude Code, Cline, OpenCode, Cursor y más de 20 herramientas, y da a GLM-5.3-Flash 3 veces la cuota del modelo estrella. Las horas valle (que incluyen todo el fin de semana) se facturan a la mitad de la tasa de créditos.
Para concretar el lado de la API, aquí tienes una calculadora rápida. Introduce tu volumen diario de tokens y mira la factura mensual frente al modelo estrella.
GLM-5.3-Flash vs el modelo estrella GLM-5.3 (y los niveles gratuitos)
Los nombres confunden a la gente, así que te diré con claridad qué modelo elegir.
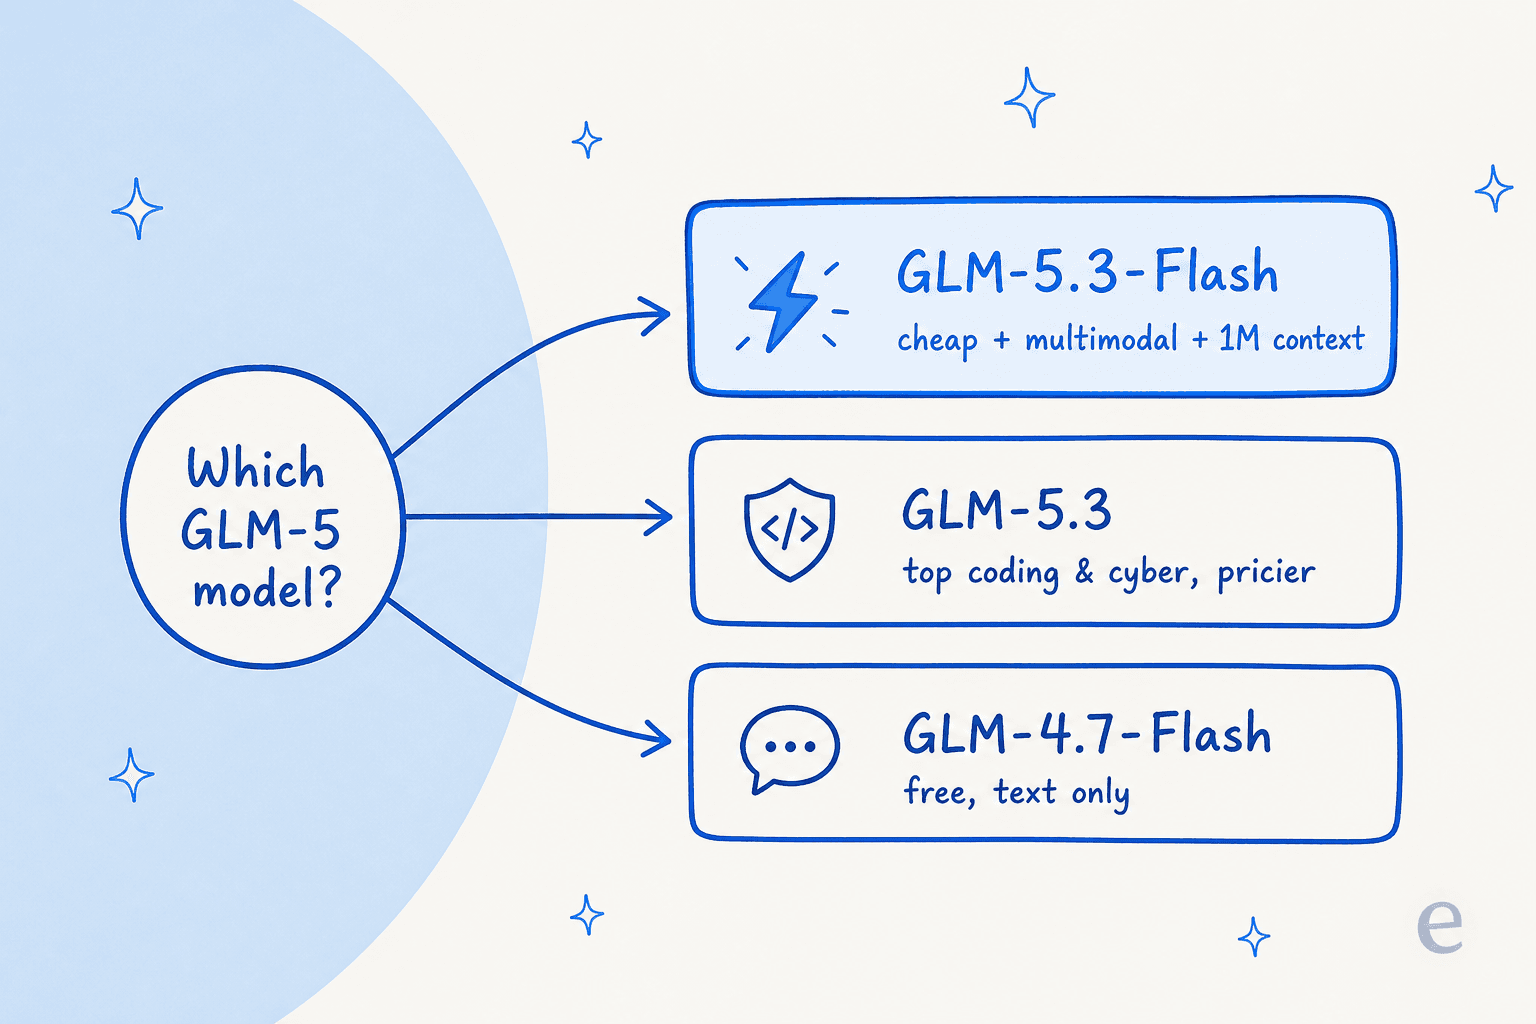
- GLM-5.3-Flash es el que eliges por defecto: barato, multimodal, 1M de contexto, alto rendimiento en proveedores externos. Ideal para cargas de alto volumen, tareas de visión y documentos, y todo lo que dependa del coste por token.
- GLM-5.3 (el modelo estrella) es un modelo realmente distinto, solo de texto, creado para programación y ciberseguridad. Lidera su clase en CyberGym y, en un estudio de seguridad de Z.ai, detectó 2.436 vulnerabilidades reales en 269 proyectos, algunas de las cuales llevaban décadas sin ser advertidas. Si haces trabajo difícil al estilo SWE-bench o revisión de seguridad, paga la prima.
- GLM-4.7-Flash y GLM-4.6V-Flash son totalmente gratuitos (texto y visión respectivamente), pero son más antiguos y menos capaces. Bien para prototipos, no para calidad de producción.
Una advertencia que sale constantemente: la velocidad depende de dónde lo ejecutes. En la API de la propia Z.ai, GLM-5.3-Flash es lento (~49 tokens/segundo), y los miembros de la comunidad fueron tajantes al respecto. En proveedores externos es otra cosa, con Databricks registrando 272,9 tokens/segundo en Artificial Analysis. Si el rendimiento importa, elige el proveedor con criterio.
Qué dice la gente
La reacción de la comunidad ha sido ruidosa y se agrupa en dos cosas: incredulidad ante el precio y quejas por la velocidad del proveedor original.
En cuanto al coste, la comparación recurrente es con los otros modelos de pesos abiertos baratos junto a los que ahora está, como Qwen y Kimi K2.5. De un hilo de Reddit muy compartido:
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Los investigadores de seguridad estuvieron entre los más rápidos en hacer pruebas reales. Uno publicó una cifra concreta de coste frente a hallazgos, exactamente el tipo de resultado específico en el que confío más que en una corazonada:
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Y sobre la nueva capacidad de visión, un evaluador independiente la puso a prueba con una muestra considerable:
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
El contrapeso honesto es la velocidad. Un hilo de r/opencode llamó al endpoint original "one of the slowest models AA [has ever seen]", lo que concuerda con la cifra de ~49 t/s de la propia Z.ai. Es una limitación real, y es específica del proveedor, no una propiedad de los pesos.
Dónde termina un modelo en bruto y empieza un compañero de equipo
Esta es la parte que se pasa por alto en cada lanzamiento de un "modelo de frontera barato", y es lo que he aprendido por las malas en más de tres años poniendo IA en colas de soporte reales: un modelo no es una solución.
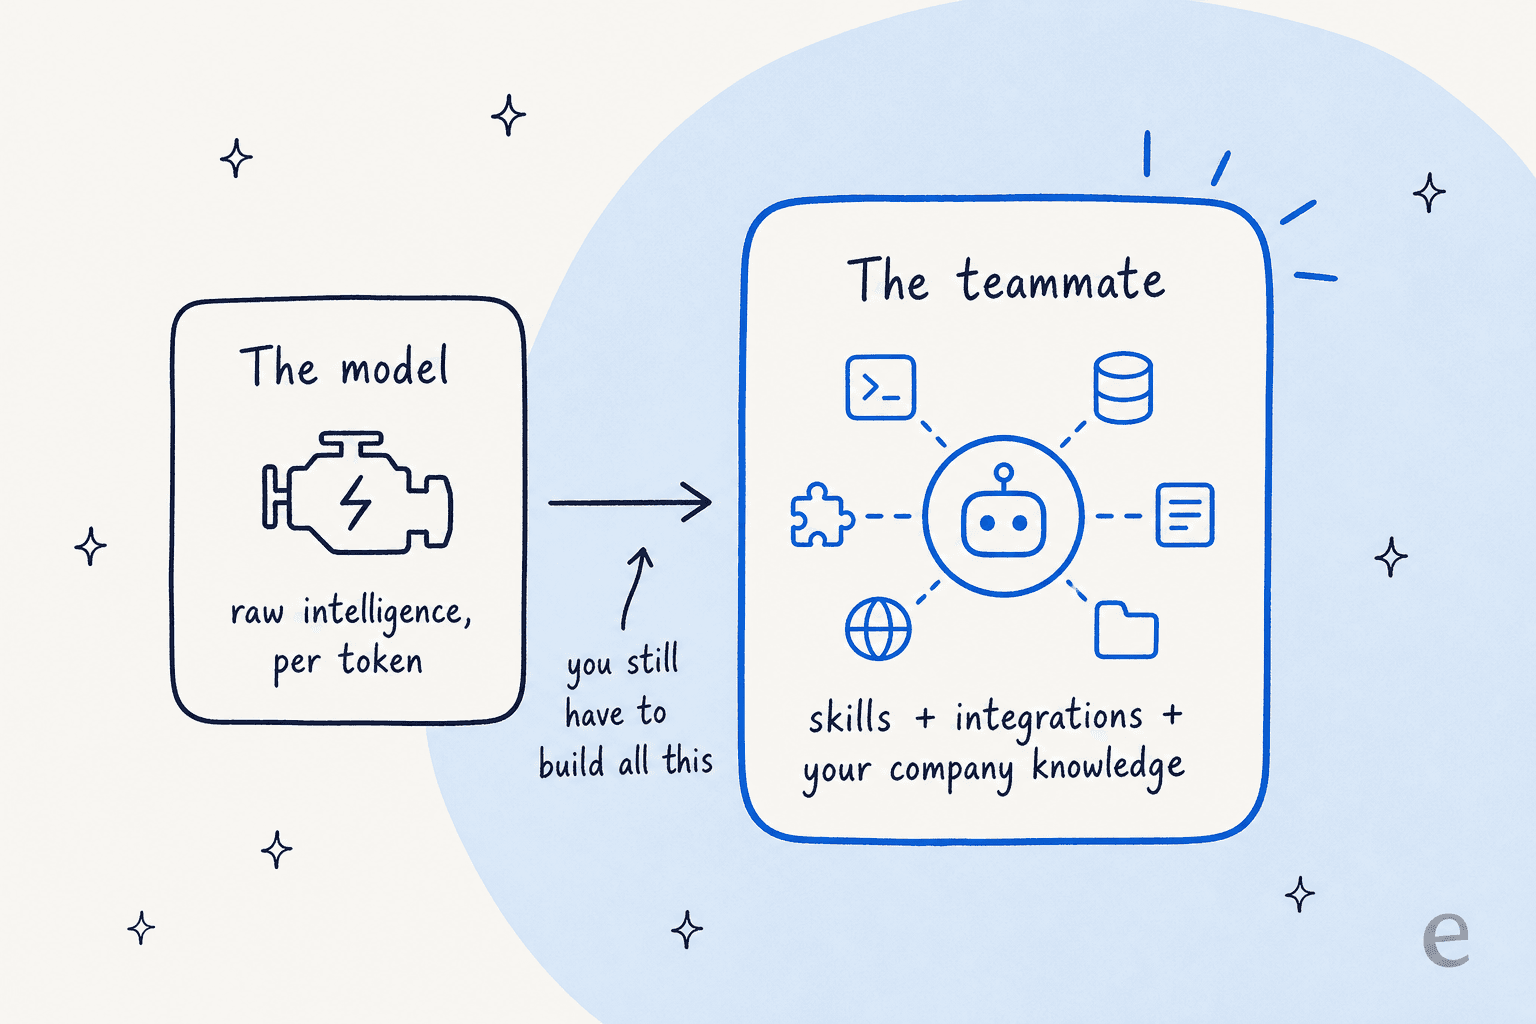
GLM-5.3-Flash te da inteligencia barata y capaz por token. No te da un sistema que conozca tu política de reembolsos, pueda leer el historial de Zendesk de un cliente, recupere el documento de ayuda correcto mediante RAG, ejecute una acción en tu helpdesk y se pruebe antes de hablar con una persona real. Cada una de esas cosas es un proyecto. Construimos todo nuestro producto alrededor de ese hueco, y el hábito más importante que adquirimos es simple: nunca confíes en un modelo con tickets reales hasta haberlo simulado con tu propio historial. Una respuesta que suena segura pero es silenciosamente errónea cuesta más que una lenta.
Así que, si eres desarrollador y quieres inteligencia en bruto para conectar a tu propio stack, GLM-5.3-Flash es una elección genuinamente buena y barata, y yo la usaría encantado. Si eres un equipo de soporte o de contenido que solo quiere el resultado, el modelo es la parte fácil y la última milla es el trabajo. Ahí es donde una plataforma de agentes de IA se gana su lugar. Es la misma razón por la que decimos que se comparen agentes terminados, no modelos en bruto, al evaluar la IA para la automatización del soporte al cliente.
Prueba eesel
Si te gusta lo que representa GLM-5.3-Flash (respuestas de nivel frontera sin facturas de nivel frontera) pero necesitas que haga un trabajo en lugar de quedarse detrás de una API, eso es eesel. Contratas a un compañero de IA, lo conectas a tus apps y empieza a trabajar desde el primer día: un compañero de IA para el helpdesk que se une a tu cola actual en Zendesk, Freshdesk o Gorgias, y un redactor de blog de IA que entrega artículos investigados y listos para publicar.
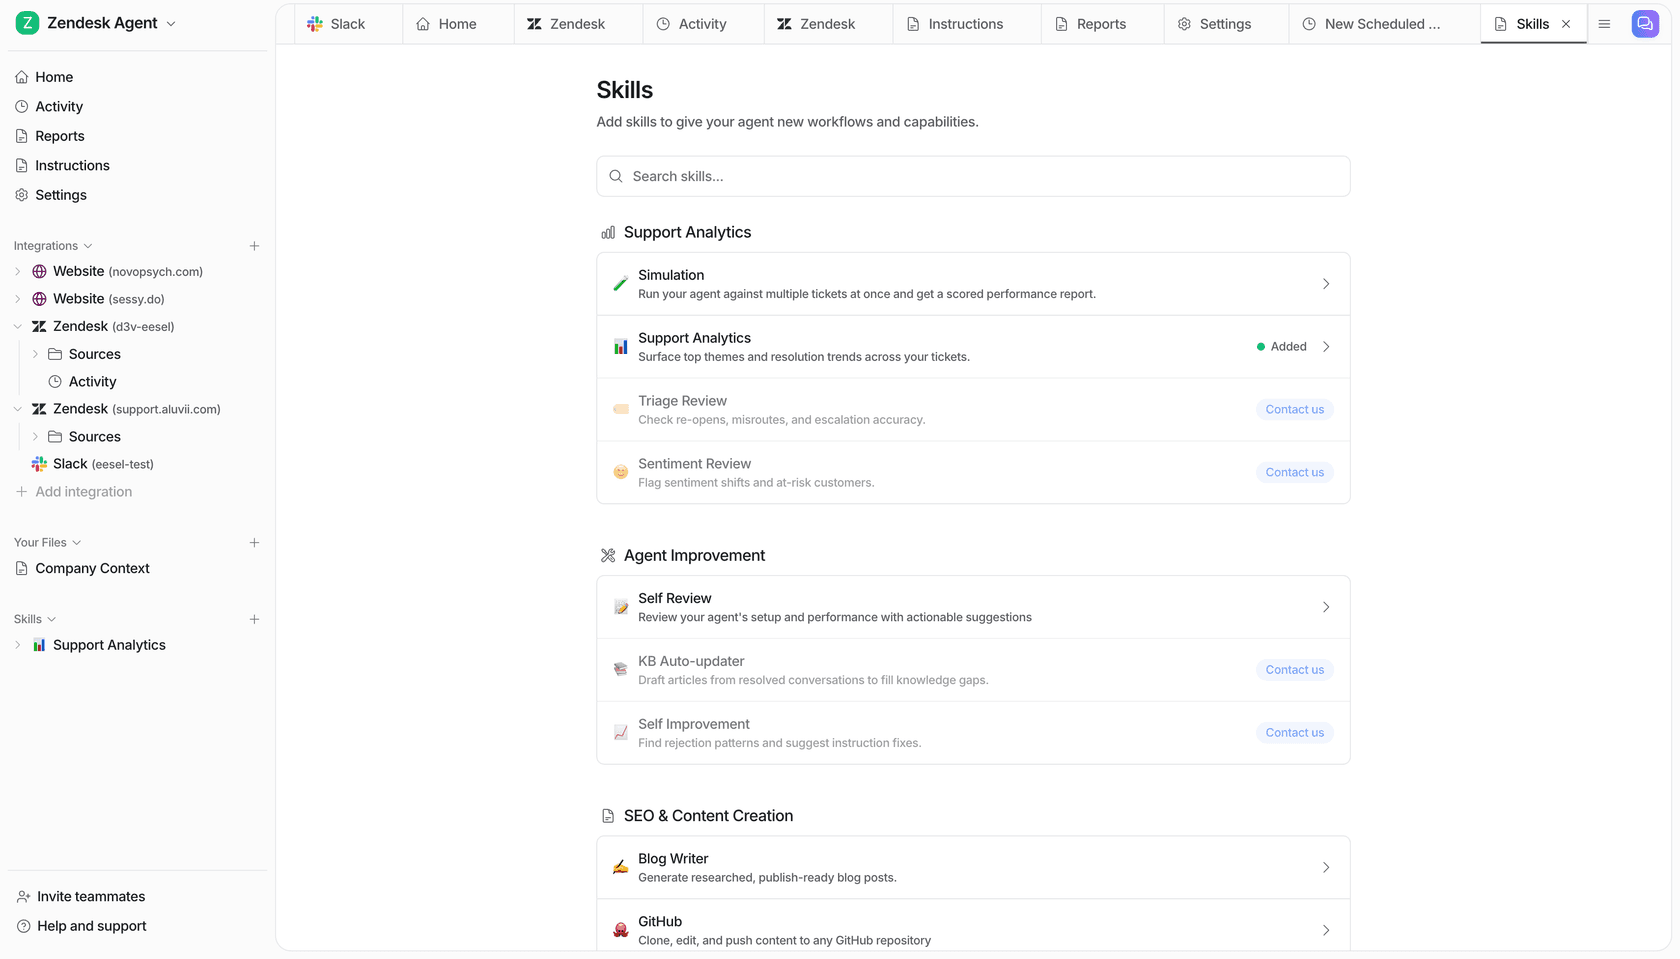
La diferencia con un modelo en bruto es la fontanería que ya está hecha: lee tu base de conocimiento y tus tickets pasados, trae las integraciones y habilidades para el puesto y (la parte que más me importa) puedes simularlo con miles de tus tickets históricos antes de que responda uno solo en vivo. Obtienes la inteligencia del modelo con la red de seguridad que una API en bruto no te da. Es gratis para probar, sin llamada de ventas.
Preguntas frecuentes
¿Qué es GLM-5.3-Flash?
GLM-5.3-Flash es el primer modelo nativamente multimodal de la serie GLM-5 de Z.ai, un modelo de mezcla de expertos de 320B parámetros con 18B parámetros activos, una ventana de contexto de 1M de tokens y pesos abiertos en HuggingFace. Z.ai lo presenta como inteligencia de nivel GLM-5.2 a aproximadamente una décima parte del precio.
¿Cuánto cuesta GLM-5.3-Flash?
El precio de la API de GLM-5.3-Flash es una promoción de lanzamiento de $0,075 por millón de tokens de entrada y $0,25 por millón de tokens de salida hasta el 9 de septiembre de 2026, y después un precio de lista de $0,15/$0,50, según la documentación de precios de Z.ai. También está incluido en el GLM Coding Plan desde $18/mes. Si estás comparando facturas de modelos para soporte, nuestra guía del modelo de IA para tickets de soporte repasa las cuentas.
¿GLM-5.3-Flash es de código abierto?
Los pesos se pueden descargar públicamente en HuggingFace y puedes alojarlo tú mismo con SGLang, vLLM o TokenSpeed, así que es un lanzamiento de pesos abiertos. Revisa el archivo de licencia para conocer los términos exactos antes del uso comercial. Si los pesos abiertos te importan, nuestro resumen de plataformas de chatbots de código abierto cubre las herramientas que lo rodean.
GLM-5.3-Flash vs GLM-5.3: ¿cuál es la diferencia?
Son dos modelos distintos. GLM-5.3-Flash es el hermano barato, multimodal y de alto rendimiento (entrada de imagen y vídeo, 1M de contexto). El modelo estrella GLM-5.3 es la potencia de programación y ciberseguridad solo de texto, con un precio de $1,40/$4,40 por millón de tokens. Elige Flash por coste y visión, y el modelo estrella para los trabajos de programación más difíciles.
¿Puedo usar GLM-5.3-Flash para atención al cliente?
Puedes, pero un modelo en bruto no es un agente de soporte. No tiene acceso a tu base de conocimiento, a tu helpdesk ni a tus tickets anteriores hasta que alguien lo conecte todo. eesel te ofrece un compañero de IA para el helpdesk que ya hace esa conexión, así que obtienes la inteligencia del modelo sin construir tú mismo la recuperación, las integraciones y las pruebas.