

Qué es realmente StepFun Step 5 Preview
He pasado los últimos años poniendo IA en colas de soporte reales, así que leo cada lanzamiento de modelo igual: no "¿es bonito el benchmark?", sino "¿podría encargarle un trabajo real mañana?". Step 5 es un modelo genuinamente interesante, y también un buen ejemplo de por qué importa esa segunda pregunta.
StepFun (阶跃星辰) es un laboratorio de Shanghái que lleva un par de años lanzando la familia "Step" para texto, visión y audio, con una buena presencia de pesos abiertos en Hugging Face. Step 5 Preview es su nuevo modelo insignia, descrito en la página del producto como un modelo de frontera "para trabajo complejo y tareas agénticas", con especial inclinación hacia la ingeniería de software y las finanzas.
El enfoque al que StepFun vuelve una y otra vez es "avanzar la frontera de Pareto", la línea de mejores compromisos posibles entre inteligencia y dinero. Su propio gráfico de lanzamiento lo dice claro: igualar en inteligencia al nivel abierto más barato y superarlo en coste.
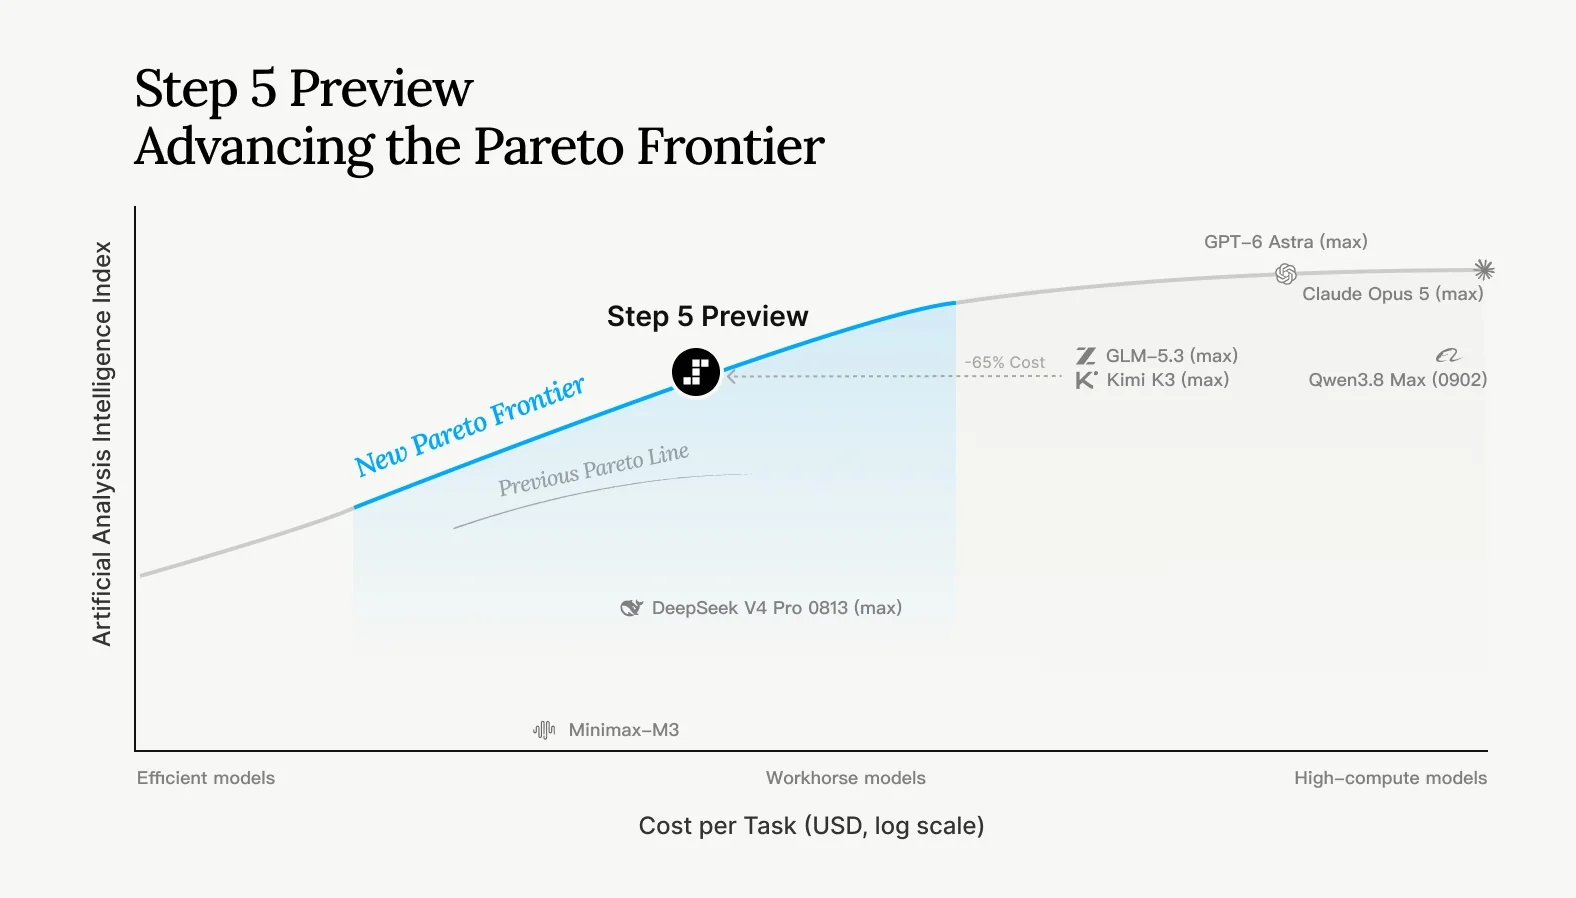
Fíjese en la afirmación incluida en ese gráfico: un 65 % menos de coste que GLM-5.3 y Kimi K3 con un nivel de inteligencia comparable. Es un gráfico del fabricante, así que léalo como la propuesta y no como el veredicto, pero al menos es una propuesta coherente.
Cómo funciona el MoE disperso: 600B totales, 27B activos
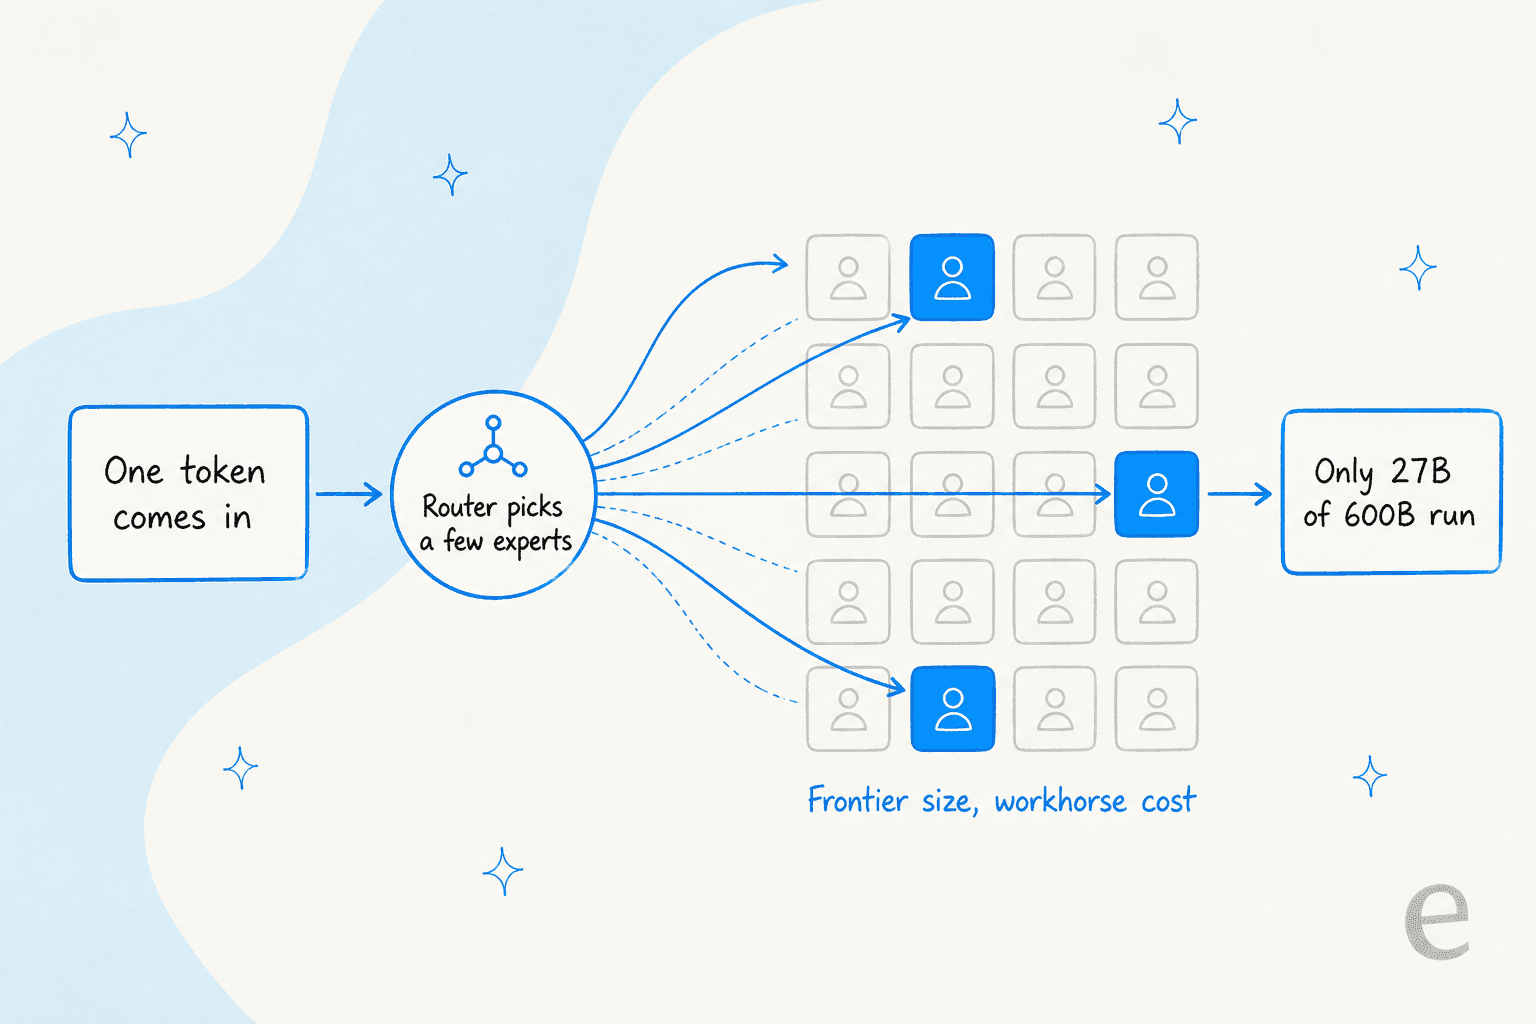
La especificación principal en la que todos se fijaron es la forma del modelo: 600B de parámetros totales, 27B activos por token. Es un diseño de mezcla de expertos dispersa, y es toda la historia del coste en un solo número.
En un modelo denso, todos los parámetros se ejecutan para cada token. En un modelo de mezcla de expertos, un pequeño enrutador elige un puñado de subredes "expertas" para cada token, de modo que solo se activa una parte del modelo. Step 5 mantiene en memoria 600B de tamaño frontera pero solo enciende 27B a la vez, por lo que StepFun puede ponerle precio como a un modelo de gama media.
No todos creen que las cuentas salgan a favor de Step 5. El número de parámetros activos surgió pronto en Hacker News:
"600b-a27b doesn't sound enticing. Also with the higher number of active parameters compared to GLM 5.3 flash and DeepSeek V4/4.1 flash, I don't see how they want to be more efficient at inference."

Es una objeción razonable. 27B activos es más pesado que algunos niveles "flash" rivales, así que la ventaja de eficiencia trata en realidad de la inteligencia por parámetro activo, no del número de parámetros activos por sí solo. Es justo el tipo de cosa que resolverán los benchmarks de inferencia independientes, y no los gráficos de StepFun.
También es un modelo de razonamiento, con un control reasoning_effort con valores low, medium o high. Más esfuerzo significa una traza de pensamiento interna más larga y, como los tokens de salida se facturan incluyendo esa traza, el esfuerzo es un mando directo de coste.
Qué puede hacer: contexto, modalidades y capacidades
Esta es la hoja de especificaciones de los documentos de la plataforma de StepFun, la parte más relevante si realmente está pensando en construir sobre él.
| Spec | Step 5 Preview |
|---|---|
| ID del modelo | step-5-preview |
| Arquitectura | MoE disperso, 600B totales / 27B activos |
| Ventana de contexto | 1M de tokens |
| Salida máxima | 64k tokens |
| Tipos de entrada | Texto, imágenes, vídeo |
| Tipo de salida | Texto |
| Razonamiento | reasoning_effort: low / medium / high |
El contexto de 1M de tokens es la especificación en la que más me apoyaría. Basta para meter una base de código completa, un trimestre de transcripciones de soporte o un montón de PDF en una sola llamada y pedir razonamiento entre documentos. En el lado multimodal puede pasar hasta 60 imágenes por solicitud, además de clips de vídeo cortos, aunque la salida es solo texto.
StepFun apuesta fuerte por la historia de la programación. Afirma que Step 5 puede ir "de la ingeniería de software y las aplicaciones visuales al hardware programable", y que en evaluaciones de expertos alrededor del 70 % de los participantes lo consideró capaz de resolver de forma autónoma tareas de programación de complejidad moderadamente alta. También hay una integración con Claude Code mediante "Step Plan" que expone el contexto completo de 1M, un buen lugar para encontrarse con los desarrolladores.
Los benchmarks y la advertencia honesta
StepFun publicó una tabla comparativa completa frente a pares abiertos (Kimi K3, GLM-5.3) y la frontera cerrada (GPT-6 Astra, Claude Opus 5). Esta es su forma, con todas las cifras de la página del producto de StepFun.
| Benchmark | Step 5 Preview | Kimi K3 | GLM-5.3 | GPT-6 Astra | Claude Opus 5 |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 67.7 | 67.5 | 66.9 | 74.1 | 74.0 |
| StepCodeBench | 49.0 | 43.9 | 40.2 | 61.0 | 63.9 |
| ProgramBench | 80.5 | 77.8 | 72.0 | 85.4 | 82.3 |
| Terminal-Bench v4 | 33.3 | 12.6 | 41.9 | 57.9 | 52.3 |
| FrontierFinance | 66.4 | 62.6 | 64.1 | 55.0 | 69.7 |
La lectura es consistente: Step 5 Preview está a la par de los otros modelos abiertos líderes y por detrás de los mejores modelos cerrados en calidad bruta de programación, mientras gana en coste. Las finanzas son su punto fuerte, donde supera ligeramente a los otros modelos abiertos y vence a GPT-6 Astra. Su propio radar de StepCodeBench cuenta lo mismo frente al nivel abierto.
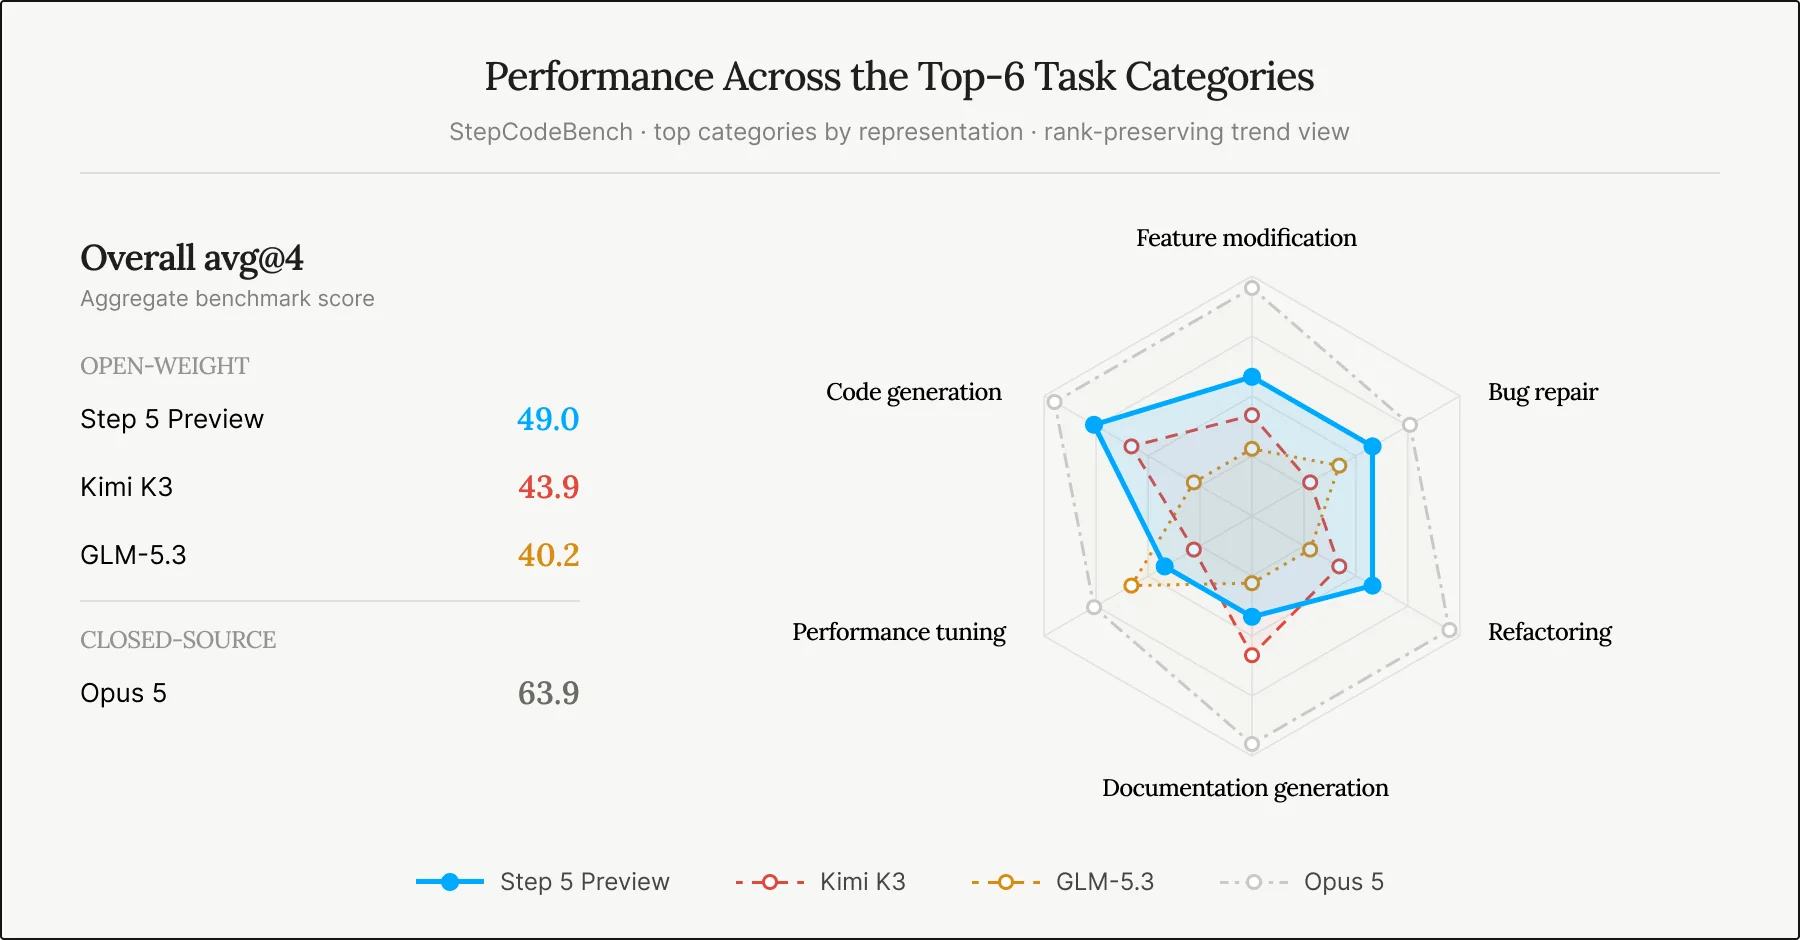
Ahora la advertencia, porque es grande. Todas las cifras de arriba son autoinformadas, aún no hay informe técnico ni paper, y StepCodeBench es el benchmark propio de StepFun (553 repositorios, 33 lenguajes). Un modelo suele lucir bien en la prueba que diseñó su propio equipo. La comunidad también señaló pronto los puntos más flojos, sobre todo la verbosidad:
"Based on the examples, it's like the thing took a writing class from Claude, but isn't quite as smart, kind of worst of both worlds. The 'Interactive Reporting' one is particularly terrible. A huge amount of waffly padding around a thesis that may or may not exist."
Y un comentarista vio cómo la demo de lanzamiento se delataba sola, el tipo de cosa que me hace querer ejecutar mis propias evaluaciones antes de fiarme de nada:
"In their first demo video, to make a 3D render of the photo, the thinking trace gives away the game [...] I'm always astounded how little effort is put into checking the AI answers displayed in these announcements."
Nada de eso convierte a Step 5 en un mal modelo. Lo convierte en un modelo no probado, que es otra cosa, y la respuesta correcta es simularlo con su propia carga de trabajo en lugar de aceptar el gráfico del lanzamiento sin más.
Cuánto cuesta y cómo conseguirlo
El precio es la parte de este lanzamiento que resulta realmente fácil de apreciar. De la página de precios de StepFun, por 1M de tokens:
| Unidad de facturación | Entrada (fallo de caché) | Entrada (acierto de caché) | Salida |
|---|---|---|---|
step-5-preview | $1.00 | $0.05 | $2.70 |
step-3.7-flash (como referencia) | $0.20 | $0.04 | $1.15 |
El descuento del 95 % por acierto de caché en la entrada es lo más destacado, y es muy relevante para cargas agénticas que reenvían en cada paso un prompt de sistema grande y casi estático. La salida a $2,70 cubre tanto la traza de razonamiento como la respuesta final, así que una ejecución locuaz de alto esfuerzo cuesta dinero de verdad. Hay un nivel V0 gratuito para probar (5 de concurrencia, 10 solicitudes por minuto), con límites de tasa que crecen según lo que haya recargado.
El acceso es donde la etiqueta "Preview" cobra sentido. Hoy el modelo es solo por API, y StepFun mantiene una cuenta atrás pública hacia los pesos abiertos.
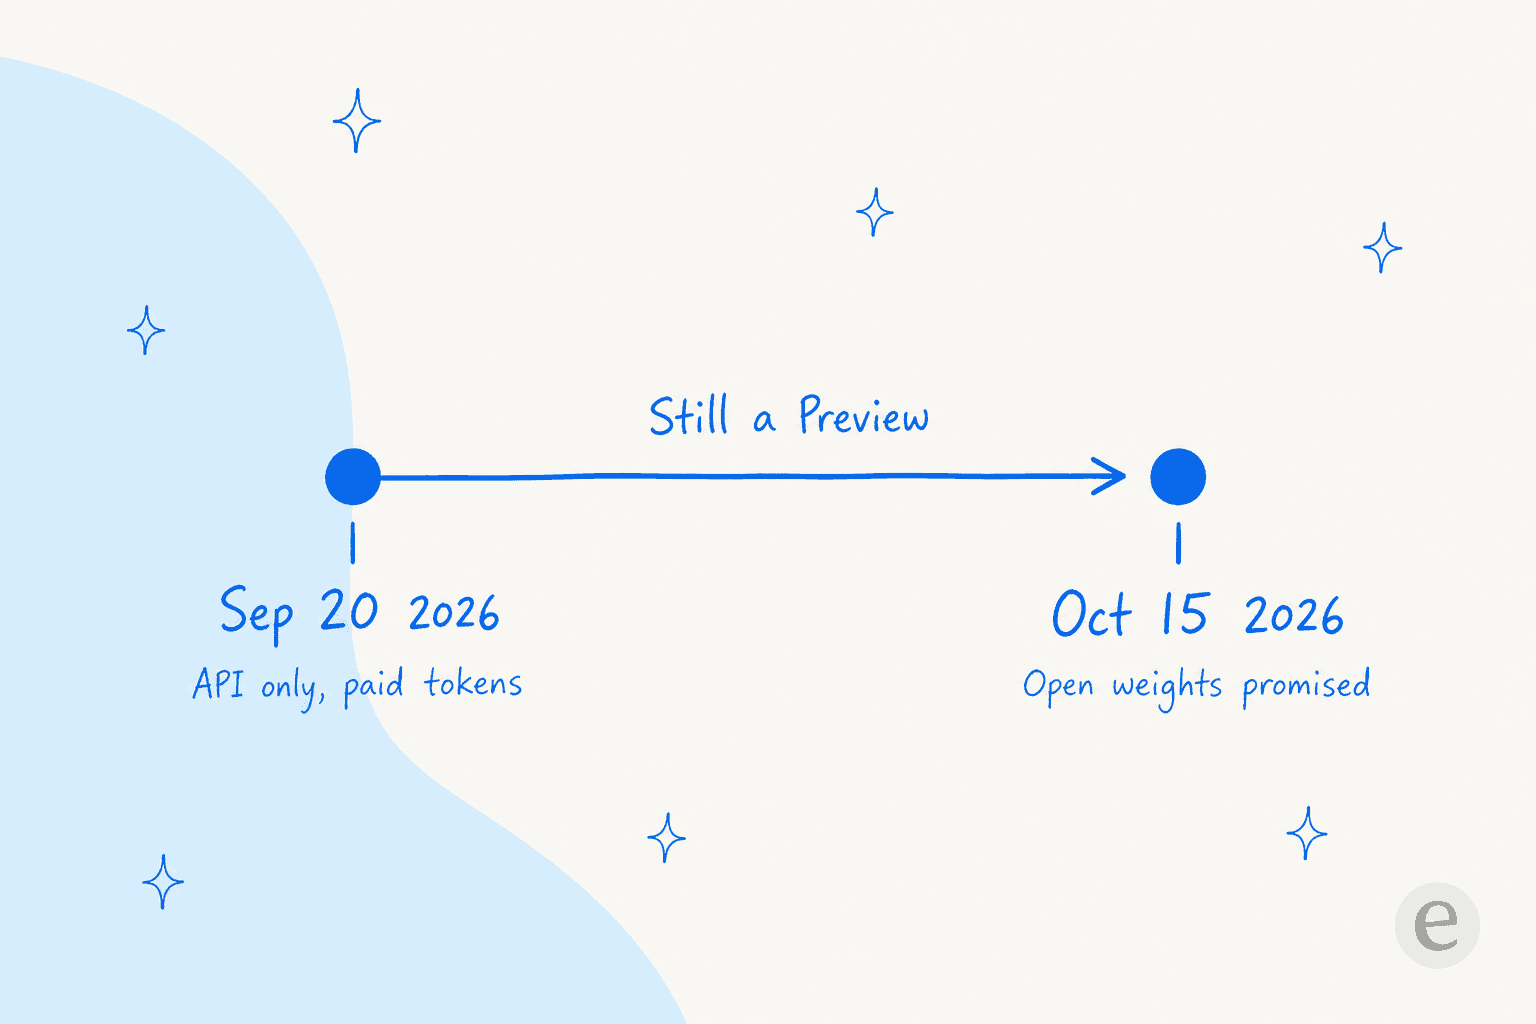
El repositorio de Hugging Face ya existe pero es un marcador de posición vacío, sin model card, pesos ni licencia al momento de escribir. La línea Flash de StepFun salió con Apache 2.0, así que es probable un lanzamiento abierto permisivo, pero yo no basaría un plan on-prem en pesos que aún no han llegado.
Para quién es Step 5 y quién debería esperar
Aquí es donde yo aterrizaría. Si es desarrollador o laboratorio y quiere un modelo capaz, barato y de contexto largo sobre el que construir, sobre todo para programación, finanzas o investigación sobre grandes conjuntos de documentos, Step 5 Preview merece una prueba real. La historia de precio por inteligencia es legítimamente buena, y la promesa de pesos abiertos lo hace aún más interesante.
Si espera un modelo asentado y probado, espere. Es una preview, los benchmarks los califica el propio fabricante, y la primera lectura de la comunidad es "prometedor pero verboso y no probado". Hasta un comentarista amable describió el patrón con suavidad:
"The previous Step models were pretty decent, but unfortunately for them, their model reasons too much and too long [...] Hopefully this doesn't reason too long to get to the answer. I welcome any open model, the more the merrier."
Le doy a StepFun crédito por lo que la mayoría de los lanzamientos hacen mal: saber lo que son. Como dijo un comentarista, el posicionamiento es honesto sobre ser lo mejor del nivel más barato en lugar de fingir que lidera las clasificaciones:
"Their posisitoning is nice. Instead of saying they are cheaper and a bit less performant (in terms of intelligence), they say they are best among the cheaper and a bit less performant ones."
Dónde termina un modelo en bruto y empieza un compañero
Hay un planteamiento al que me opondría, y no es culpa de StepFun, se aplica a todos los lanzamientos de modelos. Un modelo no es una solución. Step 5 Preview es un motor. Le da una API, una factura de tokens y capacidad en bruto. Convertir eso en algo que responda a sus clientes significa que usted construye la aplicación, conecta sus datos, escribe las barreras de seguridad y se encarga del mantenimiento.
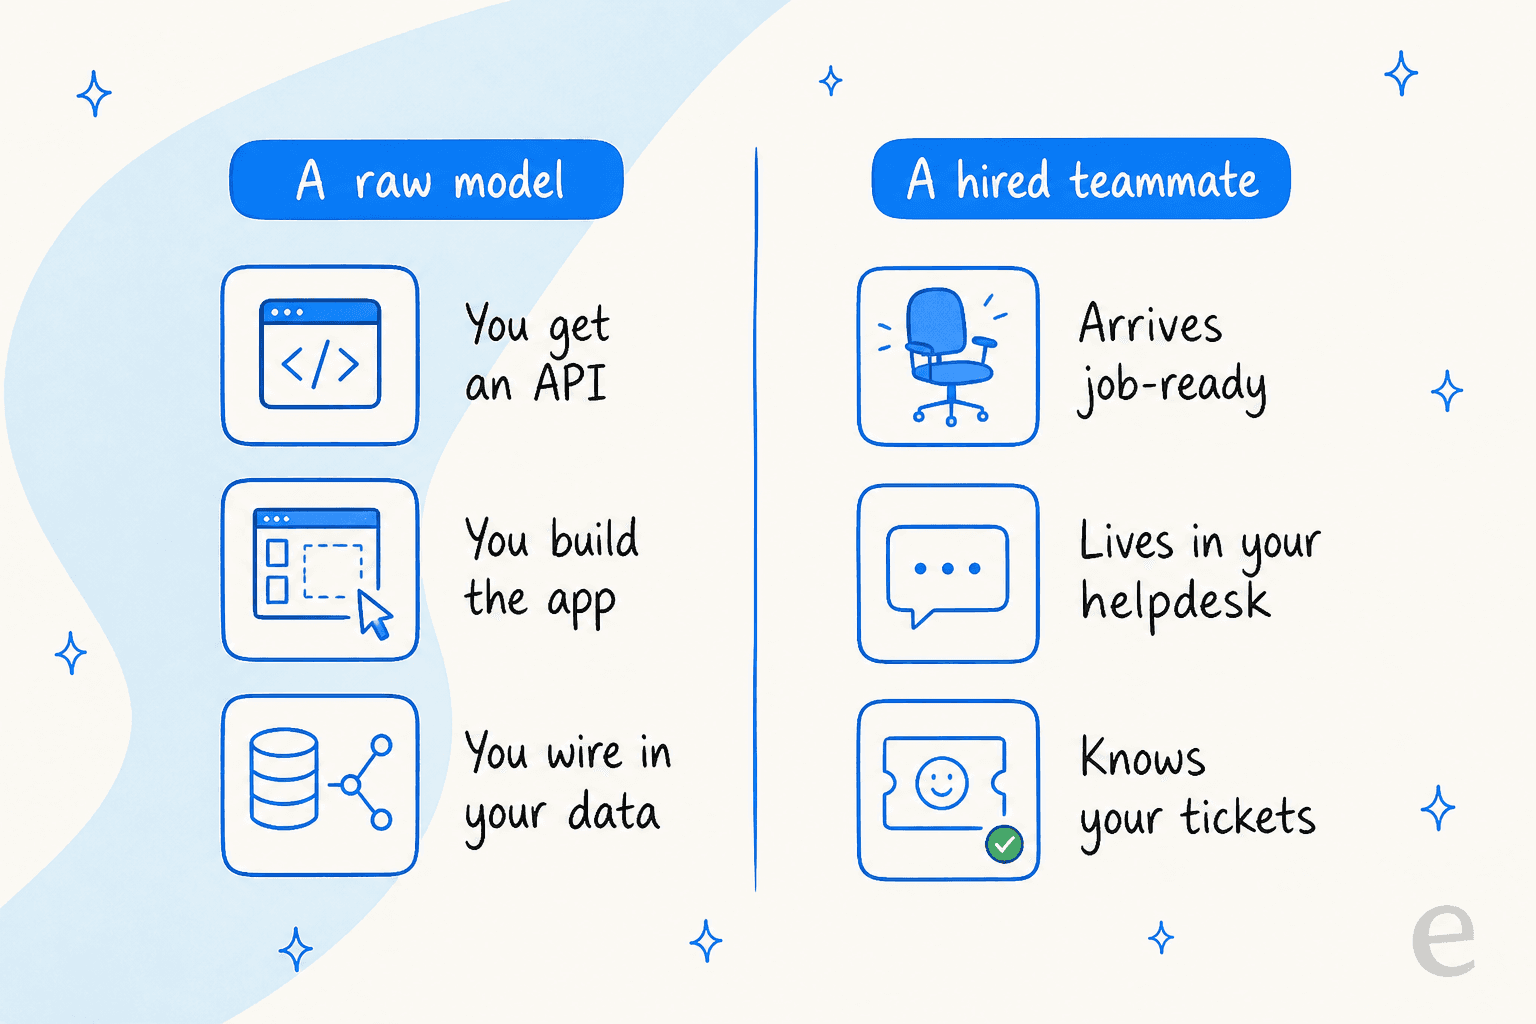
Esa brecha es la razón de ser de eesel. En lugar de un modelo en bruto, usted contrata a un compañero listo para trabajar en una tarea concreta. El compañero de IA para el helpdesk se une a su cola actual, se entrena con sus tickets pasados y su centro de ayuda, y redacta o envía respuestas dentro del helpdesk que ya usa, ya sea Zendesk, Freshdesk o Gorgias. El precio es una tarifa fija por resolución, sin cargo por asiento, así que el coste se corresponde con el trabajo hecho y no con los tokens quemados.

Lo que más me importa, dado el problema de los benchmarks autoinformados de arriba, es que puede simular al compañero con miles de sus propios tickets pasados antes de que toque a un cliente real, de modo que vea su tasa de resolución real con su carga de trabajo en lugar de la de un gráfico del fabricante. Y si prefiere manejarlo desde una terminal o un script en vez de un panel, eesel incluye una CLI y un servidor MCP reales para que agentes de programación como Claude Code operen directamente el mismo compañero. Los modelos nuevos como Step 5 son infraestructura emocionante. Un compañero es quien realmente se presenta al turno. Puede probar eesel gratis.