

MiniCPM5-2B es el nuevo modelo abierto de 2B de OpenBMB, y es realmente llamativo para su tamaño. Es un modelo denso, solo de texto, de 2,52B parámetros, con una ventana de contexto de 128K y pesos Apache-2.0, creado para ejecutarse en el dispositivo: teléfonos, portátiles y mini-PC, no en un centro de datos. En la suite propia de OpenBMB promedia 53,9 en 34 benchmarks, lo que ellos describen como el estado del arte open source de la clase 2B y, en su propio conjunto de comparación, por delante del Qwen3.5-4B, más grande (51,1).
La pega que conviene conocer desde el principio: es solo de texto (sin visión), las puntuaciones llamativas las reporta el fabricante, y una cifra destacada es inconsistente entre fuentes. Rastreadores independientes sitúan su Artificial Analysis Intelligence Index en 15, el más alto de cualquier modelo de pesos abiertos de 4B o menos; la propia publicación de lanzamiento de OpenBMB afirma 23. Ambas se citan más abajo.
Si construyes cosas, MiniCPM5-2B es un gran motor local de razonamiento y uso de herramientas. Si lo que quieres es responder tickets de clientes, recuerda que el modelo es solo el motor. Un agente de soporte que funcione necesita encima el conocimiento de tu empresa, integraciones, barreras de seguridad y pruebas, que es la capa que ofrece una plataforma como eesel.
Qué es realmente MiniCPM5-2B
MiniCPM5-2B es el segundo modelo de la línea MiniCPM5 de OpenBMB (el grupo de modelos abiertos también conocido como ModelBest), lanzado alrededor del 6 y 7 de septiembre de 2026, tras MiniCPM5-1B en mayo. La propuesta es acotada y clara: un modelo denso y pequeño, lo bastante bueno en razonamiento, programación y uso de herramientas como para ser útil, y lo bastante pequeño para ejecutarse donde ya están los datos.
Esa parte de "donde están los datos" es lo interesante. La mayoría de los modelos de los que lees este año son APIs en la nube que alquilas por token. MiniCPM5-2B va en sentido contrario: descargas los pesos y los ejecutas en un portátil, un teléfono o una placa Rockchip en una planta de fabricación. La ficha del modelo en HuggingFace lo describe como un modelo denso de 2B "built for on-device, local deployment, and resource-constrained scenarios", orientado a "local assistants, coding agents, tool-use workflows, and reasoning scenarios where a compact model is preferred."
Esta es la página del propio modelo, por donde empezarías de verdad si quisieras descargarlo.
Una limitación honesta para ajustar expectativas: es un modelo solo de texto. Este checkpoint no tiene visión ni audio, y los probadores de la comunidad señalan que maneja solo inglés y chino. Si necesitas multimodalidad, OpenBMB la mantiene en la línea separada MiniCPM-V, y la reacción de "aquí no hay visión" fue una de las más sonoras en el lanzamiento (más sobre eso abajo).
Las especificaciones que importan
En un modelo de 2B, las sorpresas están en la hoja de especificaciones. Usa una arquitectura LlamaForCausalLM sencilla, tiene 128K de contexto completo y se publica con una licencia realmente permisiva.
| Campo | Valor |
|---|---|
| Parámetros totales | 2.516.756.480 (~2,52B) |
| Parámetros sin embeddings | 1.981.982.720 |
| Arquitectura | LlamaForCausalLM estándar (sin kernels propios) |
| Capas | 42 |
| Atención | GQA, 16 cabezas de consulta, 2 cabezas KV |
| Longitud de contexto | 131.072 tokens (128K) |
| Modalidad | Solo texto (inglés / chino) |
| Licencia | Apache-2.0 (pesos y repositorio) |
| Tipo de tensor | BF16 (más versiones GGUF, MLX-4bit, GPTQ-4bit) |
Cada cifra de ahí viene del bloque "Model Information" de la ficha del modelo. Dos de ellas pesan más que el resto.
La primera es la arquitectura estándar. OpenBMB se empeñó en construir MiniCPM5-2B sobre LlamaForCausalLM simple para que, en sus palabras, "mainstream inference engines can load it directly: no custom kernels, no model-code fork." Suena a nota al pie, pero es la razón por la que el soporte de runtimes desde el día 0 (abajo) es tan amplio. Un modelo que necesita un kernel a medida sale en dos runtimes el día del lanzamiento; uno con arquitectura estándar aparece en todos a la vez.
La segunda es la licencia Apache-2.0 tanto en el repositorio como en los pesos. Se permite el uso comercial y no hay una licencia comunitaria aparte que lo restrinja, algo que no todos los lanzamientos "abiertos" pueden decir. Si estás construyendo un producto encima, eso importa más que uno o dos puntos de benchmark.
También tiene un modo propio de razonamiento profundo: el ejemplo de transformers pasa enable_thinking=True, y OpenBMB plantea el presupuesto de tokens de una tarea en unos 21K tokens (14K de pensamiento más 7K de respuesta), con muestreo recomendado de temperature=1.0, top_p=0.95.
Qué puntuaciones obtiene
Este es el titular que hizo que se fijaran en MiniCPM5-2B: en la evaluación de OpenBMB promedia 53,9 en 34 benchmarks, que presentan como el estado del arte open source de la clase 2B y, en su conjunto de comparación, por delante del mejor modelo de clase 4B, Qwen3.5-4B con 51,1. Que un modelo de 2B supere a uno de 4B es el tipo de afirmación que merece una segunda mirada.
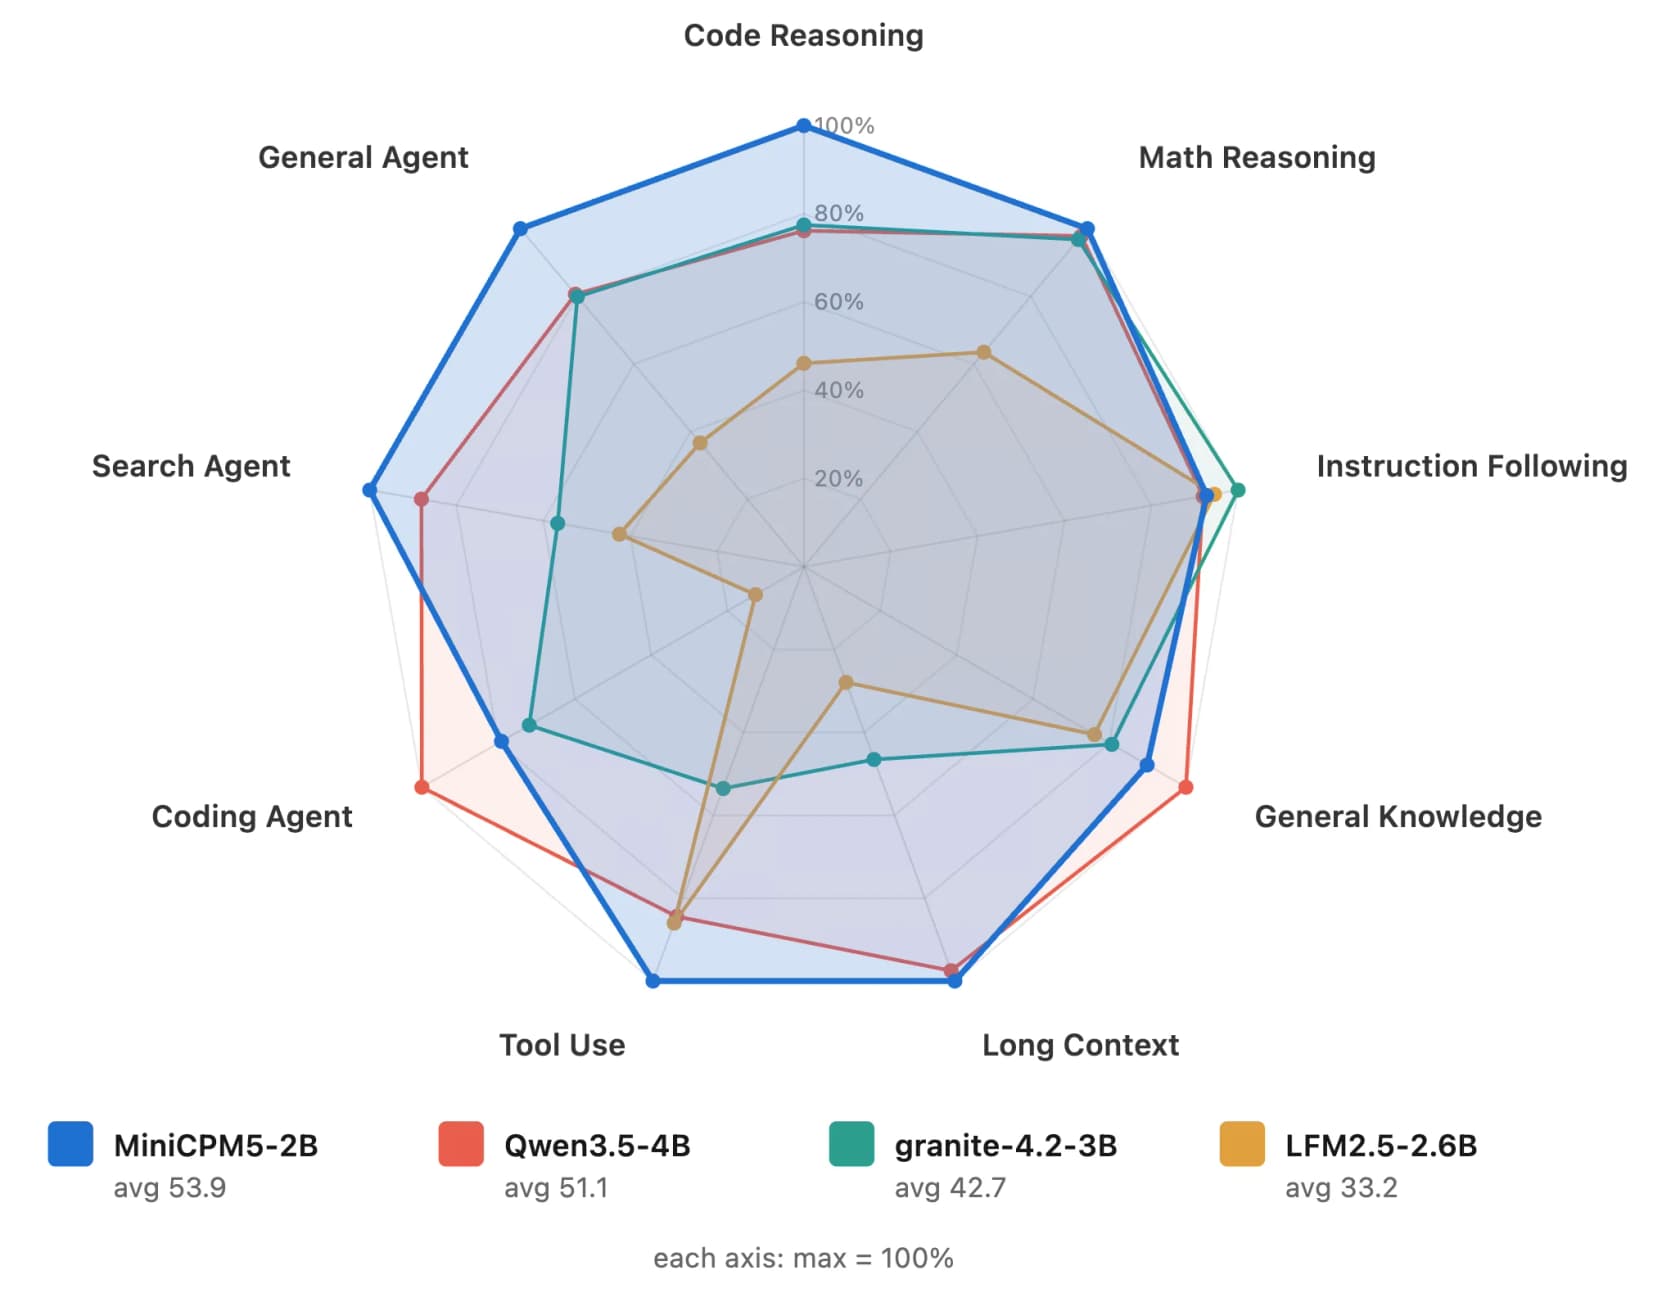
El radar muestra dónde se sostiene la historia de tamaño frente a puntuación y dónde no. MiniCPM5-2B lidera en tareas de agentes y búsqueda y se mantiene competitivo en matemáticas y contexto largo, mientras que el modelo de 4B de Qwen sigue ganando en trabajo puro de agentes de programación. Es un perfil irregular, no una ventaja uniforme, y esa es la forma honesta de leerlo.
Vale la pena mirar la tabla completa con calma, porque el "promedio 53,9" esconde algunas cifras individuales realmente grandes:
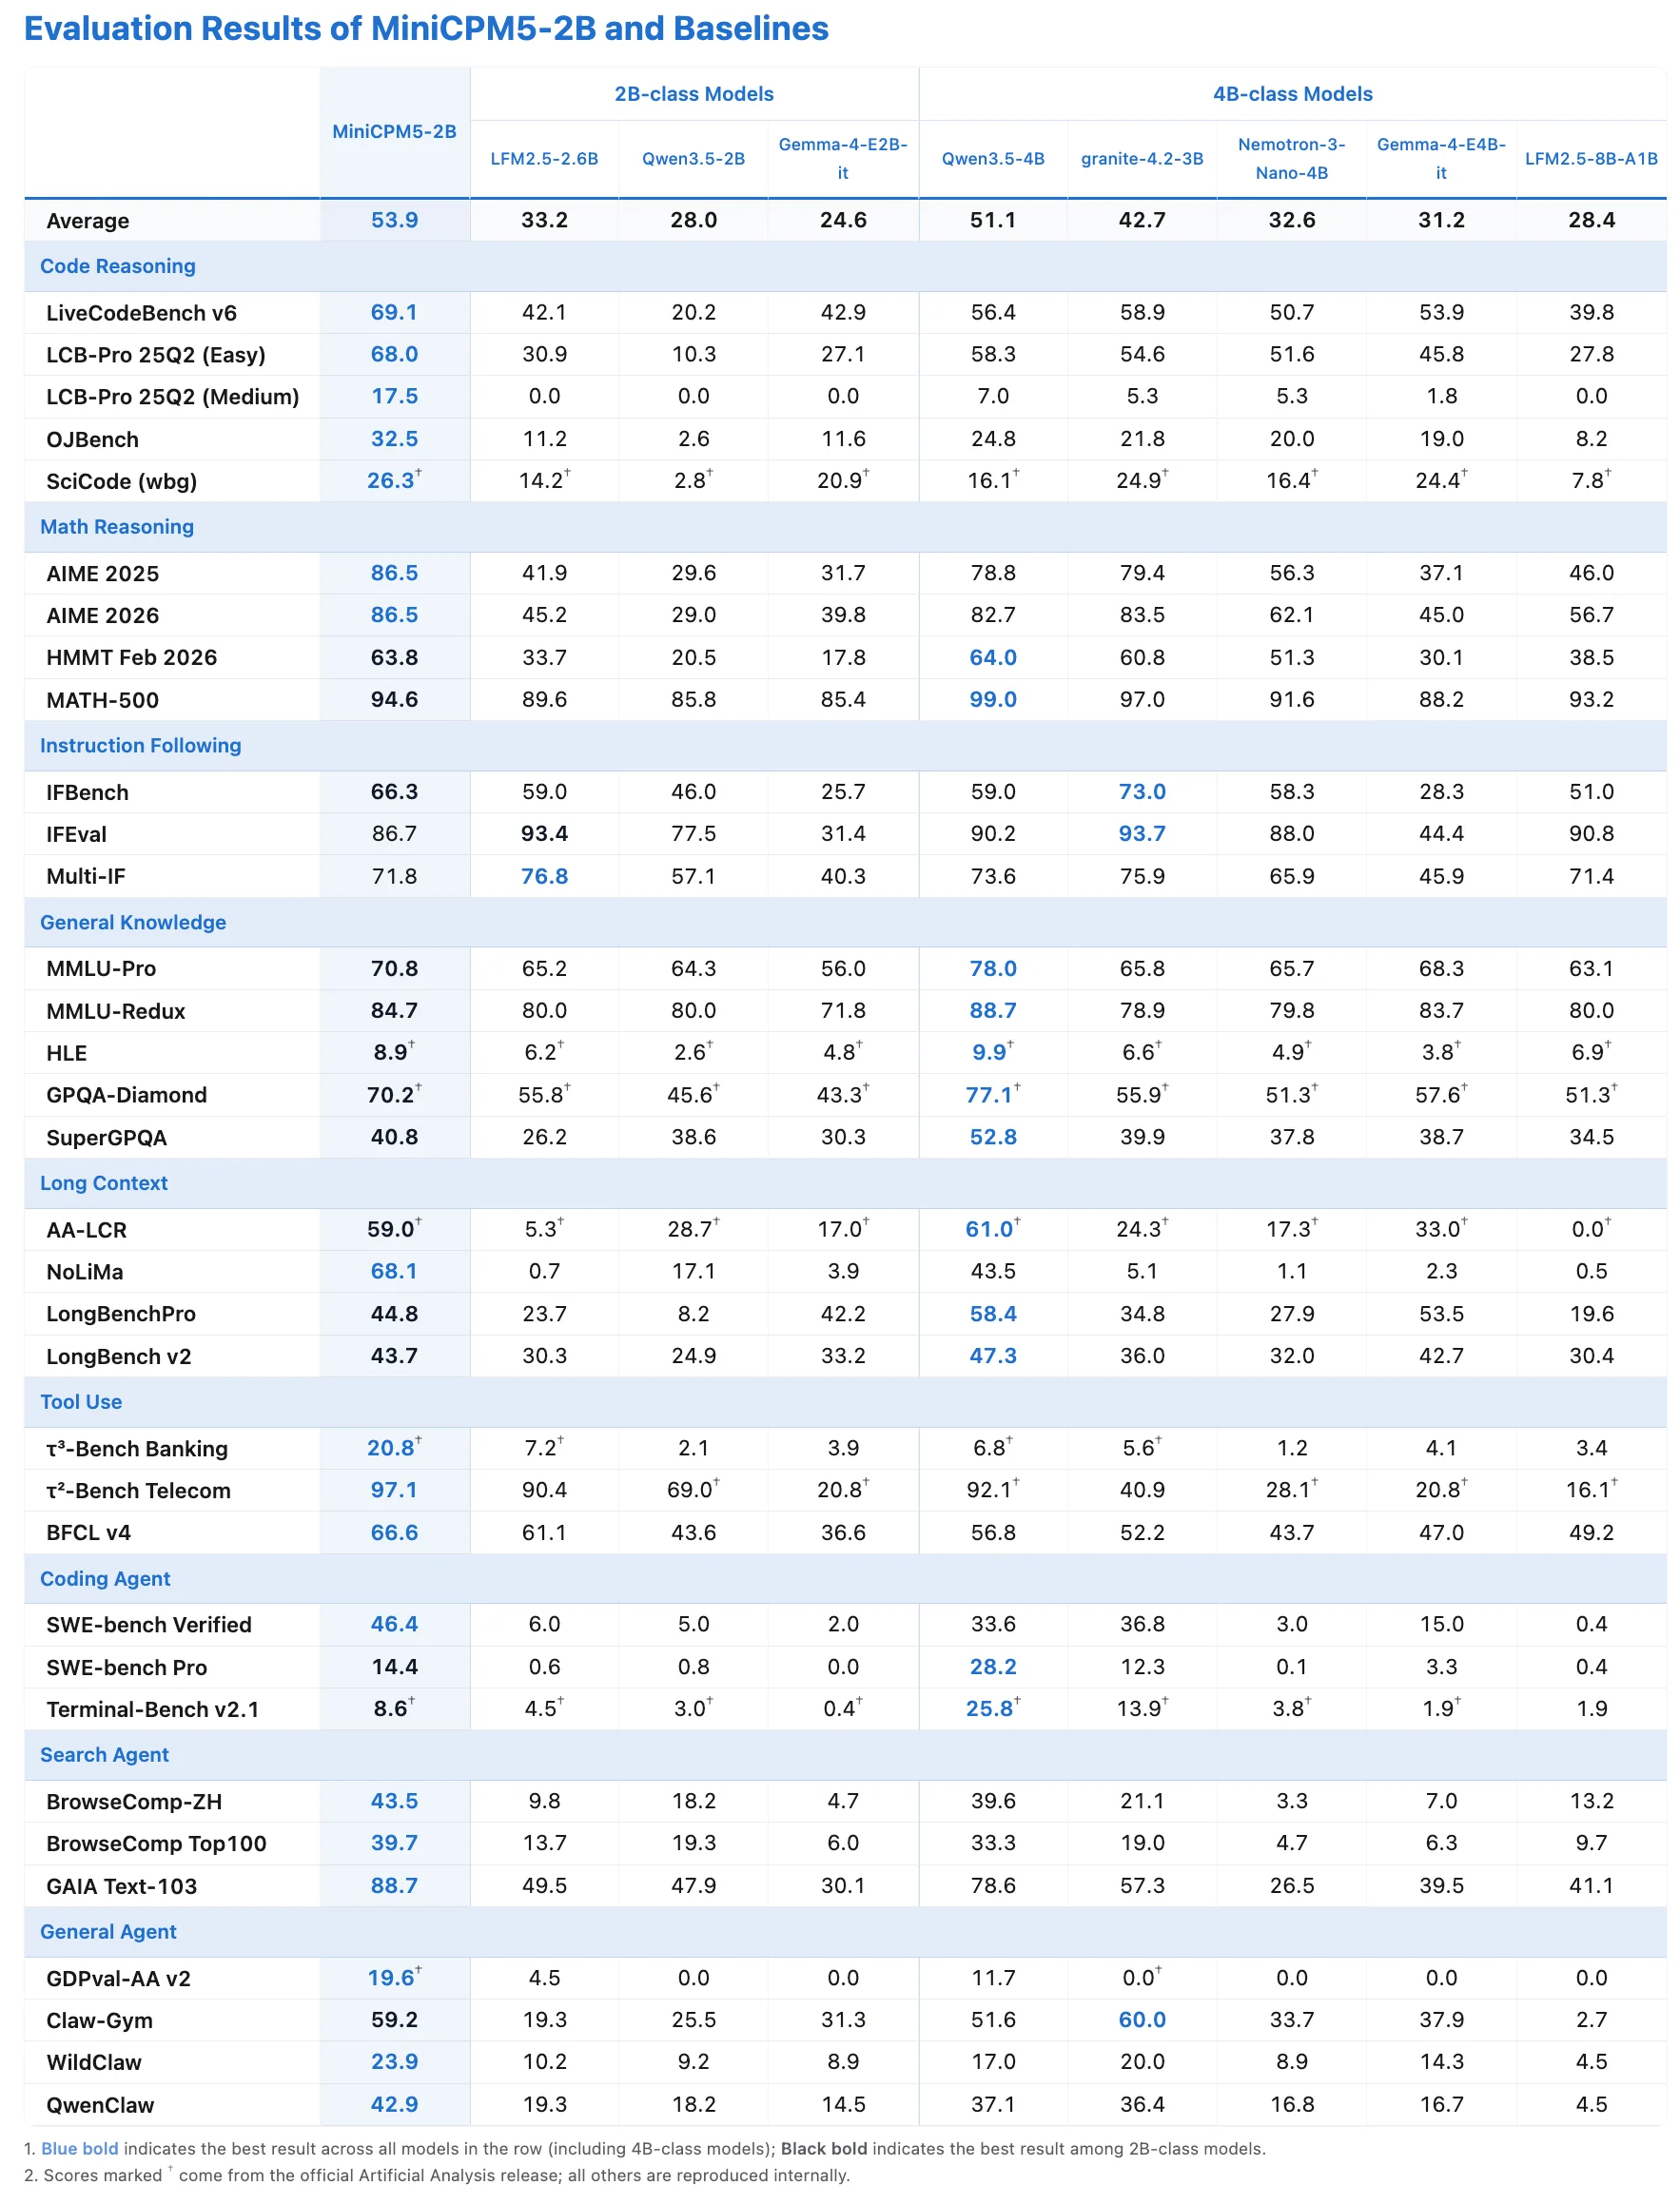
Los puntos destacados, todos de esa tabla: MATH-500 con 94,6, AIME 2026 con 86,5, LiveCodeBench v6 con 69,1, SWE-bench Verified con 46,4, τ²-Bench Telecom con 97,1 y GAIA Text-103 con 88,7. En conocimiento general logra MMLU-Pro 70,8. Para un modelo que puedes ejecutar en un portátil, esas cifras de programación y uso de herramientas son las que hacen que los desarrolladores se fijen.
Dos salvedades mantienen esto honesto. Primero, son las cifras que reporta el propio OpenBMB (algunas filas se reprodujeron internamente, otras vienen del lanzamiento oficial de Artificial Analysis), así que trátalas como un buen punto de partida y prueba con tus propias tareas en lugar de tomarlas como veredicto independiente. Segundo, una cifra destacada se contradice entre fuentes: el hilo de lanzamiento en r/LocalLLaMA y dataconomy reportan ambos un Artificial Analysis Intelligence Index de 15, "the highest of any open weights model at 4B parameters or below", mientras que la propia publicación de lanzamiento de OpenBMB afirma una puntuación de 23 más un 20 en el Agentic Index. No puedo conciliar ambas, así que las dos quedan registradas aquí. Y fíjate en lo que falta: OpenBMB no publica MMLU clásico, GSM8K ni HumanEval para este modelo, así que si esperabas compararlo con clasificaciones más antiguas, esas cifras no existen en las fuentes oficiales.
Cómo lo entrenó OpenBMB
La otra razón por la que MiniCPM5-2B resulta interesante es que OpenBMB publicó como código abierto la mayor parte de la receta, no solo los pesos. Si te interesa cómo un modelo pequeño llega a ser tan capaz, la respuesta está en el pipeline.
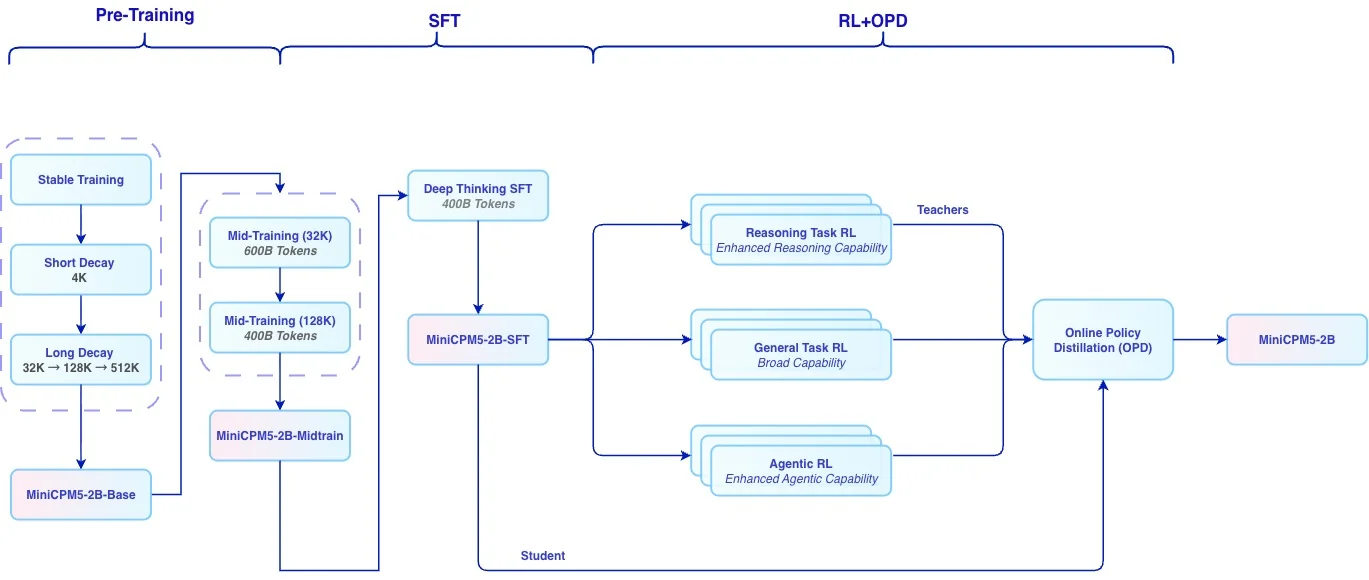
Se desarrolla en tres etapas, descritas en la ficha del modelo. El entrenamiento base usa Ultra-FineWeb de OpenBMB y conjuntos de datos UltraData relacionados. El entrenamiento intermedio adapta el modelo a las capacidades objetivo. Después el posentrenamiento hace el trabajo pesado: 400B tokens de SFT de pensamiento profundo, aprendizaje por refuerzo con profesores especializados para tareas de matemáticas, código, agentes y escritura (con el algoritmo basado en crítico JustRL II) y, por último, On-Policy Distillation, que fusiona 16 modelos expertos en el único checkpoint publicado.
OpenBMB reporta que la etapa de RL más OPD por sí sola sumó 10,96 puntos en benchmarks de razonamiento y generales y 6,96 puntos en tareas de agentes. Reproduzcas o no esas mejoras, publicar los conjuntos de datos y el framework de RL es el tipo de movimiento que hace que la comunidad de modelos abiertos preste atención, porque es repetible en lugar de una caja negra.
Ejecutarlo en el edge
La razón de ser de un modelo de 2B es ejecutarse donde uno de 200B no puede. Así que la pregunta para MiniCPM5-2B es menos "qué tan inteligente es" y más "qué te aporta realmente ejecutarlo en local".
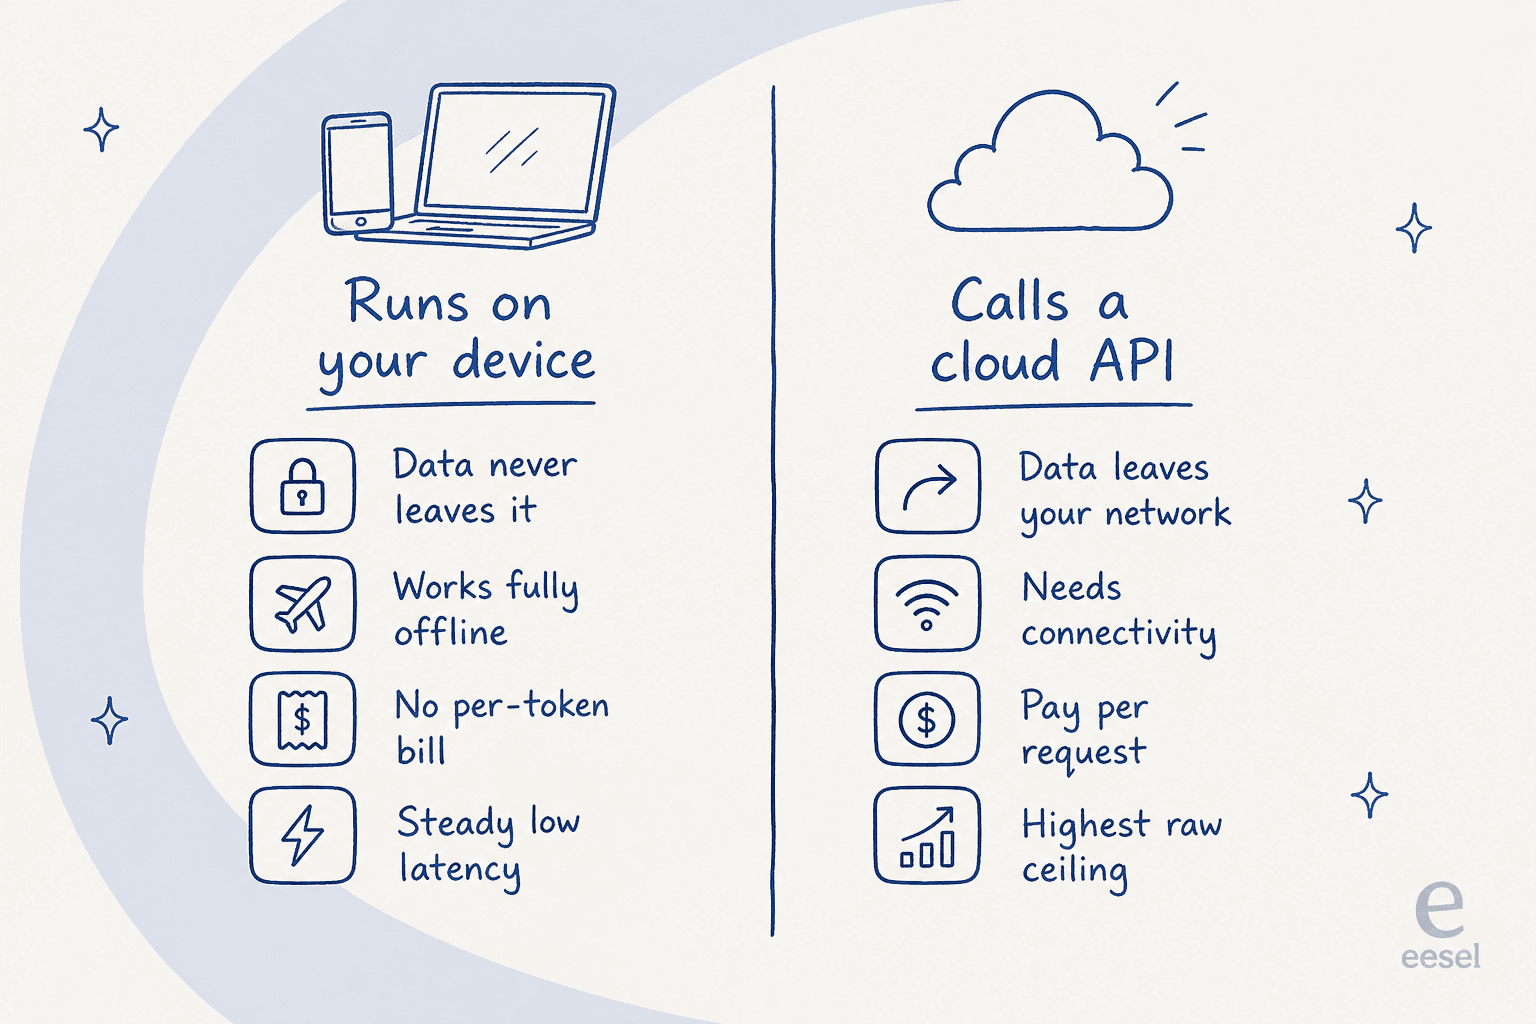
El intercambio es real en ambas direcciones. Si lo ejecutas en el dispositivo, tus datos nunca salen de la máquina, funciona sin conexión y no hay factura por token: para trabajo sensible a la privacidad o sin conexión, esa combinación es difícil de superar. Al renunciar a la nube también renuncias al techo de capacidad de un modelo de frontera. MiniCPM5-2B apuesta a que, para un conjunto creciente de tareas, un modelo local pequeño que es "suficientemente bueno" y privado supera a uno enorme y remoto al que debes confiar tus datos.
El lado práctico se sostiene. Un listado de la comunidad sitúa la versión GGUF en unos 1,6 GB (una cifra de terceros, no oficial), y OpenBMB compartió una demo ejecutándolo en un MacBook de 16 GB haciendo búsqueda web en el dispositivo. También se adaptó desde el día 0 para Intel Core Ultra con OpenVINO, Arm v9 con SME2 (donde reporta aproximadamente 1,7 veces más prefill y 1,2 veces más decode) y las placas RK3588 y RK1828 de Rockchip.
Aquella decisión de arquitectura estándar rinde aquí. El mismo checkpoint se carga en una gran variedad de runtimes el día del lanzamiento, en lugar de llegar poco a poco a uno o dos.
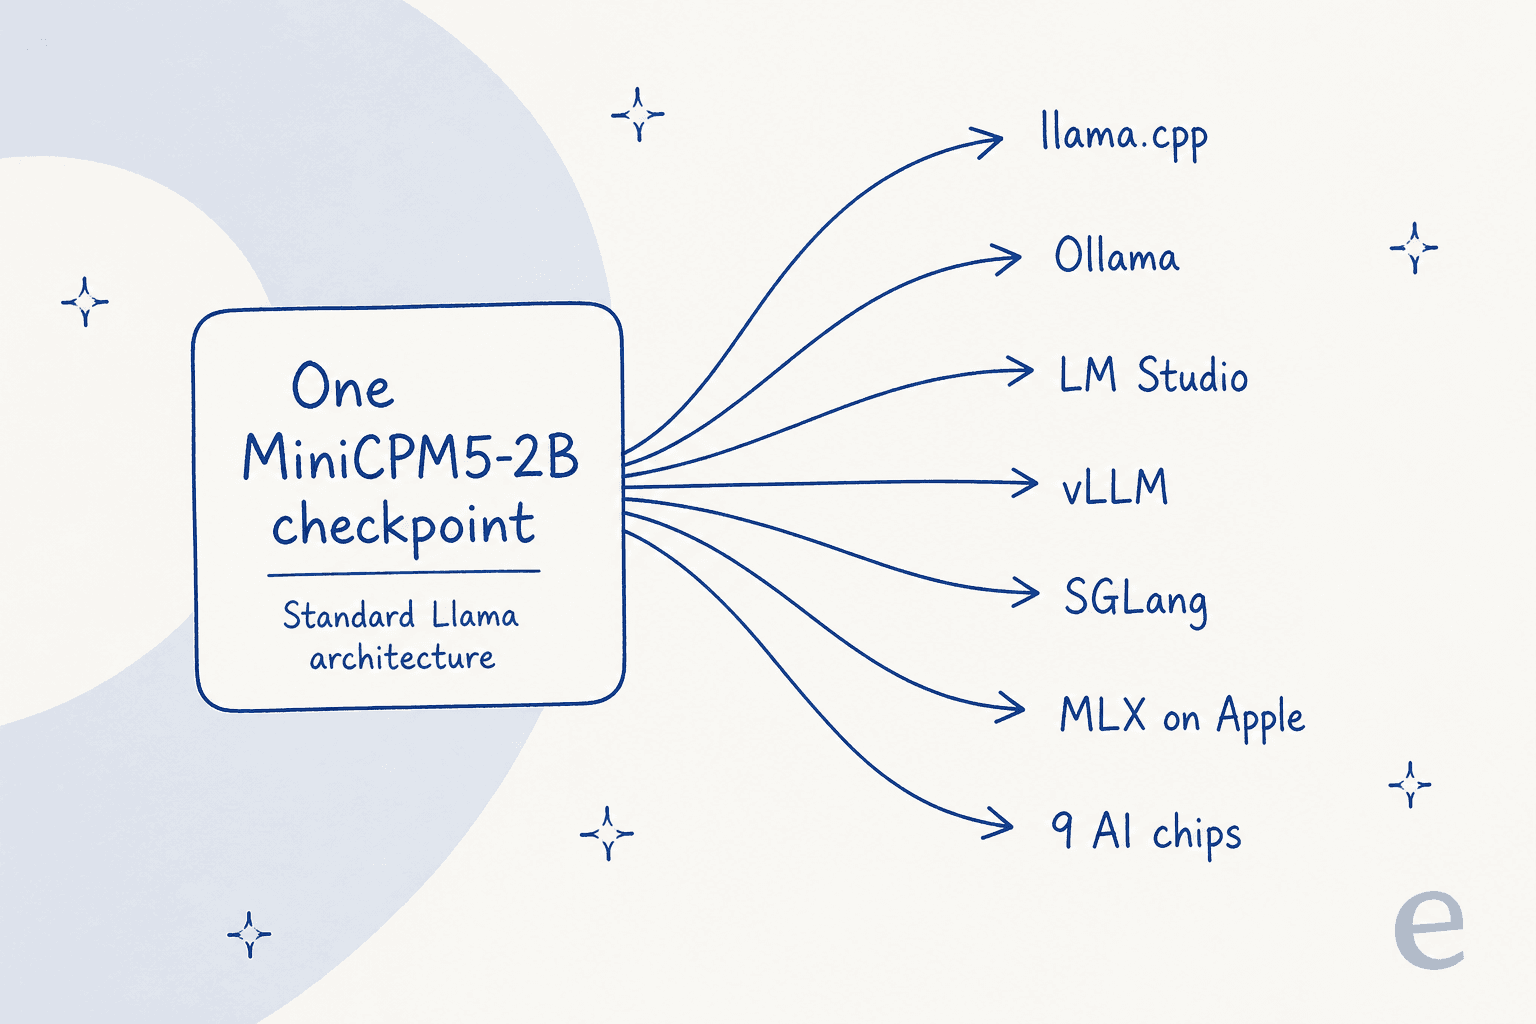
Según la tabla de despliegue de la ficha del modelo, se ejecuta en transformers, vLLM, SGLang, llama.cpp, Ollama, LM Studio, MLX para Apple Silicon y FlagOS, que lo adapta a nueve chips de IA distintos. Para llamadas a herramientas, SGLang es el backend recomendado: el modelo emite llamadas a herramientas en estilo XML y el parser integrado minicpm5 de SGLang las convierte en tool_calls compatibles con OpenAI. Incluso hay un modelo borrador DSpark para decodificación especulativa si quieres ganar más velocidad sin cambiar las salidas.
Qué dice la comunidad
Las reacciones en el lanzamiento se agruparon en dos bandos, y ambos son señales útiles.
El primero es un entusiasmo directo por la relación entre tamaño y capacidad. La publicación oficial de lanzamiento superó los 2.200 me gusta en un día, y un probador reportó haber ejecutado 32 subagentes concurrentes en un solo DGX Spark a 931 tokens por segundo de media, con un pico de 1.364. Para un modelo de 2B alojado en local, ese rendimiento es lo que da ganas de construir con él.
El segundo bando es más escéptico, y vale la pena escucharlo precisamente porque no es marketing. La queja recurrente más fuerte fue la falta de soporte de visión:
"Sad that there is no vision though."

Y algunos desarrolladores pusieron en duda que las puntuaciones de benchmark se traduzcan en trabajo real, sobre todo en arneses de programación:
"you get some likes here, but useful code? I don't think so"
Esa brecha entre una fila de benchmark sólida y el buen comportamiento dentro de un bucle de agente real es justo lo que no se puede leer en una hoja de especificaciones. Y es también lo que más importa en cuanto intentas poner cualquier modelo a trabajar en tareas reales.
Un modelo abierto es un motor, no un empleado
Este es el replanteamiento que vale la pena llevarse, y es la parte que más se saltan quienes construyen y quienes compran. MiniCPM5-2B es un gran motor. Por sí solo no es un trabajador. Descargar un buen modelo de pesos abiertos es el inicio de un proyecto, no su final, y la distancia entre ambos es mayor que el modelo.
Trabajo en la IA de eesel, y esta es la distinción en la que vivimos cada día. Llevamos años poniendo agentes de IA en colas de soporte reales, y la lección recurrente es que la calidad bruta del modelo rara vez decide si un despliegue funciona. Lo que lo decide es todo lo que rodea al modelo.
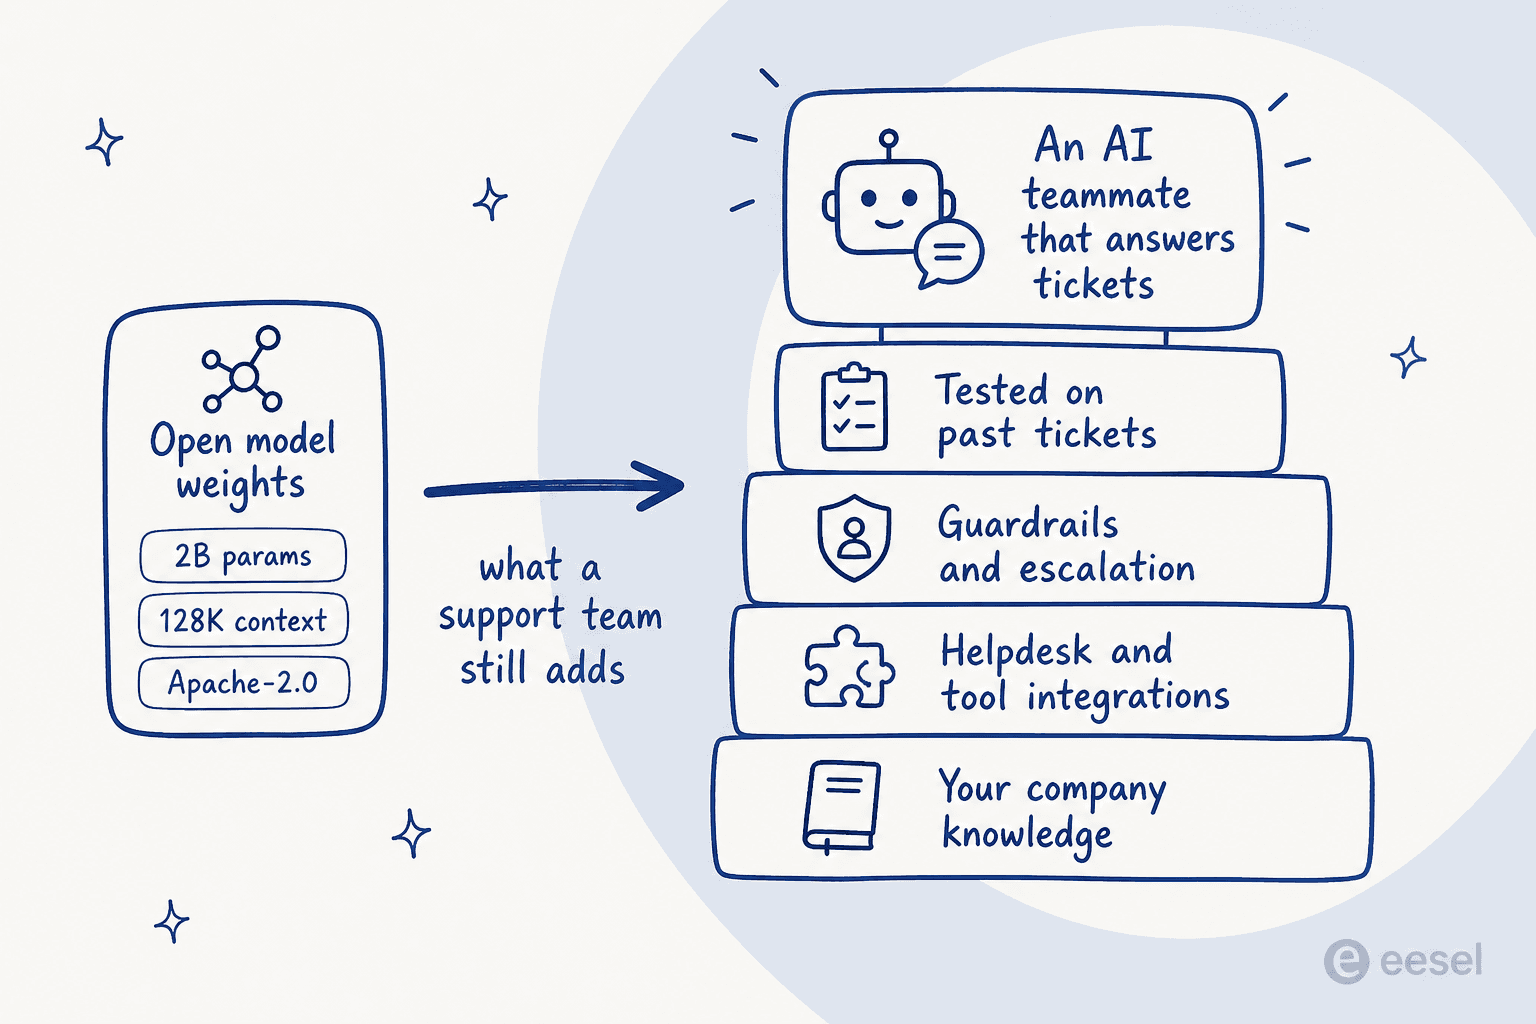
Toma el soporte al cliente como caso concreto. Para convertir un modelo como MiniCPM5-2B en algo que pueda responder un ticket real, tienes que alimentarlo con el conocimiento real de tu empresa, conectarlo al helpdesk y a las herramientas que necesita para actuar, añadir barreras de seguridad para que escale en lugar de adivinar, y probarlo con conversaciones pasadas reales antes de que toque a un cliente en vivo. Esa última parte es donde hemos visto a bots que suenan seguros dar respuestas erróneas en silencio, y por eso ahora simulamos cada despliegue con tickets históricos antes de salir en vivo. El modelo es quizá el 20 % de eso. El otro 80 % es el andamiaje aburrido y esencial, y no viene en la descarga.
Eso no es un argumento contra los modelos abiertos. Es un argumento para tener claro qué tienes entre manos. MiniCPM5-2B es un motor compacto realmente bueno con el que construir. Pero si lo que quieres construir es un agente de soporte, puedes ensamblar tú mismo todo ese 80 % o incorporarlo ya hecho.
Prueba eesel
Si tu objetivo real es responder preguntas de clientes y no ejecutar un modelo, ese es exactamente el problema que eesel existe para resolver. eesel incorpora un compañero de helpdesk con IA listo para trabajar en tu cola actual: aprende de tus tickets pasados y tu centro de ayuda, se conecta en minutos a herramientas como Zendesk, Freshdesk y Slack y, sobre todo, simula con tus tickets históricos reales para que veas cómo se comportará antes de que responda a nadie en vivo.

Y si te gusta trabajar cerca del metal, como harías con un modelo local, eesel tiene una CLI pública además de un servidor MCP, de modo que el mismo compañero que configuras en el panel puede manejarse desde una terminal, automatizarse en scripts o entregarse a un agente de programación como Claude Code o Cursor. Obtienes el trabajador listo y la superficie programable, sin tener que construir tú el 80 %. Es gratis para probar.