Qué es realmente Claude Opus 5.5
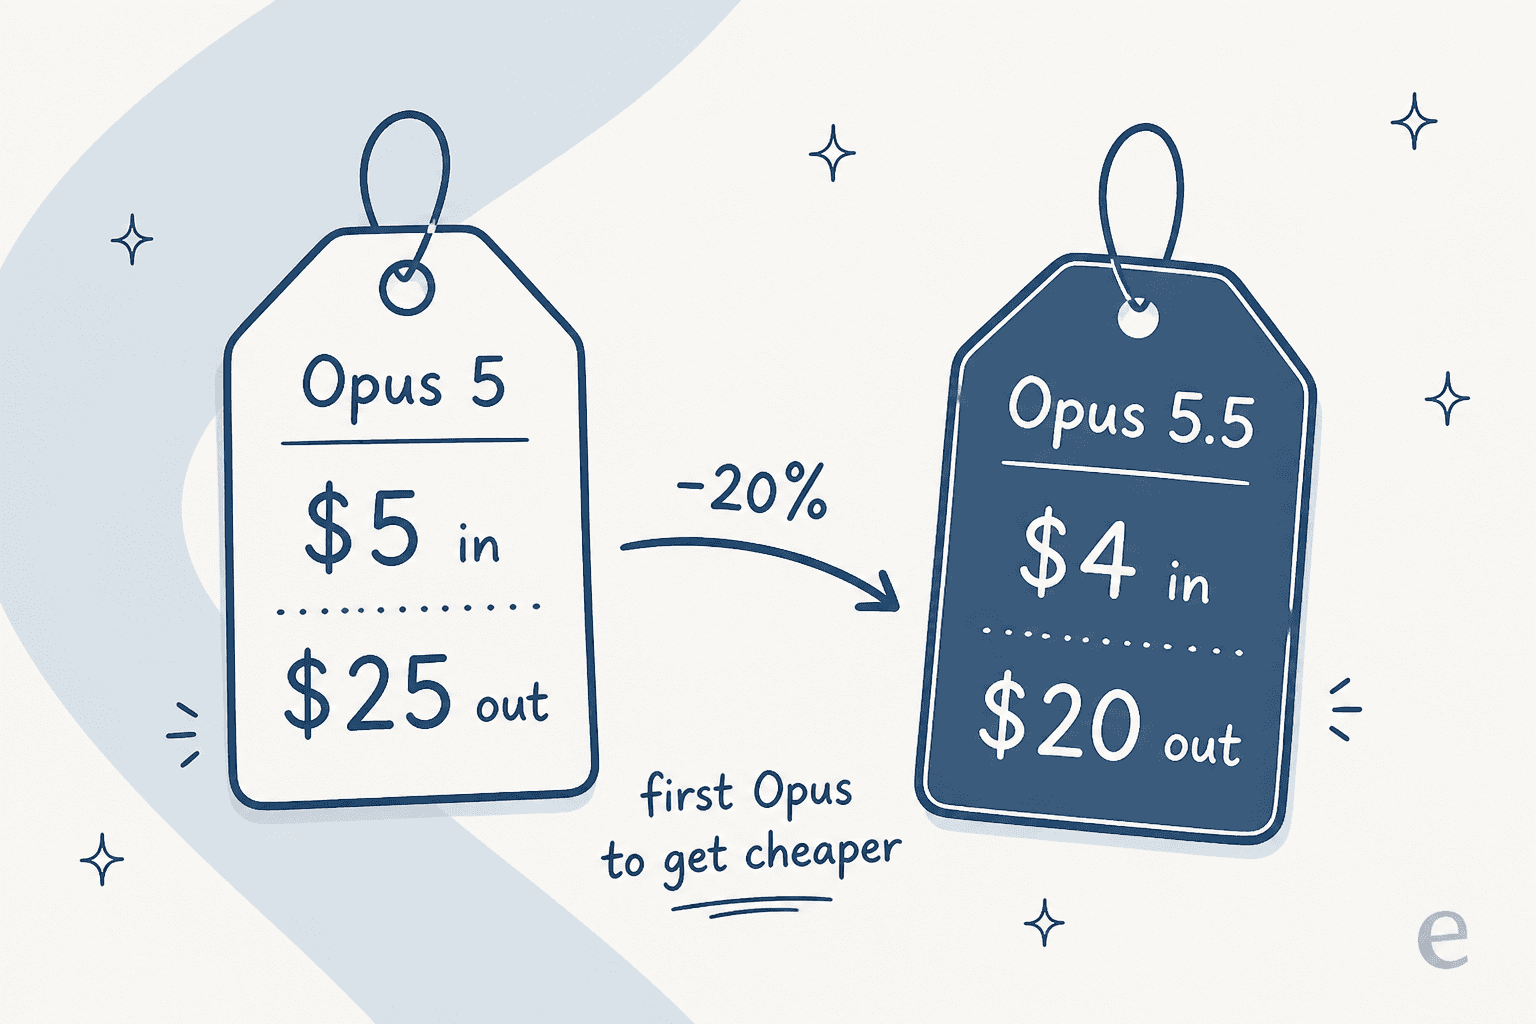
Anthropic lanzó Claude Opus 5.5 el 22 de septiembre de 2026, y se entiende mejor como un ajuste de eficiencia sobre Opus 5 que como un modelo nuevo construido desde cero. El titular es la inversión: cada Opus anterior se lanzó a precio premium, y este es el primero que se lanza más barato que el modelo al que reemplaza.
El precio pasó de los $5/$25 de Opus 5 a $4/$20 por millón de tokens, un recorte plano del 20%. Suena a poco hasta que recuerdas para qué se usa Opus normalmente: trabajo largo, intensivo en tokens y autónomo, donde el lado de salida de la factura domina. Un recorte del 20% en la tarifa de $20 de salida es donde la mayoría de los equipos lo notan.
Junto al precio cambiaron varias cosas por dentro. El esfuerzo por defecto bajó de high a medium, el pensamiento está siempre activo, y Anthropic ahora recomienda empezar con Opus 5.5 para la mayoría del trabajo en lugar de tratar a Opus como el nivel premium de último recurso. Tiene una ventana de contexto de 1M de tokens, hasta 128K tokens de salida (300K en Batch), visión nativa y una fecha de corte de conocimiento de junio de 2026. Es el modelo por defecto en Claude Max, el más potente en Claude Pro, y es el que impulsa Claude Code para programación agéntica.
El dial de esfuerzo es toda la reseña
Construyo agentes de IA en eesel, así que cada lanzamiento de frontera significa el mismo ritual: repetir mis evals, mirar el coste por tarea terminada, decidir qué cambiar. Lo que más me sorprendió de Opus 5.5 no fue la calidad, fue cuánto domina el ajuste de esfuerzo todo lo demás sobre su uso.
Así funciona el mecanismo. Opus 5.5 expone un control de esfuerzo con cinco niveles: low, medium (el nuevo valor por defecto), high, very high y max. Un esfuerzo mayor no solo hace que "se esfuerce más" de forma vaga; hace que el modelo razone durante más tiempo y genere muchísimos más tokens antes de responder. Con esfuerzo máximo en una tarea difícil, gastó aproximadamente 119k tokens de salida frente a una ejecución mucho más ligera con esfuerzo bajo. Como la salida se factura a $20 por millón, el dial de esfuerzo es en realidad un dial de coste disfrazado de etiqueta de calidad.
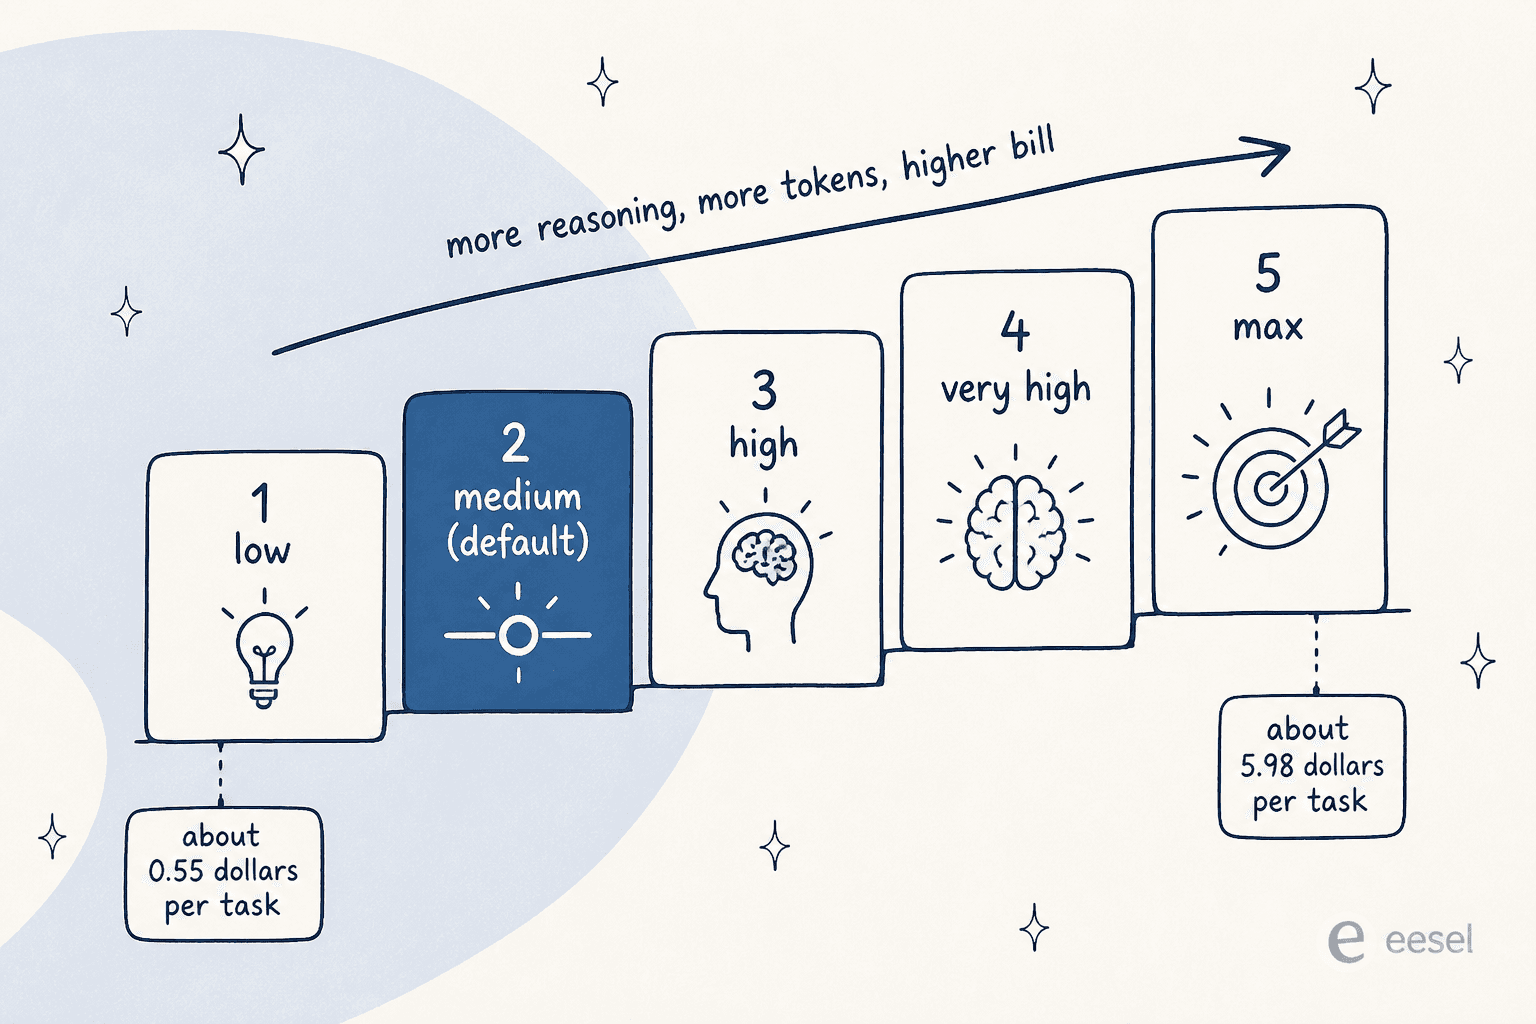
Por eso la tarifa por token es casi una distracción. Según la propia medición de Artificial Analysis, la misma tarea difícil cuesta unos $0,55 con esfuerzo bajo, unos $1,34 con esfuerzo medio y unos $5,98 con esfuerzo máximo. La inteligencia que estás pagando sube con ello: la ejecución con esfuerzo bajo obtiene 42 puntos en el Intelligence Index, medium llega a 51, y solo con max alcanza el titular de 58. Así que la pregunta real al desplegar Opus 5.5 no es "¿puedo pagarlo?", sino "¿cuál es el nivel de esfuerzo más bajo que aún cumple el listón para esta tarea?". La mayoría de las veces, es medium.
Este es también el mayor tropiezo para quienes vienen de Opus 5, donde el esfuerzo por defecto era high. Si trasladas la misma carga de trabajo a Opus 5.5 sin tocar el ajuste, tu factura por tarea puede incluso bajar, porque el valor por defecto ahora está un escalón más abajo. Es un valor por defecto genuinamente bien pensado, pero significa que no puedes deducir el coste solo a partir del precio de lista.
Los benchmarks: gana casi todas las categorías
Dejando el precio a un lado por un momento, en capacidad pura Opus 5.5 es el líder claro. En el Intelligence Index de Artificial Analysis ocupa el número uno con 58, por delante de todo el campo de frontera. Y no es una casualidad de un solo benchmark: lidera en GDPval-AA (1846), en AutomationBench y en las evaluaciones de codificación de largo alcance que más importan para los agentes.
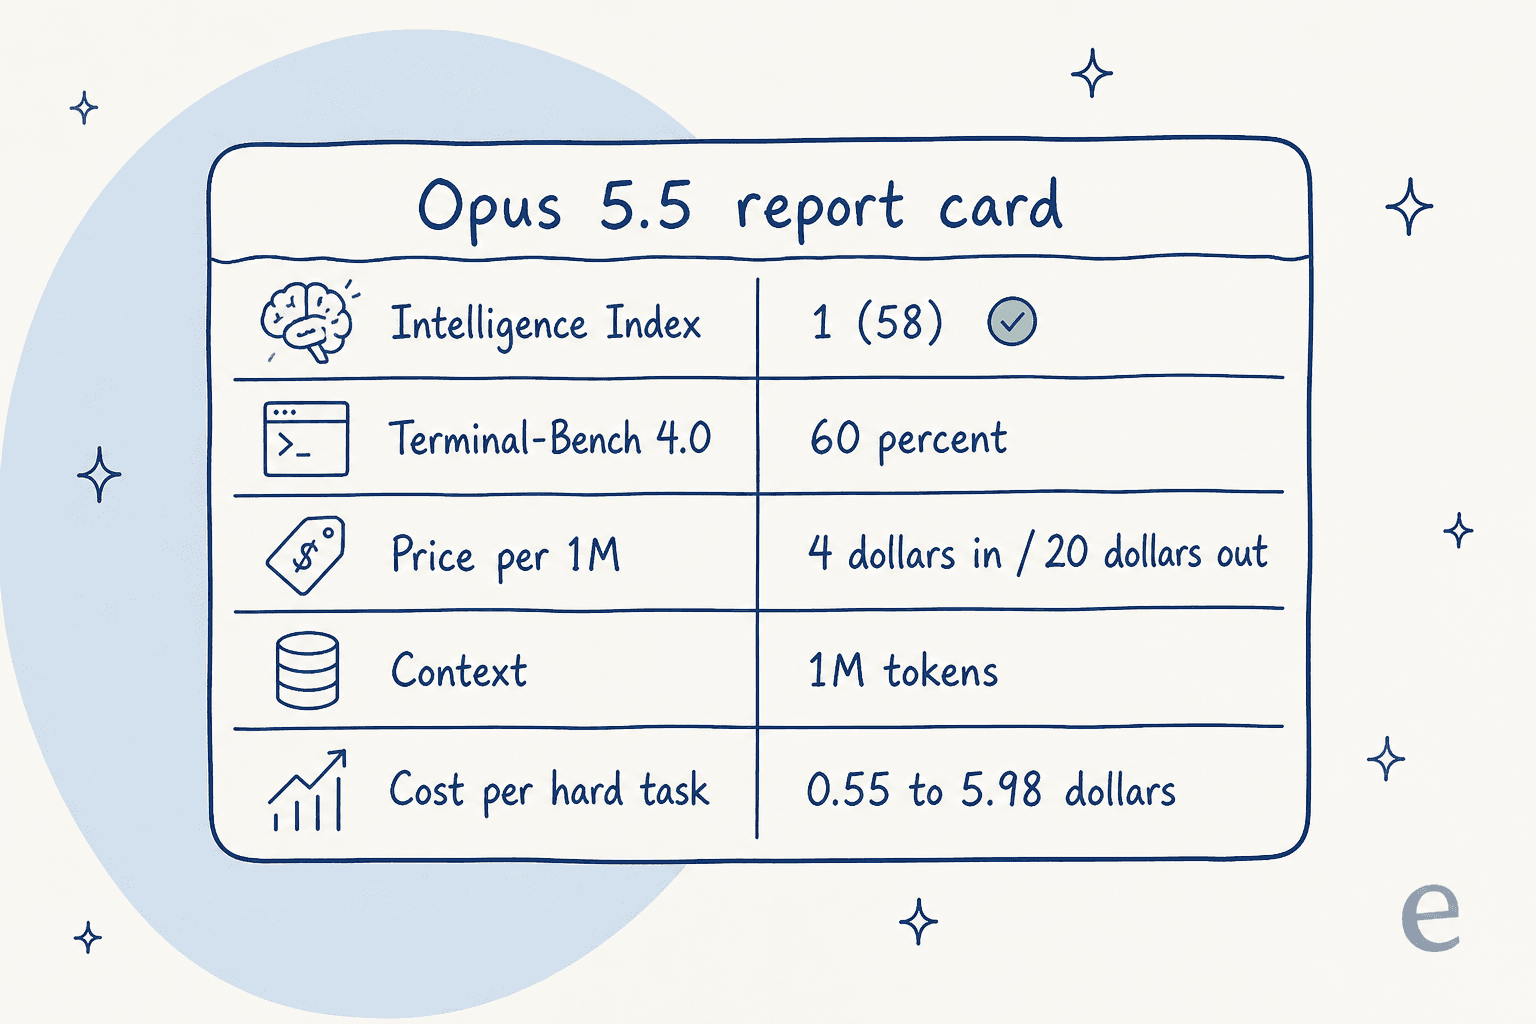
La historia de programación es donde más claramente se adelanta. En Terminal-Bench 4.0, ejecutado con el harness de Artificial Analysis a esfuerzo máximo, Opus 5.5 obtuvo 60% frente a 44% de su rival más cercano en precio. Ese es el tipo de brecha que se traduce en menos callejones sin salida en una ejecución larga de programación agéntica, exactamente la carga de trabajo para la que Anthropic lo ajustó. Si haces trabajo de ingeniería difícil, autónomo y de varios pasos, este es el modelo que termina las tareas en las que otros modelos se atascan.
Donde añadiría una advertencia: la puntuación máxima es una cifra con esfuerzo máximo, y el esfuerzo máximo es el ajuste de $5,98 por tarea. Los benchmarks que coronan a Opus 5.5 lo miden en su punto más caro. Eso es justo, todos los modelos se miden en su techo, pero significa que la victoria en el leaderboard y la experiencia cotidiana no son lo mismo, a menos que siempre pagues por max.
Lo que realmente cuesta Claude Opus 5.5
Aquí va la tarifa completa, porque los precios "desde" esconden justo las partes que muerden en trabajo intensivo en tokens.
| Concepto | Tarifa |
|---|---|
| Entrada (por 1M de tokens) | $4 |
| Salida (por 1M de tokens) | $20 |
| Lectura de caché (por 1M de tokens) | $0,20 |
| Recargo por contexto largo | Ninguno |
| Ventana de contexto | 1M de tokens |
| Salida máxima | 128K tokens (300K en Batch) |
| Coste por tarea difícil (AA) | $0,55 (low) a $5,98 (max) |
Dos filas merecen una segunda mirada. Primero, no hay recargo por contexto largo, lo que distingue a Opus 5.5 de rivales que duplican su tarifa de entrada a partir de un umbral; en trabajos de contexto enorme, esa tarificación plana cierra silenciosamente la brecha por token. Segundo, las lecturas de caché a $0,20 por millón significan que, si tu carga de trabajo es un prompt de sistema grande y estable más preguntas cortas, una gran parte de tu factura de entrada sale barata.
Un ejemplo rápido. Supongamos que ejecutas 1.000 tareas de agente difíciles al mes. Con esfuerzo medio ($1,34 cada una) son unos $1.340. Si llevas esas mismas 1.000 tareas a esfuerzo máximo por los últimos puntos de inteligencia, estás en unos $5.980. Ese vaivén de 4x es una decisión de configuración, no un cambio de plan, y es el coste por tarea que yo pondría en la pizarra antes de meter Opus 5.5 en cualquier cosa de alto volumen. Para el desglose completo con Batch y tarifas regionales, consulta mi guía de precios de Opus 5.5, y la comparativa más amplia OpenAI API vs Anthropic API cubre cómo se compara frente a la otra plataforma de frontera.
Dónde Opus 5.5 se gana su precio, y dónde no
Déjame ser concreto sobre el encaje, porque "es el mejor modelo" es cierto e inútil a la vez.
Se gana su precio cuando la tarea es difícil, larga y cara si sale mal. Un agente de programación de varias horas refactorizando una base de código real, una tarea de investigación que debe sostener un contexto enorme y razonar a lo largo de él, un problema ambiguo donde un modelo más barato da vueltas en círculos. En esos casos los tokens extra compran un resultado terminado en lugar de un callejón sin salida con apariencia plausible, y la factura es barata frente a las horas de ingeniería que ahorra.
Es la herramienta equivocada cuando la tarea está bien definida y es de alto volumen: clasificación, respuestas cortas, traducción, búsquedas simples, el 80% aburrido de la mayoría de las cargas de trabajo en producción. Pagar tarifas y latencia de Opus por trabajo que un modelo de gama media resuelve sin problema es dinero y velocidad que no recuperas. Opus es deliberadamente pausado por diseño, así que para cualquier cosa en la que un humano espera en vivo, como una respuesta de chat, la capacidad de respuesta importa más que los últimos puntos del Intelligence Index. Ese es el argumento para una configuración de dos modelos: dirigir las tareas genuinamente difíciles a Opus 5.5 y todo lo demás a Sonnet 5, o recurrir a una de las opciones más económicas de mi repaso de alternativas a Opus 5.5.
La conclusión honesta en una línea: Opus 5.5 es el mejor modelo, y "mejor modelo" rara vez es la misma pregunta que "modelo adecuado para esta tarea".
Lo que la gente dice realmente
La reacción en el hilo de lanzamiento coincidió con mis propias pruebas: respeto real por la capacidad, y un recordatorio recurrente de que la etiqueta del dial de esfuerzo importa más que el leaderboard. Un tester experimentado, comparándolo con la competencia de frontera que se lanzó al día siguiente, llegó a esto:
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

Ese "at medium" hace mucho trabajo, y es todo el sentido de esta reseña. El otro tema que vale la pena destacar es lo poco que debería decidir tu elección en 2026 un solo benchmark:
Only hands-on experience matters in the end, and these days it's very easy to switch models.
Esa última frase, "very easy to switch models", es la verdadera historia del año, y lleva directo a la pregunta que la mayoría de las reseñas de modelos se saltan.
Prueba eesel: el compañero de equipo que funciona con cualquier modelo
Toda reseña de modelo asume en silencio que el trabajo del lector es elegir un modelo, cablear su API, gestionar el prompt engineering, conectarlo con tus herramientas y evitar que alucine con clientes reales. Para la mayoría de los equipos, ese no es el trabajo. El trabajo es una tasa de resolución más alta, o publicaciones publicadas. Un modelo de frontera como Opus 5.5 es infraestructura; es el motor, no el empleado.

Así es como enmarcaría eesel. Es una plataforma de compañeros de equipo de IA, y contratas compañeros de equipo listos para trabajar en tareas específicas. El equipo actual incluye un compañero de equipo de IA para helpdesk que se une a tu cola de soporte existente y una escritora de blog con IA que redacta publicaciones investigadas. Cada uno llega ya sabiendo su trabajo, conectado a tus herramientas y anclado en el contexto de tu empresa, así que no eres tú quien elige entre niveles de esfuerzo y cuida un prompt. Como el modelo se sitúa bajo el compañero de equipo, un modelo más barato o más inteligente que salga el mes que viene es una mejora gratuita, no una reconstrucción, y el compañero de equipo de IA para helpdesk se factura por ticket resuelto en lugar de por token, así que las matemáticas del dial de esfuerzo de arriba dejan de ser tu problema.
Si eres de los que lee una reseña de modelo hasta el final, esto te va a gustar: todo se puede manejar desde la terminal. El CLI de eesel (npx @eesel/cli) conecta integraciones, edita las instrucciones permanentes del agente, simula un despliegue contra tus tickets históricos, aprueba acciones y lee el registro de actividad de cada ejecución, todo como JSON, con una opción --dry-run que imprime la llamada exacta que haría una escritura antes de enviarla. Cada workspace es también un servidor MCP, así que agentes de programación como Claude Code, Codex y Cursor pueden operar el mismo compañero de equipo. Es el mismo producto que el panel, expuesto para personas y agentes que viven en una terminal. Puedes probar eesel gratis.
Preguntas frecuentes
¿Vale la pena Claude Opus 5.5 en 2026?
¿Cuánto cuesta Claude Opus 5.5?
¿Qué es el dial de esfuerzo en Claude Opus 5.5?
¿Es bueno Claude Opus 5.5 para programar?
¿Necesito Claude Opus 5.5 para crear un agente de soporte con IA?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.