Qué es realmente Claude Mythos 5.1
Anthropic lanzó Claude Mythos 5.1 el 1 de septiembre de 2026, con el ID de modelo claude-mythos-5-1. Es un modelo frontera orientado al trabajo verificado de ciberseguridad y ciencias de la vida, y Anthropic ha dicho que Claude Security ya funciona sobre él.
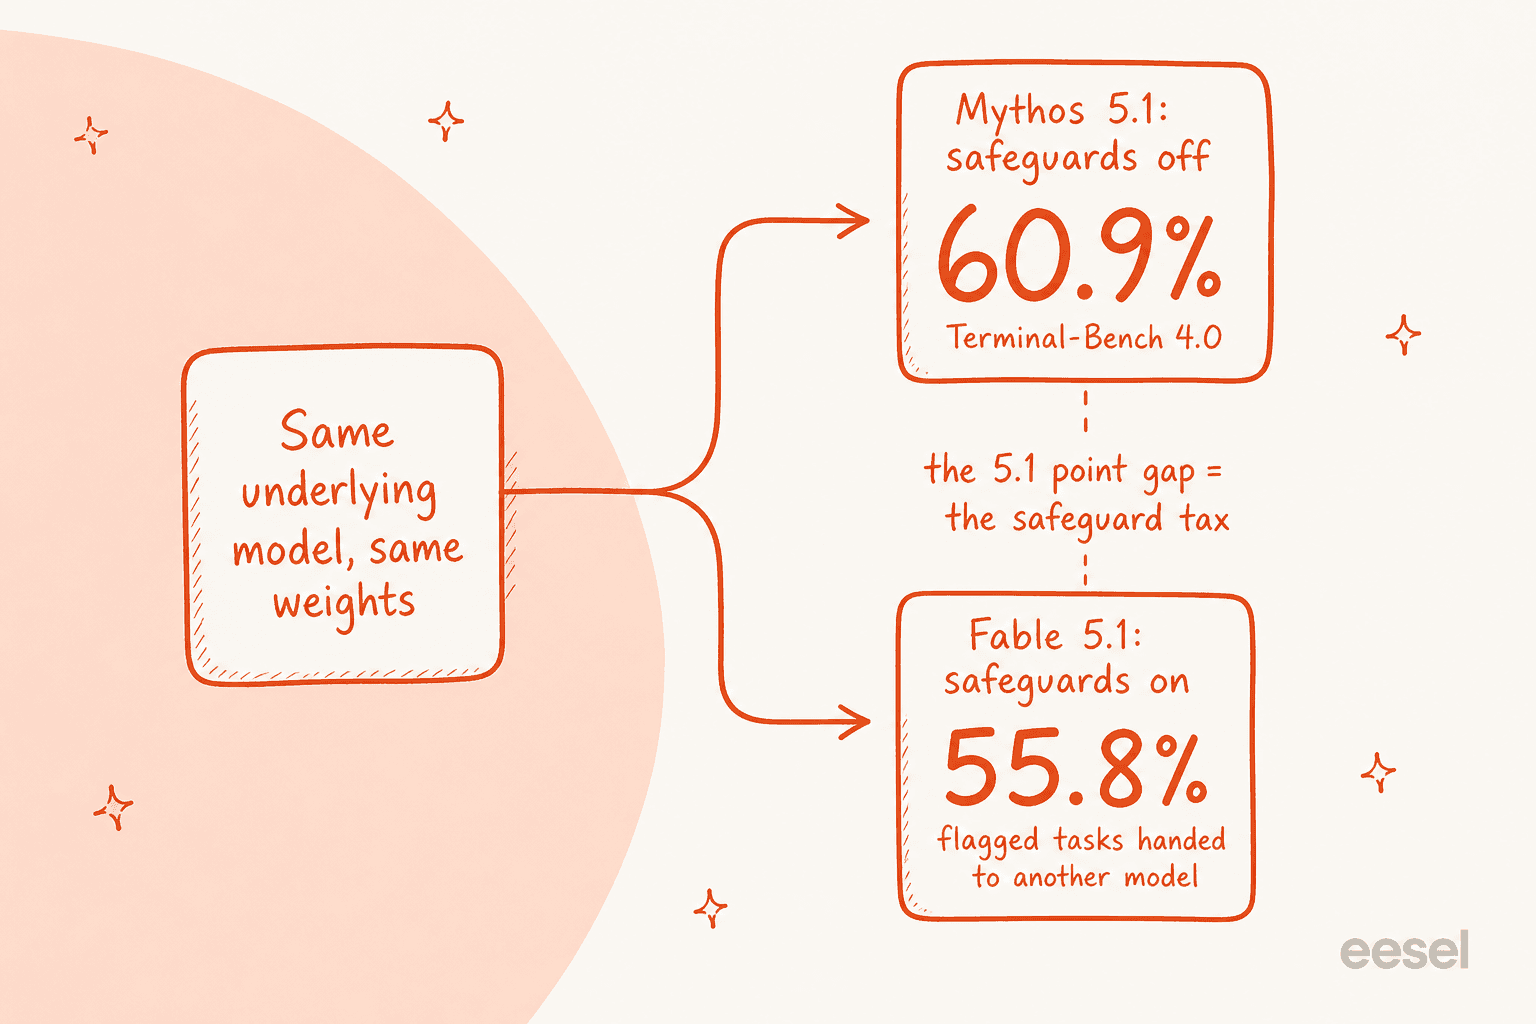
Lo que hay que asimilar antes de hablar de cualquier benchmark: Mythos 5.1 y Fable 5.1 son los mismos pesos. Lo único que cambia es la capa de seguridad. Fable 5.1 es la versión evaluada y lanzada con los mecanismos de seguridad de producción activados, y cuando uno de ellos se activa, la tarea se entrega a otro modelo (el trabajo cibernético se dirige a Opus 4.8, la biología a Opus 5). Mythos es el mismo modelo medido con esos mecanismos desactivados. Esa relación es toda la historia, así que volveré a ella una y otra vez.
Mythos 5.1 frente a Fable 5.1: la brecha es un impuesto de seguridad
Aquí está el número que todo el mundo cita fuera de contexto. En Terminal-Bench 4.0, Mythos 5.1 obtiene un 60,9 % y Fable 5.1 un 55,8 %. Parece que Mythos es el modelo más inteligente. No lo es. La puntuación más baja de Fable es lo que ocurre cuando los mecanismos de seguridad interceptan una tarea y la reasignan, y una tarea intervenida puede quedarse directamente en cero. La brecha de 5,1 puntos es el coste de los mecanismos de seguridad, no una diferencia en el cerebro subyacente.
Esto confundió a muchos lectores en el lanzamiento. Como dijo un comentarista en Hacker News:
"Espera, ¿así que es literalmente el mismo modelo pero puntúa más alto porque le quitaste el cinturón de seguridad? Eso no es un modelo nuevo, es una nota al pie de un benchmark."

El propio Anthropic espera que la brecha se reduzca a medida que los mecanismos de seguridad sean más precisos, lo que es una admisión implícita de que la diferencia está en la capa de seguridad y no en la calidad del modelo. Así que si estás comparando Mythos y Fable por capacidad pura, detente: son iguales. Donde Fable se gana su lugar es en el propio trabajo de seguridad. Ahora puede identificar vulnerabilidades de software en código fuente, dispara aproximadamente un 60 % menos de intervenciones de seguridad cibernética por sesión de Claude Code, y sus mecanismos de seguridad de biología se activan un 85 % menos en solicitudes inofensivas. Las pruebas de penetración, la generación de exploits y el escaneo de vulnerabilidades binarias siguen dirigiéndose a Opus. Ambos modelos se ubican junto al resto de la gama, así que si quieres el mapa completo de la familia, los artículos sobre Claude Opus 5 y Claude Sonnet 5 cubren los escalones inferiores.
Para que quede constancia, así se sitúa Fable 5.1 (tu sustituto práctico de Mythos) frente al resto según las cifras publicadas:
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6 | 24.7 | 29.0 | 22.4 |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| AutomationBench | 31.4 | 17.1 | 26.9 | 19.6 |
| CursorBench 3.2.0 | 73.4 | 70.5 | 70.0 | 67.2 |
| HLE with tools | 65.0 | 63.8 | 63.6 | - |
El salto en Terminal-Bench-Science, de 24,7 a 52,6, es el que realmente destacaría a un comprador. Para una comparación cara a cara con el lado de OpenAI, los análisis de GPT-5.6 Sol y GPT-5.6 vs Claude profundizan más de lo que puede hacerlo una sola fila.
La verdadera noticia es la lectura de caché a 0,25 $
Si solo te llevas un dato de esta reseña, que sea este. Fable 5.1 y Mythos 5.1 tarifan un acierto de caché a 0,25 $ por millón de tokens, lo que equivale a 0,025x la tarifa base de entrada. Cualquier otro modelo de Claude cobra 0,1x, es decir, 1,00 $. Este es un modelo al doble del precio base de Opus 5 que ofrece una lectura de caché a la mitad del precio de Opus 5 (0,50 $).
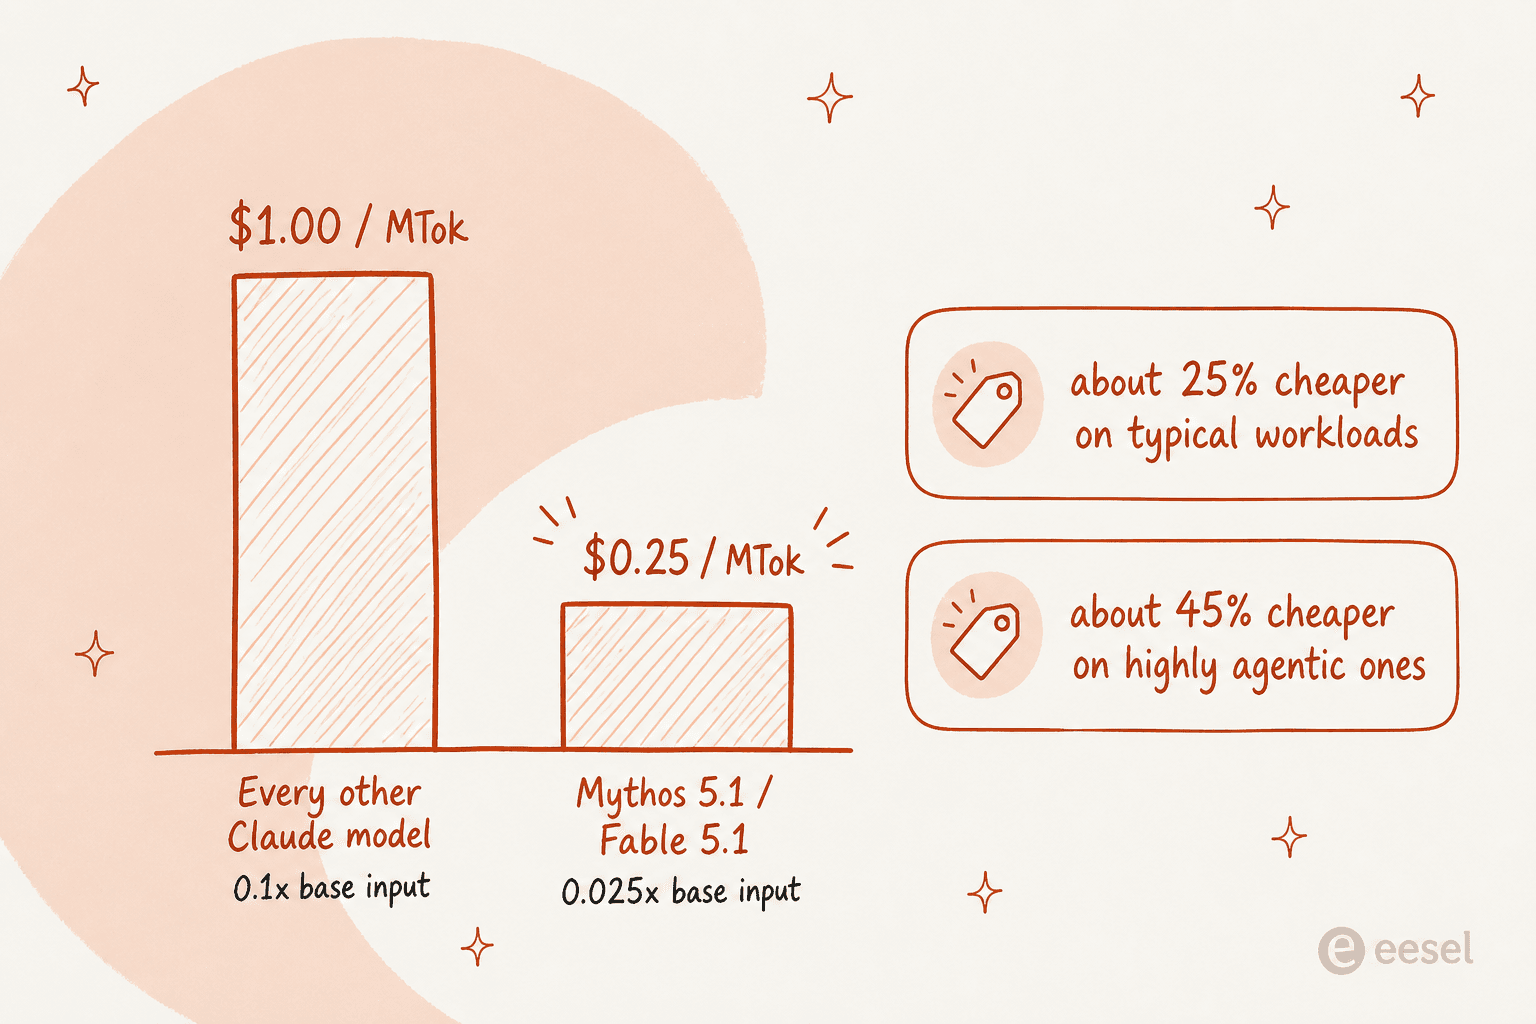
Anthropic midió el efecto durante cuatro semanas de uso en agosto de 2026: alrededor de un 25 % más barato en cargas de trabajo típicas y alrededor de un 45 % más barato en las muy agénticas. La tarifa base (10 $ de entrada / 50 $ de salida) no cambia, el modo batch cuesta 5 $ / 25 $, la escritura de caché de cinco minutos cuesta 12,50 $, y la de una hora cuesta 20 $. Si ejecutas agentes de contexto largo que vuelven a leer la misma base de conocimiento en cada turno, este es el número que realmente mueve tu factura, mucho más que la tarifa base. Un comentarista de Hacker News hizo las cuentas en voz alta:
"La lectura de caché a 0,025x es una locura. Con una tasa de aciertos del 95 %, el coste de entrada efectivo es básicamente el precio de la caché, así que estás pagando céntimos por mantener caliente un contexto enorme."
Para ver cómo se traduce la economía de la caché en un stack de agentes real, la guía de precios de la API de Anthropic y el desglose de precios de Claude Code son los siguientes que leería.
Quién puede realmente usar Claude Mythos 5.1
Aquí es donde la reseña se vuelve práctica, y un poco decepcionante. Mythos 5.1 no es algo que se activa con una clave de API. El acceso está limitado a EE. UU. hoy y pasa por una de tres puertas: el Cyber Verification Program (Anthropic dice que el acceso a Mythos llegará "en el futuro cercano", así que todavía no está activo), una beta del Life Sciences Program solo por invitación, construida con el gobierno de EE. UU., o una conversación directa con tu equipo de cuenta de Anthropic, AWS o GCP. Además, usar Mythos 5.1 exige aceptar una retención de datos de 30 días por defecto.
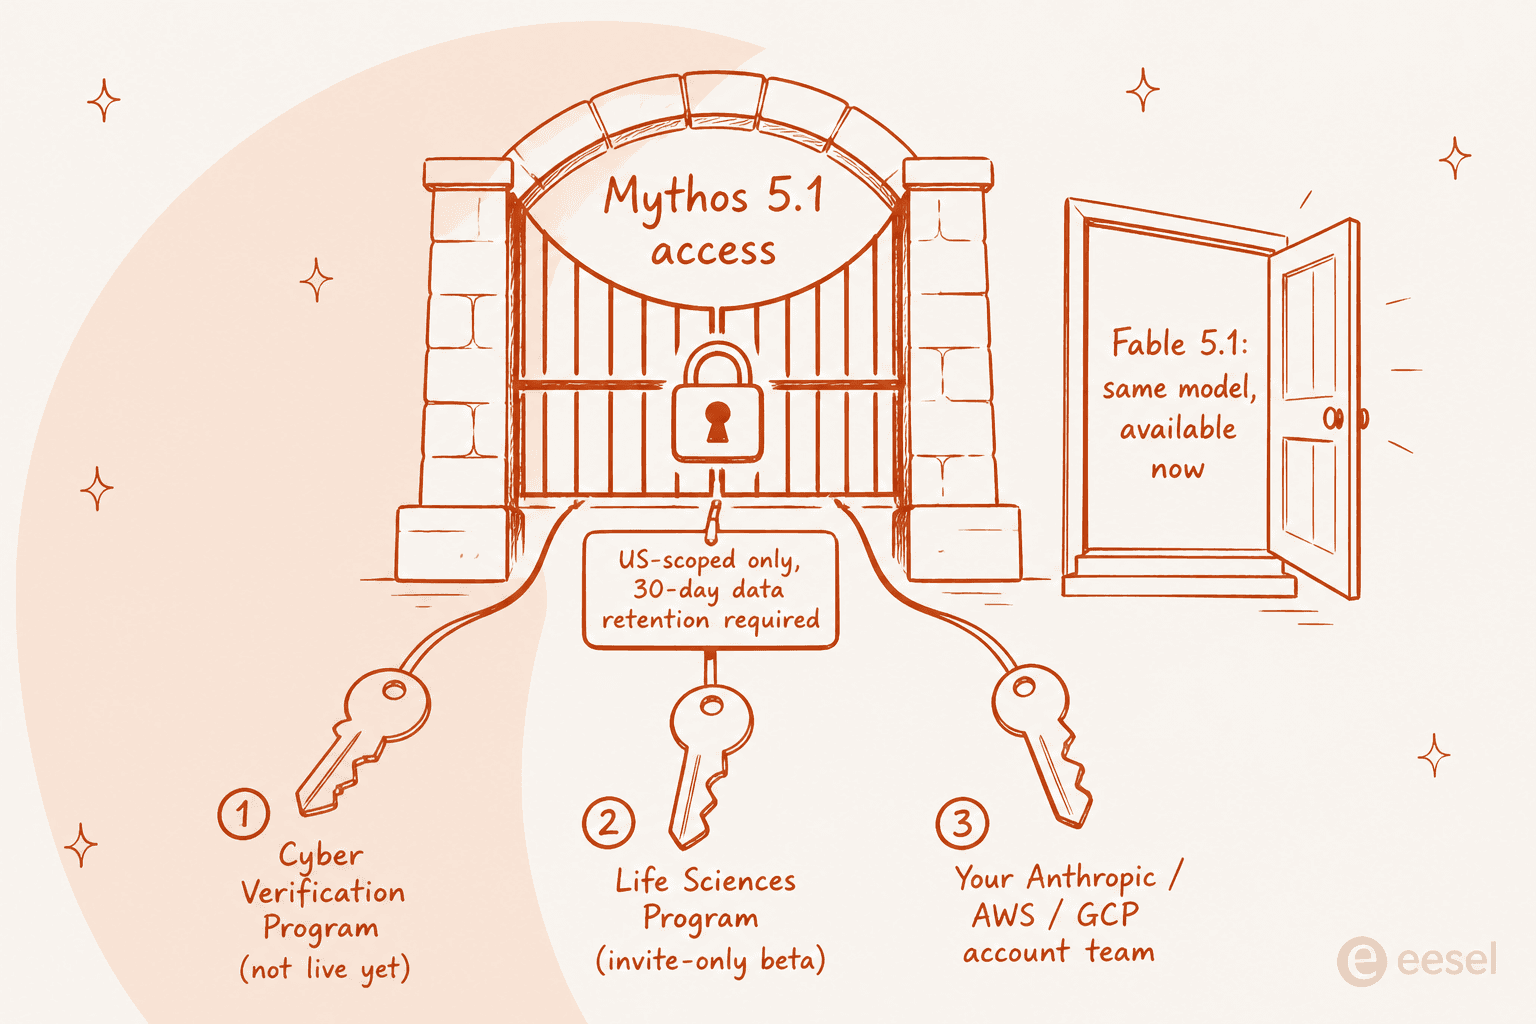
Así que la respuesta honesta a "¿debería usar Mythos 5.1?" es que, para casi todo el mundo, no está sobre la mesa, y la versión que sí puedes usar, Fable 5.1, es el mismo modelo. No es una crítica al modelo, es una razón para orientar tu evaluación hacia el hermano que realmente puedes desplegar. Si estás eligiendo un modelo de Claude para una carga de trabajo real hoy, las guías de alternativas a Claude y el mejor modelo de IA para tickets de soporte son las lecturas más pragmáticas.
La hoja de especificaciones
Para quienes quieren todos los números en un solo lugar, esto es con lo que viene Mythos 5.1 (y, por tanto, Fable 5.1):
| Especificación | Valor |
|---|---|
| Ventana de contexto | 1M tokens |
| Salida máxima | 128K tokens |
| Thinking | Adaptativo, siempre activo; esfuerzo por defecto high |
| Corte de conocimiento | Junio de 2026 |
| Latencia | Más lenta |
| Modalidad | Texto + imágenes a texto |
| Plataformas | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry |
| Retirada | No antes del 1 de septiembre de 2027 |
Hay dos cambios de cara al desarrollador que vale la pena conocer antes de construir. Hay tres cambios de API que rompen compatibilidad y afectan a ambos modelos: el uso forzado de herramientas ahora devuelve un error, los bloques de "thinking" están ligados al modelo que los produjo, y las cuentas de API nuevas creadas desde el día del lanzamiento no pueden editar el contexto anterior conservando la transcripción de "thinking", una medida contra la destilación. También hay una particularidad por la Ley de IA de la UE: los modelos lanzados después del 2 de agosto de 2026 llevan una marca de agua invisible en el texto, con una API de detección en vista previa privada. Esa marca de agua fue lo que generó más debate en el lanzamiento. Si estás integrando un modelo de Claude en tu propio stack, las notas sobre selección de modelo en Claude Code y el artículo sobre agentes gestionados de Claude son los siguientes pasos prácticos.
Qué usaría yo en realidad
Aquí está mi conclusión tras darle vueltas al lanzamiento. Mythos 5.1 es un gran modelo que probablemente no puedes usar, envuelto alrededor de un cambio de precios genuinamente genial que sí puedes. La jugada no es perseguir la invitación. Es ejecutar Fable 5.1, aprovechar la lectura de caché a 0,25 $, y tratar todo el planteamiento de Mythos frente a Fable como la nota al pie de seguridad que realmente es.
Y hay una idea más grande escondida en "el modelo es la parte fácil". Un modelo frontera, sea Mythos o Fable, es infraestructura. No es un agente de soporte, ni un investigador, ni un compañero de equipo por sí solo. Poner una clave de API de Claude en bruto junto a tu helpdesk te da un generador de texto muy inteligente que no conoce tu política de devoluciones, no puede ver tus últimos 10.000 tickets y no tiene forma de ser probado antes de hablar con un cliente. Cerrar esa brecha es el trabajo real, y es el mismo trabajo sin importar si el modelo debajo es Mythos, Fable o Opus 5.
Prueba eesel para la parte que el modelo no hace
Si el motivo por el que estás leyendo una reseña de Claude Mythos 5.1 es que quieres una IA más inteligente en tu cola de soporte, esta es la entrega honesta: el modelo no es el cuello de botella, la infraestructura que lo rodea sí lo es. Para eso exactamente está eesel.
Piénsalo como una nueva contratación. eesel es una plataforma de compañeros de equipo con IA, y el compañero de equipo de IA para el helpdesk se une a tu cola existente ya entrenado con tus tickets pasados, tu centro de ayuda y tus macros, de modo que la inteligencia bruta del modelo se dirige a tu contexto real de empresa en lugar de a la web abierta. Antes de que responda a un cliente real, puedes simularlo contra tus tickets históricos para ver exactamente qué habría dicho, que es el único hábito que le ha ahorrado a mi equipo enviar una respuesta equivocada con confianza más veces de las que puedo contar. Se conecta a tu helpdesk en minutos, ya sea Zendesk, Freshdesk, Front, Gorgias o Help Scout.
Y como una buena parte de quienes leen la reseña de un modelo son desarrolladores, vale la pena decir que eesel no es solo un panel. Existe un CLI real de eesel además de un servidor MCP, así que puedes operar el mismo compañero de equipo desde una terminal, integrarlo en tus propios flujos de trabajo, o dejar que un agente de código como Claude Code lo maneje. Es el mismo compañero de equipo tanto si lo usas con clics como si lo ejecutas sin interfaz. Puedes probar eesel gratis, y si prefieres verlo primero con tus propios tickets, reserva una demo.
Preguntas frecuentes
¿Qué es Claude Mythos 5.1?
Claude Mythos 5.1 es el modelo frontera de Anthropic lanzado el 1 de septiembre de 2026, evaluado con los mecanismos de seguridad de producción desactivados. Comparte los mismos pesos subyacentes que Fable 5.1, la versión con los mecanismos de seguridad activados que la mayoría de la gente realmente usa. Consulta la guía completa de Claude Mythos para el contexto de toda la familia.
¿En qué se diferencia Claude Mythos 5.1 de Fable 5.1?
Son el mismo modelo con una capa de seguridad distinta. En mi reseña de Claude Mythos 5.1, la única diferencia medible es que Fable entrega las tareas marcadas a otro modelo, lo que le resta algunos puntos en los benchmarks. Para un análisis más profundo del modelo hermano, lee la reseña de Claude Fable 5.1.
¿Cuánto cuesta Claude Mythos 5.1?
El precio base es de 10 $ por millón de tokens de entrada y 50 $ por millón de salida, igual que Fable 5.1. La gran novedad es la lectura de caché a 0,25 $ por millón de tokens. El desglose de precios de Claude Fable 5.1 y la guía más amplia de precios de Claude cubren el resto.
¿Cualquiera puede usar Claude Mythos 5.1?
Todavía no. El acceso está limitado a EE. UU. y pasa por el Cyber Verification Program, el Life Sciences Program o tu equipo de cuenta de Anthropic, AWS o GCP, y usarlo exige aceptar una retención de datos de 30 días. Si quieres un modelo de Claude que puedas usar hoy mismo, consulta las guías de alternativas a Claude y el mejor modelo de IA para tickets de soporte.
¿Claude Mythos 5.1 es bueno para atención al cliente?
El modelo es potente, pero un modelo en bruto es infraestructura, no un agente de soporte. Para poner un modelo de Claude en tu cola de tickets todavía necesitas recuperación de información, barreras de seguridad y pruebas, que es justo lo que conectar Claude a tu helpdesk y un software de atención al cliente con IA como eesel hacen por ti.


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.