
Qué es realmente Claude Sonnet 5.5
Claude Sonnet 5.5 es el modelo de gama media de Anthropic y el segundo lanzamiento de la familia Claude 5.5, seis días después de Opus 5.5. Anthropic lo presenta como "a faster, lower-cost complement" de Opus: Opus se reserva para el trabajo complejo que requiere juicio cuidadoso y Sonnet se ocupa de las tareas cotidianas bien acotadas. También se ha prometido un Haiku 5.5 "in the coming weeks".
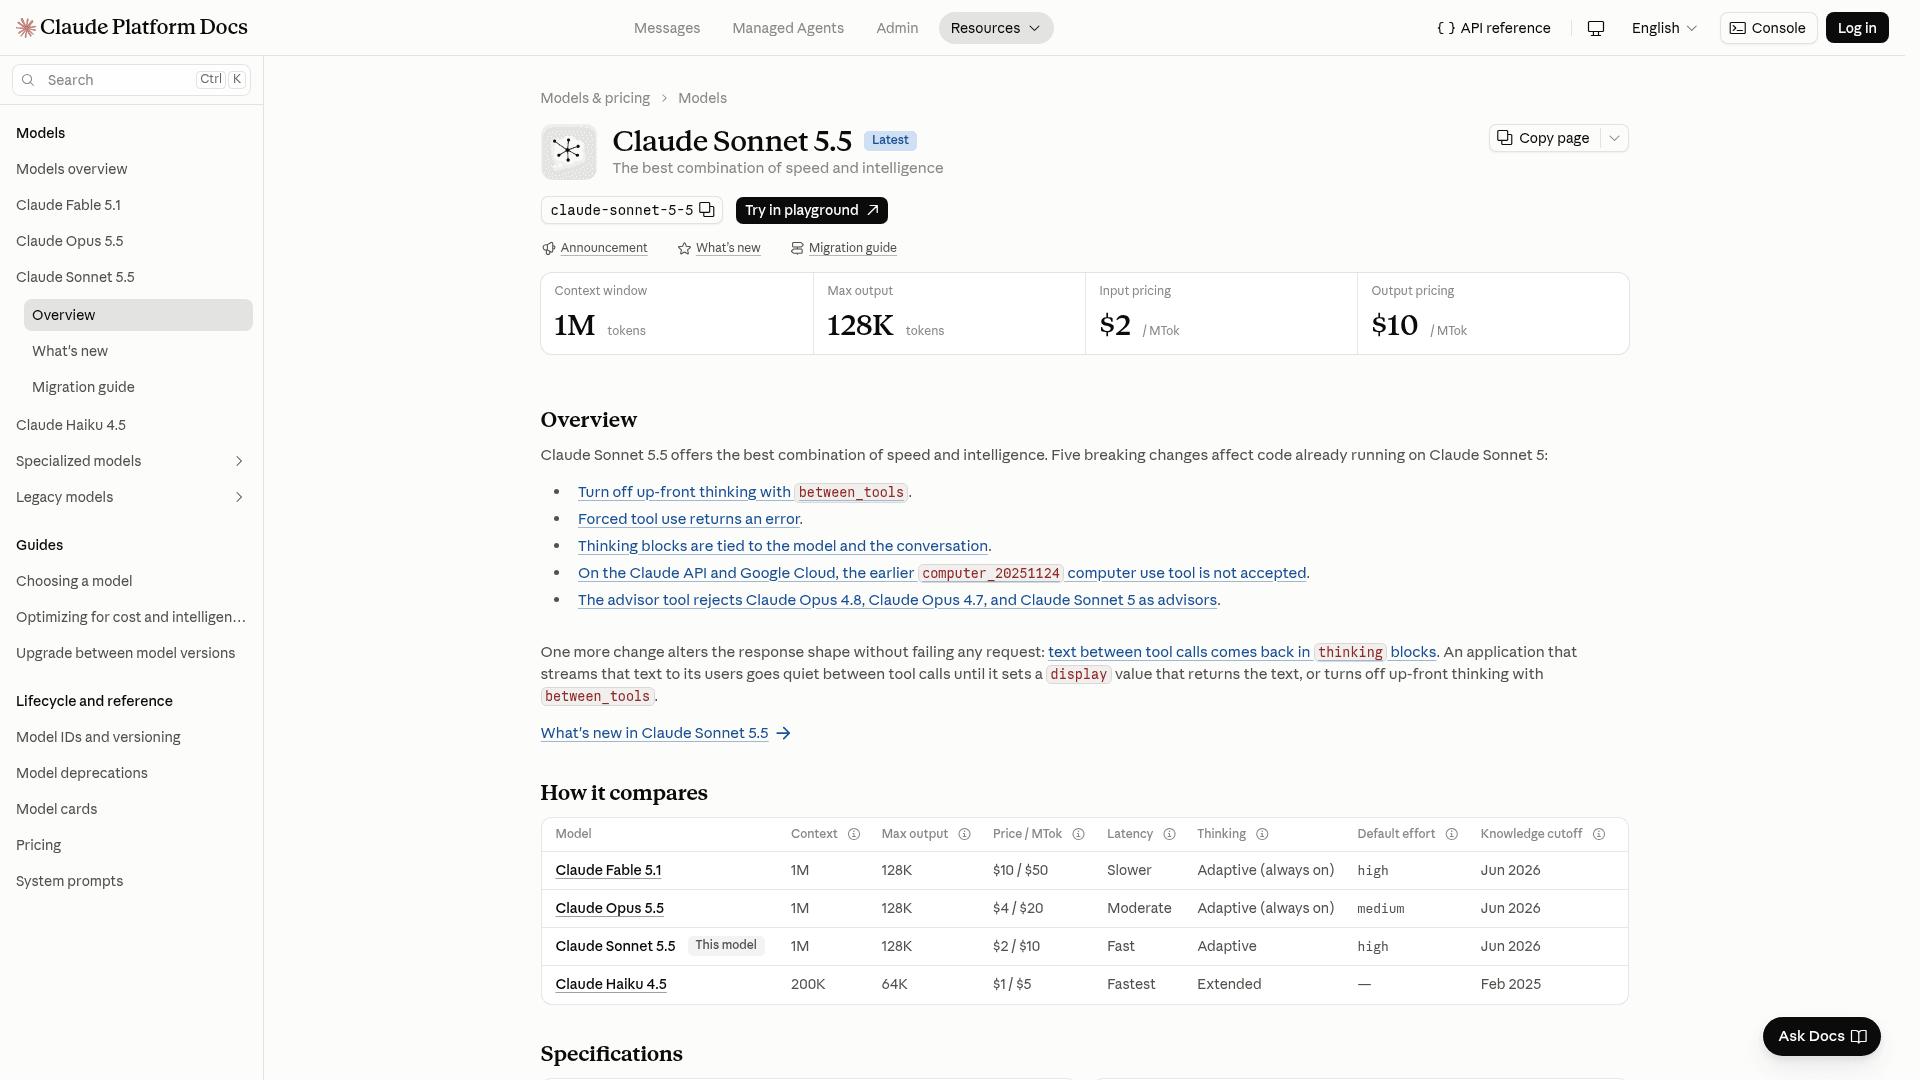
Estas son las especificaciones, según la página de resumen del modelo:
- El ID del modelo es
claude-sonnet-5-5en la Claude API, Google Cloud, Microsoft Foundry y Claude Platform on AWS, yanthropic.claude-sonnet-5-5en Amazon Bedrock. - El contexto es de 1M de tokens de entrada y 128K de salida, o 300K de salida en la Batch API con una cabecera beta.
- La fecha de corte de conocimiento fiable es junio de 2026, igual que Opus 5.5 y Fable 5.1.
- El thinking es adaptativo, y el esfuerzo por defecto es
highen la API, pero Medium en las apps de Claude y en Claude Code. - La retirada es "not sooner than September 28, 2027", lo que te da al menos un año antes de tener que volver a migrar.
El tokenizador es el mismo que en Claude Sonnet 5, según la página de novedades, lo que significa que el mismo texto da el mismo recuento de tokens. Este detalle importa más de lo que parece: implica que todo el ahorro que reclama Anthropic viene de que el modelo escribe menos, y no de una forma más amable de contar.
La verdadera historia: mismo precio, factura más pequeña
En el precio de lista, nada se movió. Sonnet 5.5 cuesta exactamente lo que cuesta Sonnet 5: 2 $ de entrada, 10 $ de salida, 0,20 $ por lecturas de caché. Lo que cambió es cuántos tokens gasta para terminar un trabajo.
Las cifras de acceso anticipado del post de lanzamiento son específicas de una forma que no suele verse:
- Balyasny Asset Management ejecutó 2.441 tareas financieras y vio que Sonnet 5.5 usaba unos 121k tokens por respuesta donde Sonnet 5 usaba 497k, y además puntuaba más alto.
- Slack vio mejores resultados en "almost all" sus evaluaciones offline de Slackbot "with about 14% fewer output tokens", y sin cambiar ningún prompt.
- Base44 terminaba las compilaciones de apps en 3,6 iteraciones de media, donde Opus 5 necesitaba 7,7.
- Lovable midió "a third fewer tool calls and roughly half the shell runs to finish a task".
La comparación lado a lado de la propia Anthropic dice lo mismo, pero de forma visual. Cuando a ambos se les pidió construir una bandada de 400 estorninos en un solo archivo HTML, Sonnet 5 seguía escribiendo código en 4.520 tokens:
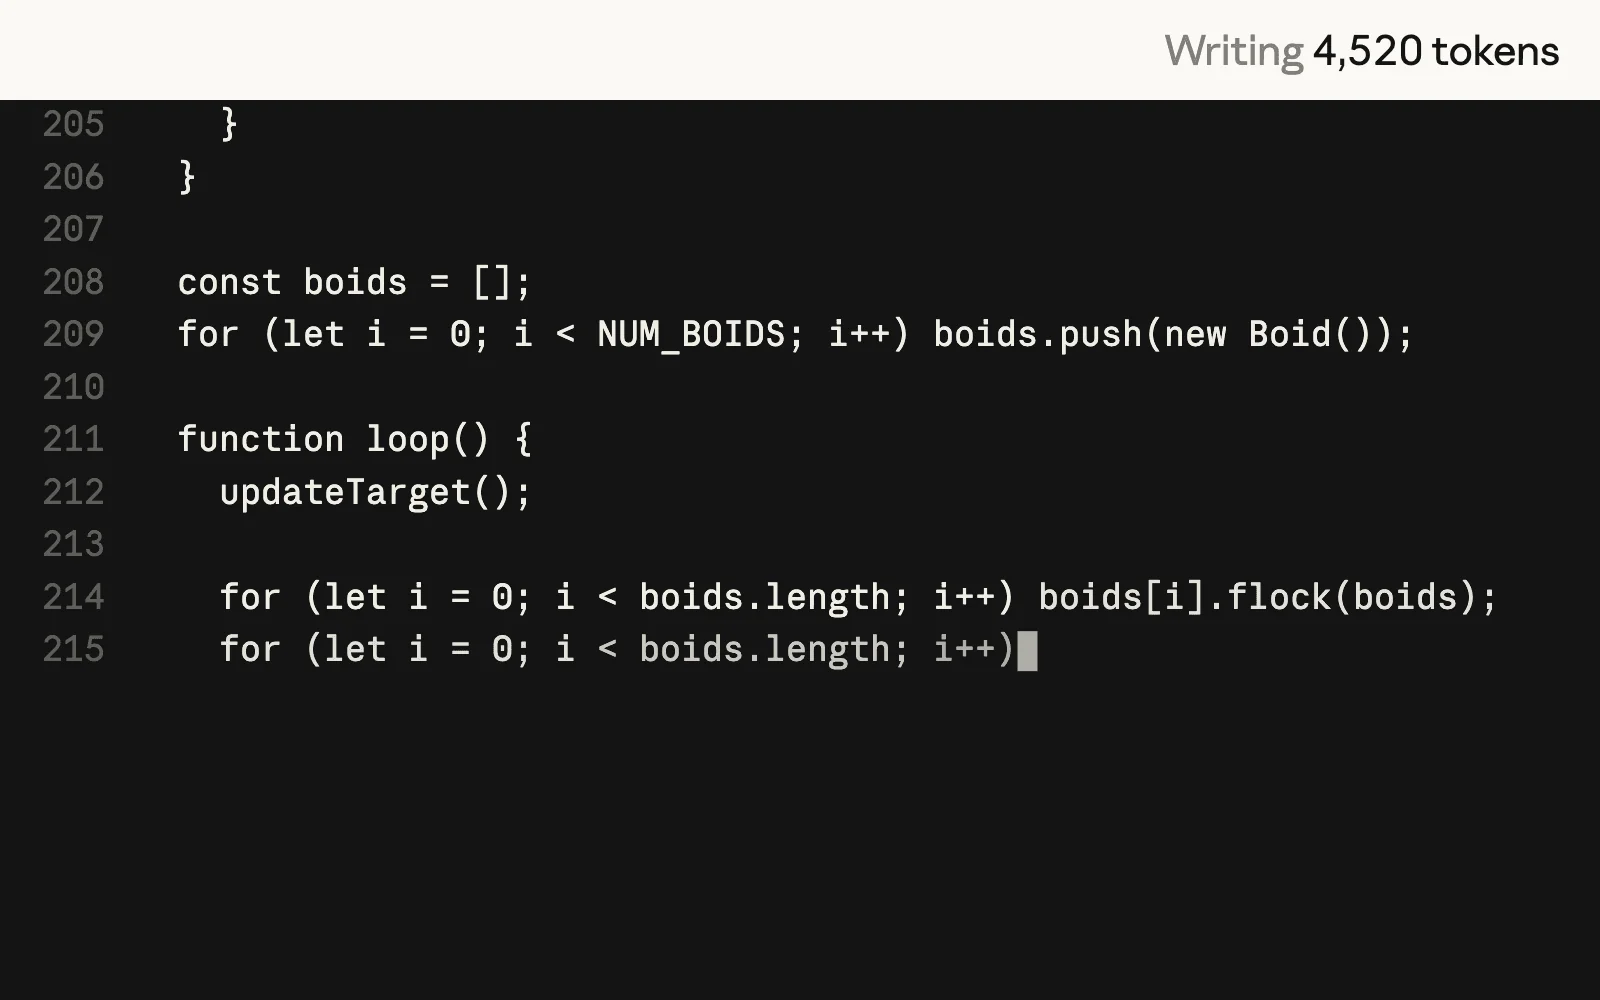
Sonnet 5.5 ya había terminado en 4.158 tokens, y para entonces su bandada llevaba volando 12,5 segundos:
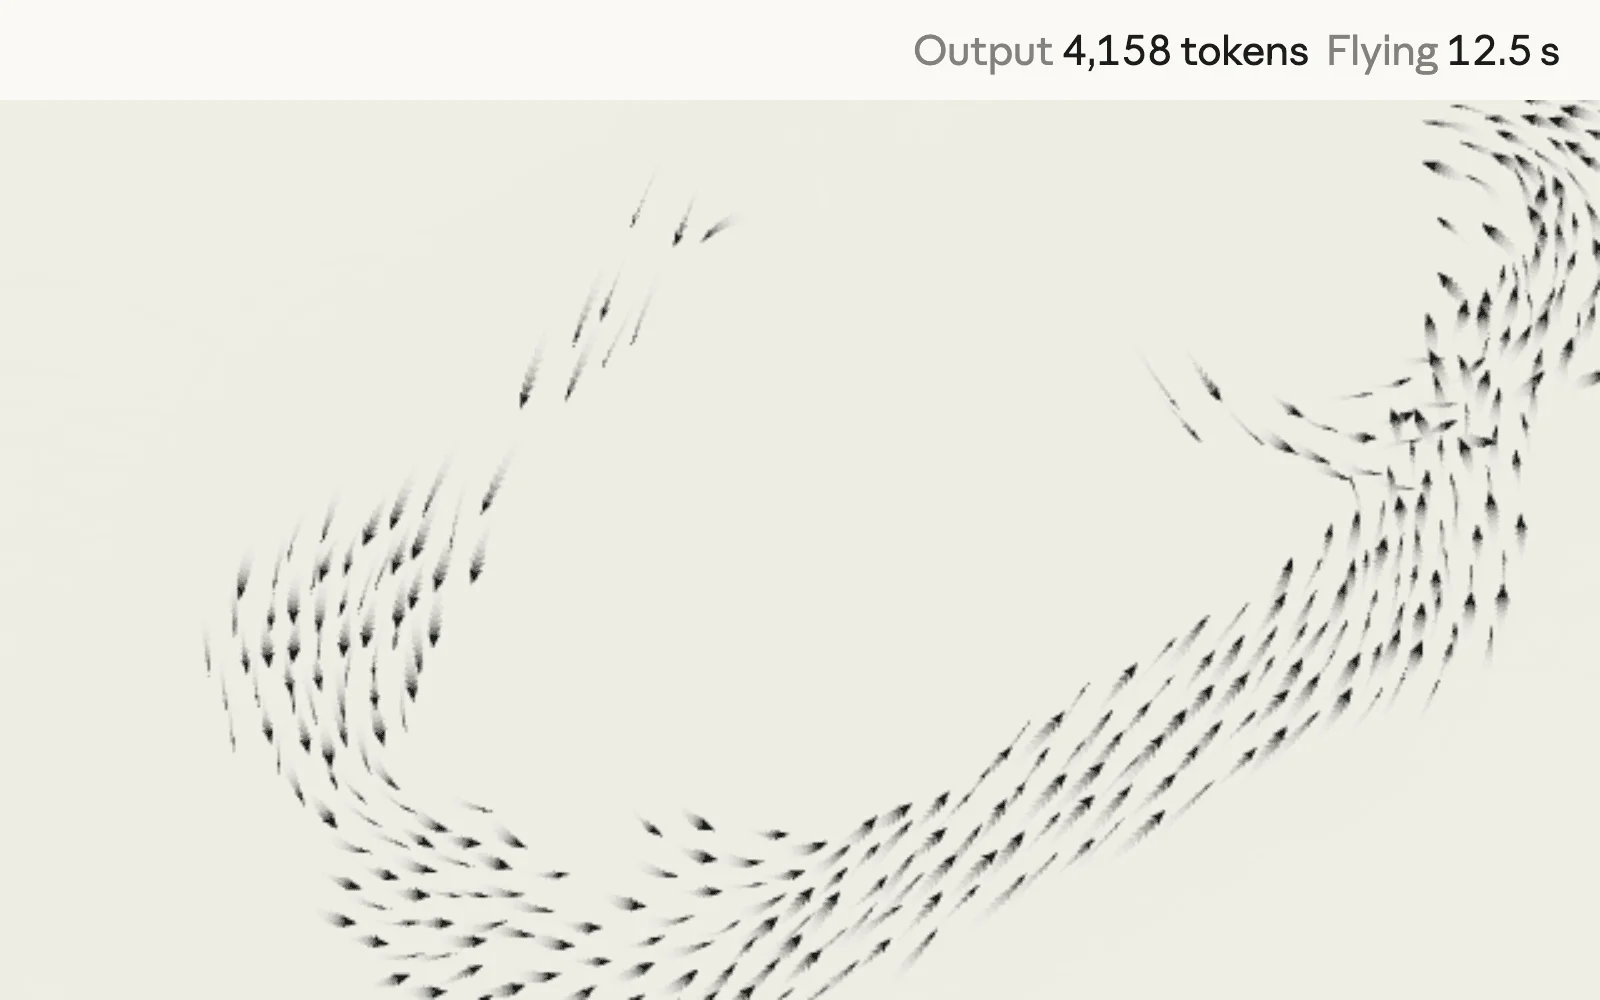
La diferencia entre los clientes es donde está la lectura honesta. La caída de 4x en tokens de Balyasny y el recorte del 14 % de Slack son ambos reales, lo que indica que el ahorro depende mucho de lo inflado que estuviera tu uso de Sonnet 5 desde el principio. El titular de Anthropic dice "up to 30% less per task", y el "up to" hace mucho trabajo en esa frase. Sonnet 5 tenía la costumbre conocida de alargarse: en las pruebas de Artificial Analysis tardó 183 turnos por tarea con esfuerzo máximo, el peor de la gráfica. Si tu carga de trabajo caía ahí, puedes esperar la cifra grande, y si tus prompts ya mantenían las respuestas cortas, espera algo más cercano a lo de Slack.
Cuánto se acerca a Opus 5.5
Para quien paga precios de Opus, esta es la parte donde el lanzamiento se pone interesante. En la tabla de benchmarks del lanzamiento de Anthropic, Sonnet 5.5 cierra la mayor parte de la brecha con un modelo que cuesta el doble por token.
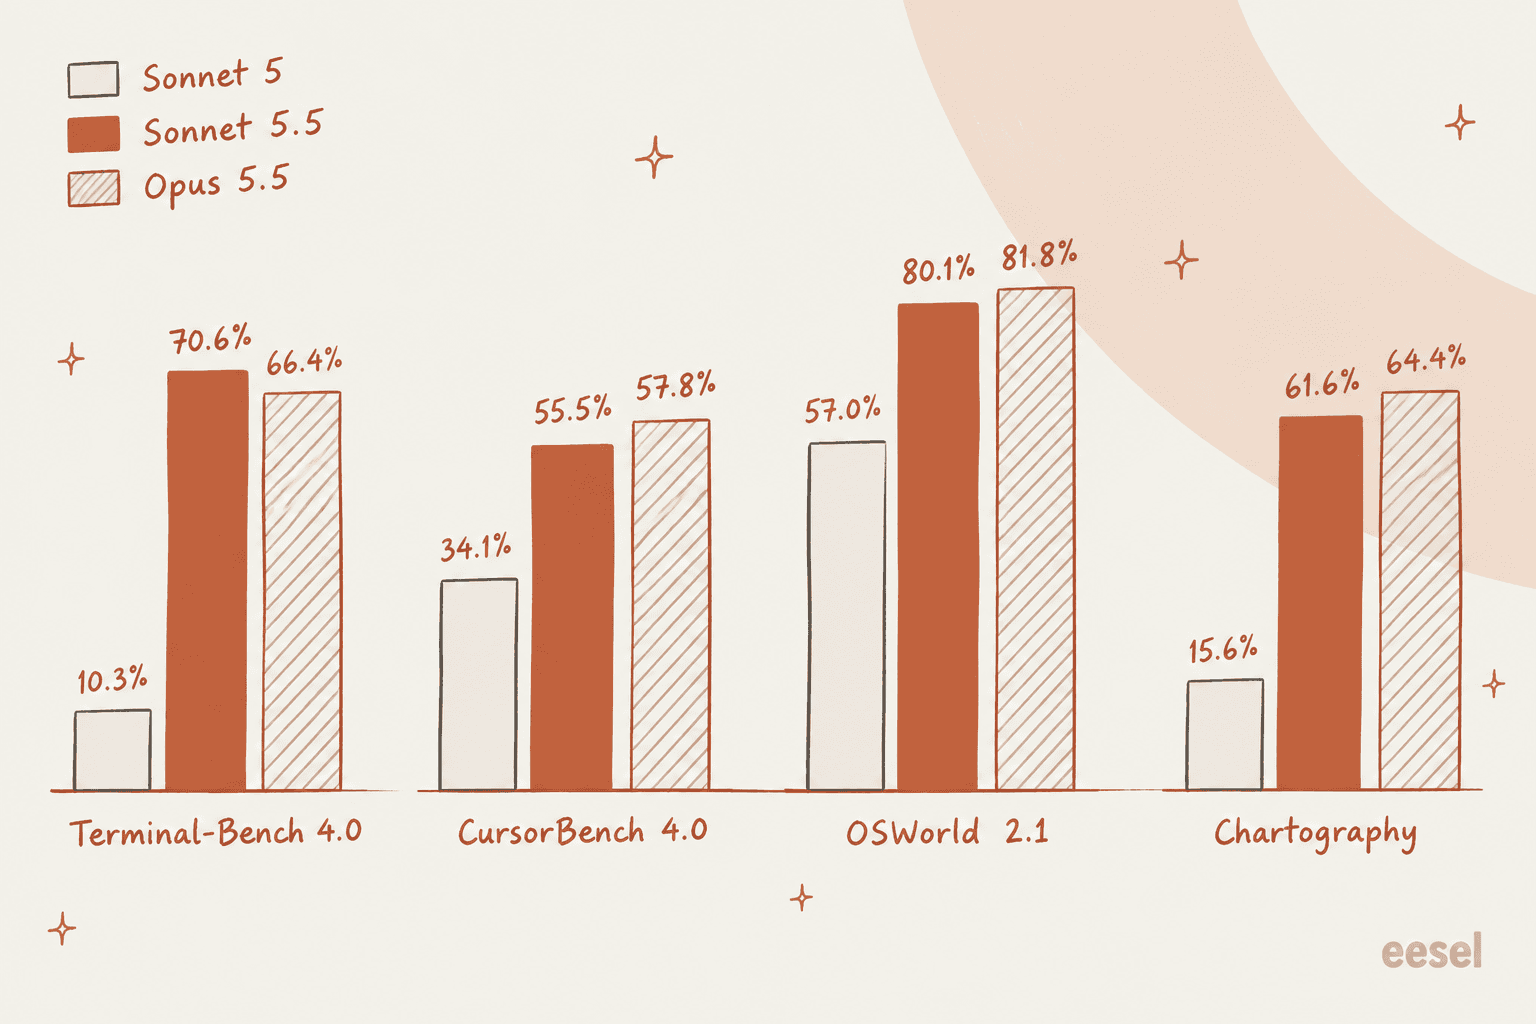
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (programación agéntica) | 70.6% | 10.3% | 66.4% | no informado |
| FrontierCode 1.1 (código listo para fusionar) | 52.1% (Xhigh) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | no informado |
| GDPval-AA v2.1 (trabajo del conocimiento, Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (trabajo de largo horizonte, Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (con herramientas) | 64.5% | 54.9% | 67.7% | no informado |
| OSWorld 2.1 (uso del ordenador) | 80.1% | 57.0% | 81.8% | no informado |
| Chartography (lectura de gráficos) | 61.6% | 15.6% | 64.4% | 53.6% |
Varias cosas llaman la atención. Primero, el salto en Terminal-Bench de 10,3 % a 70,6 % es enorme, y en esa prueba Sonnet 5.5 supera a Opus 5.5. GDPval-AA, una prueba de trabajo real en 44 ocupaciones, lo deja a dos puntos Elo de Opus 5.5 y unos 400 por delante de Sonnet 5. Y frente a GPT-6 Sol, el rival que Anthropic eligió graficar, Sonnet 5.5 en su mejor nivel de esfuerzo lidera en cada fila donde el modelo de OpenAI tiene puntuación, y con esfuerzo High iguala el mejor resultado de GPT-6 Sol en FrontierCode por aproximadamente una quinta parte del coste por tarea.
Agradezco que Anthropic sea franca sobre el límite. El post de lanzamiento dice que "in our own testing, and in that of external testers, Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment". Los benchmarks tienden a premiar tareas con una respuesta correcta clara. Las decisiones abiertas, como decidir si un cliente enterprise enfadado necesita un reembolso, una disculpa o quizá una escalada, son justo donde el gasto extra en Opus sigue compensando. La comparación Opus 5.5 vs GPT-6 Sol profundiza en ese nivel superior.
Una nota más que merece la pena leer: las puntuaciones de FrontierCode bajan con esfuerzo Max (46.2%) frente a Xhigh (52.1%). La explicación de Anthropic es que con Max, Sonnet 5.5 dividía con más frecuencia la revisión de código entre subagentes, lo que provocaba timeouts o ediciones fuera del alcance de la tarea. Pensar más no siempre es mejor, un patrón que también vio la guía de esfuerzo de Opus 5.
Qué significa Sonnet 5.5 para los equipos de soporte
Si tuviera que poner una sola cita del post de lanzamiento delante de cualquier responsable de soporte, sería esta. El Director of AI de Zendesk probó el modelo con tickets reales:
"We fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions and resolved tickets faster than the Claude models we use in production today. Tickets were processed 20% faster, getting our customers the help they need without the wait."
Abhinay Kathuria, Director of AI en Zendesk, en el anuncio de Anthropic
"Fewer wrong decisions" es la parte que importa aquí. La velocidad está bien, pero en una cola de soporte una respuesta rápida y errónea cuesta más que una lenta y correcta: crea un segundo ticket y un seguimiento airado, y a veces un reembolso encima. Zendesk AI ya ejecuta modelos de Claude en producción, así que cuando afirma mejores decisiones de escalada frente a su configuración actual, pesa de verdad. Atlassian hizo un comentario relacionado sobre la escala, diciendo que los equipos ejecutarán sus agentes de Rovo "up to 30% faster than they could with Sonnet 5", y Slack AI ya lo está probando para Slackbot.
Visto desde la cola, así es como asignaría la gama de Claude a las tareas de soporte:
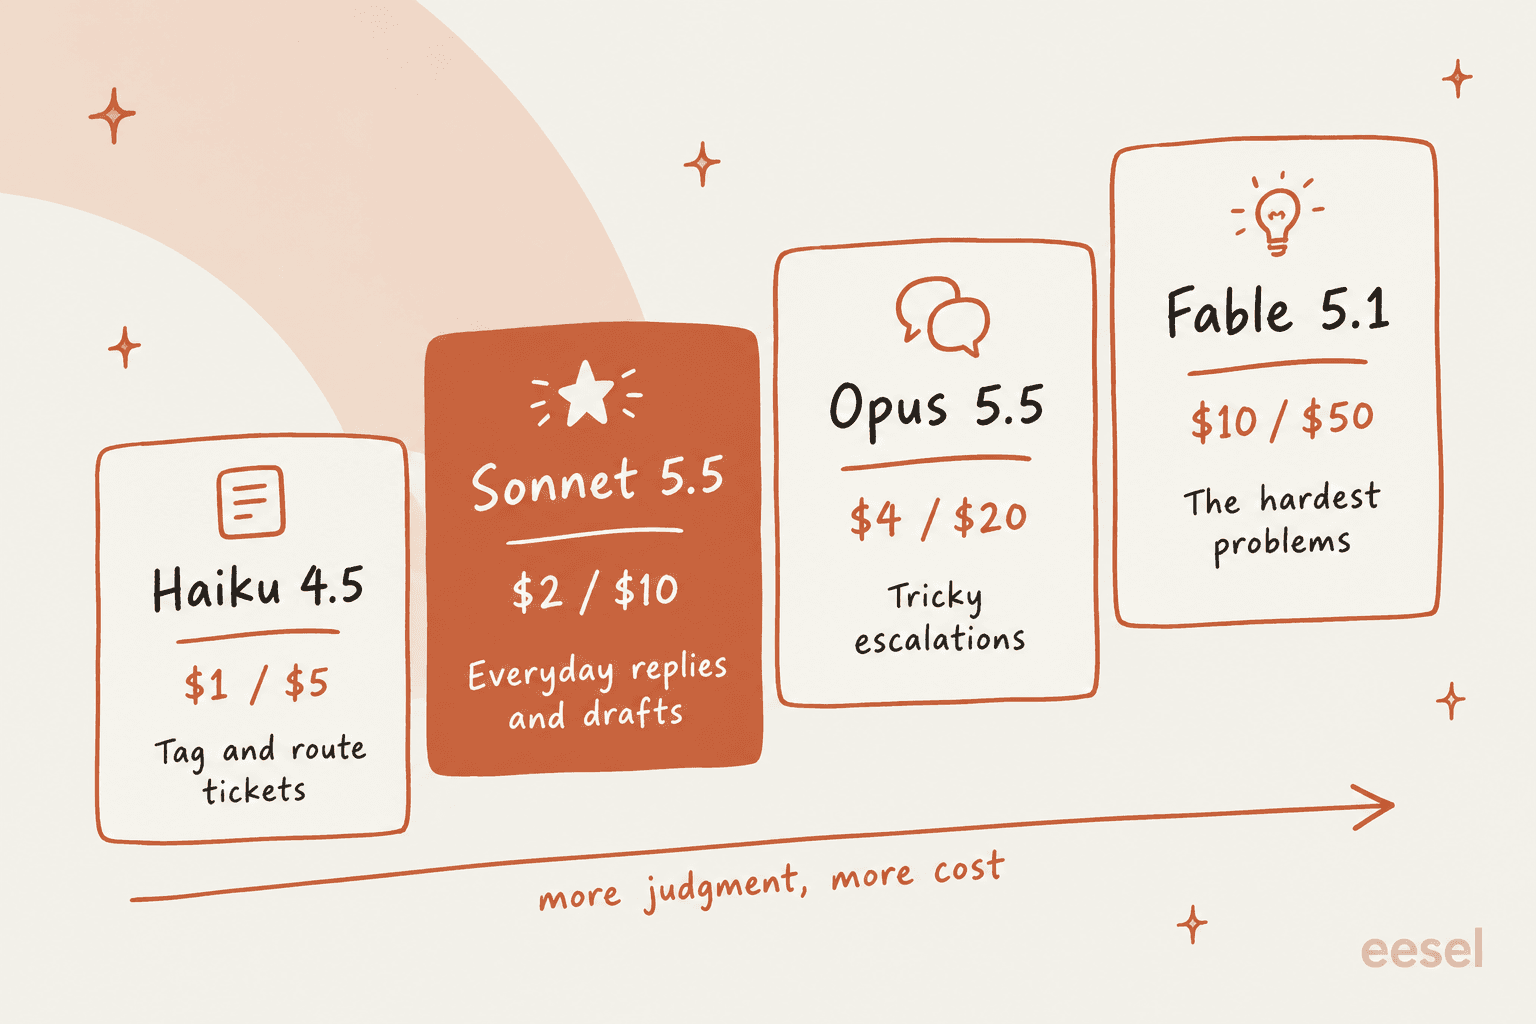
Sonnet 5.5 es el valor por defecto natural para la mayor parte de una cola: preguntas sobre pedidos, respuestas de cómo hacer algo, consultas de políticas y primeros borradores para que un agente los apruebe. Haiku sigue siendo la opción barata para la clasificación de tickets y el etiquetado. Opus 5.5 es donde mandaría los tickets que necesitan criterio, que son los que tus agentes sénior atenderían de todos modos. Donde más importa la mejora de velocidad de más del 30 % es en el chat en vivo, porque ahí hay un cliente mirando el indicador de escritura.
La salvedad honesta: un modelo mejor no arregla una respuesta que falta. He visto a un bot de soporte decirle con toda seguridad a un cliente que un producto era compatible porque el centro de ayuda decía "we support all models", y he visto a otro inventar respuestas cuando la recuperación no devolvía nada. Ninguno de esos casos era un problema de calidad del modelo. Ambos eran problemas de fundamentación, y un modelo más listo puede hacer que una respuesta errónea y segura suene aún más convincente. Por eso eesel simula cada despliegue con tickets históricos antes de que una IA responda a nadie, sea cual sea el modelo que haya debajo.
Antes de migrar: cinco cosas que ahora devuelven errores
La mayor parte de la cobertura del lanzamiento se saltará esta sección, y es la que de verdad se te comerá la tarde. Cambiar claude-sonnet-5 por claude-sonnet-5-5 es una línea. Detrás, la página de novedades enumera cinco cambios que rompen la compatibilidad, y hay una regla más que pertenece a la misma lista de comprobación.
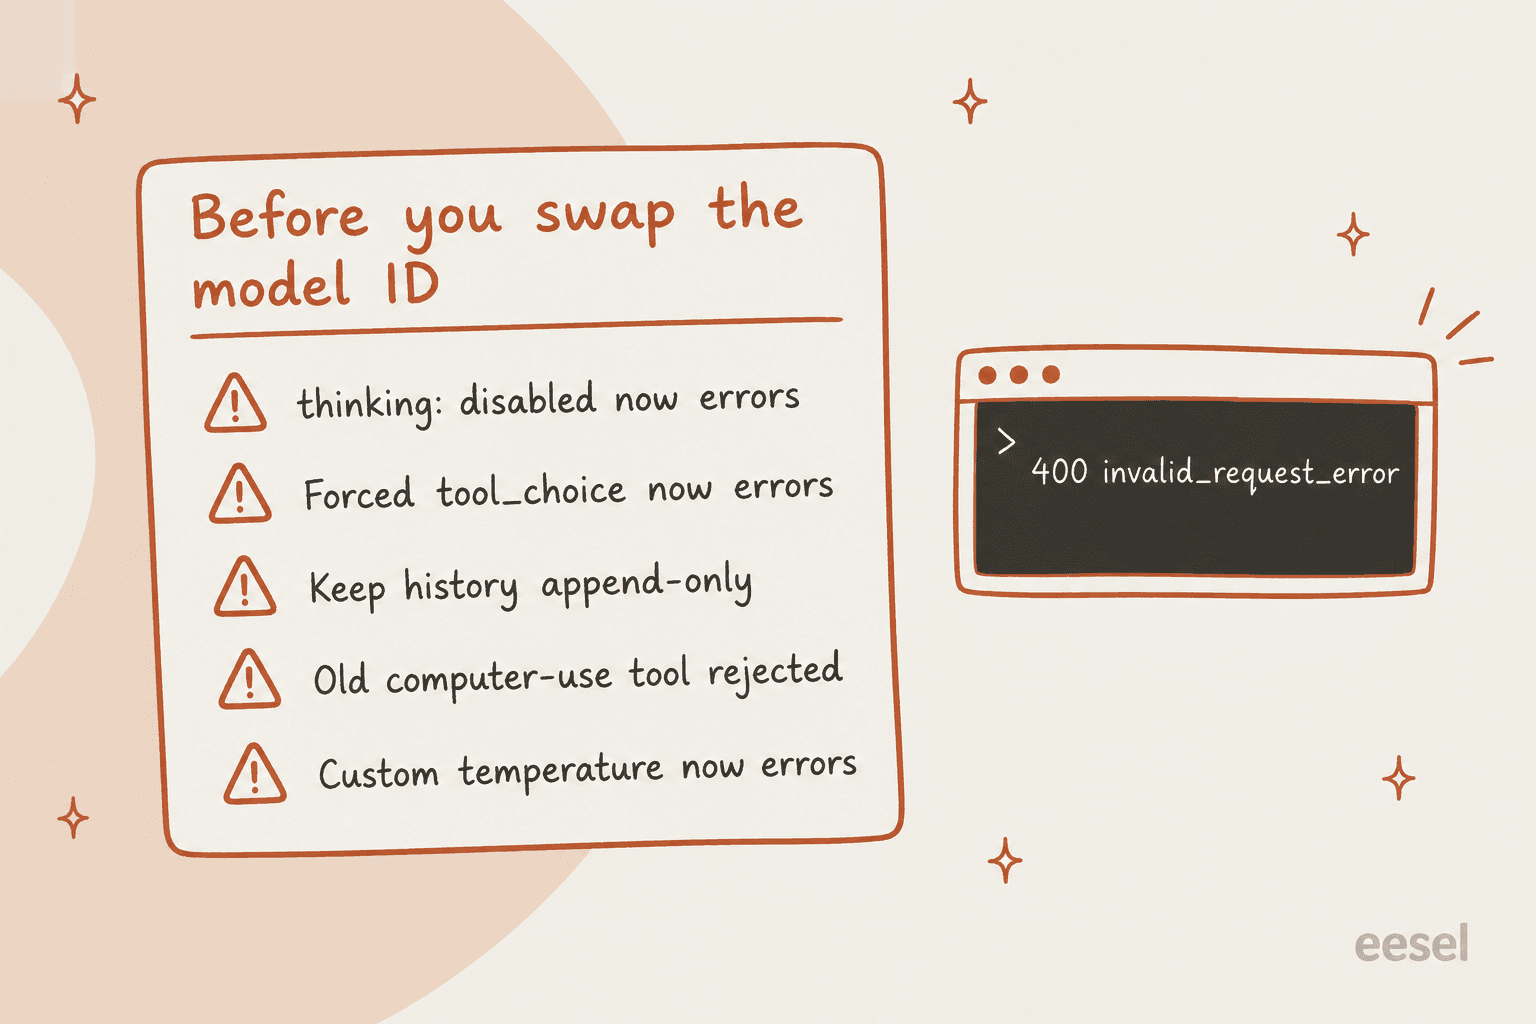
thinking: disableddevuelve un 400. Envía en su lugarthinking: {"type": "between_tools"}, que desactiva el thinking inicial. Solo funciona con esfuerzohigho inferior; conxhighomaxtambién da error.- El uso forzado de herramientas ha desaparecido.
tool_choiceconfigurado enanyo en unatoolcon nombre devuelve un error. La solución esautomás uso estricto de herramientas. - Los bloques de thinking están ligados al modelo y a la cuenta. Si editas mensajes anteriores, el prompt del sistema o las herramientas y luego reproduces un bloque de thinking de Sonnet 5.5, las cuentas más nuevas reciben un 400. Así que mantén las conversaciones en modo solo-añadir.
- La antigua herramienta
computer_20251124se rechaza en la Claude API y en Google Cloud. Bedrock todavía la acepta. - Se rechazan algunas combinaciones con advisor. Opus 4.8, Opus 4.7 y Sonnet 5 ya no pueden asesorar a un ejecutor Sonnet 5.5.
Sobre esa regla adicional, la documentación señala que configurar temperature, top_p o top_k con un valor no predeterminado devuelve un 400 en este modelo.
La trampa del soporte es la número dos. Muchos bots de helpdesk fuerzan una llamada a herramienta para garantizar una salida estructurada: "always call classify_ticket", "always call draft_reply". En Sonnet 5.5, esa petición simplemente falla. Si construiste tu propia integración sobre la API de Anthropic, busca tool_choice con grep primero, antes de tocar el ID del modelo.
También hay un cambio más discreto, que no da error pero igualmente confundirá a los usuarios. El texto que el modelo escribe entre llamadas a herramientas ahora vuelve dentro de bloques thinking, y con el valor por defecto display: "omitted" ese texto está vacío. Si tu widget de chat muestra "Checking your order status..." mientras trabaja el agente, se quedará mudo hasta que definas un valor de display. Anthropic también ha recalibrado los niveles de esfuerzo, así que vuelve a ejecutar tus pruebas de esfuerzo en lugar de arrastrar los ajustes de Sonnet 5. La guía de traspaso de agentes de IA merece una lectura si un cambio de modelo altera cuándo escala tu bot.
Lo último es la seguridad. Sonnet 5.5 es el primer Sonnet que sale con salvaguardas de ciberseguridad, porque sus capacidades cibernéticas son comparables a las de Opus 5. Las solicitudes de ciberseguridad de mayor riesgo "visibly fall back to Sonnet 5", y una solicitud rechazada devuelve HTTP 200 con stop_reason: "refusal". Para un bot de soporte esto rara vez se activará. Pero si atiendes a clientes de seguridad o TI, conviene manejar el caso de rechazo en lugar de mostrar una respuesta en blanco.
Precio y acceso de Claude Sonnet 5.5
Esta es la tarifa completa de la documentación de precios de Anthropic, por millón de tokens:
| Precio por 1M de tokens | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | Claude Haiku 4.5 |
|---|---|---|---|---|
| Entrada | $2 | $2 | $4 | $1 |
| Salida | $10 | $10 | $20 | $5 |
| Escritura en caché de 5 minutos | $2.50 | $2.50 | $5 | $1.25 |
| Escritura en caché de 1 hora | $4 | $4 | $8 | $2 |
| Lectura de caché | $0.20 | $0.20 | $0.20 | $0.10 |
| Entrada / salida en Batch | $1 / $5 | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Ventana de contexto | 1M | 1M | 1M | 200K |
Un par de notas sobre esa tabla. El thinking se factura como tokens de salida, así que una ejecución con esfuerzo high paga 10 $ por millón también por su razonamiento. Y el prompt mínimo cacheable ahora es de 512 tokens, según el resumen del modelo, lo que facilita cachear un prompt de sistema de soporte estable.
Para poner estas tarifas en términos de soporte, aquí va un cálculo ilustrativo que usa solo precios publicados. Digamos que una respuesta a un ticket envía 6.000 tokens de entrada (el ticket más los artículos de ayuda recuperados) y recibe 800 tokens de salida. Son 0,012 $ de entrada y 0,008 $ de salida, o unos 2 céntimos por ticket. Si 5.000 de esos tokens de entrada son un prompt de sistema en caché, el lado de la entrada baja a unos 0,003 $ y la respuesta completa queda cerca de 1,1 céntimos. Con 10.000 tickets al mes, eso son unos 200 $ sin caché frente a 110 $ con caché, antes de los tokens de thinking. Tus propias cifras variarán según el esfuerzo y el tamaño de la recuperación, pero muestra por qué la línea del modelo en la factura rara vez es el gran coste de un agente de soporte con IA.
Aquí puedes usarlo:
- La Claude API, como
claude-sonnet-5-5, con prompt caching y la Batch API. Hay disponible retención cero de datos. - Apps de Claude. Anthropic dice "anyone can chat with Claude using Sonnet 5.5 on Claude.ai" en web, iOS y Android. Los planes de pago se explican en la guía de precios de Claude Pro.
- Claude Code, donde el esfuerzo por defecto es Medium. La guía de precios de Claude Code cubre las cuentas de suscripción frente a API, y fijar un modelo requiere un solo ajuste.
- Las nubes: Amazon Bedrock, Google Cloud, Microsoft Foundry y Claude Platform on AWS, todas desde el primer día.
Si lo que estás sopesando son proveedores más que niveles, la comparación de tres APIs y el desglose de precios de GPT-6 Sol son las comprobaciones más rápidas.
Qué dicen los desarrolladores
El hilo del lanzamiento en Hacker News superó los 550 comentarios en un día, y la reacción se divide bastante claro. A la gente le gusta la velocidad y respeta los benchmarks, mientras que las críticas tratan sobre todo de dónde encaja junto a Opus 5.5.
"Playing around with it for a few minutes, Sonnet 5.5 feels very fast, much quicker than Opus 5.5. Can't tell yet if it's a lot worse but the speed is definitely welcome."

La crítica más afilada tiene que ver con los niveles altos de esfuerzo. Simon Willison midió su prueba habitual de SVG en cada nivel de esfuerzo y encontró que low costaba 1,6 céntimos, medium 1,8 céntimos y high 2,3 céntimos, pero max se gastó todo su presupuesto de thinking:
"Sonnet 5.5 has the same problem as Opus 5.5: on "max" thinking effort it burned through 128,000 thinking tokens (taking 15 minutes to do that) and ran out before it had produced the final SVG."
Un usuario de Reddit sacó el mismo patrón de Artificial Analysis, informando de que "sonnet 5.5 max has a cost per task of $7.60 while opus 5.5 max has $5.98", con Sonnet usando 193k tokens por tarea frente a los 119k de Opus (u/ex-procrastinator, Reddit). Otro comentarista resumió lo que sugieren las gráficas:
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost."
Anthropic dice algo muy parecido en su propio post de lanzamiento: Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings", y "at higher settings, it can perform comparably at a similar cost". Así que la conclusión práctica, y lo que le diría a cualquier equipo que esté cambiando, es esta: ejecuta Sonnet 5.5 con esfuerzo Low o Medium, donde realmente está el ahorro. La API usa high por defecto, así que la versión barata de este modelo es una que tienes que pedir. Las respuestas de soporte son justo el tipo de trabajo bien acotado que Medium maneja bien.
Hay una regresión que conviene conocer. Un desarrollador que ejecuta un benchmark adversarial encontró que Sonnet 5.5 puntuaba menos que Sonnet 5 "mainly because it is more reluctant to keep going to get an answer, instead it returns to ask the user questions" (dom96, Hacker News). Para un agente de programación eso es molesto, pero para un bot de soporte, parar a preguntar en vez de adivinar suele ser justo lo que quieres.
Un modelo más rápido sigue necesitando un compañero a su alrededor
Cada lanzamiento de modelo provoca la misma conversación con clientes técnicos: esto ya es barato y suficientemente bueno, así que ¿por qué no construir nuestro propio bot de soporte sobre la API en bruto? Es una pregunta razonable, y Sonnet 5.5 hace que la mitad del modelo sea más fácil que nunca.
Lo que la tarifa no cuenta es todo lo que rodea al modelo. Sonnet 5.5 es un motor magnífico. No es un agente de soporte hasta que alguien construye la recuperación sobre tu centro de ayuda y tus tickets anteriores, además de las reglas de escalada y el manejo de rechazos, el ajuste del esfuerzo y ahora también el trabajo de migración por cinco cambios que rompen la compatibilidad. El modelo es la infraestructura, y el empleado es lo que construyes encima.
eesel vende esa parte ya construida. Su compañero de helpdesk con IA se une a tu cola existente en Zendesk, Freshdesk, Gorgias y más. Aprende de tus tickets anteriores y de tu centro de ayuda, y luego redacta o envía respuestas, con un modelo de frontera debajo. Cuando Anthropic lanza un modelo como este, el cambio y los cambios que rompen la compatibilidad son problema de eesel, no tuyo.

Si quieres control programático, eesel tiene una CLI que opera el mismo compañero y espacio de trabajo que el panel. Puedes manejarla desde una terminal o automatizarla con scripts, y también puedes dejar que la ejecute un agente de programación como Claude Code, de modo que obtienes el flujo de trabajo agéntico que la gente construye sobre modelos en bruto sin ser dueño de la pila de fundamentación y reintentos. Mis artículos sobre la CLI de agentes de IA y los servidores MCP muestran cómo encaja todo.
El precio funciona con créditos mensuales fijos: un ticket o chat gestionado es un crédito, el plan gratuito incluye 100 créditos sin tarjeta, y los planes de pago empiezan en 299 $ por 500. Puedes simular el compañero con tus propios tickets históricos antes de que responda a un solo cliente. Prueba eesel gratis en tu cola de Zendesk y comprueba la mejora de velocidad de clase Sonnet en tickets cuyas respuestas ya conoces.
¿Vale la pena Claude Sonnet 5.5?
Si hoy usas Sonnet 5, sí, y es una de las actualizaciones más fáciles que ha lanzado Anthropic. Pagas la misma tarifa por un modelo que puntúa mucho más alto y termina con menos tokens, y además corre más rápido. El único coste real es el trabajo de migración, y es una lista conocida de cinco puntos, no un misterio.
Si usas Opus 5.5 para el trabajo cotidiano, prueba Sonnet 5.5 con tu propio tráfico y esfuerzo Medium antes de renovar ese hábito. Para tareas bien acotadas, la brecha de benchmarks es de un par de puntos y la diferencia de precio por token es de 2x. Una vez que pasas de esfuerzo high, esa ventaja desaparece, así que si una tarea necesita razonamiento máximo, mándala a Opus. Reserva Opus para las decisiones abiertas de criterio donde la propia Anthropic dice que sigue siendo claramente más fuerte. Un comentarista de Hacker News describió un patrón, "80% Sonnet 5.5, Opus 5.5 to finish the last 20%", y es también una forma sensata de repartir una cola. Para el resto del panorama, mi reseña de Sonnet 5 y el resumen de alternativas a Opus 5.5 son las siguientes lecturas.
Preguntas frecuentes
¿Qué es Claude Sonnet 5.5?
¿Cuánto cuesta Claude Sonnet 5.5?
¿Es Claude Sonnet 5.5 más barato que Sonnet 5?
¿Es Claude Sonnet 5.5 mejor que Opus 5.5?
¿Es Claude Sonnet 5.5 bueno para atención al cliente?
¿Qué se rompe al pasar de Sonnet 5 a Sonnet 5.5?
¿Puedo usar Claude Sonnet 5.5 en Claude Code?
¿Cuáles son las mejores alternativas a Claude Sonnet 5.5?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.