Mi veredicto de un vistazo
El día después del lanzamiento lo dediqué a leer el anuncio de Anthropic y la documentación del modelo, luego la guía de migración, y también el hilo de lanzamiento en Hacker News de unos 550 comentarios. Mi trabajo es construir agentes de IA para el compañero de helpdesk de eesel, así que revisé todo con una pregunta en mente: ¿pondría este modelo mañana bajo una cola de soporte real?
Aquí va la versión corta, puntuada según lo que importa cuando lo pones en producción:
| Qué comprobé | Nota | Por qué |
|---|---|---|
| Calidad de código | 9/10 | 70,6 % en Terminal-Bench 4.0, por encima de Opus 5.5 |
| Trabajo de conocimiento | 8/10 | GDPval-AA 1844, dos puntos por debajo del 1846 de Opus 5.5 |
| Eficiencia de tokens | 9/10 en Low/Medium, 4/10 en Max | ~121k frente a 497k tokens por respuesta en Balyasny, pero 193k por tarea en Max |
| Velocidad | 8/10 | Salida un 30 %+ más rápida que Sonnet 5 |
| Dolor de migración | 5/10 | Cinco cambios incompatibles, uno de ellos muy molesto para bots de soporte |
| Encaje en soporte | 8/10 | Zendesk vio tickets procesados un 20 % más rápido |
| Global | 8/10 | La mejor relación calidad-precio de la gama, con un ajuste caro que evitar |
Una nota rápida sobre el método, para que quede claro en qué se apoyan estas notas. No hice una prueba de meses en producción, ya que el modelo tiene solo un día. Las notas se construyen con las cifras publicadas por Anthropic y los resultados de clientes con nombre en el anuncio de lanzamiento, más ejecuciones de benchmarks independientes que la gente publicó, y mi propia lectura de la documentación de la API frente a cómo eesel conecta modelos en los flujos de tickets. Cuando una cifra viene de Anthropic, lo digo.
Qué es Claude Sonnet 5.5
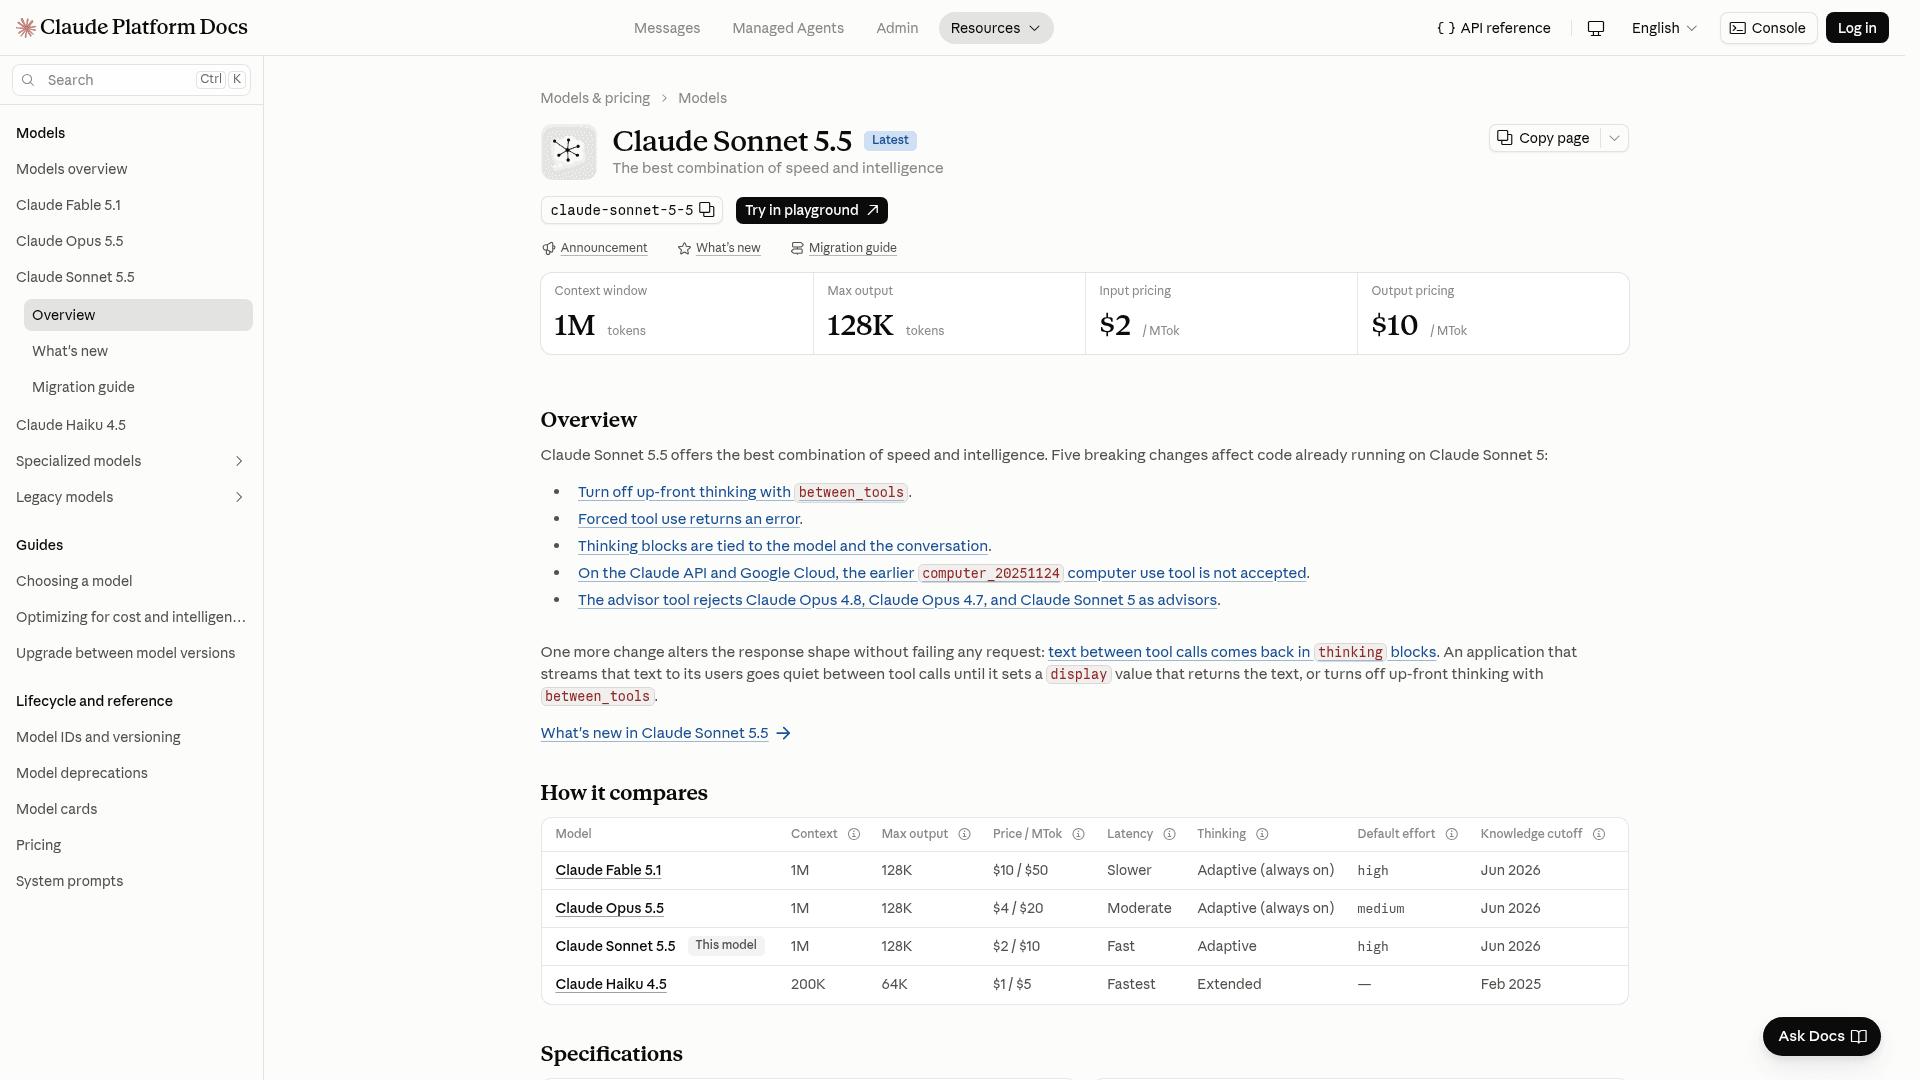
Claude Sonnet 5.5 es el modelo de gama media de la familia Claude 5.5 de Anthropic, lanzado el 28 de septiembre de 2026. Se sitúa por debajo de Claude Opus 5.5 y por encima de Haiku 4.5, mientras que Claude Fable 5.1 ocupa lo más alto de la gama. Anthropic lo presenta como "a faster, lower-cost complement" de Opus, más fuerte en "well-scoped everyday tasks, fixing bugs, and creating polished documents, slides, and spreadsheets."
En cuanto a especificaciones, la descripción del modelo indica una ventana de contexto de 1M de tokens y 128K de salida máxima (300K en Batch), con fecha de corte de conocimiento de junio de 2026 y el mismo tokenizador que Claude Sonnet 5. Para el recorrido completo del lanzamiento, el resumen de Sonnet 5.5 de mi colega lo cubre bien. Esta entrada es más bien el veredicto.
Dónde destaca Claude Sonnet 5.5
Tres cosas sobresalieron en los datos del lanzamiento, y las tres aparecen en resultados de clientes con nombre, no solo en los gráficos de Anthropic.
Programa como un modelo Opus
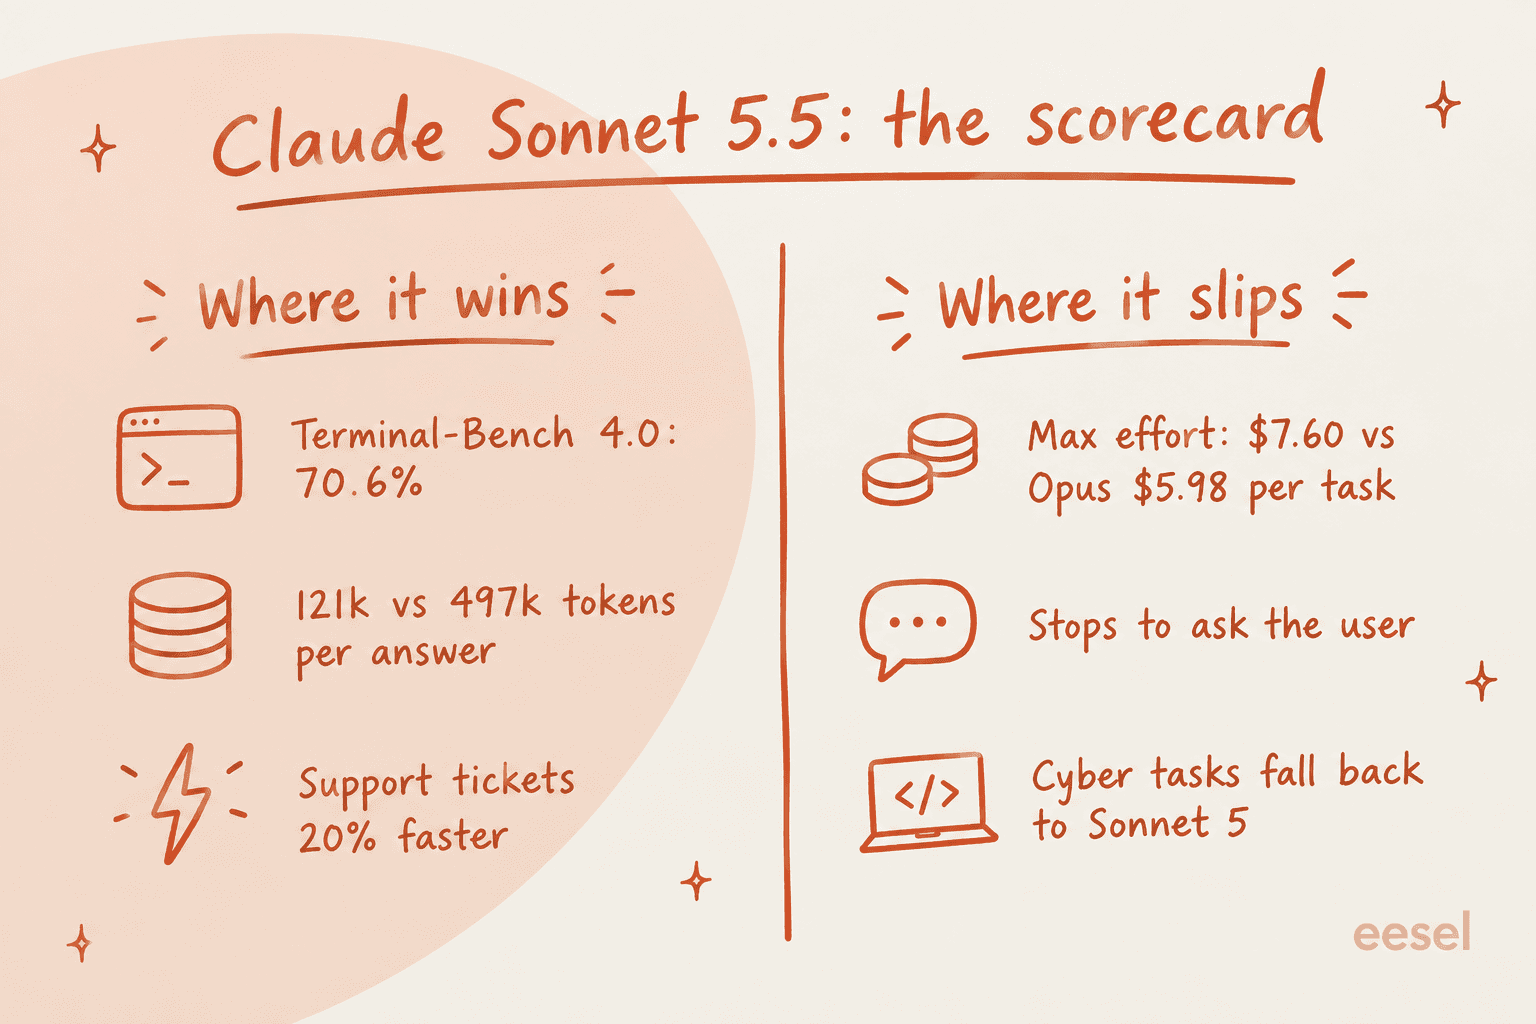
La cifra principal es Terminal-Bench 4.0, una prueba de programación agéntica que se ejecuta en línea de comandos. Sonnet 5 obtuvo 10,3 % y Sonnet 5.5 obtiene 70,6 %, por encima del 66,4 % de Opus 5.5. No es una errata. Es el mayor salto entre generaciones que he visto en un modelo Sonnet hasta ahora.
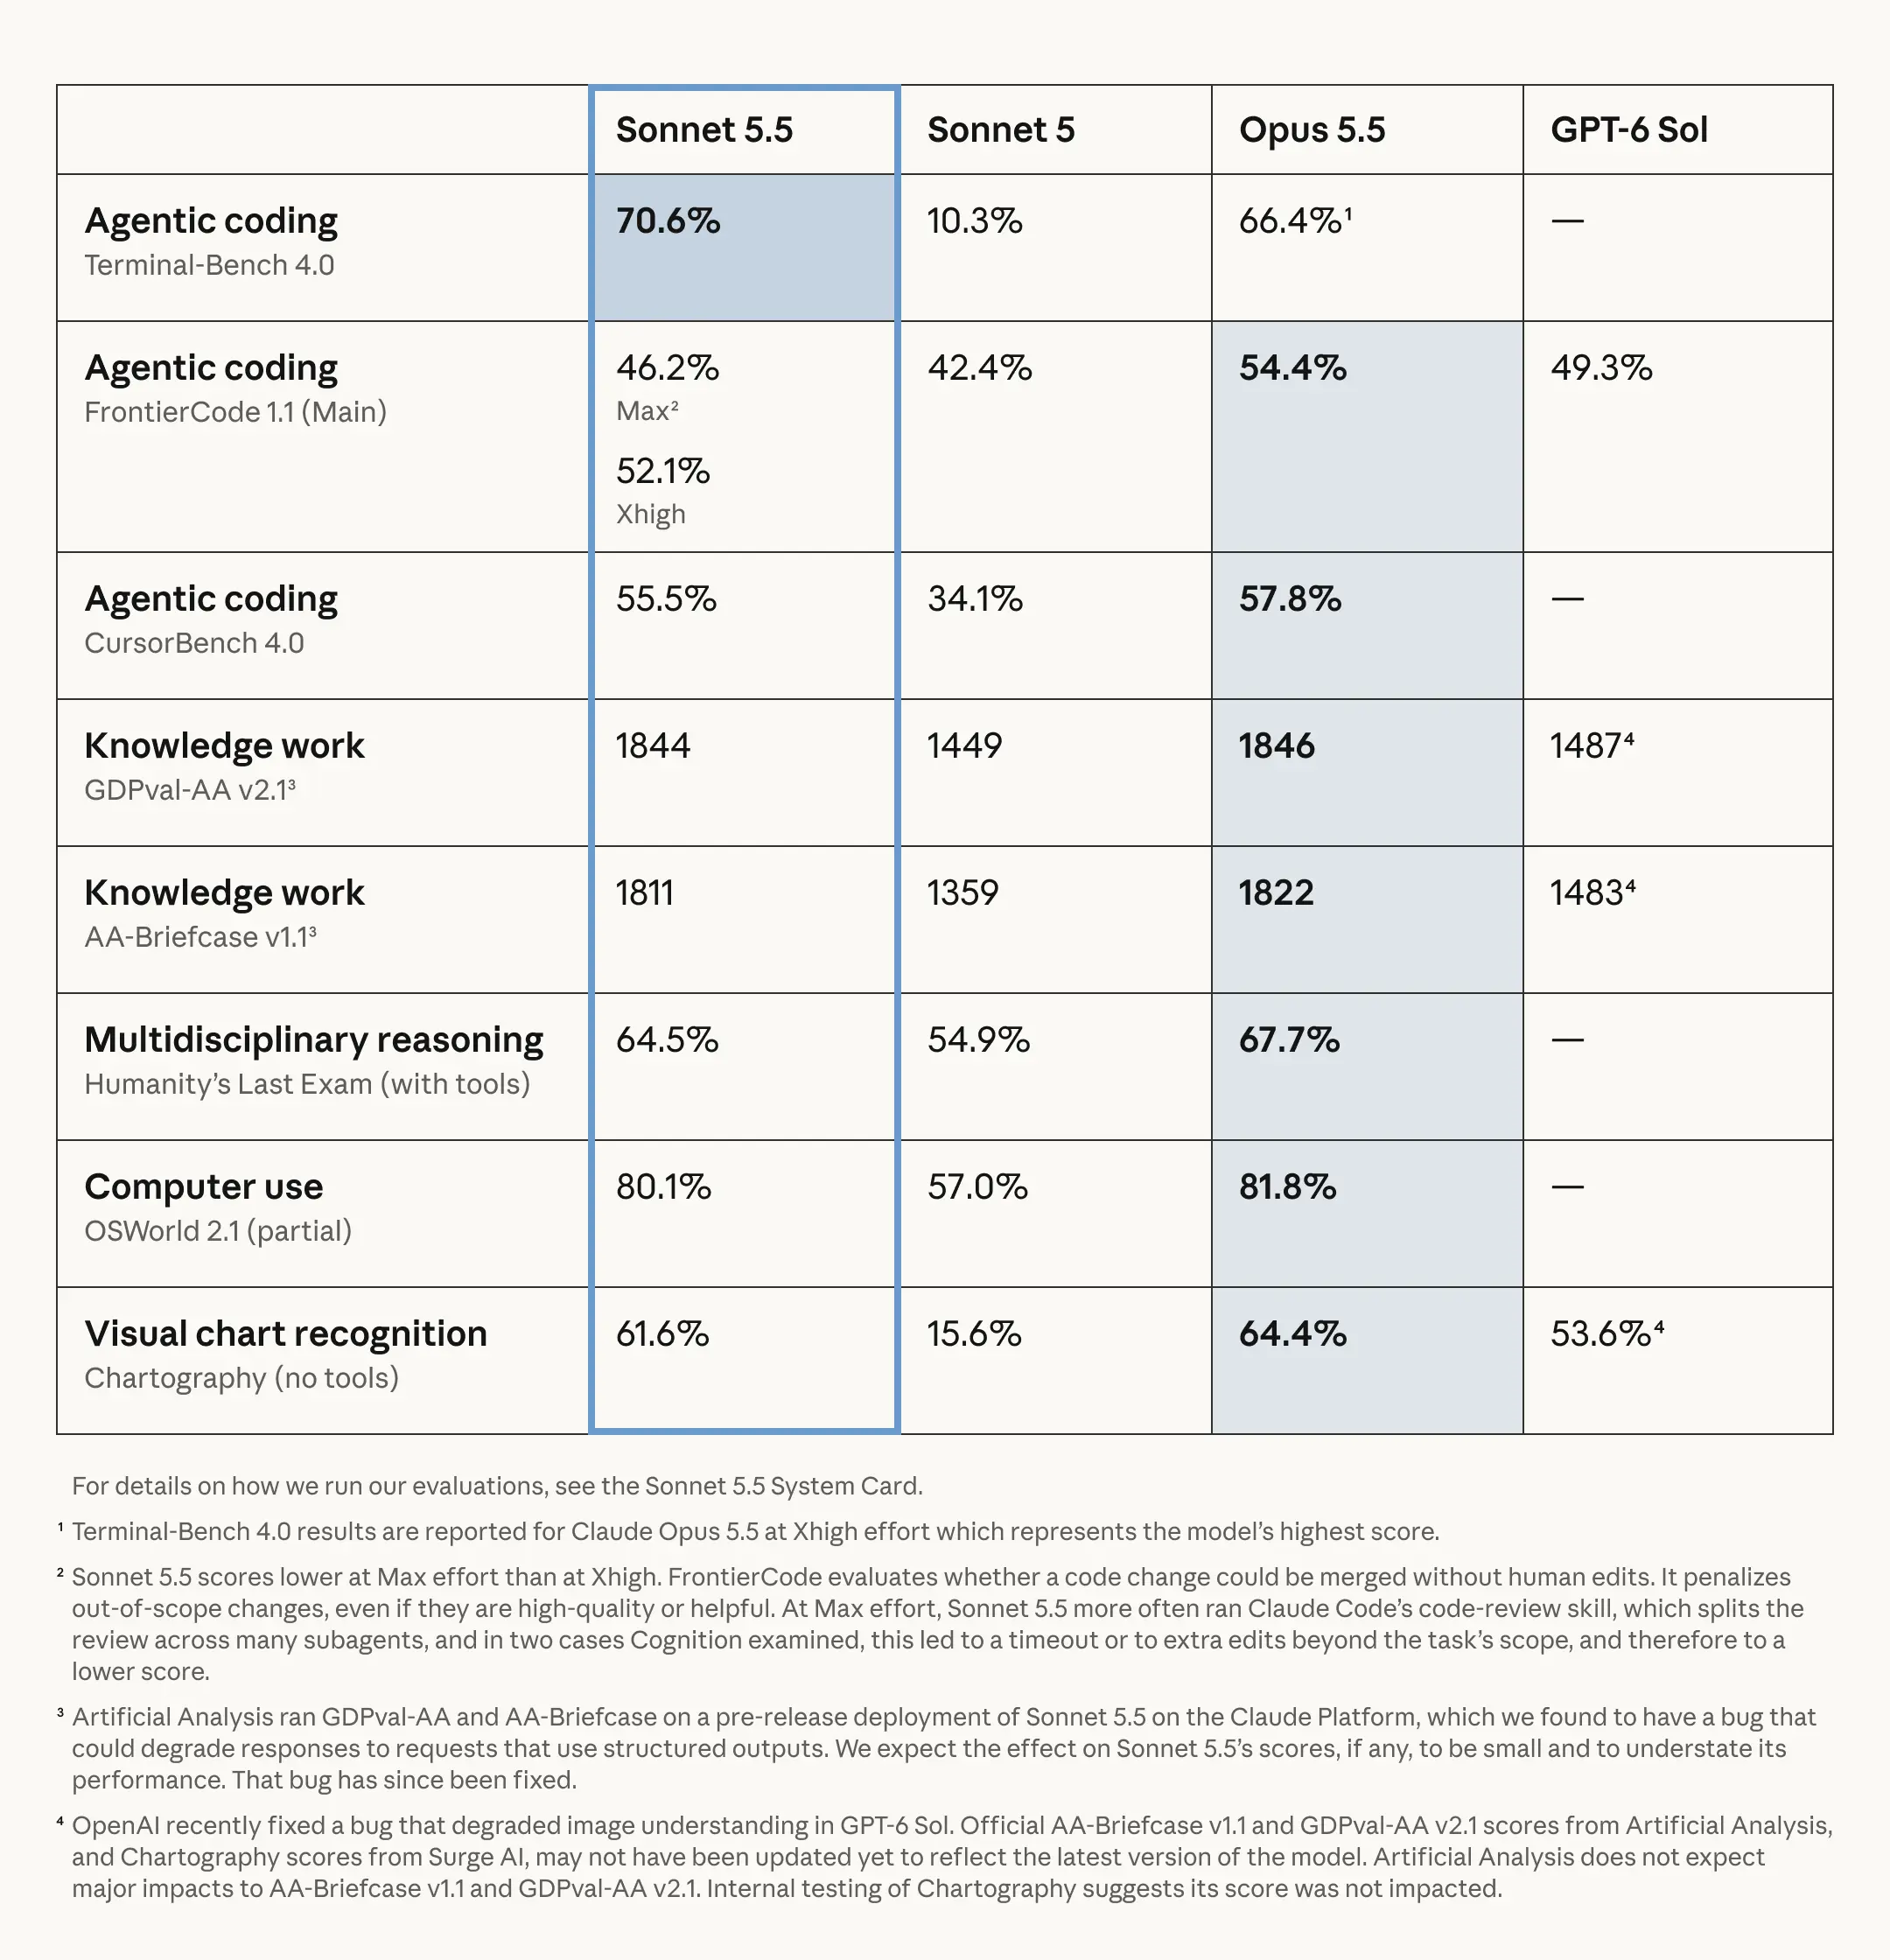
En las otras pruebas de código queda un poco por detrás de Opus: CursorBench 4.0 es 55,5 % frente a 57,8 %, y FrontierCode es 52,1 % en Xhigh frente a 54,4 %. Para un modelo a la mitad de precio por token, una diferencia de dos puntos es sinceramente una ganga. Por eso mismo, en el debate Opus vs Sonnet la gente dejó en su mayoría de discutir la calidad y pasó a discutir el coste.
Las cifras de clientes también lo respaldan. Base44 dijo que en 118 construcciones de apps reales, Sonnet 5.5 "produced apps that scored level with Opus 5" en 3,6 iteraciones por build, donde Opus 5 necesitó 7,7. Unity afirma que completó el 90 % de las tareas en su benchmark de editor de varios pasos. Y si programas en Claude Code, este es ahora el modelo que verás por defecto en esfuerzo Medium.
Llega con muchos menos tokens
El precio por token no cambió; lo que cambió es el número de tokens. Balyasny Asset Management ejecutó 2.441 tareas financieras y encontró que Sonnet 5.5 usó unos 121k tokens por respuesta, donde Sonnet 5 usó 497k. En sus evaluaciones de Slackbot, Slack vio un 14 % menos de tokens de salida sin cambios de prompt, y Lovable, por su parte, reportó un tercio menos de llamadas a herramientas.
La propia demo de Anthropic apunta a lo mismo. Con un prompt de "wind shaping sand dunes", Sonnet 5 seguía escribiendo código cuando Sonnet 5.5 ya tenía una animación funcionando:
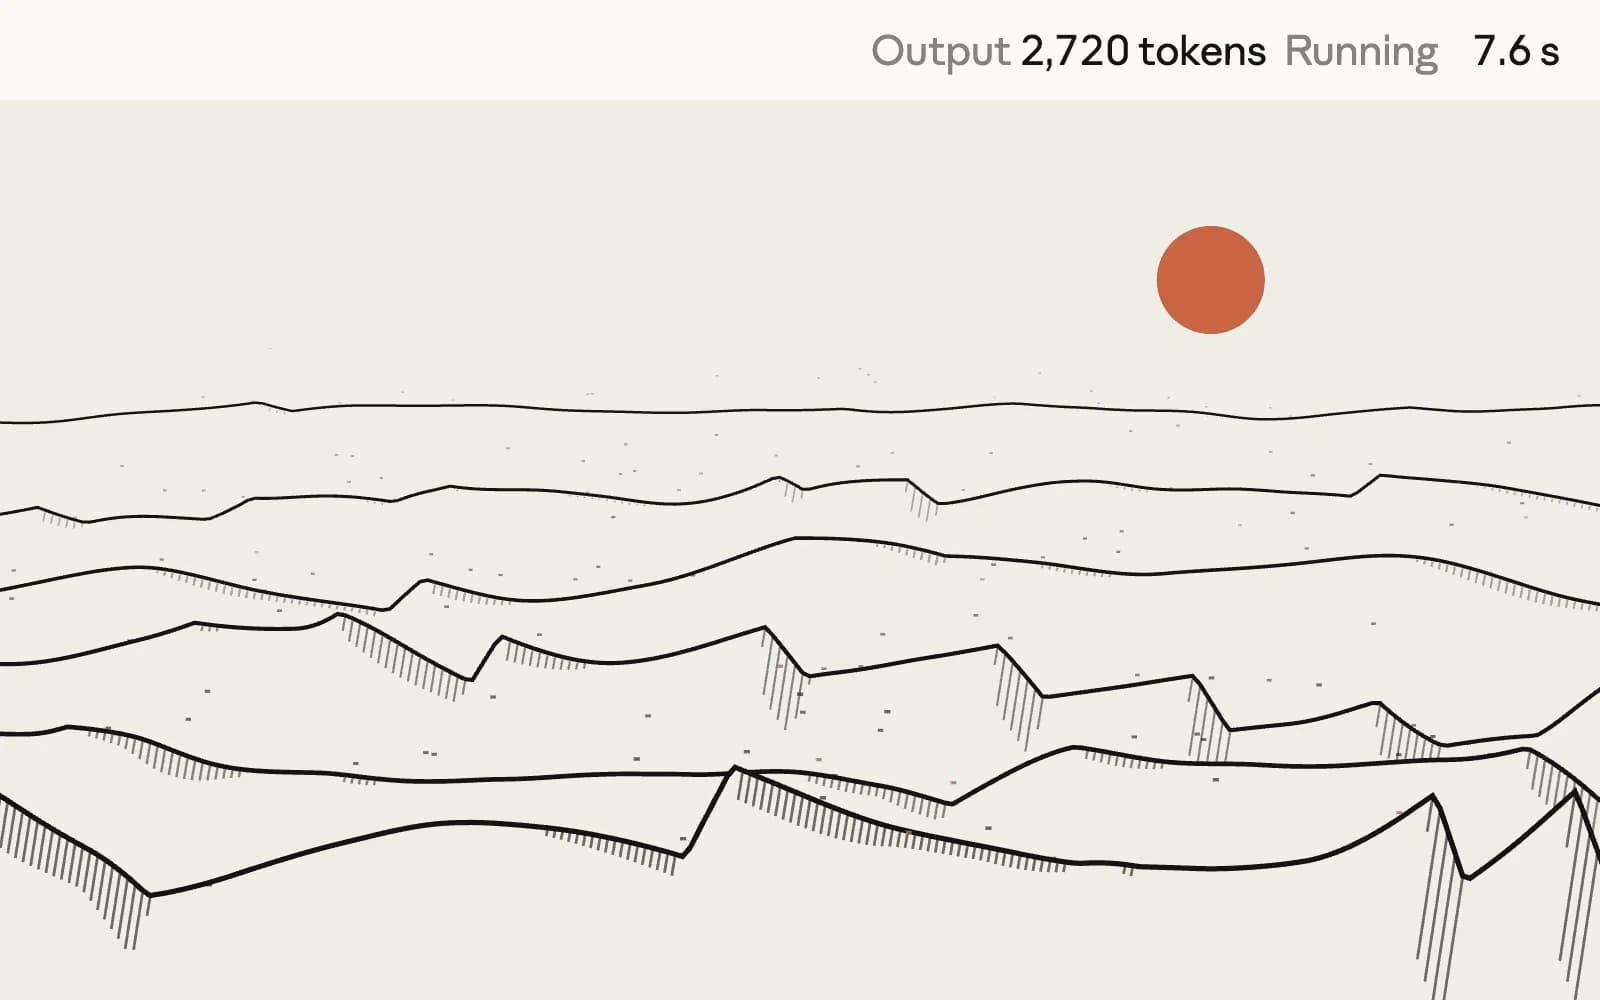
Esa eficiencia es en realidad el producto. Según Anthropic, el resultado es "up to 30% less per task" que Sonnet 5. Con los equipos con los que hablo, menos tokens también significa menos segundos de espera del cliente por una respuesta, y eso les importa más que la factura.
Maneja bien los tickets de soporte
Esta es la parte que más me importa. El Director of AI de Zendesk dijo en el anuncio de lanzamiento que "fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions," y los tickets se procesaron un 20 % más rápido. Por el lado de Atlassian, la empresa dice que los agentes Rovo funcionarán hasta un 30 % más rápido que con Sonnet 5.
Para trabajo al estilo Zendesk AI, esas dos son las cifras que deciden si un modelo es bueno: menos decisiones erróneas de escalado y menos espera. Ambas se movieron en la dirección correcta.
Dónde se queda corto Claude Sonnet 5.5
Los puntos débiles son más acotados de lo que sugieren los escépticos, pero uno de ellos cambia cómo deberías ejecutar el modelo.
El esfuerzo Max cuesta más que Opus
Este es el hallazgo que cambió mi veredicto. El propio anuncio de Anthropic admite que Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings" y que "at higher settings, it can perform comparably at a similar cost." Las ejecuciones independientes van un paso más allá.
En Artificial Analysis, como señaló un usuario de Reddit, Sonnet 5.5 en Max cuesta 7,60 $ por tarea frente a 5,98 $ de Opus 5.5 en Max, porque usó 193k tokens por tarea donde Opus usó 119k. Simon Willison ejecutó el día del lanzamiento el mismo prompt de SVG en todos los niveles de esfuerzo. Low costó 1,6 centavos y tardó 10 segundos. Max costó 1,28 $ y duró 15 minutos 40 segundos, gastando sus 128.000 tokens de pensamiento completos antes de fallar al producir la imagen.
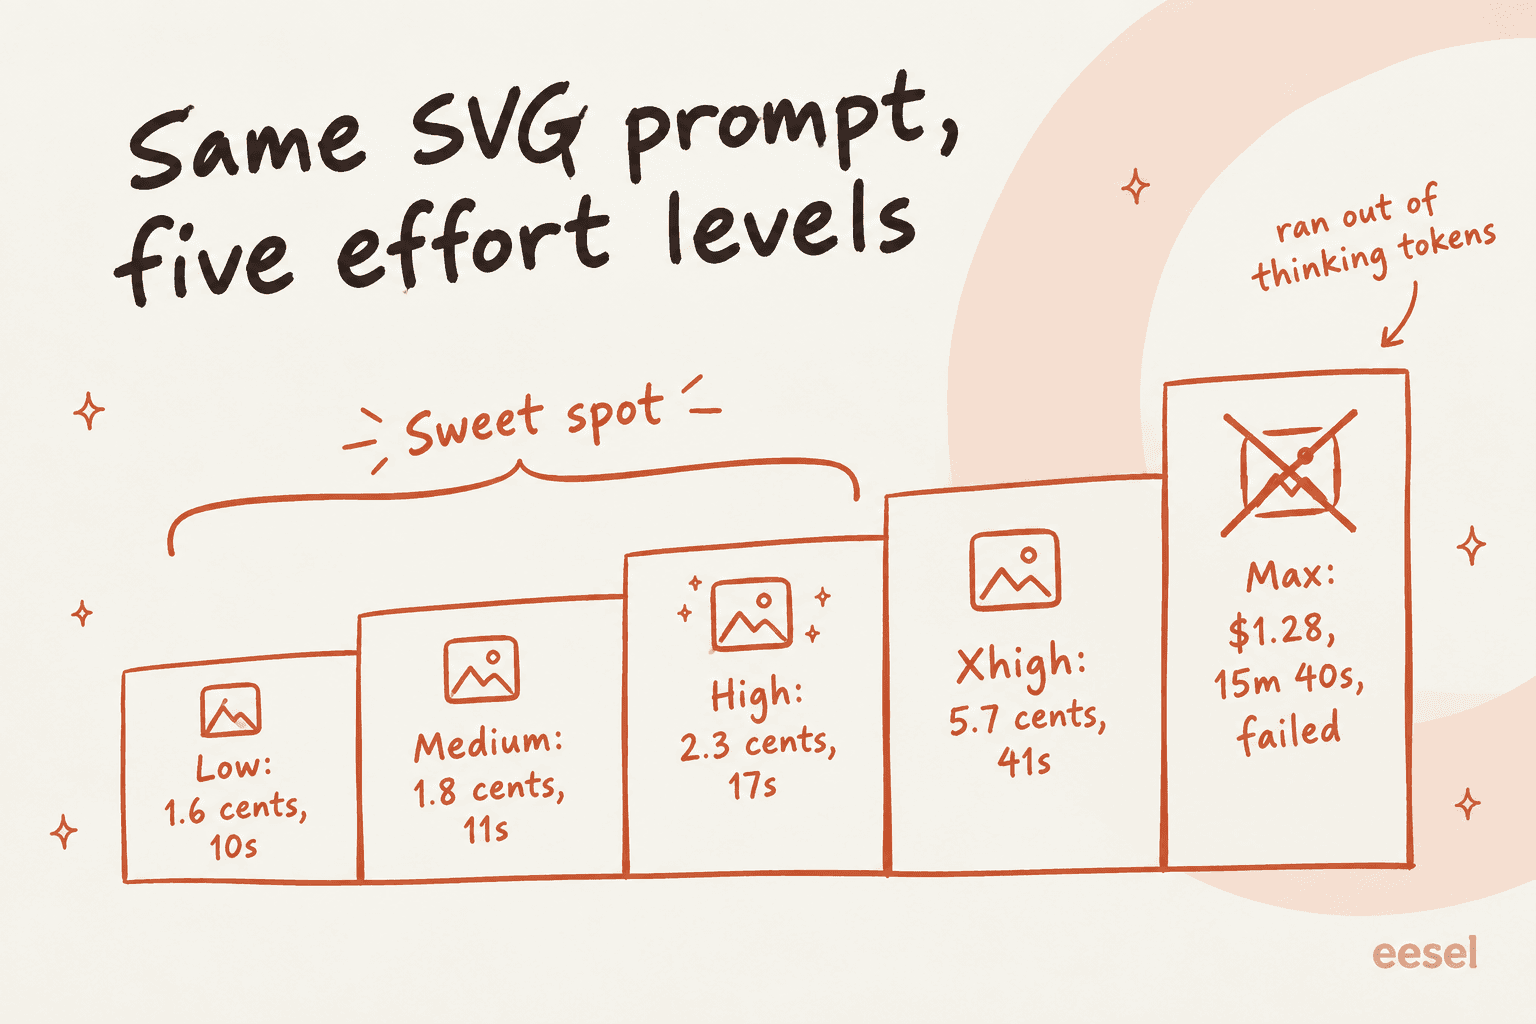
Incluso la nota al pie de FrontierCode de Anthropic tiene la misma forma. Sonnet 5.5 obtiene 52,1 % en Xhigh pero solo 46,2 % en Max, porque en Max "more often ran Claude Code's code-review skill", lo que provocó tiempos de espera agotados o ediciones fuera del alcance de la tarea. Pensar más, en este caso, empeoró el resultado.
Así que la regla es simple: trata Max como prohibido para Sonnet 5.5. Una tarea que necesita tanto razonamiento es una tarea para Opus 5.5, que llega con menos tokens.
Opus sigue siendo mejor en criterio abierto
Anthropic es bastante franca en este punto: "Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment." Los primeros informes de uso lo confirman.
"Tried Sonnet 5.5 but worse than OPUS for thinking for sure, less error/inconsistency check. I used Opus 5.5 med vs. Sonnet 5.5 High on hermes with the same agent.md, and soul.md"

Traducido a soporte, es el cliente empresarial enfadado con una disputa de facturación y tres tickets previos. Ese ticket no se lo daría a Sonnet 5.5 sin supervisión. El restablecimiento de contraseña, la consulta del estado de un pedido o la pregunta "¿cómo exporto mis datos" se las daría todo el día.
Se detiene a hacer preguntas
Hay un desarrollador que ejecuta un benchmark adversarial construido sobre un lenguaje de programación esotérico. En él, Sonnet 5.5 obtuvo 7,4 % frente al 17,8 % de Sonnet 5, y su explicación fue que "is more reluctant to keep going to get an answer, instead it returns to ask the user questions whether to keep going." Base44, en cambio, dijo que "rarely stopped mid-build to ask the user a question."
Mi lectura es que en trabajo interactivo, detenerse a comprobar suele ser lo que quieres de todos modos. En un pipeline desatendido es distinto: un modelo que se detiene a preguntar puede bloquear un trabajo toda la noche. Así que pruébalo en tu propio bucle de agente antes de confiar en él sin supervisión.
Salvaguardas de ciberseguridad y cinco cambios incompatibles
Sonnet 5.5 es el primer Sonnet que se lanza con salvaguardas de ciberseguridad como las de Opus 5.5, por lo que "higher-risk cybersecurity tasks will visibly fall back to Sonnet 5." La corrección rutinaria de bugs no se ve afectada. Aun así, el mayor subhilo de Hacker News fue de gente que hace trabajo de seguridad autorizado y que fue marcada de todos modos.
La guía de migración enumera cinco cambios incompatibles, cada uno de los cuales ahora devuelve un error 400:
| Cambio | Qué se rompe | Solución |
|---|---|---|
thinking: disabled | Solicitudes con el pensamiento totalmente apagado | Usar el nuevo ajuste between_tools |
tool_choice forzado (any o tool) | Bots que fuerzan una herramienta de clasificación | Dejar que el modelo elija y luego validar |
| Historial editado antes de un bloque de pensamiento | Apps que reescriben turnos pasados | Mantener el historial solo en modo append |
computer_20251124 | La antigua herramienta de uso del ordenador en la API y Google Cloud | Usar computer_toolset_20260801 |
| Algunos emparejamientos de la herramienta advisor | Un advisor Sonnet 5 u Opus 4.8 con un ejecutor Sonnet 5.5 | Emparejarlo con Opus 5.5 o Sonnet 5.5 |
Para los equipos de soporte, la trampa es el tool_choice forzado. Muchas integraciones de helpdesk con IA fuerzan una herramienta de "clasificar este ticket" en cada solicitud para el triaje de tickets, así que si cambias el ID del modelo sin arreglar eso, cada ticket da error. Hay otro más discreto: el texto entre llamadas a herramientas ahora llega dentro de bloques de pensamiento, lo que significa que un widget de chat que transmite "Revisando tu pedido..." puede quedarse en silencio. Por qué ese silencio importa a los clientes se explica en mi guía sobre traspasos de agentes de IA.
Lo que dicen los desarrolladores
La recepción el día del lanzamiento fue mixta, pero de una forma útil. Nadie discute los benchmarks; el debate es más sobre dónde encaja Sonnet 5.5 junto a Opus.
"It appears, at least from a quick look, to be noticeably faster than Opus. If true, and you don't need xhigh/max reasoning for your use case (like a well-defined set of code changes), Sonnet might get the job done much more quickly."
Los escépticos se centran en el precio, en especial en que las lecturas de caché cuestan los mismos 0,20 $ que en Opus 5.5:
"I feel like sonnet is priced too close to opus right now. If Sonnet 5.5 were half its current price it would make sense to use."
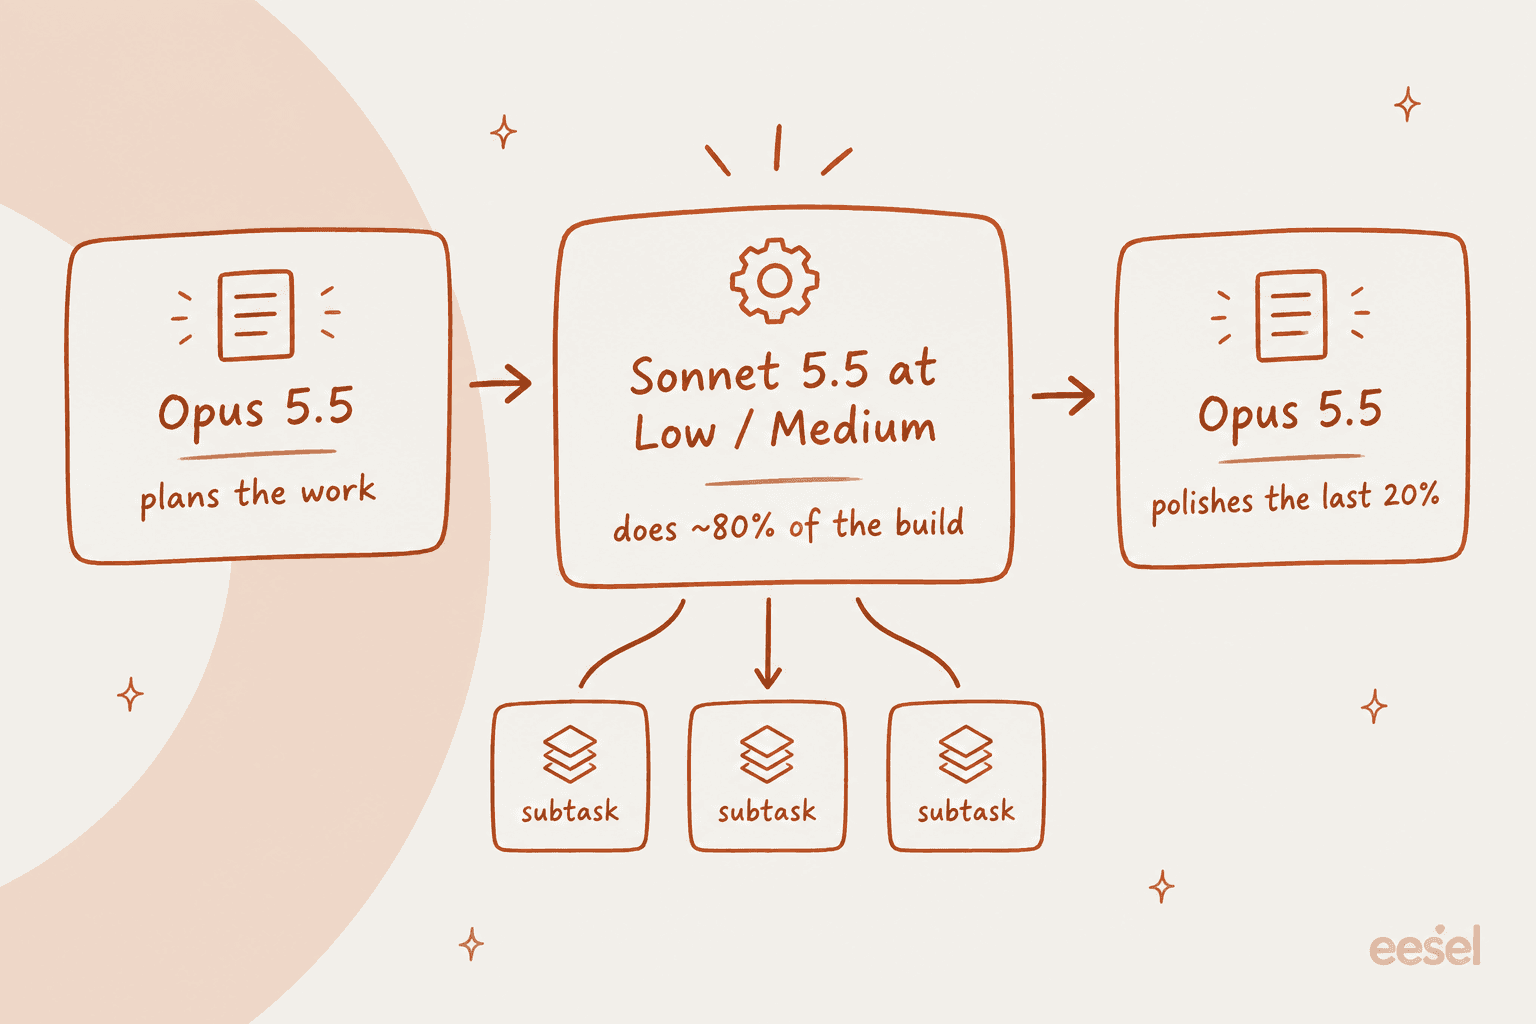
El caso de uso al que la gente vuelve una y otra vez es Sonnet como implementador rápido, bajo un planificador Opus:
"Firmly places itself as a solid subagent for opus, great work from anthropic, for once I'm interested in what haiku turns out as."

Otro comentarista describió su propio reparto como "80% Sonnet 5.5, Opus 5.5 to finish the last 20%." El patrón encaja bastante bien con los subagentes de Claude Code, y es la configuración que copiaría para mí.
Precios de Claude Sonnet 5.5 en una tabla
Las tarifas, por millón de tokens, vienen de la documentación de precios de Anthropic:
| Precio por 1M de tokens | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | Haiku 4.5 |
|---|---|---|---|---|
| Entrada | $2 | $2 | $4 | $1 |
| Salida | $10 | $10 | $20 | $5 |
| Escritura de caché de 5 minutos | $2.50 | $2.50 | $5 | $1.25 |
| Lectura de caché | $0.20 | $0.20 | $0.20 | $0.10 |
| Batch entrada / salida | $1 / $5 | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Ventana de contexto | 1M | 1M | 1M | 200K |
Los tokens de pensamiento se facturan como salida, y por eso el ajuste de esfuerzo importa tanto. Una respuesta de soporte en Medium puede pensar unos cientos de tokens, mientras que la misma respuesta en Max puede pensar decenas de miles, todos a 10 $ por millón. La línea del modelo rara vez es la parte más grande del coste de un agente de soporte con IA, pero el dial de esfuerzo es la forma más rápida de convertirla en ello.
El acceso para consumidores es la parte más sencilla. Anthropic dice que cualquiera puede chatear con Sonnet 5.5 en Claude.ai, y los planes de pago están en mi guía de precios de Claude Pro. Desde el primer día también está en Amazon Bedrock y Google Cloud, además de Microsoft Foundry. Si estás comparando proveedores, empieza con la comparación a tres bandas de APIs. Para el cara a cara con OpenAI, lee el análisis de GPT-6 Sol vs Opus 5.5.
Quién debería cambiar y quién esperar
Así tomaría yo la decisión, según lo que ejecutes hoy:
| Ejecutas... | Mi decisión | Ajuste de esfuerzo |
|---|---|---|
| Sonnet 5 en producción | Cambia esta semana, tras las correcciones de migración | Medium |
| Opus 5.5 para programación cotidiana | Pasa las tareas rutinarias a sub-agentes Sonnet 5.5 | Low o Medium |
| Opus 5.5 para planificación abierta | Quédate en Opus | n/a |
| Un bot de soporte con llamadas a herramientas forzadas | Espera hasta haber arreglado tool_choice | Medium |
| Flujos de seguridad o pentesting | Espera y solicita el Cyber Verification Program | n/a |
| Etiquetado y enrutamiento de alto volumen | Quédate en Haiku 4.5 hasta que salga Haiku 5.5 | n/a |
Anthropic dice que Claude Haiku 5.5 se unirá a la familia "in the coming weeks", así que si tu mayor preocupación es el coste por ticket, vale la pena esperarlo. Para una visión más amplia de opciones, mi resumen de alternativas de Claude para atención al cliente cubre opciones específicas de soporte. Para cambios de modelo en general, consulta la lista de alternativas a Sonnet.
Un modelo más inteligente no arregla una base de conocimiento equivocada
Hay algo que una reseña de modelo no puede mostrarte, y es que la mayoría de los fallos de bots de soporte que he visto no tienen nada que ver con el modelo. Un equipo B2B de telemática de vehículos con unos 200 tickets de Zendesk al mes descubrió que su bot decía a los clientes que soportaba marcas de coches que no estaban en su base de datos. El modelo no estaba alucinando, sin embargo. Su base de conocimiento decía que soportaban "todos los modelos", y el bot simplemente lo creyó. Pasar de Sonnet 5 a Sonnet 5.5 habría dado la misma respuesta equivocada, solo que un 30 % más rápido.
Por eso nunca juzgo un modelo para soporte solo con benchmarks. En eesel cada despliegue se simula contra tickets históricos antes de que el compañero hable con un cliente, porque ahí es donde se detectan los problemas de conocimiento que un modelo mejor no puede arreglar.
Prueba eesel con modelos de clase Claude en tu cola
Si quieres la velocidad de Sonnet 5.5 en tus tickets sin encargarte tú de la migración, eesel es el atajo. Su compañero de helpdesk con IA se une al helpdesk que ya tienes, como Zendesk, aprende de tus tickets anteriores y tu centro de ayuda, y luego redacta o envía respuestas con un modelo de frontera debajo. Todo el ajuste de esfuerzo y los cambios incompatibles de esta reseña pasan a ser trabajo de eesel en lugar del tuyo.

Si te gusta trabajar desde una terminal, la CLI de eesel opera el mismo compañero y espacio de trabajo que el panel. Puedes automatizarla con scripts o dejar que la maneje un agente de código como Claude Code, que es básicamente el mismo patrón de "Opus planifica, Sonnet construye" de antes, aplicado a tu configuración de soporte. Mi entrada sobre la CLI de agentes de IA profundiza más, y la de servidores MCP cubre el lado de los conectores.
El plan gratuito incluye 100 créditos y no pide tarjeta, y los planes de pago empiezan en 299 $ por 500 créditos. Prueba eesel con una parte de tus tickets reales y comprueba si el modelo más rápido se traduce de verdad en respuestas más rápidas.
¿Vale la pena Claude Sonnet 5.5?
Sí, con una regla añadida. En esfuerzo Low o Medium, Claude Sonnet 5.5 te da programación y trabajo de conocimiento casi al nivel de Opus a la mitad del precio por token, y es un 30 %+ más rápido con muchos menos tokens. Eso lo convierte en el nuevo valor por defecto para trabajo bien acotado y sub-agentes, y también para las respuestas de soporte cotidianas.
En Max cuesta más que Opus y a veces falla igualmente, así que no lo uses ahí. Conserva Opus 5.5 para las decisiones difíciles y abiertas y arregla tus llamadas a herramientas forzadas antes de migrar. Después, deja que el dial de esfuerzo decida tu factura, no el nombre del modelo.
Preguntas frecuentes
¿Es bueno Claude Sonnet 5.5?
¿Es Claude Sonnet 5.5 mejor que Sonnet 5?
¿Vale la pena Claude Sonnet 5.5 frente a Opus 5.5?
¿Cuánto cuesta Claude Sonnet 5.5?
¿Qué nivel de esfuerzo debería usar con Claude Sonnet 5.5?
¿Es Claude Sonnet 5.5 bueno para atención al cliente?
¿Cuáles son las desventajas de Claude Sonnet 5.5?
¿Cuáles son las alternativas a Claude Sonnet 5.5?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.