Resumen rápido
Claude Mythos 5.1 tiene un precio de 10 $ por millón de tokens de entrada y 50 $ por millón de tokens de salida, exactamente igual que Fable 5.1, porque son el mismo modelo con distintas salvaguardas. Las tarifas base no se movieron desde Fable 5. El único cambio real es la lectura de caché del prompt, que baja a 0,25 $ por millón de tokens (2,5 % de la entrada base, frente al 10 % de cualquier otro modelo Claude). La propia estimación de Anthropic es de alrededor de un 25 % más barato en cargas de trabajo típicas y hasta un 45 % más barato en las muy agénticas.
La trampa: probablemente no puedas usar Mythos 5.1. Está limitado a EE. UU., bloqueado tras una verificación cyber o de ciencias de la vida, y obliga a una retención de datos de 30 días. El modelo que sí puedes usar, Fable 5.1, es idéntico, así que el precio en torno al que deberías planificar de verdad es el de Fable 5.1. Y si estás calculando esto para trabajo de soporte o contenido en lugar de acceso directo a la API, un compañero con precio por resultado como eesel evita por completo el cálculo de tokens.
El precio, por adelantado
Aquí está toda la tabla de precios de Claude Mythos 5.1. Cada cifra de abajo también se aplica, al céntimo, a Fable 5.1, un punto al que volveré más adelante.
| Medidor | Precio (por millón de tokens) | Notas |
|---|---|---|
| Entrada base | 10,00 $ | Sin cambios desde Fable 5 |
| Salida base | 50,00 $ | Sin cambios desde Fable 5 |
| Entrada batch | 5,00 $ | 50 % de descuento, API de Message Batches |
| Salida batch | 25,00 $ | 50 % de descuento |
| Escritura de caché (5 minutos) | 12,50 $ | 1,25x la entrada base |
| Escritura de caché (1 hora) | 20,00 $ | 2x la entrada base |
| Lectura de caché | 0,25 $ | 2,5 % de la entrada base, el cambio principal |
Vale la pena mencionar las especificaciones detrás de esas cifras para que puedas calcular una factura: contexto de 1M de tokens, 128K de salida máxima, thinking adaptativo siempre activo, una configuración de esfuerzo high por defecto y un corte de conocimiento de junio de 2026. Mythos 5.1 funciona en la API de Claude, Amazon Bedrock, Google Cloud y Microsoft Foundry, y esas plataformas fijan sus propias tarifas regionales encima.
Fíjate en lo que no aparece aquí: sin tarifa por puesto, sin mínimo mensual, sin niveles de plan. Esto es precio de modelo en bruto facturado por token, así que tu coste real es una función de cuánto texto entra, cuánto sale y cuánto de la entrada puedes servir desde caché. Esa última variable es todo el juego de este lanzamiento.
La lectura de caché es la verdadera noticia
Cada otro modelo Claude actual fija el precio de un acierto de caché en el 10 % de su tarifa base de entrada. Mythos 5.1 y Fable 5.1 lo fijan en el 2,5 %. En un modelo de entrada a 10 $, eso son 0,25 $ por millón de tokens en lugar de 1,00 $.
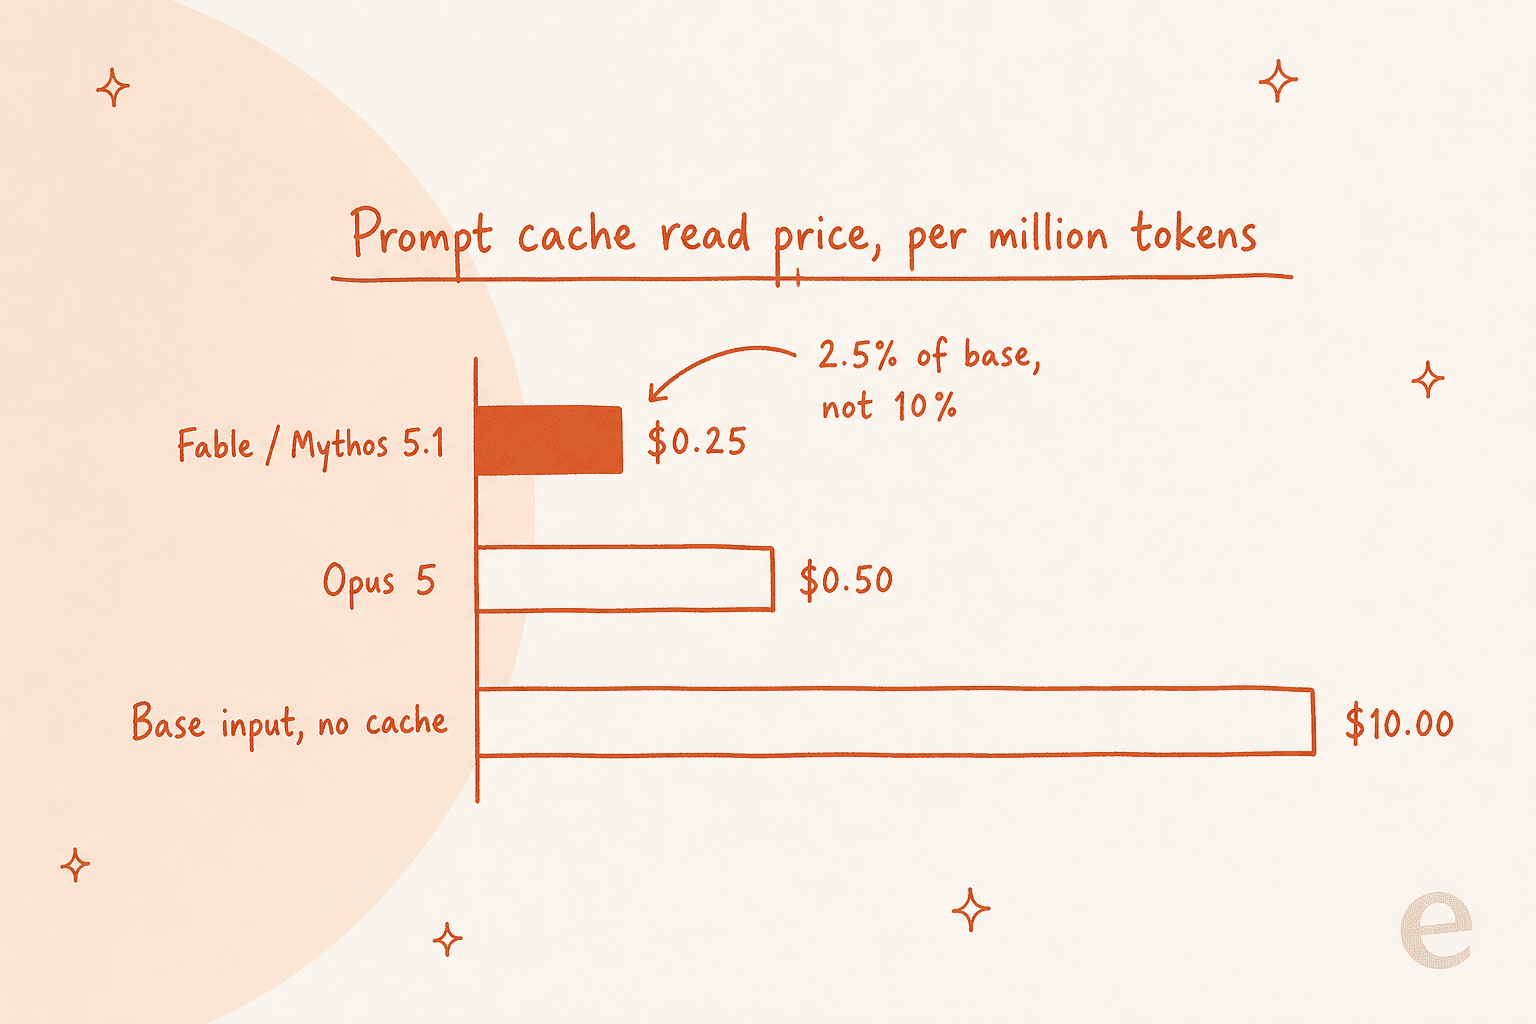
La cifra que hace que la gente mire dos veces: una lectura de caché de Mythos 5.1 cuesta la mitad que una lectura de caché de Opus 5 (0,25 $ frente a 0,50 $), aunque Mythos cuesta el doble por token de entrada base. Anthropic está diciendo, en esencia: la parte cara es pensar sobre tokens nuevos, y volver a leer tokens ya procesados debería ser casi gratis.
Eso importa por dónde van los tokens en un agente real. Una CLI de programación o un agente de soporte de larga duración reenvía toda su transcripción en cada turno. El turno 20 podría llevar un millón de tokens de contexto, casi todo un acierto de caché. Cuando la lectura de caché cae 4 veces, la partida dominante de ese tipo de factura cae con ella. Como dijo Simon Willison en Hacker News:
"Bit of a discount if you're using caching... This should impact any long-running agent since subsequent calls can benefit from cached reads for previous transcripts."

Anthropic dio cifras reales tras medir cuatro semanas de uso de agosto de 2026: alrededor de un 25 % más barato para cargas de trabajo típicas, y hasta aproximadamente un 45 % más barato para las muy agénticas. La diferencia depende por completo de cuánto se apoye el trabajo en la caché.
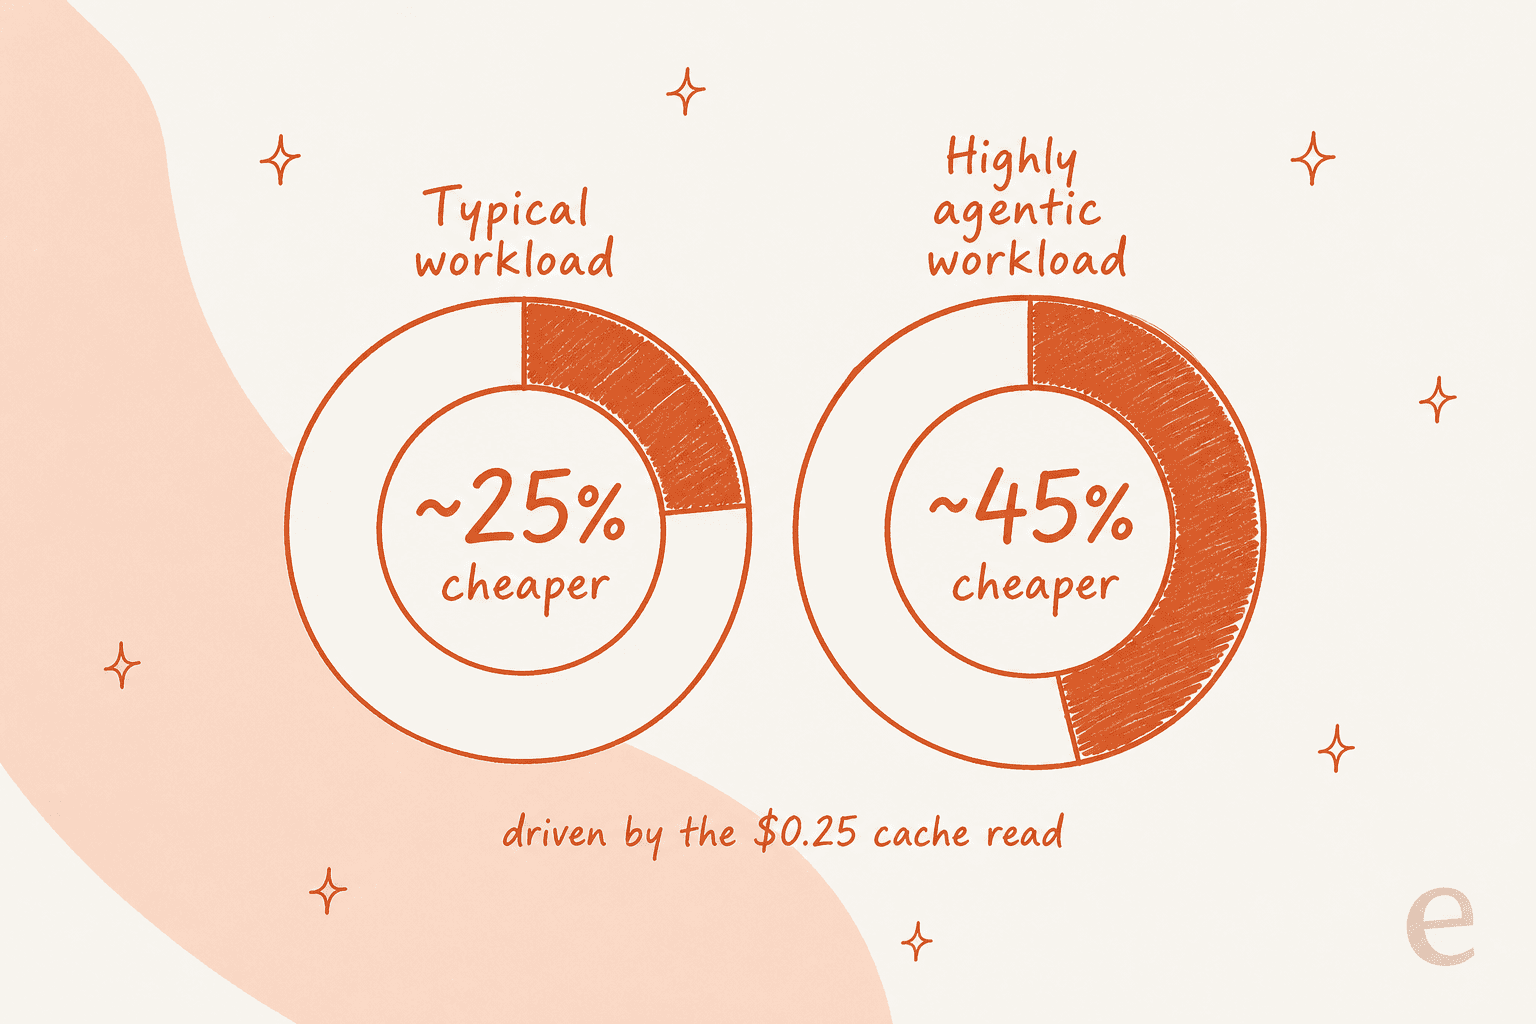
Aquí va el contrapeso honesto, porque un artículo de precios también te debe a los escépticos. La lectura de caché más barata solo importa si las lecturas de caché son una gran parte de tu gasto. Los tokens de salida siguen costando 50 $ por millón y no se movieron. Un comentarista de Hacker News, fastball, trabajó un ejemplo de 20 turnos: una conversación que termina en 1M de tokens de contexto salió a 72,00 $ en Fable 5 y 64,88 $ en Fable 5.1, porque los 50 $ de tokens de salida eran idénticos en ambos. Más barato, pero no el 25 % que podrías esperar si solo lees el titular por encima. Y otro usuario fue más directo: "This is just cache reads. In real usage it costs 15% more than Fable 5." La lección es hacer tus propios cálculos con tu mezcla de tokens, no asumir que el porcentaje del titular es el tuyo.
Para hacerlo fácil, introduce tus propias cifras:
Mythos y Fable cuestan lo mismo porque son el mismo modelo
Este es el hecho que reformula toda la cuestión de precios. Mythos 5.1 y Fable 5.1 son el mismo modelo subyacente, con los mismos pesos. La única diferencia es la capa de seguridad: Fable 5.1 se evalúa con las salvaguardas de producción activadas, y cuando una salvaguarda se activa, pasa la tarea a otro modelo. Mythos 5.1 funciona sin esa intervención.
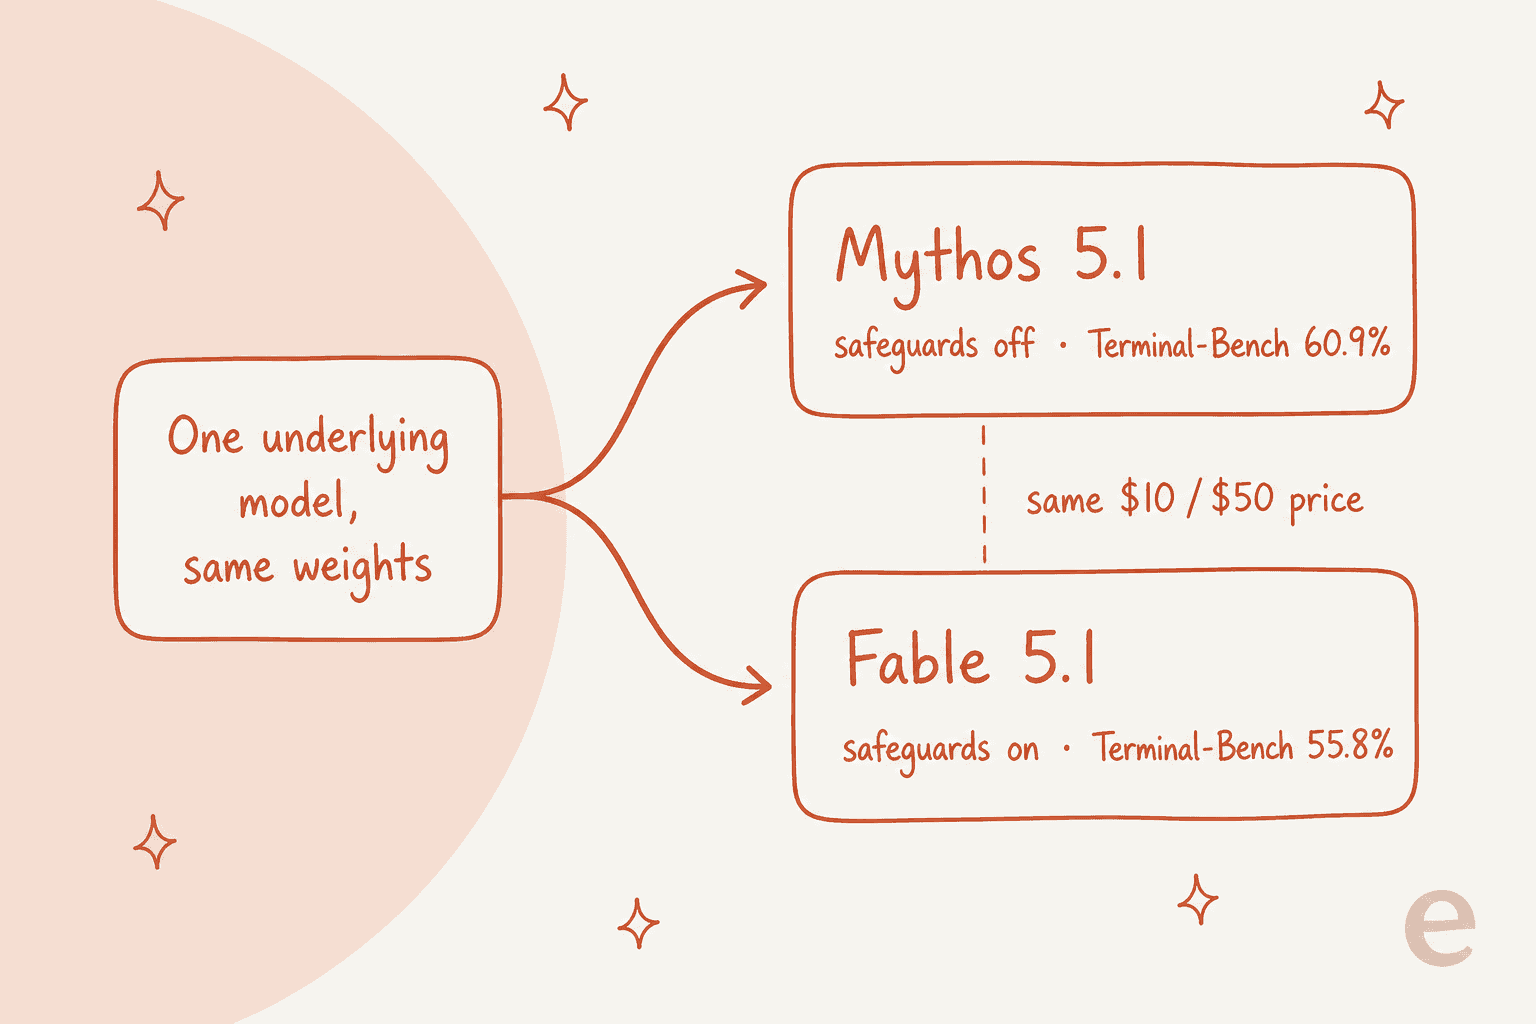
Así que cuando ves que Mythos 5.1 puntúa 60,9 % en Terminal-Bench 4.0 frente al 55,8 % de Fable 5.1, esa diferencia no es un modelo más listo. Es el impuesto que cobran las salvaguardas cuando intervienen y desvían una tarea. Anthropic espera que la diferencia se reduzca a medida que las salvaguardas sean más precisas. Ponerles el mismo precio es el movimiento honesto, porque pagas por los mismos pesos de cualquier forma.
Eso también explica por qué la tarifa base no bajó aunque esto sea un lanzamiento puntual. En Hacker News, GodelNumbering interpretó el recorte de la lectura de caché como una señal de demanda más que de generosidad:
"This gives a lot of credit to the theory that Anthropic did not get much bite on Fable at its original pricing, which in turn likely places a ceiling on LLM pricing in general."
Sea o no correcta esa lectura, la conclusión práctica para un comprador es clara: no estás eligiendo entre dos puntos de precio. Estás eligiendo entre dos configuraciones de salvaguardas en un único punto de precio.
El precio con el que debes planificar es el de Fable, porque no puedes usar Mythos
Aquí está la parte que la mayoría de los artículos de precios se saltan. Una cifra en una tabla de precios solo es real si puedes llamar al modelo. Para Mythos 5.1, la mayoría de los equipos no pueden.
El acceso hoy está limitado a EE. UU. y llega por una de tres puertas: el Cyber Verification Program de Anthropic (donde el acceso a Mythos se promete "en un futuro próximo" pero aún no está activo), el Life Sciences Verification Program (una beta solo por invitación construida con el gobierno de EE. UU.) o una conversación directa con tu equipo de cuenta de Anthropic, AWS o Google Cloud. Además, usar Mythos 5.1 requiere aceptar por defecto una retención de datos de 30 días, lo que es una línea aparte en cualquier revisión de compras.
Para todos los demás, el modelo que realmente puedes poner en producción es Fable 5.1, disponible en la API de Claude, Bedrock, Google Cloud y Foundry sin ninguna barrera de verificación. Y como son los mismos pesos, "cuál ofrece mejor relación calidad-precio" es la pregunta equivocada. Compras Fable 5.1, planificas con el precio de Fable 5.1, y que ambas tablas de precios sean idénticas significa que no pierdes nada por no tener acceso a Mythos. La tabla de precios de Mythos se lee mejor como confirmación de lo que pagarás por Fable, no como algo aparte que comparar.
Tres cambios de API que afectan a tu factura y a tu flujo de trabajo
El precio no es solo la tarifa por token, es lo que tu integración tiene que hacer para alcanzar esa tarifa. Con esta generación llegan tres cambios de API que rompen compatibilidad, y también se aplican a Fable 5.1, así que tenlos en cuenta en cualquier migración:
- El uso forzado de herramientas ahora devuelve un error. Si tu agente dependía de forzar una llamada a una herramienta concreta, ese patrón se rompe y tendrás que rehacer el flujo de uso de herramientas.
- Los bloques de thinking están ligados al modelo que los produjo. No puedes reproducir libremente una transcripción de thinking de otro modelo.
- Las cuentas de API nuevas no pueden editar el contexto previo conservando la transcripción de thinking. Es una medida contra la destilación, y cambia cómo puedes estructurar bucles de agentes largos.
Ninguno de estos cambios altera el precio de etiqueta, pero pueden cambiar el tiempo de ingeniería, que es el verdadero coste total de propiedad de cualquier migración de modelo. Presupuesta el trabajo de adaptación, no solo los tokens.
Cómo se compara con el resto de la gama
Si pones a Mythos 5.1 junto a los modelos con los que realmente lo compararías, el panorama es menos "nivel premium, precio premium" de lo que sugiere la tarifa base, en cuanto entra en juego el caché.
| Modelo | Entrada / salida (por M) | Lectura de caché (por M) | Contexto |
|---|---|---|---|
| Mythos 5.1 / Fable 5.1 | 10 $ / 50 $ | 0,25 $ | 1M |
| Opus 5 | 5 $ / 25 $ | 0,50 $ | 1M |
| Sonnet 5 | 2 $ / 10 $ | 0,20 $ | 1M |
| Haiku 4.5 | 1 $ / 5 $ | 0,10 $ | 200K |
Opus 5 tiene la mitad del precio base, pero su lectura de caché es el doble. Así que, en una carga de trabajo que es sobre todo aciertos de caché, la diferencia efectiva entre Opus 5 y Mythos/Fable 5.1 se reduce marcadamente, que es exactamente el caso para el que Anthropic está optimizando. Para una carga de trabajo que es sobre todo entrada y salida nuevas, Opus 5 sigue siendo claramente más barato. No hay una única respuesta de "modelo más barato", por lo que la calculadora de arriba importa más que cualquier ranking.
Vale la pena nombrar al elefante en la habitación, tal como hizo el hilo de Hacker News: los modelos abiertos y chinos más baratos ya fijan las lecturas de caché en centavos de un solo dígito, y varios comentaristas argumentaron que eso pone un techo a lo que pueden cobrar los laboratorios de frontera. El precio de Mythos 5.1 es una respuesta a esa presión, no una inmunidad frente a ella.
Prueba eesel
Si estás leyendo una página de precios de modelos, normalmente estás intentando responder a una pregunta más adelante en la cadena: cuánto costará realmente resolver tickets de soporte o escribir contenido. Esa es una pregunta distinta de "cuál es la tarifa por token", y es la que eesel está construido para responder.
El modelo es infraestructura. eesel es la empleada que contratas encima de él. No aprovisionas Mythos ni Fable, no cuentas lecturas de caché ni reservas capacidad. Incorporas un compañero de IA listo para trabajar para una tarea concreta, y hoy la plantilla incluye un compañero de IA de helpdesk que se une a tu cola de soporte existente y un redactor de blog con IA. Cada uno llega con las habilidades, integraciones y contexto de la empresa para su rol, y el precio es por resultado resuelto, no por token, así que una factura que puedes prever sustituye el cálculo de tokens de esta página.
Y porque los ingenieros preguntan: eesel se puede manejar desde la CLI de eesel, así que el mismo compañero que configuras en el panel se puede operar desde una terminal, automatizar en scripts o manejar con un agente de programación como Claude Code, Codex o Cursor. Si tu interés en el precio de Mythos 5.1 en realidad iba de conectar un modelo a un flujo de trabajo de soporte o contenido, esa es la capa que convierte un modelo en bruto en trabajo realmente hecho. Es gratis probarlo.
Preguntas frecuentes
¿Cuánto cuesta Claude Mythos 5.1?
¿Por qué Claude Mythos 5.1 cuesta lo mismo que Fable 5.1?
¿Cuál es el precio de la lectura de caché de Claude Mythos 5.1?
¿Puedo acceder realmente a Claude Mythos 5.1?
¿Merece la pena el precio de Claude Mythos 5.1 frente a Opus 5?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.