Por qué mirar más allá de Fable 5.1
Déjame ser justo con el favorito primero, porque Fable 5.1 es un modelo fuerte. Se lanzó el 1 de septiembre de 2026, está en la cima de la familia Claude 5, y en las evaluaciones propias de Anthropic lidera todos los benchmarks que publica, con los mayores saltos en trabajo agéntico y científico de largo alcance. Ofrece una ventana de contexto de 1M de tokens con precio fijo por token en toda la ventana, 128k de salida máxima, y pensamiento adaptativo que está siempre activo. El único movimiento de precio en 2026 fue bueno: las lecturas de caché bajaron un 75 %, de 1 $ a 0,25 $ por millón de tokens, lo que recorta los costos típicos alrededor de un 25 % y los muy agénticos hasta un 45 %.
Entonces, ¿por qué alguien comparar opciones? Surgieron algunas razones concretas de forma recurrente.
- Precio. La tarifa base sigue siendo 10 $/50 $, la etiqueta más alta de este resumen. Si tu carga de trabajo no es del tipo largo, desordenado y multi-herramienta para el que Fable está construido, estás pagando una prima por margen que no vas a usar.
- Rechazos. Varios desarrolladores en Hacker News reportaron rechazos falsos positivos, incluso en la revisión de seguridad de su propio código. Anthropic dice que los usuarios de Claude Code deberían ver alrededor de un 60 % menos de intervenciones de ciberseguridad que con Fable 5, pero es una queja real y actual.
- La marca de agua. Cada salida de Fable 5.1 lleva una marca de agua de texto estadística para cumplir con la Ley de IA de la UE. Eso está bien para la mayoría de la gente y es un problema de confianza para algunos, y generó la mayor controversia en el lanzamiento.
- Puede que no necesites un modelo en bruto. Este es el grande, y volveré a él. Si el objetivo final es un agente de soporte o un redactor de contenido, comprar un modelo de frontera significa que todavía tienes que construir el trabajador alrededor de él.
Como ingeniero que pasa la mayoría de los días conectando modelos a un producto real en eesel, lo que sigo notando es que la pregunta de "qué modelo" suele estar subordinada a una pregunta de "qué capa" que la gente se saltó. Más sobre esto después de la lista.
Cómo elegí estas alternativas
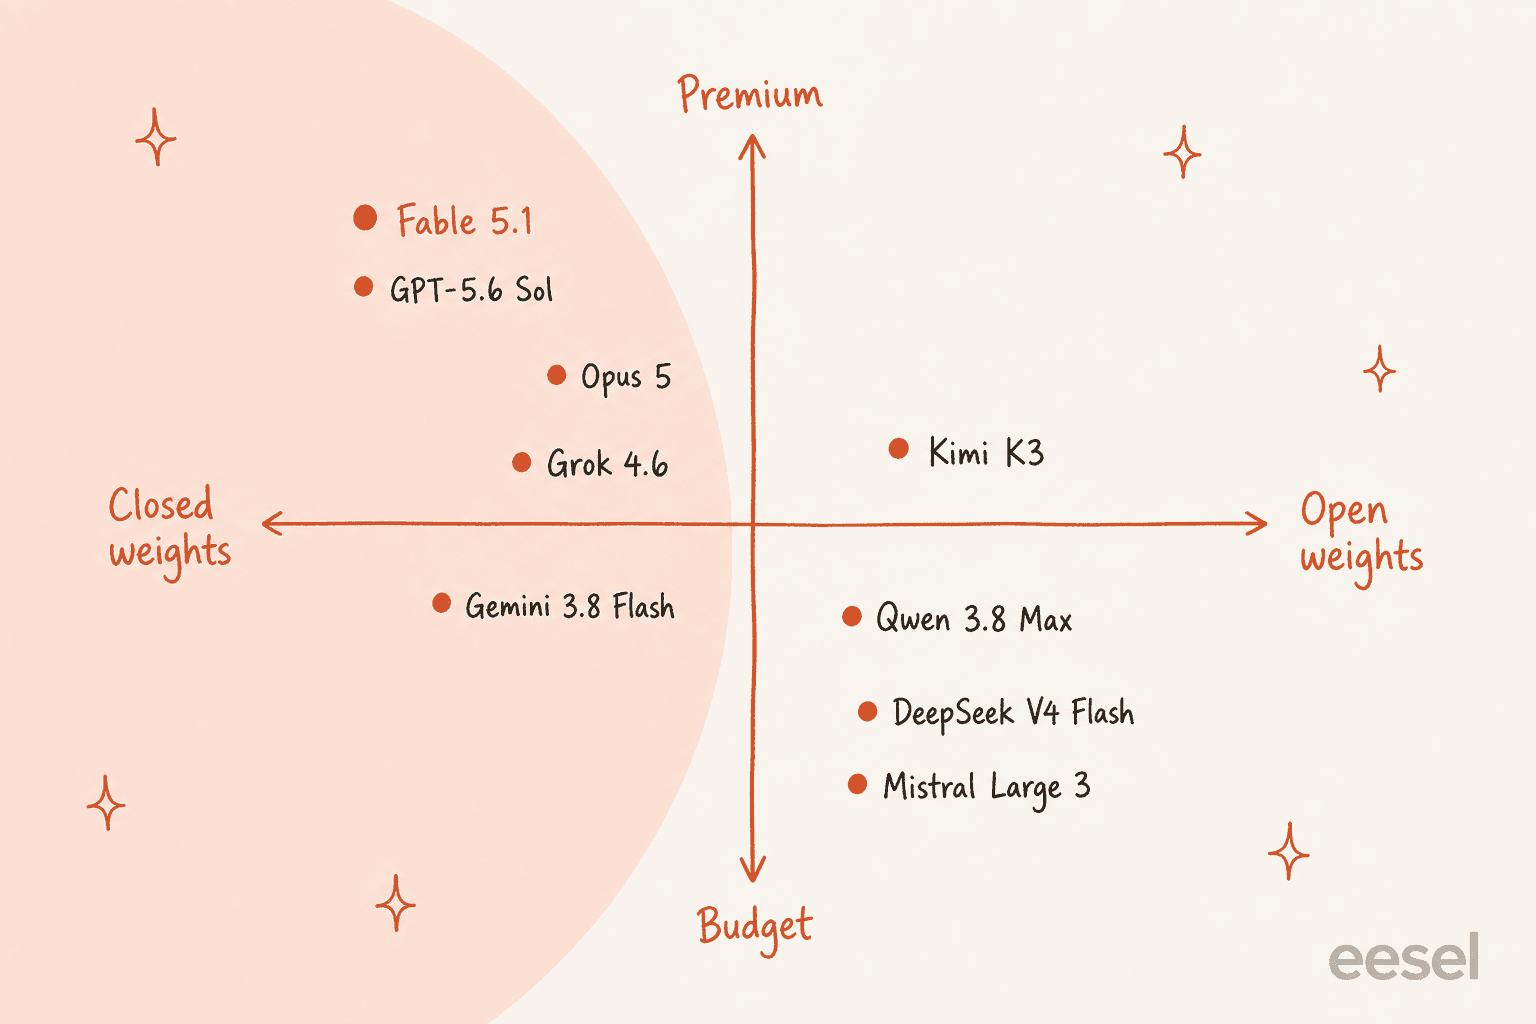
No hay un único modelo "mejor", así que esta lista está organizada según la tarea que realmente estás haciendo. Sopesé cuatro cosas para cada opción: el precio real publicado (tarifas base, no el "desde" del marketing), puntuaciones independientes donde existan (principalmente el Artificial Analysis Intelligence Index, que es agnóstico al modelo), si los pesos son abiertos, y la compensación honesta que la tabla de clasificación esconde. Cada modelo aquí es una opción real y generalmente disponible que puedes usar hoy, no una vista previa.
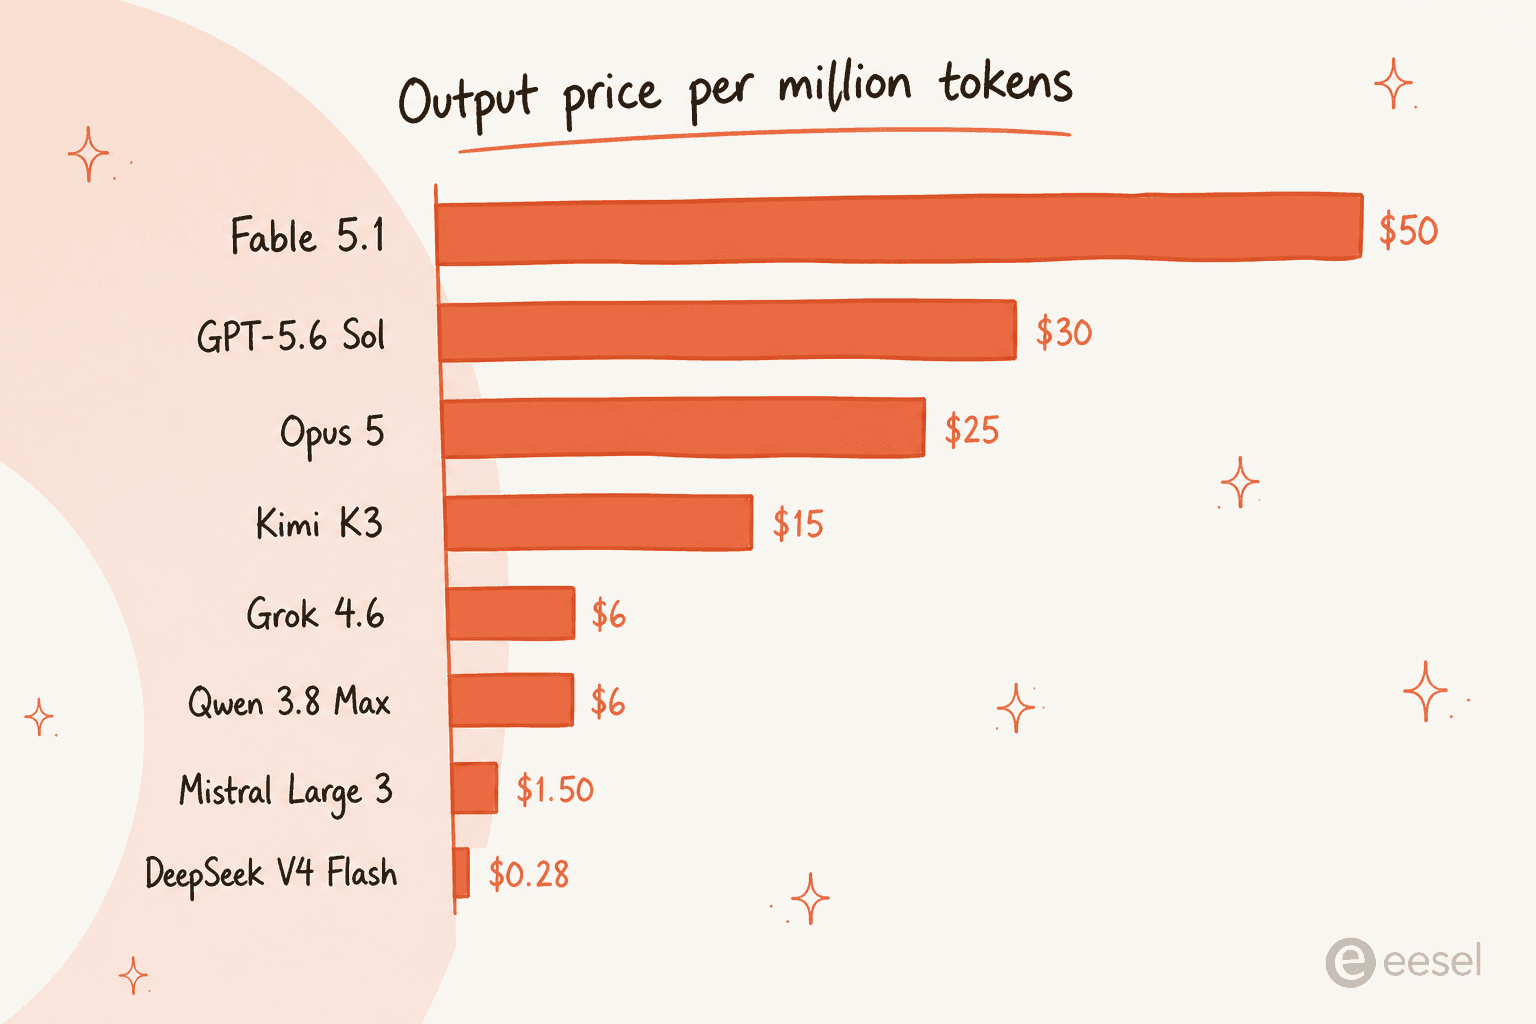
Una nota sobre las cifras: los precios son por millón de tokens (MTok), entrada y salida listadas por separado, porque la salida es donde se va el dinero en el trabajo generativo. He mantenido cada cifra fiel a la página principal de cada proveedor.
Las 8 mejores alternativas a Claude Fable 5.1 en 2026
Aquí está la lista corta de un vistazo, y luego el detalle de cada una.
| Modelo | Mejor para | Precio (entrada/salida, $/MTok) | Contexto | ¿Pesos abiertos? | vs. Fable 5.1 |
|---|---|---|---|---|---|
| Claude Opus 5 | El reemplazo por defecto | 5 $ / 25 $ | 1M | No | Mitad de precio, el punto de partida recomendado por Anthropic |
| OpenAI GPT-5.6 Sol | Pilas nativas de OpenAI | 5 $ / 30 $ (contexto corto) | 400k | No | Base más económica, pero el nivel de contexto largo se duplica tras 200k |
| Google Gemini 3.8 Flash | Lotes de alto rendimiento económicos | 0,75 $ / 3,75 $ | 1M | No | Mucho más económico, pero 13,3s de tiempo al primer token y se duplica en enero de 2027 |
| Kimi K3 | Buque insignia de pesos abiertos | 3 $ / 15 $ | 1M | Sí | Puntuación casi de tope, auto-hospedable, mitad del precio de salida de Fable |
| Qwen 3.8 Max | Multilingüe + fuerte preferencia humana | 2 $ / 6 $ | 1M | Pesos base | Top 5 en LMArena Text, un quinto del costo de salida |
| DeepSeek V4 Flash | La opción de presupuesto | 0,14 $ / 0,28 $ | 128k | Sí (MIT) | Salida ~180x más económica, con licencia MIT |
| xAI Grok 4.6 | Tiempo real + datos de X | 2 $ / 6 $ (contexto corto) | 500k | No | Base más económica, pero medidores por llamada de herramienta y un abismo en 200k |
| Mistral Large 3 | Residencia de datos en la UE, económico | 0,50 $ / 1,50 $ | 256k | Sí | Proveedor europeo, el precio de salida de nivel premium más bajo aquí |
1. Claude Opus 5
Mejor para: cualquiera que quiera un Claude de clase Fable sin la factura de clase Fable.
La alternativa más honesta a Fable 5.1 es el modelo justo debajo de él en la propia gama de Anthropic. Opus 5 se lanzó el 24 de julio de 2026, funciona a 5 $/25 $ por millón de tokens, y la guía de Anthropic es inusualmente directa: empieza con Opus 5 para la mayoría de tareas, y recurre a Fable 5.1 solo cuando Opus 5 con mayor esfuerzo todavía se queda corto. Eso es el proveedor diciéndote que el modelo más económico es la opción por defecto.
Comparte los mejores rasgos estructurales de Fable: una ventana de 1M de tokens con precio fijo, sin recargo por contexto largo, y lecturas de caché a 0,50 $ (todavía económico, aunque no el 0,25 $ de Fable). En el Artificial Analysis Intelligence Index independiente está en la cima del grupo, apenas por detrás de los lanzamientos más recientes.
La trampa que hay que conocer: las pruebas de la comunidad encontraron que Opus 5 tiende a gastar aproximadamente el doble de tokens de salida que el Opus anterior con el mismo esfuerzo, así que el costo por tarea puede subir aunque la etiqueta sea más baja, y su tasa de alucinación en un conjunto independiente subió notablemente frente a Claudes más antiguos. Es brillante y un poco verboso. Para equipos que ya están en Claude y quieren un paso real hacia abajo en costo sin salir de la familia, sin embargo, es el movimiento obvio.
Nuestra opinión: la opción por defecto. Si estás en Fable 5.1 "por si acaso", prueba primero Opus 5, probablemente nunca notarás la diferencia en el trabajo del día a día.
2. OpenAI GPT-5.6 Sol
Mejor para: equipos cuya pila ya está construida sobre OpenAI.
GPT-5.6 Sol es el buque insignia de alto razonamiento de OpenAI y el par natural entre proveedores para Fable. La tarifa base es 5 $ de entrada / 30 $ de salida para el nivel de contexto corto, lo que supera a Fable en entrada y se acerca en salida. OpenAI también ofrece hermanos más económicos en la misma familia: GPT-5.6 Terra a 2 $/12 $ y Luna a 0,20 $/1,20 $, así que puedes ajustar el costo dentro de una sola API.
Aquí está la compensación que Anthropic no tiene: OpenAI cobra un nivel de contexto largo. Al cruzar 200k tokens, Sol se reprecia a 10 $/45 $, y se aplica a toda la solicitud, no solo al excedente. Así que una ejecución agéntica con un prompt grande puede costar silenciosamente el doble de la etiqueta. Fable y Opus facturan toda su ventana a tarifa fija, lo cual es una ventaja genuina para el trabajo de contexto largo.
Nuestra opinión: la decisión correcta si eres nativo de OpenAI y tus prompts se mantienen bajo 200k. Si tu trabajo es intensivo en contexto largo, haz los números de ese abismo antes de cambiar.
3. Google Gemini 3.8 Flash
Mejor para: trabajos de lote de alto rendimiento y económicos donde nadie está esperando la respuesta.
Gemini 3.8 Flash es la historia de precios de esta lista. Con 0,75 $ de entrada / 3,75 $ de salida, es más de un orden de magnitud más económico que Fable, ofrece una ventana de 1M de tokens, y obtiene un respetable 59 en el Artificial Analysis Index. Para enriquecimiento nocturno, clasificación o generación masiva, esa combinación es difícil de discutir.
Dos advertencias honestas. Primero, la capacidad de respuesta: Artificial Analysis mide un tiempo al primer token de 13,3 segundos frente a una mediana de clase de 2,99 segundos. El rendimiento es excelente (top tres en velocidad de salida), pero el modelo tarda en empezar, lo que lo descarta para cualquier cosa en la que un humano espera, como una respuesta de chat en vivo, y no es un problema para un agente de lote. Segundo, el precio se duplica: la tarifa de 0,75 $/3,75 $ se mantiene hasta el 31 de diciembre de 2026, y luego sube a 1,50 $/7,50 $ el 1 de enero de 2027. Google mismo incluso sugiere quedarse en el 3.7 Flash más antiguo para cargas de trabajo centradas en eficiencia, ya que 3.8 "podría usar más tokens para maximizar el rendimiento".
Nuestra opinión: la jugada de valor para trabajo offline y de alto volumen. No lo pongas detrás de un widget de chat, y anota el cambio de precio de enero.
4. Kimi K3 (Moonshot AI)
Mejor para: equipos que quieren una puntuación de primer nivel con pesos abiertos que realmente puedan descargar.
Kimi K3 es el buque insignia de Moonshot AI, un modelo de mezcla de expertos de 2,8 billones de parámetros (104B activos) con una ventana de contexto de 1M de tokens. Funciona a 3 $ de entrada / 15 $ de salida, así que su salida cuesta menos de un tercio de la de Fable, y ocupa el puesto #4 en el Artificial Analysis Intelligence Index, por delante de las generaciones anteriores de Claude y GPT. El diferenciador es que Moonshot publicó los pesos abiertos a tiempo, así que puedes hospedarlo tú mismo.
Una peculiaridad a tener en cuenta: el razonamiento no se puede desactivar. K3 viene con niveles de reasoning_effort (bajo, alto, y el máximo predeterminado), pero incluso el ajuste bajo sigue razonando, y todos los niveles se facturan a la misma tarifa, así que el control regula la latencia, no el costo. Eso lo hace más caro que su titular para llamadas simples, sin razonamiento, donde un modelo más económico bastaría.
Nuestra opinión: el buque insignia de pesos abiertos más fuerte para equipos que necesitan auto-hospedar por cumplimiento o control. Si solo quieres una API alojada y no te importan los pesos, Qwen y DeepSeek lo superan en precio.
5. Qwen 3.8 Max (Alibaba)
Mejor para: trabajo multilingüe y cualquiera que confíe en la preferencia humana ciega más que en puntuaciones automatizadas.
Qwen 3.8 Max estuvo generalmente disponible desde el 2 de agosto de 2026. Es un MoE de 2,4 billones de parámetros (95B activos) con una ventana de 1M de tokens, con precio de 2 $ de entrada / 6 $ de salida con una lectura de caché implícita de 0,25 $. Eso es aproximadamente un quinto del costo de salida de Fable para un modelo que se clasifica cerca de la cima de los tableros de preferencia humana.
La curiosidad interesante es que las clasificaciones automatizadas y humanas discrepan para Qwen. En LMArena es #5 en Text y #2 en Vision, es decir, a la gente le gustan sus respuestas; en el Intelligence Index automatizado se ubica en el medio, alrededor de 58. Ninguno está equivocado, miden cosas diferentes, así que no saques un veredicto de un solo número. Alibaba también publica un hermano más pequeño con licencia permisiva, aunque el Max alojado añade visión, herramientas y un contexto predeterminado más largo que la base abierta no incluye.
Nuestra opinión: una elección fuerte y económica para texto multilingüe y orientado al consumidor, donde se muestra su ventaja de preferencia humana. Para el uso agéntico de herramientas, verifica en tus propias tareas en lugar de en la tabla de clasificación.
6. DeepSeek V4 Flash
Mejor para: la línea de presupuesto, cuando el costo por token es la restricción.
Si el precio es toda la decisión, DeepSeek V4 Flash termina la conversación. Con 0,14 $ de entrada / 0,28 $ de salida, su salida es aproximadamente 180 veces más económica que la de Fable, y se distribuye bajo licencia MIT, la más permisiva de cualquier modelo aquí. Fue re-entrenado el 31 de julio de 2026, y esa construcción fresca en realidad supera al propio V4 Pro más caro de DeepSeek en cada benchmark agéntico que la empresa publica.
No igualará a Fable en el razonamiento de largo alcance más difícil o en el recuerdo profundo sobre un contexto enorme, y su ventana (128k) es más pequeña que la de los modelos de 1M de tokens de arriba. Pero en el Artificial Analysis Index obtiene una puntuación real a unos 0,03 $ por tarea, el tipo de cifra que hace viable de nuevo toda una clase de ideas "demasiado caras para ejecutar".
Nuestra opinión: la opción por defecto cuando estás ejecutando algo a escala y el nivel de frontera es excesivo. Haz un prototipo con él antes de asumir que necesitas un modelo de 50 $ de salida.
7. xAI Grok 4.6
Mejor para: productos que viven de datos en tiempo real y de X.
Grok 4.6 funciona a 2 $ de entrada / 6 $ de salida para su nivel de contexto corto de 500k tokens, más económico que Fable en todos los tokens, con fuerte uso de herramientas y acceso nativo a datos en tiempo real de X que ningún otro modelo aquí tiene.
Pero lee el medidor antes de comprometerte. Como OpenAI, xAI cobra un nivel de contexto largo: cruza 200k tokens y cada token en la solicitud se factura a 4 $/12 $. Y Grok añade tarifas por llamada que la tarifa por token esconde, la búsqueda web y de X cuesta 5 $ por 1.000 llamadas, la búsqueda de archivos 10 $ por 1.000, así que un agente que busca mucho cuesta más de lo que sugiere la etiqueta. Una trampa de adquisición: si estás obligado a usar la nube, Azure y Bedrock tienen como máximo Grok 4.3, así que no puedes comprar 4.6 a través de ellos en absoluto.
Nuestra opinión: vale la pena cuando el tiempo real o los datos de X son la característica real. Si no lo es, los medidores por llamada de herramienta hacen que un modelo de frontera sencillo sea más fácil de presupuestar.
8. Mistral Large 3
Mejor para: residencia de datos europea y una factura de nivel premium baja.
Mistral Large 3 es la entrada europea, y es el modelo "de clase buque insignia" más económico de esta lista con 0,50 $ de entrada / 1,50 $ de salida. Para equipos que necesitan un proveedor con sede en la UE por razones de residencia de datos o regulatorias, a menudo es la única opción de tipo frontera que pasa la adquisición, y además ofrece pesos abiertos.
La compensación es directa: no compite por la cima de las tablas de inteligencia como lo hacen Fable, Opus 5 o GPT-5.6 Sol. Para el trabajo agéntico y de razonamiento más difícil está un paso atrás, y su contexto de 256k es más pequeño que el de los modelos de 1M de tokens. Pero para mucha generación y extracción práctica, a ese precio y con hospedaje en la UE, es un piso muy razonable. El asistente de consumo de Mistral, ahora bajo la marca Vibe, corre sobre los mismos modelos si quieres una interfaz de chat.
Nuestra opinión: la elección pragmática para la UE. Elígelo por residencia y costo, no para ganar un benchmark.
El replanteamiento: un modelo es un motor, no un empleado
Aquí está lo que toda lista de "mejor modelo" esconde. Elegir entre Fable 5.1 y estos ocho es la pregunta correcta solo si el modelo en sí es lo que estás entregando. Para la mayoría de los equipos, no lo es. No quieres tokens, quieres tickets resueltos o publicaciones escritas.
Un modelo de frontera en bruto es infraestructura. Llega sin saber nada de tu producto, sin conectar a nada, sin recordar nada entre llamadas. Para convertirlo en un agente de soporte todavía tienes que construir recuperación sobre tu centro de ayuda, conectarlo a tu helpdesk, escribir las barreras de seguridad, añadir la lógica de escalado y, si eres cuidadoso, encontrar una forma de probarlo antes de que hable con un cliente real. Eso son meses de trabajo, y la elección del modelo es una parte pequeña de ello.
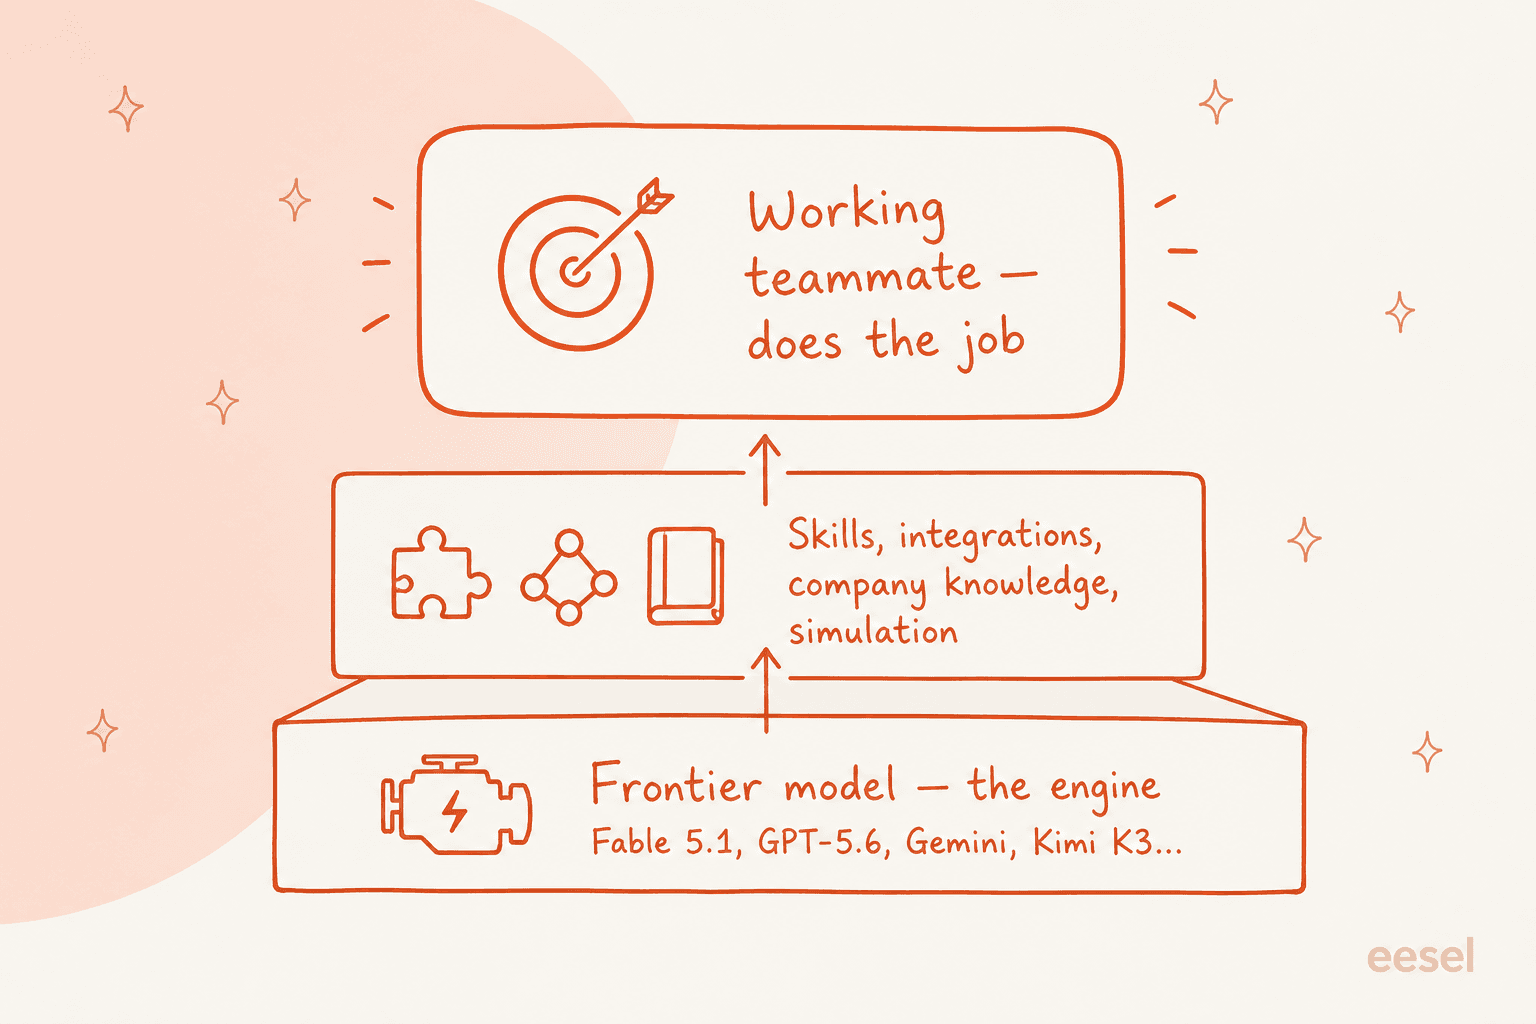
Aquí es donde me he ganado algunas cicatrices. Construyo las integraciones y APIs en eesel, y hemos pasado los últimos tres años y medio poniendo agentes de IA en colas de soporte en vivo a través de miles de tickets reales. La lección que quedó: el modelo rara vez es lo que se rompe. Lo que se rompe es un bot que suena confiado dando una respuesta incorrecta porque nadie lo probó contra la realidad primero, que es exactamente por qué cada implementación ahora se simula contra los tickets históricos de una empresa antes de acercarse a un cliente. Ninguna cantidad de "¿es Fable mejor que Opus?" responde eso.
Así que antes de pasar una semana comparando modelos, pregunta qué capa estás realmente comprando. Si estás construyendo una plataforma y el modelo es tu producto, esta lista es para ti, elige según la tarea. Si quieres un trabajador, compra el trabajador.
Prueba eesel
Si la tarea que realmente estás tratando de hacer es soporte o contenido, eesel es la capa que se sitúa por encima de todos estos modelos. eesel es una plataforma de compañeros de equipo con IA: en lugar de darte un modelo y un lienzo en blanco, contratas a un compañero de equipo listo para trabajar para una tarea definida. La formación actual es un compañero de equipo de helpdesk con IA que se une a tu cola de soporte existente, y un redactor de blog con IA, cada uno llega con las habilidades, integraciones y contexto de empresa que su rol necesita.
La parte que importa para un resumen de modelos: eesel es agnóstico al modelo por debajo, así que obtienes la capacidad de un modelo de frontera sin tener que elegirlo, ponerle precio o conectarlo, y sin rehacer ese trabajo cada vez que llega un nuevo Fable u Opus. Antes de que responda un solo ticket real, puedes simular al compañero de equipo con tus tickets pasados para ver exactamente cómo los habría manejado, el paso de prueba que la mayoría de las construcciones de modelo en bruto se saltan y luego lamentan.
Y si vives en una terminal, la CLI de eesel maneja el mismo compañero de equipo y espacio de trabajo de forma programática. Está construida para ser amigable con agentes: una persona puede ejecutarla a mano, los scripts pueden automatizarla, y agentes de codificación como Claude Code, Codex y Cursor pueden operarla directamente, así que puedes gestionar instrucciones, iniciar simulaciones, activar al agente y leer su actividad sin abrir nunca el panel. Es el mismo compañero de equipo, expuesto como una interfaz que una automatización o una IA puede manejar. Probarlo es gratis, y puedes ver cómo funciona con tus propios datos antes de comprometerte.
Qué alternativa deberías elegir realmente
Para cerrar el círculo, la versión corta por tarea:
- Quedarte en la familia Claude, gastar menos: Opus 5. Es el propio valor por defecto de Anthropic.
- Nativo de OpenAI o Google: GPT-5.6 Sol (vigila el abismo de los 200k) o Gemini 3.8 Flash (solo lotes, el precio se duplica en enero).
- Pesos abiertos: Kimi K3 para un buque insignia auto-hospedable, Qwen 3.8 Max para multilingüe, DeepSeek V4 Flash para el piso de presupuesto.
- Tiempo real o UE: Grok 4.6 para datos de X, Mistral Large 3 para residencia europea.
- Querías un trabajador, no un modelo: eesel.
Los modelos seguirán superándose entre sí, y las etiquetas de precio seguirán a la deriva. Lo que no cambia es la pregunta de la capa, decide primero si estás comprando un motor o un empleado, y el resto de la elección se vuelve mucho más pequeño.
Preguntas frecuentes
¿Cuál es la mejor alternativa a Claude Fable 5.1?
¿Cuánto cuesta Claude Fable 5.1 comparado con las alternativas?
¿Existe una alternativa más económica a Claude Fable 5.1 que siga siendo capaz?
¿Existen alternativas de pesos abiertos a Claude Fable 5.1?
¿Necesito Claude Fable 5.1 para construir un agente de soporte con IA?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.