¿Puedes conseguir Claude Mythos 5.1 de verdad?
Empieza por aquí, porque para la mayoría de los lectores esta es toda la pregunta.
Comprobación de acceso a Claude Mythos 5.1
Elige la descripción más cercana a tu equipo. Cada respuesta se toma de las propias páginas de acceso de Anthropic, a fecha de septiembre de 2026.
¿Quién eres?
Quizá, pero todavía no hoy
El Cyber Verification Program es el camino. Ya concede salvaguardas cibernéticas reducidas en modelos de clase Opus y Sonnet, y Anthropic dice que el acceso a la clase Mythos se sumará en un futuro próximo. Las solicitudes se hacen a través del portal del CVP.
Usa hoy: Fable 5.1. Ahora identifica vulnerabilidades de software en el código fuente, y los usuarios de Claude Code ven aproximadamente un 60 % menos de intervenciones de salvaguardas cibernéticas por sesión que en Fable 5.
Solo por invitación
El Life Sciences Verification Program es una beta solo por invitación, creada junto con el gobierno de EE. UU., que relaja las salvaguardas de biología para I+D profesional. Los primeros participantes ya están inscritos; se promete una inscripción más amplia, pero sin calendario.
Usa hoy: Fable 5.1, cuyas salvaguardas de biología ahora se activan un 85 % menos en preguntas benignas de biología elemental y medicina. Las consultas de ciencias biológicas de nivel de investigación siguen dirigiéndose a Opus.
Pregunta a tu equipo de cuenta
Claude Mythos 5.1 aparece en la API de Claude, Amazon Bedrock, Google Cloud y Microsoft Foundry, y la documentación dice que solicites el acceso a través de tu equipo de cuenta de Anthropic, AWS o Google Cloud. La disponibilidad sigue restringida a un conjunto de organizaciones estadounidenses.
Usa hoy: Fable 5.1 en la misma plataforma, con las Enterprise Frontier Safeguards llegando por fases este otoño y retención de datos cero disponible mientras tanto para clientes elegibles.
No, y es poco probable que cambie pronto
No hay una vía de autoservicio hacia Mythos 5.1. Ambos programas son organizacionales, verificados y limitados a EE. UU. Ni una tarjeta de crédito ni un nivel de uso te hacen entrar.
Usa hoy: Fable 5.1 para el techo, u Opus 5 a 5 $ de entrada y 25 $ de salida, que es lo que la propia documentación de Anthropic recomienda como punto de partida para la mayoría de las cargas de trabajo.
No, y no lo quieres
El margen extra de Mythos 5.1 está en ciberseguridad y biología. Ninguna de las dos aparece en una solicitud de reembolso o un ticket de WISMO. Además, es el modelo más lento y más caro de la familia, en una cola donde lo que el cliente percibe es la latencia.
Usa hoy: Sonnet 5 u Opus 5 detrás de una capa que realmente conozca tu producto. La brecha en una cola de soporte es el grounding y las pruebas, no el nivel bruto del modelo.
Qué es realmente Claude Mythos 5.1
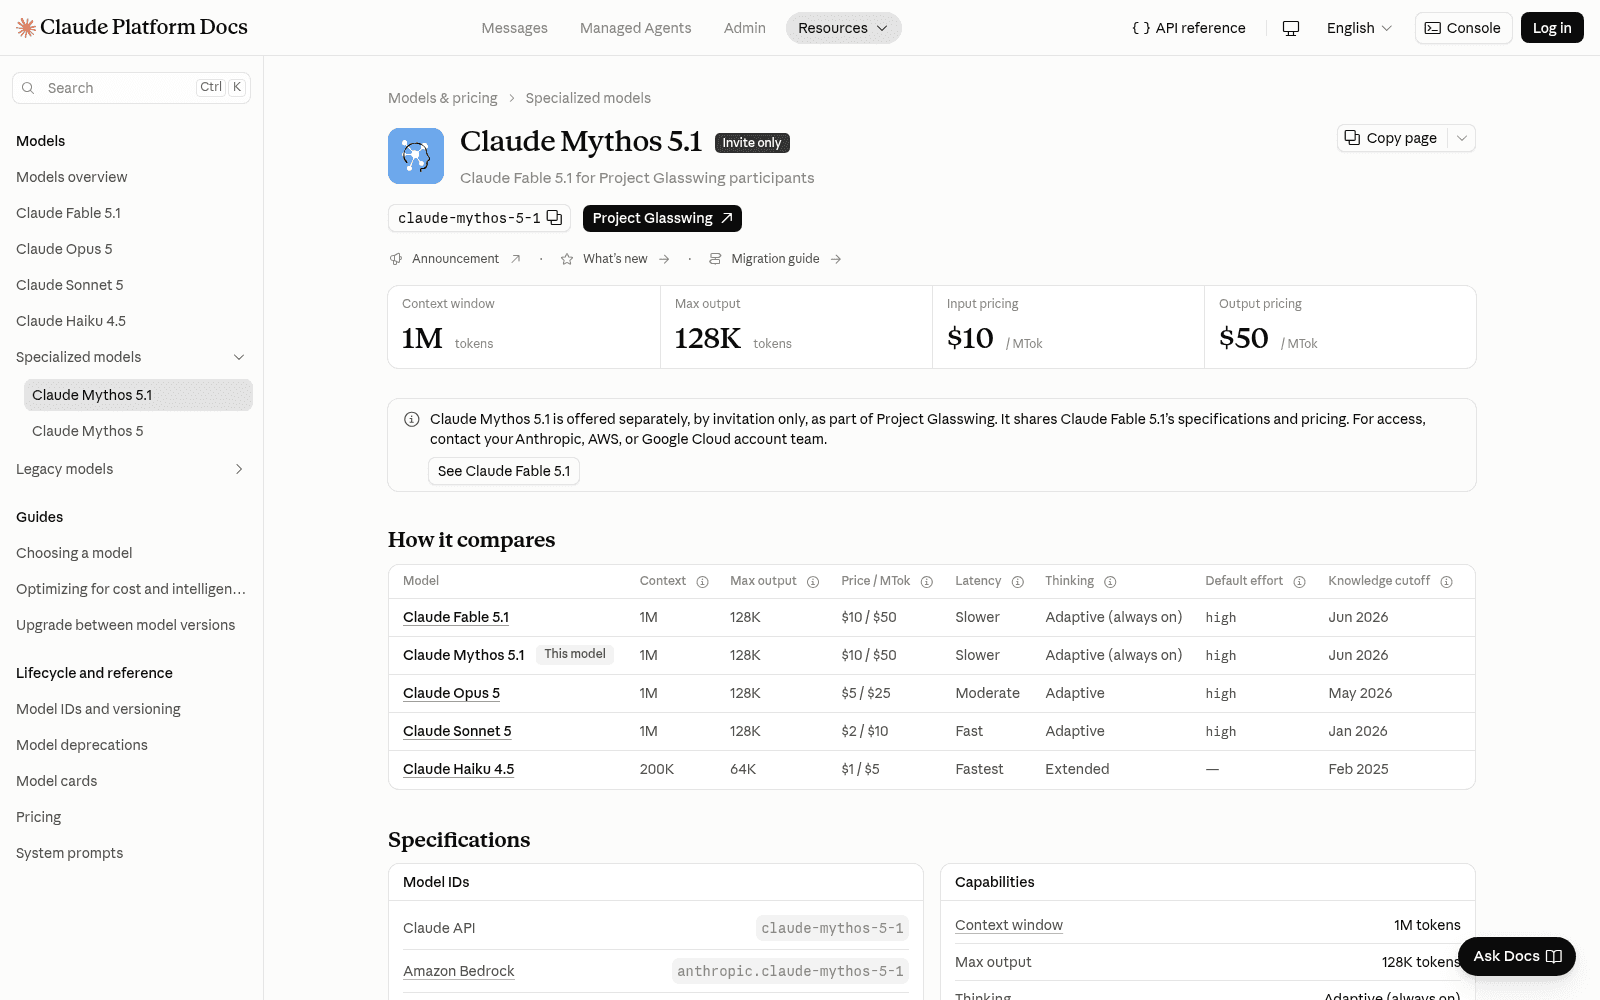
Claude Mythos 5.1 es el modelo de frontera de clase Mythos de Anthropic, lanzado el 1 de septiembre de 2026 con el ID de modelo claude-mythos-5-1. Su estado en la documentación indica "Active (invite only)", y su retirada está comprometida no antes del 1 de septiembre de 2027.
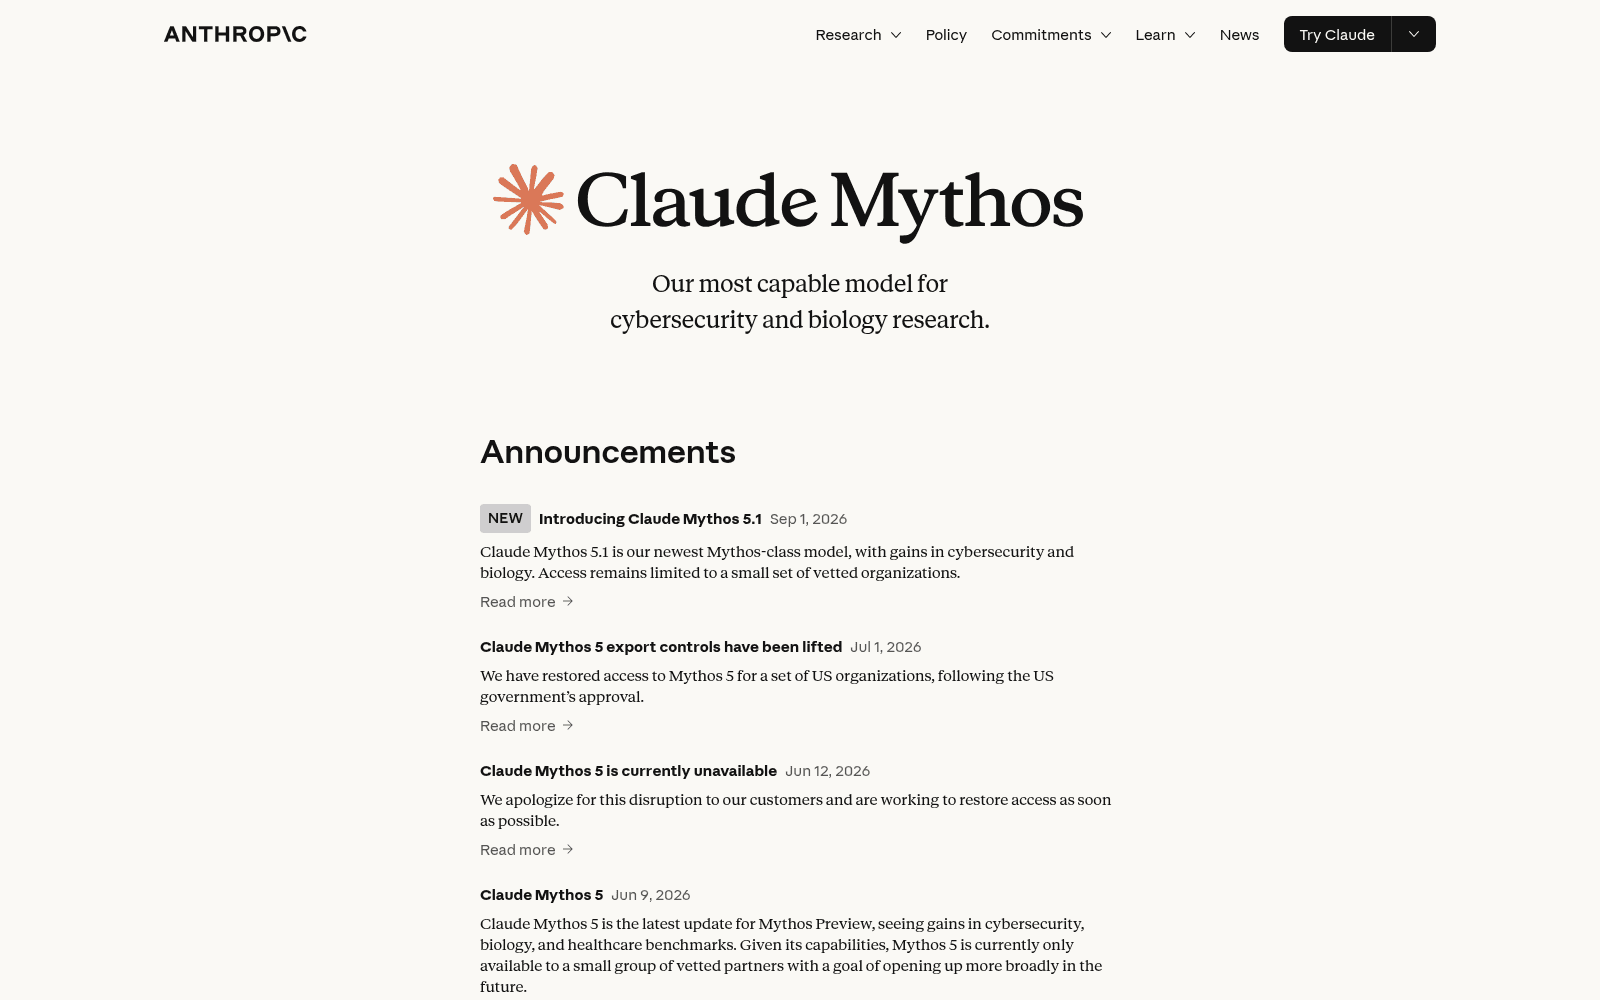
La línea Mythos empezó como Claude Mythos Preview, el modelo no publicado que Anthropic usó para lanzar Project Glasswing en abril de 2026. Mythos 5 le siguió el 9 de junio, dejó de estar disponible el 12 de junio, y tuvo sus controles de exportación levantados el 1 de julio tras la aprobación del gobierno de EE. UU. Mythos 5.1 es la tercera entrada de esa línea, y la primera que llega junto a un gemelo de disponibilidad general.
Aquí está la ficha técnica, tomada de la página del modelo y no del texto de marketing.
| Especificación | Claude Mythos 5.1 |
|---|---|
| ID del modelo | claude-mythos-5-1 |
| Lanzamiento | 1 de septiembre de 2026 |
| Estado | Activo, solo por invitación |
| Ventana de contexto | 1M de tokens |
| Salida máxima | 128K tokens |
| Thinking | Adaptativo, siempre activo |
| Esfuerzo predeterminado | high |
| Corte de conocimiento | Junio de 2026 |
| Latencia comparativa | Más lento |
| Entrada / salida | Texto e imágenes, a texto |
| Precio de entrada | $10 / MTok |
| Precio de salida | $50 / MTok |
| Lectura de caché | $0.25 / MTok |
| Plataformas | Claude API, Bedrock, Google Cloud, Microsoft Foundry |
| Retirada | No antes del 1 de septiembre de 2027 |
Una línea que vale la pena leer dos veces: usar Mythos 5.1 requiere aceptar por defecto una política de retención de datos de 30 días para monitoreo de seguridad. Ese es un dato real de contratación, y es la imagen especular de la historia de retención cero que Anthropic cuenta del lado de Fable.
Mythos 5.1 y Fable 5.1 son un modelo con dos cerraduras
Esta es la parte que confunde a casi todo el mundo, incluido el hilo de Hacker News el día del lanzamiento:
"Claude Mythos 5.1 is identical to Fable 5.1, but it offers more permissive safeguards for vetted individuals and organizations"
Then why does it have separate datapoints for Terminal Bench, and score higher? Something doesn't add up here??

Sí cuadra, y la respuesta es mecánica en lugar de misteriosa. Anthropic evalúa Fable 5.1 con las salvaguardas de producción activadas. Cuando esas salvaguardas se activan en una tarea de benchmark, la tarea no simplemente falla; se le entrega a un modelo distinto. Las tareas de ciberseguridad las completó Opus 4.8, las de biología Opus 5, y en OSWorld 2.0 las tareas intervenidas puntuaron un cero absoluto. Así que la cifra publicada de Fable 5.1 es la cifra de todo el sistema con salvaguardas, no de los pesos.
Mythos 5.1 son esos mismos pesos con los clasificadores de cíber y biología relajados. Esa es toda la diferencia.
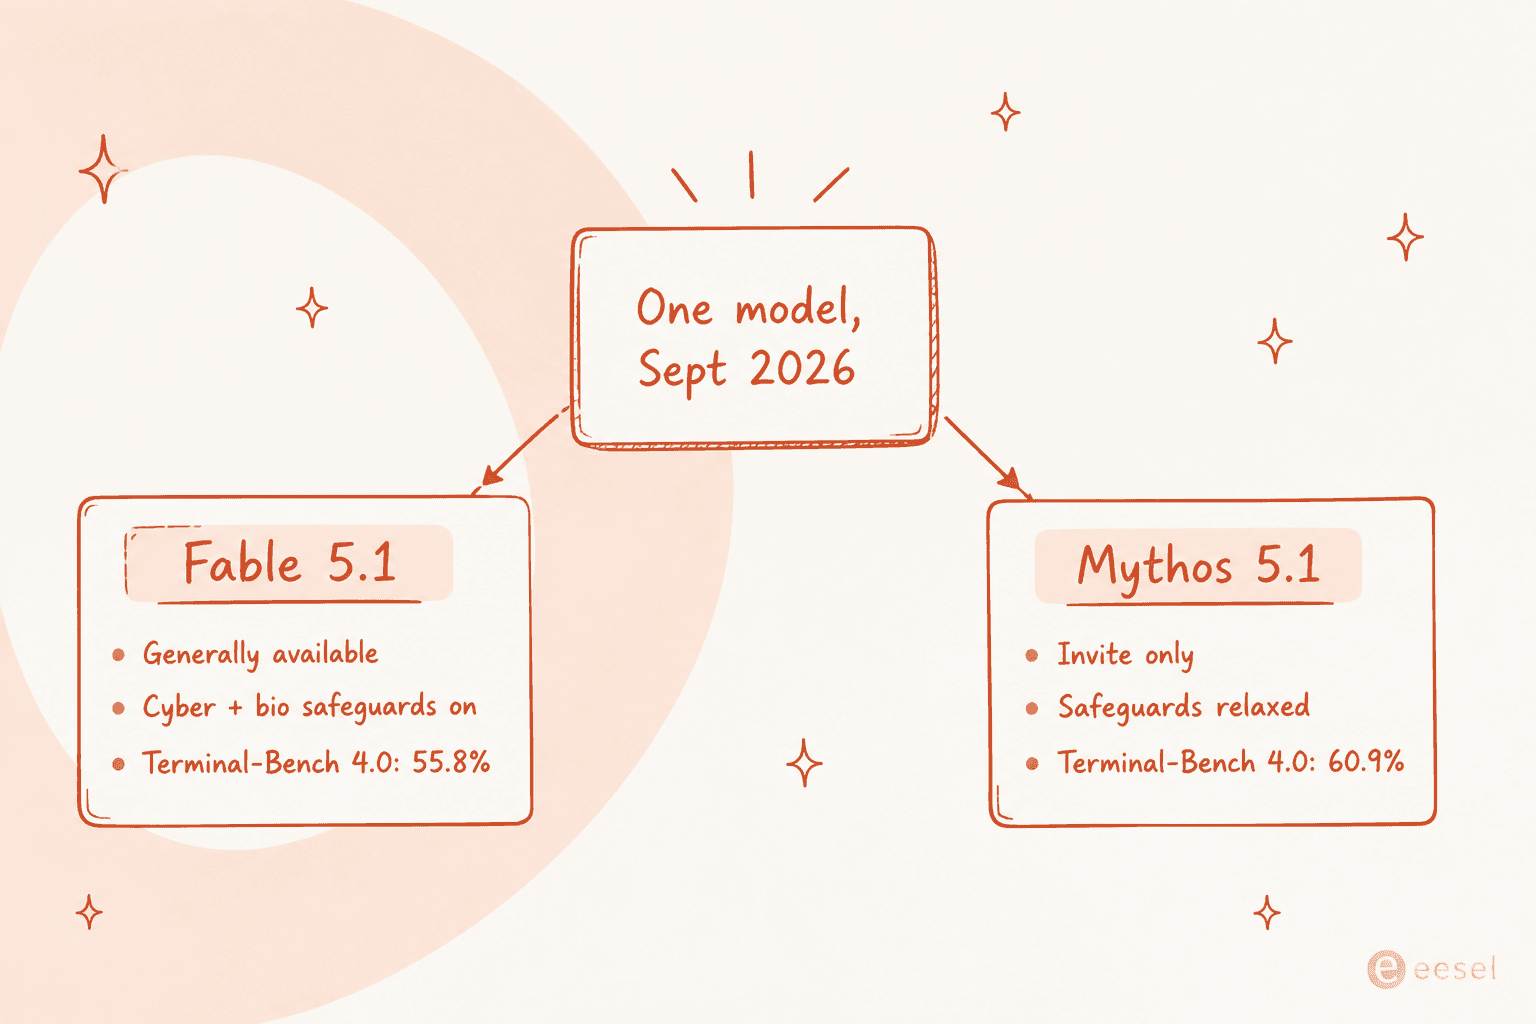
Anthropic es explícito en que espera que la brecha se reduzca. La publicación de lanzamiento señala que la diferencia en Terminal-Bench refleja las salvaguardas cibernéticas anteriores, menos precisas, y que con las mejoras de Fable 5.1 que se lanzan el mismo día, la diferencia entre ambos modelos debería ser mucho menor.
Lo que realmente cambió del lado de Fable vale la pena conocerlo incluso si nunca tocas Mythos:
- Fable 5.1 ahora puede usarse para identificar vulnerabilidades de software en el código fuente, algo que las salvaguardas anteriores bloqueaban.
- Los usuarios de Claude Code deberían ver alrededor de un 60 % menos de intervenciones de salvaguardas cibernéticas por sesión.
- Las salvaguardas de biología se activan un 85 % menos en preguntas benignas de biología elemental y medicina que las que se lanzaron con Fable 5.
- El trabajo de doble uso sigue redirigiéndose a modelos Opus: pruebas de penetración, generación de exploits y escaneo de vulnerabilidades basado en binarios.
Ese último punto es el límite honesto. Fable 5.1 leerá tu código fuente y te dirá dónde está el bug. No te escribirá el exploit.
Los benchmarks, y el que importa
Anthropic publicó las cifras de Fable 5.1 y Mythos 5.1 junto a Fable 5, Opus 5 y GPT-5.6 Sol. Las puntuaciones de abajo son de Fable 5.1 a menos que la fila indique otra cosa.
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% (60.9% Mythos 5.1) | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 (strict) | 41.7% | 36.1% | 39.6% | not published |
| Humanity's Last Exam (tools) | 65.0% | 63.8% | 63.6% | not published |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
Lo más destacado es Terminal-Bench-Science, que se más que duplicó frente a Fable 5. Todo lo demás es un paso más modesto, y el hilo de lanzamiento lo notó:
The price reduction comes from the cache read pricing falling from $1/M to $0.25/M, which means that Fable 5.1 now costs half of Opus's cache read costs ($0.5/M).
Esa lectura es justa en las filas de código y menos justa en la fila de ciencia, donde un salto de 27,9 puntos no es un artefacto de redondeo. Anthropic anota en una nota al pie un error estándar de 3,5 a 4,5 puntos por modelo en ese benchmark, lo que igualmente deja la brecha cómodamente fuera del ruido.
Las demostraciones científicas detrás de esto son la parte que de verdad capturaría en una captura de pantalla. Mythos 5.1 diseñó proteínas de unión que superaron a las mejores entradas en las competiciones de Adaptyv Bio por 10 veces en afinidad de unión para tres objetivos, con una tasa de acierto cercana al 50 % en 12 objetivos, donde entre el 10 y el 15 % es lo habitual. También escribió kernels de GPU que aceleraron siete modelos de código abierto de genómica y proteínas hasta 2,5 veces con resultados idénticos, reduciendo el coste estimado de GPU en análisis a escala del genoma entre un 30 y un 60 %. Por separado, Fable 5.1 construyó un nuevo mapa de elevación de alta resolución para un tercio de Venus a partir de datos de radar Magellan de hace 30 años.
Nada de eso es un caso de uso de soporte. Todo eso explica por qué el modelo está tras una puerta.
Precios: el recorte en la lectura de caché es la verdadera noticia
Mythos 5.1 y Fable 5.1 tienen la misma tarifa. La entrada cuesta 10 $ por millón de tokens, la salida 50 $ por millón. Eso no ha cambiado desde Fable 5.
Lo que cambió es la línea de lectura de caché, y cambió mucho.
| Medidor | Fable 5 / Mythos 5 | Fable 5.1 / Mythos 5.1 |
|---|---|---|
| Entrada base | $10 / MTok | $10 / MTok |
| Salida | $50 / MTok | $50 / MTok |
| Escritura de caché de 5 minutos | $12.50 / MTok | $12.50 / MTok |
| Escritura de caché de 1 hora | $20 / MTok | $20 / MTok |
| Lectura de caché | $1.00 / MTok | $0.25 / MTok |
| Entrada / salida por lotes | $5 / $25 | $5 / $25 |
Cualquier otro modelo de Claude fija el precio de un acierto de caché en 0,1 veces la entrada base. Fable 5.1 y Mythos 5.1 lo fijan en 0,025 veces, y la documentación de Anthropic lo señala en una nota al pie como la única excepción de la familia. Es también, como señaló el hilo mencionado, la mitad de lo que cuesta una lectura de caché en Opus 5, en un modelo que tiene el doble de precio base.
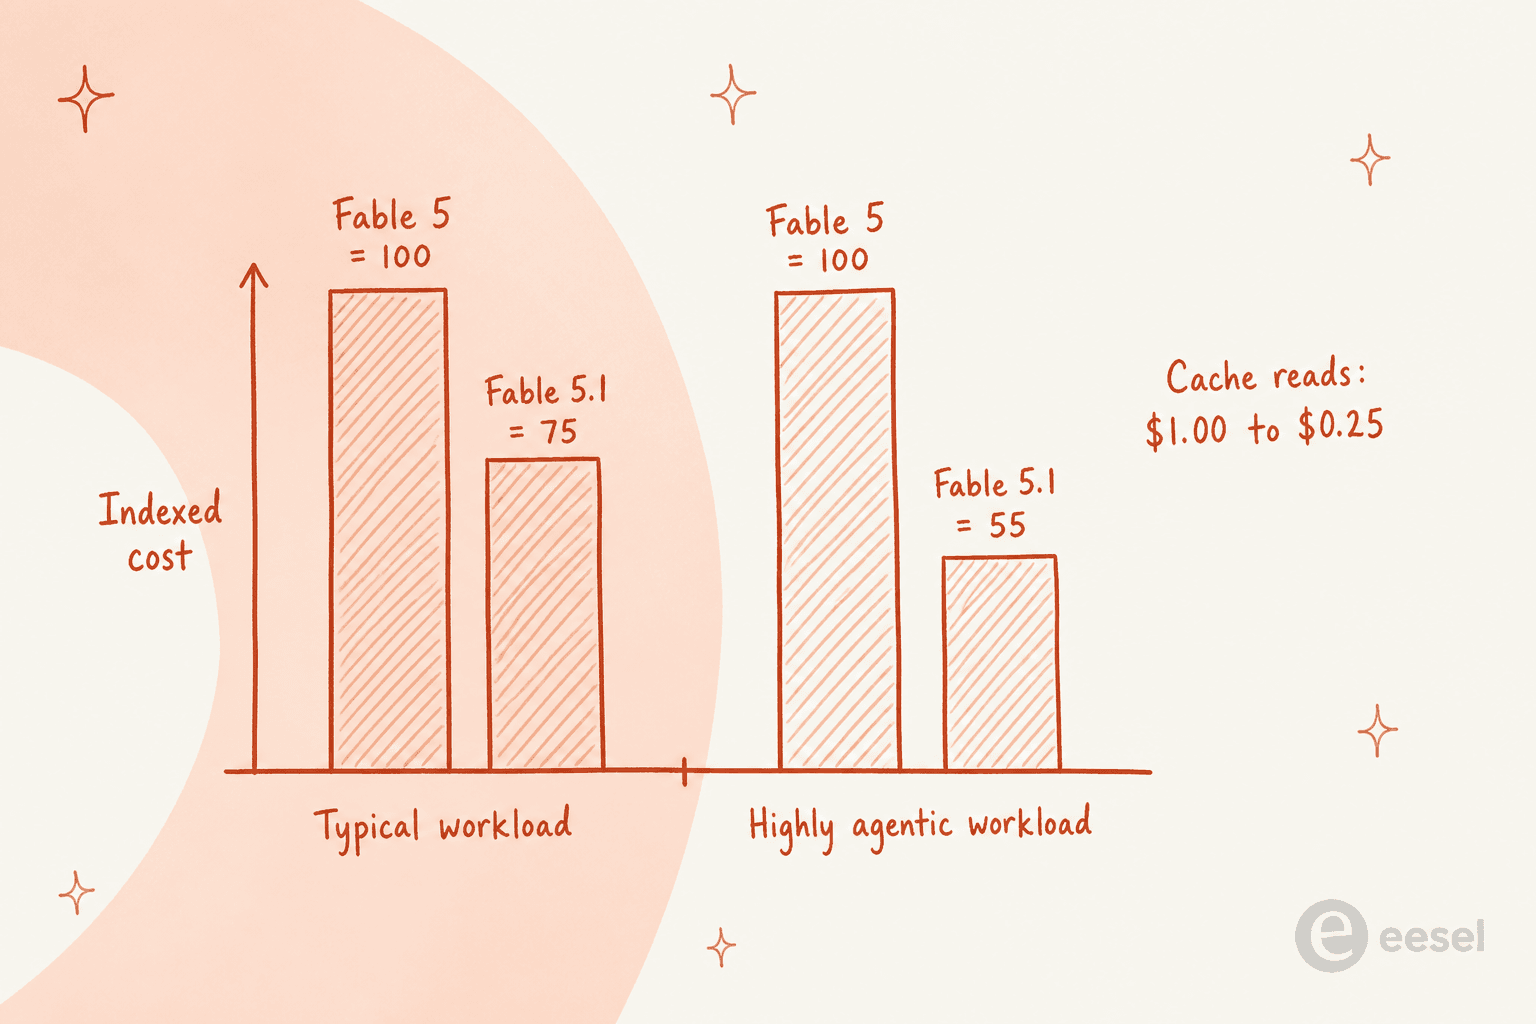
Anthropic midió esto durante cuatro semanas de uso real en agosto de 2026 con el esfuerzo predeterminado. Las cargas de trabajo típicas en Claude Enterprise, Claude Code y la API resultan alrededor de un 25 % más baratas. El trabajo agentico intensivo en contexto y herramientas, donde las lecturas de caché son la mayor parte de la factura, resulta alrededor de un 45 % más barato.
La consecuencia práctica es un cambio de planificación, no solo una factura más pequeña:
"Cache reads now cost 75% less, or $0.25 per million tokens." For me, at a typical 95% cache hit rate, I think my optimal context window size before autocompaction goes from ~200K to ~400K tokens. Great for longer horizon tasks.
Ese es todo el sentido del cambio. En una ejecución agentica larga, la transcripción se vuelve a leer en cada turno, así que el medidor de lectura de caché es el que se acumula. Si has estado comprimiendo el contexto agresivamente para mantener la factura baja, las cuentas para eso acaban de cambiar. La tarifa completa de la familia está en mi desglose de precios de la API de Anthropic, y el lado de la suscripción está en precios de Claude.
Una cosa que el recorte de precios no cambia: el contexto largo se sigue facturando de forma plana. Claude 4.6 y los modelos posteriores incluyen toda la ventana de 1M a tarifas estándar, así que una solicitud de 900 mil tokens se factura al mismo tipo por token que una de 9 mil.
Cómo funciona realmente el acceso
Dos programas, ambos verificados, ambos limitados a EE. UU. hoy en día.
Cyber Verification Program. El CVP actualmente proporciona salvaguardas cibernéticas reducidas en ciertos modelos de clase Opus y Sonnet para trabajo de seguridad defensiva. Anthropic dice que el acceso a la clase Mythos se sumará en un futuro próximo, lo cual es una promesa más que una fecha. Las solicitudes se hacen a través del portal de programas de Anthropic.
Life Sciences Verification Program. El LSVP es una beta solo por invitación, desarrollada junto con el gobierno de EE. UU., que relaja las salvaguardas de biología para investigación y desarrollo profesional mientras deja todas las demás salvaguardas en su lugar. Los primeros participantes ya están inscritos, y Anthropic dice que planea expandirse a la comunidad más amplia de ciencias biológicas.
Los clientes empresariales existentes tienen una tercera puerta: la documentación te dice que contactes a tu equipo de cuenta de Anthropic, AWS o Google Cloud. Y Claude Security, el producto de escaneo de código de Anthropic, ahora funciona sobre Mythos 5.1, que es la única forma de usar el modelo sin ser invitado a él directamente.
La razón de todo esto está en el anuncio de Glasswing de abril de 2026. Mythos Preview encontró miles de vulnerabilidades de día cero en prácticamente todos los sistemas operativos y navegadores principales, incluyendo un fallo remoto de 27 años en OpenBSD y un defecto de 16 años en FFmpeg que las pruebas automatizadas habían golpeado cinco millones de veces sin detectarlo. Anthropic comprometió 100 millones de dólares en créditos de uso y 4 millones en donaciones, e incorporó a doce socios de lanzamiento más 40 organizaciones de infraestructura adicionales, expandiéndose a unas 150 organizaciones en más de quince países para junio.
En el lado de la seguridad, la propia evaluación de Anthropic es que Mythos 5.1 tiene las capacidades cibernéticas más fuertes de cualquier modelo que haya publicado, sigue estando en la categoría de riesgo más baja de su Frontier Compliance Framework, y se queda por debajo del siguiente nivel de riesgo en la Responsible Scaling Policy. Se despliega con las mismas salvaguardas de biología que Mythos 5.
Tres cambios que romperán la integración de alguien
Vale la pena señalarlo incluso si Mythos en sí está fuera de alcance, porque estos cambios también afectan a Fable 5.1.
- El uso forzado de herramientas devuelve un error. Si tu código configura
tool_choiceenanyo en una herramienta con nombre, esa llamada ahora falla. Este es el que más probablemente hará saltar una alerta a alguien. - Los bloques de thinking están vinculados al modelo que los produjo. Los modelos anteriores no pueden leer los bloques de thinking de Fable 5.1 o Mythos 5.1, y editar un turno anterior los invalida.
- La anti-destilación cambia la edición multi-turno. Las cuentas nuevas de API creadas desde el día del lanzamiento en adelante ya no pueden editar manualmente el contexto previo de Claude conservando la transcripción de su thinking anterior. Las cuentas existentes no se ven afectadas por ahora, pero el cambio se aplicará a todos en futuros lanzamientos de modelos.
También hay un cambio de cumplimiento con una larga cola. Para cumplir con el Código de Prácticas sobre Transparencia de Contenido Generado por IA de la Ley de IA de la UE, los modelos lanzados después del 2 de agosto de 2026 llevan una marca de agua de texto, con una API de detección en vista previa privada para reguladores, investigadores y empresas obligadas. Anthropic dice que es invisible sin la API de detección y no lleva información sobre el usuario ni sus conversaciones. Fue lo que más polémica generó en el hilo de lanzamiento, algo que vale la pena saber si tu flujo de contenido tiene una opinión sobre la procedencia. Mis notas sobre contenido de IA y E-E-A-T cubren el lado de la publicación de eso.
Qué usar en su lugar, según el trabajo
Casi todos los que leen esto están eligiendo entre modelos que realmente pueden usar. Así lo dividiría yo.
- Techo de frontera, disponible hoy. Fable 5.1. Mismos pesos que Mythos 5.1, mismo precio, sin lista de espera. Contexto en qué es Claude Fable 5 y el relanzamiento de Fable 5.
- Caballo de batalla predeterminado. Opus 5 a 5 $ de entrada y 25 $ de salida. La propia documentación de Anthropic sigue diciendo que hay que empezar la mayoría de las cargas de trabajo aquí y subir solo cuando tus evaluaciones se queden cortas. La reseña de Opus 5 tiene mi veredicto, y los precios de Opus 5 tienen las tablas.
- Trabajo sensible a la latencia. Sonnet 5 a 2 $ de entrada y 10 $ de salida, con la misma ventana de 1M. Los precios de Sonnet 5 y la reseña de Sonnet 5 profundizan más.
- Agentes de codificación. El nivel de esfuerzo mueve tu factura más que el nivel del modelo. La selección de modelos de Claude Code y los precios de Claude Code son los dos que hay que leer.
- Orquestación de larga duración. Claude Managed Agents factura el tiempo de ejecución de la sesión además de los tokens, algo que el recorte de lectura de caché no toca.
- Sopesar todo el panorama. Alternativas a Claude y alternativas a Opus 5 si no estás atado a Anthropic, además de GPT-5.6 frente a Claude para la comparación directa.
Si el trabajo son conversaciones con clientes en lugar de código o investigación, la cuestión del nivel es casi irrelevante. Mi resumen del mejor modelo para tickets de soporte recorre el verdadero compromiso, y modelos de IA personalizados explica cuándo vale la pena entrenar el tuyo propio.
Lo que un modelo de frontera no arregla en una cola de soporte
Quiero ser cuidadoso aquí, porque los resultados de Mythos 5.1 son reales y la ciencia es difícil de rebatir. Pero hay un patrón de fallo que he visto suficientes veces como para ponerle nombre.
Un equipo lee una publicación de lanzamiento, actualiza el modelo detrás de su bot de soporte, y espera que la tasa de resolución se mueva. No lo hace. Lo que mueve la tasa de resolución es si el modelo puede ver el conocimiento correcto, si sabe cuándo detenerse y transferir, y si alguien lo probó contra tickets reales antes de que un cliente lo viera. Ninguno de esos son problemas de nivel de modelo.
La mitad de esto relacionada con la confianza es la que cuesta dinero. Como lo expresó una responsable de CX de una marca de suplementos DTC en una llamada de ventas:
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Eso es un problema de alcance y control, y una puntuación de 60,9 % en Terminal-Bench no tiene nada que decir al respecto. Tampoco lo tiene la vía de construirlo tú mismo, donde acaban muchos equipos tras un lanzamiento como este. Karel de GENERAL BYTES planteó el compromiso con claridad:
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
La clave de la API es la parte barata. La recuperación, los límites de permisos, las reglas de escalado, el sistema de evaluación, y el mantenimiento de las cuatro cosas a medida que tu producto cambia son la parte cara. Ese trabajo no se abarata porque las lecturas de caché sí lo hayan hecho.
Dónde encaja eesel
eesel vende compañeros de equipo de IA, no un modelo. El compañero de equipo de IA para helpdesk se une a la cola que ya gestionas, lee el centro de ayuda y los tickets pasados que ya tienes, y responde dentro del alcance que definas. El redactor de blog con IA hace el mismo trabajo para el contenido. Ambos llegan con las integraciones y el contexto de empresa para su función, que es exactamente la capa que un modelo de frontera en bruto no incluye.

Lo concreto que señalaría, dado el tema de este artículo: antes de que un compañero de equipo de eesel responda a un solo cliente real, se ejecuta contra tus propios tickets históricos para que veas qué habría dicho. Esa es la prueba en seco que nadie obtiene de un lanzamiento de modelo, y es la diferencia entre lanzar una mejora y lanzar una suposición. Se conecta con Zendesk, Freshdesk, Gorgias, Front, Help Scout y HubSpot en minutos, y es gratis probarlo.
Perseguir Mythos 5.1 para una cola de soporte es optimizar la única variable que nunca fue la limitación. Conectar Claude a tu helpdesk es una tarde más útil, y usar Claude para soporte es la versión honesta de lo que eso te da.
Mi veredicto sobre Claude Mythos 5.1
Es el modelo más capaz que Anthropic ha lanzado, no está disponible para ti, y la versión que sí está disponible para ti es el mismo modelo. Eso es algo inusual de poder escribir, y es el hecho más útil de todo este artículo.
Si eres un defensor cibernético o un científico de ciencias biológicas, solicítalo, porque los resultados científicos justifican el papeleo. Si eres cualquier otra persona, el lanzamiento que importa es el precio de lectura de caché de Fable 5.1, que en silencio hizo que el trabajo agentico con mucho contexto sea alrededor de un 45 % más barato. Eso cambiará más sistemas de producción este trimestre de lo que un modelo cerrado logrará jamás.
Preguntas frecuentes
¿Qué es Claude Mythos 5.1?
claude-mythos-5-1. Es el mismo modelo subyacente que Fable 5.1, entregado con salvaguardas de ciberseguridad y biología menos estrictas, y se ofrece solo por invitación a través de Project Glasswing. El artículo anterior sobre Claude Mythos explica cómo empezó la familia.¿Cuánto cuesta Claude Mythos 5.1?
¿Cómo consigo acceso a Claude Mythos 5.1?
¿Cuál es la diferencia entre Claude Mythos 5.1 y Claude Fable 5.1?
¿Está Claude Mythos 5.1 disponible en Bedrock o Google Cloud?
claude-mythos-5-1 en cada una. Estar en la plataforma no es lo mismo que poder llamarlo, ya que la invitación sigue siendo necesaria.¿Qué debería usar en lugar de Claude Mythos 5.1?
¿Claude Mythos 5.1 tiene una ventana de contexto de 1M?
high. Anthropic factura toda la ventana a tarifas estándar, así que una solicitud de 900 mil tokens cuesta lo mismo por token que una de 9 mil. El tamaño de la ventana de contexto de Claude Code explica lo que eso significa en el día a día.¿Es seguro usar Claude Mythos 5.1 con datos de clientes?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.