Resumen
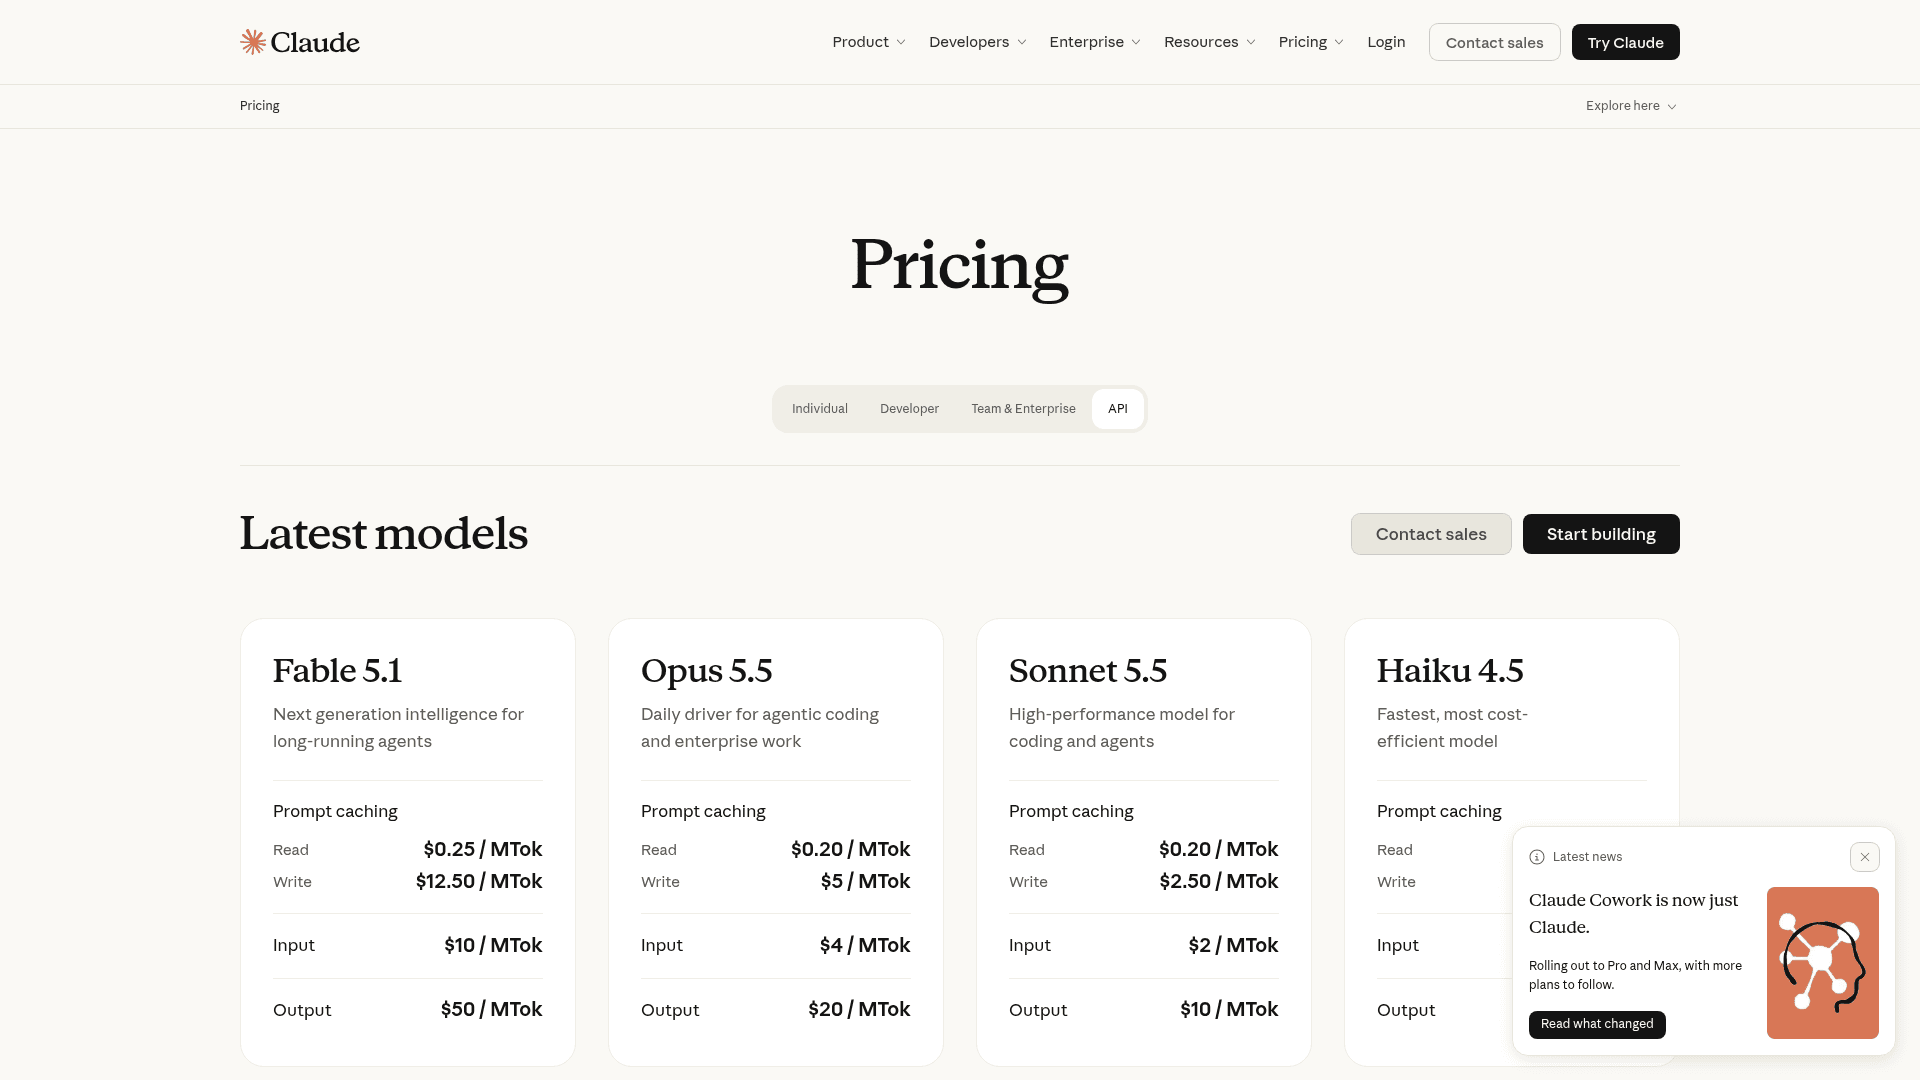
Claude Sonnet 5.5 cuesta 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida, igual que Sonnet 5 y exactamente la mitad que Claude Opus 5.5 en entrada, salida, escrituras de caché y Batch. No hay recargo por contexto largo en toda la ventana de 1M, y está incluido en el plan gratuito de Claude.
El inconveniente es la única línea que no cuesta la mitad. Las lecturas de caché cuestan 0,20 $ por millón tanto en Sonnet 5.5 como en Opus 5.5. En las pruebas de Artificial Analysis, las lecturas de caché supusieron el 40 % de la factura de Sonnet 5.5 con esfuerzo máximo, y con esa configuración costó 7,60 $ por tarea frente a los 5,98 $ de Opus 5.5. Con esfuerzo Low y Medium, Sonnet 5.5 es la opción barata y rápida que dice ser. Por encima de High, Opus 5.5 en Medium suele darte la misma puntuación por menos dinero.
En eesel yo escribo el código de integración que envía estas llamadas a la API, así que leo las tarifas por la línea que acaba en la factura. Si estás calculando el coste de Sonnet 5.5 para una cola de soporte, eesel ejecuta modelos como este dentro de un compañero de helpdesk con IA que factura por ticket gestionado, de modo que el mando del esfuerzo nunca aparece en tu factura.
Precios de Claude Sonnet 5.5 de un vistazo
Claude Sonnet 5.5 se lanzó el 28 de septiembre de 2026 y Anthropic mantuvo el precio. Esta es la tarifa completa de la API de la documentación de precios de Claude, por millón de tokens, junto a sus dos hermanos más cercanos:
| Precio por 1M de tokens | Claude Sonnet 5.5 | Claude Opus 5.5 | Claude Haiku 4.5 |
|---|---|---|---|
| Entrada | $2 | $4 | $1 |
| Salida (razonamiento incluido) | $10 | $20 | $5 |
| Escritura de caché de 5 minutos | $2.50 | $5 | $1.25 |
| Escritura de caché de 1 hora | $4 | $8 | $2 |
| Lectura de caché | $0.20 | $0.20 | $0.10 |
| Batch entrada / salida | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Fast mode | No disponible | $8 / $40 | No disponible |
| Ventana de contexto | 1M | 1M | 200K |
| Salida máxima | 128K (300K en beta de Batch) | 128K (300K en Batch) | 64K |
| Recargo por contexto largo | Ninguno | Ninguno | n/a |
Algunos detalles de esa tabla importan más de lo que parece a primera vista:
- El razonamiento se factura como salida. Sonnet 5.5 usa razonamiento adaptativo, así que cada token de razonamiento cuesta 10 $ por millón, igual que la respuesta.
- El esfuerzo por defecto de la API es
high, según la descripción general del modelo. Las apps de Claude y Claude Code usan Medium por defecto. Ese único ajuste cambia tu factura más que cualquier otra cosa de esta página. - El prompt mínimo cacheable es de 512 tokens, así que incluso un prompt de sistema de soporte corto se puede cachear.
- El tokenizador no cambia respecto a Sonnet 5, de modo que el mismo texto produce el mismo número de tokens. Cualquier ahorro viene de que el modelo escribe menos, no de un conteo más amable.
Si vienes de la generación anterior, nada en el precio de lista se movió respecto a los precios de Sonnet 5, y sigue por debajo de los 3 $ y 15 $ de Claude Sonnet 4.6. Lo que Anthropic defiende es que la factura baja igualmente, porque el modelo termina el mismo trabajo con menos tokens.
La mitad del precio de Opus en todas las líneas menos una
Esta es la parte que omiten la mayoría de los resúmenes de precios. Sonnet 5.5 cuesta exactamente la mitad que Claude Opus 5.5 en entrada, salida, escrituras de caché y Batch. En lecturas de caché no es más barato en absoluto.
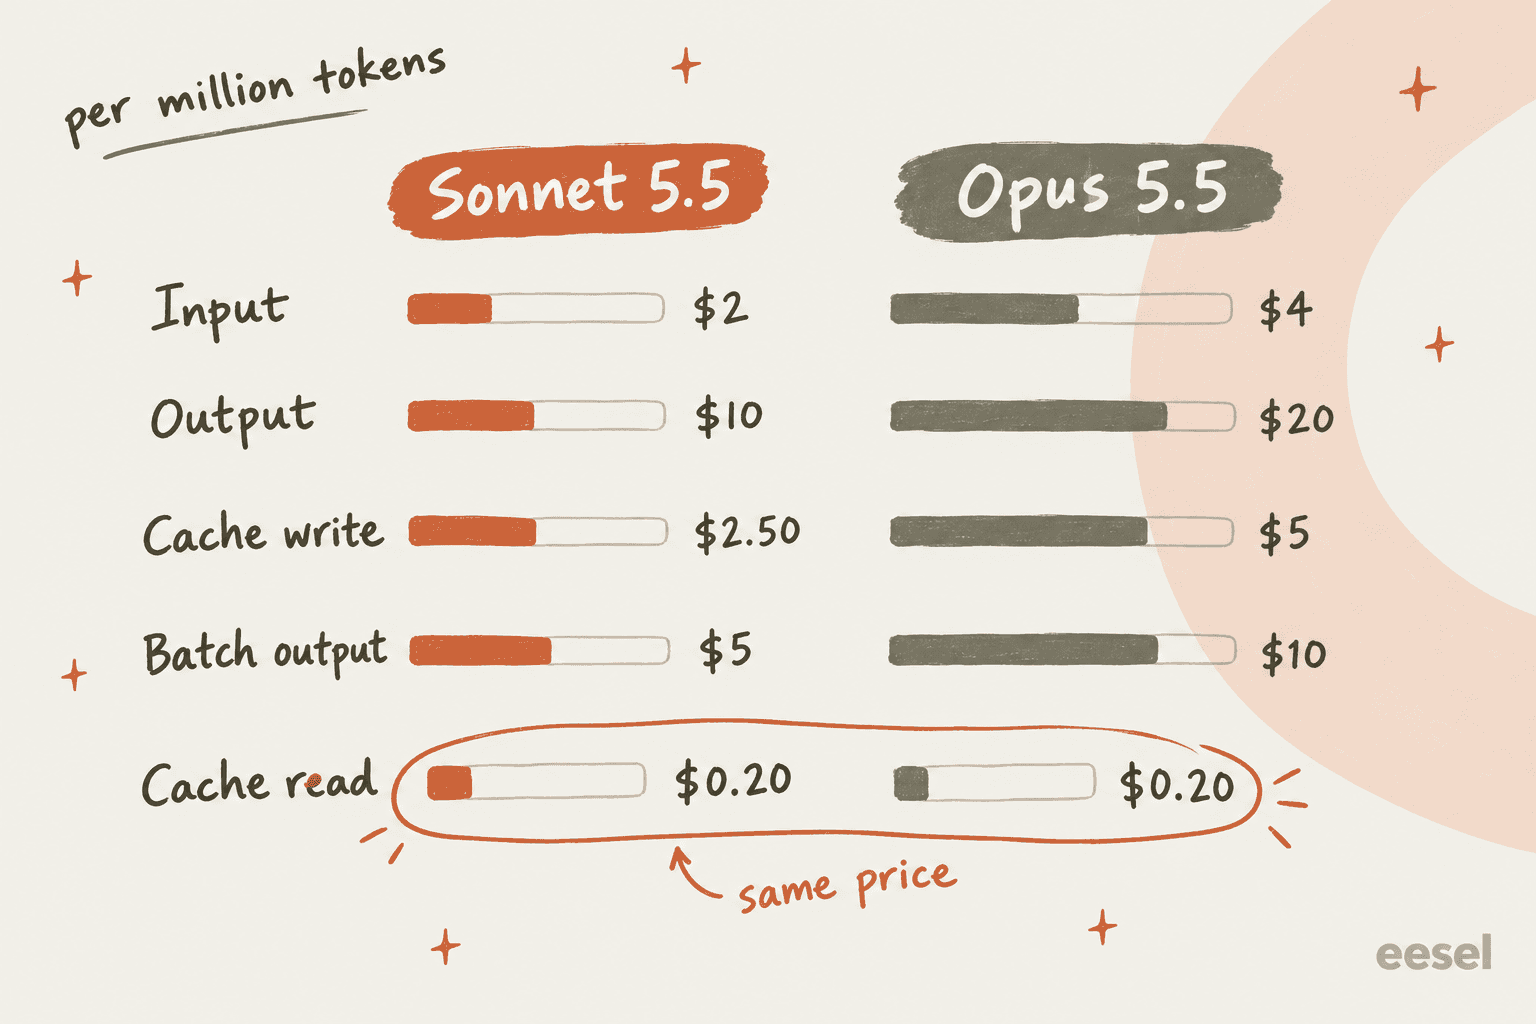
Eso ocurrió porque Opus 5.5 recibió una caché inusualmente barata. Su multiplicador de lectura de caché es 0,05x de la entrada, mientras que Sonnet usa el estándar de 0,1x, según la tabla de prompt caching. La entrada de Opus cuesta 4 $, así que 0,05x da 0,20 $. La entrada de Sonnet cuesta 2 $, así que 0,1x también da 0,20 $. El mismo número por dos caminos.
Para un chatbot que envía un prompt y recibe una respuesta, esto apenas importa, pero para un agente importa bastante. Cada turno de un bucle de agente reenvía toda la conversación hasta ese momento, y con la caché activada, la mayor parte de ese reenvío se factura como lecturas de caché. Cuanto más dura la sesión, más crece esa línea, y es la única línea en la que elegir el modelo más pequeño no te ahorra nada.
La comunidad lo detectó el día del lanzamiento:
"Cache read is the same as Opus as well where most agentic workflow cost comes from. Not quite sure where this fits well."

Lo que cuesta realmente una ejecución real
Una tarifa te dice el precio de un token. No te dice cuántos tokens gasta un modelo para terminar un trabajo, y ahí es donde Sonnet 5.5 se vuelve interesante. Artificial Analysis ejecutó su Intelligence Index en cada nivel de esfuerzo y publicó el coste medido por tarea.
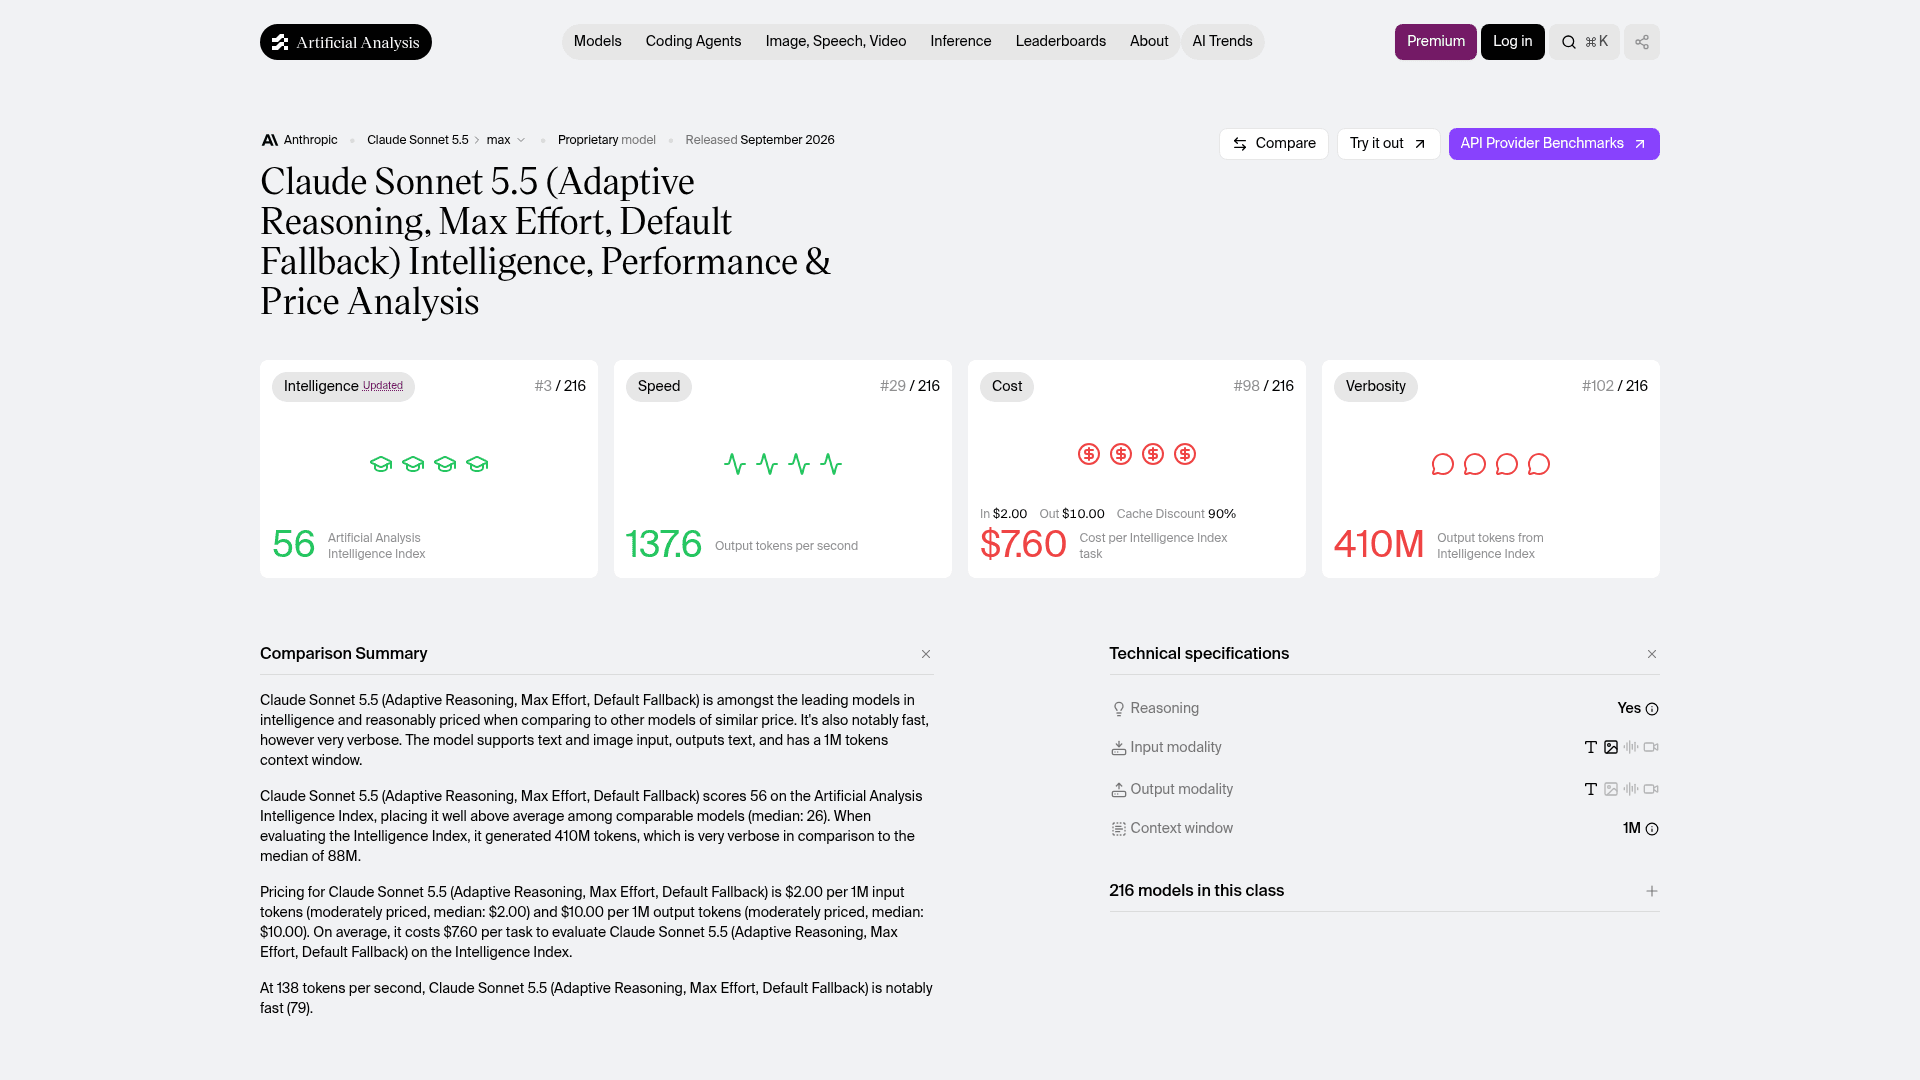
La página es contundente con el coste. Con esfuerzo máximo, Sonnet 5.5 generó 410M de tokens de salida en todo el índice frente a una mediana de su clase de 88M, y el propio resumen de AA lo califica de "very verbose". Aquí está la escalera completa de la página de Sonnet 5.5 de AA, junto a las filas equivalentes de su página de Opus 5.5:
| Esfuerzo | Puntuación Sonnet 5.5 | Coste por tarea Sonnet 5.5 | Tokens de salida por tarea | Puntuación Opus 5.5 | Coste por tarea Opus 5.5 |
|---|---|---|---|---|---|
| Low | 36 | $0.41 | 13.9k | 42 | $0.55 |
| Medium | 41 | $0.59 | 19.5k | 51 | $1.34 |
| High | 47 | $1.08 | 34.5k | 54 | $1.82 |
| Xhigh | 52 | $2.74 | 73.7k | 56 | $3.46 |
| Max | 56 | $7.60 | 192.8k | 58 | $5.98 |
Si lees la columna de Sonnet hacia abajo, el coste se duplica más o menos en cada paso por encima de Medium, y casi se triplica al pasar de Xhigh a Max. Si lees en horizontal, el patrón se invierte alrededor de High. Sonnet 5.5 con esfuerzo máximo cuesta un 27 % más por tarea que Opus 5.5 con esfuerzo máximo, con dos puntos menos de puntuación. Usó 193k tokens de salida por tarea ahí, frente a los 119k de Opus.
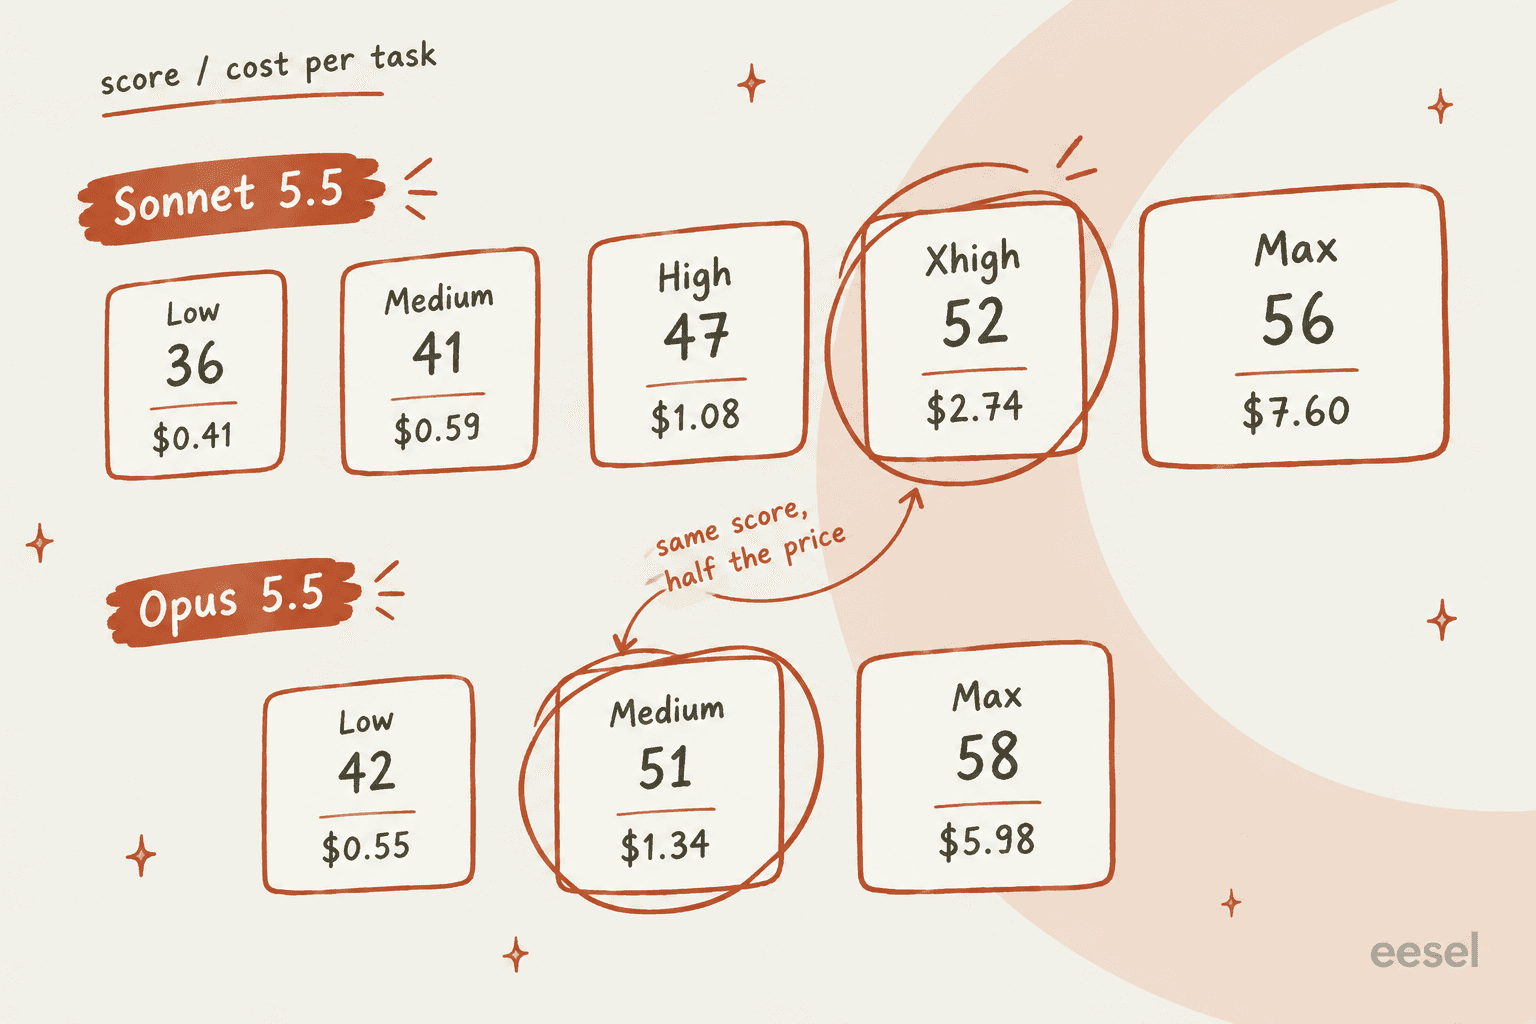
La pareja en la que yo me fijaría es Sonnet Xhigh frente a Opus Medium. Puntúan 52 y 51, y Opus cuesta 1,34 $ frente a los 2,74 $ de Sonnet. Si te encuentras subiendo Sonnet 5.5 por encima de High para conseguir la calidad que necesitas, acabas pagando más de lo que pagarías por el modelo grande en su configuración por defecto.
Esta es también la lectura honesta de la afirmación de Anthropic de "hasta un 30 % menos por tarea". La publicación de lanzamiento dice que Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings, where it costs less per task. At higher settings, it can perform comparably at a similar cost." Los números de AA lo confirman al pie de la letra.
Adónde va el dinero en la factura de un agente
AA también desglosa el coste de cada ejecución por tipo de token, y aquí es donde la línea de lectura de caché de antes deja de ser teórica. En la ejecución completa del Intelligence Index con esfuerzo máximo, la factura de Sonnet 5.5 fue de 8.977 $:
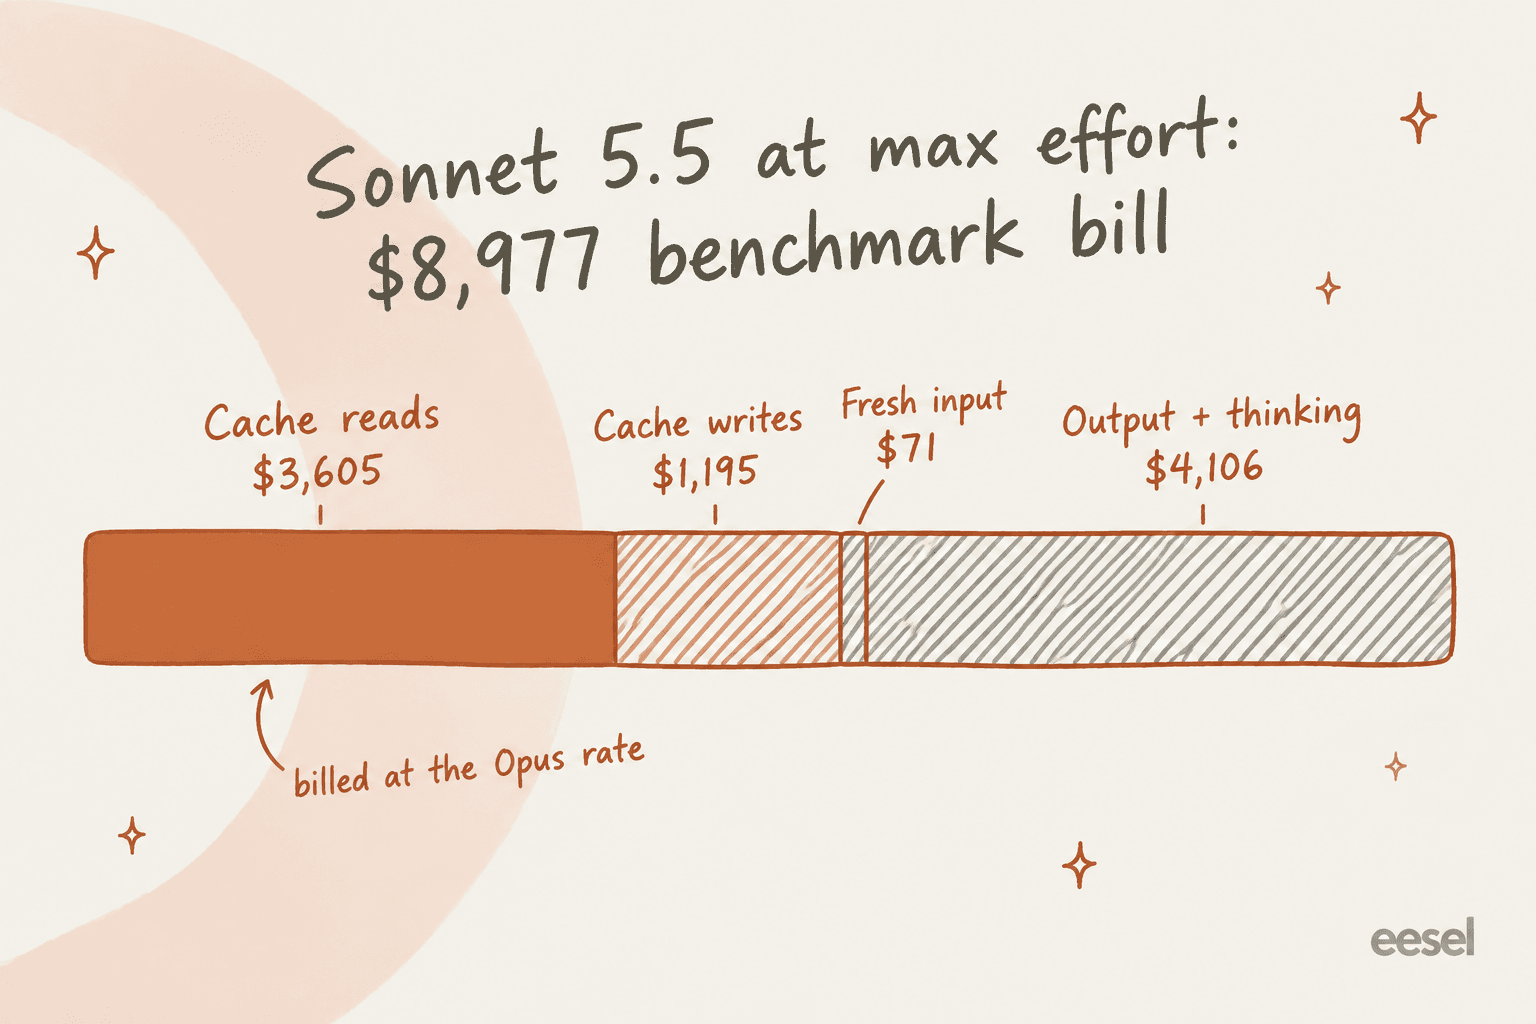
| Concepto | Sonnet 5.5 en Max | Porcentaje | Sonnet 5.5 en Medium | Porcentaje |
|---|---|---|---|---|
| Lecturas de caché | $3,605 | 40% | $180 | 26% |
| Escrituras de caché | $1,195 | 13% | $155 | 22% |
| Entrada nueva | $71 | 1% | $70 | 10% |
| Salida y razonamiento | $4,106 | 46% | $295 | 42% |
| Total | $8,977 | $701 |
De aquí saltan a la vista dos cosas. La entrada nueva, la línea que la mayoría imagina al pensar en "tokens de entrada", es casi nada, porque casi todos los tokens de entrada en una ejecución de agente son una lectura o una escritura de caché. Y las lecturas de caché, la línea sin descuento en Sonnet, pasan de una cuarta parte de la factura en Medium al 40 % en Max, porque pensar más tiempo significa más turnos y más relecturas.
Si pones ambos modelos lado a lado en la misma ejecución, la brecha se cierra, que es la misma historia que contaba la comparativa anterior de Opus 5 vs Sonnet 5. En Medium, la ejecución del índice con Sonnet 5.5 costó 701 $ frente a los 1.627 $ de Opus 5.5, así que Sonnet fue el 43 % de la factura de Opus. En Max, Sonnet costó 8.977 $ frente a los 8.708 $ de Opus. La mitad del precio de lista, un 3 % más en la factura.
Ejemplos resueltos con tres tipos de carga de trabajo
Los benchmarks son la carga de trabajo de otro, así que aquí va la cuenta según la tarifa para tres formas habituales, usando solo los precios publicados. Toma los recuentos de tokens como ilustrativos y pon los tuyos en la calculadora de abajo.
1. Un bot de respuestas de soporte. Cada respuesta envía 8.000 tokens de entrada, 6.000 de ellos un prompt de sistema y artículos de ayuda en caché, y recibe 1.500 tokens de vuelta incluyendo el razonamiento.
- Sonnet 5.5: 0,004 $ de entrada nueva + 0,0012 $ de lecturas de caché + 0,015 $ de salida = unos 2 céntimos por respuesta, o 202 $ por 10.000 tickets
- Opus 5.5: 0,008 $ + 0,0012 $ + 0,03 $ = unos 3,9 céntimos, o 392 $ por 10.000
- Haiku 4.5: 0,002 $ + 0,0006 $ + 0,0075 $ = alrededor de 1 céntimo, o 101 $ por 10.000
Aquí domina la salida, así que la mitad de precio de Sonnet en salida se traslada casi por completo. Esta es la forma en la que Sonnet 5.5 es claramente mejor compra que Opus. Para ver el panorama más amplio de lo que cuesta el soporte con IA más allá del modelo, consulta la guía de coste del servicio de atención al cliente con IA.
2. Una sesión larga de agente. Imagina un agente de programación u operaciones que ejecuta 30 turnos, relee un contexto de 60.000 tokens desde la caché en cada turno, añade 3.000 tokens nuevos y escribe 2.000 por turno.
- Sonnet 5.5: 0,36 $ de lecturas de caché + 0,18 $ de entrada nueva + 0,60 $ de salida = 1,14 $
- Opus 5.5: 0,36 $ + 0,36 $ + 1,20 $ = 1,92 $
Ahora supón que Sonnet necesita 40 turnos donde Opus necesita 25, que es la dirección que apuntan los recuentos de tokens de AA con más esfuerzo. Sonnet pasa a 0,48 $ + 0,24 $ + 0,80 $ = 1,52 $, y Opus pasa a 0,30 $ + 0,30 $ + 1,00 $ = 1,60 $. El modelo de "mitad de precio" queda ahora a 8 céntimos del caro.
3. Un trabajo Batch nocturno. Extraes campos de 10.000 documentos con 20.000 tokens de entrada y 1.000 de salida cada uno, y nada necesita respuesta en tiempo real.
- Sonnet 5.5 en Batch: 200 $ de entrada + 50 $ de salida = 250 $
- Opus 5.5 en Batch: 400 $ + 100 $ = 500 $
- Haiku 4.5 en Batch: 100 $ + 25 $ = 125 $
No hay relecturas de caché ni bucle de agente, así que la proporción de 2x se mantiene bastante limpia. Batch además se puede combinar con el prompt caching, según la documentación de precios.
Calcula tu propia factura mensual
Define el número de tokens por tarea de tu carga de trabajo y mira lo que cuesta cada modelo al mes. Las escrituras de caché se dejan fuera por simplicidad, ya que con una caché caliente son una parte pequeña de una carga estable.
Si el preset de agente te sorprende, es la línea de lectura de caché haciendo su trabajo. Con 1,8M de tokens en caché por sesión, Sonnet y Opus pagan los mismos 0,36 $ por las relecturas, y solo la línea de salida los mantiene separados.
El esfuerzo es el mando del precio, y el valor por defecto de la API es high
Anthropic te deja fijar el esfuerzo por solicitud, y es la palanca más grande sobre una factura de Sonnet 5.5. Simon Willison ejecutó el mismo prompt de SVG en cada nivel y publicó los costes en el hilo del lanzamiento:
| Esfuerzo | Coste de un prompt | Tiempo |
|---|---|---|
| Low | 1,6 céntimos | 10s |
| Medium | 1,8 céntimos | 11s |
| High | 2,3 céntimos | 17s |
| Xhigh | 5,7 céntimos | 41s |
| Max | $1.28 | 15m 40s, y falló |
En Max, el modelo, en sus palabras, "burned through 128,000 thinking tokens (taking 15 minutes to do that) and ran out before it had produced the final SVG". Eso es un salto de coste de 80 veces de Low a Max para un resultado peor.
Mi consejo práctico, como alguien que integra estas llamadas en código de producción:
- Fija el esfuerzo de forma explícita en cada solicitud. El valor por defecto de la API es
high, no el Medium que ves en las apps, así que una integración ingenua empieza un escalón por encima de la zona barata. - Empieza en Low para el trabajo rutinario como clasificación, etiquetado y respuestas cortas, y sube solo donde tus evaluaciones muestren una brecha real.
- Trata Xhigh y Max como una señal para cambiar de modelo. Pasado High, Opus 5.5 en Medium tiende a superar a Sonnet en puntuación y en precio.
- Repite tus pruebas de esfuerzo si migras desde Sonnet 5. Anthropic recalibró los niveles en la página de novedades, así que los ajustes antiguos no se trasladan.
La ventaja es grande en la parte baja del dial. AA midió Sonnet 5.5 en Medium con una puntuación de 41 por 0,59 $ por tarea, frente a Claude Sonnet 5 en Max con una puntuación de 38 por 5,09 $. Es un mejor resultado por aproximadamente una novena parte del coste, que es la historia de mejora que vende Anthropic, y se sostiene.
Descuentos, extras y las partidas pequeñas
Más allá del esfuerzo, cuatro modificadores cambian el precio por token, todos de la documentación de precios de Claude:
| Modificador | Efecto en Sonnet 5.5 | Notas |
|---|---|---|
| Prompt caching | Lecturas a $0.20 (0,1x), escrituras a $2.50 (5 min) o $4 (1 hora) | Se amortiza tras una lectura en la caché de 5 minutos |
| API Batch | 50 % de descuento: $1 de entrada, $5 de salida | Se combina con el caching; 300K de salida con un header beta |
| Inferencia solo en EE. UU. | 1,1x en cada categoría de token | Se activa con inference_geo: "us" |
| Fast mode | No disponible | Solo Opus 5.5, a $8 / $40 |
Las tarifas de herramientas se suman a los tokens. La búsqueda web cuesta 10 $ por cada 1.000 búsquedas, web fetch no tiene coste extra, y la ejecución de código es gratis cuando se usa junto con búsqueda o fetch web; si no, hay 1.550 horas de contenedor gratis al mes y luego 0,05 $ por hora. Sonnet 5.5 añade 286 tokens de prompt de sistema siempre que hay herramientas presentes. Las sesiones de Claude Managed Agents añaden 0,08 $ por hora de sesión en ejecución sobre las tarifas estándar de tokens.
Un coste fácil de pasar por alto: el uso forzado de herramientas (tool_choice con any o una herramienta concreta) ahora devuelve un 400 en Sonnet 5.5, según las notas de migración. No es un precio, pero si tu bot de soporte dependía de ello, el retrabajo es un coste real del cambio. La publicación principal repasa los cinco cambios incompatibles.
Claude Free, Pro, Max, Team y Enterprise
Si usas Sonnet 5.5 en las apps de Claude en lugar de la API, pagas por puesto, no por token. Desde la página de precios de Claude:
| Plan | Precio | Acceso a Sonnet 5.5 | Notas |
|---|---|---|---|
| Free | $0 | Sí | Anthropic dice "anyone can chat with Claude using Sonnet 5.5" |
| Pro | $17/mes con facturación anual, $20 mensual | Sí | Añade Opus y créditos de uso |
| Max 5x / 20x | Desde $100/mes | Sí | 5x o 20x el uso de Pro, acceso prioritario |
| Team estándar | $20/puesto/mes anual, $25 mensual | Sí | Para 2 a 150 personas |
| Team premium | $100/puesto/mes anual, $125 mensual | Sí | 5x el uso del puesto estándar |
| Enterprise | $20/puesto/mes más uso a tarifas de API | Sí | El uso se factura a las tarifas por token de arriba |
Dos cosas cambian la cuenta aquí. En Free y Pro, Sonnet es el modelo que la mayoría usará de verdad, y los usuarios gratuitos ahora tienen Sonnet 5.5. En Enterprise, la cuota por puesto es solo el comienzo, porque el uso se factura a las mismas tarifas de API que este artículo entero. La guía de precios de Claude y el desglose de Claude Pro cubren los límites de uso, y la guía de precios de Claude Code cubre el lado del desarrollador, donde el esfuerzo Medium es el valor por defecto.
Un desarrollador el día del lanzamiento resumió bien la división entre suscripción y API:
"Sonnet 5.5 might not be useful or necessary in a Claude Code session but it could be good value in the API when you pay per token."
Bedrock, Google Cloud y Foundry
Sonnet 5.5 salió en todas las nubes principales el primer día, como anthropic.claude-sonnet-5-5 en Amazon Bedrock y claude-sonnet-5-5 en Google Cloud y Microsoft Foundry, según la descripción general del modelo. Cómo te facturan depende de la puerta por la que entres:
- Amazon Bedrock y Google Cloud los opera el socio. Te facturan directamente a sus propias tarifas publicadas, así que revisa los precios de Bedrock antes de dar por hecha la paridad. Google también publica sus propias tarifas de Vertex AI.
- Claude Platform on AWS y Claude in Microsoft Foundry los opera Anthropic. Valoran tu uso a los precios estándar de Anthropic, aplican cualquier descuento negociado y lo convierten a Claude Consumption Units a 0,01 $ cada una, facturadas por horas a mes vencido a través del marketplace.
- La inferencia solo en EE. UU. lleva el mismo multiplicador de 1,1x en la API propia, Claude Platform on AWS y los despliegues de US Data Zone de Foundry.
Si ya ejecutas Claude a través de una nube, la guía de Bedrock y la guía de Vertex AI cubren la configuración.
Cómo se compara Sonnet 5.5 con GPT-6 Sol y Gemini 3.8 Flash
La comparación más llamativa no está dentro de la gama de Anthropic. GPT-6 Sol tiene una tarifa principal idéntica: 2 $ de entrada, 10 $ de salida, 0,20 $ de entrada en caché, 2,50 $ de escritura de caché, según el desglose de los precios de GPT-6 Sol.
| Por 1M de tokens | Claude Sonnet 5.5 | GPT-6 Sol | Gemini 3.8 Flash |
|---|---|---|---|
| Entrada | $2 | $2 | $0.75 (sube a $1.50 el 1 ene. 2027) |
| Salida | $10 | $10 | $3.75 (sube a $7.50) |
| Lectura de caché | $0.20 | $0.20 | $0.075 |
| Prima por contexto largo | Ninguna hasta 1M | Tarifa mayor por encima de 272K de entrada | Ninguna |
| Coste por tarea en AA (configuración) | $1.08 (high) | $1.05 (max) | No comparable |
| AA Intelligence Index | 47 (high) | 48 (max) | No comparable |
Las filas de AA lo delatan. Sonnet 5.5 en High y GPT-6 Sol en max quedan con casi la misma puntuación por casi el mismo coste por tarea. La diferencia está más en los extremos: Sonnet no tiene recargo por contexto largo, así que un agente de soporte que carga una gran base de conocimiento en el contexto no cruza un precipicio de precio, y Sol sí lo hace por encima de 272K. Las cifras de AA de Gemini venían de una versión anterior del índice, así que las dejé fuera de la comparación directa, y los precios de Gemini 3.8 Flash se duplican en enero. La comparativa de tres APIs profundiza más si estás eligiendo proveedor en lugar de modelo.
Para tickets de soporte en concreto, la clasificación depende menos del precio que de la fiabilidad con tus propios datos, por lo que el ranking de modelos para tickets de soporte pone la precisión primero.
Lo que dicen los desarrolladores sobre el precio
La reacción el día del lanzamiento en Hacker News giró sobre todo en torno a dónde se sitúa frente a Opus. La postura escéptica:
"I feel like sonnet is priced too close to opus right now. If Sonnet 5.5 were half its current price it would make sense to use."
La postura mesurada, que coincide con la escalera de AA de arriba:
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost."
Y la entusiasta, de un usuario que lo compara con el modelo estrella de OpenAI en una configuración más baja:
"Sonnet 5.5 medium scores better than gpt 5.6 Sol high and is less than 1/5 the cost Absolutely bonkers"

El patrón al que la gente llegaba una y otra vez era una configuración dividida: Sonnet 5.5 en Low o Medium haciendo el trabajo de alto volumen como subagente, con Opus 5.5 orquestando o rematando las partes difíciles. Si ninguna de las dos opciones te encaja, el repaso de alternativas a Claude cubre otras rutas. Eso encaja con los precios, ya que el descuento de Sonnet es real en llamadas con mucha salida y contexto corto, y se difumina en bucles largos y cargados de caché.
¿Vale la pena Claude Sonnet 5.5 a 2 $ y 10 $?
Sí, con esfuerzo Low y Medium, y ahí no lo dudaría. Supera la mejor puntuación de Sonnet 5 por una fracción del coste, cuesta la mitad que Opus en la línea de salida que domina las cargas tipo chat, y no tiene recargo por contexto largo. Para un bot de respuestas de soporte, un clasificador, un paso de redacción o un trabajo Batch nocturno, es el que elegiría por defecto.
Es una compra más débil en dos casos. Si tu carga es un bucle largo de agente, las lecturas de caché se comen el descuento porque cuestan lo mismo en ambos modelos. Y si necesitas Xhigh o Max para conseguir la calidad que quieres, Opus 5.5 en Medium suele ser más barato por la misma puntuación. Prueba Sonnet en Low primero, mide, y luego decide si la diferencia justifica 1,34 $ por tarea.
Si el trabajo es una cola de soporte, hay un coste más que pertenece a la cuenta: planificar un gasto que se mueve con el esfuerzo y el volumen. Un comprador en las llamadas de ventas de eesel llegó a 200 interacciones en un solo día de prueba y se preocupó de inmediato por los costes por interacción a escala. Las facturas por tokens hacen esa preocupación más difícil de responder, porque el mismo ticket puede costar 1,6 céntimos o 1,28 $ según un ajuste.
Prueba eesel para una factura fija por ticket
Sonnet 5.5 es el motor. Si lo que quieres son tickets respondidos, eesel es el empleado: un compañero de helpdesk con IA que se conecta a Zendesk, Freshdesk, Gorgias y tus otras herramientas, aprende de tus tickets pasados y tu centro de ayuda, y te deja simularlo con tickets históricos antes de que responda a un cliente real. Nunca eliges un nivel de esfuerzo ni vigilas las lecturas de caché. Los precios de eesel son un plan fijo mensual de créditos donde un ticket o un chat gestionado es un crédito, desde 299 $ por 500 créditos, con un nivel gratuito de 100 créditos para probar.
Si trabajas desde una terminal, el CLI de eesel maneja al mismo compañero. Puedes conectar integraciones y editar sus instrucciones permanentes, y también aprobar o denegar acciones y leer su registro de actividad como JSON. Los agentes de programación como Claude Code también pueden ejecutarlo, a través del servidor MCP del workspace.

Prueba eesel y mira lo que cuesta tu cola por ticket en lugar de por token.
Preguntas frecuentes
¿Cuánto cuesta Claude Sonnet 5.5 por millón de tokens?
¿Es Claude Sonnet 5.5 más caro que Claude Sonnet 5?
¿Cuesta Claude Sonnet 5.5 la mitad que Claude Opus 5.5?
¿Cuál es la forma más barata de usar Claude Sonnet 5.5?
¿Puedo usar Claude Sonnet 5.5 gratis?
¿Cobra Claude Sonnet 5.5 un extra por contexto largo?
¿Cuánto cuesta Claude Sonnet 5.5 en Amazon Bedrock o Google Cloud?
¿Cuánto costaría Claude Sonnet 5.5 para un bot de atención al cliente?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.