

Resumen
El precio de Claude Haiku 5.5 es de 0,10 $ por millón de tokens de entrada y 0,50 $ por millón de tokens de salida, lo mismo que GPT-6 Luna y un 90 % menos que Haiku 4.5. Ese precio solo se mantiene mientras el prompt de una solicitud tenga como máximo 100.000 tokens. Por encima de ese límite, cada línea de la factura cuesta 5 veces más (0,50 $ de entrada, 2,50 $ de salida), los tokens en caché cuentan para el límite y Haiku 5.5 es el único modelo Claude actual con este tipo de precio.
Otras dos cosas mueven el coste real por tarea. El nuevo tokenizador convierte el mismo texto en cerca de un 30 % más de tokens que Haiku 4.5, y el esfuerzo (effort) determina cuánto razonamiento pagas: ejecutar la misma batería de pruebas costó 34 $ en Low y 330 $ en Max. Batch lo reduce todo a la mitad, y las lecturas de caché cuestan una décima parte de la entrada.
Para un equipo de soporte, Haiku 5.5 es un motor de clasificación muy barato si mantienes los prompts cortos. Etiquetar 20.000 tickets al mes cuesta unos 12 $, mientras que un bot de respuestas que carga 120k tokens de contexto por ticket cuesta unos 1.300 $. Si prefieres no diseñar todo alrededor del límite, el compañero de IA para helpdesk de eesel hace la clasificación y las respuestas dentro de tu helpdesk por 299 $ fijos al mes para 500 tickets.
Precios de Claude Haiku 5.5 de un vistazo
Esto es lo que noté al ver qué busca la gente tras el lanzamiento de un modelo. La búsqueda es "precios de Claude Haiku 5.5", pero el fragmento que muestra Google ya responde 0,10 $ y 0,50 $, así que lo que el usuario pregunta en realidad es cuánto le costará un mes, y en Haiku 5.5 eso depende de un número más que de ningún otro: la longitud de tus prompts.
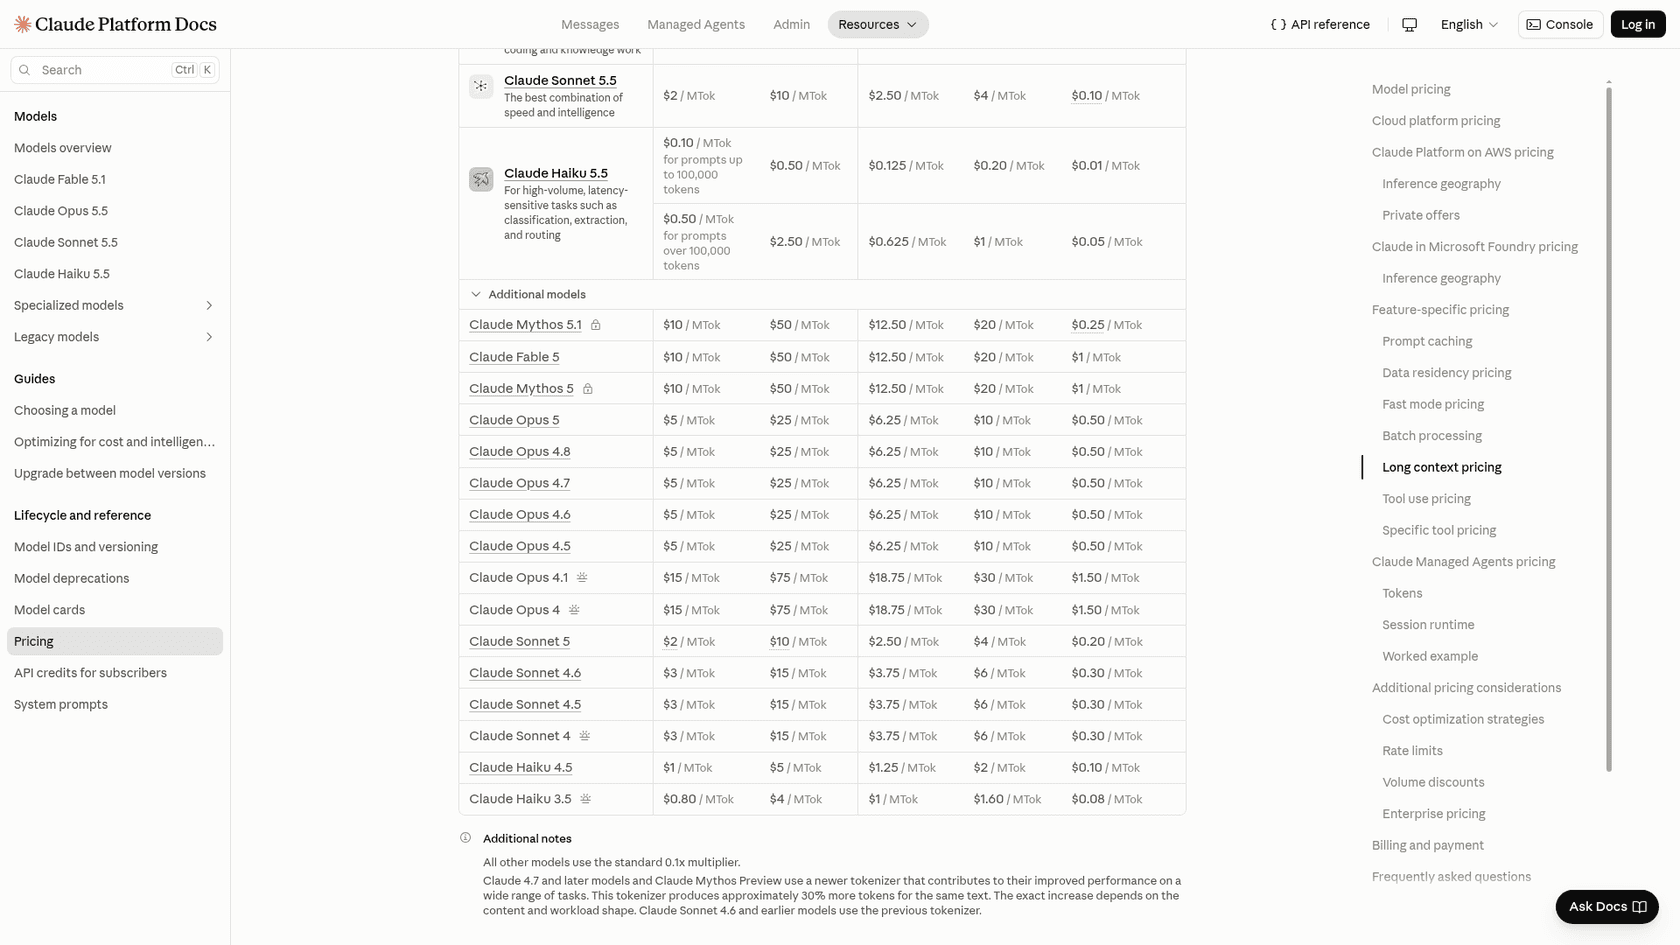
Claude Haiku 5.5 se lanzó el 7 de octubre de 2026, con el ID de modelo claude-haiku-5-5. Abajo está la tarifa completa de la API según la documentación de precios de Anthropic, por millón de tokens:
| Concepto | Prompt de hasta 100.000 tokens | Prompt de más de 100.000 tokens |
|---|---|---|
| Entrada | 0,10 $ | 0,50 $ |
| Salida (incluido el razonamiento) | 0,50 $ | 2,50 $ |
| Lectura de caché (acierto o renovación) | 0,01 $ | 0,05 $ |
| Escritura de caché de 5 minutos | 0,125 $ | 0,625 $ |
| Escritura de caché de 1 hora | 0,20 $ | 1,00 $ |
| Entrada en Batch | 0,05 $ | 0,25 $ |
| Salida en Batch | 0,25 $ | 1,25 $ |
Y así se sitúa junto a los modelos con los que realmente lo compararías:
| Modelo | Entrada | Salida | Lectura de caché | Prompts largos |
|---|---|---|---|---|
| Claude Haiku 5.5 | 0,10 $ | 0,50 $ | 0,01 $ | 5x en cada línea pasados 100k |
| Claude Haiku 4.5 | 1,00 $ | 5,00 $ | 0,10 $ | Fijo, tope de contexto de 200k |
| Claude Sonnet 5.5 | 2,00 $ | 10,00 $ | 0,10 $ | Fijo hasta 1M |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | 0,20 $ | Fijo hasta 1M |
| Claude Fable 5.1 | 10,00 $ | 50,00 $ | 0,25 $ | Fijo hasta 1M |
Hay cosas que no aparecen en la tabla y conviene señalar. No hay Fast mode para Haiku 5.5 (solo cubre los modelos Opus), y la guía de migración dice que tampoco admite Priority Tier. La inferencia solo en EE. UU. suma 1,1x en cada categoría de token, igual que en otros modelos Claude 4.6 y posteriores. Para ver el panorama de todos los modelos de Anthropic, mi guía de Anthropic API pricing lo recoge.
El límite de 100k es por solicitud, y el caché no te deja por debajo
Todos los demás modelos Claude actuales incluyen ya la ventana de contexto completa de 1M a un solo precio. La página de precios lo dice bastante claro: los modelos Claude 4.6 y posteriores "(except Claude Haiku 5.5)" facturan una solicitud de 900k tokens a la misma tarifa por token que una de 9k. Haiku 5.5 es aquí la excepción, y la documentación detalla tres reglas que deciden tu factura.
- La longitud del prompt cuenta todos los tokens de entrada. Eso incluye las lecturas de caché y también las escrituras de caché, no solo el texto nuevo.
- Cada solicitud se tarifica por separado. Una solicitud larga no empuja tus otras solicitudes a un nivel más alto, y las anteriores conservan el precio al que se facturaron.
- Una solicitud que pasa del límite paga las tarifas más altas por todo. Entrada y salida pasan a la tarifa de 5x, y el caché también, incluso cuando la mayor parte del prompt es un acierto de caché.
Esa tercera regla es la que la gente suele pasar por alto. El caché no esconde tokens al contador. Si tu agente arrastra 120.000 tokens de historial a una solicitud, paga 0,05 $ por millón por la parte en caché en vez de 0,01 $, y luego 2,50 $ por millón por su salida en vez de 0,50 $.
Esto es lo que eso hace con una sola solicitud. Un prompt de 90k tokens con 1.000 tokens de salida cuesta 0,0095 $. Añade 20.000 tokens más de prompt y la misma solicitud pasa a costar 0,0575 $.
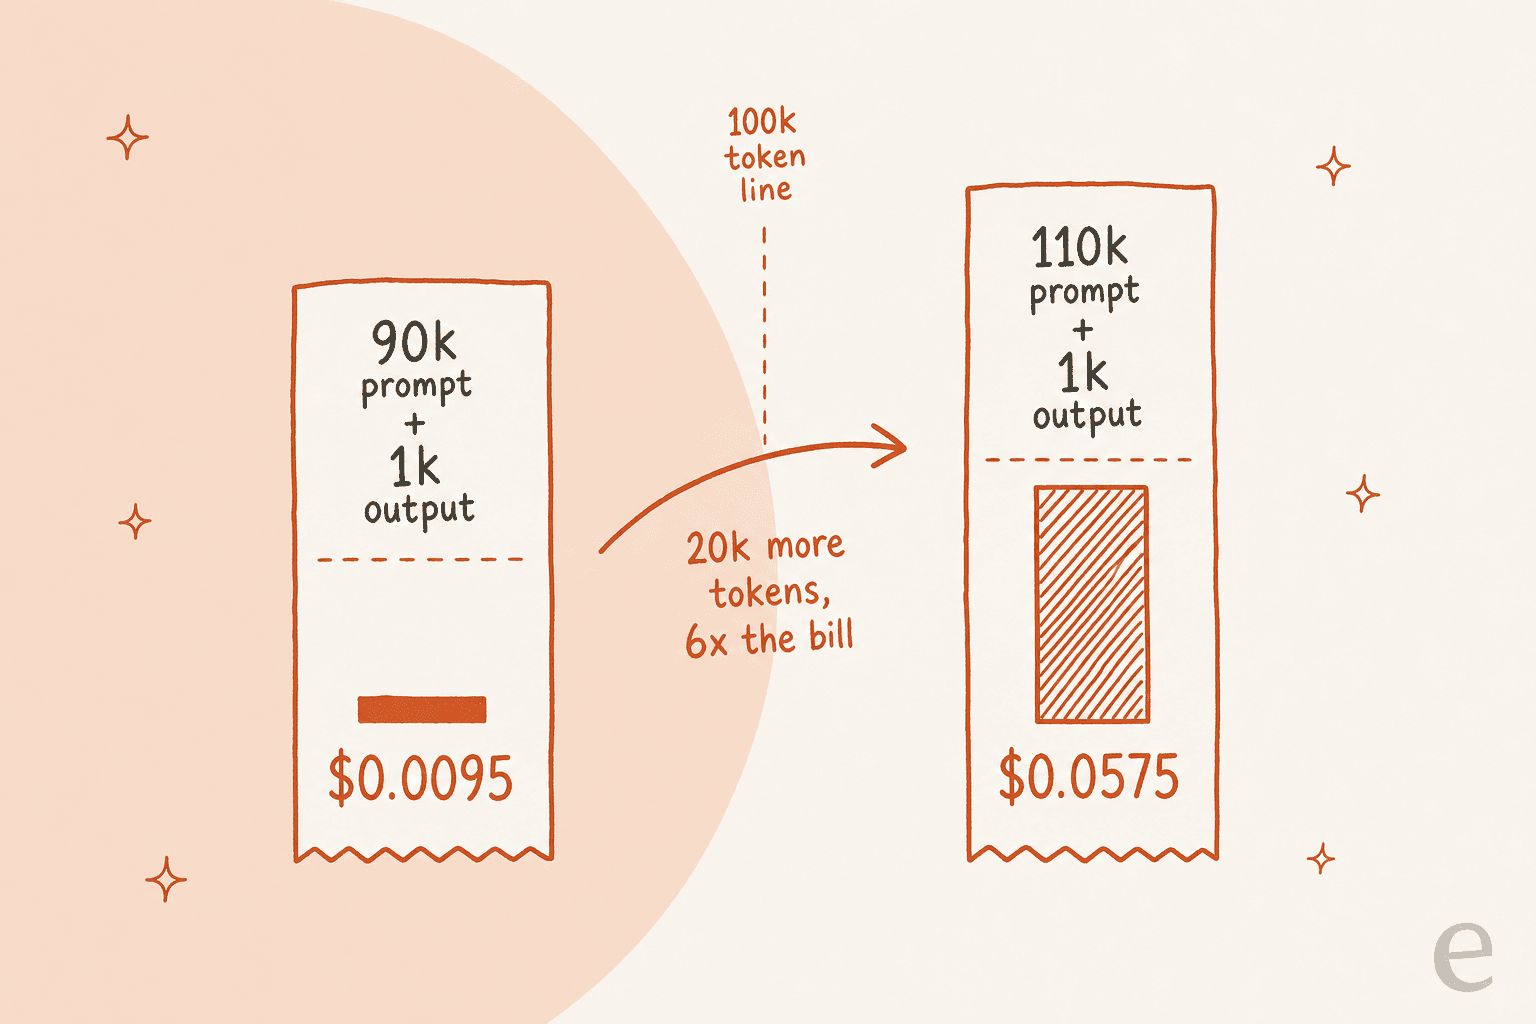
Así que 20k tokens extra hacen que una solicitud sea unas 6 veces más cara. No un 22 % más, que es lo que cabría esperar solo por el número de tokens. El hilo de lanzamiento en Hacker News lo detectó a los pocos minutos:
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value and as noted in this article, that is apparently the vast majority of Haiku use."

Lo de la "gran mayoría" lo dice la propia Anthropic. Su anuncio de lanzamiento afirma que los prompts de hasta 100.000 tokens eran cerca del 90 % de las solicitudes a Haiku 4.5. Si tu tráfico se parece a eso, el límite rara vez molesta, pero si ejecutas agentes es lo primero que debes medir.
Tus tokens se hicieron un 30 % más grandes
El segundo coste oculto está en el tokenizador. La página what's new de Anthropic dice que el mismo texto de entrada produce aproximadamente un 30 % más de tokens en Haiku 5.5 que en Haiku 4.5. Simon Willison midió un prompt largo en su contador de tokens de Claude y obtuvo cerca de 1,25x, a lo que llamó "a hidden price increase".
Eso cambia bastante el descuento de portada. Midiendo por palabra de texto, no por token:
| Comparación con Haiku 4.5 | Recorte del precio de lista | Recorte por palabra, a 1,3x tokens |
|---|---|---|
| Prompts de hasta 100k tokens | 90 % | cerca del 87 % |
| Prompts de más de 100k tokens | 50 % | cerca del 35 % |
También mueve el propio límite. Según mis cuentas, 100.000 tokens de Haiku 5.5 contienen más o menos el texto que en Haiku 4.5 eran 77.000 tokens. Cualquier prompt de Haiku 4.5 de más de unos 77k tokens hoy acabará por encima del límite tras migrar, y la guía de migración te dice que vuelvas a contar los prompts con model en claude-haiku-5-5 precisamente por eso.
La diferencia con OpenAI es aún mayor. Un comentarista estimó que 100K tokens de Claude son unos "~60-65K modern GPT tokens", así que el mismo documento llega al límite de Haiku mucho antes de alcanzar el de 272k de GPT-6 Luna. La cifra neta de la propia Anthropic, que ya tiene en cuenta el tokenizador, es que Haiku 5.5 cuesta "around 75% less to run" que Haiku 4.5 de media. Esa es la cifra honesta para planificar, no el 90 %. Haiku 4.5 sigue figurando como activo en la página de deprecaciones, con retirada no antes del 15 de octubre de 2026, así que hay tiempo para medir antes de moverte. Si lo usas dentro de Claude Code, mi guía de Claude Code Haiku cubre el cambio.
El esfuerzo es el otro mando del precio
Haiku 5.5 es el primer Haiku con un ajuste de esfuerzo, y el valor por defecto de la API es medium. Los tokens de razonamiento se facturan como salida, y no puedes desactivar del todo el razonamiento por encima de high, así que el esfuerzo decide cuántos de esos tokens de salida de 0,50 $ compras por respuesta.
Artificial Analysis ejecutó su Intelligence Index en cada nivel. El coste de toda la ejecución es la forma más clara de ver la diferencia:
| Esfuerzo | Intelligence Index | Coste de ejecutar el índice | Tokens de salida usados |
|---|---|---|---|
| Low | 29,4 | 34,31 $ | 32M |
| Medium (por defecto en la API) | 34,5 | 56,36 $ | 54M |
| High | 37,8 | 94,07 $ | 97M |
| Xhigh | 41,2 | 157,58 $ | 180M |
| Max | 43,4 | 330,25 $ | 440M |
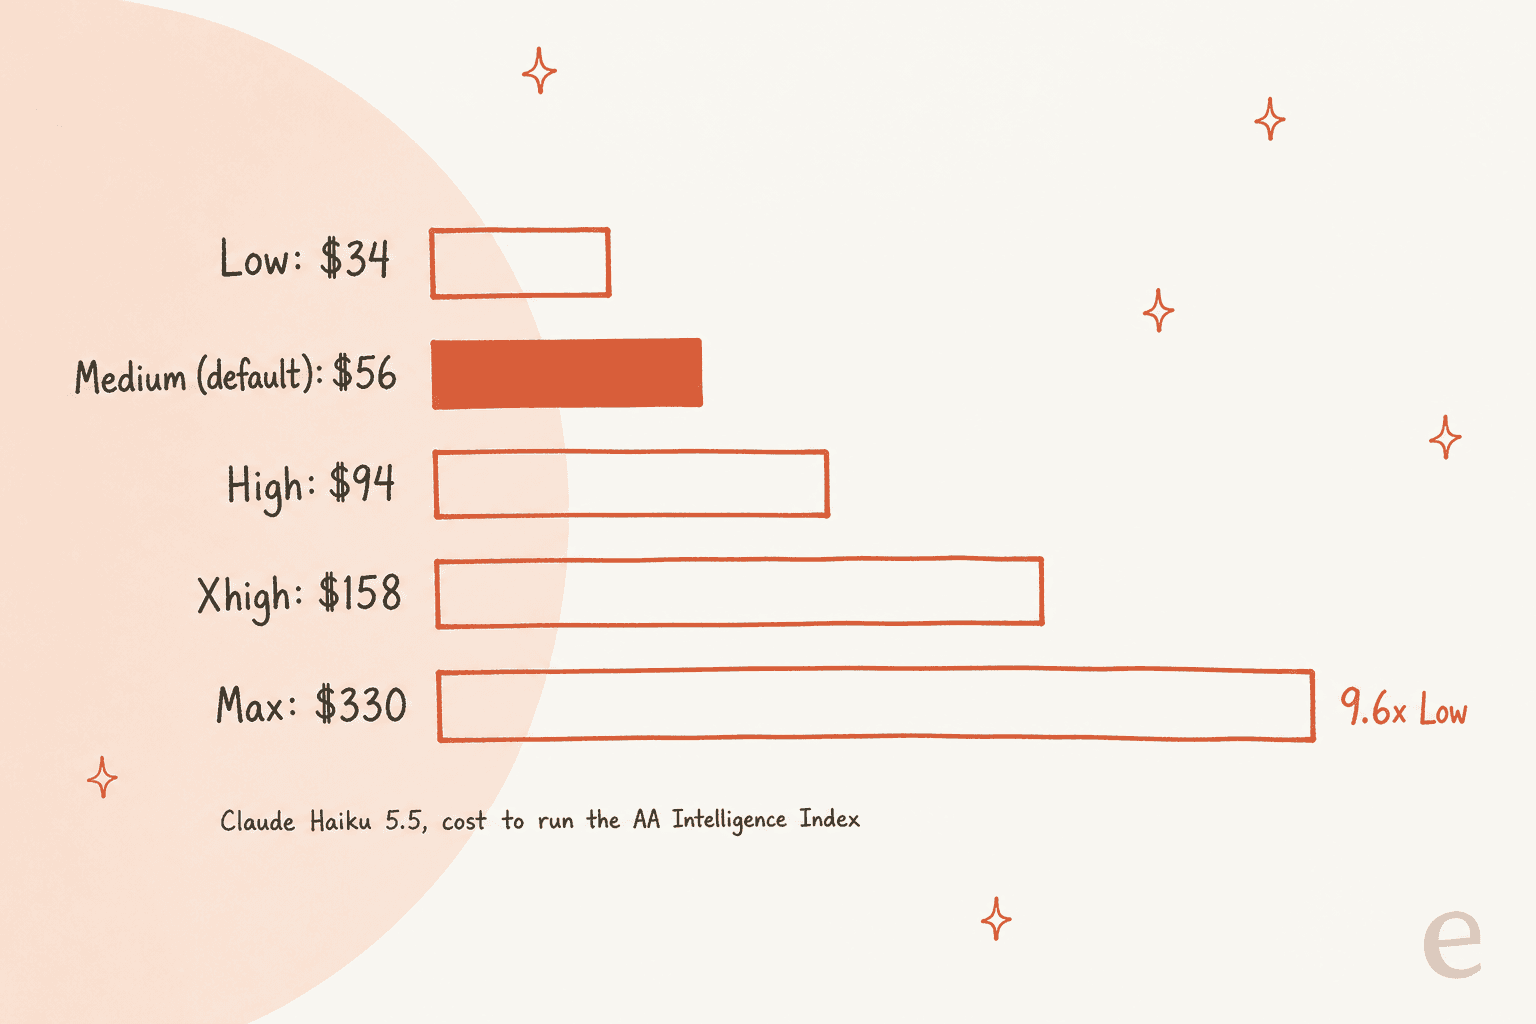
Max cuesta 9,6 veces lo que cuesta Low para el mismo conjunto de tareas, por una mejora de 14 puntos en el índice. AA midió unos 162k tokens de salida por tarea en Max y calificó al modelo de "very verbose". A precio de lista eso sale a 0,21 $ por tarea en Max, y esas cifras usan la tarifa de menos de 100k, ya que AA señala que aún no refleja los precios escalonados.
Una prueba más pequeña muestra la misma forma. Simon Willison dibujó su pelícano habitual en cada nivel: Low costó 0,0936 céntimos y tardó 7 segundos, mientras que Max tardó 5 minutos 9 segundos y costó 3,3826 céntimos. Medium y todo lo superior acertó con el cuadro de la bicicleta.
Mi opinión es sencilla. Para etiquetar y enrutar tickets, o para resúmenes cortos, empieza en Low y sube solo cuando un conjunto de prueba muestre que pierdes precisión. Para una respuesta que necesita razonar sobre una política, Medium es el valor por defecto por algo. Rara vez pagaría Max en Haiku.
Un comentarista de HN leyó las cifras de AA como que Haiku en nivel Max iguala en coste por tarea a GPT-6.1 Sol en medium, un modelo mucho más potente. En ese punto te conviene más subir a Sonnet 5.5 con menos esfuerzo. Mi guía de selección de modelo explica cuándo dar ese paso.
Lo que paga de verdad un equipo de soporte
La clasificación de soporte es la carga de trabajo que el anuncio de Anthropic nombra directamente, con clasificación y enrutamiento además de "live customer support". También es donde he visto al modelo más barato hacer el trabajo más útil. En una prueba de eesel con tráfico real de Zendesk de una bandeja de e-commerce de unos 1.000 tickets al mes, el 22 % de los tickets entrantes resultó ser spam, y la clasificación alcanzó un 93 % de precisión con un 100 % de detección de spam y cero falsos positivos. Es un trabajo que un modelo pequeño debería asumir, y no necesita prompts largos. Mi recopilación de la mejor IA para clasificar tickets cubre las herramientas pensadas para ello, y la guía del coste de la IA en atención al cliente pone la factura del modelo junto al resto del presupuesto.
Aquí van dos cargas de trabajo con 20.000 tickets al mes, cada una tarificada con la tarifa oficial. Los recuentos de tokens son supuestos, así que pon los tuyos en la calculadora de abajo. Las escrituras de caché se omiten, ya que un caché caliente gasta poco en ellas.
Etiquetado y enrutamiento de tickets (por debajo del límite)
Cada solicitud lleva un prompt de sistema de 2.500 tokens con tu lista de etiquetas más un ticket de 1.500 tokens, y devuelve unos 400 tokens con la etiqueta y un motivo breve.
| Configuración | Por ticket | Por mes (20.000 tickets) |
|---|---|---|
| Haiku 5.5, sin caché | 0,0006 $ | 12,00 $ |
| Haiku 5.5, prompt de sistema en caché | 0,000375 $ | 7,50 $ |
| Haiku 5.5, caché más Batch | unos 0,00019 $ | unos 3,75 $ |
| Haiku 4.5, mismo texto (menos tokens) | 0,0046 $ | 92 $ |
| Sonnet 5.5, sin caché | 0,012 $ | 240 $ |
A este tamaño la factura del modelo es básicamente un error de redondeo. Lo que cuesta dinero es todo lo que lo rodea, como conectarlo al helpdesk, escribir las reglas de etiquetas y revisar las etiquetas que se equivoca. Las guías sobre clasificación de tickets con IA, enrutamiento de tickets y conectar Claude a tu helpdesk cubren ese lado.
Redactar respuestas con contexto de la base de conocimiento (por encima del límite)
Ahora un bot de respuestas. Cada solicitud carga 80.000 tokens de artículos del centro de ayuda y macros que no cambian entre tickets, más 40.000 tokens de historial del ticket y datos del pedido, y escribe una respuesta de 2.000 tokens con su razonamiento. Son 120k tokens de prompt, así que por encima del límite.
| Configuración | Por ticket | Por mes (20.000 tickets) |
|---|---|---|
| Haiku 5.5, prompt de 120k, sin caché | 0,065 $ | 1.300 $ |
| Haiku 5.5, prompt de 120k, 80k en caché | 0,029 $ | 580 $ |
| Haiku 5.5, recortado a 95k, sin caché | 0,0105 $ | 210 $ |
| Haiku 5.5, recortado a 95k, 80k en caché | 0,0033 $ | 66 $ |
| Sonnet 5.5, prompt de 120k, 80k en caché | 0,108 $ | 2.160 $ |
| GPT-6 Luna, prompt de 120k, 80k en caché | 0,0058 $ | 116 $ |
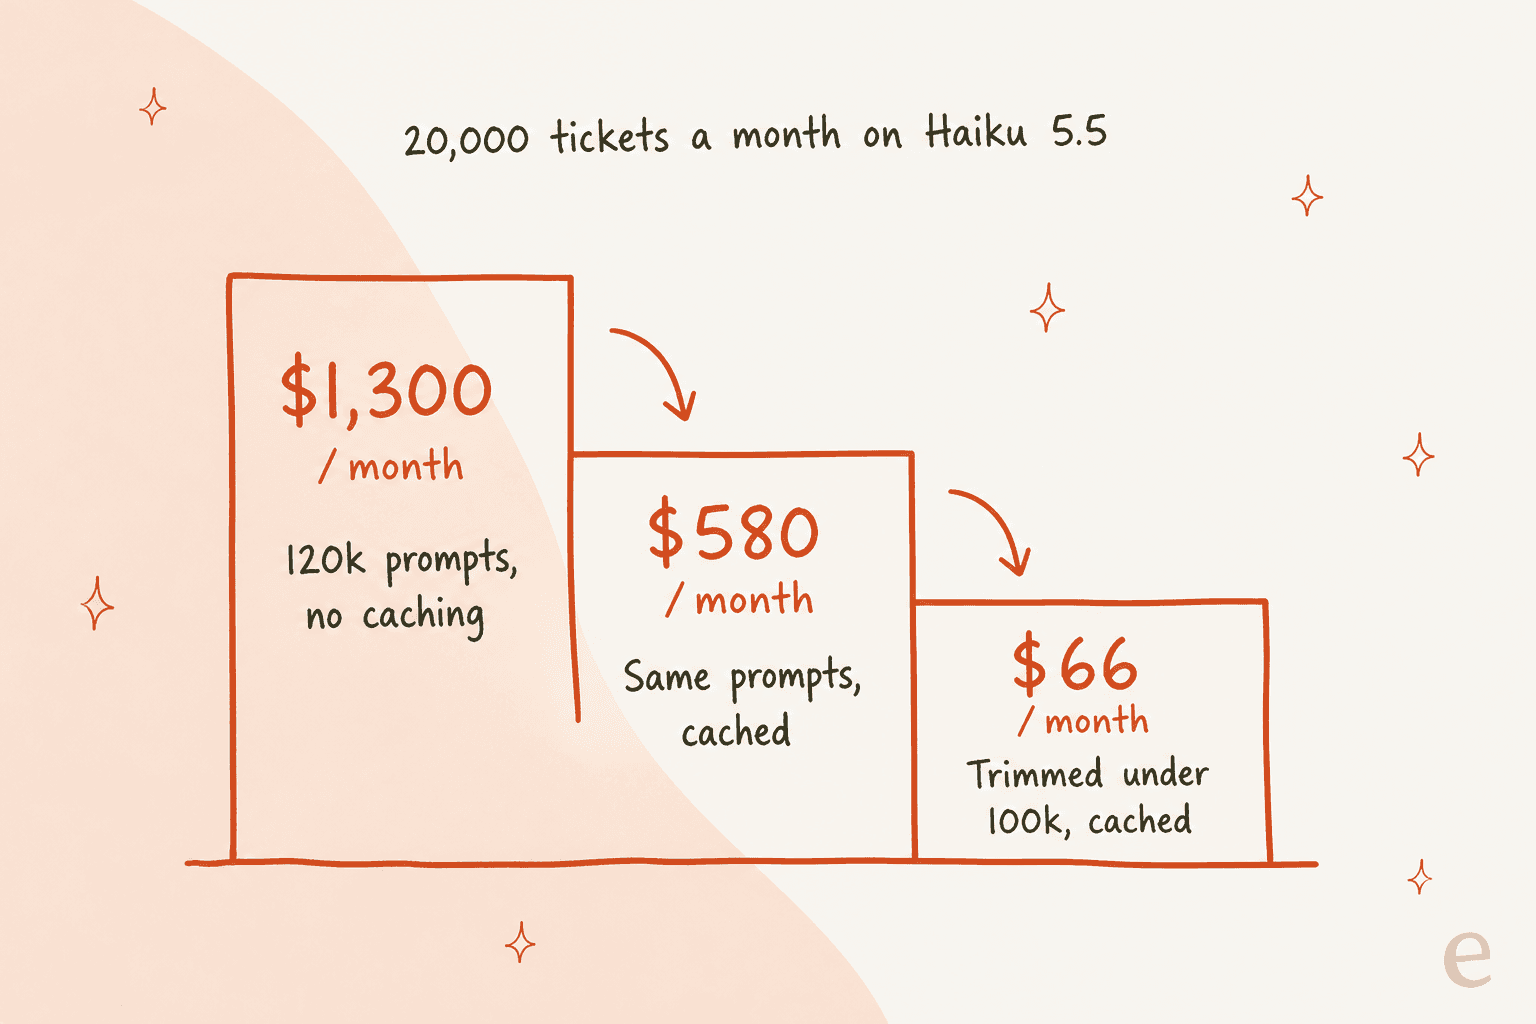
Solo con el caché la factura baja más de la mitad. Recortar 25k tokens de prompt la baja otra vez 9 veces, de 580 $ a 66 $. El recorte suele ser simplemente una recuperación de información bien hecha: traer los cinco artículos de ayuda más relevantes en lugar de una categoría entera, y resumir el historial antiguo del ticket en vez de pegarlo. El propio Haiku es bueno en ese paso de resumen, a la tarifa barata.
La fila de Luna usa los mismos recuentos de tokens, lo cual favorece a Claude, ya que OpenAI cuenta menos tokens para el mismo texto. El precio de Luna no sube hasta los 272k tokens, así que en este caso se queda muy por debajo de Haiku. Más sobre eso en la comparación de abajo y en mi desglose de GPT-6 Luna pricing.
Estima tu propia factura de Haiku 5.5
Elige un preajuste o escribe tus propios números. La barra muestra dónde queda tu prompt respecto al límite de 100k, y las filas comparan la misma carga en Haiku 4.5 y Sonnet 5.5, con GPT-6 Luna también incluido.
Dos cosas que vale la pena probar. Pon el prompt del preajuste Reply en 99.000 y luego en 101.000, y mira cómo salta la cifra mensual. Después activa Batch, que reduce cada línea a la mitad pero solo sirve para trabajo que pueda esperar hasta 24 horas, por ejemplo etiquetar de noche un atraso o resúmenes semanales de tickets.
Batch, caché y las partidas pequeñas
Estas son las palancas que se suman al precio base, según la documentación de precios:
| Palanca | Qué hace en Haiku 5.5 | Ojo con |
|---|---|---|
| Batch API | 50 % de descuento en entrada y salida, ambos niveles | Asíncrono, no sirve para chat en vivo |
| Escritura de caché de 5 minutos | 1,25x la entrada, se amortiza tras una lectura de caché | El caché caduca si hay poco tráfico |
| Escritura de caché de 1 hora | 2x la entrada, se amortiza tras dos lecturas de caché | Merece la pena con tráfico diurno estable |
| Lectura de caché | 0,1x la entrada (0,01 $ o 0,05 $) | Sigue contando para el límite de 100k |
| Inferencia solo en EE. UU. | 1,1x en cada categoría de token | El enrutamiento global es el valor por defecto |
| Prompt de sistema de uso de herramientas | 286 tokens de entrada extra (auto, none) | Baja desde 496 en Haiku 4.5 |
| Búsqueda web | 10 $ por 1.000 búsquedas, más tokens | Los resultados añaden tokens de entrada |
| Conjunto de herramientas de uso del navegador | Unos 6.600 tokens de entrada por solicitud | Las capturas se facturan como entrada de imagen |
Los modificadores se multiplican, así que una lectura de caché en un trabajo Batch cuesta la mitad del precio del caché. En un modelo tan barato, la sobrecarga de las herramientas importa más de lo que parece. Un agente de uso del navegador empieza cada solicitud unos 6.600 tokens más cerca del límite antes de haber leído una sola página.
Haiku 5.5 frente a Haiku 4.5, Sonnet 5.5 y los rivales de gama barata
El precio por token es solo la mitad de la comparación. Los tokenizadores son distintos, y también lo que escribe cada modelo por tarea. Esta tabla pone los precios de lista junto al coste por tarea del Intelligence Index de AA, que incorpora la verbosidad:
| Modelo | Entrada / salida por 1M | Punto de cambio de precio | Coste por tarea en AA |
|---|---|---|---|
| Claude Haiku 5.5 | 0,10 $ / 0,50 $ | 5x pasados 100k de prompt | 0,21 $ (Max) |
| GPT-6 Luna | 0,10 $ / 0,50 $ | 2x entrada, 1,5x salida pasados 272k | 0,07 $ (Max) |
| Gemini 3.5 Flash-Lite | 0,30 $ / 2,50 $ | Ninguno indicado | 0,19 $ |
| GLM-5.3 Flash | 0,15 $ / 0,50 $ | Ninguno indicado | 0,25 $ |
| DeepSeek V4.1 Flash | 0,15 $ a 0,30 $ / 0,60 $ a 1,20 $ | Las horas punta cuestan 2x | No medido |
| Claude Haiku 4.5 | 1 $ / 5 $ | Tope de contexto de 200k | No medido |
| Claude Sonnet 5.5 | 2 $ / 10 $ | Fijo hasta 1M | No medido |
Los precios provienen de la página de precios de cada proveedor, y la tarifa completa de OpenAI está en mi guía de OpenAI API pricing.
Si te tienta Gemini 3.8 Flash, ten en cuenta que la página de precios de Google duplica su precio el 1 de enero de 2027.
La comparación real más limpia que encontré fue la de un desarrollador que ejecutó el mismo trabajo de clasificación en ambos:
"I compared the costs between luna and haiku for some classification work. Luna comes out a fair amount cheaper due to more efficient tokenization and less outputs."
Sus números: Haiku 5.5 usó 11.893.643 tokens de entrada y costó 0,42 $ de forma síncrona, mientras que GPT-6 Luna usó 7.903.468 tokens de entrada para el mismo trabajo y costó 0,31 $. Mismo precio de lista, pero la factura de Haiku salió un 35 % más alta. El benchmark de analítica de datos de Plotly contó algo parecido, con Luna rindiendo "a bit better" por cerca del 30 % del coste de Haiku.
Entonces, ¿por qué pagar más por Haiku? Velocidad, y en algunas pruebas también calidad. AA midió de 137 a 243 tokens de salida por segundo según el nivel de esfuerzo, y un comentarista reportó que OpenRouter ofrecía aproximadamente el doble del rendimiento de Luna. Anthropic lo llama su modelo más rápido a velocidad estándar, por eso cita la atención al cliente en vivo como un buen caso. Un bot lento te cuesta más en tiempo de agentes humanos que cualquier línea de tokens. Mi artículo sobre alternativas a Haiku 5.5 profundiza en cuándo cambiar, y la comparación de tres APIs explica cómo elegir proveedor.
Frente a los propios modelos de Anthropic, el salto importa más. Sonnet 5.5 cuesta 20 veces el precio de entrada de Haiku con prompts cortos, pero solo 4 veces el de Haiku por encima del límite, y no tiene límite alguno. Si la mayoría de tus solicitudes están entre 100k y 400k tokens, pásalos a ambos por la calculadora de arriba antes de dar por hecho que gana Haiku. El desglose de Sonnet 5.5 pricing (y el anterior Sonnet 5 pricing) también cubre el recorte del mismo día en la lectura de caché, de 0,20 $ a 0,10 $, que según Anthropic hace a Sonnet 5.5 cerca de un 20 % más barato en la mayoría del trabajo con agentes.
Usar Haiku 5.5 con un plan de Claude o con créditos de API
Si solo quieres chatear con Haiku, no pagas por token en absoluto, y mi guía de precios de Claude compara los planes al completo. La página de planes de Claude lista Haiku en Free, Pro, Max y Team. Pro cuesta 17 $ al mes con facturación anual (20 $ mensual), Max empieza en 100 $, y los puestos de Team cuestan 20 $ Standard o 100 $ Premium por puesto con facturación anual.
La novedad son los créditos de API. Junto con Haiku 5.5, Anthropic empezó a dar a los suscriptores de Max y Team un crédito mensual para la Claude Platform:
| Plan | Crédito mensual de API |
|---|---|
| Max 5x | 100 $ |
| Max 20x | 200 $ |
| Team, puesto Standard | 20 $ por puesto |
| Team, puesto Premium | 100 $ por puesto |
| Tope del fondo de Team | 500 $ al mes |
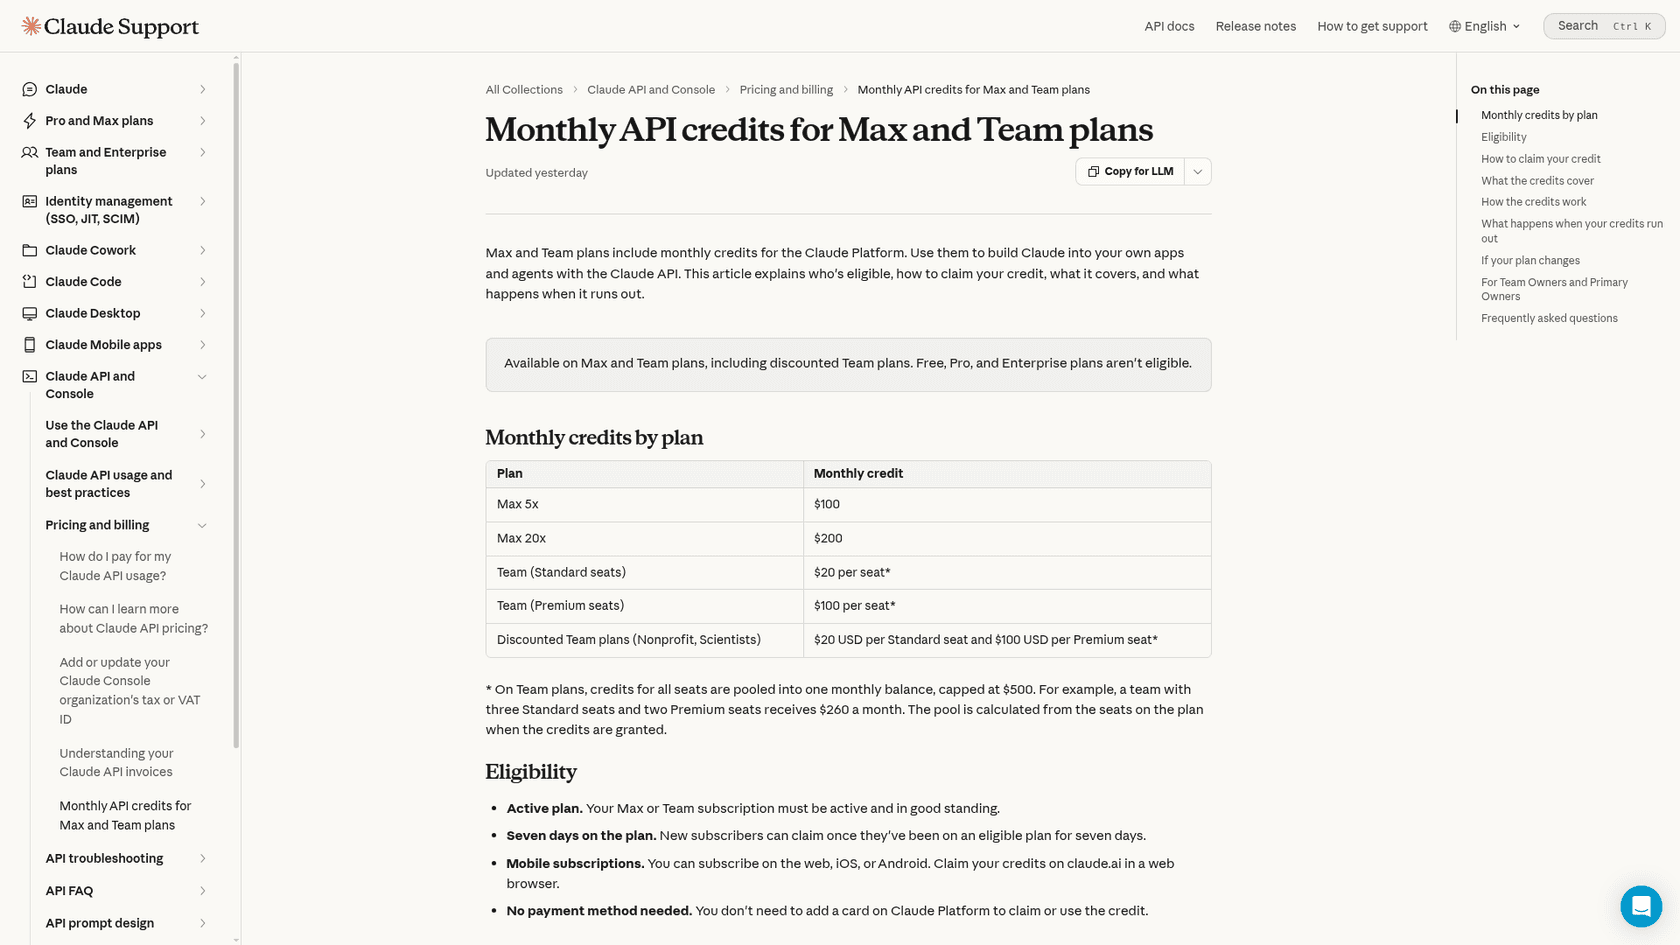
El artículo de ayuda recoge las reglas. Free, Pro y Enterprise no son elegibles, y debes llevar siete días en el plan. Los créditos no se acumulan, algo que conviene recordar, y cubren la API más Batches, Managed Agents y el Agent SDK, además de claude -p con una clave de API. No cubren el uso interactivo de Claude Code ni el uso en Bedrock, Vertex AI o Foundry.
En Haiku 5.5 ese crédito rinde mucho. Según mis cuentas, 100 $ compran unos 1.000 millones de tokens de entrada con prompts cortos o 200 millones de tokens de salida al mes. La carga de etiquetado en caché de arriba duraría cerca de un año con un mes de crédito de Max 5x. Un proyecto personal o una herramienta interna pueden vivir por completo dentro del crédito, mientras se mantengan por debajo del límite.
Qué dicen los desarrolladores del precio
El hilo de lanzamiento se dividió en torno a una pregunta: ¿cabe tu trabajo en 100k tokens?
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."
El otro lado ve el límite como un trato justo para el trabajo de subagentes:
"I would mostly use Haiku in task or explorer subagents. I'm not saying I stay under that on every task, but I do have quite a few sessions that cap out well below that, so that price difference would be very meaningful."
Y un comentarista leyó toda la estructura más como una jugada de precios que como un límite técnico:
"I'd consider the 100k a "promotional price" to match Luna's token pricing while delivering noticeably more intelligence."
Lo último es especulación, y Anthropic no ha dicho que vaya a cambiar. Aun así, es una buena razón para no construir un modelo de costes que solo funcione si Haiku se mantiene en 0,10 $ para prompts de cualquier tamaño.
¿Vale la pena Claude Haiku 5.5 a este precio?
Para trabajos cortos y de alto volumen, sí, claramente. Clasificación y etiquetado, enrutamiento, extracción, resúmenes cortos: todo cabe por debajo de 100k tokens, cuesta céntimos por cada mil llamadas y además va rápido. Viniendo de Haiku 4.5, es el recorte de costes más fácil de la gama Claude, cerca del 87 % por palabra de texto. Si usas Claude para Zendesk o un script de clasificación casero, este es el modelo que moverías primero. La guía de Claude para atención al cliente tiene la configuración.
Para agentes de contexto largo, la cosa está más reñida. Por encima del límite, Haiku cuesta una cuarta parte de Sonnet 5.5 por token sin tope a cuántas veces lo cruzas, y GPT-6 Luna sigue siendo más barato hasta 272k. Mide el tamaño de tus prompts antes de migrar y luego diseña la recuperación de información para quedarte por debajo del límite si puedes.
El panorama completo de calidad está en mi reseña de Haiku 5.5, donde el hilo de HN también incluye a desarrolladores que reportan regresiones frente a Haiku 4.5 en sus propias evaluaciones. Un modelo más barato que necesita rehacer los prompts no es más barato hasta que ese trabajo está hecho.
Deja que eesel se encargue de la cola de clasificación
Si el motivo por el que estás mirando el precio de Haiku 5.5 es tu cola de soporte, la factura de tokens es la parte más pequeña del trabajo, un punto que mi desglose del ahorro de costes en soporte con IA demuestra con cifras reales. Aun así necesitas la integración con el helpdesk y las reglas de etiquetas, luego una forma de probar con tickets pasados, y también alguien que vigile en qué se equivoca. Ese es el trabajo que eesel te quita de encima.
El compañero de IA para helpdesk de eesel se une al helpdesk que ya tienes, como Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y luego etiqueta y enruta tickets, redacta respuestas o las responde.
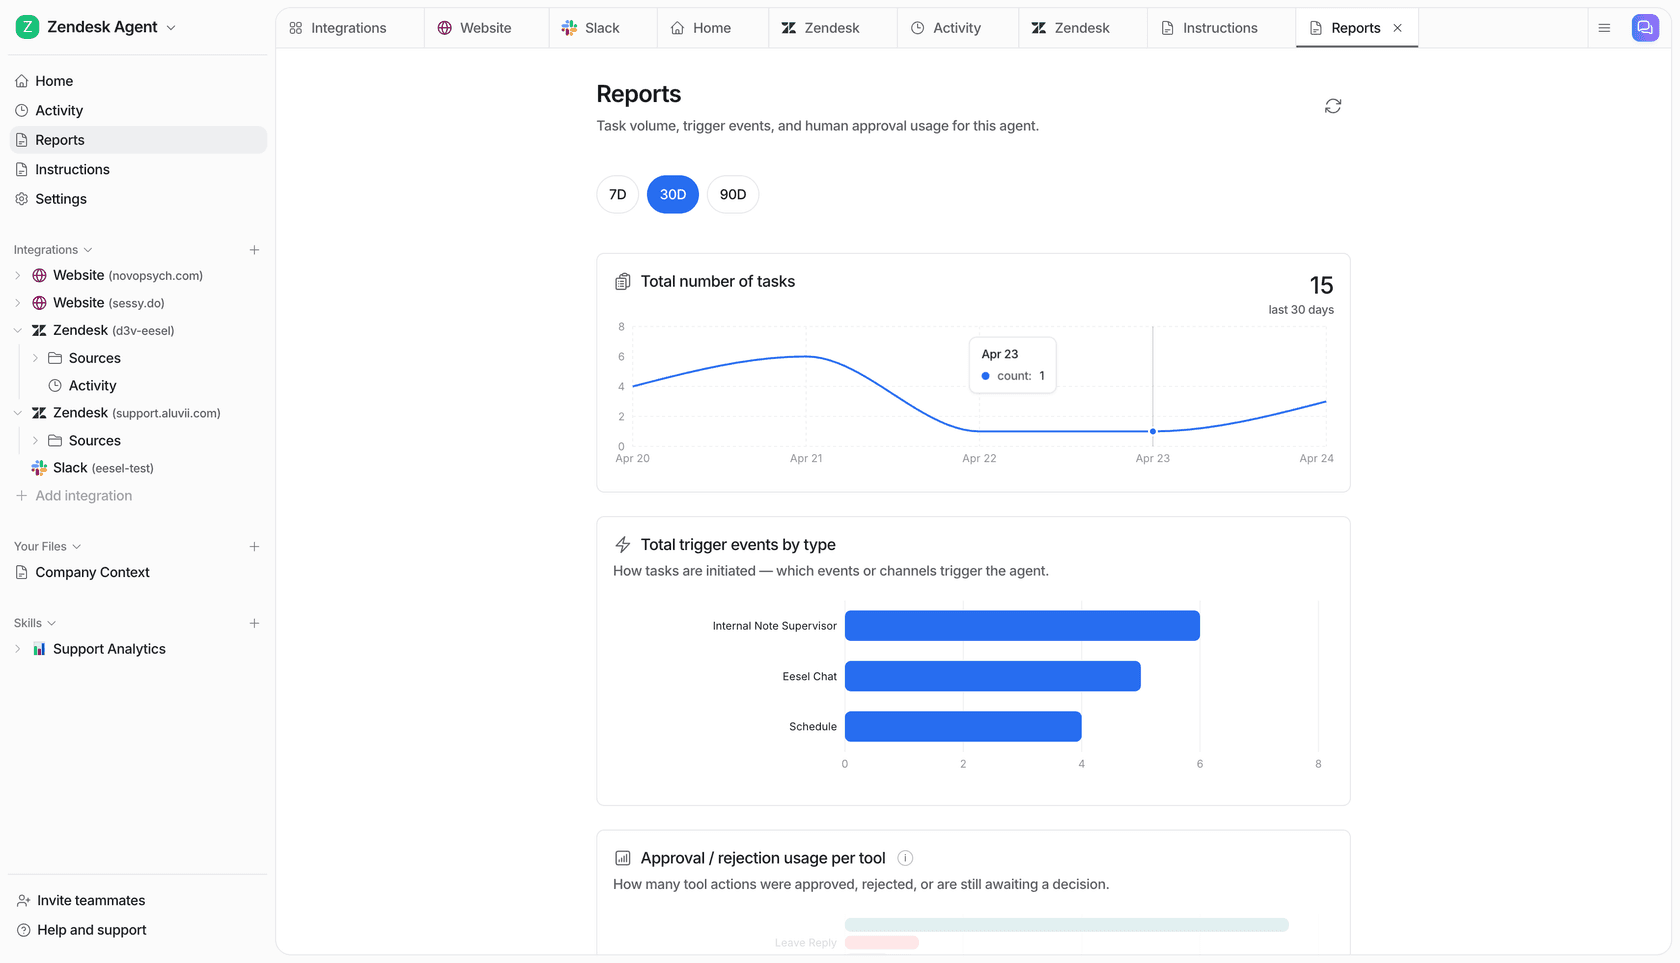
Antes de que toque a un cliente real, lo ejecutaría contra tus tickets históricos, y esa simulación viene incluida. Puedes seguir lo que hace en la vista de informes:
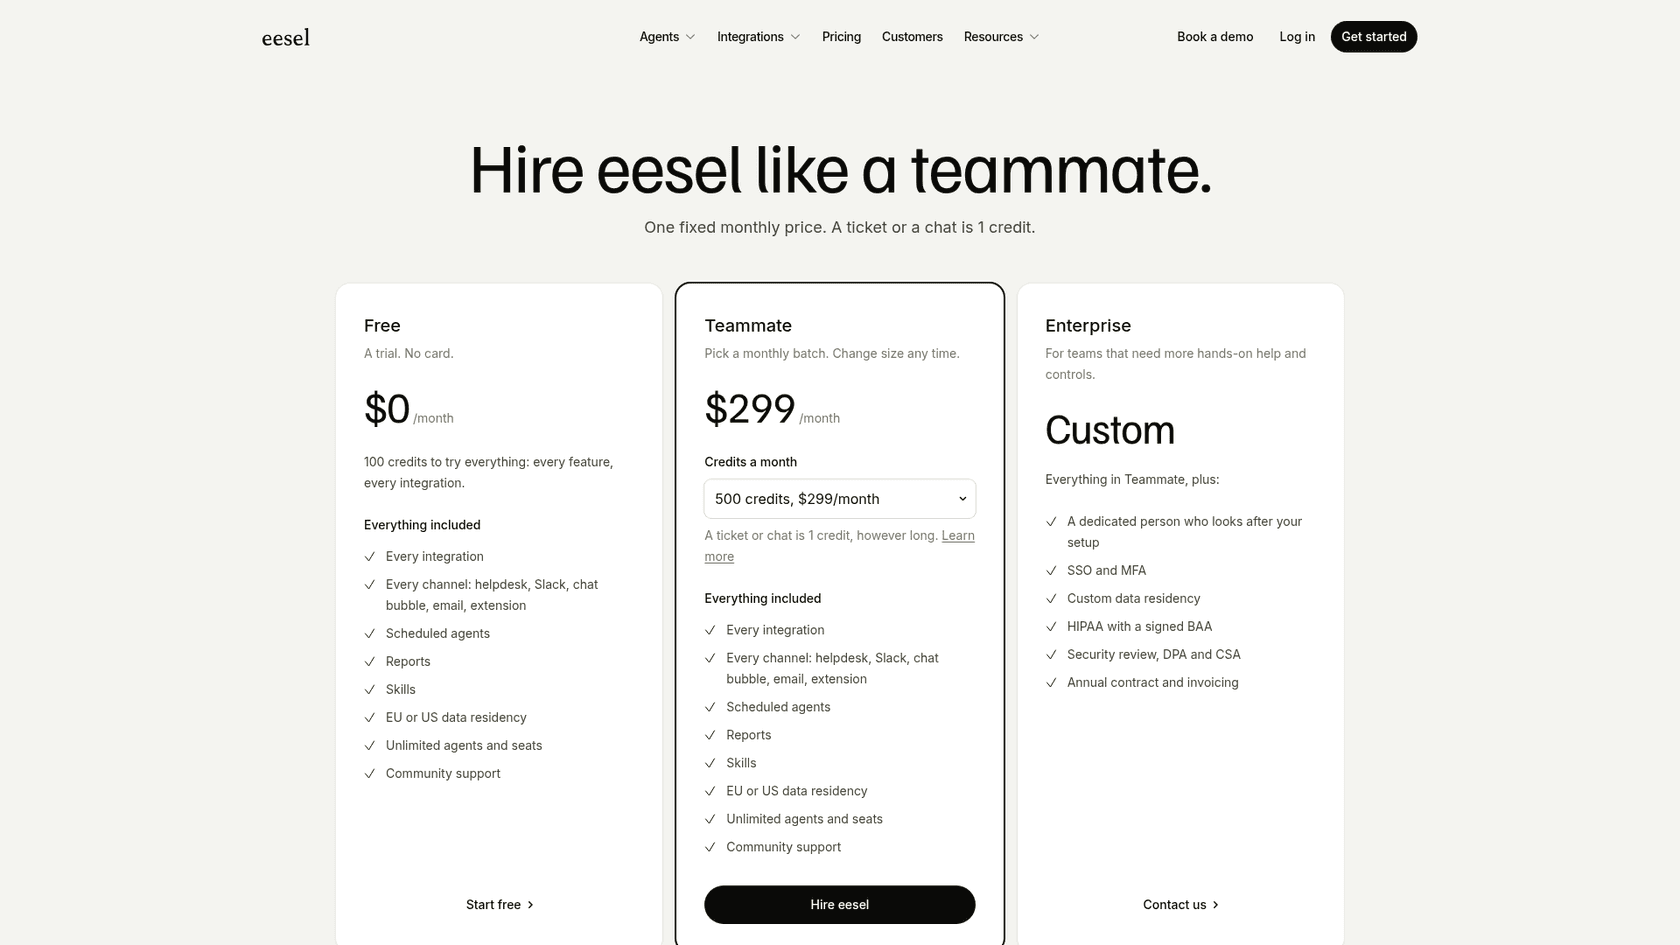
El precio es lo contrario de un contador de tokens. Un ticket o chat es un crédito sin importar cuánto dure, así que un hilo de 120k tokens cuesta lo mismo que una pregunta de dos líneas. Los planes empiezan en 299 $ al mes por 500 créditos y llegan hasta 1.749 $ por 5.000, con una prueba gratuita de 100 créditos y sin tarjeta. La previsibilidad importa más de lo que parece. Un usuario de prueba de eesel, en Gorgias, vio a su agente gestionar bien 12 chats de prueba y luego pidió cancelar en cuanto llegó a la página de facturación. Compáralo con herramientas de pago por uso como Zendesk AI pricing, donde la factura se mueve con cada resolución.
Para ser sincero sobre el encaje: si solo necesitas un script de etiquetado y tienes ingenieros, la API pura de Haiku 5.5 a 12 $ al mes es más barata, y deberías usarla. eesel tiene sentido cuando quieres el compañero completo, desde la clasificación hasta las respuestas, sin construir tú la canalización. Si prefieres automatizar el soporte desde la línea de comandos, la CLI de eesel controla al mismo compañero, de modo que tú o un agente de programación podéis automatizar sus instrucciones y aprobaciones, además del registro de actividad. Prueba eesel gratis con una muestra de tus tickets reales y mira cómo queda la clasificación antes de escribir una línea de código.