Resumen rápido
Claude Fable 5.1 es el modelo de disponibilidad general más capaz de Anthropic, lanzado el 1 de septiembre de 2026, y se sitúa por encima de Claude Opus 5 en la cima de la familia Claude 5. Está construido para trabajo agéntico de largo horizonte: sesiones de programación de varias horas, investigación profunda y trabajo de conocimiento que abarca muchas aplicaciones.
En cuanto a precios, las tarifas base no cambian respecto a Fable 5: 10 $ por millón de tokens de entrada y 50 $ por millón de tokens de salida. El cambio real está en las lecturas de caché, reducidas un 75% de 1 $ a 0,25 $ por millón de tokens, lo que según Anthropic ahorra alrededor de un 25% en cargas de trabajo típicas y hasta un 45% en las muy agenticas. Está disponible en Pro, Max, Team y Enterprise, no en el nivel gratuito.
¿Debería importarte? Si construyes con la API, sí, especialmente para programación agéntica. Si diriges un equipo de soporte o escribes contenido, casi nunca tocarás el modelo en bruto directamente; te encontrarás con inteligencia de clase Fable dentro de los productos construidos sobre él. Ese es el enfoque que usamos en eesel, donde nuestros compañeros de IA funcionan sobre modelos de frontera como este, pero llegan ya conociendo tu helpdesk y tu base de conocimiento.
¿Qué es Claude Fable 5.1?
Yo construyo los agentes de IA en eesel, así que un nuevo modelo de frontera no es para mí una carrera de benchmarks abstracta, es el motor sobre el que corren mis compañeros de equipo. Cuando Anthropic lanzó Fable 5.1 el 1 de septiembre de 2026, lo primero que hice fue leer qué había cambiado realmente bajo el marketing, y ahí hay una historia genuina más allá de "nuestro nuevo modelo lidera las tablas".
Claude Fable 5.1 es el modelo de disponibilidad general más capaz de Anthropic, presentado en su página de producto como el modelo más avanzado del mundo para programación y trabajo de conocimiento. Es el sucesor de Fable 5 y se sitúa en la cima de la familia Claude 5, por encima de Claude Opus 5. El ID del modelo en la API es claude-fable-5-1.
Algunas especificaciones que vale la pena fijar antes de nada:
- Ventana de contexto: una ventana de 1M de tokens, tanto por defecto como como máximo, con un precio plano por token en toda la ventana (sin recargo por contexto largo).
- Salida máxima: 128k tokens.
- Thinking: el thinking adaptativo siempre está activo, y ajustas su profundidad con un parámetro
effortque por defecto es alto. - Disponibilidad: la API, Amazon Bedrock, Google Cloud Vertex AI y Microsoft Foundry, además de los planes Pro, Max, Team y Enterprise. No está en el nivel gratuito.
También existe Claude Mythos 5.1, el mismo modelo subyacente con salvaguardas más permisivas, disponible solo para participantes de Project Glasswing (ciberdefensores y científicos de la vida verificados). Para casi todos los demás, Fable 5.1 es el que realmente vas a llamar.
Una nota honesta enterrada en la propia guía de Anthropic: dicen que empieces con Opus 5 para la mayoría de las cargas de trabajo y recurras a Fable 5.1 solo cuando Opus 5 con más esfuerzo siga quedándose corto, o para los proyectos de largo recorrido más ambiciosos. Es un toque refrescante de "no pagues de más por nuestro buque insignia", y debería moldear cómo piensas sobre este modelo. Es una herramienta especializada, no la opción por defecto.
Qué cambió realmente respecto a Fable 5
Esta es la parte que me parece genuinamente inteligente, y no es una cifra de benchmark. Fable 5.1 mantiene idéntica cada tarifa base de Fable 5 y luego, en silencio, hace un 75% más barato justo el medidor que domina las facturas agénticas.
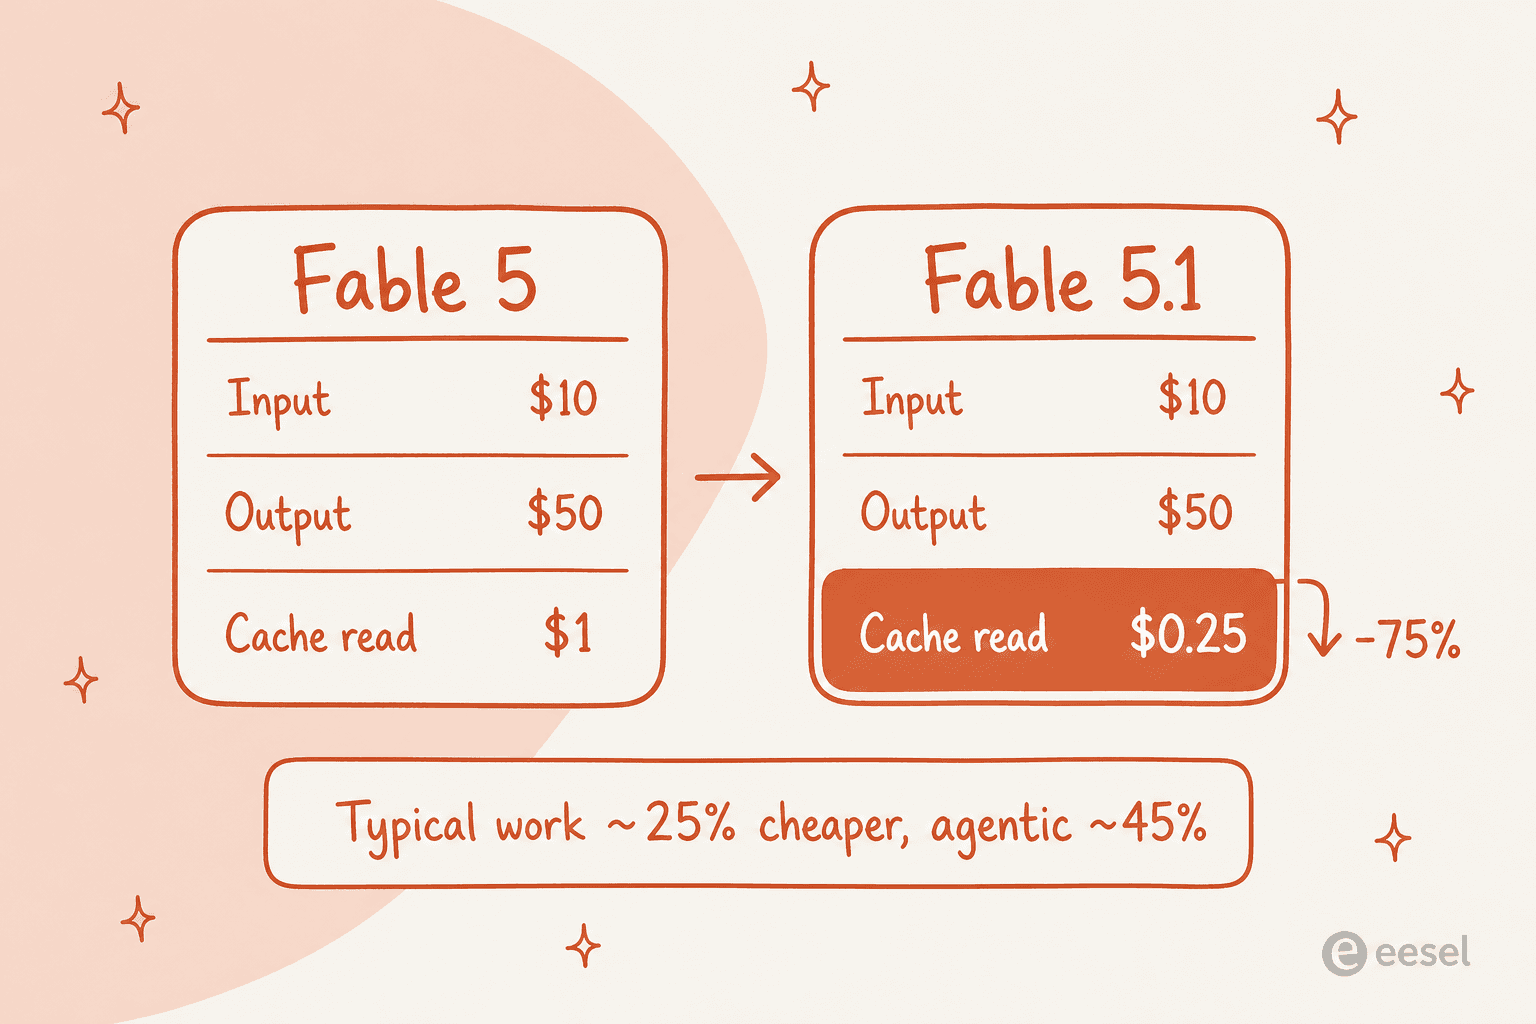
Las lecturas de caché bajaron de 1 $ a 0,25 $ por millón de tokens. Si nunca has ejecutado un bucle de agente que importe de verdad, esto suena a error de redondeo. No lo es. Una sesión agéntica larga vuelve a leer el mismo prefijo en caché (tu system prompt, tu base de código, tu historial de tickets) en cada paso, así que las lecturas de caché se acumulan mucho más rápido que la entrada nueva. Anthropic midió cuatro semanas de uso real de agosto de 2026 y calculó el ahorro efectivo en alrededor de un 25% en cargas de trabajo típicas y hasta un 45% en las muy agenticas.
El desarrollador Lance Martin planteó el ángulo del valor con claridad el día del lanzamiento:
"Fable 5.1 at low effort is often competitive with Opus and Sonnet on $ / task while scoring higher. on CursorBench 3.2.0, Fable 5.1 at low effort is at parity w/ Fable 5 at high effort at a third of the cost."
Más allá del precio, las mejoras de capacidad se concentran en seis áreas, según la documentación: programación agéntica en sesiones de varias horas, trabajo de conocimiento (documentos, hojas de cálculo, presentaciones), investigación en varios pasos, visión sobre PDFs densos y gráficos, razonamiento a lo largo de toda la ventana de 1M, y uso del ordenador. El rendimiento multilingüe está al nivel de Fable 5, no es un área de mejora, y es bueno que Anthropic lo diga así en lugar de dar a entender que todo mejoró.
Dos cambios más importan para quien construye sobre él:
- Una marca de agua de texto (nueva). Cada salida de texto lleva ahora la marca de agua estadística de texto de Anthropic para cumplir con la Ley de IA de la UE. No añade tokens ni caracteres ocultos, pero sí hace que la salida sea identificable como generada por Claude.
- Cambios importantes en la API. El uso forzado de herramientas ha desaparecido (un
tool_choicedeanyotoolahora devuelve un error 400), los bloques de thinking están vinculados al modelo, y editar turnos anteriores invalida el thinking. Si estás construyendo tu propio CLI de programación agéntica o bucle de herramientas, lee las notas de migración antes de actualizar.
Precios de Claude Fable 5.1
Pongamos toda la tabla de precios en un solo lugar. Todos los precios son por millón de tokens (MTok), en USD, según la documentación de precios de la plataforma.
| Medidor | Claude Fable 5.1 | Claude Fable 5 (anterior) |
|---|---|---|
| Entrada base | $10 | $10 |
| Salida | $50 | $50 |
| Lecturas de caché | $0.25 | $1 |
| Escrituras de caché de 5 min | $12.50 | $12.50 |
| Escrituras de caché de 1 hora | $20 | $20 |
| Batch (entrada / salida) | $5 / $25 | $5 / $25 |
La única línea que se movió es la de lecturas de caché. Todo lo demás es idéntico a Fable 5. También hay inferencia exclusiva en EE. UU. con un recargo de 1,1x para cargas de trabajo que deban permanecer en EE. UU.
¿Dónde deja eso a Fable 5.1 frente al resto de la gama actual?
| Modelo | Entrada | Lectura de caché | Salida |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $0.25 | $50 |
| Claude Opus 5 | $5 | $0.50 | $25 |
| Claude Sonnet 5 | $2 | $0.20 | $10 |
Fable 5.1 sigue siendo el Claude actual más caro en entrada y salida base, 2x Opus 5 y 5x Sonnet 5. Pero fíjate en que su lectura de caché de 0,25 $ es en realidad más barata por token que la de Opus 5 a 0,50 $. Ese es todo el sentido del cambio: hace económico un modelo insignia para las relecturas repetitivas que definen el trabajo de agentes.
Un ejemplo trabajado. Supongamos que un agente relee un contexto en caché de 150k tokens en cada una de 1.000 llamadas a herramientas en una sesión larga. Eso son 150M de tokens de lectura de caché. Con Fable 5 eso cuesta 150 $; con Fable 5.1 el mismo trabajo cuesta 37,50 $. Multiplica eso por toda una flota de agentes funcionando todo el día y el truco de "mismo modelo, caché más barata" deja de parecer un error de redondeo.
Una advertencia de la comunidad: incluso en los planes de consumo más altos, la gente reporta alcanzar límites de uso rápido con los modelos de clase Fable, lo cual es una cuestión aparte de la tabla de precios por token. Para las cifras exactas de las suscripciones Pro, Max y Team, consulta directamente claude.com/pricing y nuestro desglose de precios de Claude Pro para el ángulo del consumidor.
Si estás comparando entre proveedores, nuestras guías de precios de Gemini, precios de GPT-5.3 Codex y Gemini en general usan la misma óptica.
Qué puede hacer realmente Claude Fable 5.1
Anthropic reporta que Fable 5.1 lidera todos los benchmarks que lista. Aquí están los que realmente dicen algo, todos producidos con las salvaguardas de producción activadas (más sobre esa salvedad más abajo).
| Benchmark (qué mide) | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 (investigación agéntica) | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 (programación agéntica) | 55.8% | 42.0% | 52.3% | 37.3% |
| AutomationBench (flujos de trabajo empresariales) | 31.4% | 17.1% | 26.9% | 19.6% |
| OSWorld 2.0, parcial (uso del ordenador) | 77.9% | 72.9% | 75.4% | - |
| Humanity's Last Exam, con herramientas | 65.0% | 63.8% | 63.6% | - |
| CursorBench 3.2.0 (programación agéntica) | 73.4% | 70.5% | 70.0% | 67.2% |
Los saltos más destacados son Terminal-Bench-Science (de 24.7% a 52.6%, más del doble) y AutomationBench (de 17.1% a 31.4%). Ambos apuntan en la misma dirección: este modelo mejoró mucho en trabajo largo y autodirigido.
Ahora la parte honesta, porque las tablas de benchmarks del día de lanzamiento siempre merecen un pellizco de sal. Un comentarista de Hacker News dijo en voz alta lo que muchos callan:
"There are hundreds of benchmarks. You just need to pick a favorable dozen on release day."

Justo. Lo que más me convenció que la tabla fueron las ejecuciones reales y verificables de largo horizonte del anuncio. Ramp lo dejó correr sin supervisión durante 38 horas en un problema de machine learning, donde diagnosticó un resultado previo como un artefacto de etiquetado, lo corrigió y puso en marcha seis experimentos nocturnos en paralelo. Millennium dijo que encontró la causa de un fallo que ocurría una vez entre un millón de ejecuciones y que ningún ingeniero ni modelo había resuelto en cuatro o cinco años. Y en el benchmark de agentes de navegador más difícil de Browserbase, completó el 82% de las tareas frente al 74% de Opus 5 y el 57% de Fable 5, usando menos tokens. Ese es el tipo de resultado que una puntuación de benchmark no termina de transmitir.
Los profesionales que lo probaron confirmaron la historia sobre programación:
"I've tested Claude Fable 5.1 over the last week. Everyone should try this model... this model is delight to work with and has the depth of the Fable models. I really trust this model"
Si lo estás comparando directamente con otros modelos de programación, nuestro resumen de los mejores asistentes de programación con IA, los mejores agentes de IA y las alternativas a GPT-5.3 Codex es un buen punto de partida para calibrar expectativas.
Cómo funciona el ajuste de esfuerzo
Lo más útil para entender Fable 5.1 en la práctica no es un benchmark, es el dial effort.
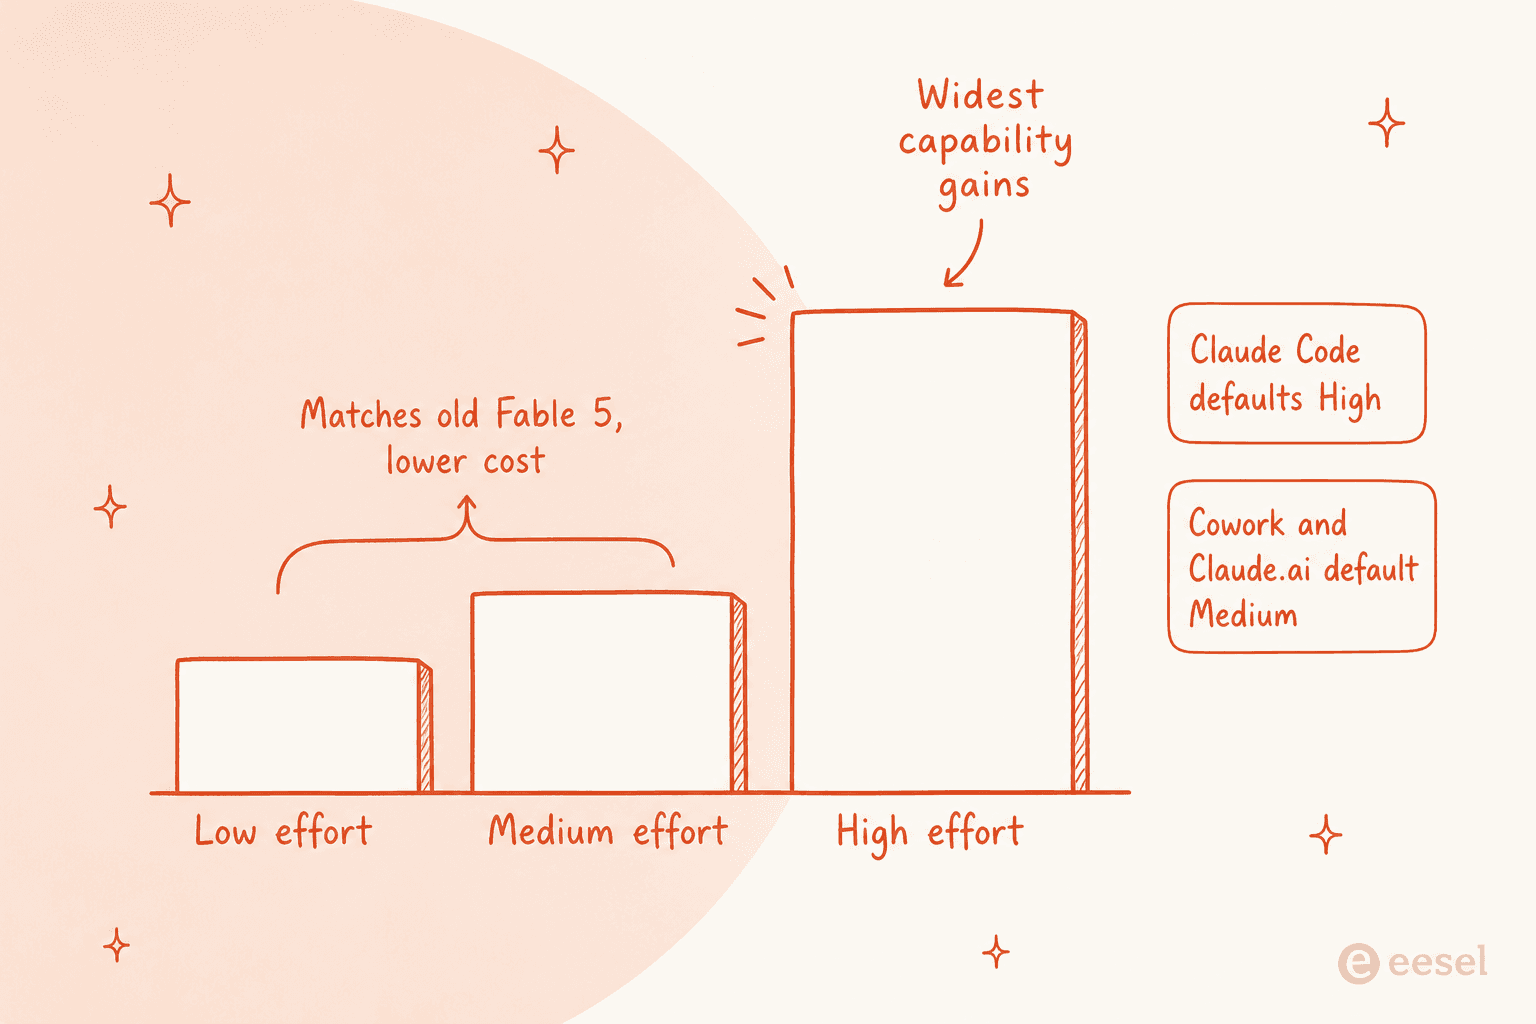
El thinking adaptativo siempre está activo, y effort controla cuánto de él obtienes. El objetivo de diseño declarado por Anthropic es que, con esfuerzo bajo o medio, Fable 5.1 iguale o supere a Fable 5 a mucho menor coste; la brecha respecto a Fable 5 es mayor con esfuerzo alto. Los valores por defecto difieren según la superficie: alto en Claude Code, medio en Claude Cowork y en Claude.ai. Así que el mismo modelo puede ser un caballo de batalla económico o un especialista de máxima profundidad según un solo parámetro, que es exactamente lo que hace que las lecturas de caché más baratas den sus frutos.
No es una victoria clara para todos, sin embargo. Un desarrollador que trabaja en lenguajes menos comunes respondió:
"I write a lot of Rust and Lean, Fable 5 is in my experience better at both. Cost/performance is a different story."
Es un recordatorio útil: "lidera todos los benchmarks" es un promedio, y tu carga de trabajo podría vivir en la cola donde el modelo anterior aún gana en calidad bruta. Pruébalo con tus propias tareas antes de migrar, del mismo modo que abordarías cualquier decisión de optimización de LLM.
La trampa: salvaguardas y confianza
Intento ser justo con cada herramienta sobre la que escribo, y eso funciona en ambos sentidos: la queja recurrente más grande sobre Fable 5.1 el día del lanzamiento no fue la capacidad, fueron los rechazos.
Anthropic sí hizo más precisas las salvaguardas. Los usuarios de Claude Code pueden esperar alrededor de un 60% menos de intervenciones de salvaguarda cibernética por sesión frente a Fable 5, y las salvaguardas de biología ahora se activan un 85% menos en preguntas escolares inocuas. Cuando una consulta sí se marca, se redirige a un modelo Opus y no se te cobra a precio de Fable por ello. Son mejoras reales y medibles.
Pero los desarrolladores siguen encontrando falsos positivos, a veces en su propio código:
"Fable is useless. Me: 'Find my security problems in my own code. This is code I own. I'm doing this under authorization of the CEO/CTO of our company.' Fable: 'yeah, no.'"
"The main issue was that Fable was unpredictable and prone to false positives by the safeguards... it still seems completely unable to understand its own guardrails and will readily reason itself into triggering them."
Suma la nueva marca de agua y los bloques de thinking vinculados al modelo, y hay una corriente real de gente que siente que el modelo desconfía más de ellos a medida que se vuelve más capaz. Si ese intercambio vale la pena depende por completo de tu trabajo; un equipo de seguridad defensiva lo nota mucho más que alguien que redacta documentos. Es un hecho a sopesar, no un factor decisivo para la mayoría.
Dónde encaja Fable 5.1 si diriges soporte o escribes contenido
Este es el replanteamiento que defendería, y es lo que más de tres años poniendo IA en colas de soporte en vivo nos enseñaron en eesel: no contratas un modelo, contratas a un compañero de equipo que usa uno.
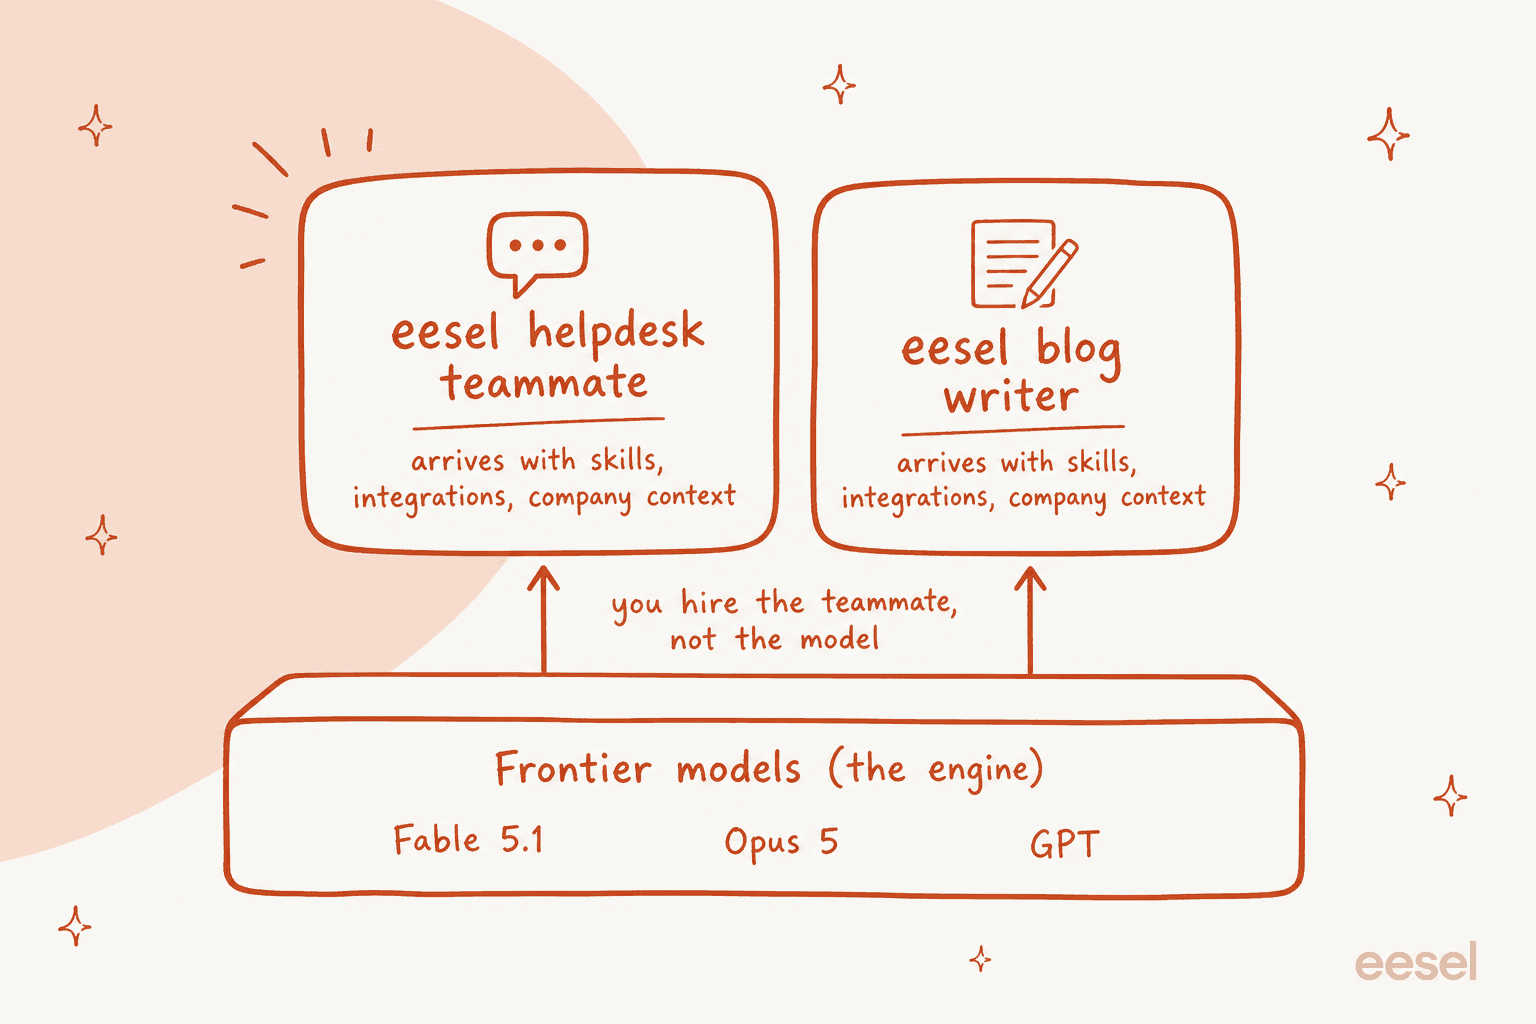
Fable 5.1 es infraestructura, el motor en bruto. Un gerente de soporte no quiere escribir un bucle de herramientas, conectar recuperación sobre tickets pasados, gestionar rechazos y administrar un presupuesto de tokens, quiere tickets resueltos. Ese hueco entre un modelo de frontera y una solución que funciona es exactamente donde vive un producto como eesel. Nuestro agente de helpdesk con IA funciona sobre modelos de frontera como este, pero llega ya entrenado en tu centro de ayuda y tickets pasados, conectado al helpdesk que ya usas.

Y como hemos visto bots que suenan seguros de sí mismos dar respuestas erróneas con total tranquilidad, cada implementación de eesel se simula contra tus tickets históricos antes de tocar a un cliente real, así ves cómo va a rendir de verdad. Eso es una propuesta muy distinta a llamar tú mismo a claude-fable-5-1. Si estás sopesando opciones, nuestras guías sobre la mejor IA de atención al cliente y la automatización de IA para atención al cliente repasan qué buscar, y construir un GPT personalizado de soporte muestra el camino DIY si prefieres ir por la vía cruda.
Si estás mapeando primero la categoría, nuestras guías sobre el mejor software de helpdesk con IA, los chatbots de atención al cliente con IA y un copiloto de IA para soporte trazan el panorama.
El lado de contenido tiene la misma forma. La escritura de Fable 5.1 mejoró de verdad, Canva dijo que "lo que destaca es la escritura" y los evaluadores de Glean prefirieron sus respuestas por aproximadamente 2 a 1 frente a Fable 5. Pero una mejor prosa de un modelo en bruto sigue sin hacer investigación de palabras clave, colocar enlaces internos o extraer fuentes reales.
Ese andamiaje es el verdadero trabajo, por eso un redactor de blog con IA supera a una simple ventana de chat para trabajo de publicación, y por eso existe nuestro resumen de herramientas de escritura de blog con IA.
En cuanto al flujo de trabajo en sí, hemos profundizado en la automatización de blogs con IA, la escritura de IA de formato largo y el coste real de un redactor de blog con IA.
Prueba eesel para soporte y contenido
eesel es una plataforma de compañeros de equipo con IA: en lugar de un modelo en bruto, contratas compañeros listos para trabajar en labores específicas. El compañero de helpdesk con IA se une a tu cola de soporte, y el redactor de blog con IA investiga y redacta contenido SEO, ambos funcionando sobre modelos de frontera como Fable 5.1 pero llegando con las habilidades, integraciones y contexto de empresa para el puesto.
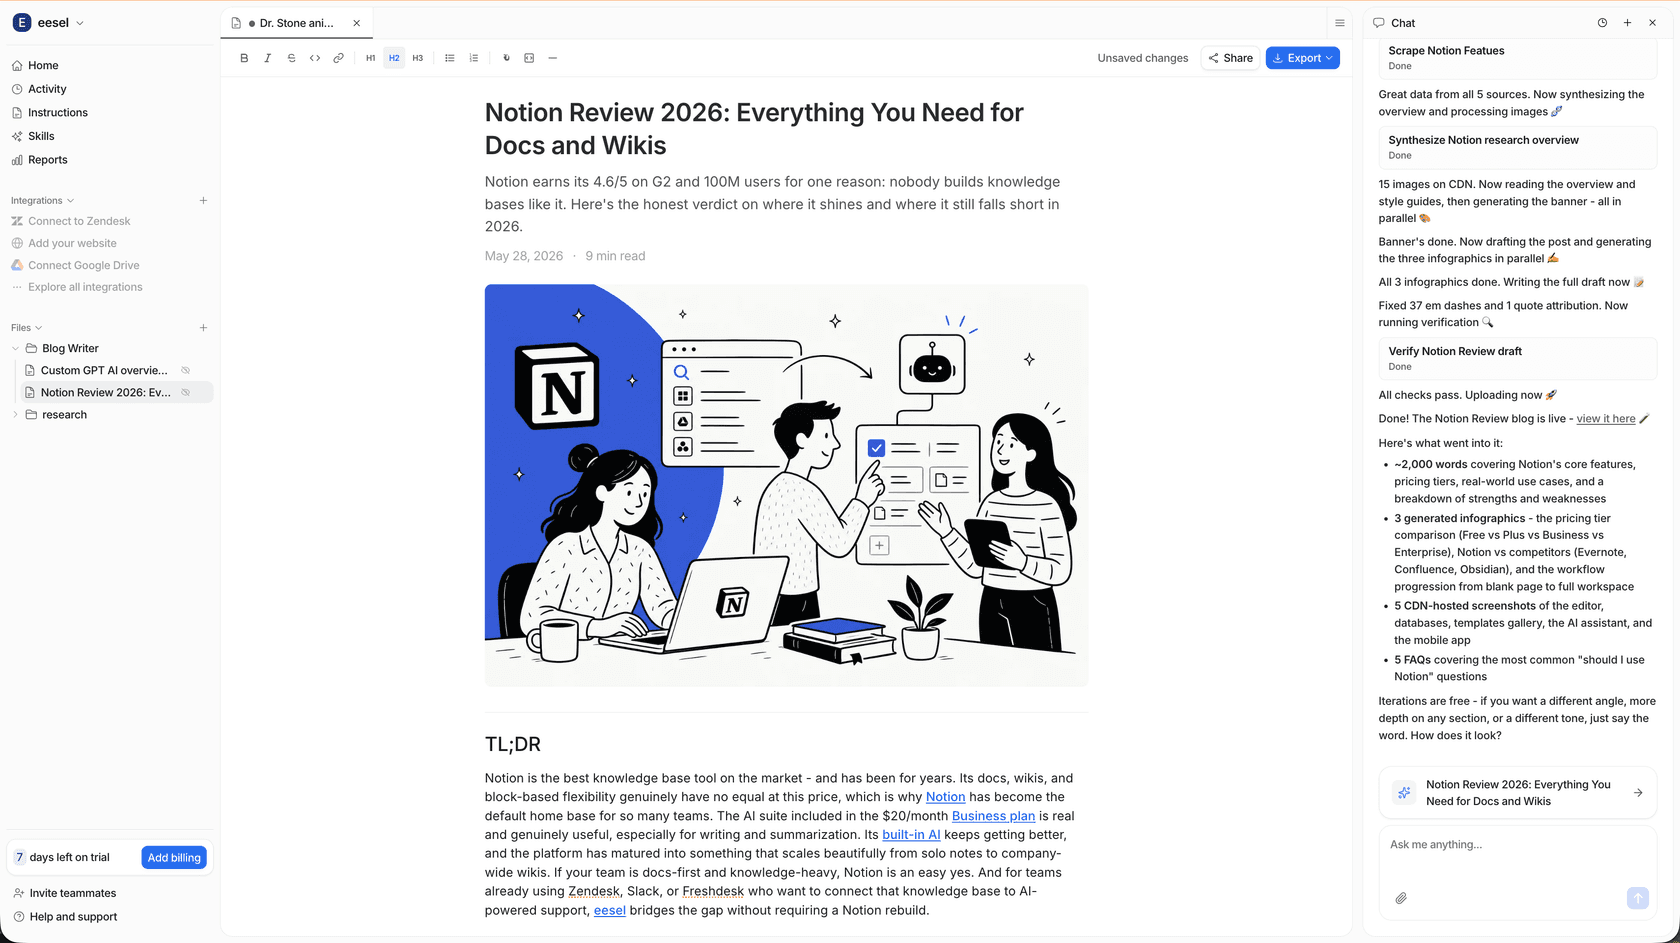
La diferencia frente a conectar un modelo tú mismo es que eesel se pone en marcha en minutos sobre las herramientas que ya usas, se entrena con tu conocimiento existente y te permite simular a un compañero con datos reales del pasado antes de salir en vivo. Puedes probar eesel gratis, sin tarjeta de crédito ni llamada de ventas, y ver cómo responde tus propios tickets o redacta tus propias entradas antes de comprometerte.
Fable 5.1 es un motor notable. La mayoría de los equipos solo quieren el trabajo terminado que hace posible, y esa es la parte que construimos nosotros.
Preguntas frecuentes
¿Cuánto cuesta Claude Fable 5.1?
¿Cuál es la diferencia entre Claude Fable 5.1 y Fable 5?
¿Es Claude Fable 5.1 mejor que Claude Opus 5?
¿Puedo usar Claude Fable 5.1 para atención al cliente?
¿Claude Fable 5.1 marca con agua su escritura?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.