Qué es realmente Fable 5.1
Permítanme ser preciso sobre qué se lanzó, porque los nombres se vuelven confusos rápido. Claude Fable 5.1 es el sucesor de Fable 5 y la cima de la gama de Anthropic. El ID del modelo en la API es claude-fable-5-1. También existe Mythos 5.1, el mismo modelo subyacente con salvaguardas más ligeras, disponible solo para participantes examinados de Project Glasswing (ciberdefensores y científicos de la vida). Cuando vea una cifra de benchmark, es de Fable 5.1 a menos que se indique Mythos.
Las especificaciones son de gama alta: una ventana de contexto de 1M de tokens con precio plano por token en toda la ventana, 128k de salida máxima, y pensamiento adaptativo que está siempre activo y se ajusta con un parámetro effort (alto por defecto). Anthropic lo posiciona para "razonamiento exigente y trabajo agéntico de largo horizonte", y su propia guía es reveladora: empezar con Opus 5 para la mayoría de los trabajos, y recurrir a Fable 5.1 solo cuando Opus 5 con más esfuerzo aún no basta. Es un consejo inusualmente honesto, y fue el marco al que volví una y otra vez durante las pruebas.
Como ingeniero que pasa la mayoría de los días conectando modelos a un producto real, lo que me importa no es la clasificación, sino si el modelo aguanta una ejecución larga, desordenada y con múltiples herramientas sin que tenga que estar vigilándolo. Ahí es exactamente donde apunta Fable 5.1.
El único número que se movió: el precio
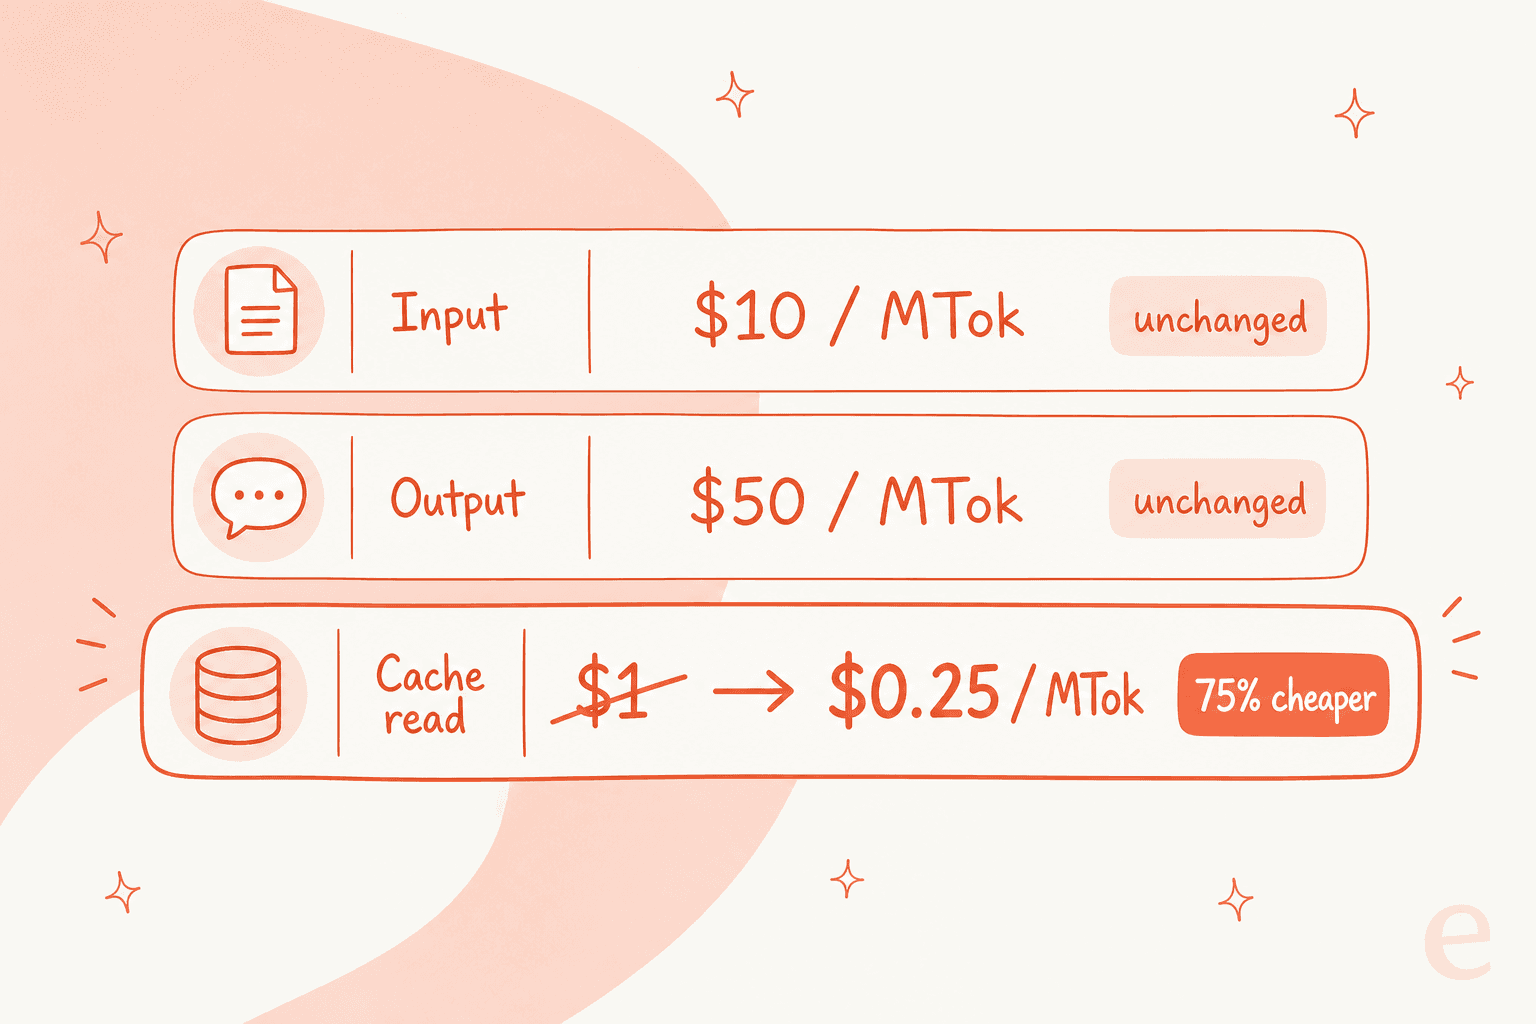
Aquí están los precios, porque un análisis que dice "desde $10" no está haciendo bien su trabajo.
| Métrica | Fable 5.1 | Fable 5 | Cambio |
|---|---|---|---|
| Entrada (por MTok) | $10 | $10 | sin cambios |
| Salida (por MTok) | $50 | $50 | sin cambios |
| Lectura de caché (por MTok) | $0,25 | $1,00 | 75% más barato |
| Escritura de caché, 5 min (por MTok) | $12,50 | $12,50 | sin cambios |
| Escritura de caché, 1 hora (por MTok) | $20 | $20 | sin cambios |
| Entrada / salida por lotes (por MTok) | $5 / $25 | $5 / $25 | sin cambios |
El recorte en las lecturas de caché es toda la historia en cuanto a costos. Anthropic estima que reduce el costo de una carga de trabajo típica en torno al 25% y el de una muy agéntica hasta un 45%, porque las ejecuciones agénticas releen el mismo contexto en caché en cada turno. Para contextualizar, la lectura de caché de $0,25 de Fable 5.1 resulta más barata por token que la de Opus 5, de $0,50, aunque la entrada base de Opus 5 cuesta la mitad. Si su carga de trabajo depende mucho de la caché, la cuenta se inclina más hacia Fable de lo que sugieren las tarifas destacadas.
Dos advertencias que conviene conocer antes de presupuestar. La inferencia exclusiva en EE. UU. lleva un multiplicador de 1,1x, y Fable 5.1 no está en el nivel gratuito, se necesita Pro, Max, Team o Enterprise. El lanzamiento también provocó la pulla habitual entre modelos rivales, cuando una cuenta de X señaló que "Fable 5.1 cobra 6 veces más que GPT-5.6 Sol". Eso es cierto en el precio de lista, y es la comparación equivocada si su trabajo es una ejecución agéntica larga, donde la eficiencia de tokens y la tasa de éxito deciden la factura real.
Los benchmarks, y cuánto confiar en ellos
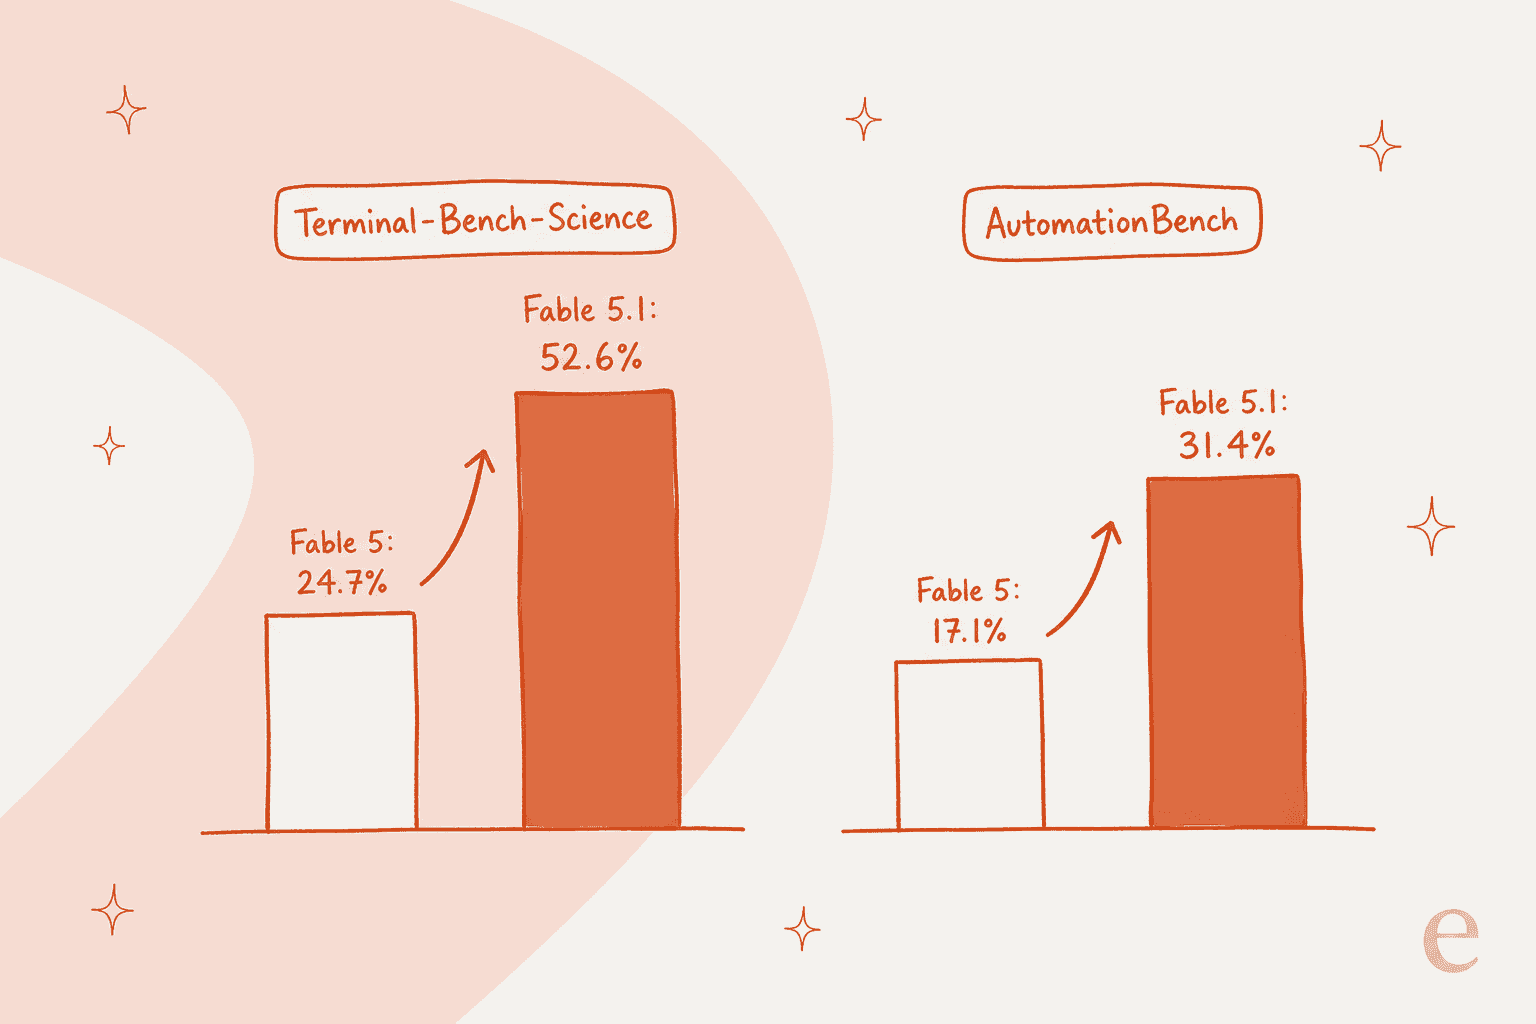
Sobre el papel, Fable 5.1 arrasa. Anthropic reporta que lidera cada prueba que publica, y los dos mayores saltos respecto a Fable 5 merecen una mirada detenida.
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science (ciencia agéntica) | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 (programación agéntica) | 55,8% | 42,0% | 52,3% | 37,3% |
| GDPval-AA v2 (trabajo de conocimiento, Elo) | 1853 | 1723 | 1824 | 1711 |
| AutomationBench (flujos de trabajo empresariales) | 31,4% | 17,1% | 26,9% | 19,6% |
| CursorBench 3.2.0 (programación agéntica) | 73,4% | 70,5% | 70,0% | 67,2% |
| Humanity's Last Exam (con herramientas) | 65,0% | 63,8% | 63,6% | - |
| OSWorld 2.0 partial (uso del ordenador) | 77,9% | 72,9% | 75,4% | - |
El salto en Terminal-Bench-Science de 24,7% a 52,6% es el que llama la atención: la investigación científica agéntica más que se duplicó. El casi duplicado AutomationBench importa más para el comprador promedio, ya que es un proxy de los flujos de trabajo empresariales desordenados.
Ahora la parte honesta, que la página de marketing mayormente entierra. Todas esas cifras de Fable 5.1 se produjeron con las salvaguardas de producción activadas, y Anthropic señala que donde las salvaguardas intervinieron, Fable 5.1 obtuvo cero en esas tareas, así que el techo de capacidad real (aproximado por Mythos 5.1, con salvaguardas más ligeras, que alcanza 60,9% en Terminal-Bench 4.0) es más alto. Y hay un error estándar de aproximadamente 3,5 a 4,5 puntos en el benchmark de ciencia. Los benchmarks son aquí una señal direccional, no una regla exacta.
El reflejo de escepticismo de la comunidad es saludable, y lo comparto:
"¿Cómo es posible que todos los modelos de xAI, OpenAI, Anthropic, Qwen, etc. ganen todos los benchmarks en cada lanzamiento? Mañana todos los anteriores (excepto Anthropic, claro) subirán de versión y estarán en la cima de HN ganando todos los benchmarks."

Así que doy más peso a las ejecuciones de clientes que Anthropic divulgó que a la clasificación. Ramp reportó una única ejecución de 38 horas sin supervisión que diagnosticó un mal resultado de ML como un artefacto de etiquetado y puso en marcha seis experimentos durante la noche. Millennium dijo que encontró la causa de un fallo de uno en un millón que ningún ingeniero ni modelo había descifrado en cuatro o cinco años. Browserbase lo situó en el 82% de las tareas en su benchmark de agentes de navegador más difícil, frente al 74% de Opus 5 y el 57% de Fable 5, usando menos tokens. Ese es el tipo de resultados de largo horizonte que una fila de benchmark no puede capturar.
En qué es realmente bueno
Destacaron tres cosas, y solo una de ellas está en una clasificación.
La escritura es la sorpresa. Durante años la queja más frecuente sobre Claude fue que su prosa sonaba como un memorando de cumplimiento normativo. Fable 5.1 es la primera versión en la que eso se invierte, y la reacción fue inmediata:
"Como usuario ferviente de Claude Code que me cambié a GPT 5.6 Sol en vez de Opus 5 por lo difícil de leer que era su prosa, esto me hace feliz. Me encanta su producto, pero los modelos actuales son muy difíciles de usar si hay que cambiar mucho de contexto. La brevedad es clave."
Glean dijo que sus jueces prefirieron las respuestas de Fable 5.1 en una proporción de aproximadamente 2 a 1 frente a Fable 5 en conocimiento cotidiano y redacción, y Canva calificó la escritura como "lo más destacado". Si escribe para ganarse la vida, esta es la mejora que importa más que cualquier puntuación de programación.
La programación aguanta en sesiones largas. Esta es la promesa y en su mayor parte se cumple. SpaceXAI (Cursor) lo calificó como el modelo más capaz que han ejecutado en CursorBench 3.2, especialmente al verificar su propio trabajo, y Red Hat dijo que encontró la causa raíz de cada build fallido que probaron. Las demostraciones de un solo intento inundaron X el día del lanzamiento, que son divertidas pero demuestran menos que lo aburrido (encontrar la causa raíz de un build fallido es la prueba real).
Las ejecuciones agénticas se mantienen en el carril. Every resumió el ángulo de eficiencia como "inteligencia de Fable, precio de Opus, velocidad de Sonnet", registrando alrededor del doble de velocidad que Opus 5 usando cerca de la mitad de los tokens. Un desarrollador capturó la versión práctica:
"un prompt, 43 minutos, $2,96: claude fable 5.1 escribió un mundo de 1.660 líneas"
Dónde falla
Un análisis justo nombra los límites, y Fable 5.1 tiene dos reales.
Los rechazos siguen siendo el mayor punto de dolor. Esto surgió una y otra vez el día del lanzamiento, y no es la típica queja de "la IA es demasiado cautelosa", son desarrolladores que no pueden hacer trabajo de seguridad legítimo sobre su propio código:
"Fable es inútil. Yo: "Encuentra los problemas de seguridad en mi propio código. Este es código que yo poseo. Hago esto bajo autorización del CEO/CTO de nuestra empresa." Fable: "sí, no.""
El propio planteamiento de Anthropic es que las salvaguardas cibernéticas ahora son más precisas, y los usuarios de Claude Code deberían ver alrededor de un 60% menos de intervenciones por sesión que con Fable 5, y Fable 5.1 ahora puede identificar vulnerabilidades de forma defensiva. Pero las pruebas de penetración, la generación de exploits y el escaneo de binarios todavía se redirigen a los modelos Opus, y los falsos positivos en el propio código son reales. Un probador resumió el problema de confianza sin rodeos: todavía "parece completamente incapaz de entender sus propias barreras y termina razonando hasta activarlas él mismo."
La marca de agua es un punto de fricción de confianza. Fable 5.1 añade una marca de agua estadística de texto en cada salida, para cumplir con la Ley de IA de la UE. No añade tokens ni caracteres ocultos y no codifica quién es usted, pero significa que Anthropic puede identificar el texto que produjo el modelo, y algunos usuarios están incómodos con eso:
"Aviso: la huella digital de Claude (marca de agua) ya está activa con Fable 5.1. Esto significa que Anthropic puede identificar texto generado por el modelo."

Si los requisitos de procedencia importan en su organización, eso es una ventaja. Si contaba con una salida indetectable, es un factor decisivo en contra. En cualquier caso, sepa que está ahí. También hay algunos cambios de API incompatibles respecto a Fable 5 que vale la pena revisar si construye sobre la API: el uso forzado de herramientas desapareció (un tool_choice de any o tool ahora devuelve un 400), los bloques de pensamiento están ligados al modelo, y las llamadas paralelas a herramientas son más variables.
Quién debería recurrir a él de verdad
El veredicto honesto, según quién sea usted:
- Ejecuta trabajos de agentes largos y autónomos. Sí. Este es exactamente el terreno natural del modelo, y el recorte en las lecturas de caché es lo que hace asequibles las ejecuciones de horas. Recurra a él.
- Escribe o hace trabajo intensivo de conocimiento. Un sí rotundo en calidad. El salto en la prosa es real y los resultados en presentaciones y hojas de cálculo son los mejores que Anthropic ha lanzado.
- Hace programación y chat cotidianos. Probablemente no, al menos no por defecto. Opus 5 es más barato y el propio Anthropic dice que empiece por ahí. Escale a Fable 5.1 cuando Opus 5 con esfuerzo alto se atasque.
- Hace investigación de seguridad. Pruebe los rechazos contra su flujo de trabajo real primero. La precisión mejoró, pero los falsos positivos en su propio código son una queja vigente.
- Solo quiere un agente de soporte o un redactor de contenido que funcione. Está comprando en la capa equivocada, más sobre eso a continuación.
Un modelo no es un compañero de equipo
Aquí está el replanteamiento con el que quiero que se quede, porque es donde la mayoría de las preguntas de "qué modelo debería comprar" se descarrilan. Fable 5.1 es un motor espectacular. No es un trabajador. No tiene idea de qué hace su producto, no puede ver su centro de ayuda ni sus últimos 10.000 tickets, no tiene integraciones, ni forma de que usted lo pruebe contra su propio historial antes de que toque a un cliente real. Comprar acceso a un modelo puro para resolver un problema de soporte o contenido es como contratar a la persona más inteligente del mundo y luego darle cero contexto, cero herramientas y cero incorporación.
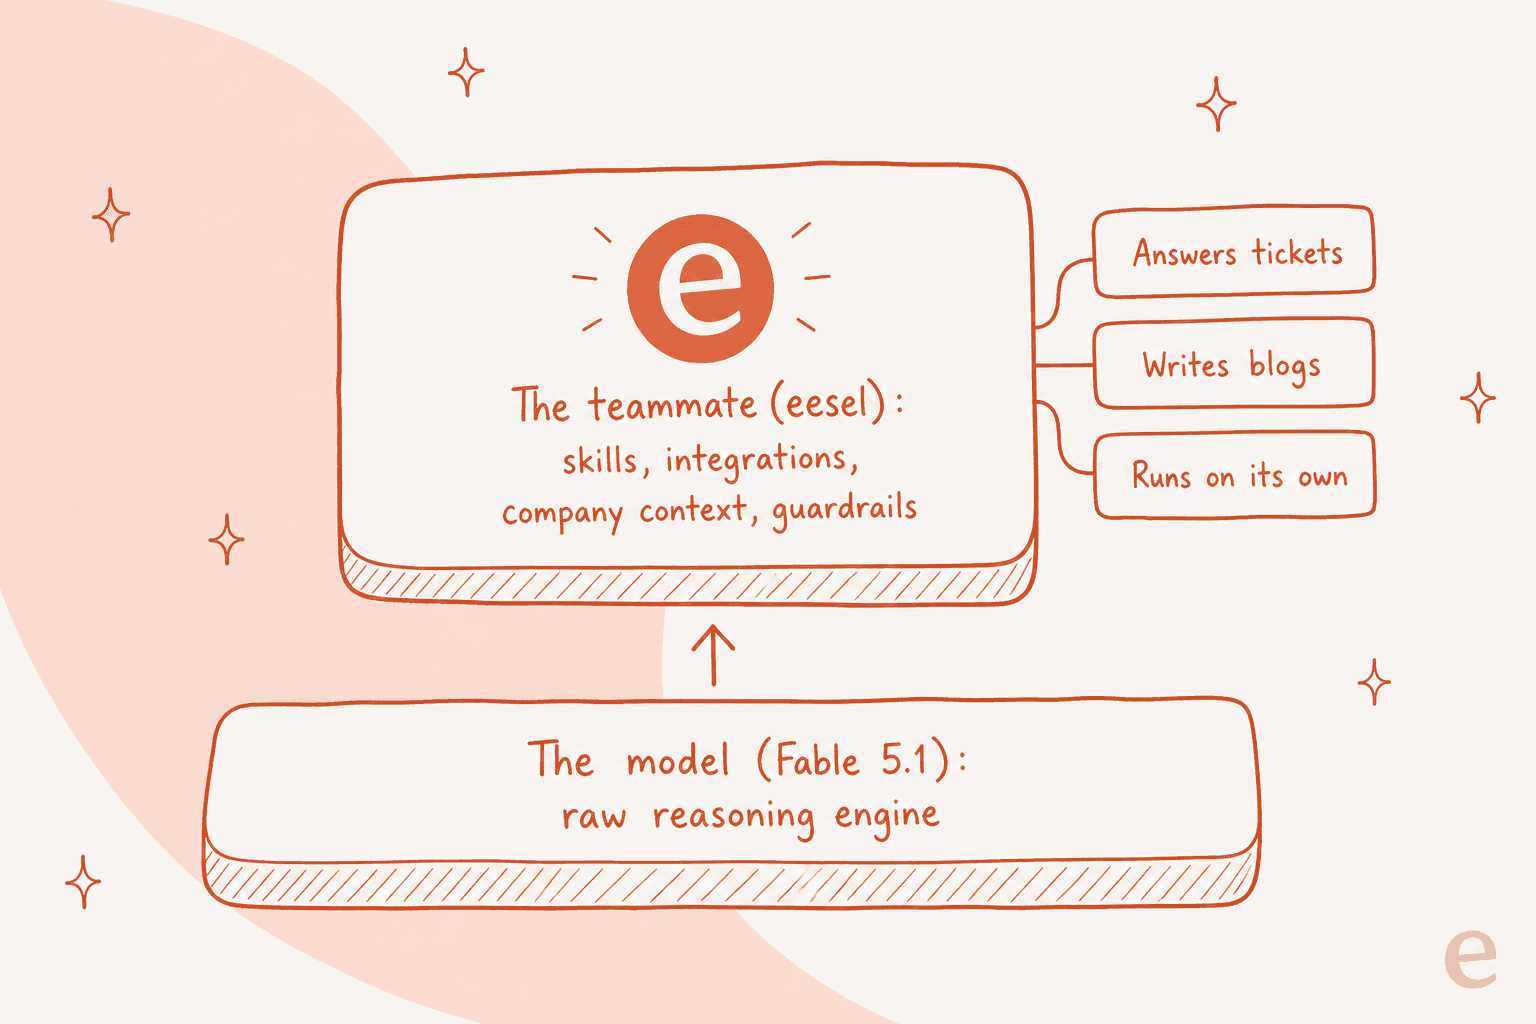
Esa brecha entre "modelo puro" y "compañero de equipo terminado" es toda la razón por la que existe eesel. La idea es simple: no contrata un modelo, contrata a un compañero de equipo listo para trabajar en un puesto específico. La oferta actual es un compañero de equipo de helpdesk de IA que se une a su cola de soporte existente, y un redactor de blog de IA, y cada uno llega ya con las habilidades, integraciones y contexto de la empresa que su rol necesita, funcionando sobre un modelo de vanguardia por debajo.
Y como es amigable con los agentes de principio a fin, no está atado a un panel de control. La CLI de eesel permite que una persona maneje al mismo compañero de equipo desde una terminal, que los scripts lo automaticen, y que agentes de programación como Claude Code o Cursor lo operen de forma programática, junto con MCP y webhooks. Si le gustó lo que hace Fable 5.1 dentro de Claude Code, así es como apunta esa misma energía a su espacio de soporte en lugar de a un repositorio nuevo.
Prueba eesel
Si llegó aquí tratando de averiguar con qué modelo ejecutar su soporte al cliente, la mejor pregunta es qué compañero de equipo contratar. eesel es una plataforma de compañeros de equipo con IA: el compañero de equipo de helpdesk de IA se conecta a herramientas como Zendesk, Freshdesk o Gorgias en minutos, aprende de sus tickets pasados y su centro de ayuda, y, de forma crucial, le permite simularlo sobre tickets pasados antes de que responda jamás a un cliente, así ve la tasa de resolución y las respuestas de antemano en lugar de accionar un interruptor y esperar lo mejor.
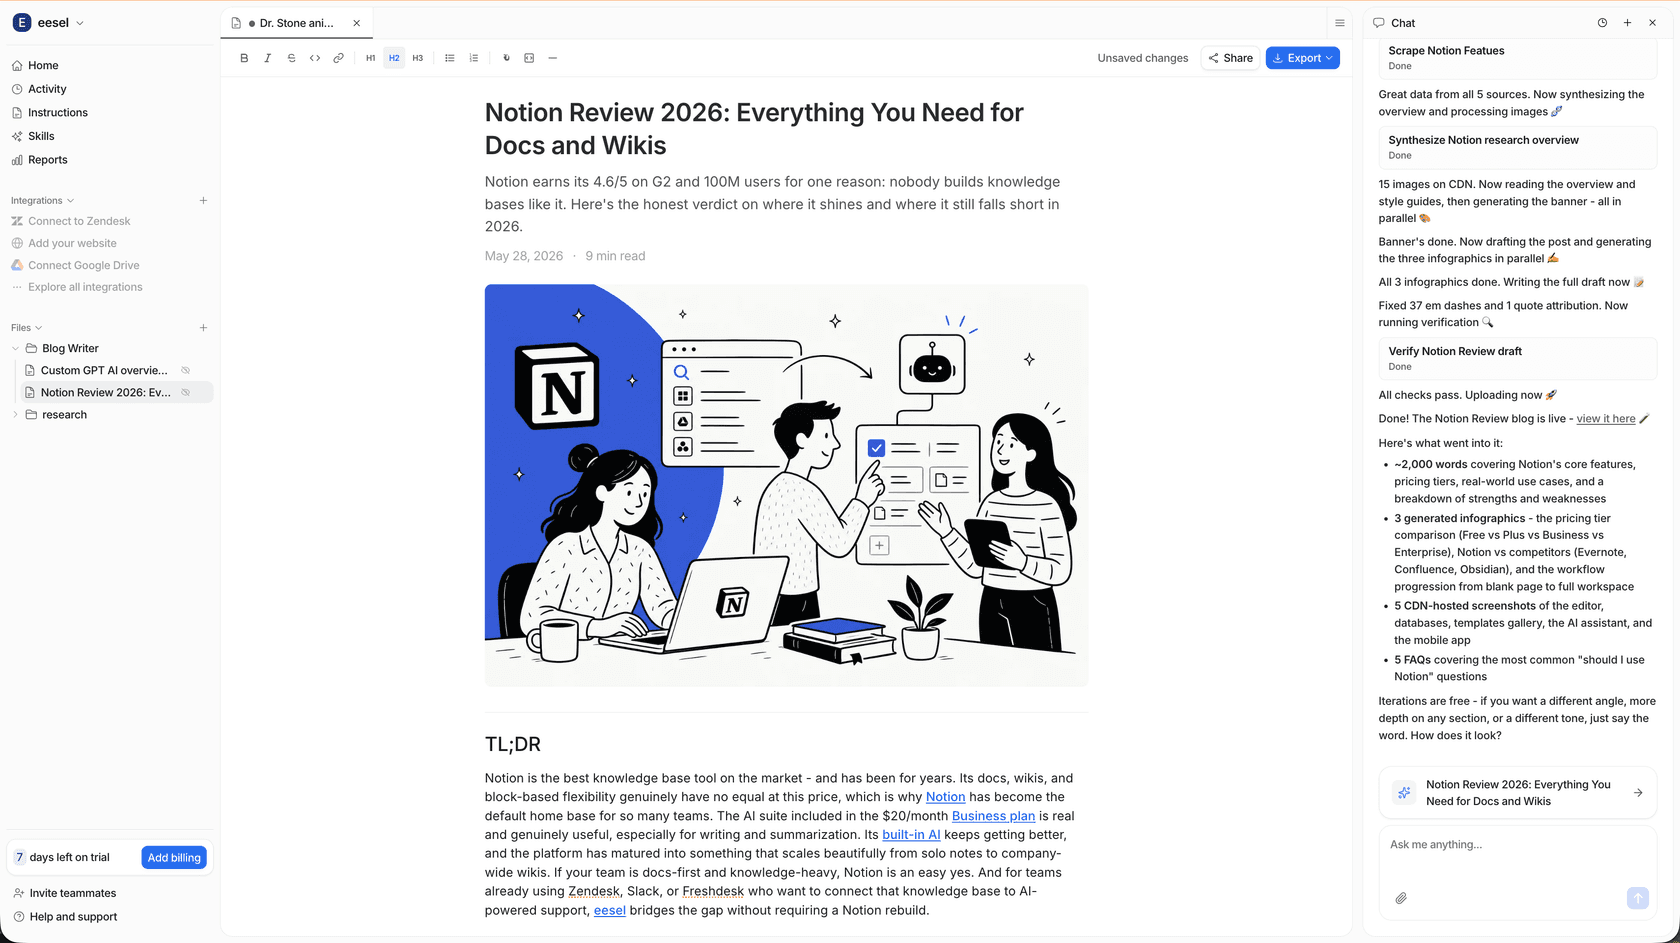
Ese paso de simular antes de lanzar es exactamente lo que un modelo puro como Fable 5.1 no le puede dar, y por eso elegir el modelo es la parte fácil y elegir al compañero de equipo es la que realmente decide su resultado. Puede probar eesel gratis.
Preguntas frecuentes
¿Cuánto cuesta Claude Fable 5.1?
¿Es Claude Fable 5.1 mejor que Opus 5?
¿Qué cambió en Claude Fable 5.1 respecto a Fable 5?
¿Claude Fable 5.1 rechaza demasiado?
¿Necesito Fable 5.1 para operar un agente de soporte de IA?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.