

¿Qué tan rápido es "ultrarrápido"?
La velocidad es todo el argumento, así que empiezo por los números que TypeSafe publica de verdad y luego los pongo a prueba.
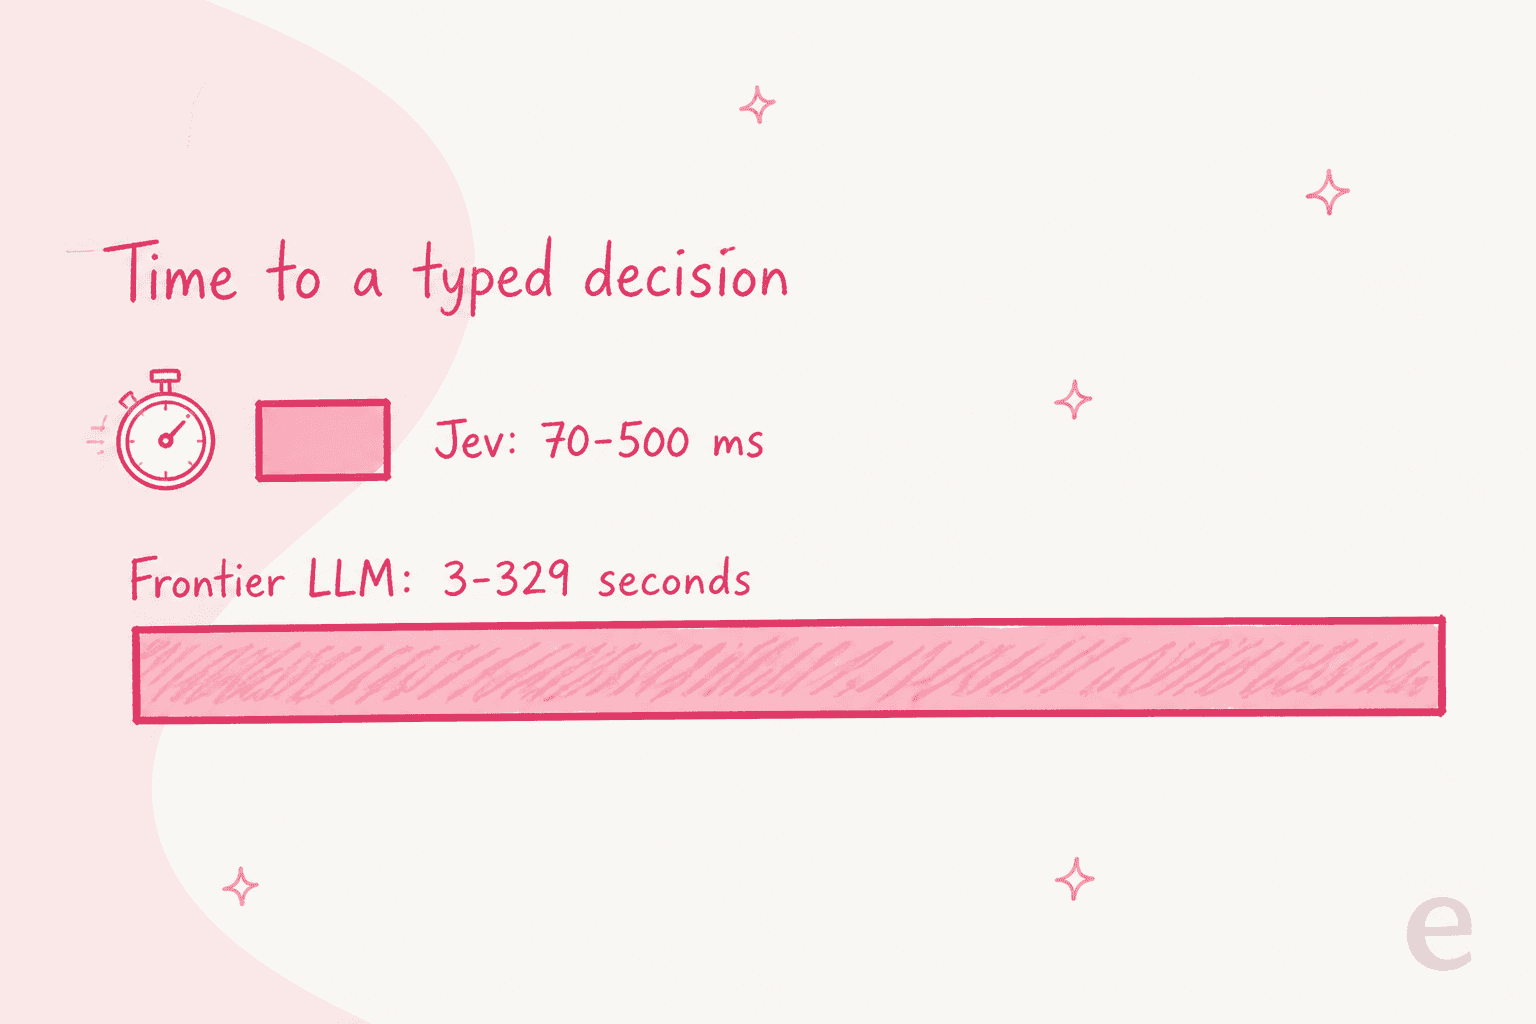
TypeSafe dice que el tiempo de respuesta de extremo a extremo de Jev es de 70 ms a 500 ms, frente a 3 a 329 segundos de los LLM de frontera en consultas de tipo System One. En su página de inicio va más lejos con un benchmark de flujo de trabajo: 193,6x más rápido y 444,6x más barato, aunque la publicación de lanzamiento reconoce con honestidad que esas cifras "están en el extremo alto de las mejoras del mundo real". Una demo en la misma página mide una sola decisión en 0,114 segundos y 0,000081 $, frente a 8,566 segundos y 0,013880 $ de una referencia con LLM.
Aquí está el mismo conjunto con las salvedades incluidas, porque las referencias importan tanto como los números.
| Afirmación | Jev | Referencia indicada por TypeSafe |
|---|---|---|
| Latencia de extremo a extremo | 70 ms a 500 ms | 3 a 329 segundos para LLM de frontera |
| Múltiplo de velocidad | 40x a 200x más rápido | en consultas de tipo System One |
| Titular de flujo de trabajo | 193,6x más rápido | "en el extremo alto de las mejoras del mundo real" |
| Demo de decisión única | 0,114 s | 8,566 s para la referencia con LLM |
| Ventana de contexto | 32.000 tokens | versión del modelo jev-1.13.0 |
El rango de 70-500 ms es la cifra con la que yo planificaría, porque describe una sola solicitud y no un flujo de trabajo entero. Con esa latencia, una decisión cabe dentro de una solicitud que un usuario está esperando, algo imposible cuando un paso de clasificación tarda ocho segundos.
Por qué Jev es rápido: una pasada paralela, no un flujo de tokens
La velocidad no es un truco de ajuste, viene de un diseño distinto. Un LLM muestrea un token a la vez, en secuencia, hasta producir una cadena para que la lea una persona. Jev genera todas sus salidas en una sola pasada paralela y nunca produce texto libre.
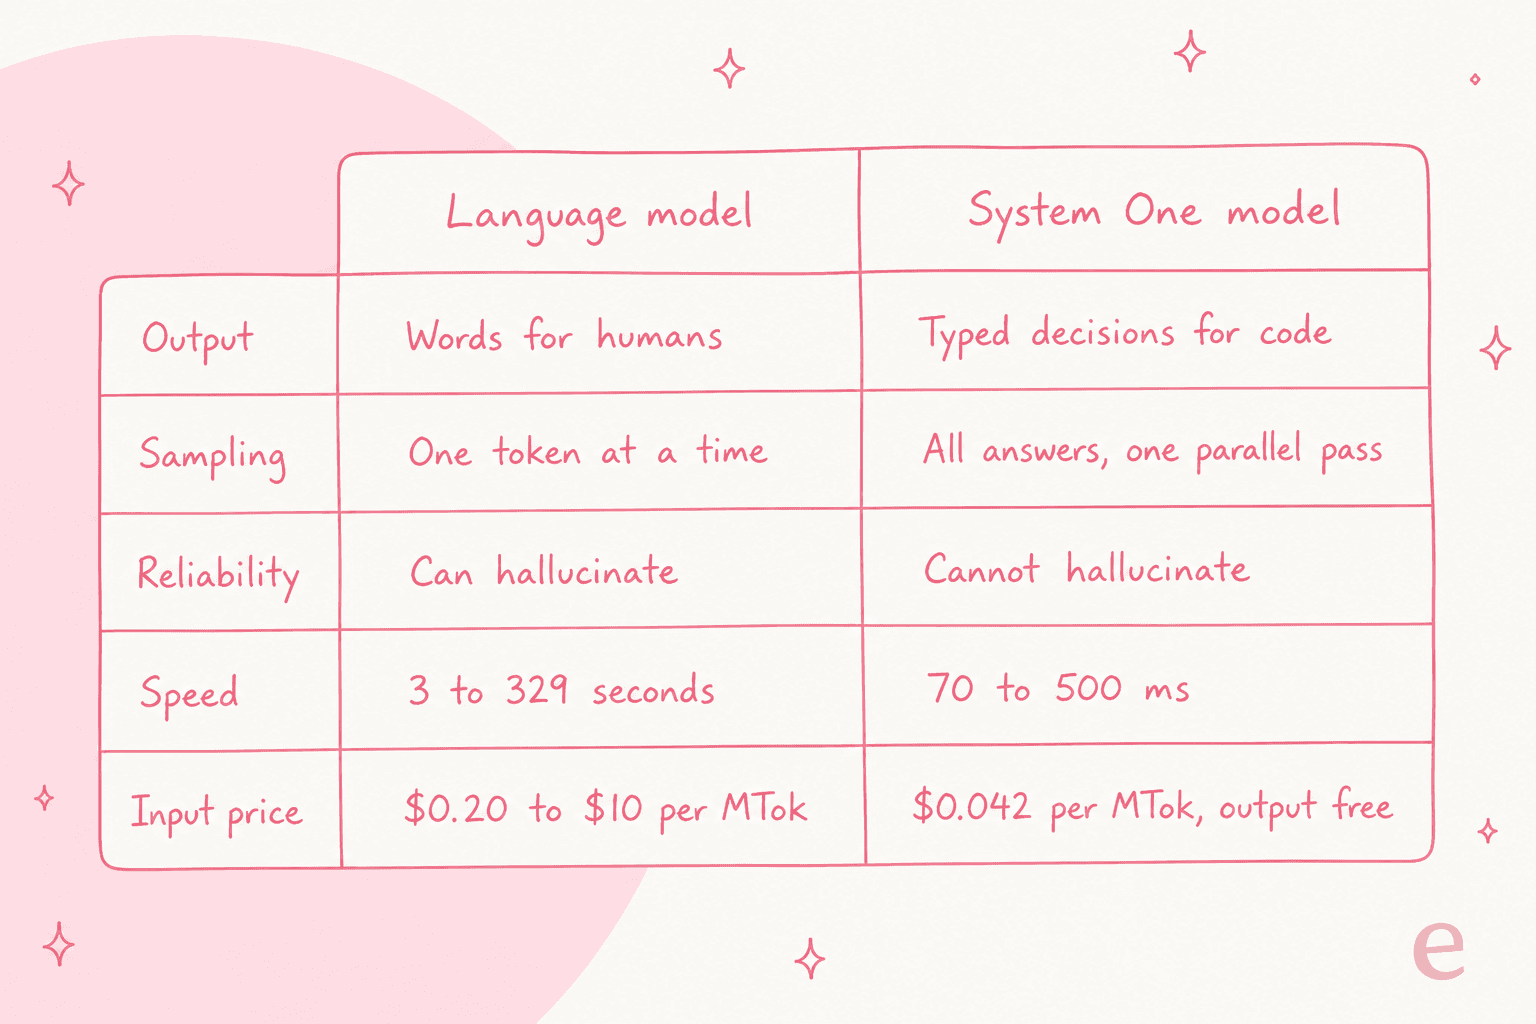
Le envías a Jev un estado (una cadena o un objeto estructurado) más un conjunto de preguntas tipadas. Evalúa cada pregunta en paralelo contra ese mismo estado y devuelve respuestas tipadas con probabilidades y una puntuación de confianza. Como cada pregunta se puntúa por separado, TypeSafe dice que añadir más apenas cambia el tiempo de respuesta, así que puedes preguntar "¿es urgente?", "¿qué departamento?" y "¿qué tan frustrado está?" en una sola llamada y seguir dentro de tu presupuesto de latencia.
Por eso describir a Jev como una primitiva rápida es más justo que decir "un LLM más rápido". Encaja donde hoy fuerzas a un modelo de lenguaje a emitir un blob JSON que luego parseas y rezas para que sea válido, la misma pregunta de "qué capa elijo" que aparece en AgentKit frente a la API de Anthropic. No encaja donde necesitas redacción, explicación o razonamiento de varios pasos.
La comparación de velocidad no es del todo equivalente
Esto lo detectó el público del día de lanzamiento en menos de una hora, y conviene ser claros. Jev es rápido en parte porque hace menos. El comentario más votado del hilo de Hacker News, con 1.929 puntos, replanteó todo el lanzamiento, y la crítica de latencia más afilada llegó justo después:
"'70-500ms vs 3-329 seconds' are apples-to-oranges unless the LLM baseline is doing comparable work... If Jev is skipping generation entirely for a narrow structured task, of course it's faster."

Es un golpe justo. Comparar un modelo que emite tres valores tipados con otro que escribe un párrafo, y luego llamar al primero 200x más rápido, es medir dos cosas distintas. La lectura honesta es que Jev es extremadamente rápido para la porción de trabajo con forma de decisión a la que apunta, y esa porción es real y común. No es más rápido en los trabajos que simplemente no hace.
Así que la cifra en la que más confío ni siquiera está en el sitio de TypeSafe. Vino del CEO de Vercel al poner Jev en un producto en producción:
"We're seeing extraordinary results from @typesafeai... Jev is up to 18x faster (p95) and more accurate."
Una mejora de 18x en p95 en un paso real de revisión de seguridad es a la vez menor y mucho más sólida que la cifra de marketing de 200x, y señala justo dónde rinde lo ultrarrápido.
Dónde la velocidad realmente rinde
La latencia inferior al segundo solo vale la pena cuando una decisión está en la ruta crítica, con algo esperando la respuesta. Ese es el patrón que hay que buscar: un verificador rápido delante de un sistema más lento.
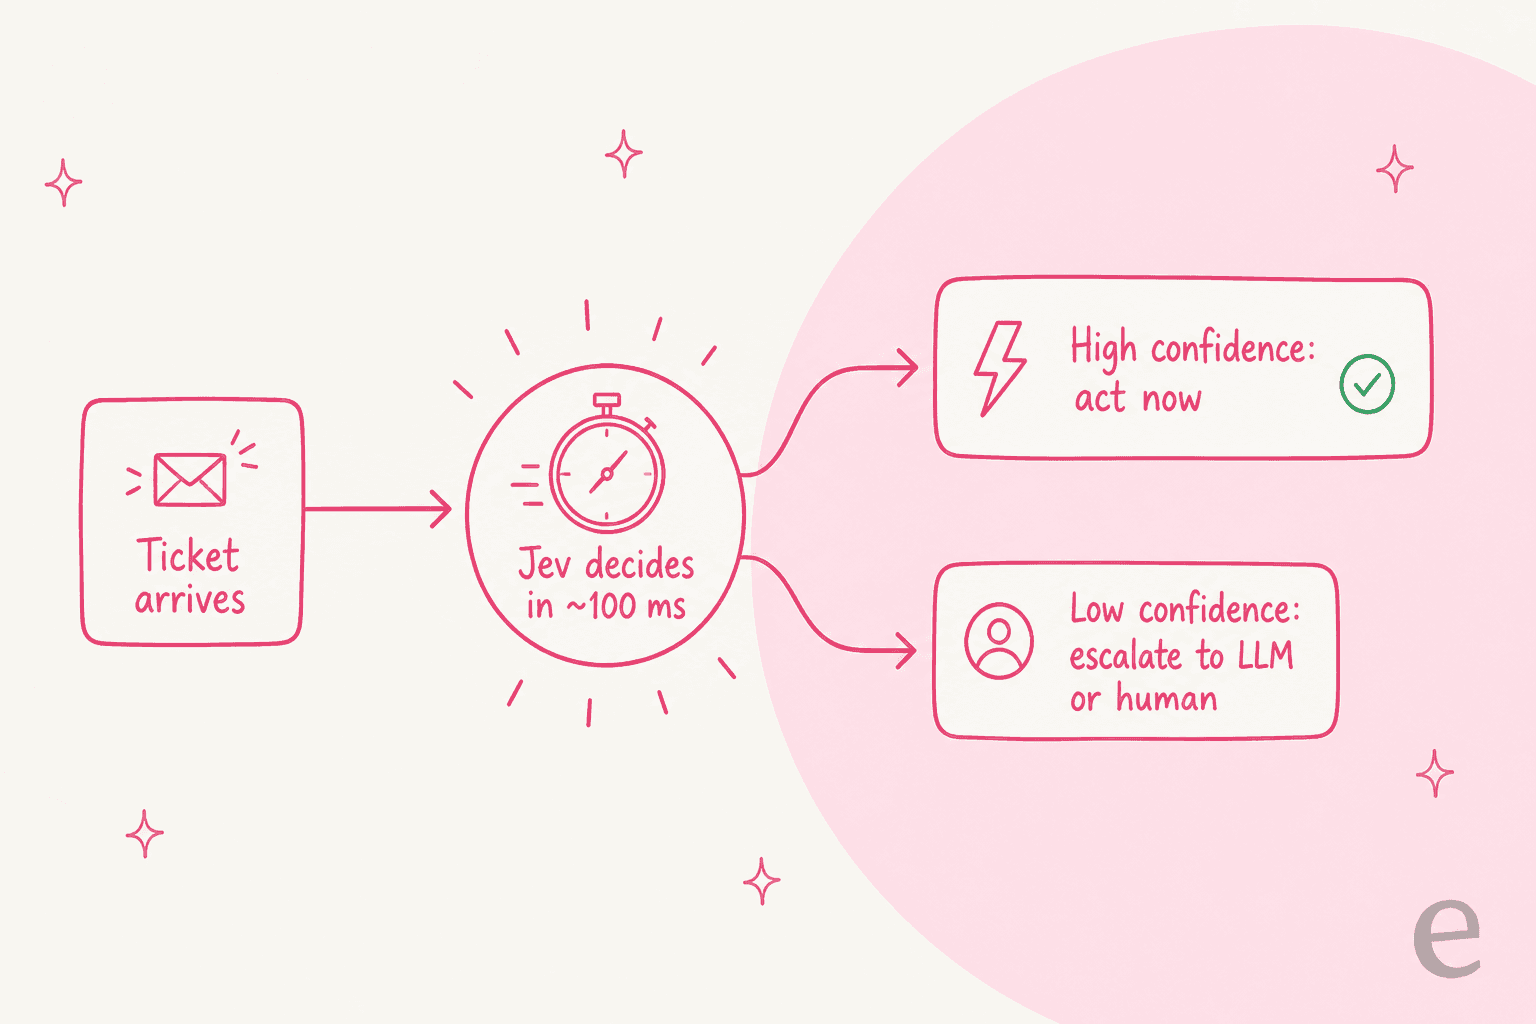
El ejemplo práctico que publica Cloudflare es, significativamente, un ticket de soporte: dale a Jev "Help! My payouts have been failing for 3 days" y devuelve is_urgent con 0,95, department como facturación con 0,8 de confianza y una puntuación de frustración, todo en una llamada. Eso es triaje, derivación y sentimiento en una sola solicitud, justo el tipo de paso que un flujo de triaje de tickets con IA ejecuta miles de veces al día. Cuando cada llamada tarda 100 ms en vez de 8 segundos, puedes ejecutarla de forma síncrona al llegar el ticket en lugar de en una lenta cola en segundo plano.
El desarrollador que mejor resumió el apetito ya lo estaba haciendo a mano:
"this is exactly how I am using LLMs in production, to narrowly make choices and return structured data... Jev's focus on structured I/O and confidence scores are game changing."
La puntuación de confianza es lo que hace usable la velocidad en un bucle así: actuar al instante sobre las respuestas seguras y enviar las dudosas a un modelo más grande o a una persona. Es la misma disciplina que hay detrás del buen diseño de agentes de IA y de cualquier paso serio de asistencia al agente, donde el objetivo es velocidad sin dejar que una decisión errónea pero segura de sí misma llegue a un cliente.
Lo que cuesta funcionar tan rápido
La otra mitad de "ultrarrápido" es que es lo bastante barato como para llamarlo constantemente. TypeSafe fija el precio de Jev en 0,042 $ por millón de tokens de entrada con la salida gratis, lo que presenta como 238x menos en entrada que Claude Fable 5.1, y describe la salida como "too cheap to meter". Todavía no hay una página de precios independiente, y sobre la sostenibilidad la publicación de lanzamiento es refrescantemente clara: "We can't prove it isn't subsidized; we'll need the long-term to prove the sustainability of our pricing (which we expect to go down, not up)."
Barato por llamada más rápido por llamada es lo que desbloquea el argumento de la paradoja de Jevons que da nombre al modelo: cuando una decisión cuesta una fracción de centavo y vuelve en 100 ms, dejas de racionarla y empiezas a llamarla en todas partes, igual que ya te apoyas en primitivas baratas en la automatización de flujos de trabajo con IA. Es una postura muy distinta a pagar precios de LLM por cada clasificación.
¿Deberías construir sobre la velocidad de Jev?
Mi lectura tras revisar la documentación, las demos y las críticas: recurre a Jev cuando el trabajo sea una decisión estrecha y bien acotada que tu código consume y la latencia esté en la ruta crítica, como derivación, moderación, detección de intención, puntuación o una puerta de seguridad rápida delante de un modelo mayor. Ahí es donde los 70-500 ms y la salida gratis cambian de verdad lo que puedes construir.
No lo uses esperando un ChatGPT más rápido. No escribe, no explica ni mantiene una conversación, y una herramienta tan rápida invita al abuso en tareas que un clasificador simple o una regla debería resolver. La línea que hay que mantener es que Jev es una primitiva: te da una gran decisión en milisegundos, y tú sigues siendo dueño del pipeline, de la lógica de escalado, de la estrategia de desviación y de cada acción posterior a la decisión. La velocidad en la decisión no te compra nada de eso.
Prueba eesel
Si gestionas soporte, la traducción honesta es esta: Jev es un motor brillante, no el coche. Te dirá que un ticket es urgente, de facturación y de un cliente frustrado en unos 114 milisegundos. No abrirá el ticket, no redactará una respuesta basada en tu centro de ayuda, no aplicará el reembolso ni pasará a una persona cuando no esté seguro. Alguien todavía tiene que construir esa capa.
eesel es ese compañero terminado. Es un compañero de soporte con IA que conectas a tu helpdesk, y ya toma las decisiones de triaje, derivación y escalado que Jev expone como primitivas, y luego actúa sobre ellas de principio a fin. Aprende de tus tickets anteriores y de tu centro de ayuda, y puedes simular con tickets históricos antes de que toque a un cliente real.

Y si te gustó la ergonomía para desarrolladores de Jev, esto te gustará: eesel no es solo un panel. La CLI de eesel (npx @eesel/cli) maneja el mismo compañero desde una terminal, una persona puede ejecutar eesel chat o eesel activity a mano, los scripts pueden automatizarlo en CI y agentes de programación como Claude Code, Codex y Cursor pueden controlarlo, ya que cada comando imprime JSON y --dry-run muestra la llamada exacta antes de que se dispare. Cada espacio de trabajo es además un servidor MCP. Jev te da la decisión rápida; eesel te da el compañero que actúa sobre ella. Puedes probar eesel gratis.
Preguntas frecuentes
¿Qué tan rápido es TypeSafe Jev?
TypeSafe sitúa el tiempo de respuesta de extremo a extremo de Jev en 70 ms a 500 ms, frente a 3 a 329 segundos de un LLM de frontera en trabajo del mismo tipo. El detalle es que Jev solo devuelve decisiones tipadas, no texto, así que la comparación no es del todo equivalente. Es realmente rápido para las tareas de clasificar y derivar que hay detrás de la desviación de nivel 1.
¿Por qué Jev es mucho más rápido que un modelo de IA normal?
Un LLM muestrea un token a la vez hasta escribir una cadena que lee una persona. Jev evalúa todas sus preguntas en una sola pasada paralela y nunca genera texto libre, así que se salta la parte más lenta. Eso también significa que es una primitiva de decisión, no un sustituto de un modelo que escribe o razona, la misma división que ves entre un agente basado en reglas y uno de IA.
¿Es justa la comparación de velocidad de Jev?
En parte. Una cifra real y sólida vino del CEO de Vercel, que midió Jev 18 veces más rápido en p95 en un paso real de revisión de seguridad. La cifra de marketing de 193,6x corresponde a un flujo de trabajo completo y, en palabras de la propia TypeSafe, está en el extremo alto de las mejoras reales, algo que Hacker News señaló enseguida.
¿Cuánto cuesta el modelo ultrarrápido Jev?
TypeSafe fija el precio de Jev en 0,042 $ por millón de tokens de entrada con la salida gratis, lo que presenta como un precio de entrada 238 veces menor que Claude Fable 5.1. Todavía no hay tabla de planes y el acceso es mediante una lista de espera de acceso anticipado. También está disponible en Cloudflare Workers AI.
¿Puedo usar Jev para responder tickets de soporte por sí solo?
No por sí solo. Jev toma la decisión rápida, pero no abre el ticket, no redacta una respuesta fundamentada ni aplica el reembolso. Un compañero terminado como eesel toma esas decisiones de atención al cliente y actúa sobre ellas en tu helpdesk, e incluso puedes manejarlo desde la CLI de eesel.