

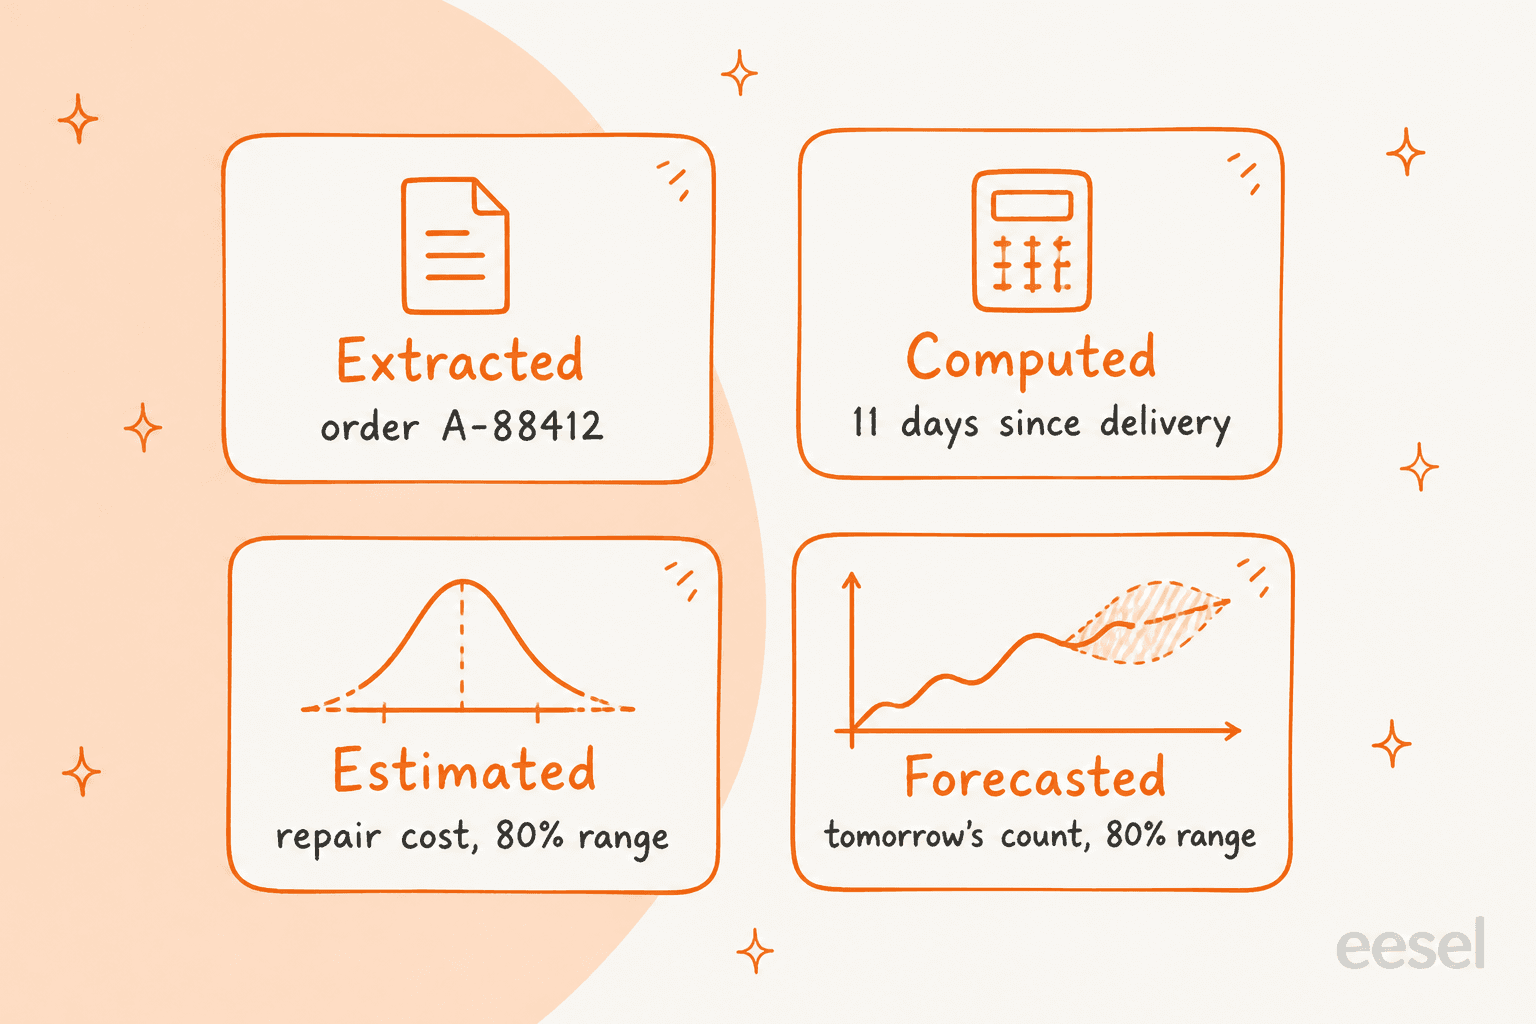
Cloudflare Clairic es un nuevo modelo de extracción que Cloudflare lanzó en vista previa en Workers AI el 19 de octubre de 2026. Le das entradas desordenadas (un correo, la foto de un recibo, un CSV) más una lista de campos tipados, y devuelve un valor tipado por campo, con una puntuación de confianza, en una sola pasada y sin generar texto. Puede copiar un valor (un número de pedido), calcularlo (días desde la entrega), estimarlo con un rango del 80 % (un coste de reparación) o prever los siguientes pasos de una serie.
Cuesta 0,10 $ por millón de tokens de entrada, sin cargo de salida, y los pesos abiertos están prometidos «pronto». En la demo del pedido dañado de Cloudflare, Clairic hizo la extracción en 0,46 segundos donde GLM-5.3 tardó 16,1, y toda la cadena Clairic, Clef y LLM costó un 49 % menos que usar un LLM para cada paso.
Para los equipos de soporte, Clairic es un analizador muy bueno y nada más. Convierte «el pedido A-88412 llegó roto» en campos en los que tu código puede confiar. No busca el pedido, no responde ni reembolsa. Si quieres tanto la lectura como el trabajo posterior, el compañero de IA de eesel para el helpdesk hace las dos cosas dentro de tu helpdesk, y así consigue Rúngne que cada ticket de Gorgias esté confirmado, etiquetado y con borrador antes de que una persona lo abra.
¿Qué es Cloudflare Clairic?
Trabajo la cola de soporte de eesel todos los días, y lo lento de la mayoría de los tickets no es escribir la respuesta. Es copiar. El número de pedido del segundo párrafo, la fecha de entrega del correo de seguimiento, el total de la foto borrosa de un recibo. Cloudflare Clairic es un modelo hecho justo para ese copiado, y es lo más práctico que ha salido hasta ahora de la ola «System One».
Clairic se lanzó en el blog de Cloudflare el 19 de octubre de 2026, escrito por Alex Reneau, Michelle Chen y Kevin Flansburg, del equipo de Workers AI. Vive en Workers AI como @cf/cloudflare/clairic, está marcado como vista previa y Cloudflare dice que prevé publicar los pesos más adelante.
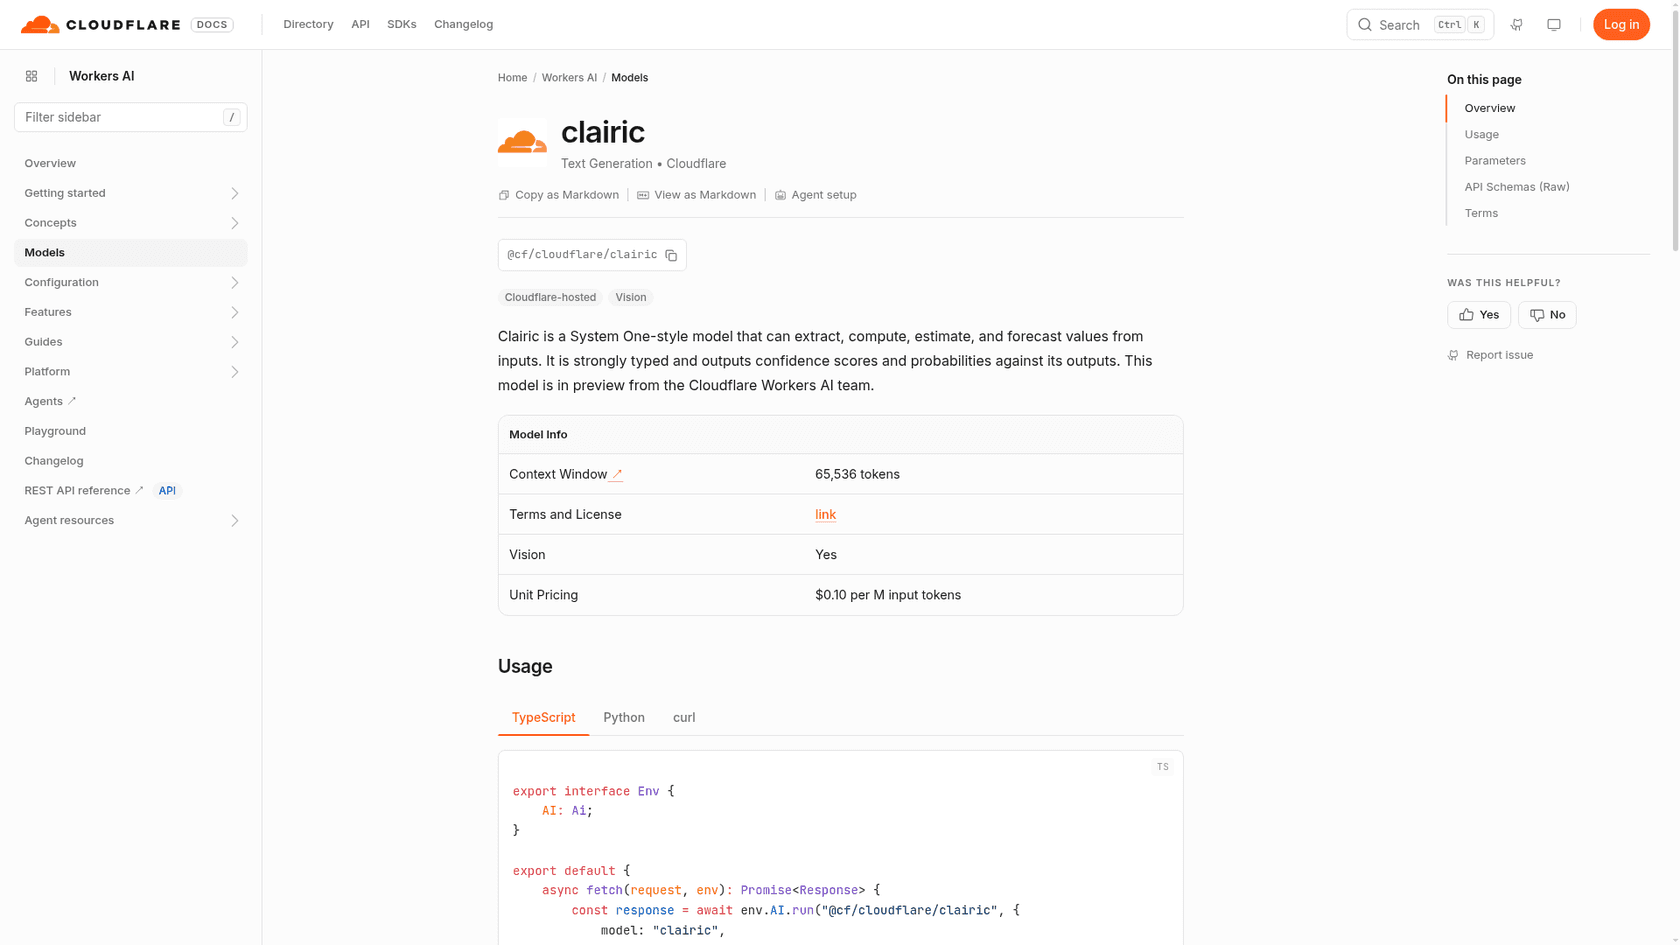
La ficha del modelo es corta. Una ventana de contexto de 65.536 tokens, soporte de visión (hasta cuatro imágenes por solicitud) y una sola línea de precio. El nombre, según Cloudflare, mezcla «clerical» (oficinista), «clairvoyance» (clarividencia) y Cloudflare AI Regression model, que resume bien lo que hace: introducción de datos aburrida más un poco de predicción. Cierra unas semanas intensas para el equipo de IA de Cloudflare, después del navegador para agentes Kitesurf y de una API de búsqueda web.
¿Por qué Cloudflare creó un modelo de extracción?
Un mes antes de Clairic, TypeSafe presentó Jev y la idea de los modelos System One, tomada del pensamiento rápido y lento de Daniel Kahneman. Cloudflare siguió el 1 de octubre con Clef, su propio modelo de decisión. Ambos responden preguntas en las que puedes enumerar de antemano las respuestas posibles: si es urgente, qué equipo se encarga, reembolso o reparación.
El argumento de Cloudflare es que muchas de las llamadas de salida estructurada que van a los LLM de frontera tienen respuestas que no puedes enumerar de antemano. ¿Cuál es el total de la factura? ¿Cuándo se entregó? ¿Cuántos días de retraso hay? Un modelo de decisión no ayuda ahí, porque no hay un conjunto fijo de opciones sobre el que repartir probabilidades. Clairic es el primer modelo de la segunda clase, que Cloudflare llama modelos de extracción System One.
Así presenta Cloudflare las tres clases, resumido de su publicación de lanzamiento:
| System One: extraer | System One: decidir | System Two | |
|---|---|---|---|
| Modelos de ejemplo | Clairic | Jev, Clef | GPT, Claude, Gemini, DeepSeek |
| Cómo se ejecuta | Una pasada en paralelo | Una pasada en paralelo | Un token cada vez |
| Salida | Valores tipados: fragmentos, números, fechas, listas, distribuciones | Una de tus opciones listadas, con probabilidades | Texto libre |
| Qué responde | ¿Cuál es el importe? ¿Cuándo ocurrió? ¿Cuánto será? | ¿Qué categoría? ¿Qué acción? | ¿Por qué ocurrió? ¿Cómo lo arreglamos? |
| ¿Siempre una respuesta válida? | Sí, un valor de su tipo o null | Sí, una de tus opciones | No, hay que analizar y comprobar el texto |
La frase de la publicación de Cloudflare a la que vuelvo una y otra vez es esta: los modelos de extracción convierten la entrada en bruto en valores tipados, los modelos de decisión convierten valores en decisiones y los LLM convierten decisiones en palabras. Es una forma limpia de dividir un flujo de soporte, y se parece más a cómo trabaja un buen agente un ticket que a «mandar todo a un modelo grande y esperar lo mejor».
¿Cómo funciona Cloudflare Clairic?
Una solicitud tiene dos partes. El state es el texto que quieres que lea (más hasta cuatro imágenes PNG, JPEG o WebP, enviadas en línea). El mapa fields es tu esquema: cada campo tiene un nombre, un tipo y instructions opcionales en lenguaje llano. Clairic lee todo en una sola pasada hacia delante y responde todos los campos a la vez, así que pedir treinta campos cuesta más o menos lo mismo que pedir tres.
No hay límite superior de campos. La documentación del modelo dice que los campos que no caben junto al state en una pasada de 8.192 tokens se reparten en pasadas paralelas que ven toda la entrada, y luego se fusionan.
| Tipo de campo | Qué recibes |
|---|---|
text | Un fragmento exacto de la entrada, con sus desplazamientos de caracteres |
number | Un número leído o calculado, respetando integer y decimals |
date, time, datetime | Fechas de calendario reales y horas válidas, en formato ISO |
duration | Una duración en la unidad que elijas |
list | Todos los textos, números o fechas que coincidan, en el orden de la entrada |
estimate | Una distribución dentro de tus min y max, sobre tu cuadrícula step, en escala lineal o logarítmica |
forecast | Una estimación por cada paso futuro de una serie, hasta 64 pasos |
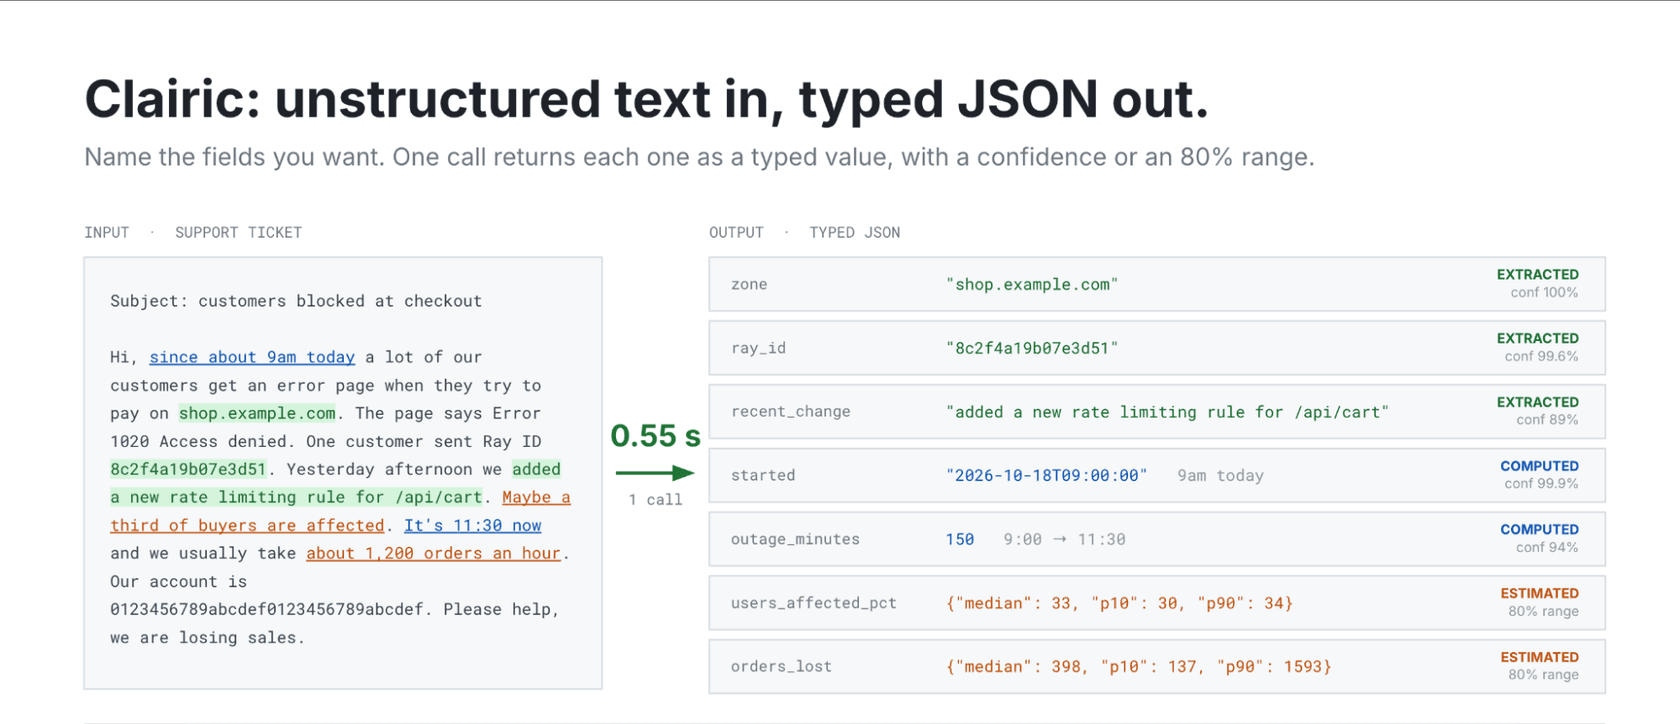
Toda respuesta de un solo valor llega con p_null (la probabilidad de que la entrada no lo contenga) y una puntuación confidence. Las estimaciones y previsiones llegan con una mediana y un intervalo del 80 %, de p10 a p90, y puedes pedir los 99 percentiles con options.include_quantiles. Si un campo depende de la fecha de hoy, la entrada del changelog dice que fijes reference_date o añadas al state una línea como «Today: 2026-10-19».
Valores extraídos y calculados
El ejemplo principal de Cloudflare es un correo de soporte, y por eso le presté atención. Un cliente escribe que el pedido A-88412 llegó el 28 de septiembre con la pantalla agrietada y una esquina abollada, que pagó 649,00 $ más 52,10 $ de impuestos y que hoy es 9 de octubre. A Clairic se le piden seis campos, y las respuestas muestran toda la idea de una vez:
order_idvuelve como"A-88412"con su fragmento en el correo y una confianza de 0,999957.amount_paidvuelve como701.1, un número que no está escrito en ningún sitio. Clairic sumó el precio y los impuestos.days_since_deliveryvuelve como11, calculado a partir de dos fechas del texto.damagevuelve como una lista,["cracked screen", "dented corner"], con ambos fragmentos para que puedas resaltarlos.tracking_numbervuelve comonull, porque el correo no trae ninguno. Elguessdel modelo fue «$52.10», con una confianza de 0,416 y unp_nullde 1.
Esto último es lo que debería importarle a la gente de soporte. Un LLM al que se le pide un número de seguimiento a veces te entrega una cadena de aspecto plausible. Clairic te entrega null y te dice qué habría adivinado, de modo que tu código puede preguntar al cliente en lugar de buscar en la transportista un número que no existe. Es el mismo instinto que la prevención de alucinaciones en un bot de soporte, integrado en el formato de salida.
Cloudflare también pasó por el modelo la foto de un recibo real y algo torcido. Clairic leyó el número de pedido, la marca de tiempo, la cantidad, el precio unitario, el subtotal, los impuestos y la propina, y devolvió null para el descuento porque no había ninguno impreso. La confianza fue menor en las lecturas difíciles (0,78 en el número de pedido, 0,83 en la marca de tiempo) y superior a 0,99 en las limpias, que es el comportamiento que quieres.
Valores estimados
Algunos valores no están en la entrada, pero la entrada contiene indicios. El ejemplo de Cloudflare es el precio de una casa: cinco ventas comparables y una propiedad objetivo, con un campo sale_price de tipo estimate entre 50.000 $ y 5.000.000 $ en escala logarítmica. Clairic devolvió una mediana de 415.000 $ y un rango del 80 % de 370.000 $ a 470.000 $.
La anchura de ese rango es la parte útil. La guía de modelos de extracción de Cloudflare dice que un intervalo estrecho indica que la entrada respalda la estimación y uno ancho indica que no. En soporte, eso es la estimación del coste de reparación en el ejemplo del pedido dañado, y es lo que permite que el siguiente paso decida «reparar» o «reembolsar» sin que una persona adivine.
Valores previstos
Un campo forecast toma un historial como texto plano y devuelve una estimación por cada paso futuro, cada una con un intervalo del 80 %. Cloudflare lo probó con el número diario de personas controladas en los puntos de seguridad de los aeropuertos de EE. UU., pidiendo cada mañana el recuento del día siguiente durante 21 días seguidos.
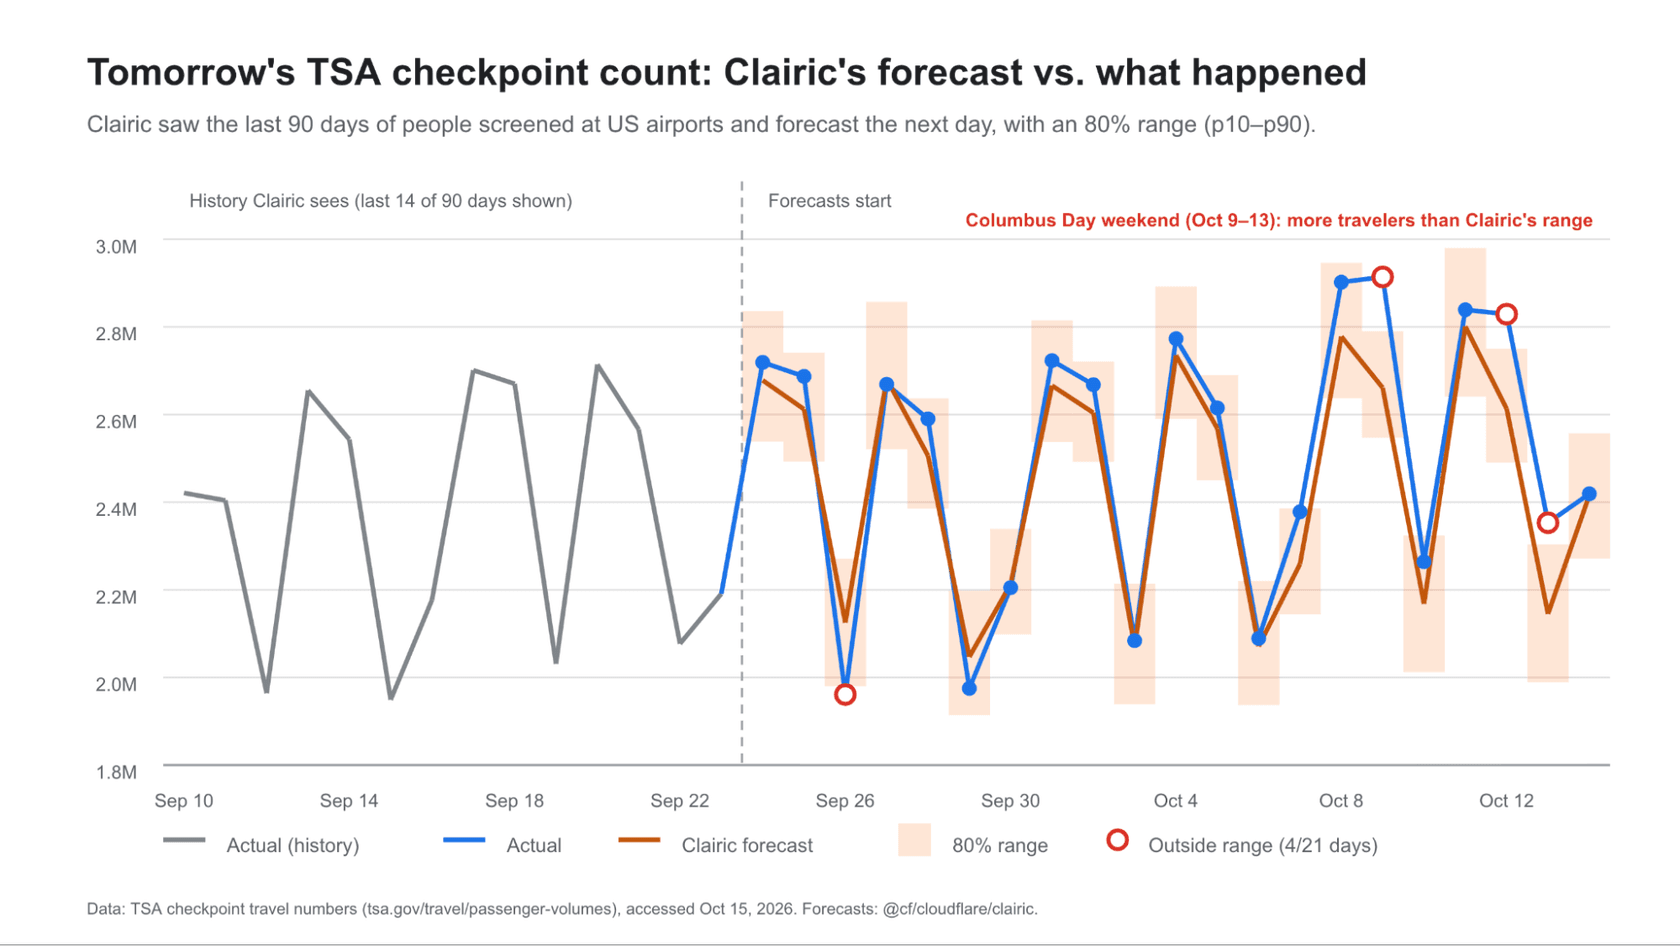
Las previsiones se desviaron un 3,3 % de media, y 17 de los 21 recuentos reales cayeron dentro del intervalo del 80 %, que es más o menos lo que debe hacer un intervalo del 80 %. Tres de los cuatro fallos cayeron en el fin de semana del Columbus Day, porque Clairic lee patrones de la serie y no conoce los festivos que la serie no muestra. Cloudflare es franco en que esto no sustituye a un modelo de series temporales dedicado, así que yo no planificaría un cuadrante de festivos con esto. Para eso, una buena previsión de plantilla de soporte sigue siendo la herramienta.
Clairic vs Clef vs un LLM: ¿cuál es la diferencia?
La forma más clara de ver dónde encaja Clairic es la cadena que Cloudflare montó para el lanzamiento. El mismo correo de pedido dañado pasa por dos configuraciones. En una, Clairic extrae los hechos, Clef decide entre reembolso y reparación gratuita según una política escrita, y GLM-5.3 redacta la respuesta. En la otra, GLM-5.3 hace los tres pasos.
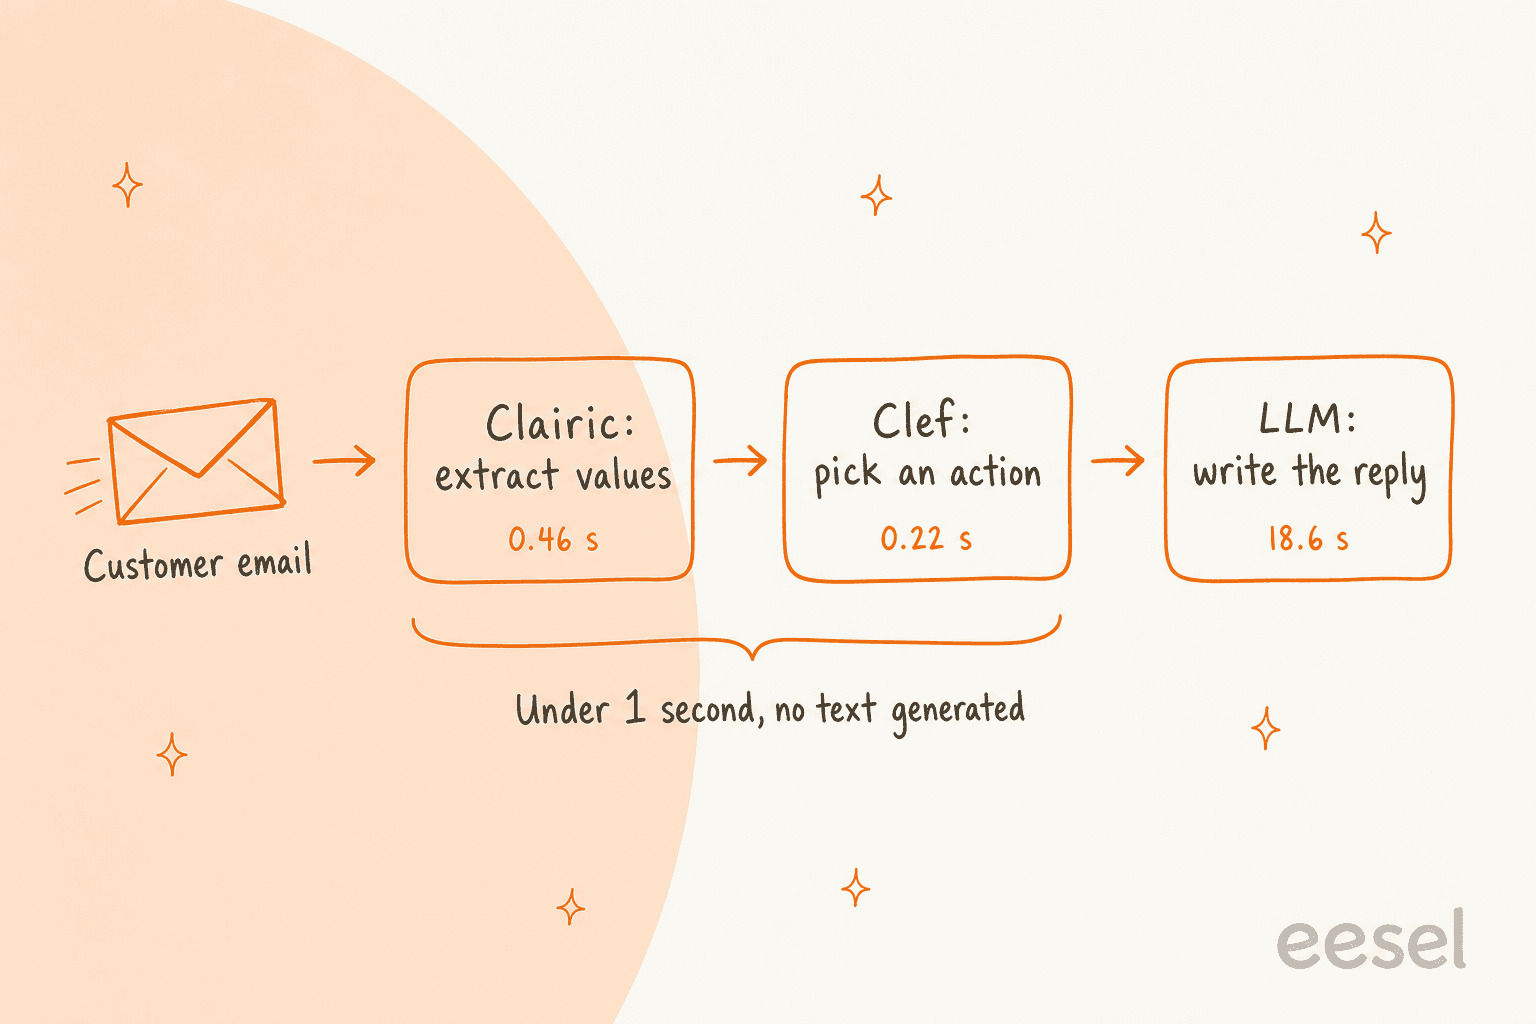
| Clairic, luego Clef, luego GLM-5.3 | GLM-5.3 en cada paso | |
|---|---|---|
| Latencia total | 19,3 s | 61,7 s |
| 1. Extraer | Clairic: 0,46 s | GLM-5.3: 16,1 s |
| 2. Decidir | Clef: 0,22 s | GLM-5.3: 21,9 s |
| 3. Responder | GLM-5.3: 18,6 s | GLM-5.3: 16,4 s |
| Coste por millón de reclamaciones | 6.032 $ | 11.740 $ |
Eso es 3,2 veces más rápido y un 49 % más barato, y casi todo el tiempo y coste restantes corresponden al único paso que escribe texto. Ambas cadenas acertaron los hechos y la decisión en todas las ejecuciones, así que no es una historia de «el LLM falló». La diferencia que señala Cloudflare es la consistencia: la estimación de reparación de Clairic fue idéntica en cada ejecución, mientras que la de GLM-5.3 salió como 250 $, 250 $ y 220 $. Cloudflare también señala que cuando Gemma 4 y Qwen ejecutaron la versión solo con LLM, no pudieron producir el coste de reparación.
También hay un ángulo de seguridad escondido en ese diseño. Clef decide a partir de un resumen de cinco líneas de valores tipados en lugar del correo en bruto, y el LLM nunca ve el correo. Un mensaje de cliente que intente convencer al modelo de dar un reembolso lo tiene mucho más difícil a través de campos tipados, lo que importa a cualquiera que piense en la automatización de reembolsos con IA.
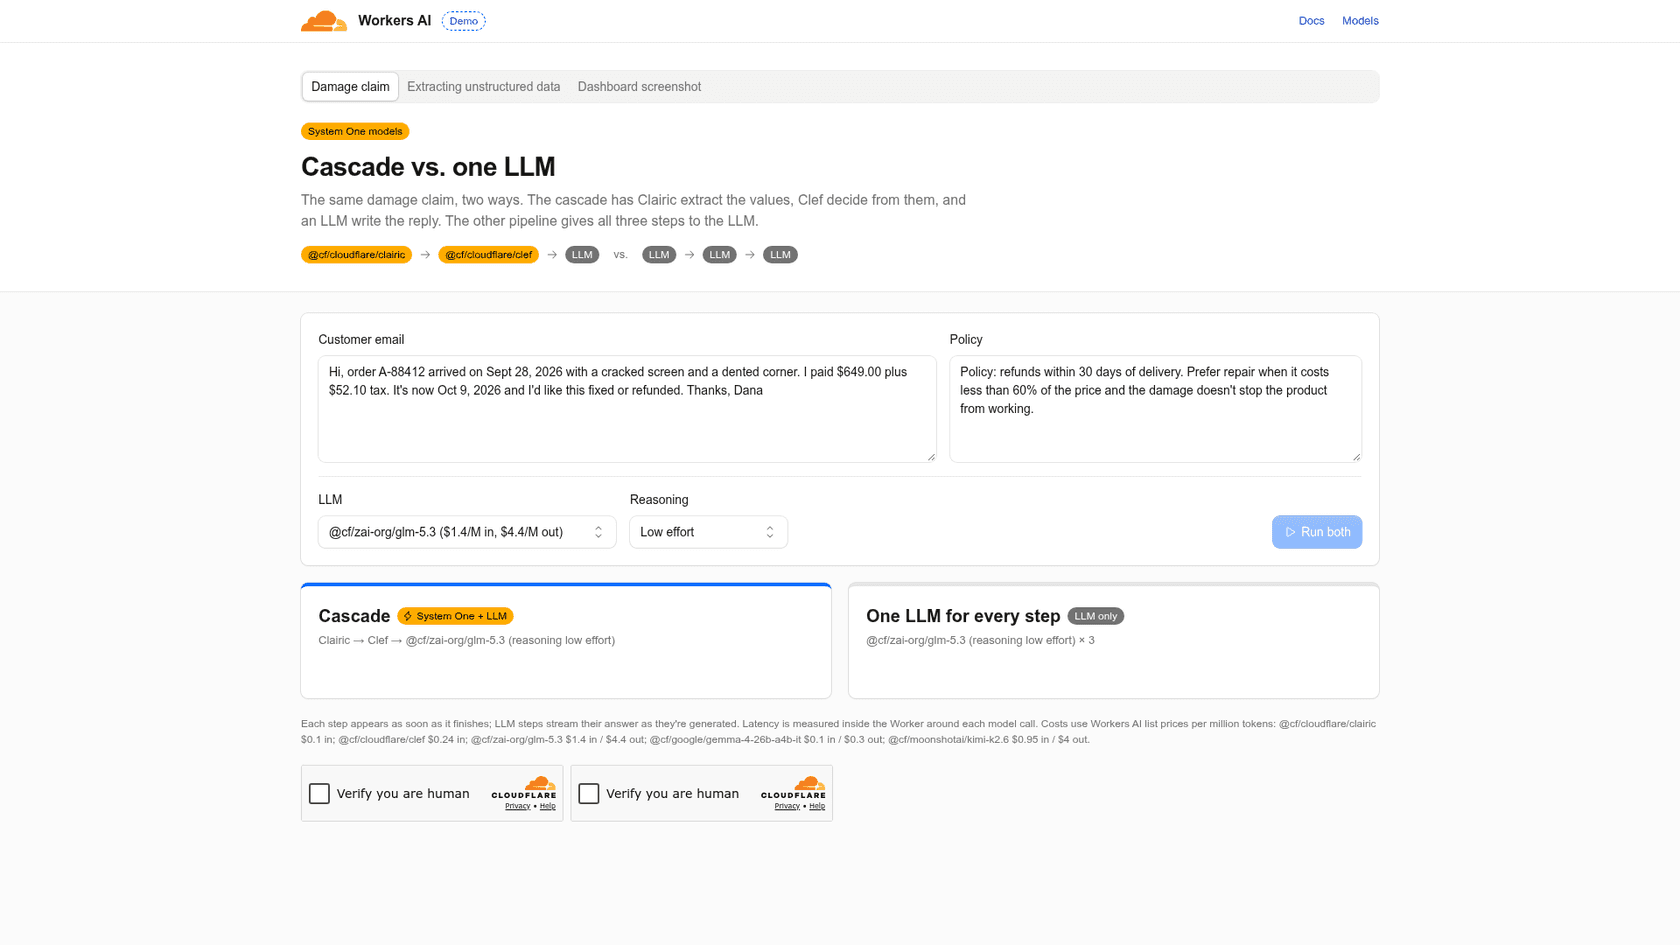
Puedes hacer la comparación tú mismo en la demo en vivo de la cadena de Cloudflare, con tu propio correo y texto de política.
¿Cuánto cuesta Cloudflare Clairic?
Clairic se factura como cualquier otro modelo de Workers AI, en neurons, y la página de precios de Workers AI lo lista junto a sus hermanos. Como no genera tokens, solo hay precio de entrada.
| Modelo | Precio por M de tokens de entrada | Neurons por M de tokens de entrada | Precio de salida |
|---|---|---|---|
Clairic (@cf/cloudflare/clairic) | 0,100 $ | 9.091 | Ninguno |
Clef (@cf/cloudflare/clef) | 0,240 $ | 21.818 | Ninguno |
Clef-omni (@cf/cloudflare/clef-omni) | 0,150 $ | 13.636 | Ninguno |
Clef-flash (@cf/cloudflare/clef-flash) | 0,038 $ | 3.455 | Ninguno |
Workers AI en sí cuesta 0,011 $ por 1.000 neurons, y cada cuenta recibe 10.000 neurons gratis al día, que se reinician a las 00:00 UTC. Pasarse de la asignación gratuita requiere el plan Workers Paid.
Para concretar, el ejemplo de factura de la página del modelo usó 655 tokens de entrada (61 del texto de la factura, 472 del esquema de seis campos y el resto de sobrecarga) en tres pasadas. A 0,10 $ por millón, son unos 0,000066 $ por llamada, o unos 6,55 $ por 100.000 facturas. Los 10.000 neurons gratis equivalen a unos 1,1 millones de tokens de entrada de Clairic al día, así que con ese ejemplo unas 1.680 llamadas al día no cuestan nada. Fíjate en que el esquema era más grande que el documento. Las instructions largas en cada campo son lo que hace crecer tu factura de tokens, así que mantenlas cortas.
Para comparar con el LLM que quizá uses hoy, la guía de precios de Clef tiene una calculadora para el lado de la decisión, y el desglose del coste del soporte con IA cubre lo que cuesta toda la pila por ticket.
¿Cuáles son los límites de Clairic ahora mismo?
Esto es una vista previa, y Cloudflare es inusualmente directo sobre lo que todavía no funciona. Según la publicación de lanzamiento y el changelog:
- La aritmética se detiene en dos pasos. Los totales, diferencias, conversiones y cálculos de fechas son fiables. Las cadenas largas de pasos dependientes y las sumas de muchas filas de una tabla, no. El consejo de Cloudflare: que Clairic extraiga las entradas y que tu código haga las cuentas.
- Las estimaciones necesitan evidencia. Si pides un valor sobre el que la entrada no da pistas, obtendrás un intervalo ancho.
- La calibración se mide, no se garantiza. Los intervalos se entrenan para estar calibrados y lo están en la mayoría de los conjuntos reservados, pero pueden quedarse estrechos con datos desconocidos.
- La previsión es básica. Las previsiones del siguiente paso siguen los patrones recientes, los horizontes largos tienden a la media y los festivos que la serie no muestra se pasarán por alto.
- Bien formado no es correcto. Los tipos garantizan la forma. Usa
confidence,p_nully los intervalos para decidir qué automatizar y qué enviar a revisión.
También hay límites prácticos. Las imágenes tienen un máximo de cuatro por solicitud, 4 MiB cada una y 8 MiB en total, y no se aceptan URL remotas, así que envías los bytes en línea. Clairic figura bajo Text Generation, y la página de límites de Workers AI fija el valor por defecto para ese tipo de tarea en 300 solicitudes por minuto.
El vacío que la gente notó el día del lanzamiento son los benchmarks. Cloudflare publicó ejemplos prácticos y la comparación de cadenas, pero todavía no hay puntuaciones en benchmarks estándar de extracción:
"It's interesting that they haven't published any benchmarks yet."

Otros en el mismo hilo estaban más interesados en hasta dónde podría llegar:
"Seems like it might excel at NER and intent-slot tasks, too."
Esa es también mi lectura. Hasta que Cloudflare publique cifras, la forma honesta de juzgar Clairic es ejecutarlo con unos cientos de tus propios tickets y comparar los campos con lo que tu equipo introdujo de verdad.
¿Dónde encaja Clairic en una cola de soporte?
Del lado de soporte, aquí es donde creo que el modelo se gana el sueldo. Gran parte de lo que hace un agente en el primer minuto de un ticket es extracción: encontrar el número de pedido, comprobar la fecha de entrega, averiguar si está dentro del plazo de devolución, anotar qué está dañado. En una llamada de demo a principios de este año, un equipo B2B de telemática en Zendesk dijo a mis compañeros de ventas que lo primero que querían era etiquetar a partir de una lista fija de etiquetas y autocompletar campos del ticket. Clairic es una forma limpia de construir lo segundo tú mismo.
Así repartiría yo los trabajos habituales de soporte entre las tres clases de modelo. Elige un trabajo para ver cuál encaja:
¿Qué clase de modelo se encarga de este trabajo de soporte?
Extracción (Clairic), decisión (Clef) o generación (un LLM)
Toca un trabajo de arriba.
text. Devuelve el fragmento exacto con desplazamientos de caracteres, o null con una puntuación p_null si el cliente no incluyó ninguno, para que puedas preguntar en lugar de adivinar.duration. Un valor calculado a partir de dos fechas. Añade la fecha de hoy al state o fija reference_date, o el cálculo no tendrá dónde anclarse.estimate. Devuelve una mediana y un rango del 80 % dentro de los límites que fijes. Un rango ancho es tu señal de que la entrada todavía no respalda un número.forecast, con cuidado. Sirve para una cifra aproximada del siguiente paso. Cloudflare dice que pasa por alto eventos que el historial no muestra, como los festivos, así que no dimensiones una semana punta con esto.Lo que Clairic te da y una llamada a un LLM con modo JSON o llamada a funciones no te da es una forma integrada de decidir en qué confiar. Cada respuesta lleva una confianza y una probabilidad de estar ausente, lo que se traduce con claridad en tres carriles:
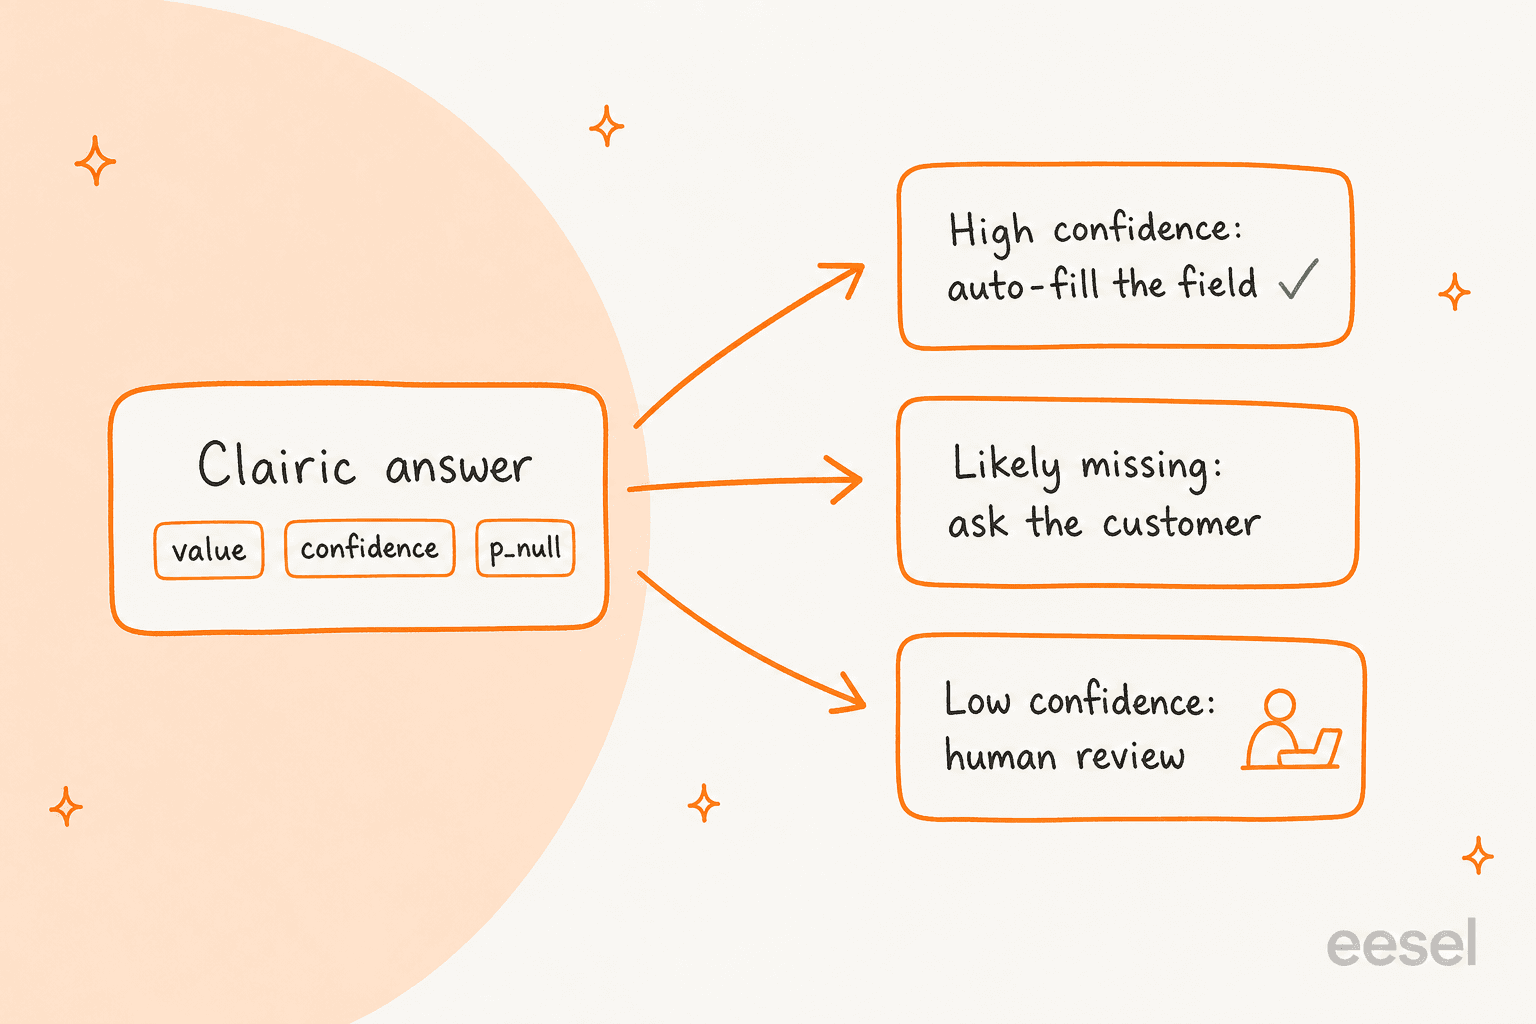
Es la misma lógica que ya usan la mayoría de los helpdesks para la clasificación de tickets, y encaja detrás de herramientas que quizá ya uses. La propia extracción de entidades de Zendesk hace una versión de esto dentro del helpdesk, y la versión de IA avanzada añade entidades personalizadas. Clairic es la opción de construirlo tú mismo: más control sobre el esquema y los umbrales, y más código del que hacerte cargo.
Lo que Clairic no hace es el trabajo. No abrirá Shopify para comprobar el pedido, no aplicará tu matriz de aprobación de reembolsos, no escribirá de vuelta en el ticket ni sabrá cuándo un artículo dañado necesita a una persona. Alguien tiene que escribir el Worker que haga todo eso, gestionar la escalada y mantenerlo funcionando cuando cambie la API del helpdesk. Para un equipo con ingenieros que quieren un analizador rápido y barato dentro de su propia cadena de triaje de tickets, es un intercambio justo. Para un equipo de soporte que quiere la cola resuelta esta semana, es un componente, no una respuesta.
¿Quién debería usar Cloudflare Clairic?
Recurriría a Clairic en tres situaciones:
- Ya trabajas en Workers. Llamarlo es una línea
env.AI.run()junto a tu código existente, y los neurons diarios gratuitos cubren mucha extracción de bajo volumen. - Analizas una y otra vez las mismas formas. Facturas, recibos, correos de pedido, avisos de envío. Campos fijos, alto volumen, y una respuesta tipada gana a revalidar el JSON de un LLM en cada llamada.
- Necesitas saber cuándo el modelo no está seguro. Las puntuaciones
confidenceyp_nullte dan gratis una señal de enrutamiento, que es la mayor parte del trabajo de una automatización segura.
Esperaría si necesitas ejecutarlo en tu propio hardware (todavía sin pesos), si necesitas cifras de precisión auditadas antes de una revisión de lanzamiento (todavía sin benchmarks) o si el trabajo es sobre todo matemática de varios pasos con tablas grandes (Cloudflare mismo dice que eso se haga en código). Y si lo que de verdad quieres es menos tickets en la cola en lugar de campos más limpios, un agente de IA para helpdesk ya hecho te lleva ahí sin construir nada.
eesel para el ticket posterior a la extracción
Clairic es infraestructura. eesel es el empleado. eesel es una plataforma de compañeros de IA, y el compañero que importa aquí es el compañero de IA para el helpdesk. Se une a tu cola de Zendesk, Freshdesk, Gorgias o Front, aprende de tus tickets anteriores y tu centro de ayuda, y hace la lectura que hace Clairic como parte de trabajar el ticket: encontrar el pedido, comprobar las fechas, detectar qué está dañado. Luego actúa. Etiqueta, redacta, responde o traspasa, y todo lo que marques como «preguntar primero» espera a que una persona lo apruebe.
Rúngne, una marca noruega de ropa de escalada en Gorgias y Shopify, ejecuta tres agentes de eesel: uno confirma y etiqueta cada ticket, otro busca el pedido, el seguimiento y el stock en Shopify y deja un borrador, y otro responde directamente las preguntas sencillas. Entre el 8 de agosto y el 8 de septiembre de 2026 eso supuso unos 2.100 tickets gestionados, 580 borradores dejados para el equipo y 150 consultas de pedidos. Los artículos dañados, los paquetes perdidos y las cancelaciones van directamente a personas, que es la misma línea que yo trazaría en cualquier automatización basada en extracción. Dokument 24 hace la versión más ligera en Zendesk: cada primer mensaje recibe una etiqueta de producto y un borrador en danés como nota interna.

Si Clairic te atrae porque es programable, echa un vistazo a la CLI de eesel. Es el mismo compañero que el panel, manejado desde una terminal, y cada comando imprime JSON, así que un script o un agente de programación como Claude Code, Cursor o Codex puede ejecutar toda la configuración. Para un flujo al estilo extracción, se ve así:
npx @eesel/cli initinicia un workspace sin necesidad de cuenta (Node 18.17 o superior), yeesel loginlo conserva.eesel integrations connect <platform>conecta Zendesk, Freshdesk o Gorgias, yeesel integrations <platform> actionslista todas las acciones que el compañero puede realizar allí con su ajuste de aprobación.eesel instructionscontiene las reglas permanentes en lenguaje llano, como «rellena el campo del número de pedido; si no hay, pídelo».eesel approvals listyeesel approvals approve <id>despejan acciones retenidas desde un script, y--dry-runimprime la llamada exacta que haría una escritura antes de que ocurra.eesel activitymuestra lo que hizo el compañero, lo más reciente primero, que es tu registro de auditoría.
El workspace también es un servidor MCP (eesel mcp token imprime la línea de claude mcp add), y el artículo de mi compañero sobre la CLI de agentes de IA profundiza en cómo llevar el soporte desde una terminal.
La unidad de precio es distinta porque compra algo distinto. Los precios de eesel empiezan con 100 créditos gratis, y luego planes mensuales fijos desde 299 $ por 500 créditos, donde un crédito cubre un ticket o chat completo sin importar cuántas consultas y acciones requiera. Si quieres construir tú mismo la capa de extracción, Clairic es un componente rápido, barato y honesto. Si quieres que los correos de pedidos se lean, se consulten y se respondan en tu helpdesk esta semana, prueba eesel en tu propia cola y lee los borradores antes de pagar nada.
Preguntas frecuentes
¿Qué es Cloudflare Clairic?
Cloudflare Clairic es un modelo de extracción que Cloudflare lanzó en vista previa en Workers AI el 19 de octubre de 2026, como @cf/cloudflare/clairic. Le envías texto (más hasta cuatro imágenes) y una lista de campos tipados, y devuelve un valor tipado por campo con una puntuación de confianza. Está junto a los modelos de decisión como Clef en lo que Cloudflare llama modelos System One.
¿En qué se diferencia Cloudflare Clairic de Clef?
Clef elige entre las opciones que le das y devuelve una probabilidad para cada una, así que responde «¿qué equipo?» o «¿reembolso o reparación?». Clairic responde con valores que no se pueden enumerar de antemano, como un número de pedido, una fecha, un total o un coste de reparación estimado. La propia demo de Cloudflare los encadena: Clairic extrae, Cloudflare Clef decide y un LLM redacta la respuesta.
¿Cuánto cuesta Cloudflare Clairic?
Clairic cuesta 0,10 $ por millón de tokens de entrada, sin cargo por tokens de salida, porque no genera tokens. Se factura en neurons de Workers AI (9.091 por millón de tokens de entrada) y cada cuenta recibe 10.000 neurons gratis al día. Para ver el panorama completo de Workers AI, consulta la guía de precios de Clef.
¿Cloudflare Clairic es de código abierto?
Todavía no. En el lanzamiento, Clairic es una vista previa alojada solo en Workers AI, y Cloudflare dice que tiene previsto publicar el modelo con pesos abiertos pronto. Si necesitas algo que puedas alojar tú mismo hoy, los modelos de lenguaje pequeños en Hugging Face son el camino habitual.
¿Puede alucinar Cloudflare Clairic?
Puede equivocarse, pero no puede inventar una respuesta mal formada. Cada valor vuelve en el tipo que pediste o como null, y las respuestas de texto son fragmentos de tu entrada con desplazamientos de caracteres. La documentación de Cloudflare deja claro que bien formado no es lo mismo que correcto, así que usa las puntuaciones confidence y p_null como usarías umbrales de confianza en otros sitios.
¿Puedo usar Cloudflare Clairic para tickets de soporte?
Sí, los ejemplos del lanzamiento de Cloudflare son un correo de pedido dañado y un ticket de caída del checkout. Clairic extrae el ID del pedido, las fechas, los importes y la lista de daños del mensaje para que tu código o un modelo como Clef puedan actuar. No responde ni toca tu helpdesk, y ahí entra un agente de IA para helpdesk como eesel.
¿Cómo llamo a Cloudflare Clairic?
Desde un Worker, llama a env.AI.run("@cf/cloudflare/clairic", { model: "clairic", state, fields }). Desde cualquier otro sitio, envía el mismo cuerpo por POST a /accounts/{account_id}/ai/run/@cf/cloudflare/clairic con un token de API. Si lo integras en una pila de soporte, el artículo de mi compañero sobre la API de helpdesk con IA cubre la fontanería alrededor.
¿Cloudflare Clairic es bueno para hacer previsiones?
Para una cifra rápida del siguiente paso, sí: en la prueba TSA de 21 días de Cloudflare, sus previsiones se desviaron un 3,3 % de media. Aun así, Cloudflare califica la previsión como básica y dice que no sustituye a un modelo de series temporales entrenado con tus datos. Para dimensionar un equipo de soporte, una buena previsión de plantilla sigue siendo la mejor herramienta.