

TorchNeuron es el backend de PyTorch de código abierto de AWS para sus chips Trainium, en beta pública desde el 20 de octubre de 2026. Registra Trainium como un dispositivo normal de PyTorch llamado neuron, así que para la mayoría del código la migración consiste de verdad en convertir .to('cuda') en .to('neuron'). La biblioteca es gratuita bajo Apache 2.0 y lo que pagas es el tiempo de Trainium: 2,235 $ por hora de chip Trainium2 en EC2 Capacity Blocks, frente a 5,970 $ de una H100.
El titular oculta la trampa. El modo eager es el camino fácil y depurable, pero la velocidad de producción viene de torch.compile, que en Neuron necesita formas estáticas y falla con cualquier operador que no pueda traducir. Además, solo funciona en Trainium2 y Trainium3, así que quienes usan Trainium1 e Inferentia se quedan con el stack antiguo.
Si entrenas o sirves tus propios modelos en AWS, esta es la semana para hacer un piloto. Si solo quieres una IA que haga un trabajo, como responder tickets, olvida la cuestión del chip: un compañero de IA de eesel se ocupa de la capa de modelos, y SE Ranking ejecuta uno en tres productos con unas 4.650 conversaciones al mes.
¿Qué es TorchNeuron?
TorchNeuron es un backend nativo de PyTorch para AWS Trainium, la familia de chips de IA propios que Amazon desarrolla desde que compró Annapurna Labs en 2015. Se anunció en el blog de PyTorch el 19 de octubre de 2026 y salió como beta pública de código abierto en la PyTorch Conference North America el 20 de octubre. El código está en aws-neuron/torch-neuronx con licencia Apache 2.0.
Yo construyo integraciones y APIs para eesel, y "funciona con un cambio de una línea" es la afirmación en la que menos confío, sobre todo porque la he escrito yo mismo en nuestras propias páginas. Así que leí la documentación, el repositorio y el material del lanzamiento antes de creérmelo. La versión corta: la afirmación se cumple en modo eager, y el trabajo de ingeniería real se traslada al paso de compilación.
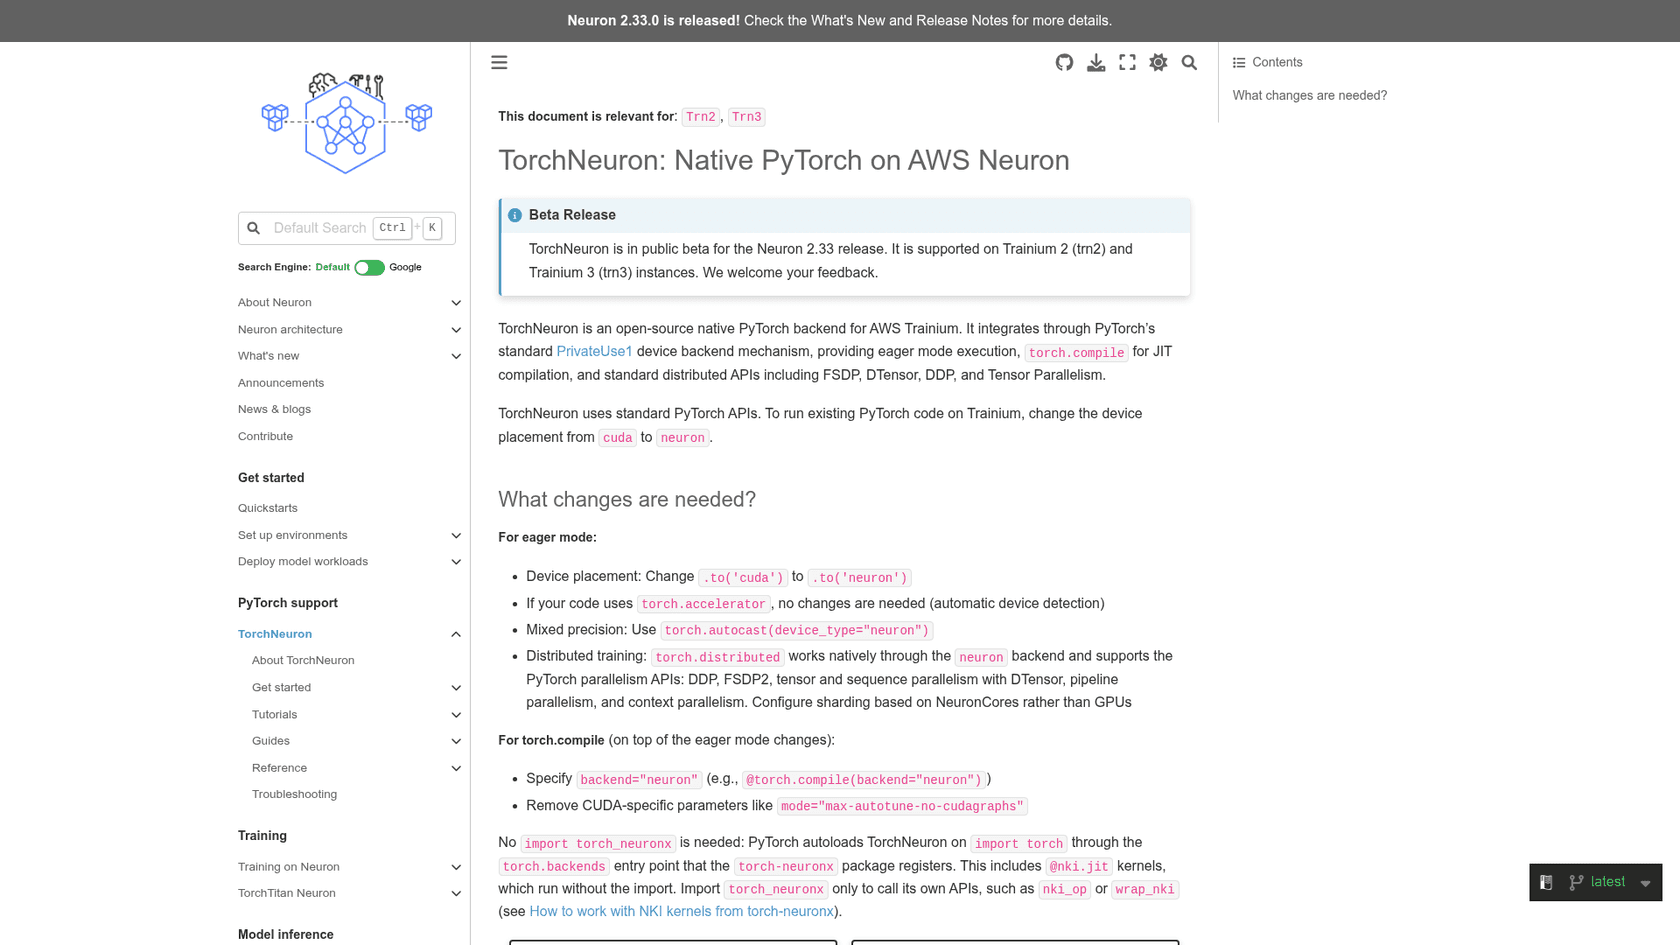
La documentación oficial lo dice claro: TorchNeuron está en beta pública para la versión Neuron 2.33 y funciona en instancias Trainium2 (trn2) y Trainium3 (trn3). El planteamiento de la propia Amazon en About Amazon es que el 85 % de los investigadores y desarrolladores de IA escribe su código en PyTorch, y que hasta ahora llevar ese código a chips nuevos significaba meses de reescritura y revalidación.
Andy Jassy, CEO de Amazon, expuso el argumento de negocio en X ese mismo día:
"Trying a new AI chip used to be a lot of work. You often had to rewrite your code, revalidate it, and sink many weeks in, betting this new chip is the right one for your workload."
Qué hay de nuevo en realidad
Trainium lleva años ejecutando PyTorch, así que es razonable preguntar qué cambió. La respuesta es la fontanería de debajo. Hasta PyTorch 2.9, Neuron ejecutaba PyTorch a través de PyTorch/XLA, que usaba tensores perezosos: no se ejecutaba nada hasta que se trazaba y compilaba un grafo, así que los prints, los breakpoints y el control de flujo de Python se comportaban de forma rara. AWS anunció que PyTorch 2.9 sería la última versión basada en XLA, y que la 2.10 y posteriores pasarían a soporte nativo.
TorchNeuron se engancha a PrivateUse1, el punto de extensión oficial de PyTorch para hardware propio. Para PyTorch, Trainium pasa a ser un dispositivo más junto a CPU y CUDA. Por eso la publicación del lanzamiento puede afirmar que torch.nn, torch.autocast, torch.distributed y torch.profiler funcionan en el dispositivo neuron tal como están escritos.
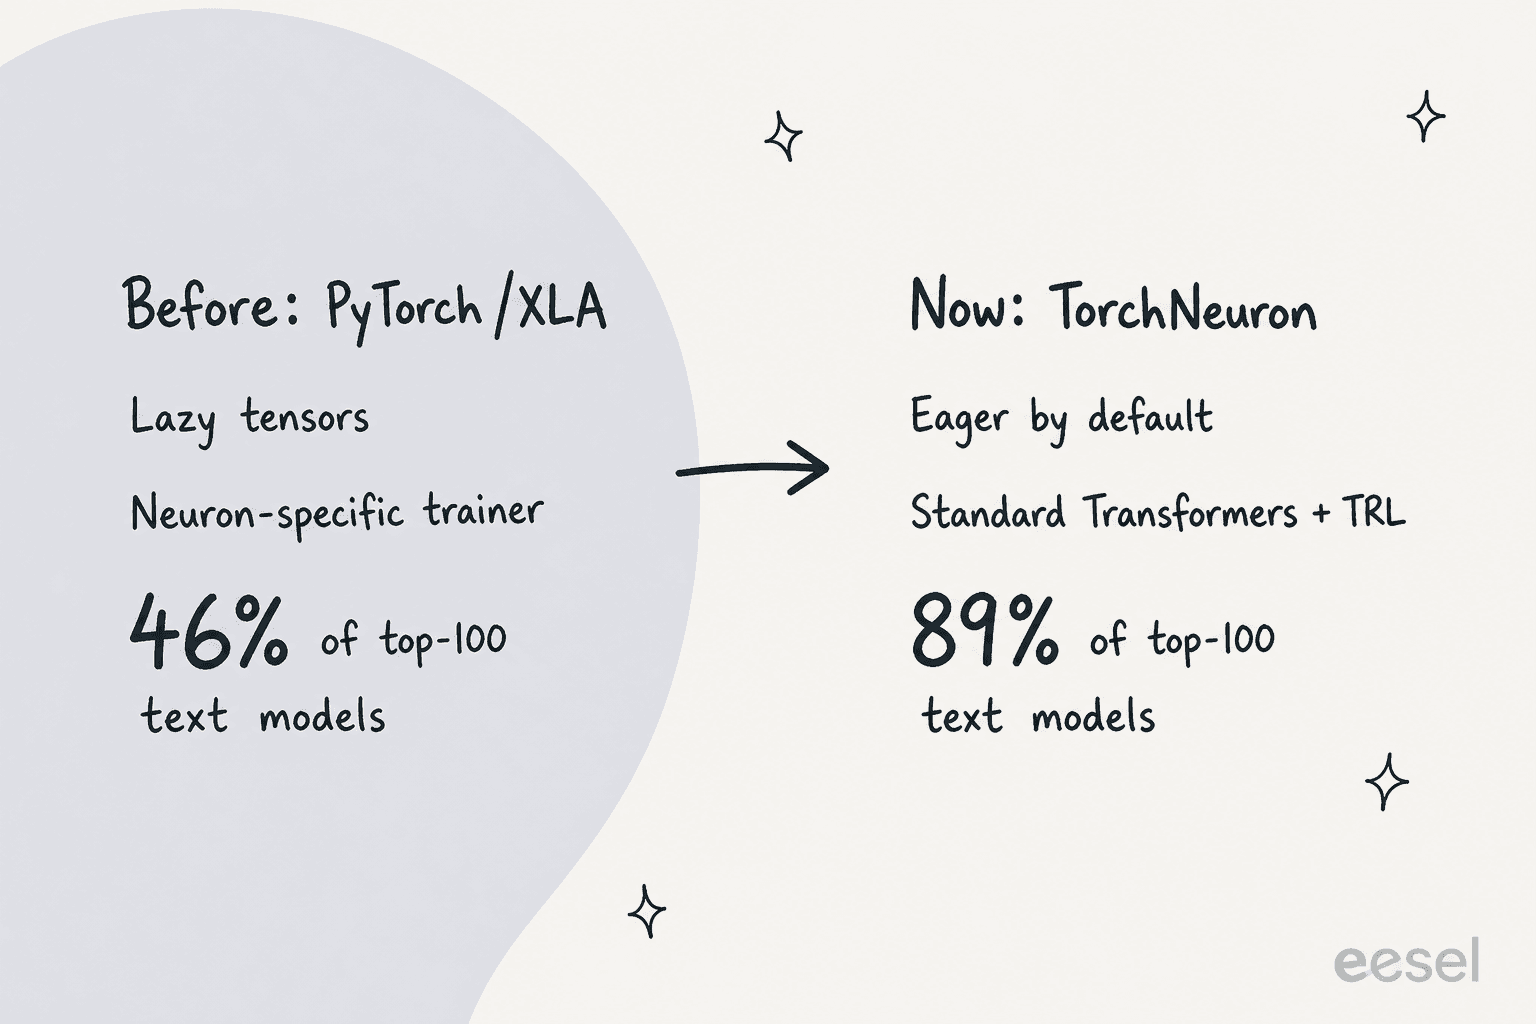
La medida más clara del cambio viene de Hugging Face. En su publicación del lanzamiento, Hugging Face dice que el 89 % de las 100 arquitecturas principales de generación de texto ya funcionan sin cambios, frente al 46 % con su antigua biblioteca Optimum Neuron v0.4.5. Ahora recomienda usar Transformers, Diffusers, Accelerate, PEFT y TRL directamente en Trainium en lugar de pasar por Optimum Neuron.
Aquí está el antes y el después en una tabla:
| PyTorch/XLA (torch-neuronx antes de 2.14) | TorchNeuron (torch-neuronx 2.14+) | |
|---|---|---|
| Ejecución | Tensores perezosos, grafos trazados | Eager por defecto, torch.compile opcional |
| Depuración | A nivel de grafo, prints retrasados | Los prints y breakpoints de Python funcionan |
| Ruta de Hugging Face | Wrapper Optimum Neuron | Transformers, TRL, Diffusers directamente |
| Distribuido | APIs específicas de Neuron | DDP, FSDP2, DTensor, TP, PP |
| Chips | Trn1, Trn2, Inferentia | Solo Trn2 y Trn3 |
| Versiones de PyTorch | Hasta la 2.9 | 2.14 en la versión actual |
Esa última fila importa más de lo que sugiere la cobertura del lanzamiento, y vuelvo a ella en la sección de límites.
Cómo funciona TorchNeuron
Por debajo, TorchNeuron tiene dos backends: uno registrado en el dispatcher de PyTorch para el modo eager y otro registrado en TorchDynamo para torch.compile. Ambos pasan el trabajo al compilador de Neuron, que produce archivos NEFF (Neuron Executable File Format) que el runtime de Neuron ejecuta en el chip.
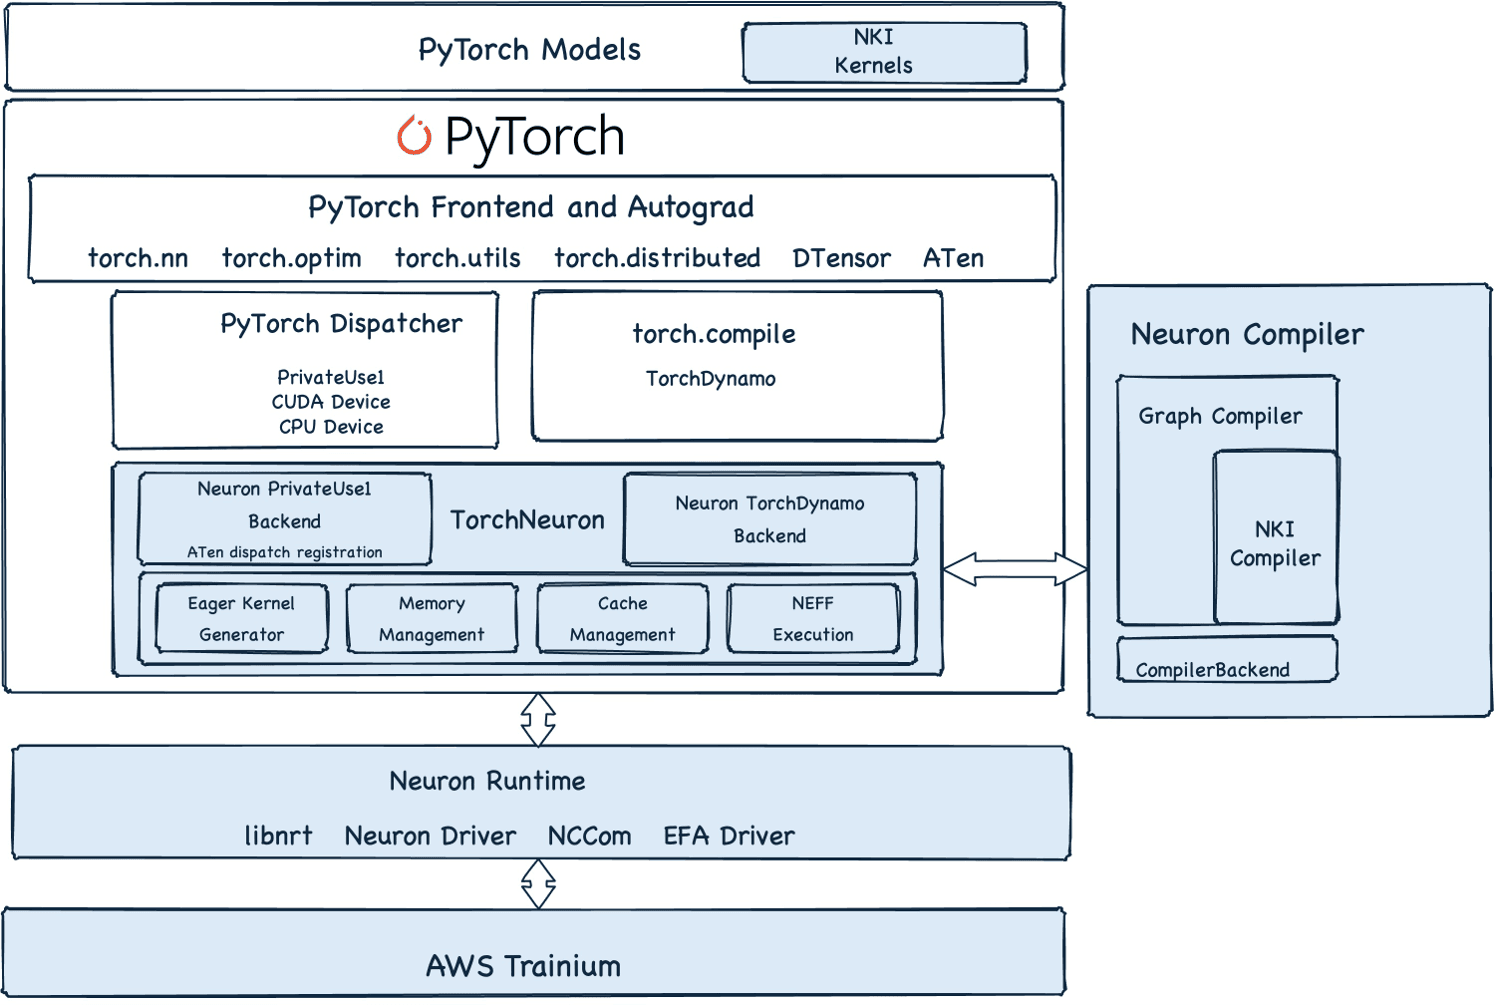
La página About TorchNeuron explica los dos caminos en detalle. Se comportan de forma tan distinta que los trataría como dos productos.
El modo eager ejecuta cada operación en cuanto la llamas. La primera vez que se ejecuta un operador, se compila a su propio NEFF y queda en una caché en disco; después se sirve desde la caché. Si un operador no tiene implementación en Neuron, vuelve a la CPU con una advertencia, así que el modelo se ejecuta igualmente. También hay un modo eager adaptativo experimental (activa TORCH_NEURONX_ENABLE_CONCATENATION=1) que fusiona operaciones aptas para reducir la sobrecarga de lanzamiento.
torch.compile captura el modelo en un grafo mediante TorchDynamo y AOTAutograd, lo baja a StableHLO a través de Torch-MLIR y compila el grafo completo en un único NEFF. Es el camino de producción. El precio es la rigidez: según el README de GitHub, dynamic debe ser False, mode solo acepta "default", los tensores deben ser contiguos y cada nueva forma de entrada provoca una compilación nueva. Un operador capturado que el backend no pueda traducir hace que la compilación falle por defecto.
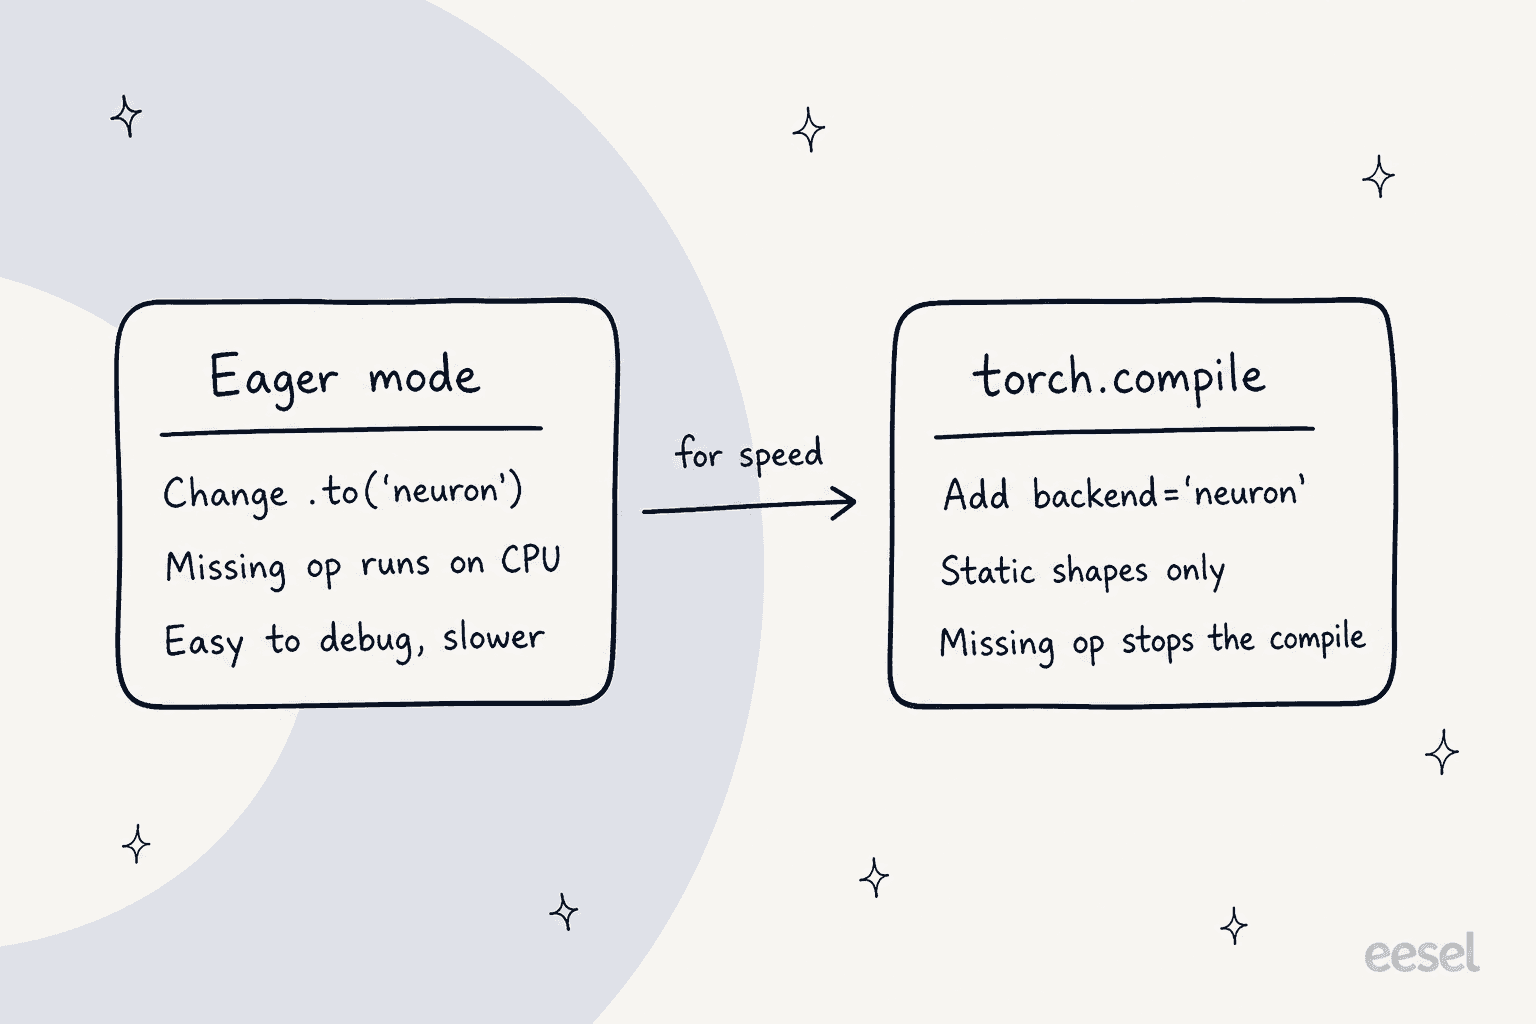
Así que la lectura honesta de "un cambio de configuración" es: un cambio para empezar y una segunda ronda de trabajo para ir rápido. En la práctica, esa segunda ronda consiste sobre todo en rellenar o agrupar las entradas en unas pocas formas fijas y apuntar TORCH_NEURONX_NEFF_CACHE_DIR a almacenamiento compartido (la documentación sugiere Amazon FSx) para que una flota no recompile los mismos grafos en cada instancia.
Por encima de ambos modos está NKI, la Neuron Kernel Interface, para escribir kernels personalizados cuando el compilador no basta. Registras un kernel NKI como operador normal de PyTorch con nki_op, y funciona en modo eager y dentro de un grafo compilado. AWS también liberó NKI-lib, un conjunto de kernels optimizados que incluye FlashAttention y kernels blockwise para MoE.
Cómo es el cambio de código
Para un bucle de entrenamiento, la publicación del lanzamiento muestra todo el diff como una sola línea:
model = MyModel().to('neuron')   # the only change
optimizer = torch.optim.AdamW(model.parameters())
for batch in dataloader:
    optimizer.zero_grad()
    loss = criterion(model(batch), targets)
    loss.backward()
    optimizer.step()
Para la versión compilada, indicas el backend una vez con torch.compiler.set_default_backend("neuron"), o en cada llamada con torch.compile(model, backend="neuron"). El código escrito contra torch.accelerator, la API de PyTorch independiente del dispositivo, no necesita ningún cambio. Ni siquiera hace falta import torch_neuronx: el paquete se registra solo a través del entry point torch.backends y se carga con import torch.
La lista completa de ediciones de la documentación es corta:
- Cambia
.to('cuda')por.to('neuron'), o apóyate entorch.accelerator. - Usa
torch.autocast(device_type="neuron")para precisión mixta. - En trabajos distribuidos, configura el sharding por NeuronCores en lugar de por GPU.
- Para
torch.compile, añadebackend="neuron"y elimina ajustes exclusivos de CUDA comomode="max-autotune-no-cudagraphs".
Para modelos de Hugging Face es aún más corto. Cargar un modelo con device_map="neuron" coloca los pesos en Trainium, y device_map="auto" encuentra el dispositivo por sí solo. El ejemplo de Hugging Face hace fine-tuning con un script estándar de TRL SFTTrainer en 8 chips Trainium2 (media trn2.48xlarge), con un único ajuste específico de Neuron: HF_DEACTIVATE_ASYNC_LOAD=1, porque la carga asíncrona de pesos aún no es compatible. El checkpoint que guarda es un checkpoint normal de Transformers que puedes cargar en cualquier hardware.
Este es el tipo de migración mecánica en el que los agentes de programación son buenos. Si estás moviendo un repositorio, una herramienta como Claude Code o OpenAI Codex puede encontrar las llamadas específicas de CUDA y sustituirlas, siempre que revises tú mismo los logs de compilación.
¿Cuánto cuesta TorchNeuron?
La biblioteca es gratuita. TorchNeuron usa Apache 2.0, se instala con pip install torch-neuronx desde el repositorio pip de Neuron y viene preinstalado en la Neuron Deep Learning AMI y en los Deep Learning Containers. El costo es el tiempo de Trainium.
AWS publica los precios de Trainium en su página de precios de Capacity Blocks, donde reservas capacidad de aceleradores para una ventana fija. Estas son las tarifas efectivas por hora listadas el 20 de octubre de 2026, y AWS indica que la próxima actualización de precios prevista es en enero de 2027:
| Instancia | Aceleradores | Por hora de instancia | Por hora de chip | ¿Funciona con TorchNeuron? |
|---|---|---|---|---|
| trn2.48xlarge (US East, Ohio) | 16 x Trainium2 | 35,7608 $ | 2,235 $ | Sí |
| trn2.3xlarge (regiones seleccionadas) | 1 x Trainium2 | 2,235 $ | 2,235 $ | Sí |
| trn1.32xlarge | 16 x Trainium | 9,532 $ | 0,596 $ | No |
| p5.48xlarge | 8 x H100 | 47,757 $ | 5,970 $ | GPU, no Neuron |
| p5e.48xlarge | 8 x H200 | 54,924 $ | 6,866 $ | GPU, no Neuron |
| p5en.48xlarge | 8 x H200 | 63,158 $ | 7,895 $ | GPU, no Neuron |
Linux no tiene cargo adicional de sistema operativo en estos bloques. Los Trn3 UltraServers, que escalan hasta 144 chips Trainium3, no tienen tarifa pública por hora en esa página.
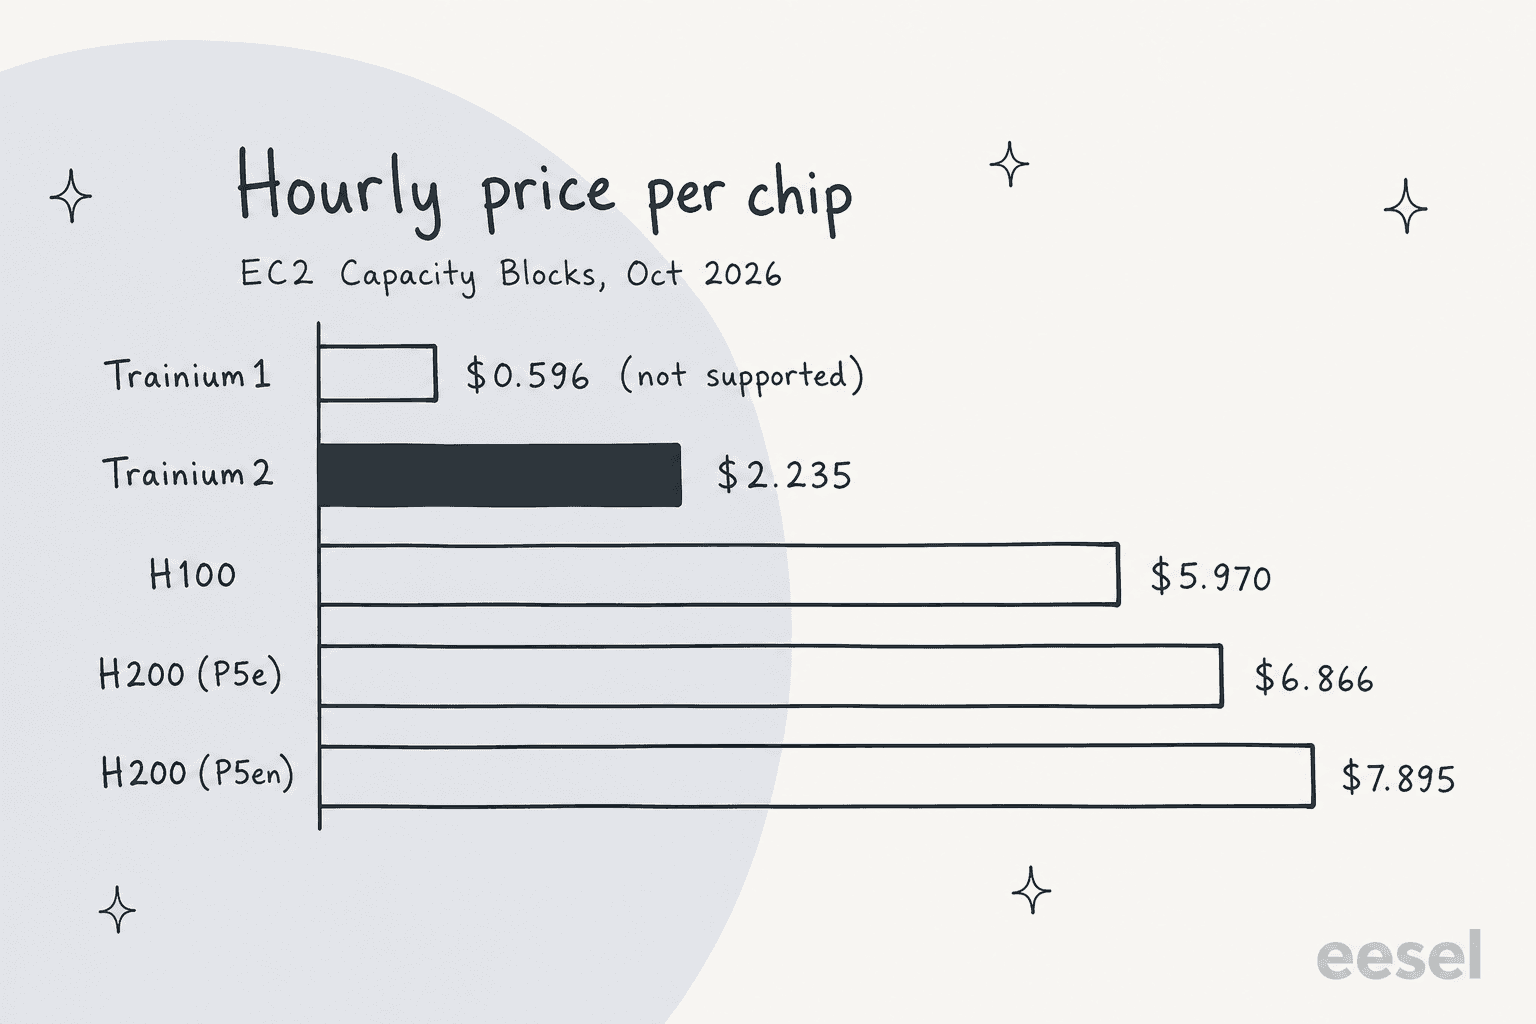
Por chip, una hora de Trainium2 cuesta cerca del 37 % de una hora de H100. Eso no significa que tu trabajo cueste el 37 %, porque un chip Trainium2 y una H100 hacen cantidades distintas de trabajo. La afirmación de AWS en la página de Trn2 es más acotada: las instancias Trn2 ofrecen "30-40% better price performance than GPU-based EC2 P5e and P5en instances." Una trn2.48xlarge lleva 16 chips Trainium2, 1,5 TB de HBM y hasta 20,8 petaflops FP8.
La única cifra de cliente del lanzamiento es de Deepgram, la empresa de reconocimiento de voz:
"In the benchmarks we evaluated, Trainium processes about 60% more input audio seconds per dollar than our existing GPU baselines, which helps us bring better models to customers at lower prices."
Adam Sypniewski, CTO de Deepgram, en el blog de PyTorch
Fíjate en el contexto de esa cifra: Deepgram migró su modelo durante un proyecto de varios meses con el AWS Generative AI Innovation Center. Es un resultado real, pero es una migración con apoyo, no un cambio de fin de semana. Para comparar entre nubes de GPU, mis desgloses de precios de CoreWeave y precios de Lambda cubren el otro lado de la tabla, y la guía de precios de AWS cubre el resto de la factura.
Benchmarks y cobertura de pruebas
AWS no publicó con el lanzamiento una clasificación de velocidad de modelos. Lo que sí publicó son pruebas de cobertura, que me parecen la cifra más útil para una beta. Según la publicación del lanzamiento, AWS ejecuta de forma continua unos 100.000 modelos de Hugging Face, elegidos para cubrir el 99,9 % del uso real por número de descargas, en una configuración reducida sobre Trainium. Cada ejecución comprueba si el modelo carga, si funcionan los pases forward y backward y si compila.
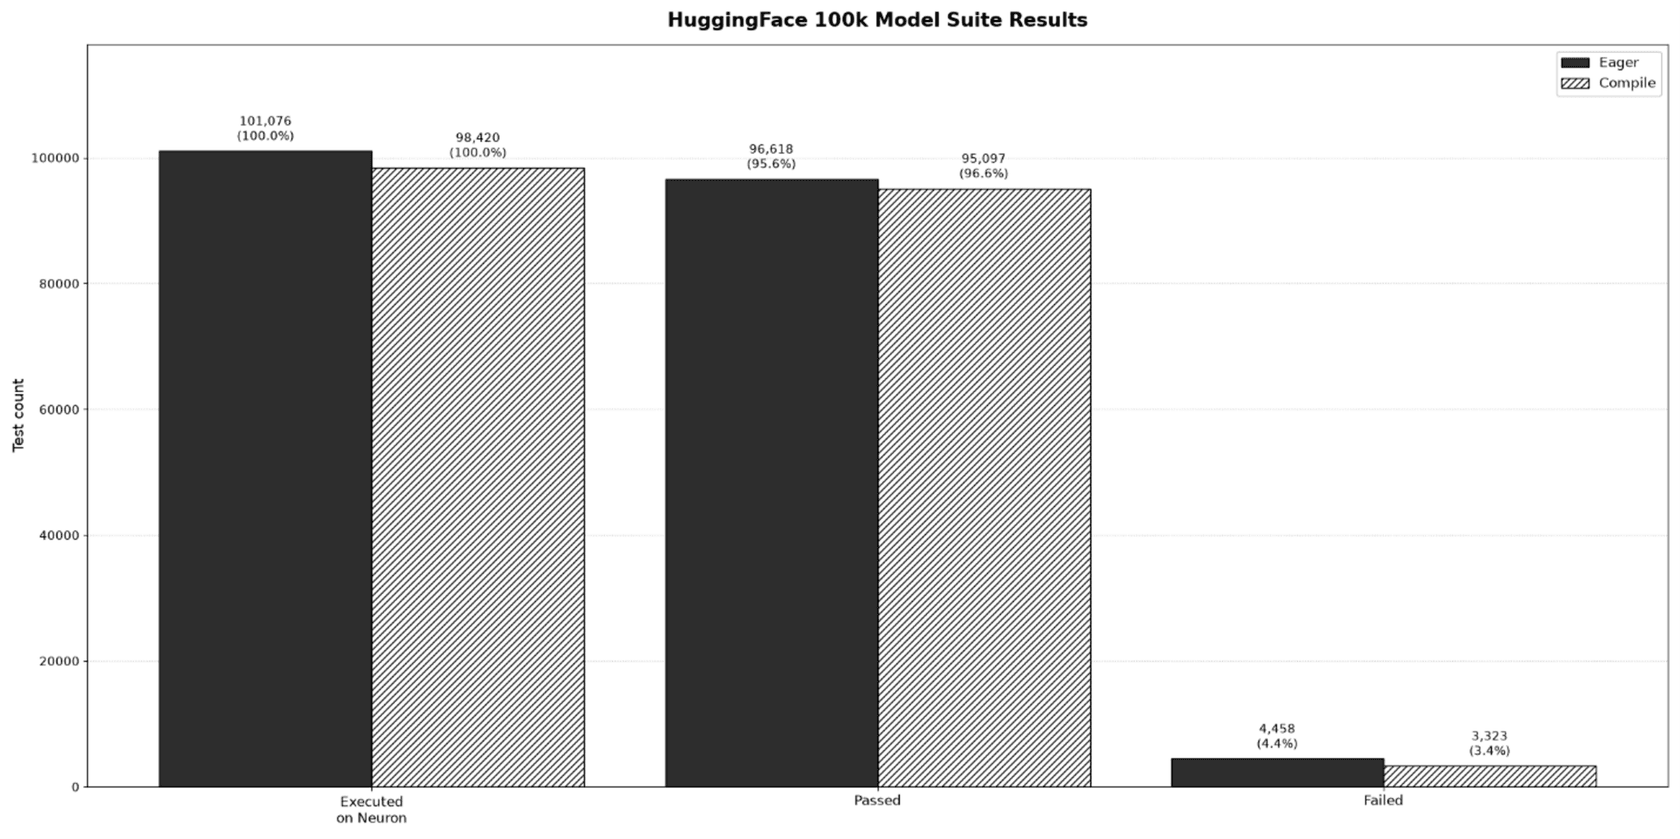
Los resultados de septiembre de 2026: pasa el 95,6 % en modo eager y el 96,6 % con torch.compile, con 4.458 y 3.323 fallos respectivamente. Es una cifra sólida para una beta y es el tipo de prueba correcto. En eesel aprendí la misma lección desde el otro lado: un agente de soporte que luce genial en una demo puede dar respuestas erróneas con total seguridad en tickets reales, por eso simulamos cada despliegue con los tickets históricos de un cliente antes de salir en vivo. Un barrido sobre 100.000 modelos reales es lo equivalente que hace AWS con un compilador.
La suite de pruebas de PyTorch upstream indica dónde están las lagunas. La ejecución de agosto de 2026 produjo unos 154.000 resultados de prueba, de los cuales unos 69.000 se omitieron. Unos 30.000 los omitieron las propias comprobaciones de elegibilidad de PyTorch (pruebas solo para CUDA y solo para CPU). Los otros ~39.000 fueron omisiones deliberadas de Neuron, y el grupo más grande, ~22.000 pruebas, corresponde a operadores que aún no tienen una traducción nativa a Neuron.
En cuanto al hardware, la página de Trn3 afirma que los Trn3 UltraServers ofrecen hasta 4,4 veces el rendimiento y 4 veces el rendimiento por vatio de los Trn2 UltraServers, con hasta 362 petaflops MXFP8 en 144 chips. Son cifras de AWS para el chip, no resultados de TorchNeuron, y todavía no he visto benchmarks independientes de ninguno de los dos.
Lo que TorchNeuron aún no hace
Es una primera versión, y AWS es inusualmente directo sobre lo que dejó fuera. Según la publicación del lanzamiento y el README:
- Chips antiguos. Solo se admiten Trn2 y Trn3. Trainium1, con 0,596 $ por hora de chip el acelerador más barato de la tabla anterior, e Inferentia se quedan en la línea de torch-neuronx basada en XLA (versiones anteriores a 2.14).
- Formas dinámicas.
torch.compilenecesita formas estáticas. Las entradas de longitud variable implican rellenar o agrupar, y cada forma nueva recompila. - Precisión. float64 se ejecuta como float32, lo que puede cambiar resultados que necesitan precisión de 64 bits. El soporte de int64 depende de la operación.
- Funciones omitidas a propósito. Tensores dispersos, NestedTensor, autograd en modo forward, máscaras de atención arbitrarias en la atención multi-head nativa (sin máscara y causal funcionan), cuantización por canal y upsampling bilineal/bicúbico no están en esta versión.
- FP8 y TorchAO. Están en beta privada, con disponibilidad general prevista para la próxima versión. El soporte de FlexAttention es limitado.
- Tiempo de compilación en la primera ejecución. La primera llamada de una operación o de un grafo compilado incluye la compilación, que "can be significant for a large model", según el README.
La reacción de la comunidad es, hasta ahora, de optimismo cauteloso por parte de quienes ya han hecho este tipo de migración. En una respuesta a Jassy, un ingeniero lo resumió así:
"Big if this works flawlessly. I have been on the other end, it's not been pretty."
Otra respuesta bajo la publicación del CEO de AWS, Matt Garman, señaló la prueba a más largo plazo: si AWS sigue integrando sus cambios en el propio PyTorch.
"Open sourcing is the easy half, upstreaming is the harder promise."
AWS ha empezado: la publicación del lanzamiento enumera 26 pull requests a PyTorch y TorchTitan, abiertos para mejorar la calidad de las pruebas y eliminar suposiciones de CUDA escritas a fuego.
Antes de reservar un Capacity Block, conviene comprobar tu código contra esa lista. Marca lo que corresponda:
Marca lo que usa tu carga de trabajo para ver la solución de cada bloqueo, extraída de la documentación y el README de TorchNeuron.
Cómo se compara TorchNeuron con otras formas de ejecutar modelos
El verdadero rival de TorchNeuron es la GPU. La elección para un equipo que entrena o sirve sus propios modelos queda así:
| Opción | Qué gestionas | Cambios de código | Ideal para |
|---|---|---|---|
| TorchNeuron en Trainium | Instancias, caché de compilación, formas | Nombre del dispositivo, formas estáticas para compilar | Equipos comprometidos con AWS con trabajos grandes y constantes |
| GPU de NVIDIA en AWS (P5, P5e, P5en) | Instancias | Ninguno para código CUDA | Código con kernels CUDA propios, arranque más rápido |
| Nubes de GPU (CoreWeave, Lambda) | Instancias o clústeres | Ninguno para código CUDA | Capacidad de GPU fuera de las grandes nubes |
| GPU serverless (Modal, Baseten) | El código de tu modelo | Wrappers pequeños | Inferencia con picos sin planificar capacidad |
| APIs de modelos alojados (Together AI, Groq) | Nada | Solo llamadas a la API | Modelos abiertos sin tocar hardware |
Lo interesante es que la primera fila solía tener "reescribe tu stack de entrenamiento" en la columna de cambios de código. Ahora se parece más a las filas de GPU, que es justo el objetivo del lanzamiento. AWS enumera socios que ya construyen sobre esto, entre ellos Anyscale, Modular y Nota AI, y con el soporte de Hugging Face la mayoría de los modelos abiertos de mis artículos sobre Kimi K3 o DeepSeek V4 Flash están a un device_map de Trainium.
En serving, TorchNeuron alimenta el mismo backend de torch.compile en vLLM Neuron, un plugin que añade un servidor compatible con OpenAI, batching continuo y una caché KV paginada. Si tu objetivo final es un agente gestionado en AWS y no tu propio stack de serving, Bedrock Managed Agents está una capa por encima de todo esto.
Primeros pasos
Necesitas una instancia Trn2 o Trn3 y Python 3.12, 3.13 o 3.14. En la Neuron Deep Learning AMI, TorchNeuron ya viene instalado. En otra instancia Linux, el README te indica instalar el driver y el runtime de Neuron y luego fijar las versiones:
pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
pip install "torch-neuronx==2.14.*" "neuronx-cc==2.*" "nki>=0.6" --extra-index-url https://pip.repos.neuron.amazonaws.com
python -m torch_neuronx.collect_env
Mantén los pines: las versiones anteriores de torch-neuronx son el producto basado en XLA con el mismo nombre de paquete, una forma fácil de instalar lo equivocado. La comprobación collect_env debería informar de que el dispositivo es utilizable desde torch.
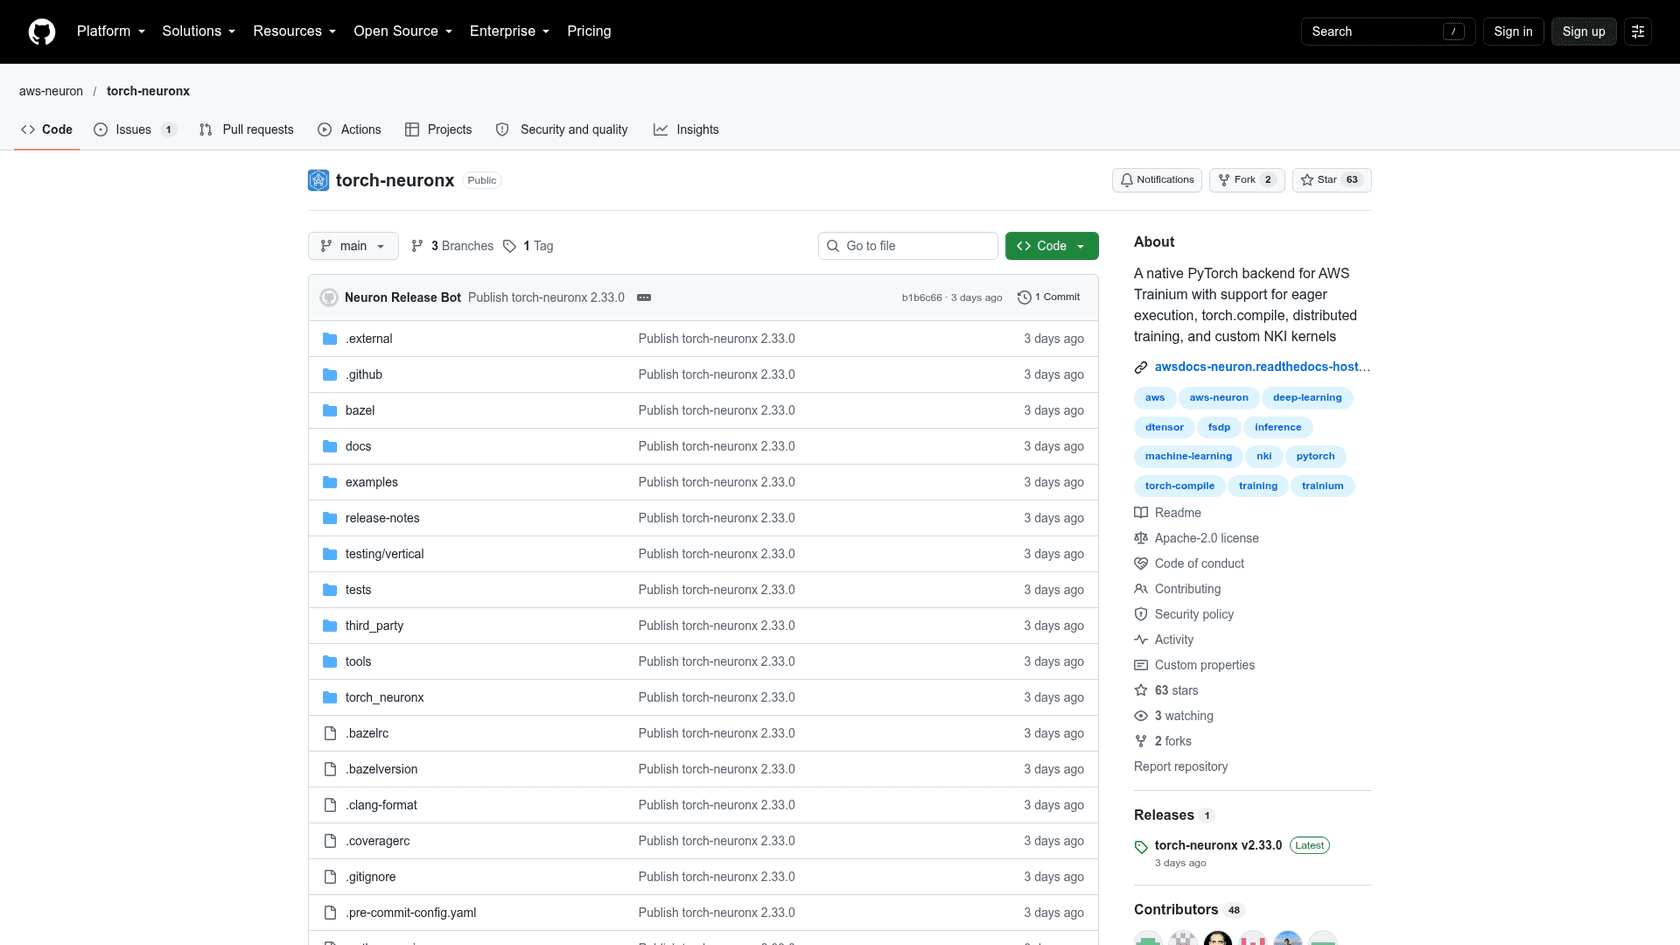
El repositorio tenía 63 estrellas y 48 colaboradores cuando lo capturé el día del lanzamiento, con ejemplos de Llama, Whisper, Qwen2, un modelo de mezcla de expertos, entrenamiento de GPT-2 y ejecuciones multinodo. Para entrenamiento a gran escala, torchtitan-neuron incluye recetas de TorchTitan ajustadas a Trainium. La publicación del lanzamiento explica cómo entrenar Llama 3 8B con SimpleFSDP y torch.compile en una sola trn2.48xlarge.
Mi orden sugerido para un piloto:
- Ejecuta tu modelo en modo eager en una trn2.3xlarge o trn2.48xlarge y lee cada advertencia de fallback a CPU.
- Arregla las formas y luego pasa la ruta crítica a
torch.compileconfullgraph=True. - Comparte la caché de NEFF entre instancias antes de escalar.
- Compara el costo por paso de entrenamiento o por token con tus GPU actuales, no el costo por hora.
Para quién es TorchNeuron
TorchNeuron es para equipos que entrenan o sirven sus propios modelos de PyTorch, ya trabajan en AWS y gastan en aceleradores lo bastante como para que una diferencia de 30-40 % en rendimiento por precio justifique un sprint de ingeniería. Los equipos de investigación sacan más partido del modo eager, ya que depurar por fin funciona como en cualquier otro dispositivo. Los equipos de producción sacan más partido del lado del costo, una vez resueltas las formas y la caché.
No es para ti si tu código depende de kernels CUDA personalizados que todavía no puedes reescribir, si necesitas Trainium1 o Inferentia, o si nunca tocas pesos de modelos. La mayoría de las empresas que usan IA, incluidas la mayoría de las que conozco en eesel, están en este último grupo: quieren que la IA haga un trabajo, y el chip donde se ejecuta es problema de otro.
Dónde encaja eesel: esto es infraestructura, eesel es el empleado
TorchNeuron hace la capa de hardware más barata y más fácil de cambiar. Es una buena noticia para todos los que construyen modelos y, con el tiempo, reduce el costo de los productos de IA construidos encima. Pero no responde un ticket, no redacta una respuesta ni escribe un artículo de blog. Eso son trabajos, y los trabajos necesitan contexto: tu centro de ayuda, tus conversaciones pasadas, tus reglas sobre reembolsos.
Esa es la capa en la que trabaja eesel. eesel es una plataforma de compañeros de IA: contratas compañeros listos para trabajar en tareas concretas, hoy un compañero de IA para el helpdesk y un redactor de blog con IA. El compañero para el helpdesk se une a tu cola actual, aprende de tu centro de ayuda y de tickets anteriores, y se simula con tus conversaciones históricas antes de responder a un cliente real.
SE Ranking es un buen ejemplo para un público técnico. Ejecuta un agente de eesel por producto para SE Ranking, Planable y SE Visible en Zendesk, y entre el 8 de agosto y el 8 de septiembre de 2026 eesel gestionó unas 4.650 conversaciones, incluidos unos 2.100 chats en vivo. Las preguntas sobre la API y Looker Studio se derivan a un grupo de nivel 2 con la evidencia ya recopilada, en lugar de que el bot adivine.
Si eres de los lectores que acaban de instalar un backend de PyTorch desde un índice pip fijado, probablemente también prefieras configurar esto desde una terminal. La CLI de eesel opera el mismo compañero y el mismo espacio de trabajo que el panel, así que todo lo que configures allí aparece en la interfaz y al revés. npx @eesel/cli init chat-bubble --site https://your-site.com crea un agente, añade una burbuja de chat al sitio web y empieza a leer tu sitio, sin necesidad de cuenta; después, eesel login conserva el espacio de trabajo. Desde ahí, eesel chat habla con el agente, eesel files upload añade conocimiento, eesel integrations connect conecta tu helpdesk, eesel automations define lo que hace por su cuenta y eesel approvals te deja aprobar acciones retenidas.
Cada comando imprime JSON, los errores vuelven como {error, hint, retryable} y --dry-run muestra la llamada exacta al servidor que haría una escritura. Eso es lo que permite que lo usen agentes de programación como Claude Code o Cursor: el agente puede ejecutar la configuración y leer sus propios resultados. Cada espacio de trabajo es además un servidor MCP, y eesel mcp token imprime una línea de configuración lista para pegar.

El mismo registro que ves arriba en el panel es lo que eesel activity imprime en la terminal, con lo más reciente primero.
Prueba eesel
TorchNeuron te deja elegir el chip más barato para tus modelos. eesel te deja saltarte esa decisión en el trabajo de soporte: un compañero para el helpdesk que se conecta a Zendesk, Freshdesk o Gorgias, se entrena con tus tickets pasados y se prueba con conversaciones históricas antes de tocar una en vivo. Para equipos SaaS con preguntas muy técnicas sobre la API, la API del helpdesk con IA y la CLI permiten automatizar toda la configuración con scripts. Prueba eesel gratis, o empieza desde la terminal con npx @eesel/cli.
Preguntas frecuentes
¿Qué es TorchNeuron?
neuron a PyTorch estándar, de modo que el modo eager, torch.compile y torch.distributed funcionan en Trainium2 y Trainium3. Se lanzó en beta pública el 20 de octubre de 2026. Si lo que buscas es una IA que haga un trabajo y no un chip donde ejecutar modelos, un compañero de IA es el otro extremo del stack.¿TorchNeuron es gratis?
¿De verdad TorchNeuron solo requiere cambiar una línea de código?
.to('cuda') por .to('neuron'), o no cambies nada si tu código ya usa torch.accelerator. Para obtener velocidad de producción, además añades backend="neuron" a torch.compile, usas formas estáticas y quitas las opciones exclusivas de CUDA. Herramientas agénticas como Claude Code resuelven bien este tipo de migración mecánica.