

Resumen
Muse Spark Open es el primer modelo Muse de pesos abiertos de Meta, lanzado el 15 de octubre de 2026. Tiene 816B parámetros con 42B activos por token, acepta texto, imágenes, video y audio, maneja 1M de tokens de contexto y comparte su modelo base con el Muse Spark 1.3 cerrado. Puedes descargarlo de Hugging Face o alquilarlo en siete proveedores.
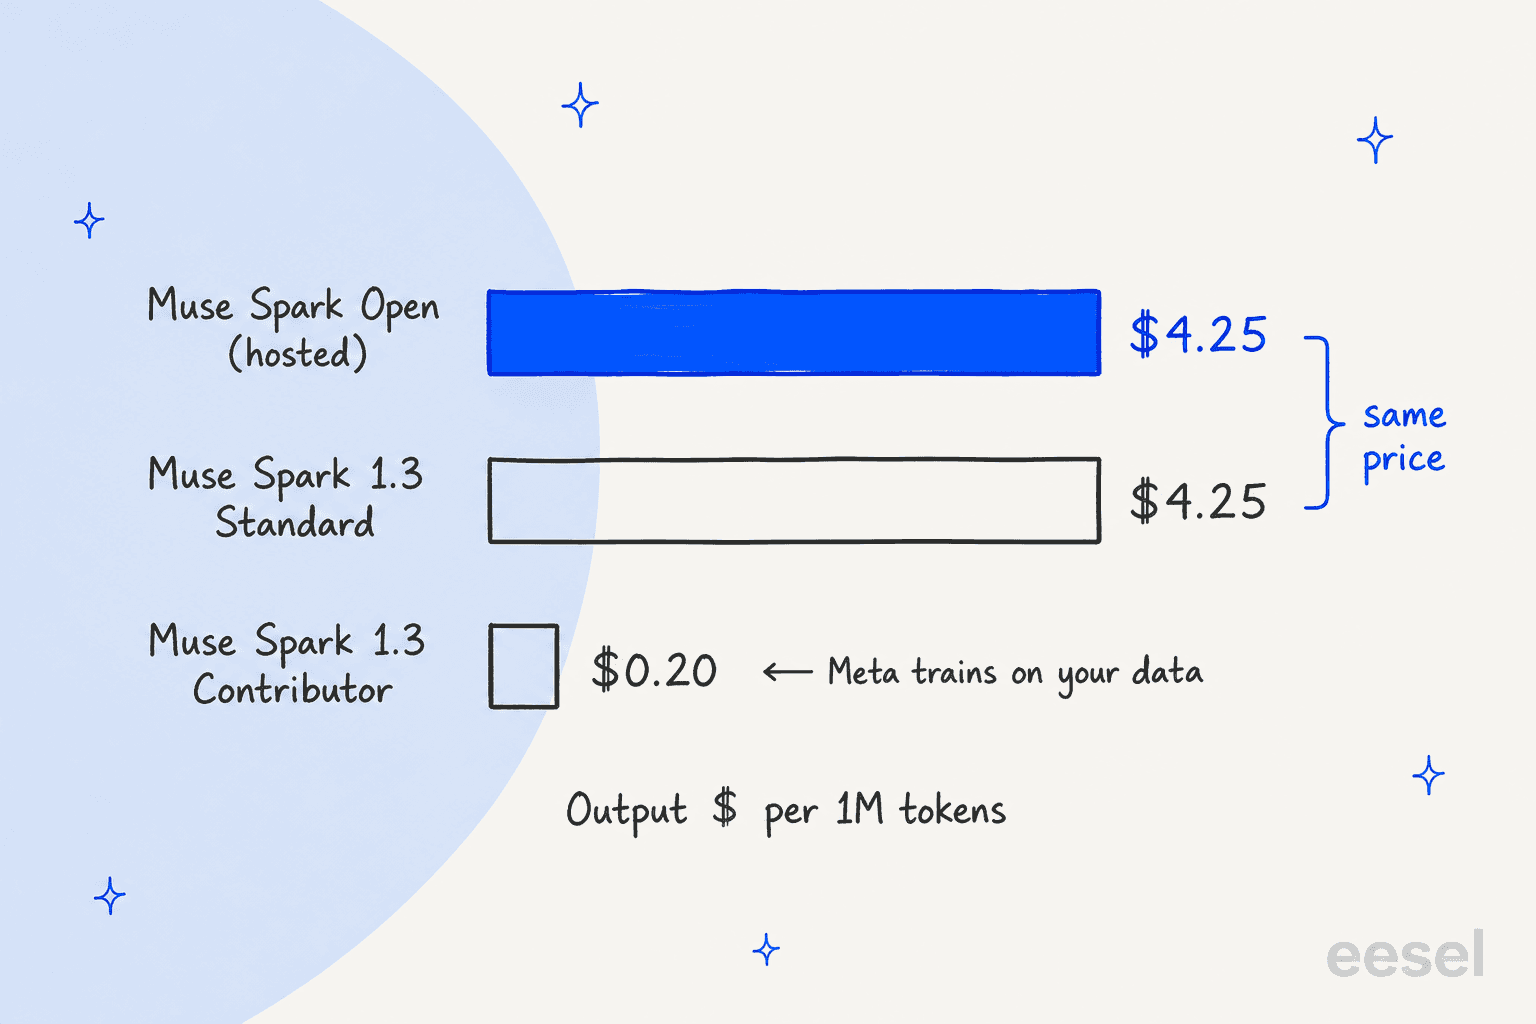
Esta es la parte que omite la cobertura del lanzamiento. Alojado, cuesta $1.25 de entrada y $4.25 de salida por millón de tokens, exactamente la tarifa que Meta cobra por el Muse Spark 1.3 cerrado. En la propia tabla de Meta obtiene 39 en el Artificial Analysis Index, por detrás de GLM 5.3 (45) y Kimi K3 (44). Es decir, los pesos abiertos aquí no te dan un modelo más barato ni más inteligente. Te dan control: dónde se ejecuta el modelo, quién ve el tráfico y si puedes ajustarlo. Además, registra la tasa de jailbreak más baja de su comparación por un margen enorme.
Yo construyo los agentes de IA en eesel, y esa pregunta sobre el control es la que más escucho. Un equipo B2B de telemática que usa Zendesk detuvo una vez una demo para preguntar si los tickets con números de tarjeta y contraseñas se quedarían dentro de su propio entorno. Muse Spark Open es el primer modelo Muse para el que la respuesta honesta puede ser "sí, ejecútalo tú mismo". Pero un modelo autoalojado sigue siendo un modelo, no un compañero de equipo. Si lo que quieres es un compañero de IA para helpdesk que ya conozca tu centro de ayuda, esa es la capa que vende eesel.
Qué lanzó realmente Meta el 15 de octubre
El blog de investigación de Meta llama a Muse Spark Open "the most capable US open-weight model to date", creado para programación y trabajo con agentes. La publicación del equipo de PyTorch añade el detalle más importante: "shares the same base model as Muse Spark 1.3", con un posentrenamiento de seguridad adicional para que se sostenga "as a standalone model without system guardrails". Es un cambio enorme para una empresa que pasó la mayor parte de 2026 manteniendo Muse Spark cerrado.
La ficha del modelo en Hugging Face lista las especificaciones:
| Especificación | Muse Spark Open |
|---|---|
| Fecha de lanzamiento | 15 de octubre de 2026 |
| Parámetros | 816B en total, 42B activos por token |
| Arquitectura | Mezcla de expertos, 256 expertos, 8 activos por token, 62 capas |
| Contexto | 1M de tokens en inferencia |
| Entrada / salida | Entrada de texto, imagen, video y audio; salida de texto |
| Idiomas | Entrenado con datos de más de 100 idiomas |
| Esfuerzo de razonamiento | low, medium, high, xhigh (por defecto xhigh) |
| Pesos | BF16 y NVFP4 |
| Licencia | Muse Model License |
El lanzamiento fue ruidoso. El hilo de Hacker News alcanzó 914 puntos y 477 comentarios el primer día, y la publicación de investigación de ML de Apple sobre cómo ejecutarlo en Mac Studio sumó otros 363 puntos.
Cómo funcionan 42B activos de 816B
Esta es la parte que me parece más interesante, porque explica tanto lo del hardware como lo del precio. Muse Spark Open es un modelo de mezcla de expertos. Cada capa contiene 256 redes de expertos pequeñas, y un enrutador elige 8 de ellas para cada token. Así, el modelo almacena 816B parámetros, pero cada token solo pasa por unos 42B.
Esa división tiene dos consecuencias que la gente suele confundir:
- La memoria la fijan los 816B. Todos los expertos tienen que estar en memoria porque cualquier token podría necesitar a cualquier experto. Por eso los pesos BF16 pesan unos 1.6TB.
- La velocidad la fijan los 42B. Cada token solo lee su porción, así que la generación va a un ritmo más cercano al de un modelo de 42B. Apple lo dice sin rodeos: los 1.2 TB/s de ancho de banda del M5 Ultra "is fast enough to read the small slice each token needs."
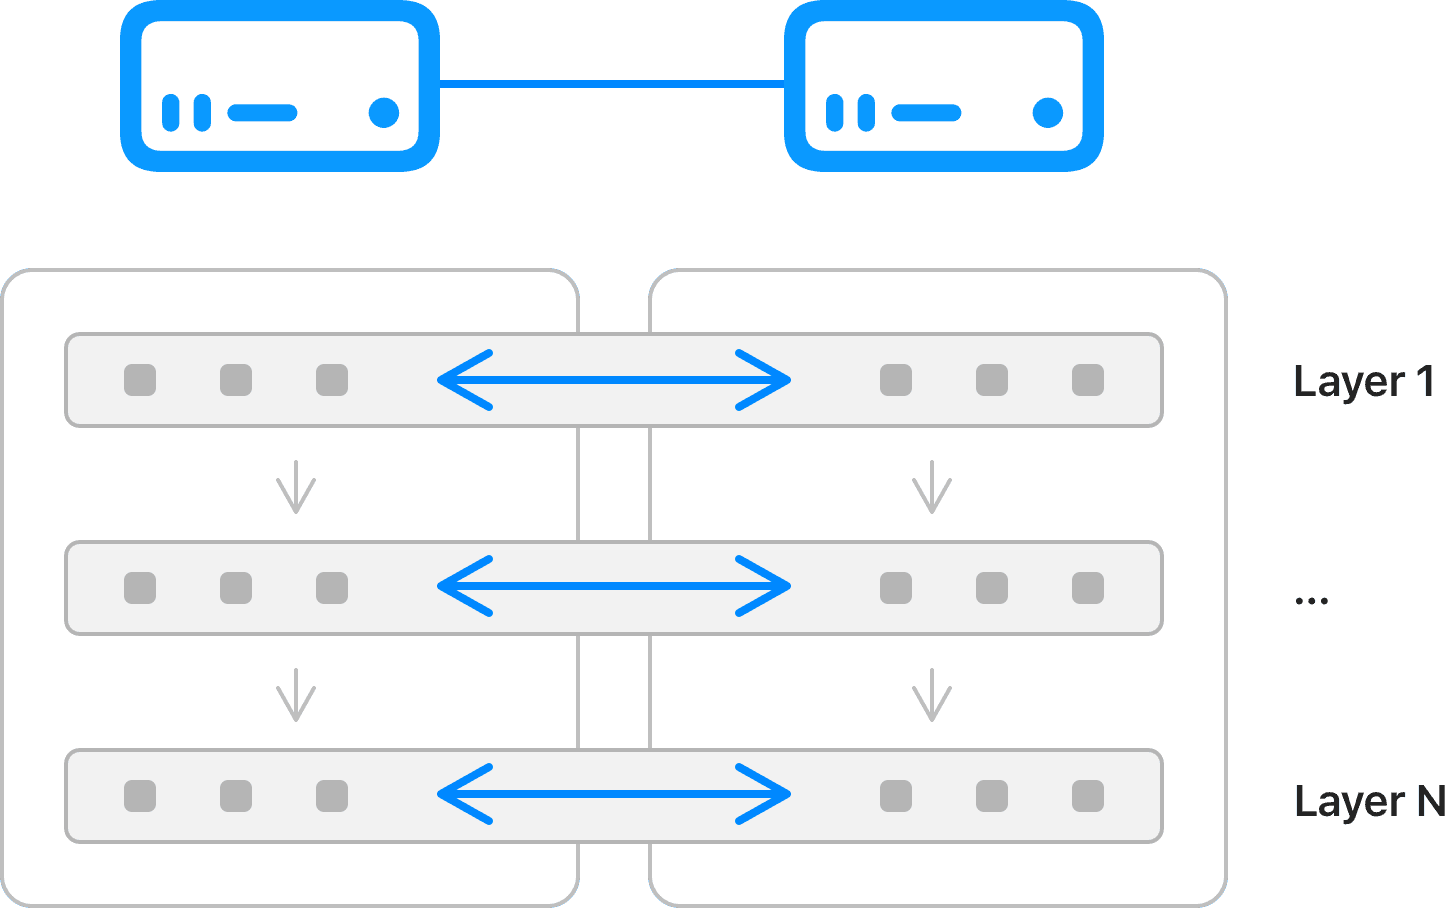
La publicación para desarrolladores de Meta dice que el checkpoint NVFP4 cuantiza solo los expertos, lo que lo deja en unos 530GB. Sigue siendo demasiado grande para cualquier equipo de escritorio, así que Meta y Apple lo reparten entre dos máquinas con paralelismo tensorial: cada Mac guarda la mitad de cada capa y hace la mitad del cálculo de cada token.
La ficha del modelo también describe un codificador de percepción aparte de 1.8B parámetros para imágenes y video. En la práctica, eso significa que no tienes que acoplar un modelo de visión por separado. Un solo checkpoint lee capturas de pantalla, grabaciones y documentos, lo cual importa si estás construyendo agentes que usan una computadora y no solo un cuadro de chat.
Precio de Muse Spark Open: la misma tarifa que el modelo cerrado
Los pesos son gratis. El número interesante es lo que cuesta alquilarlo. Meta no sirve Muse Spark Open en su propia API; su página de precios solo lista Muse Wonder y los modelos Spark cerrados. En cambio, siete socios lo alojan, y los que tienen tarifas públicas coinciden en la misma.
| Dónde | Entrada / 1M | Caché / 1M | Salida / 1M | Notas |
|---|---|---|---|---|
| OpenRouter | $1.25 | $0.15 | $4.25 | Enruta entre Modal, Together, Nebius, Fireworks, Baseten; 262,144 de salida máxima |
| Fireworks AI | $1.25 | $0.15 | $4.25 | Entrenamiento LoRA serverless vía API |
| Baseten | $1.25 | $0.15 | $4.25 | NVFP4 con un drafter especulativo |
| Groq | No público | No público | No público | Vista previa limitada, contexto de 131K |
| API de Meta: Muse Spark 1.3 Standard | $1.25 | $0.15 | $4.25 | Cerrado, precios de Meta |
| API de Meta: Muse Spark 1.3 Contributor | $0.10 | $0.002 | $0.20 | Cerrado, Meta entrena con tus datos |
El modelo abierto se alquila exactamente por lo que cuesta el cerrado. Y el token más barato de Meta sigue siendo el nivel contributor cerrado, a cerca de una vigésima parte del precio de salida, a cambio de que Meta entrene con tu tráfico. Si calculaste el precio de Muse Spark Open esperando el descuento habitual de los pesos abiertos, todavía no está ahí. Mi artículo sobre los precios de Muse Spark 1.3 explica cómo funciona ese trato de dos niveles.
Dos cosas lo suavizan. El almacenamiento en caché es agresivo: OpenRouter reporta un precio de entrada promedio ponderado de unos $0.35 por millón en tráfico real, porque las tasas de aciertos de caché superan el 70% en la mayoría de los proveedores. Y Artificial Analysis encontró que el modelo es bastante conciso: usó 110M de tokens de salida para completar su índice frente a una mediana de 130M, a unos $0.84 por tarea.
Un comentarista de Hacker News interpretó el precio plano como un efecto secundario de la licencia:
"The usual effect of separate licensing is decreased price competition from public providers (like we saw with Kimi K3)."

Es una lectura razonable de la licencia, de la que hablo más abajo. Lo que vigilaría es si los proveedores empiezan a recortarse precios entre sí en unas semanas. Para ver cómo otros proveedores fijan precios a modelos abiertos, consulta los precios de Together AI y los precios de Fireworks AI.
La afirmación sobre el Mac Studio, y el problema
El titular de Meta es que Muse Spark Open es "the first model in its class to run on your desktop using two Apple M5 Ultra Mac Studios." Es real, y Apple publicó los números. En sus tablas de rendimiento, con un contexto de 8,192 tokens:
| Configuración | Tiempo hasta el primer token | Velocidad de decodificación |
|---|---|---|
| 2 Mac Studio, paralelismo de pipeline | 8.4s | 15.74 tok/s |
| 2 Mac Studio, paralelismo tensorial | 8.2s | 24.99 tok/s |
| 4 Mac Studio, paralelismo tensorial | 4.8s | 36.73 tok/s |
Veinticinco tokens por segundo es utilizable para un agente de programación que trabaja en segundo plano. Meta dice que así entregó correcciones reales de iOS para el cliente de Mastodon Ice Cubes y manejó DaVinci Resolve de principio a fin, todo en el dispositivo mediante Muse Code.
Ahora el problema. La configuración con dos Mac necesita 512GB de memoria por máquina, y la propia tienda de Apple lista la opción de 512GB para M5 Ultra como "coming late October." A día de hoy no se puede pedir. La página de Mac Studio en la tienda empieza las configuraciones M5 Ultra en $5,499 con 96GB de memoria, antes de cualquier mejora. La publicación para desarrolladores de Meta ofrece una ruta con cuatro Mac de 256GB cada una, que alcanza el mismo 1TB de memoria conjunta.
Si no tienes hardware de Apple, esta es la escalera completa de lo que hace falta:
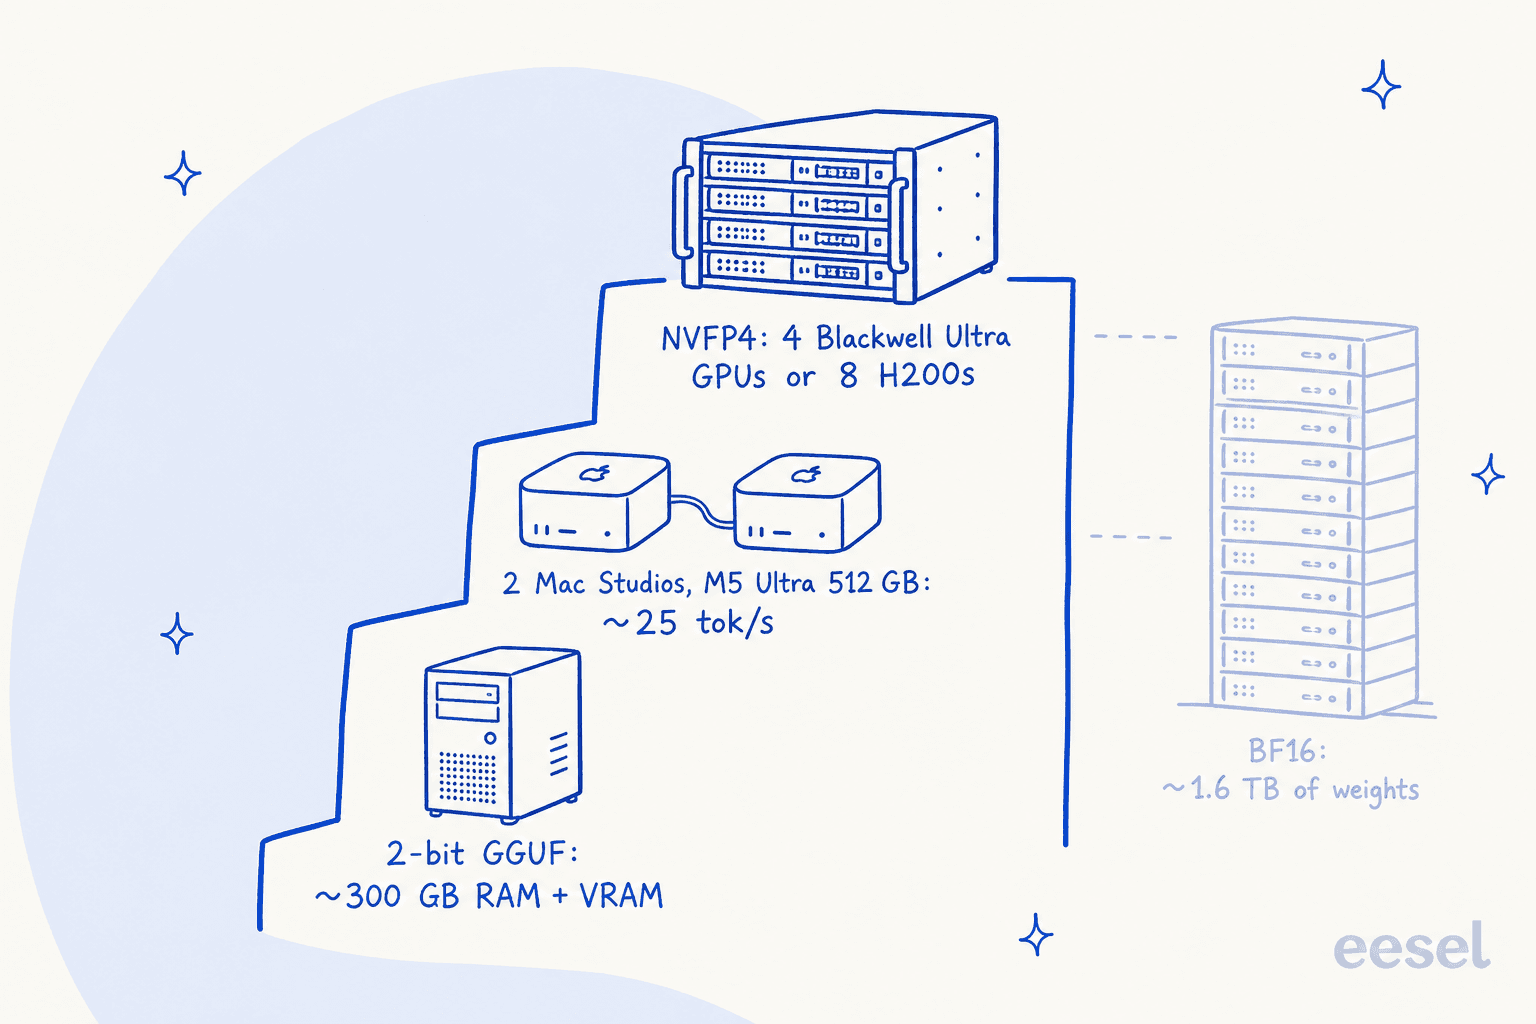
- GPU de centro de datos. La ficha del modelo pide al menos 700GB de memoria de GPU para NVFP4 y 2TB para BF16. La publicación para desarrolladores de Meta dice que NVFP4 se sirve en cuatro GPU Blackwell Ultra u ocho H200, mediante SGLang, vLLM o TensorRT-LLM.
- Una estación de trabajo grande. El GGUF dinámico de 2 bits de Unsloth cabe en unos 300GB de RAM del sistema y VRAM combinadas, ejecutado con llama.cpp. Espera pérdida de calidad con esa compresión; la propia ficha del modelo advierte que las versiones cuantizadas pueden diferir en casos límite.
- Catálogos en la nube. Amazon SageMaker AI, Google Cloud Model Garden y Microsoft Foundry Models incluyen los pesos si quieres una instancia privada en tu propia cuenta de nube.
El resumen más honesto vino de un comentarista que leyó la guía de Unsloth: "You & Me won't be running this one" (spwa4, Hacker News). Para la mayoría de los equipos, "abierto" significará alquilarlo a un proveedor, o ejecutarlo en su propia nube por razones de datos.
Cómo se compara Muse Spark Open con otros modelos abiertos
Meta comparó Muse Spark Open con siete pares de pesos abiertos, entre ellos Kimi K3, Mistral Large 4, Inkling y Beam de Reflection. Ejecutó su propio modelo con esfuerzo xhigh. Esta es la tabla publicada:
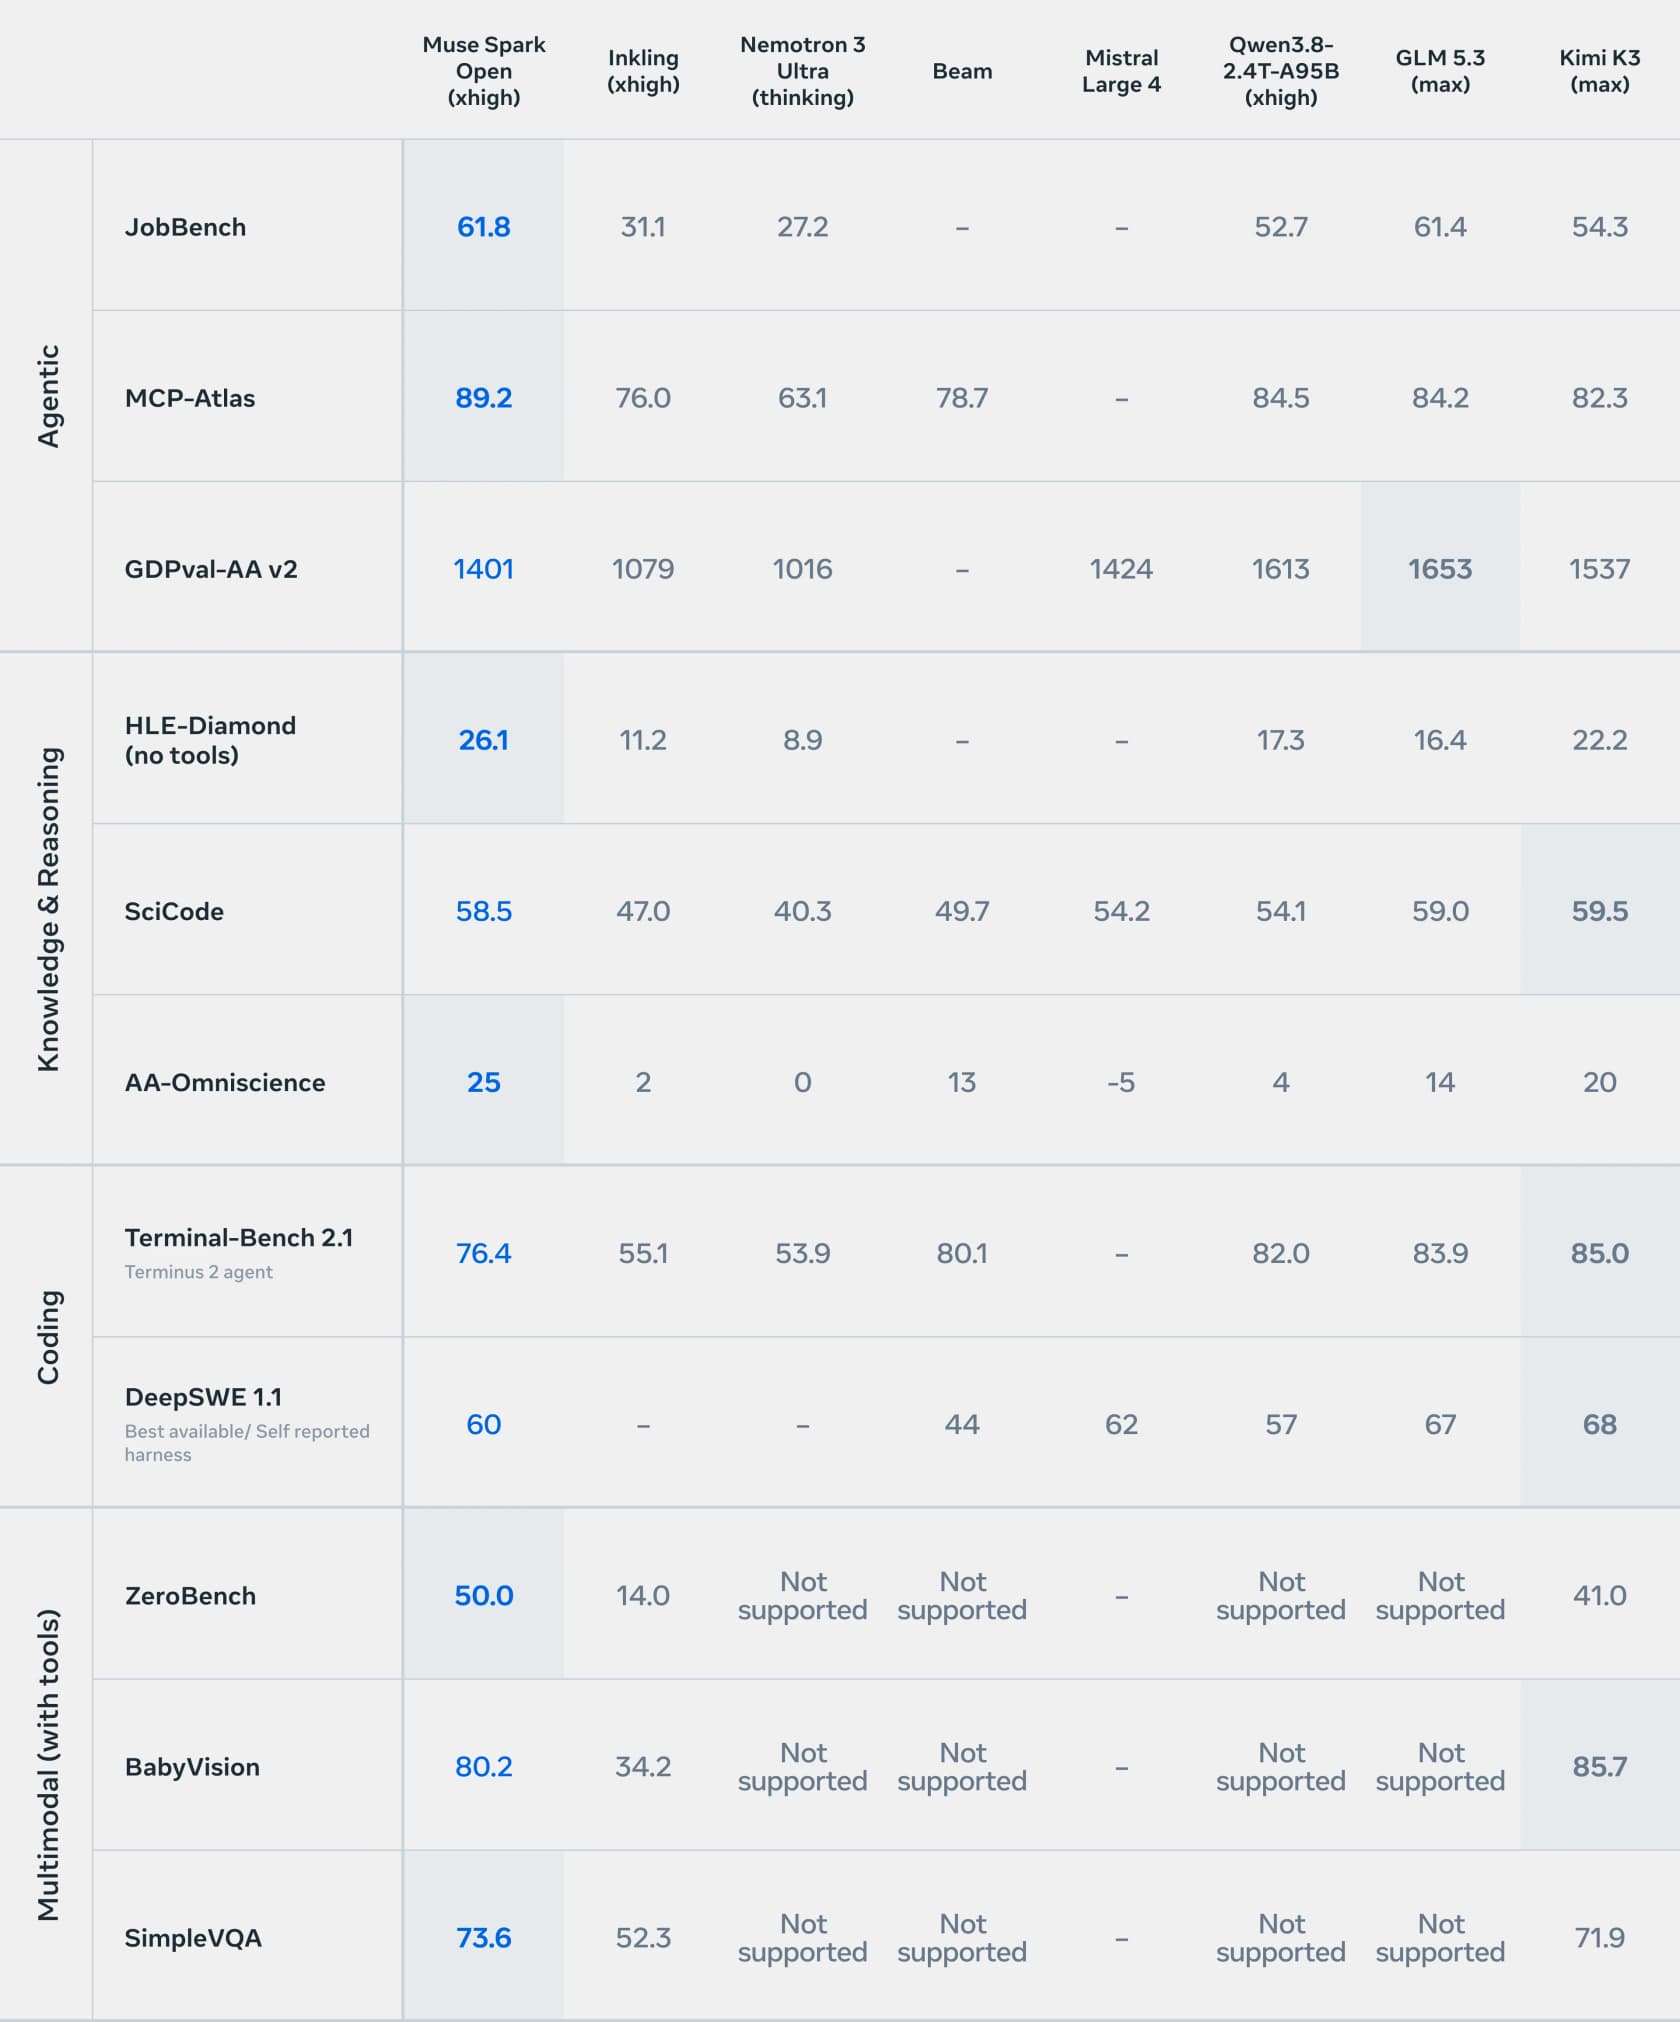
Léela fila por fila y aparece una forma clara:
- Dónde lidera: uso de herramientas y tareas de agentes (MCP-Atlas 89.2, JobBench 61.8), conocimiento sin herramientas (HLE-Diamond 26.1, AA-Omniscience 25) y varias pruebas multimodales (ZeroBench 50.0, SimpleVQA 73.6).
- Dónde se queda atrás: el índice general y la programación. En el Artificial Analysis Index obtiene 39, por detrás de GLM 5.3 (45), Kimi K3 (44) y Qwen3.8 (40). En Terminal-Bench 2.1 marca 76.4 frente a 85.0 de Kimi K3; en DeepSWE, 60 frente a 68.
- Dónde juega en otra liga: la seguridad. En StrongREJECT, una prueba adaptativa de jailbreak donde menos es mejor, obtiene 0.5. Todos los demás modelos que Meta probó quedan entre 62.9 y 86.4.
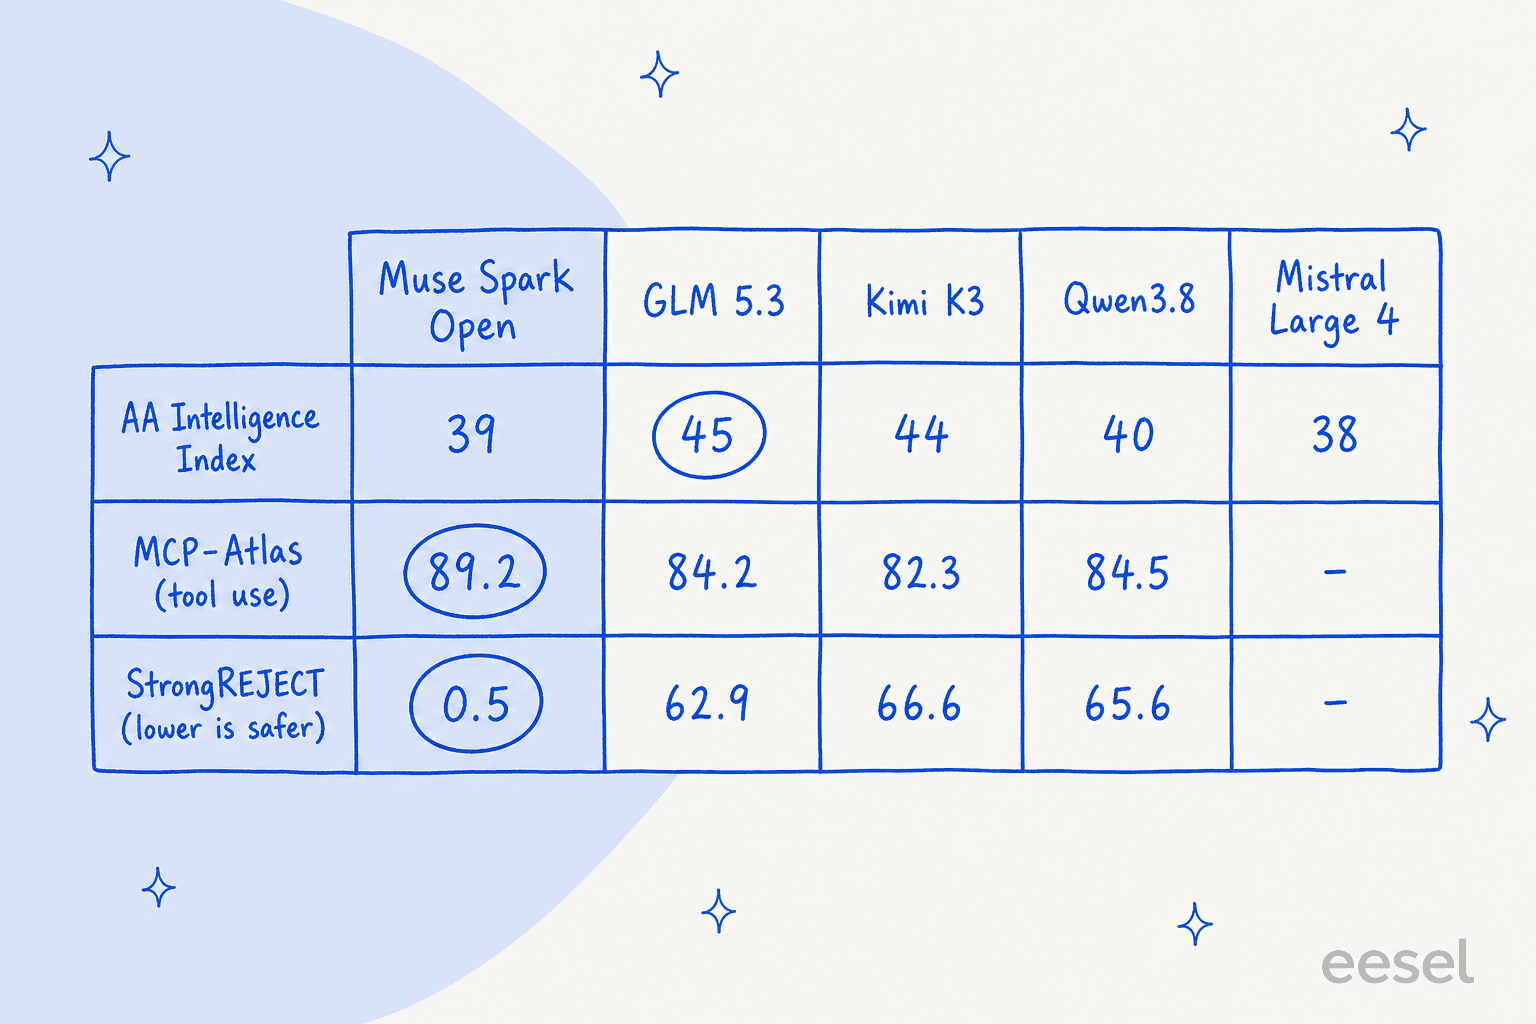
El número independiente coincide con el de Meta. Artificial Analysis lista a Muse Spark Open con 39 en su índice, muy por encima de la mediana de 19 para modelos comparables, a 131 tokens por segundo. Hacker News lo puso en contexto rápido:
"39 on AA, about the same as Deepseek v4.1 flash and Mimo 2.5 Flash. Behind Glm 5.3 flash and Qwen3.8-Flash-Next"
Esa comparación duele, porque DeepSeek V4.1 Flash y GLM 5.3 Flash son modelos mucho más pequeños. Los reportes de uso real hasta ahora coinciden en la forma: un probador lo encontró "dumber than GLM 5.3" pero "really fast" en Fireworks (eknkc, Hacker News), y otro lo ubicó "closer to 1.2" que a 1.3 en benchmarks (modeless, Hacker News). Meta no publicó una comparación directa con sus propios modelos cerrados, así que toma esto último como una impresión temprana.
Mi lectura: es sobre todo un modelo para llamadas a herramientas y bucles de agentes, con un comportamiento de seguridad sólido, más que el mejor programador abierto. Los primeros usuarios citados en la publicación para desarrolladores de Meta dicen lo mismo, y lo elogian por elegir "the right next tool" y por sus salidas estructuradas limpias en llamadas de varios pasos y en paralelo. Si tu agente se la pasa llamando herramientas, la ventaja en MCP-Atlas importa más que la brecha del índice. Si se la pasa escribiendo código, Kimi K3 es la opción abierta más fuerte según estos números.
La licencia: gratis, con tres condiciones
Meta publicó los pesos bajo la Muse Model License, que describe como con "limited commercial terms." Se lee como una licencia permisiva con condiciones añadidas. Puedes usarlo, copiarlo, modificarlo, ajustarlo, destilarlo, fusionarlo, publicarlo y venderlo, gratis, sujeto a:
- La política de uso. Una larga lista de usos prohibidos, desde armas e infraestructura crítica hasta reseñas falsas y hacer pasar las salidas por texto escrito por humanos. También dice que el modelo no está pensado para menores de 18 años.
- Atribución. Debes mostrar de forma "prominently display" las palabras "Built with Muse Spark Open" en la interfaz de tu producto, la documentación, el sitio web o el menú de ajustes. Esto también aplica a cualquier modelo que entrenes o destiles a partir de sus salidas.
- La cláusula de servicio de $20M. Si vendes acceso a modelos de IA como servicio mediante API, y tu grupo de empresas gana más de $20 millones en un periodo de 12 meses, debes notificar a Meta y firmar antes un acuerdo aparte.
La tercera cláusula suena aterradora y en su mayoría no lo es. Excluye explícitamente el uso interno, la investigación y el uso del modelo para impulsar funciones de tu propio producto. Una empresa SaaS que ejecuta Muse Spark Open detrás de su bandeja de soporte no le debe nada a Meta más allá de la línea de atribución. La cláusula apunta a proveedores de inferencia y grandes plataformas que revenden el modelo.
Un obstáculo práctico más: descargar desde Hugging Face implica un formulario restringido que pide tu nombre legal completo, fecha de nacimiento y el nombre completo de la organización con identificadores corporativos. Meta además no reclama la propiedad de las salidas, que es la cláusula que tu equipo legal buscará primero.
Lo uso internamente, para investigación o para impulsar funciones dentro de mi propio producto
Gratis. Sin acuerdo aparte, incluso por encima de $20M de ingresos. Aun así debes seguir la política de uso y mostrar "Built with Muse Spark Open" en algún lugar que los usuarios puedan encontrar: la interfaz, la documentación, el sitio web o un menú de ajustes.
Vendo acceso por API a modelos de IA y mi grupo de empresas gana menos de $20M al año
Gratis por ahora, con las mismas reglas de atribución y de uso. Vigila los ingresos: la prueba es cualquier periodo de 12 meses consecutivos, contando a ti y a tus afiliadas.
Vendo acceso por API a modelos de IA y mi grupo de empresas gana más de $20M al año
Debes notificar a Meta y firmar un acuerdo escrito aparte antes de ofrecer Muse Spark Open, o cualquier cosa derivada de él, en ese servicio. Las condiciones no son públicas.
Ajusté o destilé un modelo nuevo a partir de él
Eso cuenta como Derivative. La línea de atribución y la política de uso lo acompañan, y también la cláusula de servicio de $20M si revendes acceso a él.
Resumido de la Muse Model License con fecha del 15 de octubre de 2026. No es asesoría legal; lee el texto completo en Hugging Face antes de lanzar.
¿Es "abierto"? Muchos comentaristas de Hacker News dijeron que no, porque la licencia no está aprobada por la OSI y solo se publican los pesos, sin datos de entrenamiento ni código. Yo lo llamaría pesos abiertos con un techo comercial, y para la mayoría de las empresas ese techo está muy por encima de cualquier cosa que alcancen. Si quieres bloques de construcción totalmente de código abierto, mi lista de agentes de IA de código abierto es un mejor punto de partida.
Seguridad: la parte más fuerte del lanzamiento
Aquí es donde Meta hizo más trabajo, y se nota. La ficha del modelo reporta, sin salvaguardas a nivel de sistema:
- Uso indebido en ciberseguridad: rechazó el 99.2% de los jailbreaks en el benchmark interno de Meta y el 94.8% en PolyGuard, RedCode y CyberBench 2024. Kimi K3 rechazó el 75.5% y el 70.2% con la misma configuración.
- Química y biología: más del 98% de rechazos en BioTIER de SecureBio, más del 97% en la prueba agéntica de biología multivuelta de Meta.
- Honestidad: una tasa de honestidad del 98.1% en el benchmark MASK, y 0% de mala conducta en el benchmark Agentic Misalignment.
Hay una contrapartida escondida en la propia tabla de Meta. En la prueba FORTRESS, Muse Spark Open tiene la puntuación de riesgo adversarial más baja (5.8) pero la puntuación de rechazo excesivo más alta (17.4) del grupo, es decir, rechaza más solicitudes inofensivas que GLM 5.3 (3.2) o Kimi K3 (2.7). Para un bot de cara al cliente, unas cuantas respuestas extra de "no puedo ayudarte con eso" son un costo real. Pruébalo con tu propio tráfico antes de confiar en la configuración por defecto.
Dos salvedades de la propia Meta. El informe de evaluación completo sigue "available soon." Y la ficha del modelo advierte que "downstream modifications could degrade safety", así que en el momento en que lo ajustas, esos números dejan de ser tuyos. El propio consejo de Meta es desplegarlo dentro de un sistema con barreras de protección adicionales y "human-in-the-loop confirmation for irreversible actions", que es lo mismo que le diría a cualquiera que ponga un modelo detrás de una cola de soporte.
Ajuste fino desde el primer día
Esto es lo otro que los pesos abiertos realmente desbloquean. Meta dejó listo desde el lanzamiento el soporte de posentrenamiento en todos los frentes, según su publicación para desarrolladores:
- PyTorch TorchTitan: preentrenamiento, SFT multivuelta, LoRA y aprendizaje por refuerzo.
- Hugging Face TRL: LoRA con SFTTrainer sobre el checkpoint publicado.
- Fireworks AI: entrenamiento LoRA serverless mediante una API, con secuencias de hasta 262,144 tokens. Su página del modelo señala que el ajuste fino administrado en la interfaz aún no está disponible para este modelo.
- Together AI: SFT o aprendizaje por refuerzo GRPO en su servicio de posentrenamiento, y luego servir varios adaptadores LoRA en un mismo despliegue.
- NVIDIA NeMo AutoModel y Miles de RadixArk para trabajo con todos los parámetros.
Para un equipo de soporte, el ajuste fino suena atractivo: enseñarle tu tono, los nombres de tus productos, tus reglas de reembolso. En mi experiencia rara vez es la primera solución. La mayoría de las respuestas incorrectas que veo vienen de un centro de ayuda desactualizado o contradictorio, no de un modelo que necesite reentrenarse, y la recuperación lo arregla más rápido. Mi artículo sobre RAG vs LLM explica por qué. Ajusta el modelo cuando la recuperación ya esté sólida y aún veas problemas de estilo o formato.
¿Quién debería usar realmente Muse Spark Open?
Así lo decidiría yo:
- Necesitas el modelo dentro de tus propios muros. Datos regulados, una revisión de seguridad que bloquea a terceros procesadores o un contrato con un cliente que dice "sin IA externa". Es el caso más sólido, y los números de seguridad lo hacen más fácil de defender.
- Estás construyendo agentes con muchas herramientas. Las ventajas en MCP-Atlas y JobBench son reales. Combínalo con un servidor MCP y mira cómo maneja tu conjunto de herramientas.
- Quieres ajustar un modelo multimodal grande. Acepta audio y video de forma nativa, y la pila de entrenamiento estaba lista el día del lanzamiento.
- Quieres los tokens más baratos de Meta. Sáltatelo. El precio contributor del Muse Spark 1.3 cerrado es mucho más barato, si aceptas que Meta entrene con ese tráfico.
- Quieres el mejor programador abierto. Mira primero Kimi K3 o Qwen, o sube a modelos cerrados de frontera como Claude Opus 5.5 y el más reciente Muse Wonder.
Para el soporte al cliente en concreto, la elección del modelo es la decisión más pequeña. Mi guía de modelos para soporte explica por qué la recuperación, el escalamiento y las pruebas mueven más la calidad de resolución que unos cuantos puntos de índice. Una brecha de 6 puntos en el índice rara vez se nota en una cola de tickets. Una respuesta segura basada en un artículo desactualizado se nota todos los días, con pesos abiertos o sin ellos.
Prueba eesel
Muse Spark Open es infraestructura. Obtienes pesos, una licencia y una factura de hardware, y luego construyes tú mismo la recuperación, las reglas de escalamiento, las pruebas y el registro de auditoría. eesel es el empleado. Nuestro compañero de IA para helpdesk se conecta con Zendesk, Freshdesk, Gorgias y el resto, aprende de tus tickets pasados y de tu centro de ayuda, y puedes ejecutarlo con cientos de tus tickets históricos antes de que responda a un solo cliente. Esa repetición es donde detectas la respuesta demasiado segura de sí misma antes que un cliente, sea cual sea el modelo que haya debajo.
Si prefieres gestionarlo desde una terminal, como harías con un modelo autoalojado, la CLI de eesel lo cubre. eesel instructions lee y edita las reglas permanentes del compañero, eesel approvals lista las acciones que esperan a una persona y eesel activity muestra cada ejecución y por qué hizo lo que hizo. Cada comando imprime JSON y las escrituras aceptan --dry-run, así que un agente de programación como Claude Code puede gestionar tu compañero de soporte igual que gestiona tu repositorio. Si escribes contenido en lugar de responder tickets, la misma plantilla incluye un escritor de blogs con IA.

Empezar es gratis con 100 créditos y sin tarjeta. Prueba eesel con los tickets del mes pasado y mira qué habría respondido, antes de calcular el precio de un solo Mac Studio. Los planes están en la página de precios.