

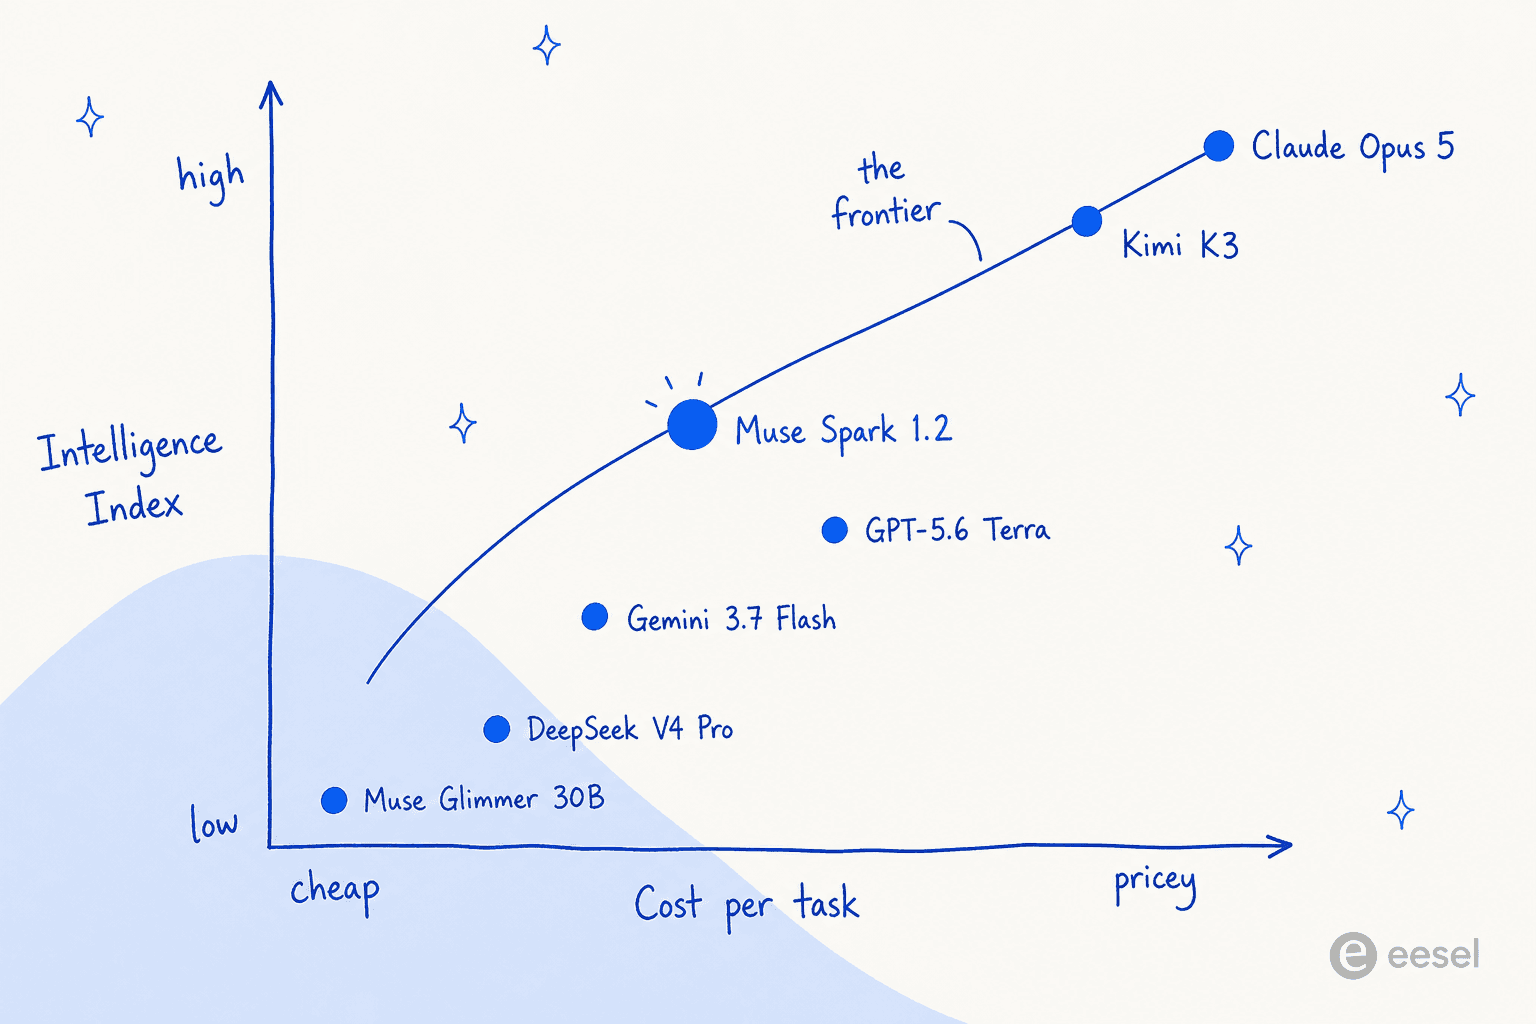
La mayoría de los artículos sobre "alternativas a Muse Spark 1.2" empiezan diciéndote que el modelo está superado. No lo está. En el Artificial Analysis Intelligence Index, nada puntúa más alto que Muse Spark 1.2 con un coste por tarea menor. Está 7º de 20 con 56,76, y eso por 0,3992 $ la tarea. Todos los modelos por encima en el ranking te cuestan más.
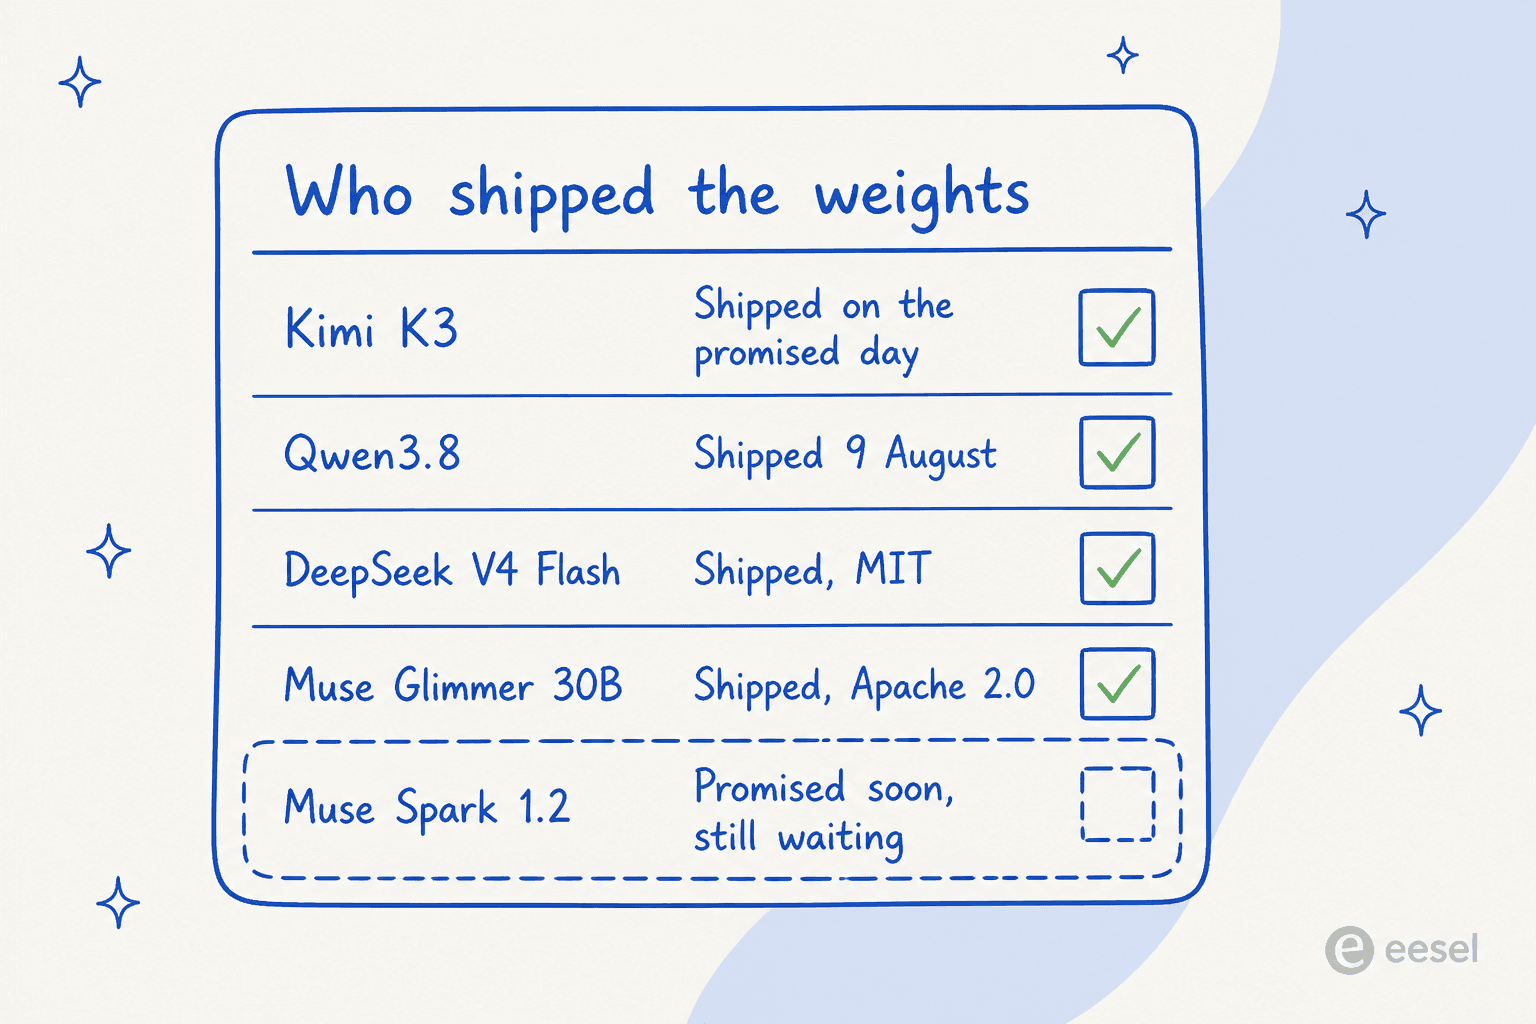
Así que la razón honesta para irse no tiene nada que ver con la capacidad. Lo que importa es que el Chief AI Officer de Meta prometió pesos abiertos para Muse Spark 1.2 el 10 de agosto, sin licencia ni fecha, y ocho días después no se ha publicado nada. Moonshot, mientras tanto, publicó Kimi K3 justo el día que prometió. Qwen publicó el 9 de agosto, y DeepSeek lleva meses con licencia MIT.
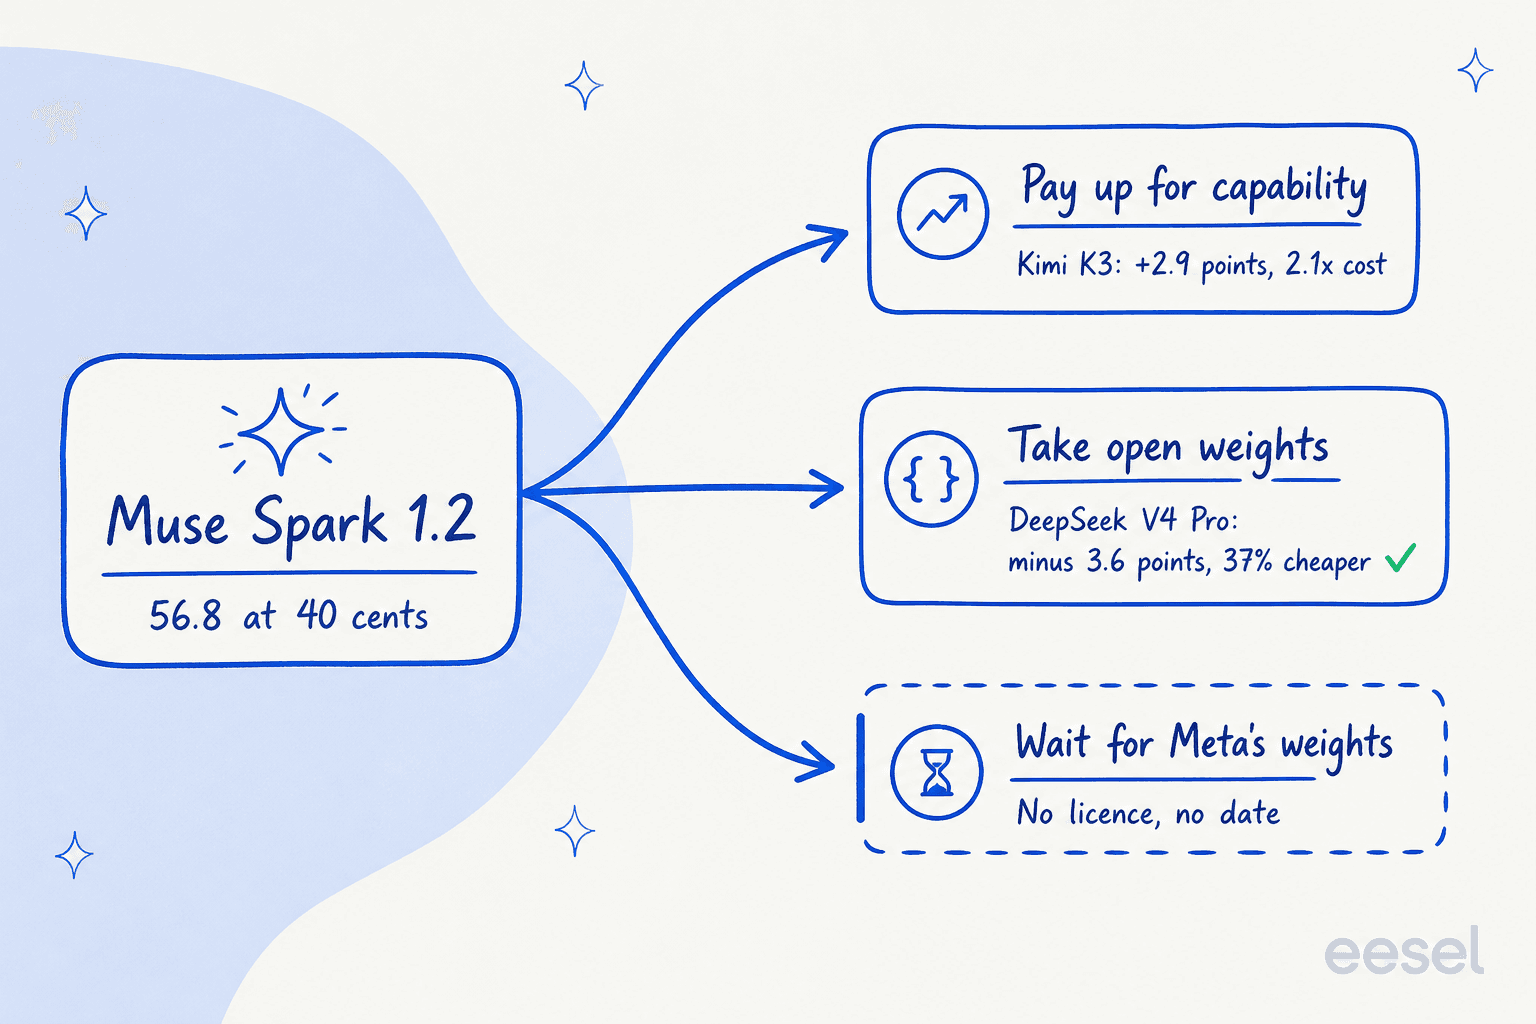
Eso divide tus opciones con bastante claridad. Paga más por un salto real de capacidad, o renuncia a puntos del índice por pesos que de verdad son tuyos. Lo que no existe es la opción que da las dos cosas por menos. Más abajo clasifico 8 alternativas con los números reales.
Una advertencia antes de que dediques una semana a esto. Si el modelo que eliges va a responder tickets de soporte, el modelo en sí rara vez es el cuello de botella. Un equipo con el que trabajé tenía una IA que decía con total seguridad a los clientes "sí, soportamos el modelo de tu coche" para marcas que ni siquiera estaban en su base de datos, y era porque su centro de ayuda decía "soportamos todos los modelos". Ninguna puntuación de índice arregla esa frase. La recuperación sí.
Por qué la gente mira más allá de Muse Spark 1.2
En eesel construyo integraciones y la infraestructura de APIs, así que con cada lanzamiento de modelo mi instinto es saltarme el post de lanzamiento e ir a leer la tarifa, los límites de uso y luego la página del modelo. Muse Spark 1.2 es interesante por una razón concreta: aquí el marketing y los datos discrepan en la dirección contraria a la habitual. El planteamiento del lanzamiento subestimó dónde quedó en precio-rendimiento y exageró lo que llegarías a poseer.
Hay tres cosas que de verdad empujan a la gente a buscar otra cosa.
Los pesos son una promesa, no una descarga. El Chief AI Officer de Meta dijo que una versión de pesos abiertos llegaría "pronto". La organización verificada de Meta en Hugging Face muestra ahora mismo cuatro repositorios, y los cuatro son de Muse Glimmer. Si buscas Muse-Spark en Hugging Face, no obtienes ningún resultado, de nadie.
Nadie puede verificar el modelo de forma independiente. Para la mayor parte del ranking, Artificial Analysis publica velocidad de salida y latencia. Para Muse Spark 1.2 esos dos campos están en blanco. Muse Glimmer está en la misma tabla y los tiene. Puedes ponerle precio a este modelo, pero no puedes medir lo rápido que responde.
El nivel barato te cuesta tu tráfico. El ID muse-spark-1.2-contributor es 12,5 veces más barato en entrada, y la propia documentación de Meta lo describe como precio con descuento a cambio del permiso para entrenar con tus prompts y tus respuestas. Las cuentas de ese intercambio ya las cubrí en el desglose de precios de Muse Spark 1.2.
Cuatro días antes del anuncio de Meta, un comentarista de Hacker News defendió el caso de los pesos mejor que la propia publicación de Meta:
"Meta, please go back to publishing weights. Your models aren't top-tier, this wouldn't hurt you at all at your current position in the rankings. They wouldn't have the best open-weight models, but the best western open-weight models."

Meta hizo exactamente eso cuatro días después, pero con un modelo alumno de 30B. El modelo de frontera recibió un adjetivo.
Cómo elegí estos 8
Clasifiqué según tres criterios, en este orden.
Puntuación independiente, no gráficos del proveedor. Cada cifra del índice en esta página es del Artificial Analysis Intelligence Index v4.1.1. Ejecuta nueve evaluaciones, así que ningún laboratorio elige su propio conjunto de comparación. Eso importa aquí, porque los gráficos del lanzamiento de Muse Spark 1.2 cambiaron el arnés de agente entre versiones.
Coste por tarea, no precio de lista. La verbosidad es lo que ocultan las tarifas por millón de tokens. Muse Spark 1.2 gasta 30.430 tokens de salida en cada tarea del índice, así que el coste real queda bastante por encima de lo que sugiere el 1,25 $ del titular. El coste por tarea es la cifra que sobrevive al contacto con una factura real.
Si existen los pesos. Para cada modelo de la lista fui a comprobar el campo de licencia en el repositorio real, en lugar de fiarme de una nota de prensa. Dos de los ocho resultaron tener una licencia distinta de la que suele atribuírseles.
Dejé fuera un nombre obvio. No hay ningún modelo de eesel en esta lista, porque eesel no es un proveedor de modelos, y meter a mi propio empleador en una tabla de benchmarks sería justo lo que hace inútiles estos artículos.
La tabla comparativa
Las puntuaciones del índice y el coste por tarea vienen del ranking de modelos de Artificial Analysis, consultado el 18 de agosto de 2026. Las tarifas por token vienen de la página de precios de cada proveedor, consultada el mismo día.
| Modelo | Índice | Coste / tarea | Entrada /1M | Salida /1M | Contexto | Pesos | Licencia | Ideal para |
|---|---|---|---|---|---|---|---|---|
| Claude Opus 5 | 63.05 | $2.3369 | $5.00 | $25.00 | 1M | No | Propietaria | El techo más alto del ranking |
| GPT-5.6 Sol | 60.93 | $1.2312 | $5.00 | $30.00 | 1.05M | No | Propietaria | Trabajo de frontera con herramientas de OpenAI |
| Grok 4.6 | 60.92 | $0.8367 | varía | varía | 2M | No | Propietaria | Casi frontera a coste medio |
| Kimi K3 | 59.70 | $0.8375 | $3.00 | $15.00 | 1.05M | Sí | Kimi K3 License | Pesos abiertos que de verdad superan a Muse Spark |
| Qwen3.8 Max | 58.08 | $1.1320 | $2.00 | $6.00 | 1M | Solo la base | qwen3.8-max | Potencia alojada con una alternativa abierta |
| Muse Spark 1.2 | 56.76 | $0.3992 | $1.25 | $4.25 | 1.05M | No | Propietaria | El modelo establecido del que hablamos |
| GPT-5.6 Terra | 56.58 | $0.5080 | $2.00 | $12.00 | 1.05M | No | Propietaria | Cambio equivalente con mejores herramientas |
| Gemini 3.7 Flash | 56.03 | $0.4022 | $0.75 | $3.75 | 1.05M | No | Propietaria | Velocidad a un coste casi idéntico |
| DeepSeek V4 Pro | 53.20 | $0.2521 | $0.66 | $1.98 | 1M | Sí | MIT | La licencia permisiva más barata de aquí |
| GPT-5.6 Luna | 52.32 | $0.0471 | $0.20 | $1.20 | 1.05M | No | Propietaria | El suelo de precio de los modelos alojados |
| Muse Glimmer 30B | 35.06 | $0.0732 | local | local | 131K | Sí | Apache 2.0 | Ejecutar un modelo de Meta en tu propia GPU |
Las tarifas de DeepSeek mostradas aquí son las de fuera de hora punta. Las tarifas de Gemini mostradas son introductorias, hasta el 31 de diciembre de 2026.
Si representas coste frente a capacidad, la forma de la decisión se ve mucho más fácil.
Elige tu ruta de escape
En lugar de leer los ocho, responde la única pregunta que de verdad divide el campo.
¿Qué necesitas realmente que Muse Spark 1.2 no te da?
Elige una. Cada respuesta te cuesta algo, y se muestra la cifra.
Lidera el Intelligence Index con 63,05, es decir, 6,29 puntos por delante de Muse Spark 1.2. Ofrece el contexto completo de 1M a precio estándar, sin recargo por contexto largo.
El coste: 2,3369 $ por tarea frente a 0,3992 $. Pagas 5,9 veces más por una mejora de capacidad de aproximadamente un 11 %.
59,70 en el índice, y el único modelo de pesos abiertos del ranking de 20 filas que supera a Muse Spark 1.2. Los pesos salieron el día que Moonshot dijo que saldrían.
El coste: 0,8375 $ por tarea, es decir, 2,1 veces el coste por 2,94 puntos del índice. La licencia es propia, no MIT.
Licencia MIT sin términos especiales, 53,20 en el índice y la opción creíble más barata por tarea, con 0,2521 $. Existen 662 repositorios de la comunidad, 316 de ellos cuantizados.
El coste: 3,56 puntos del índice por debajo de Muse Spark 1.2, y la tarifa se duplica en horas punta UTC.
El modelo Apache 2.0 de Meta, destilado de Muse Spark, que ocupa menos de 20 GB a unos 4 bits. Es el modelo de Meta que de verdad puedes descargar hoy.
El coste: 35,06 en el índice, es decir, 21,70 puntos por debajo de Muse Spark 1.2. Un agente local capaz, no un sustituto de frontera.
1. Claude Opus 5
Ideal para: equipos donde una respuesta equivocada cuesta más que la factura de la API.
El modelo estrella de Anthropic ocupa lo más alto del ranking con 63,05. Es también el único modelo de aquí donde la diferencia con Muse Spark 1.2 es lo bastante grande como para notarla sin ningún arnés de benchmarks.
Dónde supera a Muse Spark 1.2. Seis puntos del índice, y en la práctica se nota en las tareas largas de varios pasos, aquellas donde un error temprano se acumula. Además ofrece el contexto completo de 1M a precio estándar, y Anthropic afirma con claridad que una solicitud de 900k tokens se factura a la misma tarifa por token que una de 9k. Ni OpenAI ni xAI hacen eso.
Dónde no. El coste, y por un margen amplio. Luego lo que la mayor parte de la cobertura pasa por alto: la tasa de alucinación AA-Omniscience de Opus 5 subió 14 puntos hasta el 50 %. Una puntuación de índice más alta no es lo mismo que un modelo más veraz.
Precios. 5,00 $ de entrada, 0,50 $ de lectura de caché, 25,00 $ de salida por millón. Batch cuesta la mitad. Las escrituras de caché cuestan 6,25 $ con TTL de 5 minutos. Si ese techo es más de lo que necesitas, Claude Sonnet 5 cuesta ahora de forma permanente 2,00 $ y 10,00 $, después de que Anthropic cancelara el aumento previsto para el 1 de septiembre.
Veredicto: la elección adecuada cuando un error es caro y la factura de tokens no. Descártalo si haces clasificación de alto volumen, porque ahí pagarías 5,9 veces más por tarea por una capacidad que la tarea nunca usa.
2. Kimi K3
Ideal para: cualquiera cuyo requisito real sea "pesos abiertos, y mejor que lo que tengo".
El modelo estrella de Moonshot es la entrada más interesante de esta lista, y la razón es que es el único modelo que cumple las dos mitades de lo que la gente dice querer de Meta. Puntúa 59,70, por encima de Muse Spark 1.2, y los pesos se pueden descargar ahora mismo, hoy.
Dónde supera a Muse Spark 1.2. Casi tres puntos del índice, y además 2,8 billones de parámetros que puedes alojar tú mismo. Lo que merece una pausa es esto: el blog técnico de Moonshot dijo que los pesos se publicarían antes del 27 de julio de 2026, y el primer commit público en Hugging Face es del 27 de julio de 2026. Una fecha concreta, cumplida al día.
Dónde no. Dos cosas. El coste por tarea es 0,8375 $, es decir, más del doble. Luego la licencia, que no es lo que dicen la mayoría de los análisis: los metadatos del propio repositorio dicen license: other con license_name: "kimi-k3", una licencia propia de Moonshot. Pesos abiertos, sí. Código abierto permisivo, no. Su Openness Index es 38,89, por debajo del 44,44 de Muse Glimmer.
Precios. 3,00 $ de entrada, 0,30 $ de acierto de caché, 15,00 $ de salida por millón, así que territorio Claude Sonnet y no territorio económico. Mi reseña completa de Kimi K3 analiza el comportamiento del esfuerzo de razonamiento, que no se puede desactivar en ningún nivel.
Veredicto: la respuesta por defecto para quien esperaba los pesos de Meta. Pagas más o menos el doble por tarea y lees con cuidado la licencia antes de lanzar, pero existe hoy y es claramente mejor.
3. Qwen3.8 Max
Ideal para: equipos que quieren un modelo alojado ahora y una alternativa autoalojada después.
El modelo estrella de Alibaba puntúa 58,08 alojado, y en esta entrada mi propia investigación me corrigió a mitad del borrador. A principios de este mes los pesos de Qwen 3.8 estaban prometidos y sin publicar, justo en la posición en la que está ahora Muse Spark 1.2. Luego salieron el 9 de agosto.
Dónde supera a Muse Spark 1.2. 1,32 puntos del índice alojado, mientras que la base abierta Qwen3.8-2.4T-A95B por sí sola sigue puntuando 57,70. Es decir, incluso la versión descargable supera al modelo que estás pensando dejar.
Dónde no. El coste por tarea es 1,1320 $, casi el triple. La versión abierta tampoco equivale en funciones al producto alojado: la propia ficha del modelo de Qwen indica que Max alojado añade entrada de visión, soporte sin razonamiento, contexto de 1M por defecto y herramientas integradas. Y la licencia vuelve a ser propia, qwen3.8-max, no Apache.
Precios. 2,00 $ de entrada, 0,25 $ de lectura de caché implícita, 6,00 $ de salida por millón. La lectura de caché explícita es más barata, 0,17 $, pero crearla cuesta 2,50 $ por millón, así que solo compensa con prefijos que repites mucho. Las rutas de acceso prácticas las puse en cómo acceder a Qwen3.8 Max.
Veredicto: la mejor cobertura de esta lista, porque puedes empezar alojado y luego pasar a tu propio hardware sin cambiar de familia de modelos. La reseña de Qwen3.8 Max incluye las cifras de preferencia humana, que apuntan en una dirección más amable que el índice automatizado.
4. GPT-5.6 Terra
Ideal para: un cambio equivalente donde las herramientas de alrededor importan más que la puntuación.
El modelo de gama media de OpenAI queda en 56,58, es decir, 0,18 puntos por debajo de Muse Spark 1.2. A efectos prácticos los dos modelos tienen la misma capacidad a distinto precio, y por eso la publicación de lanzamiento de Meta comparó con Terra y no con GPT-5.6 Sol. Un comentarista lo notó en su momento:
"They chose to compare against Open AI's mid tier model Terra instead of Sol and still lost some benchmark against it. They left Opus in and got beat in all but one benchmark. Nothing wrong with trying to improve, but why the marketing games?"
Dónde supera a Muse Spark 1.2. Sobre todo en el ecosistema. Terra funciona dentro de las herramientas que tu equipo probablemente ya usa, y OpenAI publica cifras de velocidad y latencia que Meta no publica.
Dónde no. Es un 27 % más caro por tarea, por una puntuación marginalmente menor. También tiene un precipicio de contexto largo: los prompts de más de 272K tokens de entrada se cobran a 2x en entrada y 1,5x en salida en toda la solicitud, no solo en el exceso, según la página del modelo de OpenAI. Muse Spark 1.2 no tiene ningún recargo por contexto largo.
Precios. 2,00 $ de entrada, 0,20 $ en caché, 12,00 $ de salida por millón, y eso antes del multiplicador de contexto largo. Dónde exactamente muerde ese precipicio lo cubre el desglose de precios de GPT-5.6.
Veredicto: cambia por las herramientas y por las cifras de latencia publicadas, no por la capacidad. Si tus prompts superan con frecuencia los 272K tokens, haz las cuentas antes de migrar.
5. Gemini 3.7 Flash
Ideal para: cargas de trabajo de alto volumen donde el rendimiento es la restricción.
La línea Flash de Google puntúa 56,03 a 0,4022 $ la tarea, lo que la deja dentro de un error de redondeo de Muse Spark 1.2 en ambos ejes. La diferencia es que Google publica lo rápido que es. Artificial Analysis lo mide en 340,1 tokens por segundo, el primero de 188 modelos medidos.
Dónde supera a Muse Spark 1.2. Velocidad medida, además de una tarifa de lista más barata, 0,75 $ de entrada. Es el único modelo de aquí donde también puedes bajar la capacidad a propósito: con esfuerzo low puntúa 50,9 a 0,16 $ la tarea, y para clasificación suele ser lo correcto.
Dónde no. Hay dos salvedades reales. La tarifa actual es introductoria hasta el 31 de diciembre de 2026 y se duplica a 1,50 $ y 7,50 $ el 1 de enero de 2027, así que cualquier modelo de costes que montes hoy tiene un precipicio dentro. Su tasa de alucinación también empeoró hasta el 64,5 % desde el 55,6 % de la versión anterior, algo que analicé en la reseña de Gemini 3.7 Flash.
Precios. 0,75 $ de entrada, 0,075 $ en caché, 3,75 $ de salida por millón hasta finales de 2026. La salida máxima es de 65.536 tokens, notablemente más ajustada que el resto de esta lista.
Veredicto: la mejor elección si la latencia es la queja real que tienes con Muse Spark 1.2, dado que ni siquiera puedes medir la de Meta. Presupuesta ya el cambio de precio de enero, en lugar de sorprenderte después.
6. DeepSeek V4 Pro y V4 Flash
Ideal para: los pesos más baratos con los que puedes hacer lo que quieras.
Esta es la entrada que gana por licencia y no por puntuación. V4 Pro puntúa 53,20 a 0,2521 $ la tarea, y tanto él como DeepSeek V4 Flash llevan una licencia mit sencilla en los metadatos del repositorio. Sin términos especiales. Tampoco una política de uso al lado.
Dónde supera a Muse Spark 1.2. Precio y libertad. Es un 37 % más barato por tarea, tiene licencia MIT y cuenta con el ecosistema de comunidad más profundo de toda la comparación: una búsqueda devuelve 662 repositorios, 316 de ellos cuantizados. Ese ecosistema es lo que hace realista el autoalojamiento en lugar de teórico.
Dónde no. Cede 3,56 puntos del índice. También hay una rareza que conviene planificar: DeepSeek cobra el doble en hora punta, definida como de 01:00 a 04:00 y de 06:00 a 10:00 UTC. Una cola de soporte europea toca esa ventana a diario; una estadounidense casi nunca. En cuanto a política de datos, los términos de la API de pago de DeepSeek callan sobre el uso para entrenamiento en lugar de permitirlo, y la infraestructura está bajo la ley de la RPC.
Precios. V4 Pro cuesta 0,66 $ de entrada y 1,98 $ de salida en hora valle, y se duplica en hora punta. V4 Flash es mucho más barato, 0,22 $ y 0,66 $ en hora valle, y puntúa 51,77. La aritmética de la hora punta se explica con detalle en el post de precios de DeepSeek V4 Flash.
Veredicto: si tu requisito es "pesos MIT, baratos", esta es la respuesta y nada más de la lista compite. Si la carga de trabajo toca datos regulados de clientes, la residencia de datos es lo primero que hay que resolver.
7. GPT-5.6 Luna
Ideal para: el trabajo de volumen que nunca deberías haber ejecutado en un modelo de frontera.
Luna puntúa 52,32 a 0,0471 $ la tarea. Eso es 8,5 veces más barato que Muse Spark 1.2 por el 92 % de la puntuación del índice, y es la cifra de aquí que debería hacer replantearse toda su configuración a cualquiera que haga clasificación masiva.
Dónde supera a Muse Spark 1.2. Coste, y de forma drástica. La mayoría de las cargas de producción no tienen forma de frontera: etiquetado y enrutado, extracción y resumen rara vez necesitan 56 puntos de índice. Luna está totalmente alojado y con latencia publicada, algo que el modelo de Meta no tiene.
Dónde no. Está 4,44 puntos por debajo, y esa diferencia se nota en cualquier cosa realmente de varios pasos. Un caballo de batalla, no un razonador.
Precios. 0,20 $ de entrada, 0,02 $ en caché, 1,20 $ de salida por millón, y con el mismo multiplicador de contexto largo >272K que lleva el resto de la familia GPT-5.6.
Veredicto: la línea más infravalorada de la tabla. Antes de migrarlo todo a un modelo más caro, divide tu tráfico y comprueba cuánto de él necesita realmente el modelo caro.
8. Muse Glimmer 30B
Ideal para: ejecutar un modelo de Meta en hardware propio, hoy.
Si llegaste aquí porque querías pesos de Meta, esto es lo que existe de verdad. Glimmer tiene 29,78 mil millones de parámetros bajo Apache 2.0, destilado de Muse Spark, con un contexto de 131.072 tokens y fecha de corte de conocimiento de enero de 2026.
Dónde supera a Muse Spark 1.2. Puedes descargarlo. Meta cuantiza a unos 4 bits, lo que deja el modelo de lenguaje por debajo de 20 GB y cabe en una tarjeta de 24 GB. El coste por tarea es 0,0732 $, y es el único modelo de Meta con un Openness Index, de 44,44. La respuesta de la comunidad fue inmediata: ya existen 296 repositorios de Glimmer, y la versión GGUF de unsloth, con 755.125 descargas, supera al propio repositorio de pesos de Meta.
Dónde no. 35,06 frente a 56,76 es una diferencia de 21,70 puntos, y ninguna comodidad local la cierra. También hay una nota al pie de licencia que conviene conocer: junto al texto real de Apache 2.0, el repositorio incluye un USAGE_POLICY.md redactado por Meta que restringe el uso por menores y prohíbe aplicaciones militares, de armas y de infraestructura crítica. Apache 2.0 no impone ninguno de esos términos, así que la superficie práctica aquí es Apache más un documento de política.
Precios. Descarga gratuita, y después tu propio cómputo. Un desarrollador que lo ejecutaba en un Mac mini de 32 GB fue sincero sobre lo que eso significa en la práctica:
"I am getting good results with muse-glimmer running locally, with the caveat that everything runs slowly (e.g., give it a task and then go walk outside or do Qi Gong exercises for a while)."
Veredicto: un muy buen modelo de agente local y un mal sustituto de Muse Spark. Trátalo como una herramienta distinta, no como un camino de degradación.
Qué dice realmente la comunidad
La opinión sobre Muse Spark 1.2 se divide con claridad en una sola línea. Quienes leyeron los benchmarks atacan su posición; quienes lo usaron elogian lo pocos tokens que desperdicia. Ambos tienen razón, y por eso la reacción al lanzamiento parece tan contradictoria.
La lectura escéptica más afilada llegó el día del lanzamiento:
"Somewhat surprised that Meta with all their resources couldn't make a model that matches Composer on any frontier. All the Sparks are dominated by some other model everywhere along the frontier. The use traces must be crucial to functionality which is why they're keeping prices so low."
Dos semanas de medición independiente han respondido en parte a esto. En el ranking actual de Artificial Analysis, Muse Spark 1.2 no está dominado en precio-rendimiento en absoluto; está en la frontera en su propio punto de coste. La segunda mitad del comentario, la del precio como jugada de adquisición de datos, se sostiene mucho mejor.
Sobre los pesos, la objeción no es realmente sobre este anuncio. Es sobre el anterior:
"Meta in this case, started nicely with Llama, then switched to closed models, kicked out researchers to build data labeler CEO empire inside Meta. Now opening again, what's next? closing again?"
Y la postura que vi con más frecuencia no era "cambia" ni "quédate". Era quedarse con el artefacto abierto y rechazar el producto alojado:
"I'd also argue this is the case for any company releasing open weights. They're not righteous, they're marketing. That's not necessarily a bad thing! [...] I still will not use a hosted Meta product, but damn this model looks solid."
Para equilibrar: la voz positiva más fuerte sobre el anuncio fue el CEO de Box, y lo leyó como un cambio de categoría más que como un lanzamiento de producto:
"Meta releasing Muse Spark 1.2 as open weights is a very big deal. America now finally has its response to the open weights AI race."
Esa reacción fue a la promesa, sin embargo. Ocho días después la descarga sigue sin existir.
Lo que ninguno de estos cambios arregla
Esta es la parte que más me importa, porque paso mi vida laboral en la capa que hay debajo de estos modelos.
Si estás eligiendo entre los ocho para una carga general de programación o investigación, la tabla de arriba es casi todo lo que necesitas. Pero buena parte de quienes buscan alternativas a Muse Spark 1.2 intentan arreglar una automatización de soporte que da respuestas equivocadas, y un cambio de modelo casi nunca es la solución para eso.
El ejemplo con el que empecé es el más claro que conozco. Un equipo de soporte técnico B2B tenía una IA que decía con seguridad a los clientes "sí, soportamos el modelo de tu coche" para marcas de vehículos que no estaban en su base de datos. El modelo no estaba roto. Su centro de ayuda decía "soportamos todos los modelos", la IA recuperó esa frase y luego respondió correctamente a partir del texto que le habían dado. Pasar de un modelo de 56,8 a uno de 63,1 no cambia nada de ese resultado, porque el fallo ocurrió en la recuperación y no en el razonamiento.
Puedes ver lo mismo en los datos de benchmarks. La precisión AA-Omniscience de Muse Spark 1.2 de hecho cayó respecto a 1.1, del 52,0 % al 45,4 %, mientras que la tasa de alucinación mejoró del 50,0 % al 33,3 %. No se volvió más sabio. Mejoró en declinar. Para un asistente general es un intercambio razonable, y para un agente de soporte es malo, porque ahí una respuesta declinada sigue siendo un ticket.
Hay tres cosas que mueven la precisión del soporte más que el modelo:
- Lo que la IA puede ver. Los tickets resueltos del pasado, y no solo los artículos del centro de ayuda. La mayoría de las herramientas entrenan solo con la documentación publicada, que es exactamente la razón por la que te repiten "soportamos todos los modelos".
- Lo que hace cuando no está segura. Enrutado basado en confianza hacia un borrador en lugar de una respuesta en vivo, de modo que una respuesta de baja confianza se convierta en una escalación en lugar de un error de cara al cliente.
- Si lo probaste antes que tus clientes. Simular contra tus propios tickets históricos es lo que te dice la tasa de resolución real. Una puntuación pública de índice solo te dice la de otro.
Profundizo en todo esto en modelos de IA para soporte, y en el patrón de fallo en sí en alucinaciones de IA en soporte.
Prueba eesel para el trabajo de soporte
Si has llegado a una comparación de modelos porque tu IA de soporte sigue respondiendo mal, entonces el nivel del modelo es el mando equivocado. eesel es un compañero de equipo con IA que se conecta a Zendesk, Freshdesk, Gorgias, HubSpot o Front, y aprende de tu historial de tickets resueltos desde el primer día, no solo de tu base de conocimiento pública.
Lo que importa para todo lo anterior: antes de tocar a un solo cliente, lo ejecutas en simulación sobre tus propios tickets pasados y ves la tasa de resolución real, desglosada por tema. Gridwise vio el 73 % de las solicitudes de nivel 1 resueltas durante el primer mes. La facturación es un crédito por ticket (los planes empiezan en 299 $ al mes por 500 créditos), y no por millón de tokens que no puedes prever, así que la aritmética de hora punta y de contexto largo de esta página deja de ser tu problema.

Pruébalo gratis, sin tarjeta, y en un día sabrás si el modelo fue alguna vez tu problema. Prueba eesel.
Entonces, cuál deberías elegir
Si te llevas una sola cosa de esta página, que sea esta: Muse Spark 1.2 no es un mal trato en capacidad por dólar, y cambiar solo por la puntuación te costará más de lo que te da.
Vete, en cambio, por una razón concreta. Si una respuesta equivocada es cara, Claude Opus 5 te compra la mayor diferencia real. Si lo que necesitas son pesos que superen lo que tienes hoy, Kimi K3 es el único modelo que hace ambas cosas, a aproximadamente el doble del coste por tarea. Si el requisito es específicamente MIT, DeepSeek es la respuesta y la licencia ahí es limpia. Y si la queja es la velocidad, Gemini 3.7 Flash es el único de los dos cuya velocidad alguien ha publicado.
Y si sigues esperando los pesos de Meta, vale la pena recordar el balance. Moonshot dio una fecha y la cumplió. Alibaba publicó en menos de una semana. DeepSeek ha sido MIT todo el tiempo. Meta publicó el modelo alumno y un adjetivo.
Preguntas frecuentes
¿Cuáles son las mejores alternativas a Meta Muse Spark 1.2?
¿Muse Spark 1.2 es de código abierto?
muse-spark-1.2 es un modelo propietario de API sin pesos publicados. Meta anunció el 10 de agosto que pronto llegaría una versión de pesos abiertos, sin indicar licencia ni fecha, y desde entonces no se ha publicado nada. El modelo de Meta que sí es abierto es Muse Glimmer 30B, bajo Apache 2.0. Para ver el panorama general, consulta mi resumen de agentes de IA de código abierto.¿Cómo se compara el precio de Muse Spark 1.2 con las alternativas?
muse-spark-1.2 cuesta 1,25 $ por millón de tokens de entrada y 4,25 $ de salida, lo que equivale a 0,3992 $ por tarea del Intelligence Index. Eso es más barato por tarea que los precios de Kimi K3, con 0,8375 $, y más barato que Claude Opus 5, con 2,3369 $. El desglose completo de los precios de Muse Spark 1.2 está en mi análisis de precios.¿Qué modelo de pesos abiertos se acerca más a Muse Spark 1.2?
¿Debería dejar Muse Spark 1.2 para un caso de atención al cliente?
¿Qué es Muse Glimmer 30B y puede reemplazar a Muse Spark 1.2?
¿Muse Spark 1.2 tiene nivel gratuito?
muse-spark-1.2-contributor cuesta 0,10 $ de entrada y 0,20 $ de salida a cambio de que Meta use tu tráfico para entrenar modelos futuros, y está limitado a 100 solicitudes por minuto. Si lo que buscas es una factura baja sin ese intercambio de datos, GPT-5.6 Luna, con 0,0471 $ por tarea, es la opción alojada más barata del ranking.