

¿Qué es Meta Muse Wonder?
Muse Wonder es la nueva serie de modelos de Meta Superintelligence Labs, y Meta llama al par "our most capable models" hasta la fecha. Se sitúa por encima de la línea de modelos Muse Spark 1.3 y es algo distinto de Meta Muse, el agente personal para consumidores que se lanzó en septiembre. Piensa en Wonder como el motor y en Muse como uno de los coches en los que pronto se instalará.
Yo construyo integraciones y APIs en eesel, así que leo las páginas de lanzamiento como leo la documentación de cualquier proveedor: qué puedo llamar realmente, a qué precio y con qué condiciones. Pasé la semana del lanzamiento en la documentación de modelos de Meta, la página de precios y límites de uso, la tabla de benchmarks y el hilo de Hacker News de 362 comentarios. Este análisis se basa en todo eso, no en una nota de prensa.
Esto es lo que lanza Meta, en una tabla:
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| ID del modelo | muse-wonder-1.0 | muse-wonder-full-1.0 |
| Dónde se consigue | Meta Model API, OpenRouter, todos los planes de Muse Code | Solo planes Power Usage y Maximum Usage de Muse Code |
| Ventana de contexto | 1.048.576 tokens | 1M de tokens |
| Tipos de entrada | Texto, imagen, vídeo, audio, PDF | No documentado por separado |
| Esfuerzo de razonamiento | "minimal" a "max" | Mostrado en max (xhigh en SWE-Marathon) |
| Precio | 4,00 $ entrada / 0,20 $ en caché / 20,00 $ salida por 1M de tokens | Incluido en un plan mensual de 50 $ o 200 $ |
| Estado | Preview | Solo por suscripción |
Dos detalles de la documentación de modelos importan más de lo que parece. Primero, Muse Wonder está etiquetado como preview. Segundo, Meta afirma que "setting reasoning effort to 'max' on Muse Wonder doesn't select" Wonder Full. No existe ningún parámetro de la API que desbloquee el modelo más grande.
Los benchmarks: dónde gana Wonder Full y dónde no
La página del modelo de Meta publica una tabla de 14 filas que compara ambos modelos Wonder con Claude Fable 5.1, GPT-6 Astra y Claude Opus 5.5, todos con razonamiento máximo. Conté el ganador resaltado en negrita de cada fila.
| Benchmark | Qué mide | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|---|
| Personal Superintelligence Index | Índice compuesto interno de Meta | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA | Trabajo de agentes legales | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | Investigación financiera | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | Consultas de salud abiertas | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | Flujos de trabajo empresariales de principio a fin | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | Trabajo profesional | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | Uso de herramientas profesionales | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1 (partial) | Uso del ordenador | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| MemoryBench | Recordar el contexto | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | Programación en terminal | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | Programación de largo recorrido | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | Ingeniería ultralarga | 57.5 (xhigh) | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | Programación desde cero | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| Artificial Analysis Index | Global | 56 | 52 | 53 | 53 | 58 |
El recuento: Wonder Full gana 6 filas, Opus 5.5 gana 6, GPT-6 Astra gana 1 y Muse Wonder a secas gana 1 (MemoryBench, por 0,1 puntos sobre su propio hermano mayor). Claude Fable 5.1 no gana ninguna.
Es un resultado real. Hace un año nadie contaba a Meta entre los laboratorios de frontera, y que Wonder Full supere a GPT-6 Astra en 11 de 14 filas es un gran salto. La cifra legal es la que más destaca: 13,1 en el benchmark de agentes legales de Harvey es baja en términos absolutos, pero es más de tres veces el 4,2 de Opus 5.5. Si sigues a Harvey AI, sabes lo duro que es ese benchmark para todos los modelos.
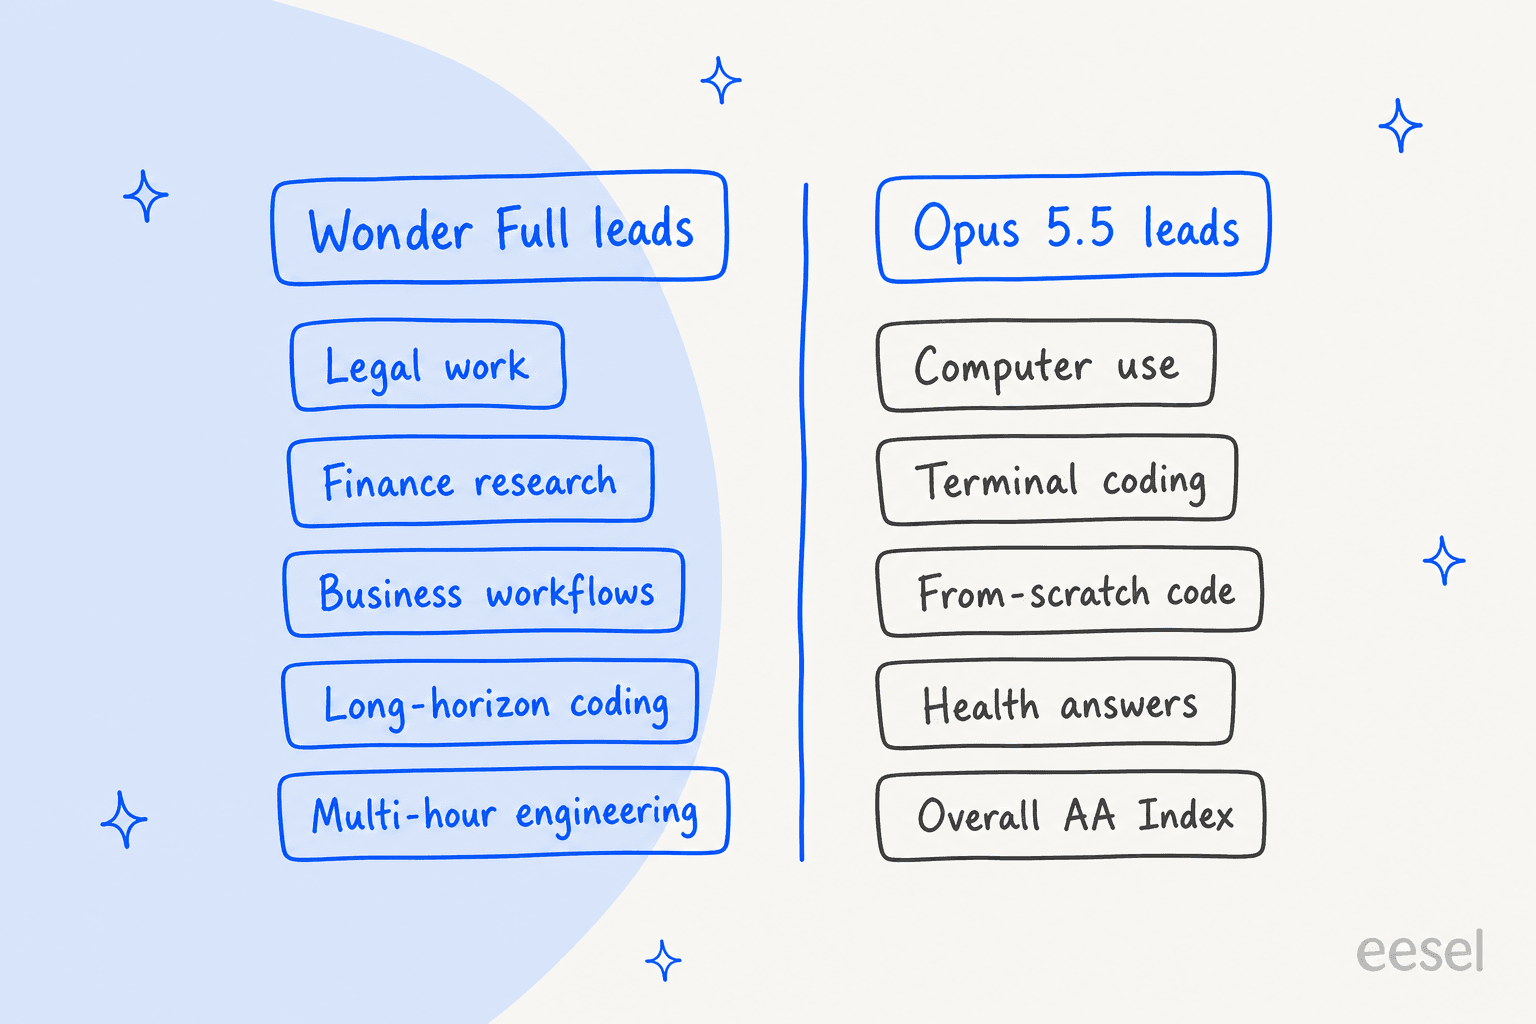
La división tiene una forma. Wonder Full gana cuando la tarea es larga y cargada de documentos: un trabajo legal, un informe de investigación financiera, un proyecto de programación de varias horas. Opus 5.5 sigue ganando cuando el modelo tiene que manejar un ordenador o escribir algo desde cero, y su ventaja en ProgramBench (70,5 frente a 59,0) es la brecha más amplia de toda la tabla. Una advertencia sobre el planteamiento de Meta: el Personal Superintelligence Index es un índice compuesto interno de Meta, así que le daría menos peso que a las filas de terceros.
El blog de lanzamiento de Meta también muestra el ranking independiente de Artificial Analysis a fecha del 12 de octubre, donde Wonder Full queda segundo.
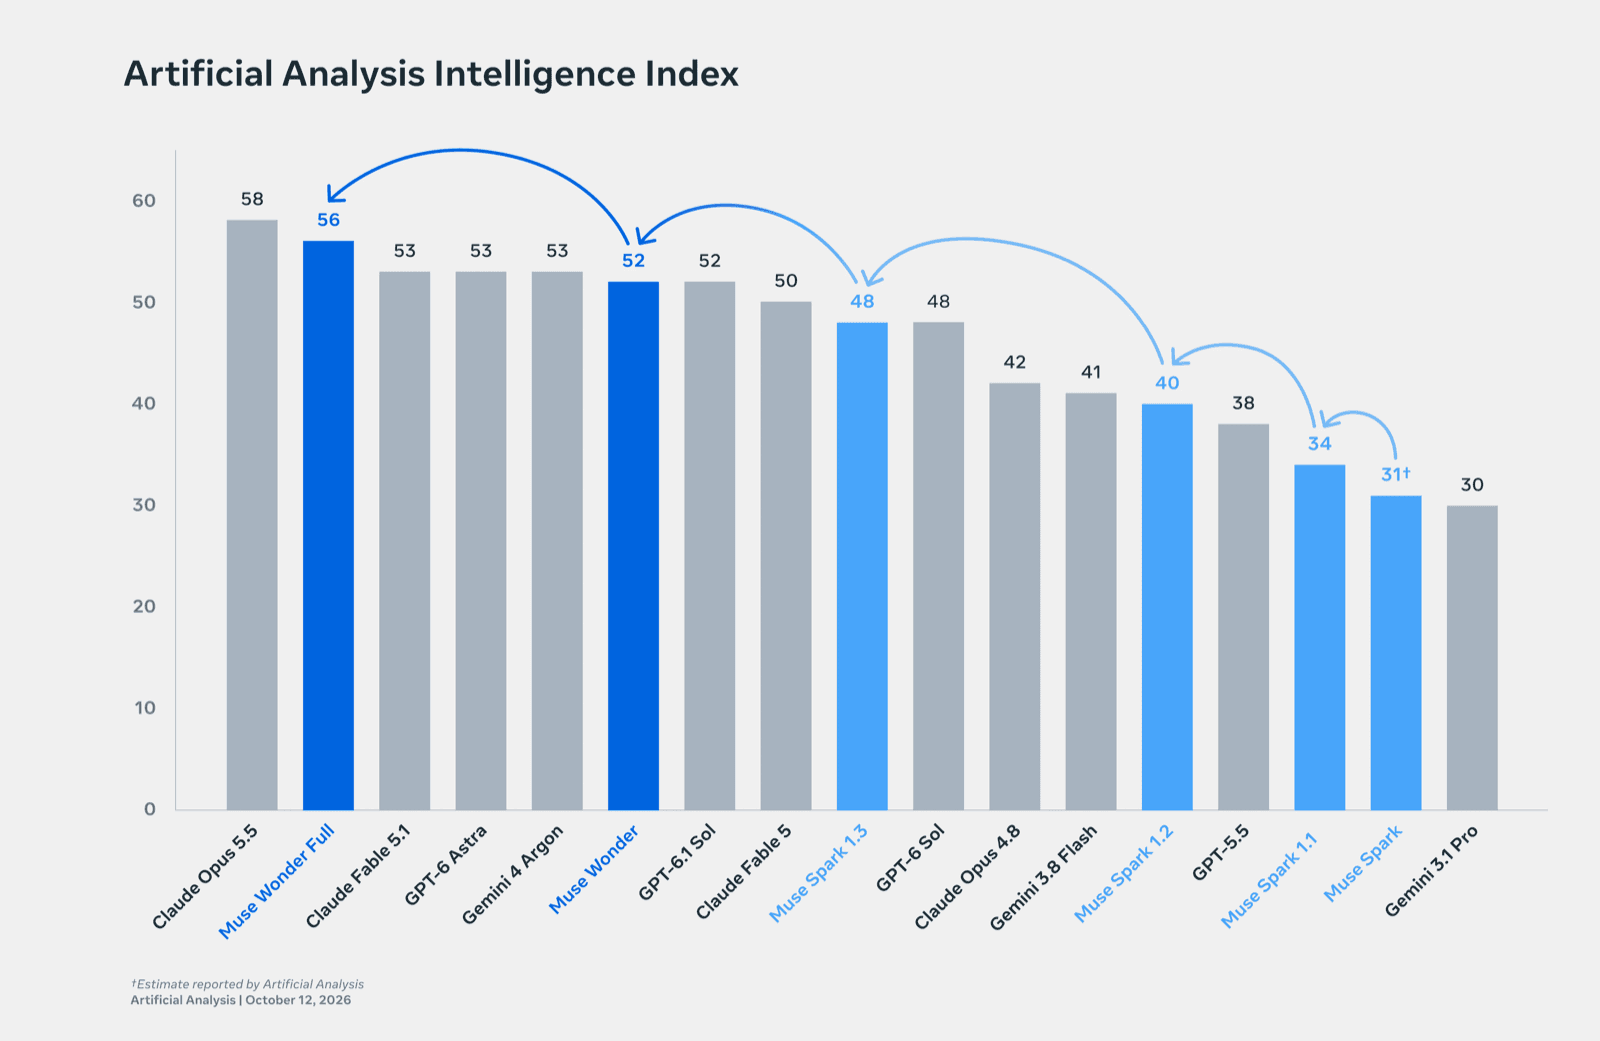
La reacción de HN a ese segundo puesto fue la que cabría esperar:
"2nd place model on aa according to them, losing only to opus 5.5 is really really not bad"

Las clasificaciones cambian rápido, eso sí. Más tarde ese mismo día, otro comentarista informó de que Wonder Full había caído al quinto puesto en el ranking en vivo, por detrás de Gemini 4 Argon. Trata cualquier captura de un ranking como una instantánea.
La trampa: el Wonder que puedes comprar no es el Wonder del gráfico
Esta es la parte que la mayor parte de la cobertura del lanzamiento pasa por alto. Mira otra vez el gráfico de AA: el modelo que puedes llamar desde la API obtiene 52. Eso está por debajo de Fable 5.1, GPT-6 Astra y Gemini 4 Argon (todos con 53), y al mismo nivel que GPT-6.1 Sol. Sigue siendo un modelo potente, unos cuatro puntos por encima de Muse Spark 1.3 en el mismo gráfico. Pero no es el que supera a Opus 5.5.
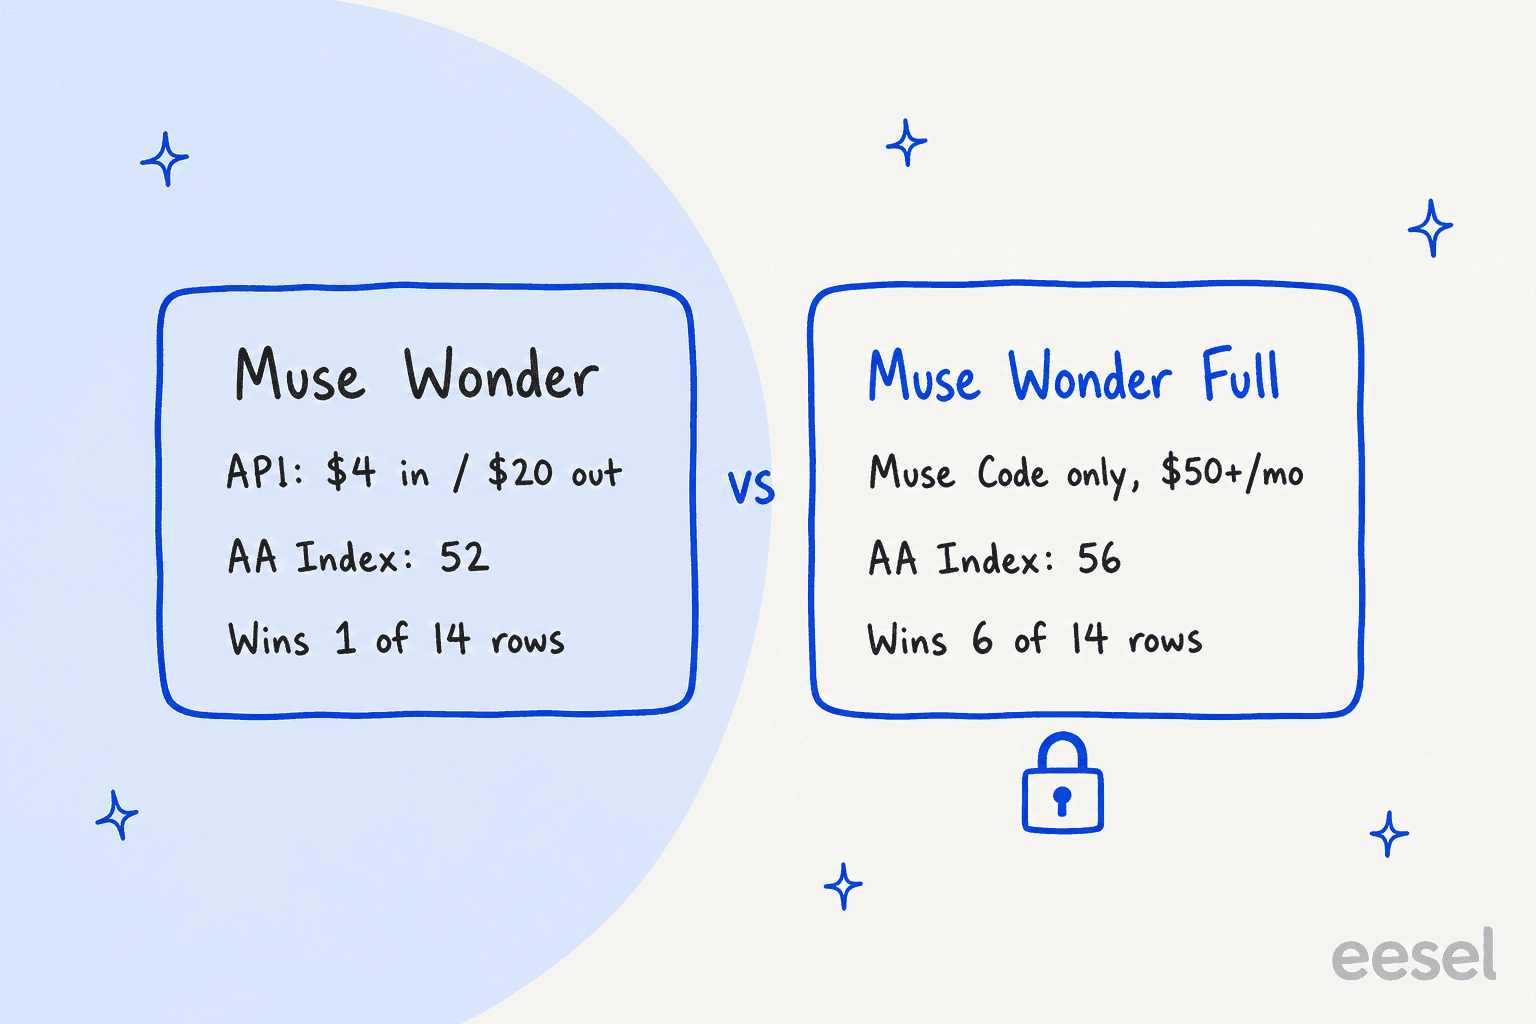
Un comentarista de HN lo detectó a las pocas horas del lanzamiento:
"Upon closer inspection, the benchmark scores for "Muse Wonder" on the main marketing page are actually for "Muse Wonder Full," which is only available on the higher-tier subscription plans. This pricing is for "Muse Wonder.""
Simon Willison enumeró los modelos que veía su clave de API, y muse-wonder-1.0 era el único Wonder de la lista. Así que, si eres un desarrollador que construye un producto, la decisión no es "Muse Wonder Full contra Opus 5.5". Es "Muse Wonder con 52 contra Opus 5.5 con 58, al mismo precio". Eso es más difícil de vender.
Precios de Muse Wonder
Los precios vienen en dos formas distintas que no se solapan.
Pago por uso en la Meta Model API (según la tarifa de Meta):
| Uso | Muse Wonder (modo Standard) | Modo Contributor |
|---|---|---|
| Entrada | 4,00 $ por 1M de tokens | No disponible |
| Entrada en caché | 0,20 $ por 1M de tokens | No disponible |
| Salida | 20,00 $ por 1M de tokens | No disponible |
| Búsqueda web con fuentes | 2,50 $ por 1.000 consultas | No disponible |
| Límite de uso | 3.000 solicitudes y 4M de tokens por minuto | No disponible |
Meta también afirma que no hay recargo por contexto largo y que los tokens de guía que inyecta en cada prompt no se facturan. Es una tarifa clara y justa. También es un gran cambio respecto al hábito pasado de Meta de ofrecer precios más bajos que todos. El precio de Muse Spark 1.3 es de 1,25 $/4,25 $, y su nivel Contributor baja a 0,10 $/0,20 $. Wonder no tiene ningún nivel con descuento en la API.
"$4/$20 in vs out making it higher than Sol and on par with Opus."
Así se compara con los rivales de la tabla de Meta, todos a tarifas estándar de API según la página de precios de cada proveedor:
| Modelo | Entrada por 1M | Entrada en caché por 1M | Salida por 1M |
|---|---|---|---|
| Muse Wonder | 4,00 $ | 0,20 $ | 20,00 $ |
| Claude Opus 5.5 | 4,00 $ | 0,20 $ | 20,00 $ |
| GPT-6 Astra | 10,00 $ | 1,00 $ | 50,00 $ |
| Claude Fable 5.1 | 10,00 $ | 0,25 $ | 50,00 $ |
| Muse Spark 1.3 | 1,25 $ | 0,15 $ | 4,25 $ |
Muse Wonder y Opus 5.5 cuestan lo mismo al céntimo, incluida la tarifa de caché. Introduce a continuación tu propio volumen mensual para ver la diferencia con los demás.
Las suscripciones de Muse Code, la única vía para llegar a Wonder Full, vienen en cuatro planes:
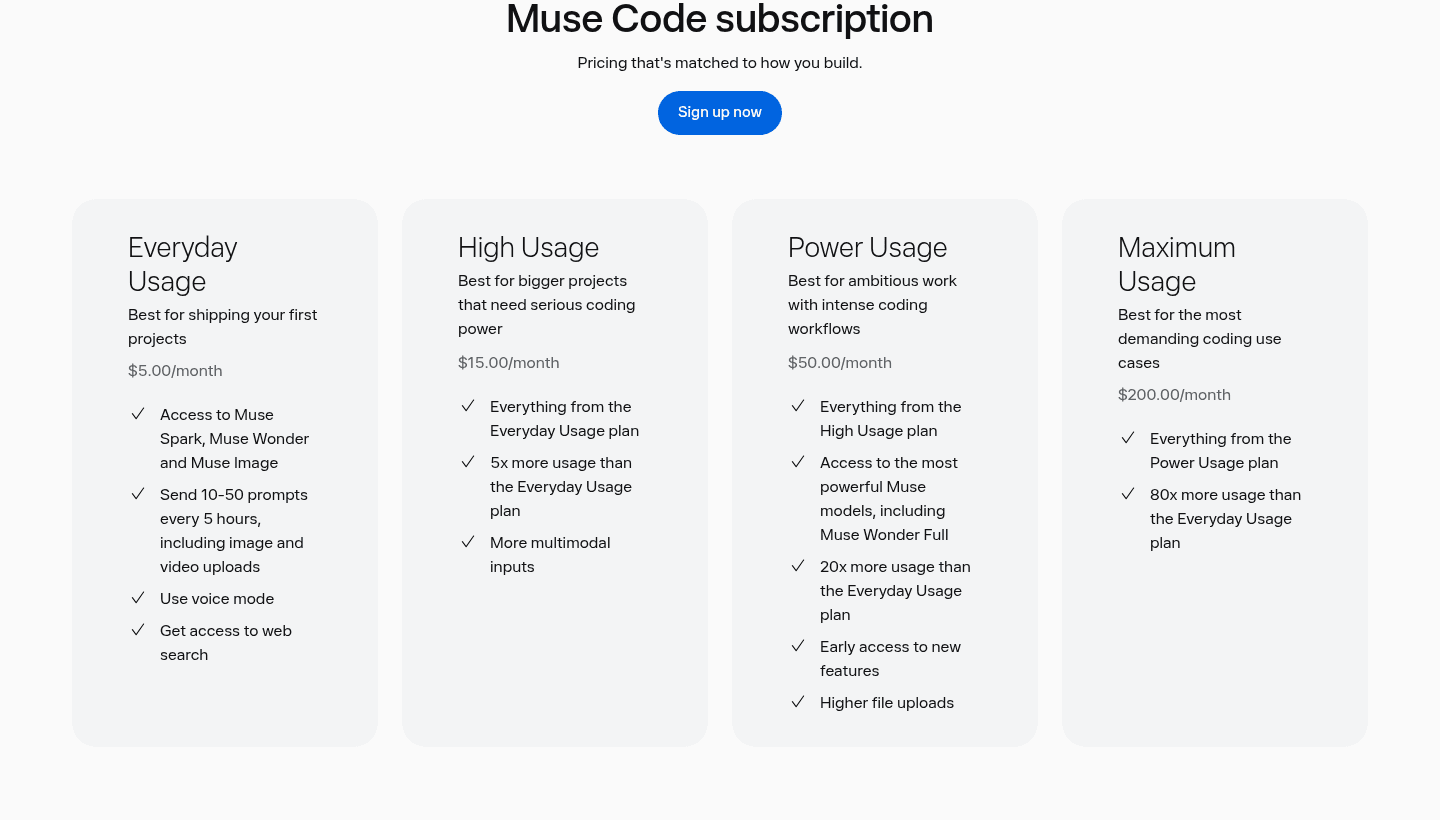
| Plan | Precio | Uso | Wonder | Wonder Full |
|---|---|---|---|---|
| Everyday Usage | 5 $/mes | 10-50 prompts cada 5 horas | Sí | No |
| High Usage | 15 $/mes | 5x Everyday | Sí | No |
| Power Usage | 50 $/mes | 20x Everyday | Sí | Sí |
| Maximum Usage | 200 $/mes | 80x Everyday | Sí | Sí |
Los precios proceden de la página de Muse Code; las reglas de los planes están en la documentación de suscripciones. Conviene leer la letra pequeña: hay que ser mayor de 18 años, la disponibilidad "may vary by region", no hay reembolsos al cancelar y Meta puede revocar una suscripción de inmediato por una infracción de las políticas. Además, una clave de suscripción solo funciona dentro de la CLI de Muse Code, así que no puedes dirigir el tráfico de tu aplicación a través de un plan de 50 $. Para ver el coste completo del propio agente de programación, consulta mi desglose de precios de Muse Code.
En el plan de entrada, un usuario temprano encontró los límites ajustados:
"The usage limits on their basic $5 code plan to try things out are ludicrously low?"
Contó que tres prompts cortos consumieron el 17 % de su asignación semanal. Como Wonder Full empieza en el nivel de 50 $ de todos modos, presupuestaría Power Usage si Full es la razón por la que estás aquí.
Active Memory y Active Focus: qué hay realmente de nuevo
Meta presenta Wonder en torno a dos capacidades con nombre. Active Memory consiste en "carrying important context about you across conversations and actively retrieving the details relevant to the task at hand." Active Focus es cómo el modelo sigue trabajando hacia un objetivo difícil: "trying alternative approaches, working through blockers, and adapting to new information", mientras pide aclaraciones y consulta "before taking important actions."
Ambas se corresponden con filas de la tabla. MemoryBench es el único lugar donde Wonder a secas gana de forma clara (85,6), y SWE-Marathon es donde la ventaja de Full es mayor (57,5 frente a 46,3 de Opus 5.5). Eso encaja con la documentación para desarrolladores de Meta, que recomienda Wonder para "long-running, complex tasks where capability matters more than cost per token, such as multi-file coding changes, multi-hour agent runs, and sub-agent orchestration," y remite todo lo que sea de alto volumen o sensible a la latencia a Muse Spark.
Las demos del lanzamiento son más personales que corporativas: un plan de carreras construido entre varias apps, merchandising personalizado pedido a partir de fotos de Instagram, un plano de asientos para una boda, una reclamación de seguro. Es un adelanto de hacia dónde va este modelo, hacia el agente personal Muse, que según Meta Wonder "will soon power", empezando por los suscriptores.
En cuanto a seguridad, Meta describe Wonder como su "most aligned model to date", con sus salvaguardas más sólidas contra el uso indebido químico, biológico y cibernético, aunque permite trabajo cibernético defensivo dentro de su marco de escalado. El informe de seguridad completo figura como "available soon", así que esa parte todavía no se puede comprobar.
Datos y acceso: el modo Contributor viene activado por defecto
Este es el ajuste que yo revisaría antes que ninguno.
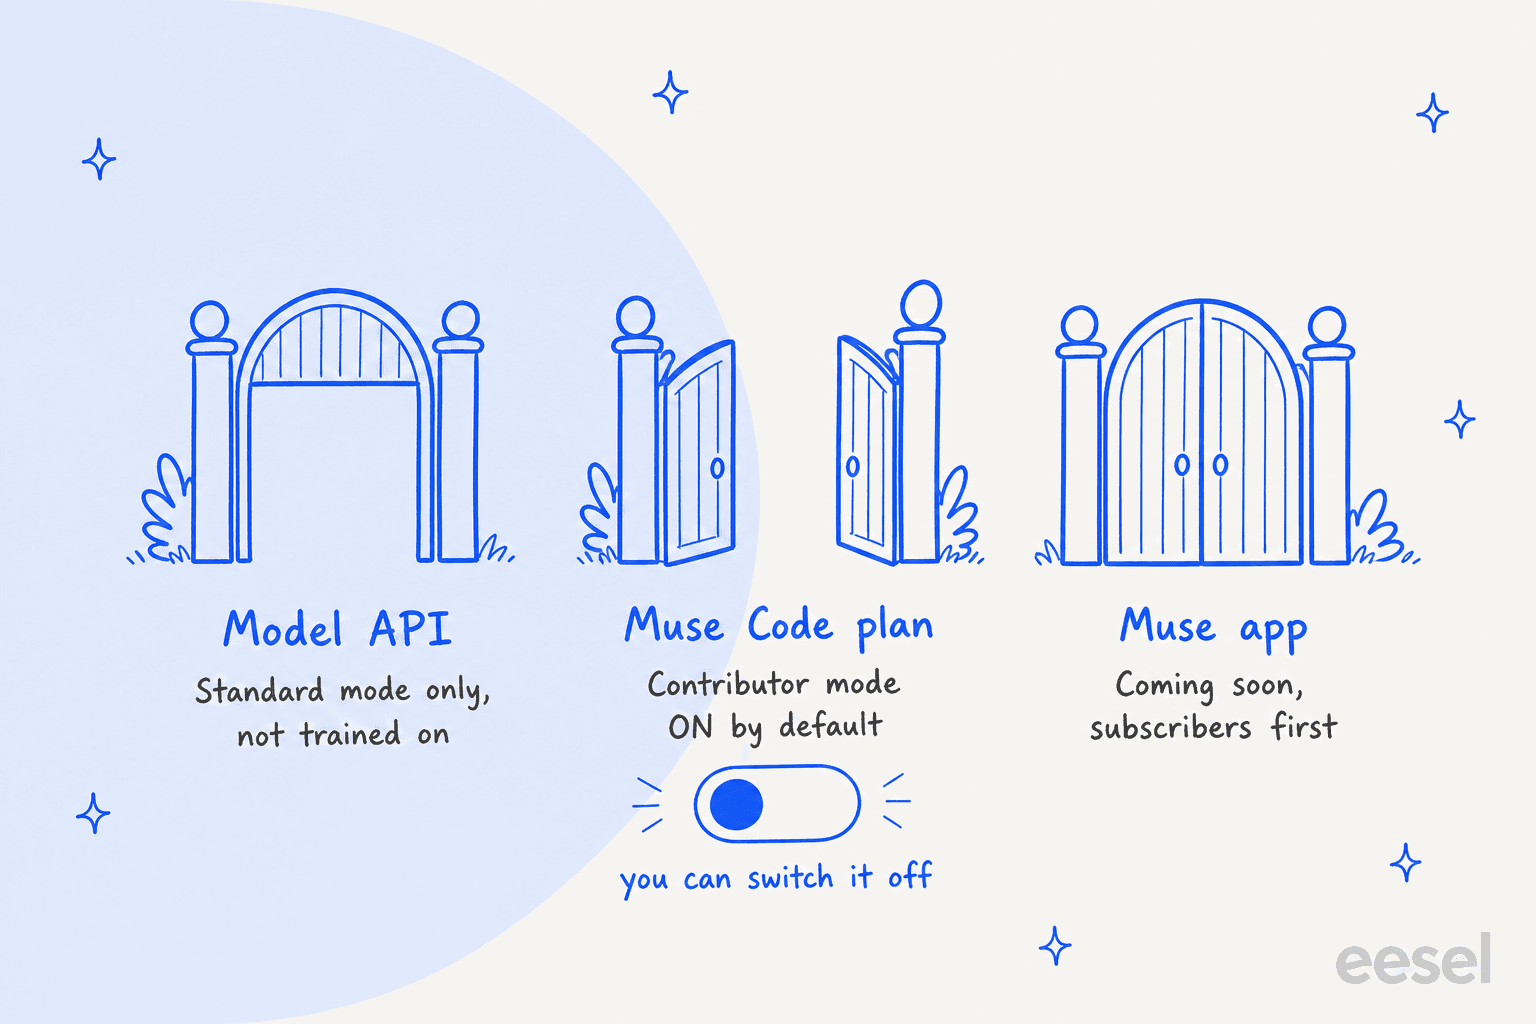
En la API, Muse Wonder funciona solo en modo Standard: la documentación de Meta dice que tu contenido "is not used to train Meta models." Dentro de Muse Code es lo contrario. La página de suscripciones dice "Muse Code subscriptions default to Contributor mode", que te da más uso "in exchange for letting Meta use your content to train future Meta models." Por contenido se entiende tus prompts, tu código, tus archivos y tu contexto, además de las respuestas. Puedes desactivarlo en cualquier momento y, a partir de entonces, el contenido nuevo no se utiliza.
Así que el camino más barato a Wonder Full, un plan de Muse Code, es también el que entrena con tu código a menos que cambies un ajuste. Es un trato razonable para un proyecto personal. Para el repositorio de una empresa, desactívalo desde el primer día.
Esta pregunta surge en las llamadas de ventas de eesel más que cualquier benchmark. Un evaluador técnico de una empresa de hardware preguntó una vez, en una demo, si eesel recurre discretamente a algún otro ChatGPT cuando no sabe una respuesta y si eso se podía desactivar. Lo que querían era sencillo: respuestas solo a partir de su conocimiento aprobado, y que su conocimiento siguiera siendo suyo. Qué modelo de frontera hay por debajo les importaba mucho menos que esa regla.
Qué dicen los primeros usuarios
El veredicto de la comunidad, dos días después, es "cifras impresionantes, compruébalo tú mismo". Destacaron algunos informes de uso real.
En visión, Wonder a secas tuvo dificultades en la prueba de un desarrollador:
"Image->HTML test for Muse Wonder. It's much worse than Opus 5.5. IMO it's closer to Sonnet or Haiku for this test."
Más tarde confirmó que era Wonder a secas, ya que Full no estaba en OpenRouter, la misma brecha de la sección anterior, apareciendo en la práctica.
En cuanto al entorno de ejecución, un usuario de pago tuvo problemas de configuración antes de que el modelo llegara a importar:
"I paid them for a month to try out Muse Code, but their sandbox never worked across Mac or Linux (both very stock installs, nothing special)."
Y sobre la línea Muse en general, los usuarios habituales del modelo anterior se muestran optimistas. Uno escribió que Muse Spark 1.3 es "very fast and powerful" y su "work horse for open source development." Otro comentarista señaló que la suscripción es solo para Norteamérica por ahora, mientras que la API es accesible a través de OpenRouter.
Ventajas e inconvenientes
Ventajas
- Wonder Full empata con Opus 5.5 con seis victorias cada uno en la tabla de 14 filas de Meta, y lidera con claridad en legal (13,1 frente a 4,2) e ingeniería ultralarga (57,5 frente a 46,3)
- Segundo en el índice de Artificial Analysis en el lanzamiento (56), el mejor resultado de Meta por un amplio margen
- Tarifa de API clara: sin recargo por contexto largo, tokens de guía sin facturar, entrada en caché a 0,20 $
- Contexto de 1M de tokens, cinco tipos de entrada y generosos límites de 3.000 RPM / 4M TPM desde el primer día
- Disponible en OpenRouter, así que puedes probarlo dentro de herramientas que ya usas
Inconvenientes
- El modelo de la API (52 en AA) no es el que está detrás de las puntuaciones destacadas, y cuesta lo mismo que Opus 5.5 (58)
- Wonder Full está bloqueado a las suscripciones de Muse Code de 50 $ o 200 $ al mes, sin ruta con precio por token
- Los planes de Muse Code usan por defecto el modo Contributor, que entrena con tu contenido hasta que lo desactives
- Estado preview, un informe de seguridad aún "coming soon" y posiciones en el ranking que cambiaron el mismo día
- Wonder a secas se queda por detrás de Opus 5.5 en uso del ordenador, programación en terminal y programación desde cero
¿Quién debería usar Meta Muse Wonder?
Elige Wonder Full si eres un desarrollador individual o un equipo pequeño que trabaja en proyectos de programación largos, redacción legal o investigación financiera, y 50 $ al mes por Muse Code te resultan fáciles de justificar. Desactiva antes el modo Contributor. Es la mejor razón hasta ahora para probar el agente de programación de Meta, y las alternativas a Muse Code merecen un vistazo con el mismo presupuesto.
Elige Muse Wonder a secas en la API si necesitas ejecuciones largas de agentes con buena memoria y quieres un segundo proveedor de frontera junto a Anthropic. Con precios idénticos, lo probaría en paralelo con Opus 5.5 en tus propias tareas antes de mover cualquier tráfico de producción.
Descártalo por ahora si necesitas sobre todo uso del ordenador o generación de código desde cero, donde Opus 5.5 sigue liderando, o si tu carga de trabajo es de alto volumen y sensible al precio, donde la propia documentación de Meta te remite a Muse Spark. Si estás comparando de forma amplia, mi recopilación de los mejores asistentes de programación con IA y la guía de precios de Claude Code cubren las otras opciones.
Y si diriges un equipo de soporte, el lanzamiento de un modelo es el lugar equivocado para empezar. Wonder puede impulsar un agente de IA, pero alguien tiene que conectarlo con tu helpdesk, mantenerlo dentro de tu conocimiento, decidir cuándo pasa el caso a una persona y demostrar que acierta antes de que toque a un cliente. Esa es la diferencia entre un modelo y un compañero, y por eso elegir el mejor modelo para tickets de soporte es solo el primer paso. Mis notas sobre el uso de Muse para Zendesk muestran cuánto trabajo de integración hace falta.
Contrata a eesel en lugar de montar un modelo tú mismo
Muse Wonder es infraestructura; eesel es el empleado. eesel es una plataforma de compañeros de IA donde contratas compañeros listos para trabajar en tareas concretas, y ahora mismo hay dos puestos: un compañero de helpdesk con IA y un redactor de blogs con IA.
Para los equipos de soporte, el compañero de helpdesk se conecta con Zendesk, Freshdesk o Gorgias, aprende de tus tickets anteriores, tu centro de ayuda y tu documentación, y responde solo con lo que has aprobado. Antes de que responda a nadie, puedes simularlo con tus tickets históricos y ver exactamente qué habría dicho. He visto a un bot de apariencia segura dar una respuesta equivocada en una cola real, y por eso existe esa prueba. Los planes son una tarifa mensual fija en la que un ticket equivale a un crédito, desde 299 $/mes por 500 créditos, con 100 créditos gratis para probar, según la página de precios de eesel.

Si estabas leyendo sobre Muse Wonder porque quieres que la IA trabaje tu cola de tickets, olvídate de comparar modelos. Prueba eesel gratis y mira cómo redacta respuestas con tus propios tickets.