

Meta Muse Spark 1.3 es un modelo realmente sólido para programación y contexto largo que se lanzó el 2026-09-02, y se gana su titular: un Artificial Analysis Intelligence Index de 62 para el nivel superior, puesto 6 de 636 modelos. Pero tres cosas moderan el entusiasmo. Primero, el nivel que puntúa 62 es max, y el razonamiento max seguía restringido por pruebas de seguridad en el lanzamiento, así que el nivel que realmente puedes ejecutar es xhigh. Segundo, el planteamiento de Meta de "agentes mejorados" es en realidad una historia de programación mejorada: Opus 5 max todavía lo supera en cuatro de seis filas de agentes en el propio gráfico de Meta. Tercero, es verboso y gasta unas 3x los tokens de Muse Spark 1.2, así que tu factura real va por delante de la tarifa de lista.
El precio es la parte más interesante: un endpoint estándar a $1.25 / $4.25 por millón (datos privados) junto a un endpoint de colaborador a aproximadamente $0.10 / $0.20 (Meta entrena con tu tráfico). Si lo estás evaluando para soporte al cliente, recuerda que un modelo es infraestructura, no un compañero. eesel pone a tu disposición un agente de soporte de IA listo para trabajar que funciona con modelos como este, se conecta a tu helpdesk y se simula con tus tickets anteriores antes de responder a nadie.
Qué significa "reseña" aquí y qué no pude probar
Me gano la vida construyendo integraciones y APIs, así que cuando leo un lanzamiento de modelo me interesa menos la nota de prensa y más lo que hace la cosa una vez que la conectas. Esa es la lente de esta reseña. Leí con atención el blog de investigación de Meta y su metodología de evaluación, saqué los números de Artificial Analysis y leí todo el hilo de lanzamiento en Hacker News, donde aterrizaron 261 comentarios en un día.
Lo que no pude hacer fue ejecutar max de principio a fin, y eso no es un atajo mío. El propio blog de Meta dice que los modos de razonamiento disponibles hasta ahora se lanzan hoy "with max reasoning coming shortly after we finish additional safety testing." Así que el modo que obtiene el 62 no es el modo que la mayoría puede llamar todavía. Cuando hablo del comportamiento en vivo me refiero a xhigh, el nivel que realmente está disponible, que obtiene un 61. Ten presente esa brecha durante el resto del artículo, porque el marketing de Meta no lo hace.
El gráfico que Meta quiere que leas
Toda reseña de Muse Spark 1.3 va a abrir con este cuadro, así que lo pongo y luego te cuento lo que no dice.
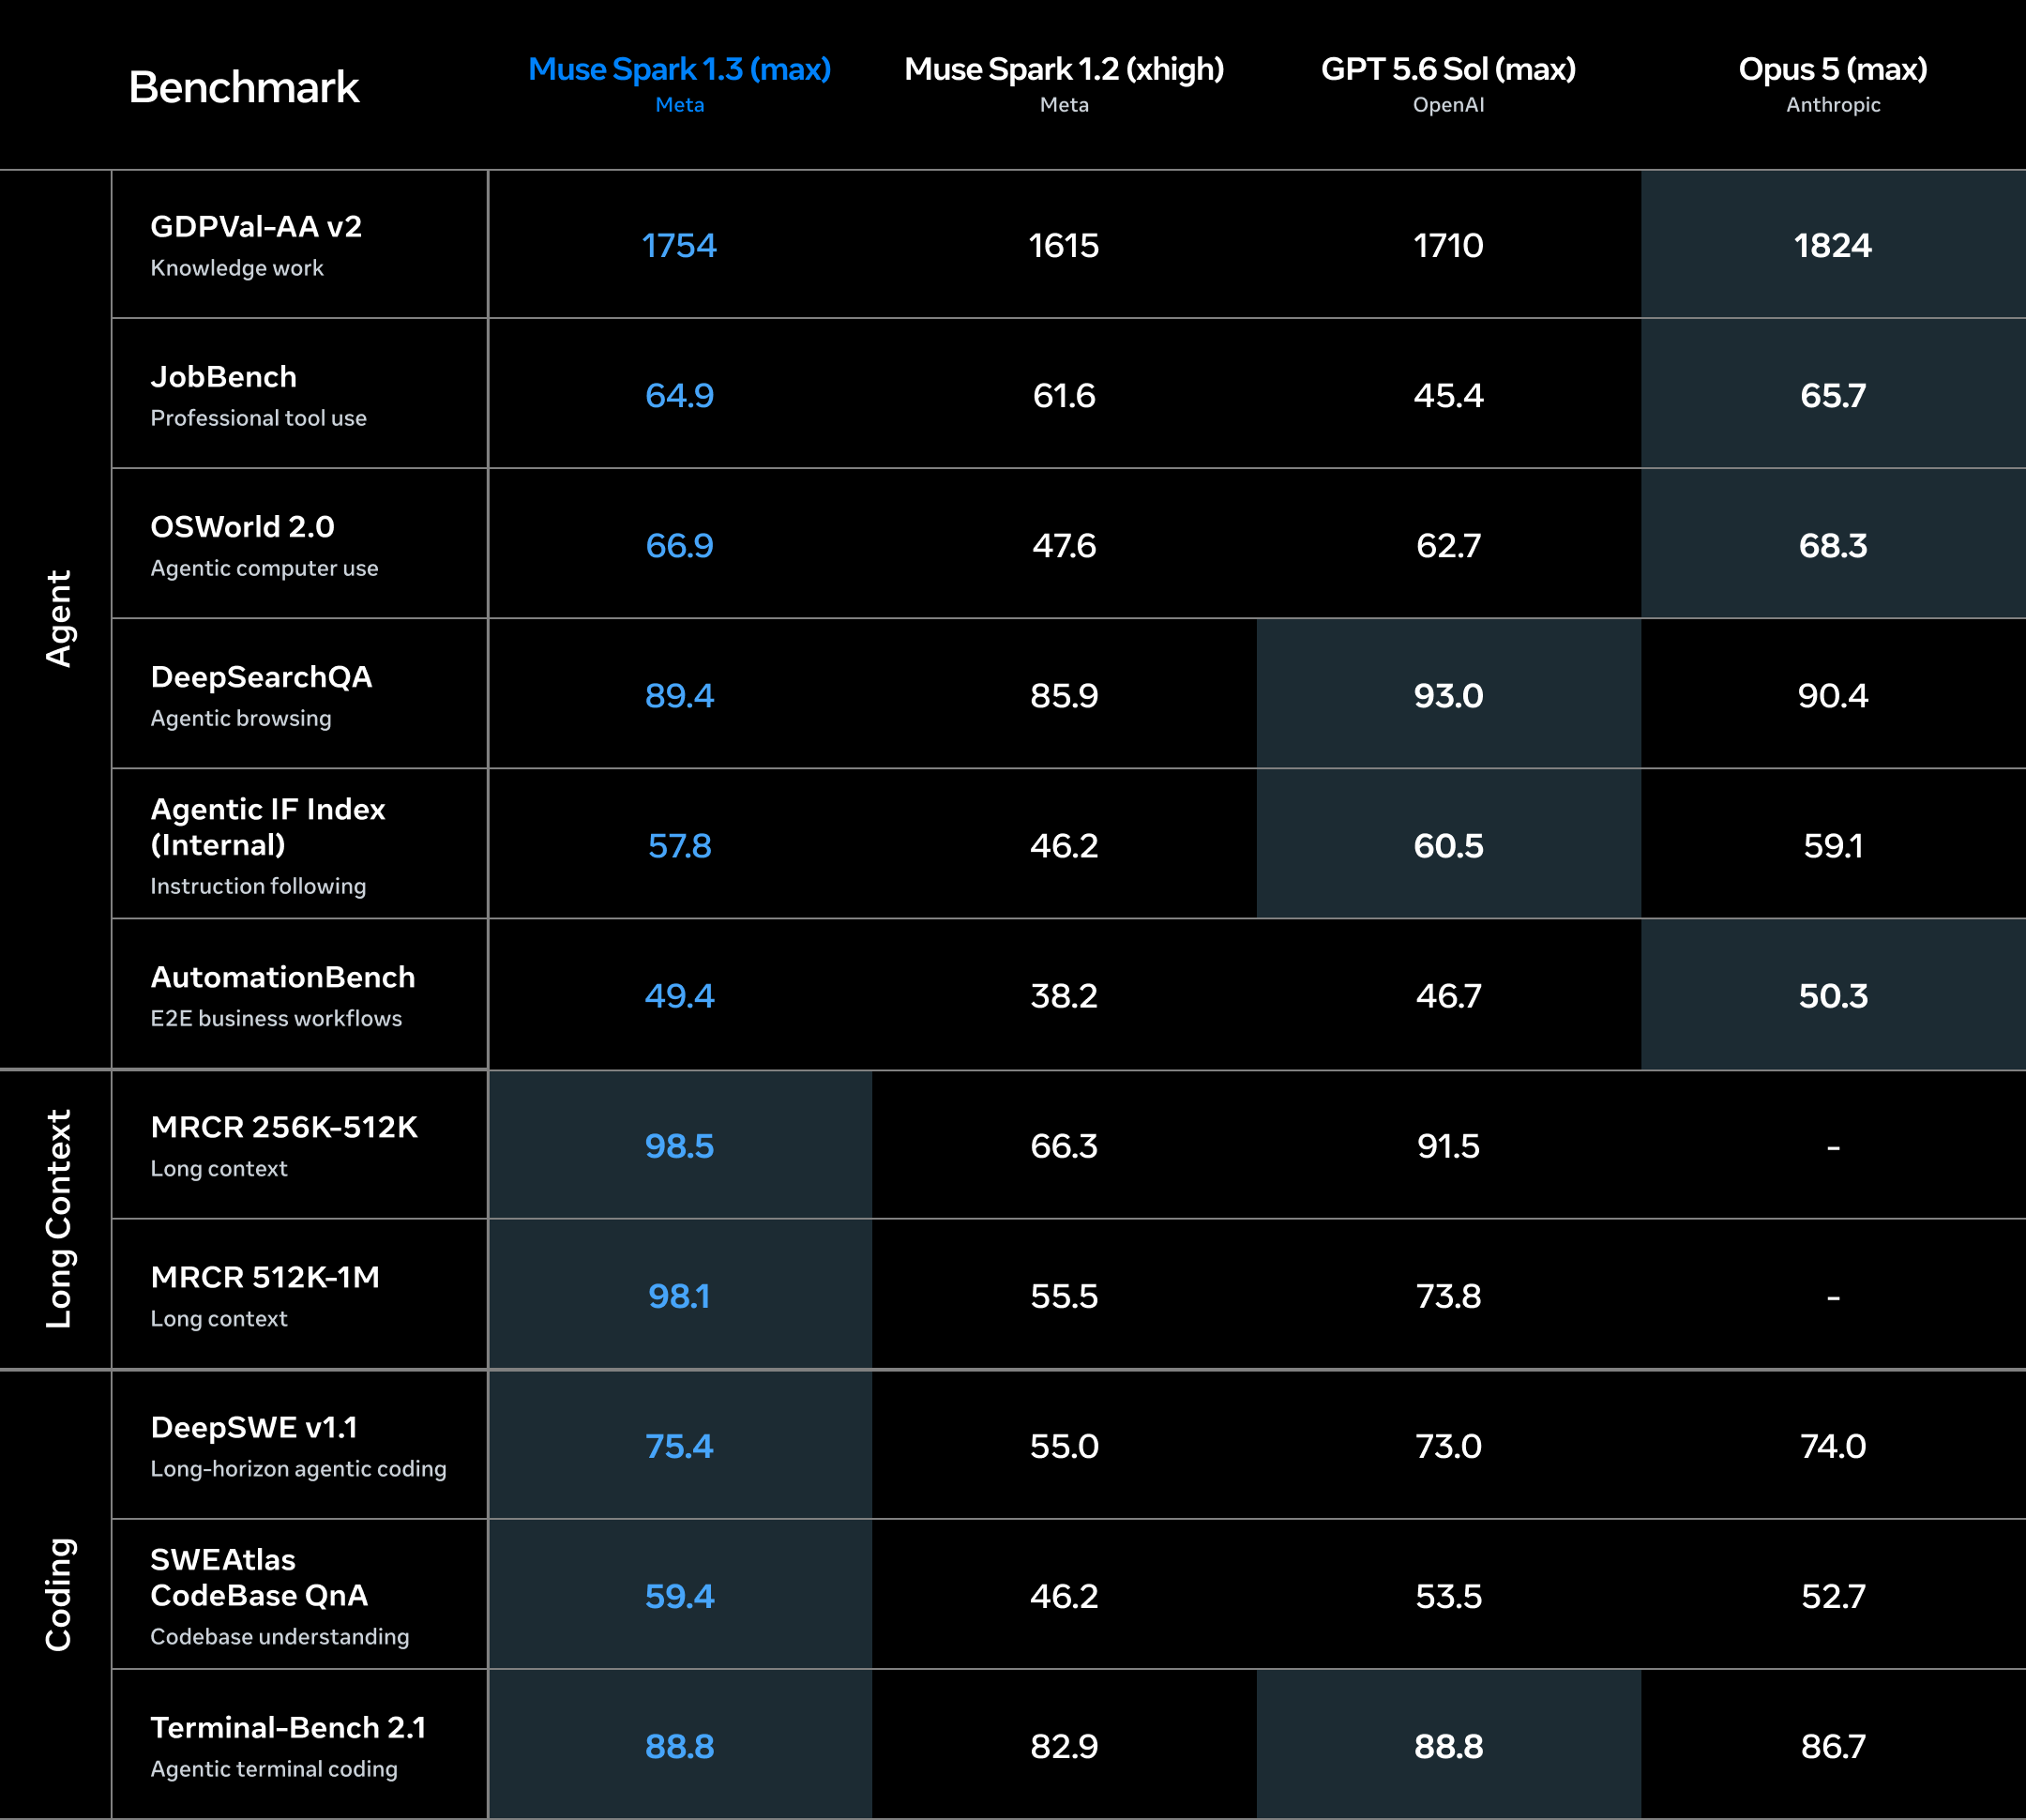
Las cuatro columnas son Muse Spark 1.3, Muse Spark 1.2, GPT-5.6 Sol y Opus 5, en las categorías de agentes, programación, seguimiento de instrucciones y contexto largo. Se lee como una victoria limpia de 1.3. Aquí está el asterisco: la columna de 1.3 es max, y la columna de 1.2 con la que se compara es xhigh. Eso no es una comparación en igualdad de condiciones. Parte del salto que ves es un cambio de nivel de razonamiento, no un cambio de generación del modelo. Un comentarista de HN, sunaookami, señaló que el cuadro "only shows max reasoning" mientras que max es precisamente el modo restringido, y lo calificó de deshonesto. Te están mostrando la mejor versión posible de 1.3 contra una versión intermedia de 1.2.
Eso no hace malo al modelo. Hace del gráfico un artefacto de marketing, que es lo que siempre son los gráficos de lanzamiento. Léelo para ver la dirección, no el tamaño exacto de la brecha.
Dónde gana de verdad: contexto largo y programación
Sin el envoltorio, las victorias reales siguen siendo reales, y se concentran en dos lugares.
En contexto largo, 1.3 es excelente. En la prueba de recuperación MRCR de Meta obtiene 98.5 en la banda de 256K-512K y 98.1 en 512K-1M, muy por delante de las cifras de 1.2 a su lado. Si tu carga de trabajo es "lee esta enorme base de código o conjunto de documentos y razona sobre todo", esa recuperación es un motivo legítimo para echarle un vistazo. La ventana de contexto de 1M tokens no es aquí solo margen de marketing; las puntuaciones de recuperación dicen que realmente usa la ventana.
En programación, las mejoras frente a 1.2 son la parte más creíble del blog de Meta porque son específicas. Los ingenieros de Meta reportan aproximadamente un 20% menos de llamadas a herramientas y un 25% menos de tokens en las mismas tareas de programación, con un estilo más limpio y menos divagante. En DeepSWE v1.1 obtiene 75.4 frente a 55.0 de 1.2, y empata con GPT-5.6 Sol en 88.8 en Terminal-Bench 2.1. Un revisor de la comunidad, majerep, llamó a la versión anterior "the best free model available on OpenCode" para tareas precisas y moderadas, y los números de programación dicen que 1.3 amplía esa ventaja. Si tuviera que buscar un modelo barato para dirigir un bucle de programación con agentes, este estaría en la lista corta junto a Kimi K3 y DeepSeek V4 Flash.
Dónde la historia "agéntica" es en realidad una historia de programación
Este es el hallazgo que no esperaba al empezar. El titular de Meta es "improved performance across agentic and coding tasks", y la mitad agéntica de eso no se sostiene frente al modelo que la propia Meta eligió para comparar.
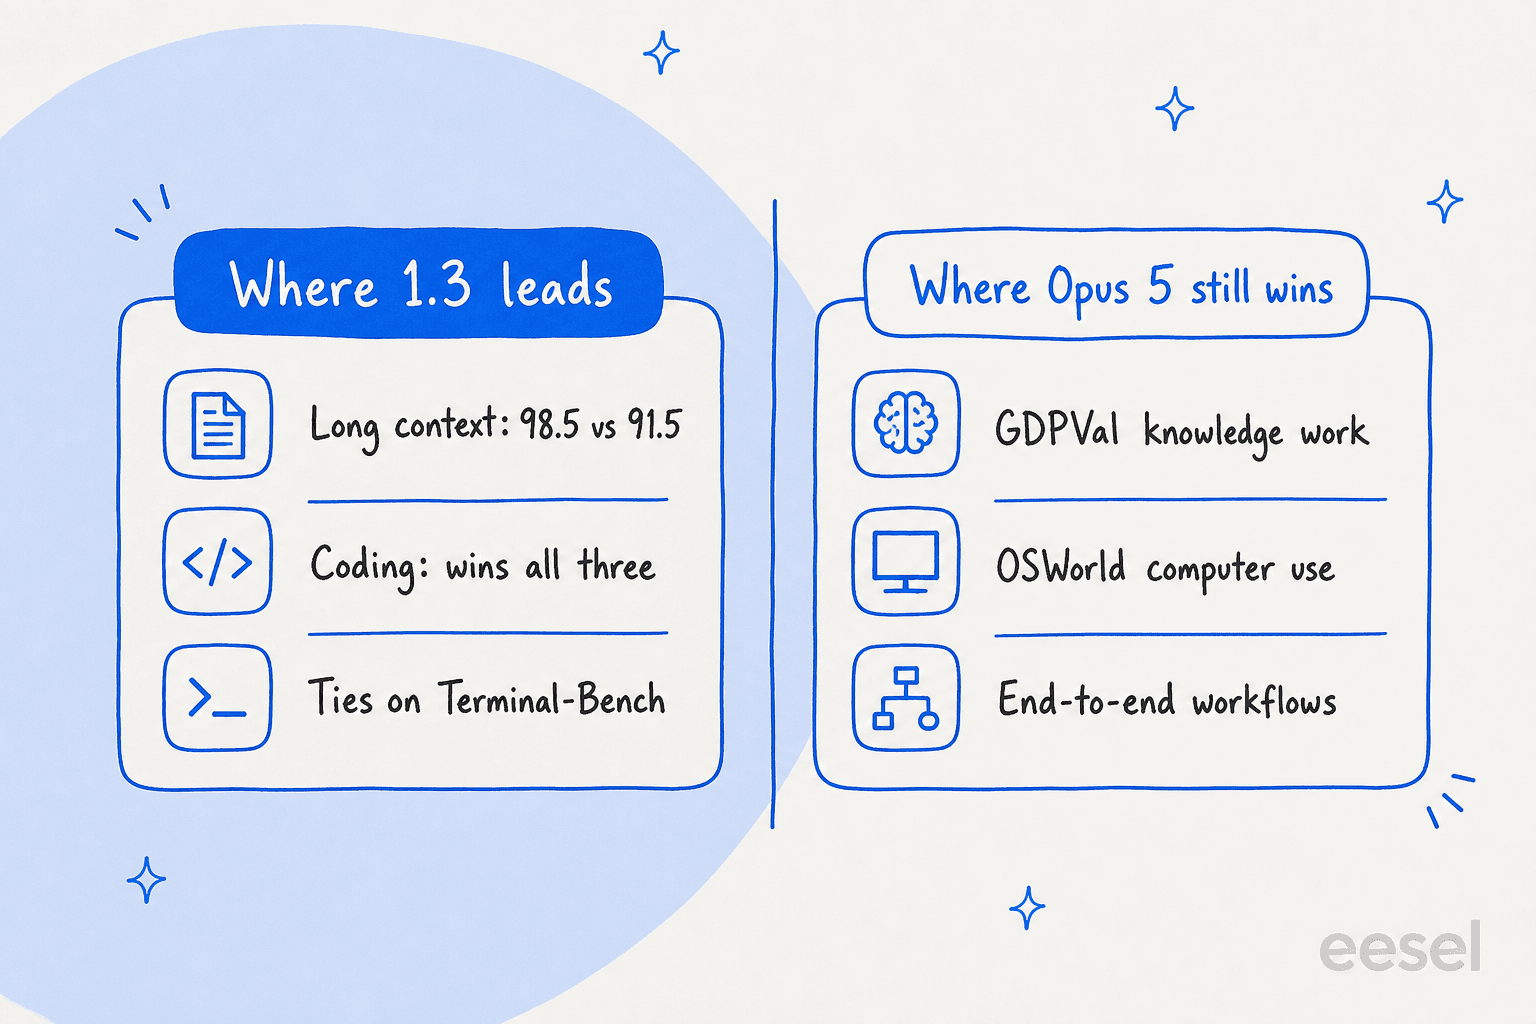
Recorre las seis filas de agentes del cuadro de Meta. Opus 5 max gana GDPVal-AA v2 (1824 a 1754), JobBench (65.7 a 64.9), OSWorld 2.0 (68.3 a 66.9) y AutomationBench (50.3 a 49.4). GPT-5.6 Sol se lleva DeepSearchQA (93.0) y el Agentic Instruction-Following Index (60.5). Es decir, Muse Spark 1.3 pierde todas las filas de agentes frente a uno u otro rival. Donde domina es en programación y contexto largo, que es una afirmación distinta de "mejor agente". La lectura honesta es que "agentes mejorados" es sobre todo "programación mejorada", y la programación sí está genuinamente mejorada.
Quiero ser justo, porque sigue siendo un modelo del top diez y las brechas en agentes son estrechas. Pero si eliges un modelo específicamente para uso de herramientas en varios pasos y control del ordenador, el cuadro que publicó Meta te dice discretamente que Opus 5 es la opción más segura para ese trabajo. Para la automatización del soporte, donde una acción "agéntica" errónea significa una respuesta errónea a un cliente real, esa distinción importa mucho, y por eso simulamos cada agente con tickets anteriores antes de ponerlo en producción en lugar de fiarnos de una fila de benchmark.
El impuesto de la verbosidad que nadie pone en el cuadro
La velocidad y el precio se ven geniales hasta que cuentas los tokens. Para completar el Artificial Analysis Intelligence Index, Muse Spark 1.3 emitió 120 millones de tokens de salida, frente a una mediana del campo de 72 millones. Eso lo sitúa en el puesto 139 de 636 en verbosidad, es decir, es más charlatán que la mayoría.
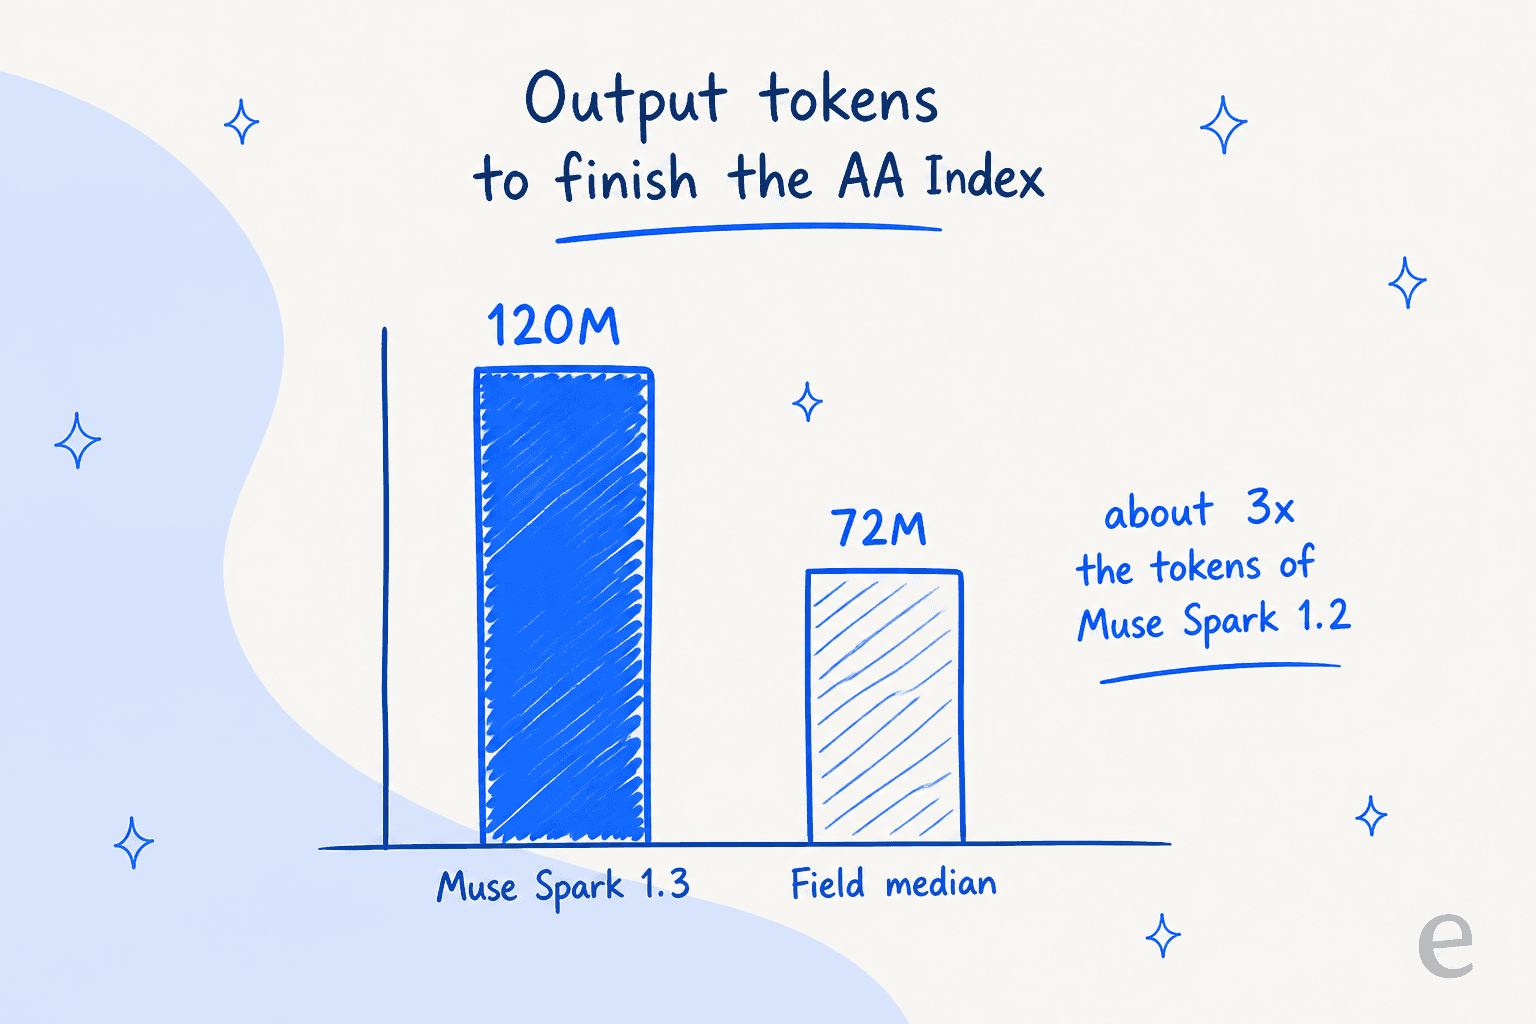
La gente de Hacker News, ejecutando su habitual prueba de estrés de SVG de un pelícano en bicicleta, estimó de forma independiente aproximadamente 3x el uso de tokens de 1.2. Como pagas por token de salida, la verbosidad es un multiplicador directo del coste. Una tarifa de salida de $4.25 por millón que produce el triple de tokens no es realmente un modelo de $4.25 en la práctica. Este es el número que pondría junto a la tabla de precios antes de firmar nada, y es exactamente el tipo de coste total oculto que un contador de tokens sin procesar esconde y un precio fijo por resolución no.
El precio son dos precios, y la brecha es toda la historia
El precio de Muse Spark 1.3 es lo más comentado, y con razón, porque en realidad son dos precios con un peaje de datos en medio.
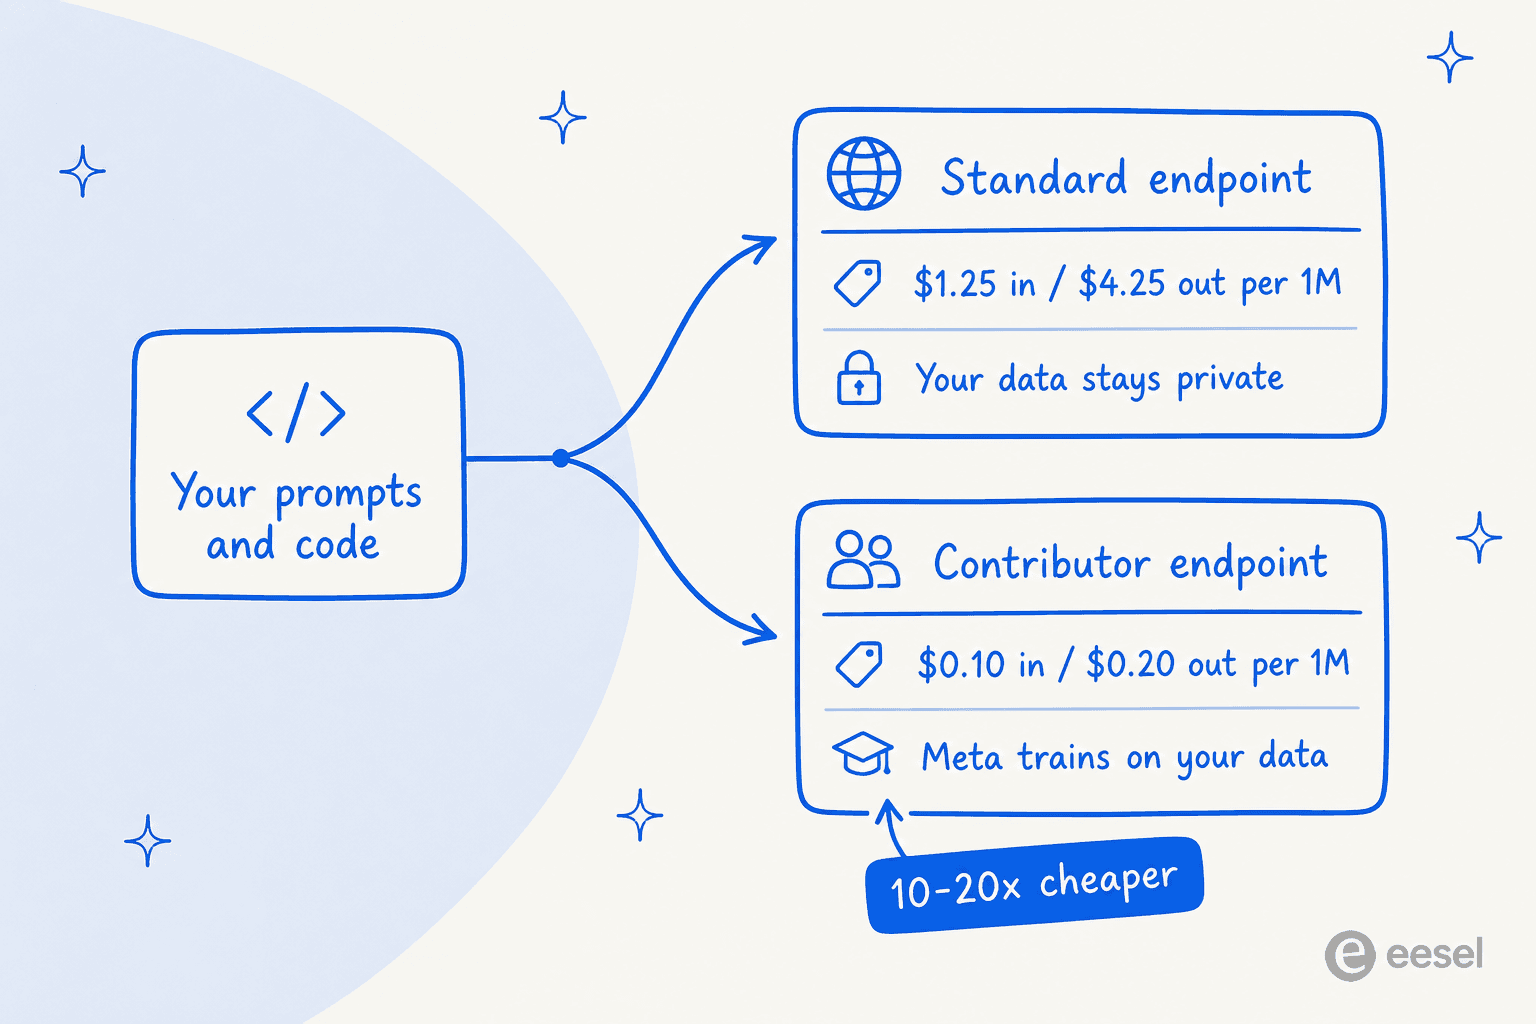
| Endpoint | Entrada / 1M | Salida / 1M | ¿Meta entrena con tus datos? |
|---|---|---|---|
| Estándar (xhigh) | $1.25 | $4.25 | No |
| Colaborador | ~$0.10 | ~$0.20 | Sí |
La tarifa estándar tiene un precio moderado frente a una mediana de entrada de $1.75, y Artificial Analysis midió $0.55 por tarea del Index. El endpoint de colaborador es 10-20x más barato porque le pagas a Meta con datos en lugar de dólares. La lectura de la comunidad sobre por qué existe la división es más afilada que el planteamiento de la propia Meta:
"It's not that Meta really wants your data and they're willing to pay top dollar for it. It's that companies really don't want Meta to have their data and they're willing to pay top dollar for that."

Eso es todo en dos frases. La prima no es por un modelo mejor; es el precio de mantener a Meta fuera de tu tráfico. Para un proyecto de aficionado, da igual. Para cualquier cosa que toque datos personales de clientes, el endpoint "barato" no es realmente una opción, así que el número con el que deberías planificar es el estándar de $1.25 / $4.25, multiplicado por el factor de verbosidad de arriba.
Qué piensa realmente la comunidad
El sentimiento el día del lanzamiento fue genuinamente mixto, y la mezcla es instructiva. A los optimistas les gusta la relación precio-inteligencia. Como señaló HDBaseT, el endpoint de colaborador es "by far the cheapest, significantly cheaper per M than ChatGPT Luna, significantly smarter than Luna too." Los escépticos no se convencieron de la capacidad, y dijeron de la versión anterior:
"Used Muse Spark 1.2 and was not impressed at all. Fast and cheap but even GPT 5.6 Terra felt much more capable."
Y mromanuk describió cómo rebotó con 1.2 en una aplicación web real y volvió a Claude, Kimi K3 o DeepSeek V4, esperando que 1.3 supere el listón. El hilo común: lo rápido y barato es real, la capacidad de primer nivel es discutida, y la herramienta con la que lo manejas importa. Varios comentaristas, incluido meric_, insistieron en que debes ejecutarlo en el propio arnés Muse Code de Meta, con el que fue entrenado conjuntamente, o dejas eficiencia sobre la mesa.
Quién debería usarlo y quién debería saltárselo
Seré concreto, porque una reseña que termina en "depende" te hizo perder el tiempo.
- Úsalo si tu carga es programación o razonamiento de contexto largo, puedes trabajar en Muse Code y tus datos no son sensibles, de modo que el endpoint de colaborador es viable. En esa intersección es una opción sólida y barata.
- Considéralo para agentes de programación sensibles al coste donde de otro modo recurrirías a Kimi K3 o DeepSeek V4 Flash. Presupuesta la verbosidad.
- Sáltatelo, por ahora si necesitas el mejor uso agéntico de herramientas (el cuadro apunta a Opus 5), si necesitas
maxhoy (aún restringido) o si manejas datos regulados y no puedes pagar la prima estándar. - Sáltate el modelo sin procesar por completo si lo que realmente quieres es automatización de soporte al cliente. Es un producto distinto, y te explico por qué a continuación.
Un modelo no es un compañero: qué significa esto para un equipo de soporte
Esta es la trampa en la que veo caer a los responsables de soporte cada vez que un modelo así se vuelve tendencia. Leen "modelo agéntico del top diez, baratísimo" y piensan que pueden apuntarlo a su bandeja de entrada. Un modelo sin procesar es infraestructura, como una base de datos o una API de pagos. Es potente y genérico. No conoce tu política de reembolsos, no está conectado a tu helpdesk, no recuerda los tickets de la semana pasada y no tiene un freno incorporado antes de enviar una respuesta errónea y segura de sí misma a un cliente que paga. Meta incluso dice que 1.3 es mejor en "confirming before consequential actions", lo cual admite que un modelo sin procesar necesita esa salvaguarda añadida.
Esa brecha entre un modelo y un compañero que funciona es lo que eesel existe para cubrir. eesel es una plataforma de compañeros de IA, y contratas compañeros listos para trabajar para tareas concretas. La plantilla actual es un agente de soporte de IA y un redactor de blogs de IA. El agente de soporte llega ya sabiendo hacer el trabajo: se entrena con tu base de conocimiento y tus tickets anteriores, se une a tu cola existente, redacta o resuelve automáticamente y escala limpiamente cuando debe. El modelo de debajo es un componente intercambiable; un modelo de frontera como Muse Spark 1.3 es exactamente el tipo de motor sobre el que puede funcionar, pero el valor está en todo lo que lo rodea.
La parte que se relaciona directamente con un lanzamiento de modelo de programación como este es la CLI de eesel. Si te gusta Muse Code porque puedes manejar un agente desde una terminal, entenderás por qué esto importa. La CLI es una forma amigable para agentes de operar el mismo compañero eesel y el mismo espacio de trabajo que vive en el panel: una persona puede ejecutarla a mano desde una terminal, los scripts pueden automatizarla en CI y agentes de programación como Claude Code, Codex y Cursor pueden manejarla directamente. Es el mismo compañero, no un producto aparte recortado, así que puedes gestionar fuentes, lanzar ejecuciones y extraer actividad sin hacer clic por una interfaz. Esa es la diferencia entre "aquí tienes una clave de modelo, suerte" y "aquí tienes un compañero al que además puedes automatizar con scripts".
Prueba eesel en lugar de una clave de modelo sin procesar
Si llegaste a esta reseña porque estás valorando construir automatización de soporte sobre un modelo de frontera barato, la respuesta honesta es que el modelo es la parte fácil y el menor de tus problemas. eesel te da el agente de soporte de IA ya preparado para el trabajo: funciona con modelos de frontera como este, se conecta a Zendesk, Freshdesk y el resto de tu stack y, lo que realmente reduce el riesgo, te permite simularlo con miles de tus tickets anteriores para ver su tasa de resolución real antes de que responda jamás a un cliente.
Ese paso de simulación es la lección que aprendimos por las malas tras años de poner IA en colas de soporte en vivo: hemos visto bots de apariencia segura dar respuestas erróneas en silencio, por eso nada en eesel llega a un cliente sin un ensayo previo con tu propio historial. Puedes empezar gratis y ver el número con tus propios datos.
El veredicto
Muse Spark 1.3 es una mejora real para programación y contexto largo, y con el precio de colaborador es una de las mejores opciones de valor por token del tablero. Como "modelo agéntico top" está sobrevendido: el propio cuadro de Meta muestra a Opus 5 ganando las filas de agentes, el nivel insignia max está restringido y la verbosidad 3x significa que el precio de lista barato no es el precio que pagas. Léelo como lo que es, un especialista en programación rápido, barato y verboso con un fuerte hábito de contexto largo, y es fácil de apreciar. Solo no confundas un modelo potente con un compañero que trabaja. Si el trabajo es atender a clientes, contrata al compañero, no al motor.