

Meta lanzó Muse Spark 1.2 el 5 de agosto de 2026 y lo presentó como una versión de programación. Si lees las cifras independientes, es lo único que apenas es. En Artificial Analysis, Terminal-Bench subió 2,2 puntos mientras el índice agéntico subió 9,6 y el Elo de GDPval subió 254. El colapso en agentes generales que lastraba a 1.1 se arregló, y Meta lo mencionó en una sola frase.
Lo segundo que hay que saber es que los gráficos de programación principales de Meta cambian dos variables a la vez. Muse Spark 1.2 se mide dentro de Muse Code, el nuevo agente de terminal de Meta, mientras que 1.1 se mide en mini-swe-agent. Además, los modelos se entrenaron conjuntamente con ese arnés. Así que la diferencia que ves es un modelo más un arnés, y el gráfico no puede separarlos por ti.
Lo tercero es el precio, y es la parte más interesante del lanzamiento. El mismo modelo tiene dos IDs: $1,25/$4,25 por millón de tokens, o $0,10/$0,20 si dejas que Meta entrene con tu tráfico. Eso es aproximadamente 16x con una mezcla normal. En eesel construyo agentes de IA para colas de soporte, y el patrón que señalaría es uno que he visto hundir acuerdos: el modelo nunca fue el cuello de botella. Un comprador hizo una vez una evaluación metódica de 67 pruebas de nuestro agente, calificó las respuestas de conocimiento como sólidas y se fue igualmente porque el widget de chat era lento y se atascaba. Los tokens más baratos no arreglan lo que rodea a los tokens.
Qué lanzó realmente Meta el 5 de agosto
Llegaron dos cosas juntas, de parte de Matthias Reso y Josh Walters en el blog para desarrolladores de Meta: el modelo y el agente creado para ejecutarlo.
Muse Spark 1.2 es el modelo. La propia descripción de Meta es inusualmente contenida: llama a 1.2 «a moderate improvement over Muse Spark 1.1», optimizado para «multi-file refactors, long debugging sessions and tasks that run well past a single prompt». La publicación de investigación es aún más directa y plantea el lanzamiento como «our next step toward the frontier, with larger and much more capable models on the way.» Nadie en Meta afirma aquí tener un modelo de frontera, y yo les tomaría la palabra. Es una postura distinta al resto del impulso de IA de Meta, donde el trabajo de cara al consumidor recibe promesas mayores.
Muse Code es el agente, en beta. Se instala con un comando, se ejecuta en tu terminal, lanza subagentes en paralelo y registra todo lo que hace. Es la pieza nueva de este lanzamiento, y creo que es la que la mayoría de la cobertura pasó por alto. Si nunca has usado una herramienta de programación con IA en terminal, esa es la categoría a la que se une.
Tres cosas pasaron sin cambios desde Muse Spark 1.1: la ventana de contexto de 1.048.576 tokens, la tarifa estándar y los pesos cerrados. Lo que cambió fuera del modelo es la disponibilidad. Meta amplió la vista previa pública más allá de Estados Unidos, que para quien intentó acceder a 1.1 desde fuera de EE. UU. fue el verdadero titular.
Artificial Analysis ya marcó Muse Spark 1.1 como obsoleto y lo redirige a 1.2, lo que indica cómo quiere Meta que se lea el linaje.
Dónde mejoró realmente Muse Spark 1.2
Esta es la parte que pondría en la pizarra. Meta vendió esto como un modelo de programación. Las cifras de programación fueron las que menos se movieron.
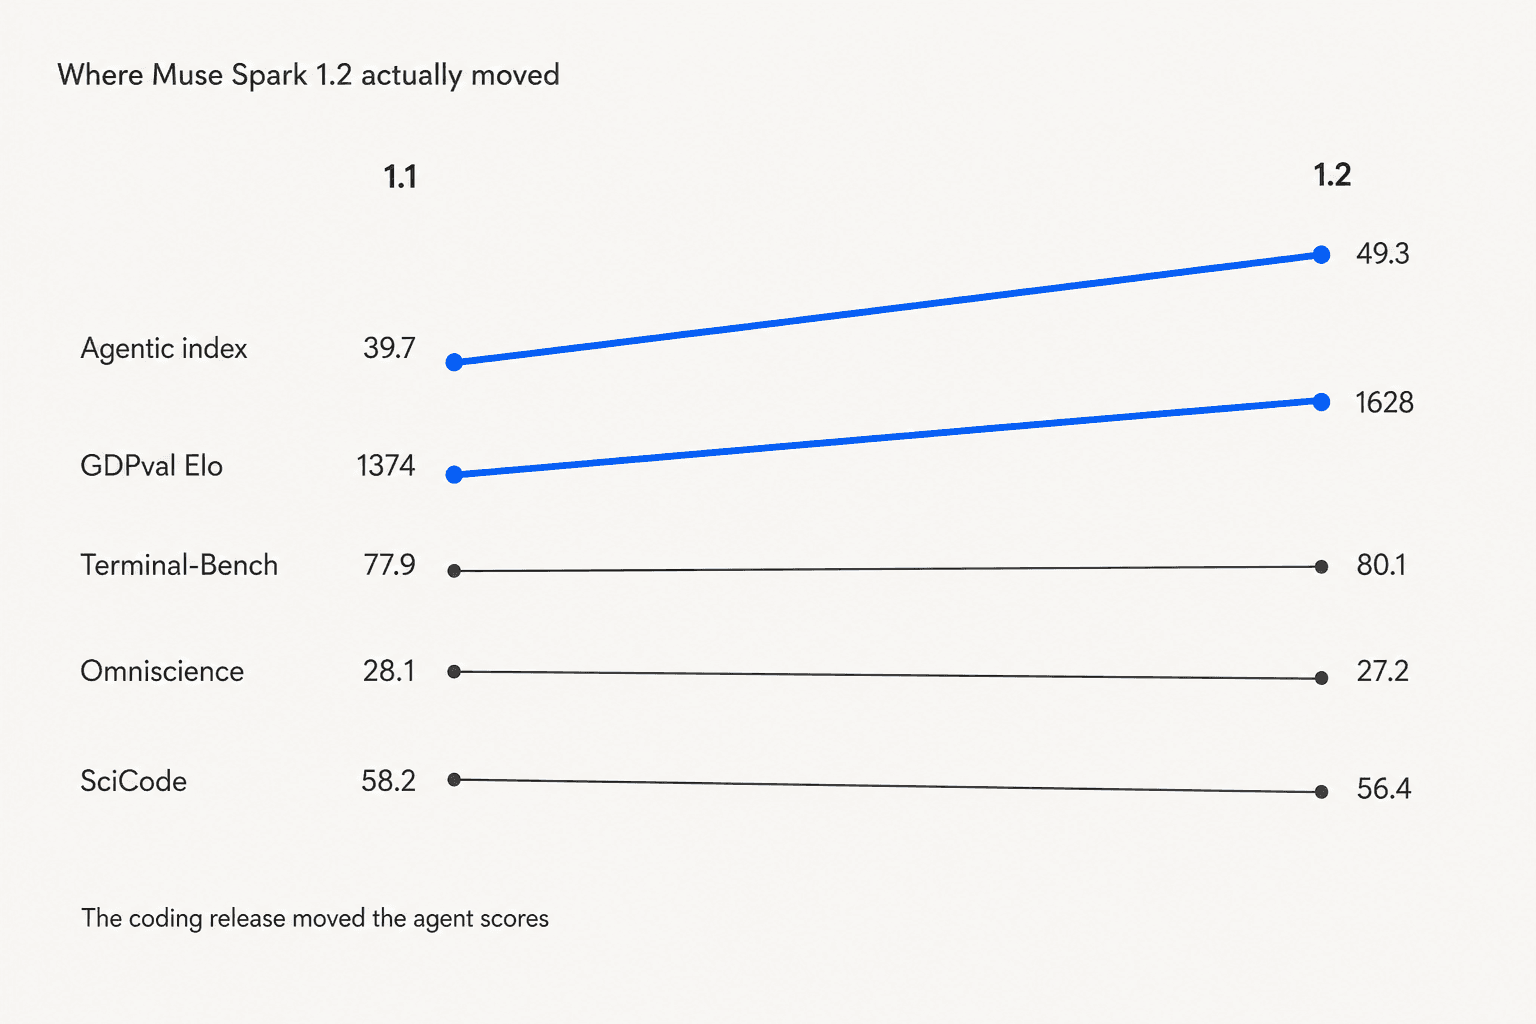
Todo esto proviene de Artificial Analysis, que ejecutó ambas versiones en el mismo arnés, que es lo que hace que la comparación valga algo:
| Benchmark | Muse Spark 1.1 | Muse Spark 1.2 | Cambio |
|---|---|---|---|
| Índice agéntico | 39.7 | 49.3 | +9.6 |
| GDPval-AA v2 (Elo) | 1374 | 1628 | +254 |
| Intelligence Index | 53.2 | 56.8 | +3.6 |
| tau-3 Banking | 31.8% | 34.9% | +3.1 |
| CritPt | 15.1% | 17.7% | +2.6 |
| Terminal-Bench 2.1 | 77.9% | 80.1% | +2.2 |
| AA-LCR (contexto largo) | 81.3% | 83.3% | +2.0 |
| GPQA Diamond | 89.8% | 90.4% | +0.6 |
| Humanity's Last Exam | 46.2% | 45.5% | -0.7 |
| AA-Omniscience Index | 28.1 | 27.2 | -0.9 |
| SciCode | 58.2% | 56.4% | -1.8 |
SciCode, un benchmark de programación, retrocedió. Terminal-Bench, el benchmark de programación con el que Meta abrió, se movió aproximadamente una quinta parte de lo que se movió el índice agéntico. Mientras tanto, GDPval-AA v2, la evaluación que puntúa comparaciones ciegas por pares de entregables profesionales reales, subió 254 puntos Elo, lo que llevó al modelo del fondo de esa tabla al segundo puesto detrás de Opus 5 en el gráfico de Meta.
En mi reseña de Muse Spark 1.1 señalé que lo más extraño de ese modelo era la contradicción en su centro: Meta comercializaba un modelo para agentes, y las evaluaciones agénticas independientes eran sus peores resultados. Ese es el hueco que 1.2 rellena. Simplemente no es el hueco al que apunta la publicación de lanzamiento de Meta.
Para dar contexto sobre la compañía que ahora tiene, 56,8 sitúa a Muse Spark 1.2 en el puesto trece de veinte en esa tabla, por detrás de Claude Opus 5 con 63,1 y Grok 4.6 con 60,9, y por poco por delante de GPT-5.6 Terra con 56,6.
La cifra de alucinaciones hay que leerla dos veces
Una línea más de la misma fuente, porque es el tipo de cosa que una sola puntuación de índice oculta. Artificial Analysis desglosa AA-Omniscience en precisión y tasa de alucinación:
| Medida | Muse Spark 1.1 | Muse Spark 1.2 |
|---|---|---|
| Precisión | 52.0% | 45.4% |
| Tasa de alucinación | 50.0% | 33.3% |
1.2 alucina aproximadamente un tercio menos y acierta aproximadamente un octavo menos de respuestas. Aprendió a negarse a responder. Es una mejora real para cualquier cosa con un cliente al otro lado y un retroceso real para cualquier cosa que necesite una respuesta, y el resultado neto es un índice compuesto ligeramente peor. Si eliges un modelo para un flujo de trabajo en el que una respuesta equivocada sale cara, ese equilibrio es probablemente la cifra más relevante de esta publicación, y no aparece en ningún gráfico de Meta. La versión más amplia de ese problema está en alucinaciones de IA en soporte, y el lado de las herramientas para detectarlas está en herramientas de seguimiento de LLM.
La trampa del arnés en los propios gráficos de Meta
Ahora, la parte que me hizo volver a leer la publicación de lanzamiento.
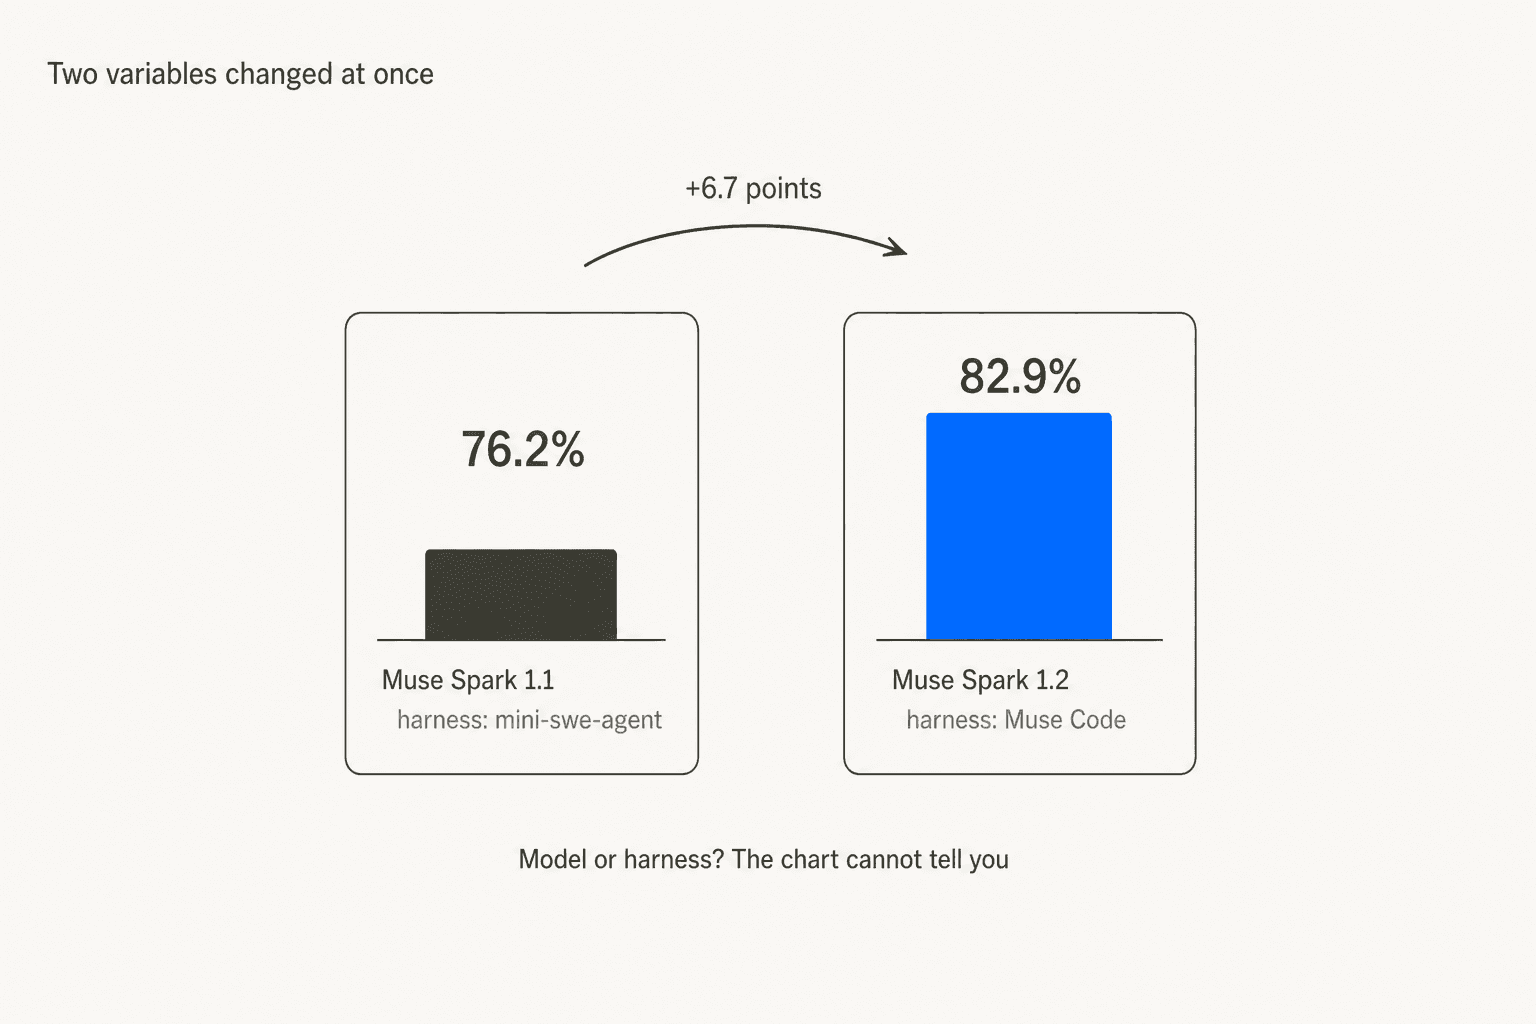
El gráfico de Terminal-Bench 2.1 de Meta muestra a Muse Spark 1.2 con 82,9 % y a Muse Spark 1.1 con 76,2 %. En el pequeño texto gris bajo cada barra también nombra el arnés en el que se ejecutó cada modelo: 1.2 se ejecutó en Muse Code, 1.1 en mini-swe-agent. Lo mismo en el gráfico de DeepSWE. Meta no lo esconde, está impreso ahí mismo, pero el ojo lee las barras y no la nota al pie.
Meta también dice abiertamente que «co-trained Muse Spark 1.2 with Muse Code», incluidas «rejection sampled harness trajectories» y optimizaciones de receta para objetivos, compactación y subagentes. Así que el modelo se ajustó al arnés en el que se evalúa.
El único gráfico donde no se nombra ningún arnés es el benchmark interno de programación de Meta, y es el más plano de la página:
| Modelo | Meta Internal Coding Bench |
|---|---|
| Opus 5 (max) | 79.4% |
| Muse Spark 1.2 | 70.6% |
| Muse Spark 1.1 | 68.3% |
| GPT 5.6 Terra (max) | 65.4% |
| Gemini 3.6 Flash (high) | 63.9% |
2,3 puntos, en el gráfico donde el arnés deja de ser una variable. Compáralo con los 6,7 puntos de Terminal-Bench y los 6,3 de DeepSWE, donde sí lo es. No digo que Meta haya cocinado nada. Digo que si vas a ejecutar este modelo en tus propias herramientas, la cifra con el arnés controlado es la que predice tu experiencia, y es la cifra más pequeña de la página.
Un comentarista del hilo de lanzamiento en Hacker News expresó la versión general de esto mejor que yo:
"Outputs are a little bit more deterministic if you control the harness. It is easy to benchmark across one harness, one system prompt and extract the most performance when you control the harness."

Por cierto, esto no es un problema específico de Meta. Todos los laboratorios lanzan ya un agente propio y miden dentro de él, desde Claude Code hasta Codex y Grok Build. Aquí solo resulta especialmente legible porque Meta imprimió los nombres de los arneses en el gráfico.
Muse Code, la parte realmente nueva
Muse Code se instala en una línea y se ejecuta como muse en cualquier directorio de proyecto:
curl -fsSL https://dev.meta.ai/install.sh | bash
La idea de diseño es el fan-out. Le das al agente principal un lote de tareas en un solo prompt, y este lanza un hijo con permiso de escritura por tarea, cada uno en su propio git worktree, de modo que los hijos paralelos nunca tocan los mismos archivos.
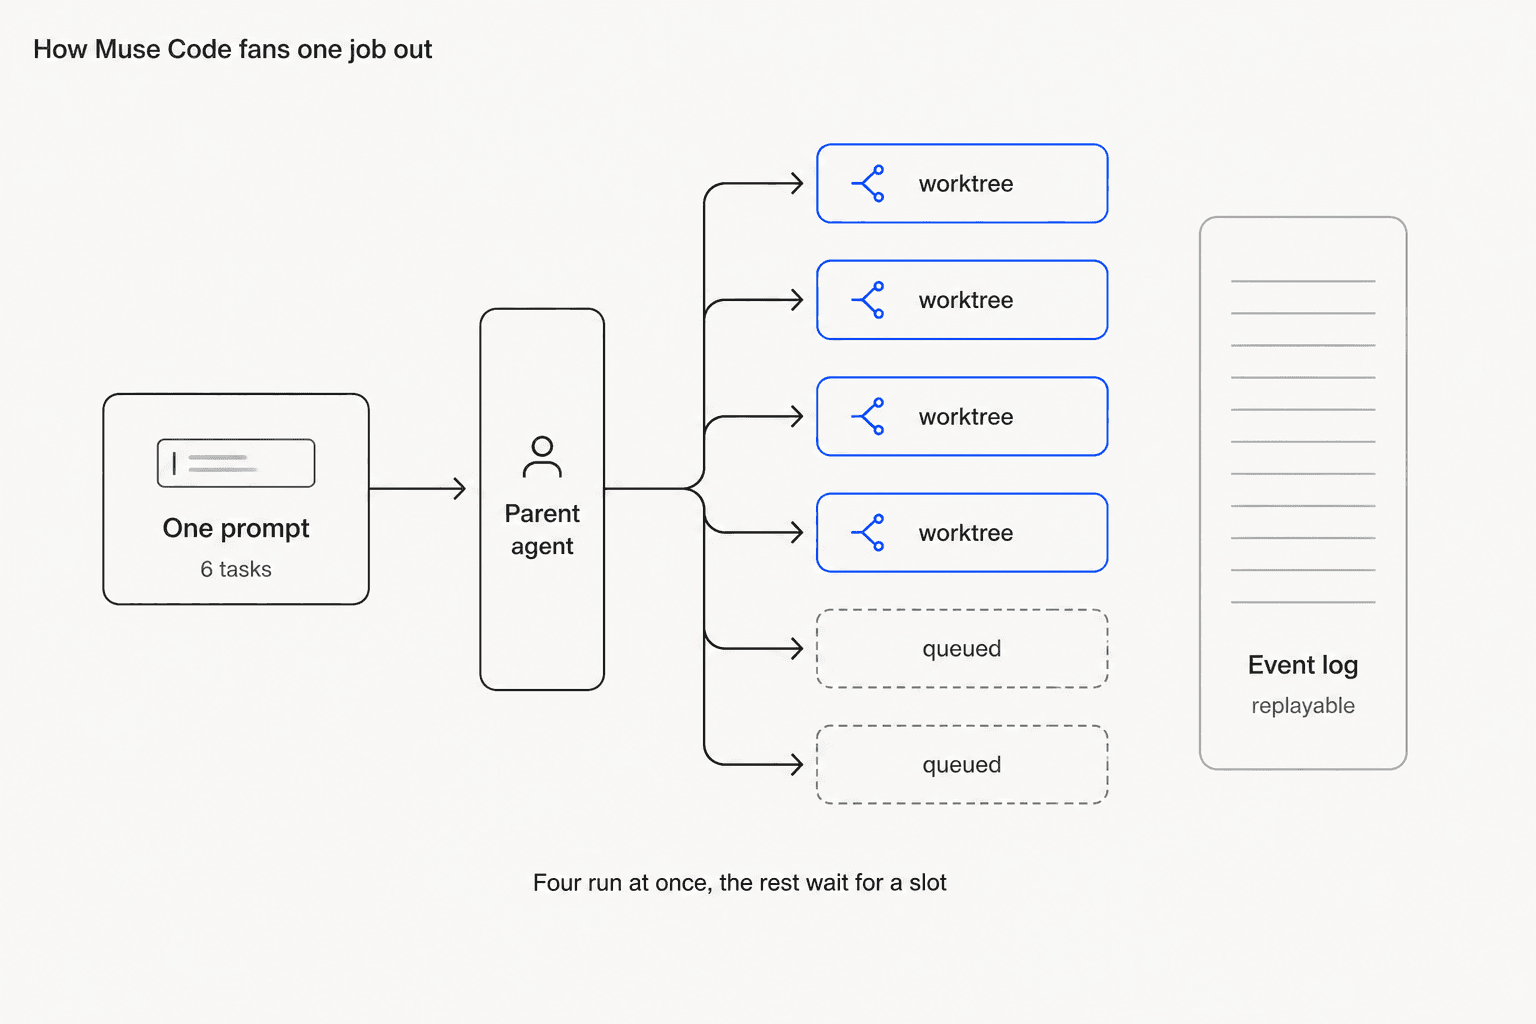
El propio cookbook de fan-out de Meta recorre un lote de seis tareas en un repositorio de juego de ejemplo. El agente principal lanza seis hijos, el límite de concurrencia del host resulta en cuatro, y las tareas cinco y seis esperan en cola hasta que se liberan plazas.
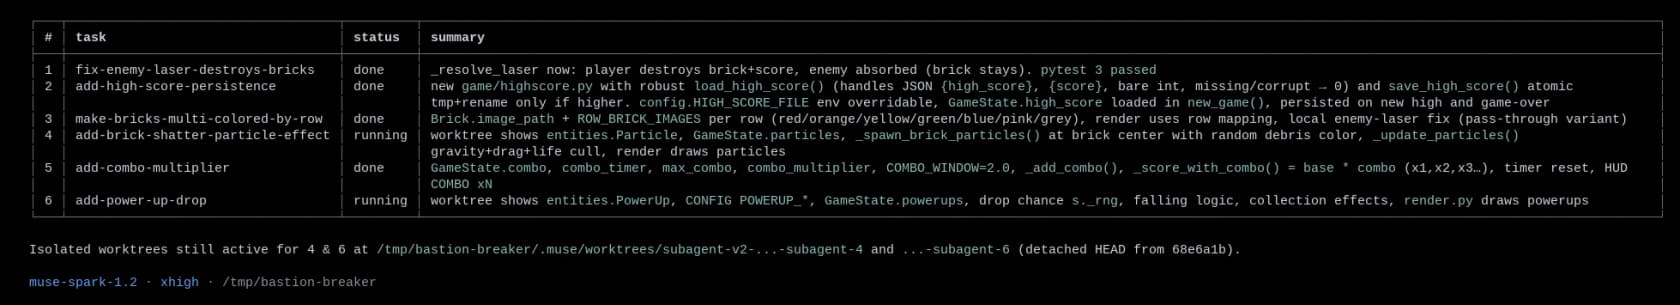
subagent_status devuelve esa lista, con la tarea de cada hijo, su estado y un resumen de una línea de lo que cambió. Fíjate en la barra de estado de la captura de Meta: muse-spark-1.2 · xhigh. El esfuerzo está en alto en la demo, algo que conviene recordar al comparar las cifras con tu propia factura. Los worktrees quedan en .muse/worktrees/ en estado detached HEAD, extraídos del HEAD del agente principal, sin ningún comando git worktree manual. En la ejecución de Meta, el hijo que corrigió el error pasa toda la suite de pruebas dentro de su propio worktree mientras el master del agente principal sigue fallando esa misma prueba.
Vale la pena nombrar otras dos piezas:
- Un registro de eventos reproducible. Cada llamada al modelo, ejecución de herramienta, aprobación y edición se añade a JSONL simple en tu disco, que puedes recorrer con
jq. El mismo registro impulsamuse resume, de modo que una sesión caída retoma desde el último paso registrado en lugar de volver a pedirse desde cero. - Skills incluidas. Vienen integrados cuatro playbooks:
/plan(basa un plan en tus archivos reales y luego se detiene para pedir aprobación),/grilling(te interroga con una pregunta que fuerza una decisión cada vez),/grill-with-docsy/taste(una lista anti-slop de valores visuales por defecto que conviene evitar). Solo se invocan de forma explícita, así que el agente no recurrirá a/grillpor su cuenta, y un skill se carga solo durante el turno en que lo invocas.
Si quieres un análisis más largo de cómo se está configurando esta categoría, mi artículo sobre la CLI de programación agéntica cubre el panorama. Montar la tuya es un proyecto distinto, y la guía del Claude Code SDK es la comparación más cercana a lo que Meta ha construido aquí.
Para el mercado de herramientas en general, está el resumen de las mejores herramientas de asistente de programación con IA. Quien lo esté comparando con el líder actual debería empezar con la guía del asistente de programación Claude AI.
La lectura honesta sobre Muse Code: el aislamiento de worktree por subagente y un registro de eventos con reproducción exacta son buena ingeniería, y la reacción de un comentarista de Hacker News coincidió con la mía, que «Muse code is more interesting than the new model.» Si supera al arnés que ya usas es algo que una beta y una publicación de blog no pueden responder.
Precio de Muse Spark 1.2 y el intercambio contributor
Meta publica dos IDs de modelo para un solo modelo, y la diferencia entre ellos es la historia.
| ID del modelo | Contexto | Entrada / Mtok | Entrada en caché / Mtok | Salida / Mtok | Política de datos |
|---|---|---|---|---|---|
muse-spark-1.2-contributor | 1M | $0.10 | $0.002 | $0.20 | "Used to improve our products" |
muse-spark-1.2 | 1M | $1.25 | $0.15 | $4.25 | "Not used to improve our products" |
Esas etiquetas son redacción propia de Meta, de su página del modelo. La tarifa estándar no cambia respecto a 1.1, así que si ya pagabas por el modelo anterior, 1.2 es una mejora gratuita en precio.
El nivel contributor tiene límite de tokens en una ventana móvil de 5 horas en lugar de por número de solicitudes, y Meta dice que está disponible en países seleccionados. Meta también señala que ahora acepta solicitudes de retención cero de datos a través de ventas, que es la puerta empresarial del nivel estándar.
Con una mezcla normal de 3:1 entre entrada y salida, eso resulta en $0,125 por millón de tokens con el ID contributor frente a $2,00 con el estándar. 16x, y el tipo de cambio es tu tráfico.
Dos cifras para contrastar. Artificial Analysis midió Muse Spark 1.2 en $0,399 por tarea del Intelligence Index con la tarifa estándar, un 37 % más que los $0,292 de 1.1 porque el modelo piensa más. Si aplicas la misma mezcla de tokens a la tarifa contributor, queda cerca de $0,017 por tarea, lo que estaría por debajo de DeepSeek V4 Flash con $0,027, el modelo más barato de esa tabla. Esa segunda cifra es aritmética mía sobre los costes de tokens por tarea publicados por AA, no un resultado medido, y asume que las escrituras en caché se facturan a la tarifa de entrada, algo que Meta no publica. La comparación con DeepSeek es en la que conviene detenerse, porque ese modelo es de pesos abiertos y puedes ejecutarlo donde nadie entrene contigo. Mi reseña de DeepSeek V4 Flash tiene el panorama completo.
Incluso con la tarifa estándar, el argumento de valor se sostiene. Muse Spark 1.2 puntúa 56,8 en el Intelligence Index a $0,399 por tarea; Claude Opus 5 puntúa 63,1 a $2,34. Seis veces el coste por un once por ciento más de índice. Que ese once por ciento importe depende por completo de tu carga de trabajo, que es el mismo argumento que planteé en alternativas a Claude Opus 5.
Una salvedad sobre la factura de razonamiento: $339,82 de los $639,27 que le costó a Artificial Analysis ejecutar el índice completo se fueron en tokens de razonamiento que nunca ves. El control /effort de Meta lo sube y lo baja, y en tareas sencillas es el primer mando que tocaría. Es la misma partida oculta que hace difícil prever el precio de la API de Anthropic solo a partir de una tarifa publicada.
Qué dicen los desarrolladores
El hilo de lanzamiento reunió 333 puntos y 266 comentarios, y la reacción se dividió en una línea clara: el precio es interesante, la cuestión de la confianza no está resuelta y la dependencia del arnés es real.
Sobre el precio, la lectura fue inmediata:
"If you are happy to share data for training, the contributor mode offers amazing price $0.10 / $0.20"
Otra persona planteó el mismo hecho como una pregunta abierta sobre cuánto valen los datos:
"Very interesting they have a way cheaper "contributor" version "used to improve our products", how much of that is price discrimination vs the data being that valuable? Roughly DeepSeek V4 Flash pricing, though you can get V4 from providers that don't train on your data"
El dato más afilado para quien planee usar el modelo fuera del agente de Meta vino de un desarrollador que probó exactamente eso:
"It's useless. Tried with OpenCode + OpenRouter and it couldn't complete an simple task. It stuck using grep/search tools. I think Muse Spark was so heavily RL'd on the Meta harness that it make it useless or very token inneficient to use in other harness like Opencode."
Es la prueba de una sola persona y choca directamente con la afirmación de Meta de que entrenó con múltiples arneses para que el modelo «still generalizes to other coding agents you already use.» No consideraría ninguna de las dos cosas zanjada. Lo trataría como lo primero que hay que probar, con una pequeña prueba de pago en tus propias herramientas, antes de pasar un flujo de trabajo a él. El mismo consejo vale para cualquier modelo específico de dominio ajustado a fondo a un solo entorno.
Otro comentarista midió en OpenRouter un rendimiento de unos 150 tokens por segundo, lo cual es rápido para esta clase. La propia API acepta solicitudes en formato OpenAI, así que cambiarla es sobre todo un cambio de URL base, el mismo tipo de migración que se cubre en API de OpenAI vs Anthropic.
Y la línea de «acceso global ampliado» recibió una contradicción rotunda de al menos un usuario, que informó de que el nivel contributor seguía siendo solo para EE. UU. La redacción de Meta es más estrecha que el titular: el ID barato está «available in select countries», que no es la misma promesa que un modelo disponible globalmente.
Los pesos abiertos llegan, sin fecha
Cuatro días después del lanzamiento, el Chief AI Officer de Meta hizo el anuncio que mucha gente llevaba tres generaciones de modelos esperando:
"1/ big announcement today: we will be releasing an open weight version of muse spark 1.2 soon. we also are releasing muse glimmer, a 30B agentic model with open weights under apache 2.0. muse glimmer can run on 24GB of VRAM without losing agentic reliability. 🧵"
Glimmer se lanzó. Los pesos de Spark 1.2, no, y «soon» no trae licencia ni fecha. Yo planificaría con lo que realmente se puede descargar hoy, que es Glimmer en 30B bajo Apache 2.0, y trataría Spark de pesos abiertos como una grata sorpresa si llega. Meta tiene antecedentes de lanzar antes lo adyacente: el mismo patrón apareció con Muse Image.
Si los pesos abiertos son toda la razón por la que lees esto, Qwen3.8 Max es la alternativa seria disponible hoy. La comparación DeepSeek vs Kimi K3 es la que leería antes de elegir entre los otros dos.
Entonces, ¿quién debería usar Muse Spark 1.2?
Dónde aterriza, tras una semana con las cifras:
- Vale la pena probarlo si ejecutas trabajos agénticos largos con presupuesto ajustado. El salto en el índice agéntico es real, el contexto es un 1M genuino y, a $0,40 por tarea con la tarifa estándar, cuesta aproximadamente una sexta parte de Opus 5. El caso de estudio de optimización de kernels muestra la forma honesta: con más de 1.000 llamadas a herramientas y hasta 24 horas, Muse Spark 1.2 alcanzó +68,7 % sobre la línea base, cuarto de seis, por detrás de Opus 5 con +74,0 %, GPT-5.6 Sol con +71,2 % y Opus 4.8 con +69,6 %. Si lees la curva en lugar del punto final, también arranca más despacio: estaba cerca del 27 % con 200 llamadas a herramientas mientras Opus 5 ya superaba el 60 %. Llega. Toma el camino largo.
- Vale la pena probarlo si tu código no es sensible. El nivel contributor tiene precio de modelo de pesos abiertos y Meta te dice exactamente con qué pagas. Para proyectos personales, trabajo OSS y prototipos desechables es un sí directo.
- Probablemente no, si necesitas lo más alto de la tabla. Opus 5 lidera todos los gráficos que Meta publicó, incluido el interno de Meta. GPT-5.6 Sol también está por delante en el índice. Si lo que te falta es velocidad bruta y no inteligencia, Gemini 3.6 Flash es la respuesta más barata.
- Probablemente no, todavía, si te comprometes con un arnés. Las mejores cifras de programación vienen de la pareja con Muse Code, Muse Code está en beta y el único informe público de ejecutar el modelo en otro sitio fue malo. Esa combinación aconseja una prueba, no una migración.
- No por sí solo, si el trabajo es atención al cliente. La caída de precisión junto con la caída de alucinaciones es exactamente el equilibrio que importa a una carga de soporte, y ninguna de las dos cifras se puede corregir desde la API. Las opciones que de verdad aguantan en una cola están en mi resumen de los mejores agentes de IA, y el marco de presupuesto está en coste del servicio de atención al cliente con IA.
Prueba eesel
Ese último punto es donde quiero terminar, porque es el error que veo cometer a los equipos cada trimestre. Un lanzamiento de modelo como este hace que un proyecto de automatización de soporte parezca una decisión de precio. No lo es. Entre muse-spark-1.2 y una IA que pueda responder con seguridad a un cliente real están la recuperación sobre tu propio contenido, los umbrales de confianza, las reglas de escalado y una forma de saber qué hará antes de que lo haga. Esa es la diferencia entre un agente de IA y un chatbot, y es donde vive realmente el proyecto.
eesel es esa capa. Se conecta al helpdesk que ya usas, aprende de tus propios tickets resueltos en lugar de un rastreo web genérico y simula primero sobre tu historial de tickets para que veas la tasa de resolución y las respuestas antes de que un solo cliente las vea. Ese paso de simulación existe porque he visto a un bot de apariencia segura dar respuestas equivocadas en silencio, y una tasa de alucinación del 33 % no es una cifra que quieras descubrir en producción.

Si estás evaluando modelos porque tu cola se ahoga, empieza por el otro extremo. Ejecuta una simulación sobre tus últimos miles de tickets, mira qué se desvía de verdad y luego discute sobre tokens. Gratis para probar y sin tarjeta para empezar.
Dos lecturas más si estás en una fase más temprana de esa decisión. Mi artículo sobre el mejor LLM para soporte cubre bien la elección del modelo. Para el caso de negocio, las cifras están en coste de un agente de IA vs un agente humano.
Preguntas frecuentes
¿Cuánto cuesta Meta Muse Spark 1.2?
muse-spark-1.2 cuesta $1,25 por millón de tokens de entrada, $0,15 en caché y $4,25 de salida, idéntico al precio de Muse Spark 1.1. El ID muse-spark-1.2-contributor cuesta $0,10 de entrada, $0,002 en caché y $0,20 de salida, y la página del modelo de Meta indica que el tráfico se usa para mejorar sus productos. Los tokens de razonamiento se facturan a la tarifa de salida en ambos.