

Resumen rápido
Meta lanzó Muse Spark 1.3 el 2 de septiembre de 2026, aproximadamente cuatro semanas después de la versión 1.2, dentro de su agente de codificación Muse Code y la API de modelos de Meta. Es un salto real: se sitúa en el puesto #6 de 636 modelos en el Índice de Inteligencia de Artificial Analysis, con una ventana de contexto de 1 millón de tokens y entrada de texto, imagen y video.
La lectura honesta sobre dónde gana es la siguiente: el contexto largo y la codificación son las ganancias reales. Registra una recuperación de contexto largo casi perfecta (98,5 y 98,1) y gana en cada fila de codificación en la propia tarjeta de puntuación de Meta. Sin embargo, en los benchmarks puros de agentes, Opus 5 (max) todavía lidera en cuatro de seis. Además, las cifras principales tienen un truco: la tarjeta de puntuación de Meta compara el modo max de 1.3 (que todavía está restringido por pruebas de seguridad en el lanzamiento) con el modo xhigh de 1.2, por lo que parte del salto es un cambio de nivel de razonamiento y no un salto generacional limpio. También es aproximadamente tres veces más prolijo que la versión 1.2.
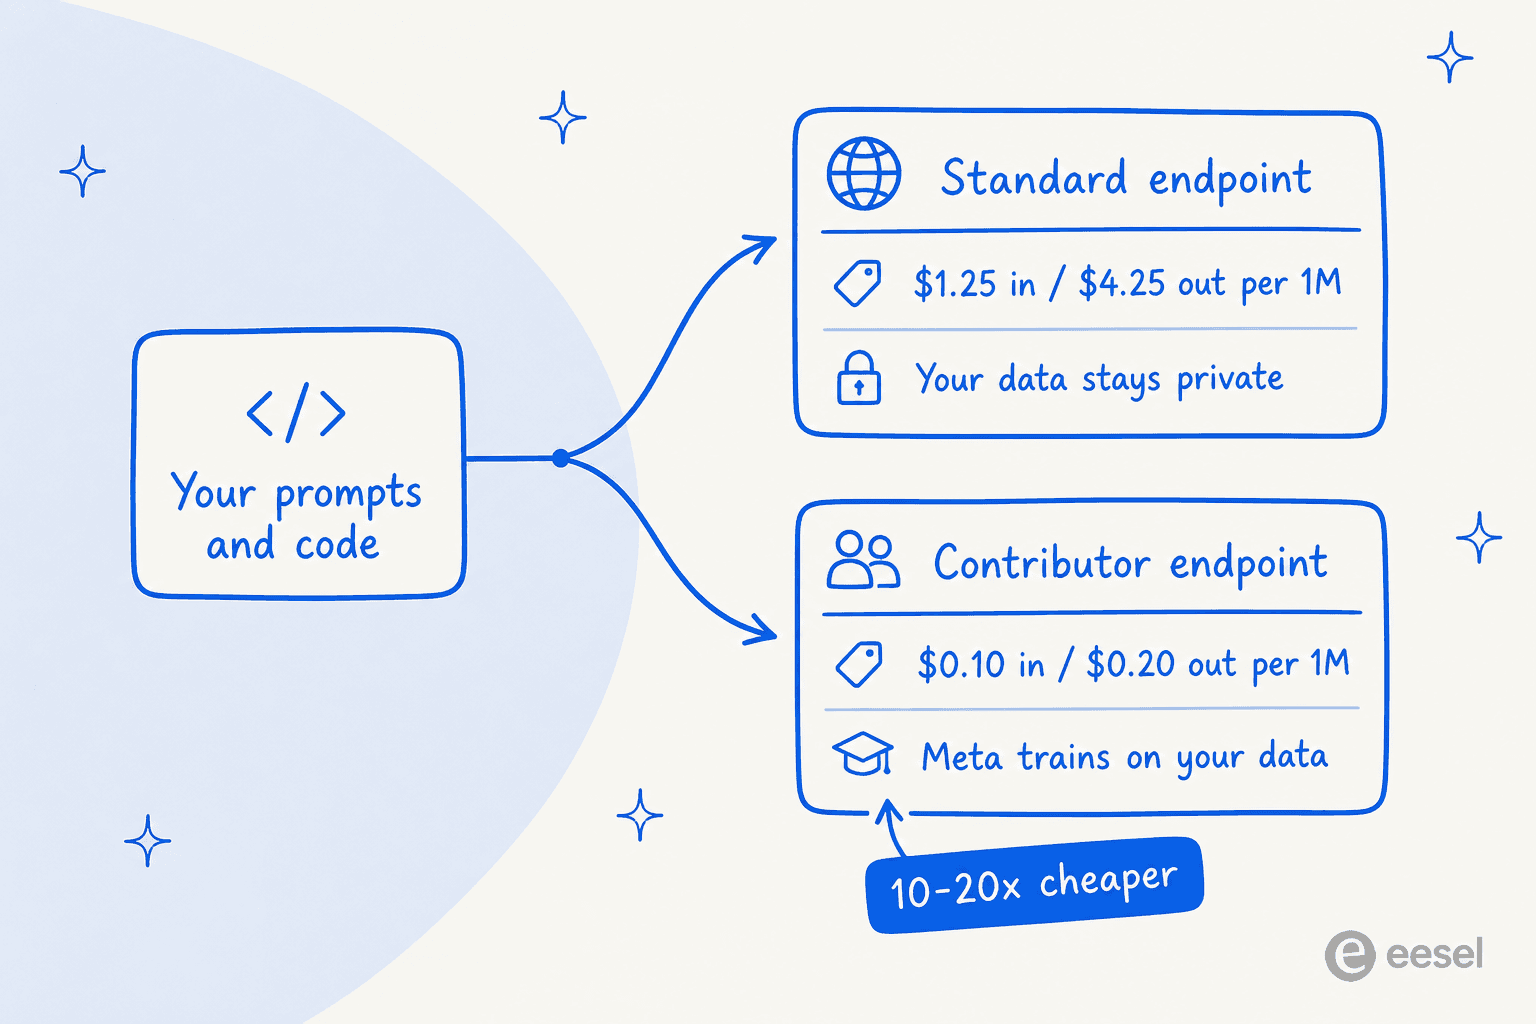
El precio es la parte más comentada. El punto de conexión estándar cuesta 1,25 $ / 4,25 $ por cada millón de tokens; un punto de conexión para "colaboradores" es aproximadamente entre 10 y 20 veces más barato si permite que Meta entrene con sus datos. Independientemente de lo que elija, un modelo básico es infraestructura, no un trabajador terminado. Si lo que realmente desea es un agente de soporte o un redactor de blogs que ya conozca su negocio, ese es el trabajo que un compañero de IA como eesel AI realiza por encima de modelos como este.
Qué es realmente Muse Spark 1.3
Me gano la vida construyendo sobre estas API de modelos, por lo que lo primero que hago con cualquier lanzamiento es separar el modelo del marketing. Muse Spark 1.3 es el modelo de razonamiento de frontera de pesos cerrados de Meta, y Meta lo posiciona como otro paso "hacia la superinteligencia personal" en su anuncio en el blog de investigación. Se puede acceder a él de dos maneras: a través de Muse Code, el entorno de agente de codificación propio de Meta, o directamente a través de la API de modelos de Meta.
Algunos hechos que vale la pena fijar antes de que comience el ruido de los benchmarks:
- Se distribuye en dos variantes publicadas:
max(el modo de razonamiento superior) yxhigh(más rápido). El blog de Meta señala que el razonamiento max "llegará poco después de que terminemos las pruebas de seguridad adicionales", por lo que el modo totalmente disponible en el lanzamiento es xhigh, no max. - La ventana de contexto es de 1 millón de tokens y acepta texto, imágenes y video como entrada.
- Es un modelo propietario. Artificial Analysis lo clasifica como cerrado y no se anunció el lanzamiento de pesos abiertos, lo que lo coloca en una categoría diferente a la línea Llama abierta de Meta.
Esa división de variantes importa más de lo que parece, y volveré a ella, porque silenciosamente está haciendo mucho trabajo en las cifras de lanzamiento.
Los benchmarks: dónde gana 1.3 y dónde no
Meta encabezó el lanzamiento con una tarjeta de puntuación de cuatro modelos: Muse Spark 1.3, Muse Spark 1.2, GPT-5.6 Sol y Claude Opus 5, en tareas de agente, codificación, seguimiento de instrucciones y contexto largo. Aquí está directamente de la fuente.
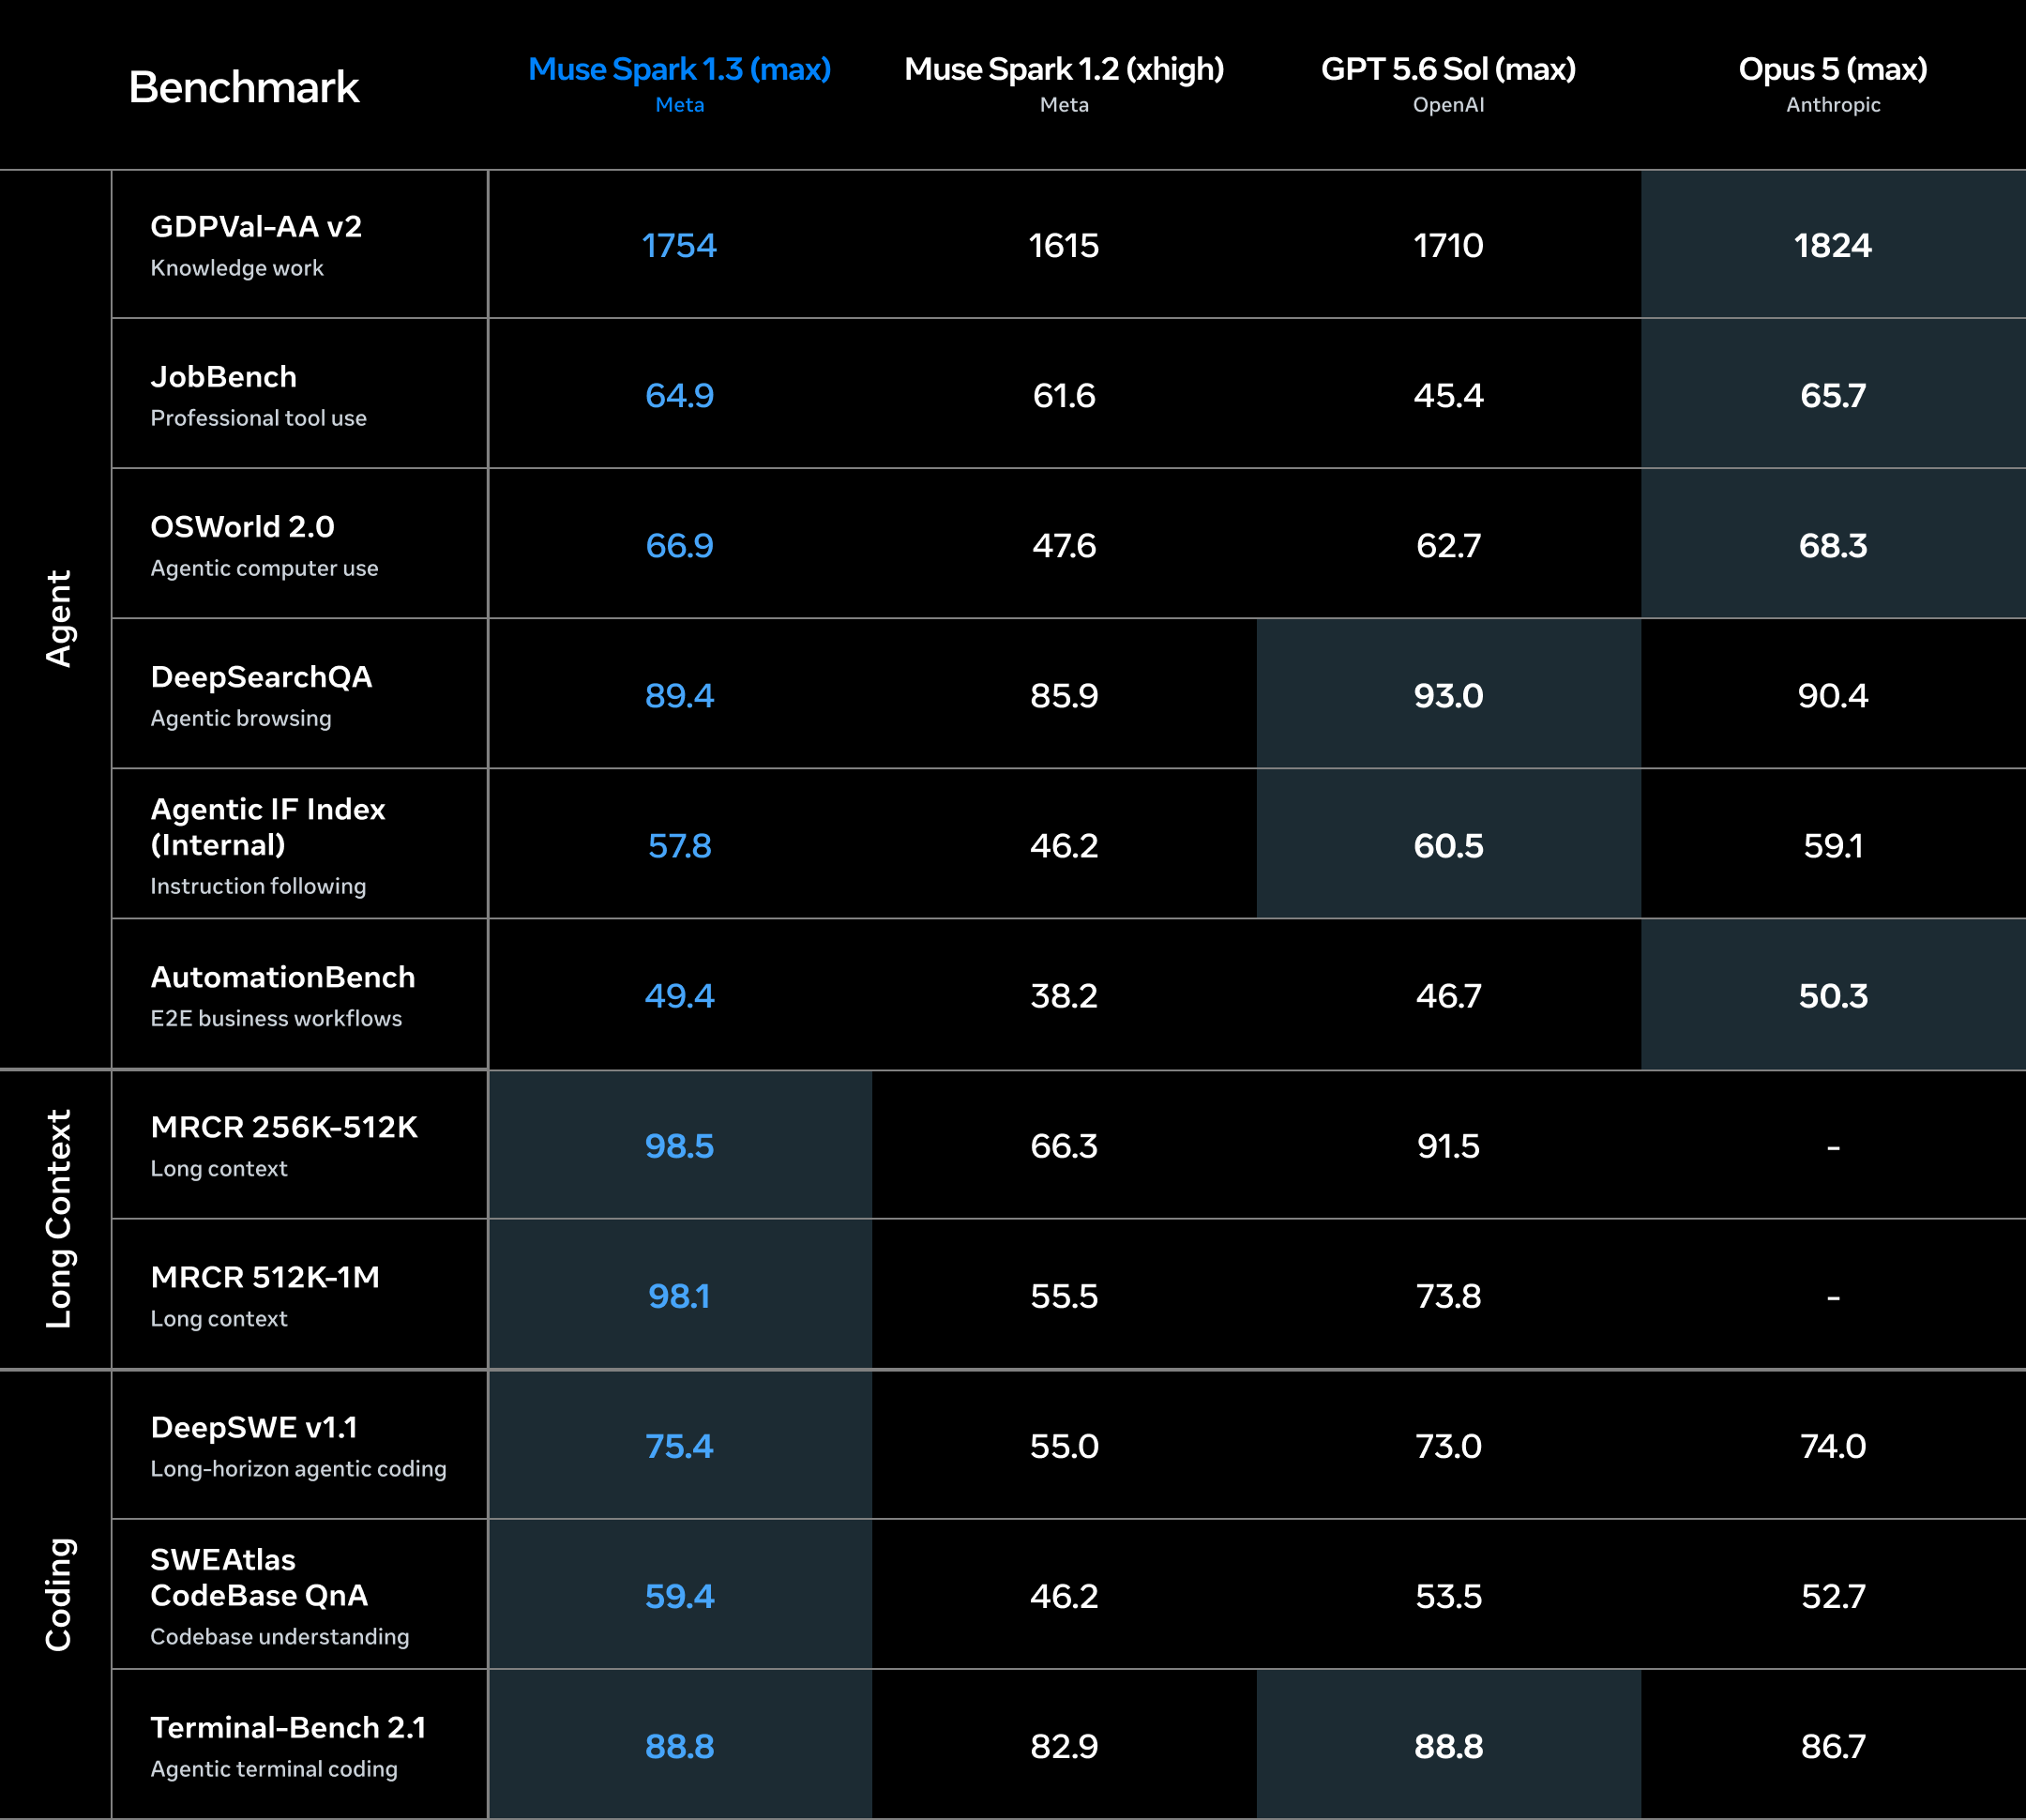
Al leer las filas, aparece un patrón claro, que es más útil que la cifra del titular:
| Benchmark | Muse Spark 1.3 (max) | Muse Spark 1.2 (xhigh) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|---|
| GDPVal-AA v2 (trabajo de conocimiento) | 1754 | 1615 | 1710 | 1824 |
| JobBench (uso de herramientas profesionales) | 64,9 | 61,6 | 45,4 | 65,7 |
| OSWorld 2.0 (uso de computadora) | 66,9 | 47,6 | 62,7 | 68,3 |
| DeepSearchQA (navegación de agentes) | 89,4 | 85,9 | 93,0 | 90,4 |
| Agentic IF Index (seguimiento de instrucciones) | 57,8 | 46,2 | 60,5 | 59,1 |
| AutomationBench (flujos de trabajo E2E) | 49,4 | 38,2 | 46,7 | 50,3 |
| MRCR 256K-512K (contexto largo) | 98,5 | 66,3 | 91,5 | – |
| MRCR 512K-1M (contexto largo) | 98,1 | 55,5 | 73,8 | – |
| DeepSWE v1.1 (codificación de agentes) | 75,4 | 55,0 | 73,0 | 74,0 |
| SWEAtlas CodeBase QnA | 59,4 | 46,2 | 53,5 | 52,7 |
| Terminal-Bench 2.1 (codificación de terminal) | 88,8 | 82,9 | 88,8 | 86,7 |
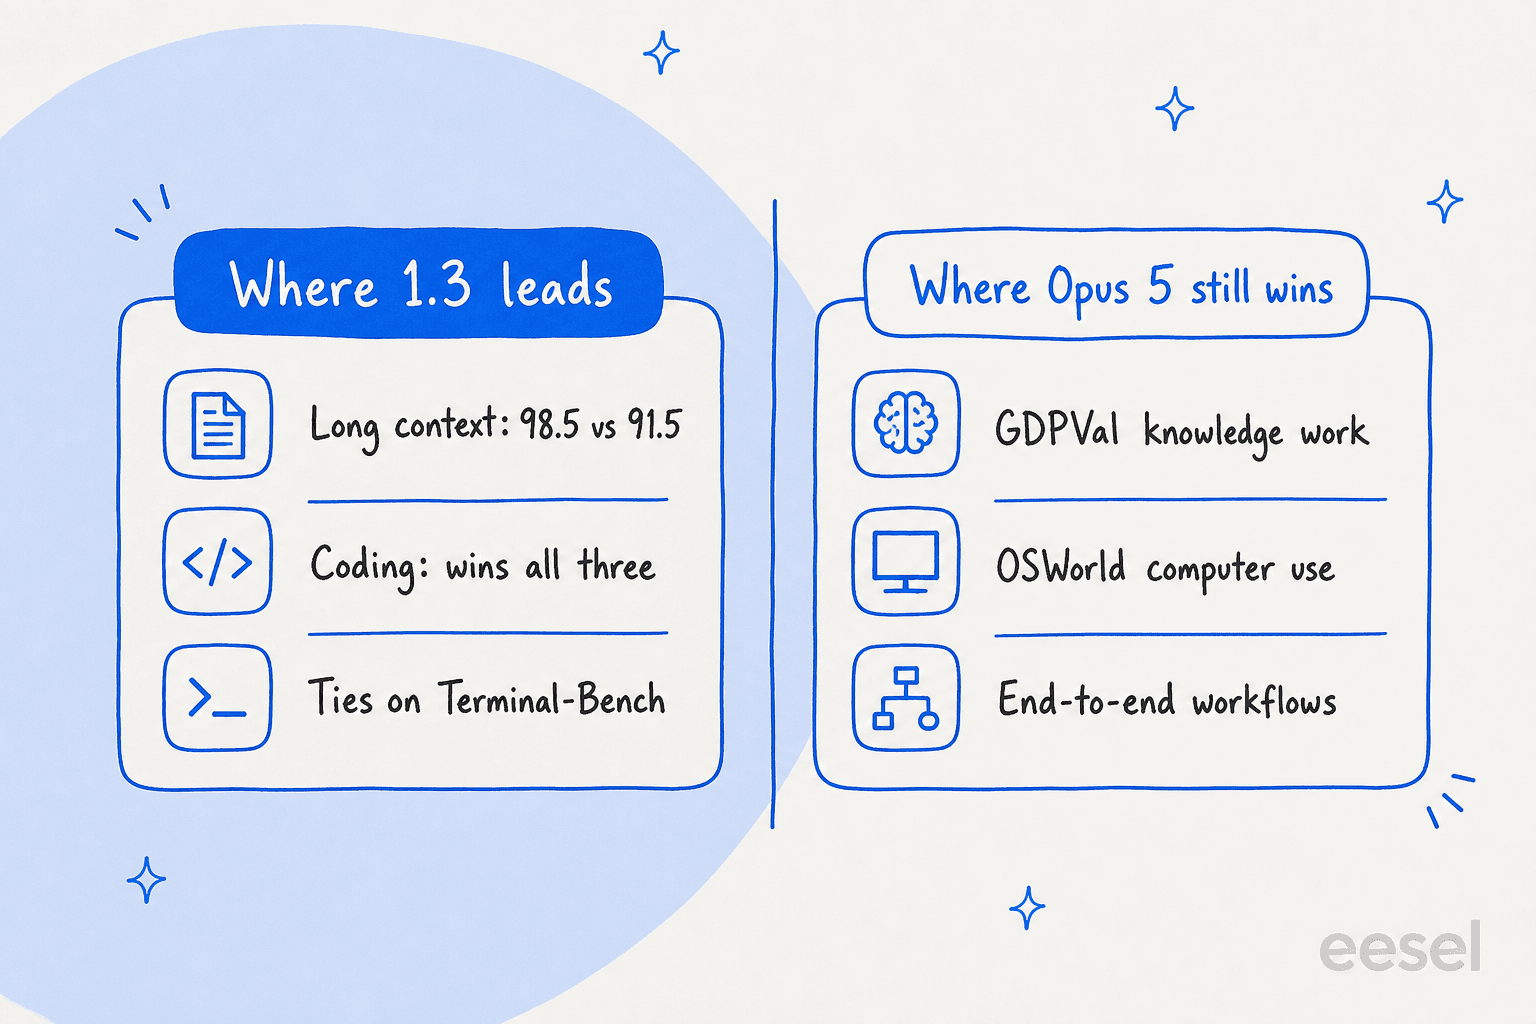
La historia que cuenta la tabla es que Muse Spark 1.3 domina el contexto largo y la codificación. Sus puntuaciones de 98,5 y 98,1 en las pruebas de contexto largo de MRCR no son solo victorias, sino que dejan a GPT-5.6 Sol (91,5 y 73,8) y a su propio predecesor (66,3 y 55,5) muy atrás, mientras que Opus 5 ni siquiera registró una cifra. En codificación, se lleva DeepSWE v1.1 (75,4), comprensión de base de código (59,4) y empata con GPT-5.6 Sol en la cima de Terminal-Bench (88,8). Ese es un resultado real y comprobable, y coincide con la afirmación de Meta de que 1.3 utiliza un 20% menos de llamadas a herramientas y un 25% menos de tokens que la versión 1.2 para terminar un trabajo de codificación.
Pero observe la columna de agentes con honestidad. En los seis benchmarks de agentes, Opus 5 (max) vence a 1.3 en cuatro (GDPVal, JobBench, OSWorld, AutomationBench), y GPT-5.6 Sol se lleva los otros dos (DeepSearchQA, Agentic IF). Por lo tanto, decir que es un "modelo mejorado de agentes y codificación" es justo para la codificación, pero en las evaluaciones de agentes, 1.3 es un sólido segundo lugar, no el líder. En el conjunto, Artificial Analysis sitúa su variante max en un Índice de Inteligencia de 62, ocupando el puesto #6 de 636 modelos, frente a una mediana de 17 para modelos comparables. Es bueno, pero la clasificación es lo suficientemente estrecha como para que un rival pueda recuperarla en una semana, y un comentarista de HN señaló que Gemini 3.8 Flash había mantenido brevemente el primer puesto el mismo día.
El truco en las cifras principales
Aquí hay algo que me gustaría que un colega me señalara. Mire de nuevo los encabezados de las columnas de la tarjeta de puntuación: la columna 1.3 es max y la columna 1.2 es xhigh. Esos son niveles de razonamiento diferentes. Por lo tanto, algunos de los llamativos saltos de 1.2 a 1.3, como el paso de 47,6 a 66,9 en OSWorld o de 66,3 a 98,5 en MRCR, son en parte una brecha entre max y xhigh, no una ganancia pura de versión a versión. Una comparación equitativa de xhigh casi con seguridad estrecharía esas diferencias.
Ese enfoque molestó a la gente. Como dijo un comentarista en el hilo de lanzamiento:
"Es un poco deshonesto que el benchmark solo muestre el razonamiento max".

El truco tiene peso real porque el modo max que sustenta esas puntuaciones principales es el que todavía está bloqueado por las pruebas de seguridad en el lanzamiento. Lo que realmente puede utilizar hoy es xhigh, que obtuvo una puntuación de 61 en el Índice de Inteligencia. No es una brecha enorme con respecto al 62, pero es la cifra honesta para lo que se distribuye ahora.
El segundo asterisco es la verbosidad. Artificial Analysis midió que 1.3 emite 120 millones de tokens de salida para completar el Índice de Inteligencia completo (la mediana del sector es de 72 millones), y las pruebas de la propia comunidad lo situaron en aproximadamente 3 veces el uso de tokens de 1.2. Dado que se paga por token de salida, un modelo que piensa en voz alta 3 veces más no es automáticamente más barato solo porque su precio por token sea bajo. Vale la pena simularlo en su propia carga de trabajo antes de asumir el precio de etiqueta.
Precios: la división entre datos y descuento
Aquí es donde el lanzamiento se puso interesante, y es un movimiento muy al estilo de Meta. Hay dos puntos de conexión para el mismo modelo, y la diferencia de precio se basa totalmente en sus datos.
| Punto de conexión | Entrada / 1M | Salida / 1M | Sus datos |
|---|---|---|---|
| Estándar (xhigh) | 1,25 $ | 4,25 $ | Se mantienen privados, no se usan para entrenamiento |
| Colaborador | ~0,10 $ | ~0,20 $ | Se usan para mejorar los productos de Meta |
Las cifras estándar de xhigh están confirmadas en Artificial Analysis, que también registró un costo de 0,55 $ por tarea del Índice de Inteligencia, 182 tokens/segundo de salida y un tiempo de 38,51 s para el primer token de respuesta. Las cifras del colaborador provienen de usuarios que citan la página de precios de Meta en el hilo de lanzamiento, por lo que debe tratar los centavos exactos como de alta confianza pero no como una verdad absoluta hasta que la página de Meta sea más fácil de leer. En cualquier caso, la brecha es de aproximadamente 10 a 20 veces.
La lectura de la comunidad sobre por qué existe la división fue más aguda que cualquier artículo de prensa:
"No es que Meta realmente quiera tus datos y esté dispuesta a pagar el precio máximo por ellos. Es que las empresas realmente no quieren que Meta tenga sus datos y están dispuestas a pagar el precio máximo por eso".
Ese es el intercambio en una sola frase. El punto de conexión de colaborador es más barato por millón que ChatGPT Luna e incluso que el antiguo DeepSeek V4 Flash, según señaló un comentarista, lo cual es una oferta real para un proyecto de aficionado o un script desechable. Para cualquier cosa que toque datos de clientes o código propietario, el recargo del punto de conexión estándar es el objetivo, no un error. Elija el punto de conexión que coincida con la sensibilidad de la entrada, no solo el que tenga el número más pequeño.
Qué piensa realmente la comunidad
El sentimiento del día del lanzamiento se vivió en Hacker News (391 puntos, 261 comentarios), y fue refrescantemente mixto en lugar de un muro de hype. A las personas que habían usado 1.2 en un entorno de codificación real les gustó la velocidad y el precio, y tenían curiosidad por saber si 1.3 corrige sus hábitos:
"Estoy usando en parte 1.2 para aplicar ingeniería inversa y volver a implementar un binario de un juego antiguo y ha sido bastante bueno y rápido... 1.2 puede quedarse atascado emitiendo resúmenes de pensamiento que suenan similares sin un progreso aparente cuando se le pide que resuelva errores".
Otros no estaban convencidos en absoluto por la generación anterior, lo cual es una advertencia justa contra la lectura de los benchmarks como experiencias vividas:
"Usé Muse Spark 1.2 y no me impresionó en absoluto. Rápido y barato, pero incluso GPT 5.6 Terra se sentía mucho más capaz".
Un consejo práctico surgió repetidamente y vale la pena aplicarlo: Meta entrenó el modelo conjuntamente con su propio entorno, por lo que ejecutarlo dentro de Muse Code en lugar de un agente de terceros tiende a usar menos tokens y turnos. Si lo prueba en el entorno de otra persona y parece caro, esta es parte de la razón.
Cómo diseñó Meta el comportamiento del agente
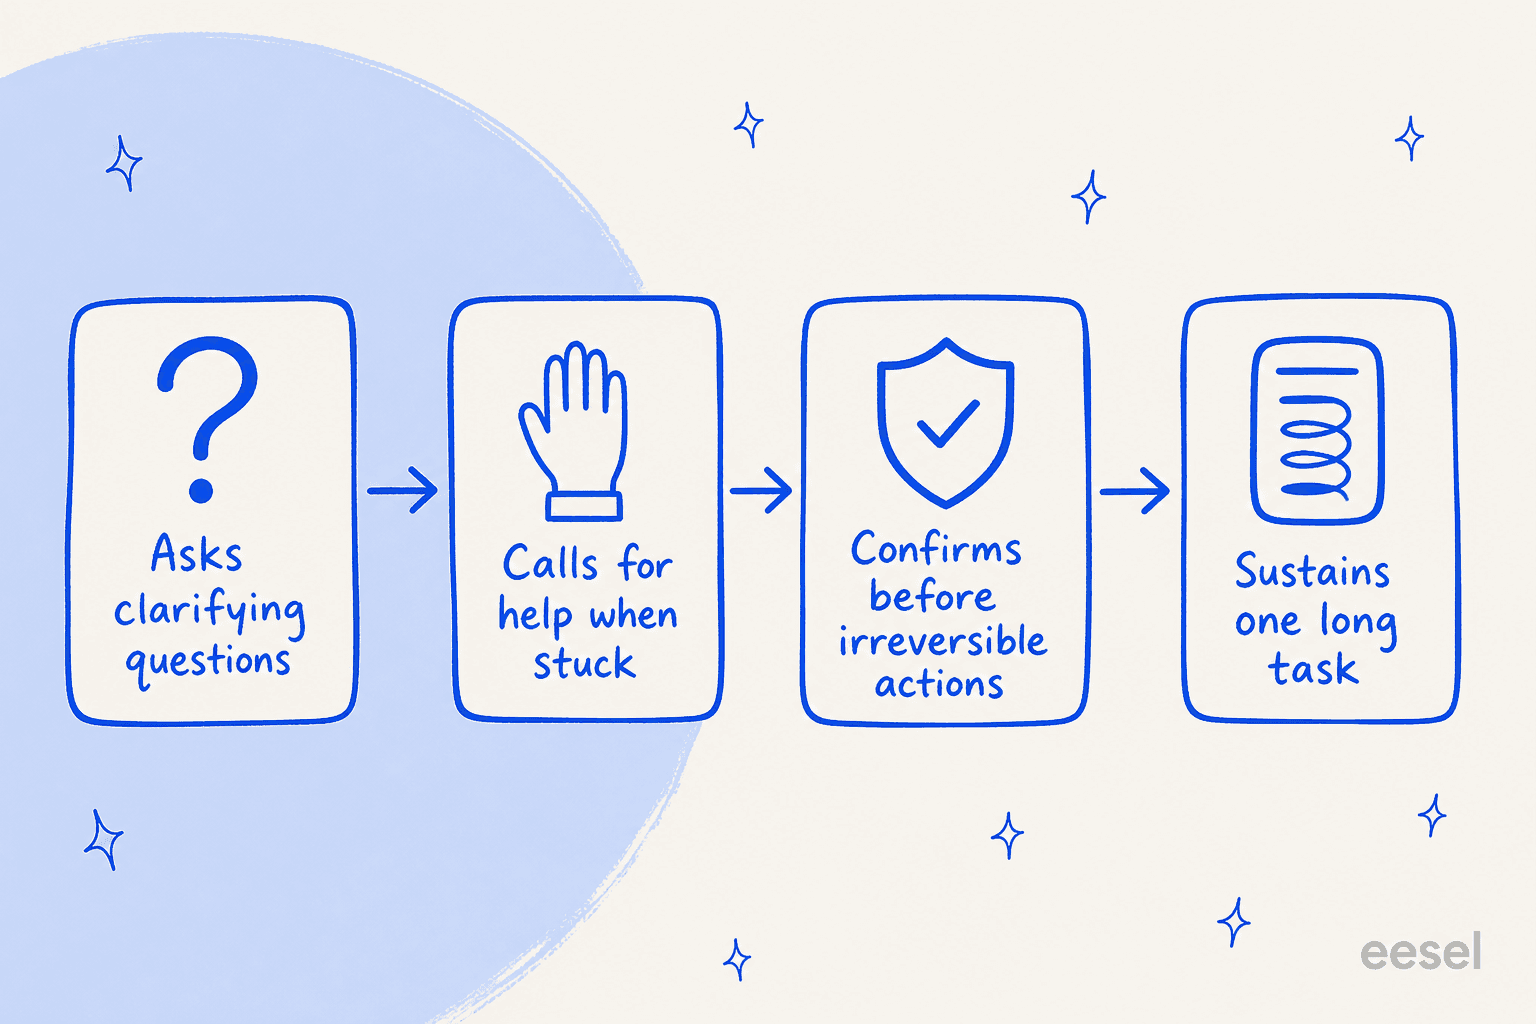
Aparte de los benchmarks, la afirmación de ingeniería más interesante es sobre el comportamiento. Meta dice que 1.3 fue entrenado para comportarse menos como un pasante ansioso y más como uno cuidadoso: hacer preguntas aclaratorias, pedir ayuda cuando está atascado, confirmar antes de acciones consecuentes o irreversibles y mantener un solo hilo largo y desordenado sin perder los requisitos iniciales.
Meta acompaña eso con afirmaciones de seguridad: mayor resistencia a ataques adversarios, mejor resistencia a la inyección de prompts y mejor calibración en torno a acciones irreversibles. Después de haber pasado más de tres años viendo agentes de IA ejecutarse en colas en vivo, interpreto que "confirmar antes de acciones irreversibles" es la línea más importante de todo el anuncio. Un modelo seguro que hace lo incorrecto silenciosamente es peor que uno vacilante que verifica. Esta es exactamente la razón por la que, en los productos en los que trabajo, simulamos cada agente con datos históricos reales antes de que toque a un cliente en vivo, en lugar de confiar en una puntuación de benchmark para predecir el comportamiento en producción.
Ese instinto es también el puente hacia la parte que la mayoría de estas publicaciones de lanzamiento omiten: un modelo fuerte es materia prima, no un trabajador terminado.
De un modelo de frontera a un compañero contratado
Aquí está la visión honesta de un constructor. Muse Spark 1.3 es un gran motor. No es, por sí solo, un empleado. El modelo no conoce su producto, no está conectado a su centro de ayuda ni a su CMS, no ha sido probado contra sus casos límite y no confirmará antes de enviar un correo electrónico a un cliente a menos que usted construya todo eso a su alrededor. Esa brecha entre el "modelo de frontera" y "algo que hace un trabajo" es la capa completa que eesel AI existe para llenar.
La forma en que yo lo plantearía es la siguiente: modelos como este son la infraestructura; eesel AI es el compañero que usted contrata por encima de ella. Usted no elige el modelo, no configura las integraciones ni escribe el entorno de seguridad. Usted contrata a un compañero listo para trabajar para un rol específico, y este llega portando ya las habilidades, las integraciones y el contexto de la empresa para ese trabajo.
Pruebe eesel AI
Si está leyendo esta publicación porque está decidiendo qué construir con Muse Spark 1.3, ese es el momento para el que se creó eesel AI. eesel AI es una plataforma de compañeros de IA: en lugar de una API de modelo básico, usted contrata a un compañero listo para trabajar en un puesto definido. Hoy, esa plantilla incluye un compañero de centro de ayuda de IA que se une a su cola de soporte, busca pedidos y redacta o envía respuestas dentro de su centro de ayuda existente, y un redactor de blogs con IA que investiga y redacta publicaciones de formato largo como esta.
El diferenciador concreto es la parte que un modelo básico no puede darle: el compañero del centro de ayuda se simula con sus propios tickets anteriores antes de entrar en funcionamiento, para que pueda ver cómo habría manejado conversaciones reales en lugar de esperar que una puntuación de benchmark se traslade a la realidad. Se conecta a sus herramientas en minutos, tiene un plan gratuito con 50 $ de prueba y el precio es de 0,40 $ por ticket o sesión de chat y 4,00 $ por publicación de blog (sin mínimos mensuales ni tarifas de plataforma), por lo que un modelo prolijo que piensa en voz alta no es su problema a la hora de calcular el precio.