

Resumen
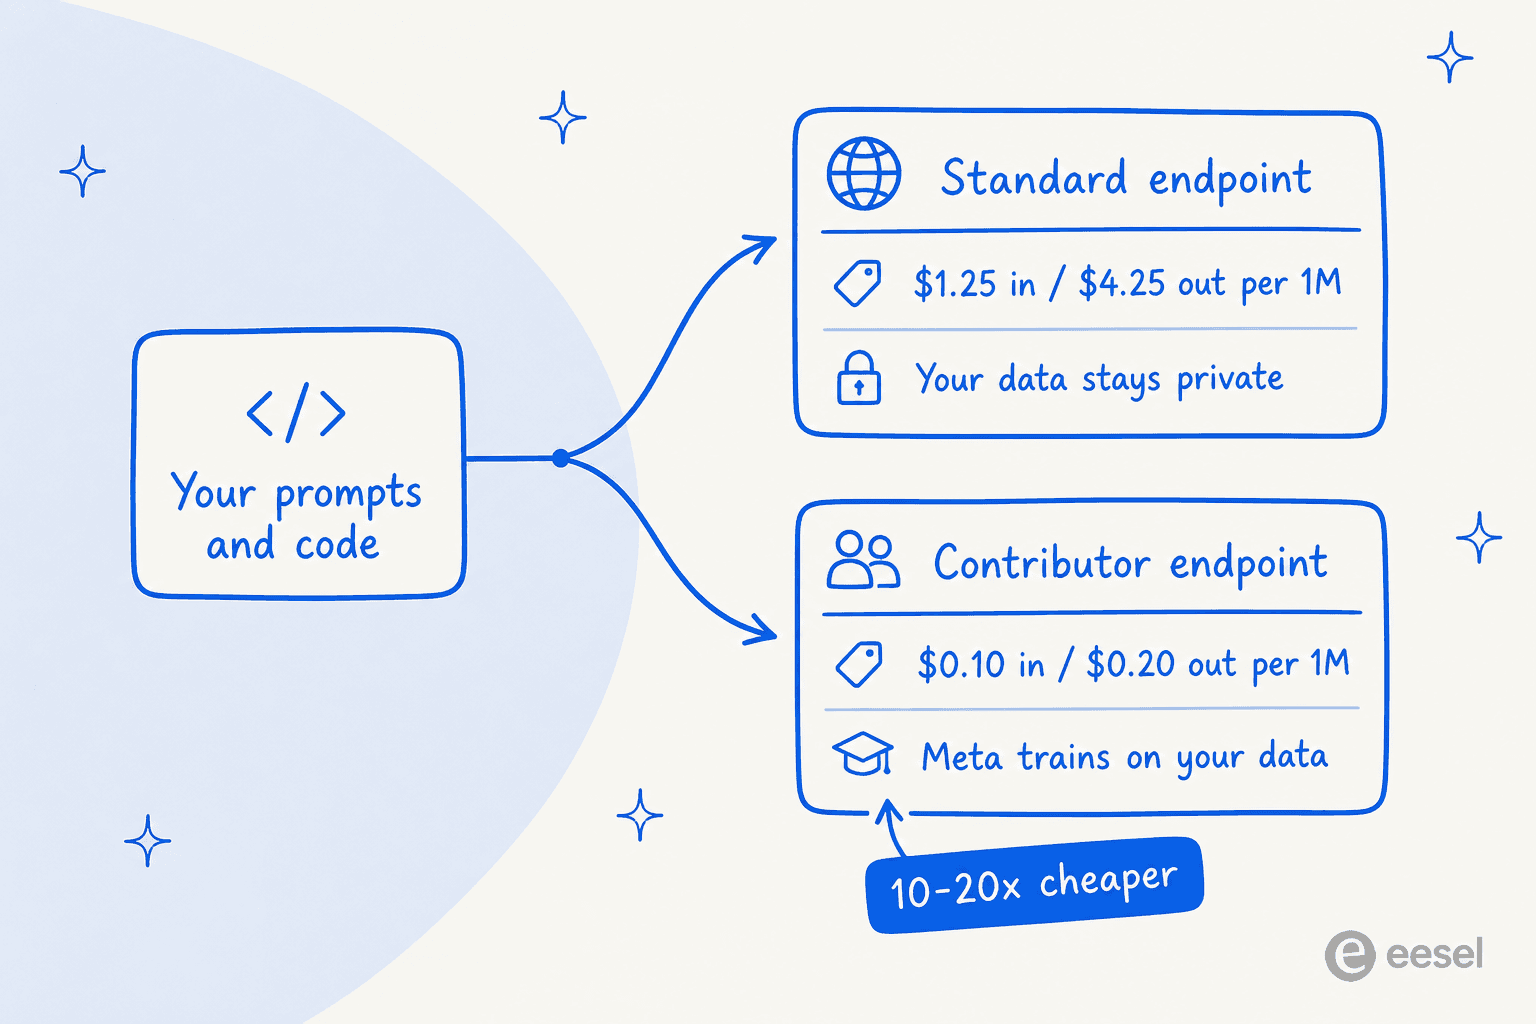
El modelo Muse Spark 1.3 de Meta tiene dos precios para el mismo modelo, y la diferencia entre ellos radica enteramente en sus datos. El endpoint estándar cuesta $1.25 por cada millón de tokens de entrada y $4.25 por cada millón de salida en el nivel xhigh, manteniendo su tráfico privado. El endpoint de contribuidor cuesta aproximadamente $0.10 / $0.20 por millón, unas 10 a 20 veces más barato, a cambio de que Meta entrene con lo que usted envíe.
El precio de lista es solo la mitad de la historia. Muse Spark 1.3 es inusualmente verboso, por lo que una tarifa baja por token puede producir una factura alta por tarea. Artificial Analysis calcula que el endpoint estándar tiene un costo combinado de unos $0.78 por cada millón de tokens y aproximadamente $1.37 para terminar una tarea del Intelligence Index, además de un descuento de caché del 88% que vale la pena conocer.
He pasado dos años viendo cómo los equipos eligen un modelo basándose en su precio de entrada y luego se sorprenden con la línea de salida en la factura. Así que, aquí va la opinión honesta para desarrolladores: una API de modelo puro es un centro de costos que debe gestionar token por token. Si lo que realmente desea es un agente de soporte o un redactor de blogs que haga un trabajo por un precio predecible, ahí es donde se sitúa un compañero de IA como eesel AI, facturando por resolución en lugar de por token.
Por qué paga realmente
Lo primero que hay que aclarar es que el "precio de Muse Spark 1.3" no es un número único. Meta ofrece el mismo modelo a través de dos endpoints en la API de modelos de Meta, y sus precios son muy distintos.
| Endpoint | Entrada / 1M | Salida / 1M | Sus datos | Ideal para |
|---|---|---|---|---|
| Estándar (xhigh) | $1.25 | $4.25 | Se mantienen privados, no se usan para entrenamiento | Producción, datos de clientes, código propietario |
| Contribuidor | ~$0.10 | ~$0.20 | Se usan para mejorar los productos de Meta | Proyectos personales, scripts desechables, tareas por lotes no sensibles |
Las tarifas estándar de xhigh están confirmadas en Artificial Analysis y se mantuvieron estables respecto a Muse Spark 1.2 en lugar de subir con la nueva versión, lo cual es una buena noticia. Las cifras del contribuidor provienen de usuarios que citan la propia página de precios de Meta en el hilo de lanzamiento, así que considere los centavos exactos como de alta confianza pero no como una verdad absoluta hasta que esa página sea más fácil de leer. De cualquier modo, la diferencia es de aproximadamente 10 a 20 veces, y es la decisión de precios más importante que tomará con este modelo.
La lectura de la comunidad sobre por qué existe esta división fue más aguda que cualquier artículo de prensa:
"No es que Meta realmente quiera sus datos y esté dispuesta a pagar una fortuna por ellos. Es que las empresas realmente no quieren que Meta tenga sus datos y están dispuestas a pagar una fortuna por eso."

Ese es el intercambio resumido en una frase. La prima del endpoint estándar no es un impuesto, es el producto. Elija el endpoint que coincida con la sensibilidad de la entrada, no el que tenga el número más pequeño.
Estime su factura mensual
Los precios de lista son abstractos hasta que introduce su propio volumen, así que aquí tiene una calculadora. Ingrese aproximadamente cuántos millones de tokens procesa cada mes, elija un endpoint y la herramienta hará la aritmética tanto para la entrada como para el lado de la salida, que es notoriamente pesado.
Preste especial atención al campo de salida. Debido a que Muse Spark 1.3 depende mucho de los tokens de salida, y la salida cuesta 3.4 veces más que la entrada, esa casilla moverá su factura mucho más que la de entrada. Esto nos lleva a la parte que el precio de lista oculta.
El impuesto por verbosidad
Aquí está el truco que no aparece en ninguna página de precios. Muse Spark 1.3 piensa mucho en voz alta. Artificial Analysis midió que emite 140 millones de tokens de salida para completar el Intelligence Index completo, frente a una mediana de la industria de unos 90 millones, y las propias pruebas de la comunidad en el lanzamiento lo situaron en aproximadamente el triple del uso de tokens de la versión 1.2.
Usted paga por token de salida. Por lo tanto, un modelo con una tarifa de salida baja que genera una montaña de tokens no es necesariamente la opción barata. Ejecute el mismo trabajo en un modelo más conciso con una tarifa más alta y el modelo conciso podría ganar en la factura final. Esta es exactamente la trampa que mencioné al principio, y es por eso que el costo por tarea importa más que la tarifa por token. Artificial Analysis sitúa el endpoint estándar en unos $1.37 para finalizar una tarea del Intelligence Index una vez que se tiene en cuenta la verbosidad, junto con una velocidad de salida cercana a 198 tokens por segundo y un tiempo hasta el primer token de unos 29 segundos.
Dos factores ayudan a reducir el costo real:
- El descuento de caché del 88%. Los tokens de entrada repetidos (un aviso de sistema largo, una base de conocimientos que envía en cada llamada) se facturan a una fracción de la tarifa de entrada. Para cargas de trabajo que utilizan agentes o recuperación intensiva y reenvían el mismo contexto, esto representa un ahorro real y considerable.
- El entorno propio de Meta. Meta entrenó el modelo junto con Muse Code, por lo que ejecutarlo dentro de Muse Code tiende a usar menos tokens y turnos que un agente de terceros. Si lo pone a prueba en otro lugar y le parece caro, parte de la razón es el entorno.
La conclusión para su presupuesto: no calcule el precio de este modelo basándose en la tarifa de entrada. Estime su volumen de salida con honestidad, aplique el descuento de caché donde su carga de trabajo repita contexto y realice simulaciones con una parte real de su propio tráfico antes de comprometerse.
El nivel max que aún no puede comprar
Hay un asterisco en los precios que es fácil pasar por alto. Meta publicó sus puntajes de referencia principales en el nivel de razonamiento max, pero max está restringido tras pruebas de seguridad adicionales en su lanzamiento, por lo que el nivel al que realmente puede llamar y pagar hoy es xhigh. Aún no existe un precio estándar público para max.
Esto importa por dos razones. Primero, si presupuesta basándose en los puntajes de lanzamiento, lo está haciendo sobre un nivel que no puede adquirir. Segundo, cuando max esté disponible, espere que cueste más y que sea incluso más verboso que xhigh, ya que más razonamiento significa más tokens de salida a $4.25 por millón. El desglose completo de los puntos de referencia analiza qué parte del salto de 1.2 a 1.3 es realmente una brecha de max frente a xhigh en lugar de un salto generacional neto, lo cual vale la pena leer antes de asumir que los números del nivel superior se aplican a lo que usted está pagando.
Comparativa de precios con otros modelos
Si solo consideramos el precio de lista, el endpoint estándar de Muse Spark 1.3 se sitúa en el segmento de modelos de vanguardia económicos. Aquí tiene una idea de dónde aterriza frente a los modelos con los que la mayoría de los equipos lo comparan. Estas son las tarifas de lista de entrada/salida para un nivel comparable; el costo real seguirá dependiendo de la verbosidad y de su propia combinación de uso.
| Modelo | Entrada / 1M | Salida / 1M | Notas |
|---|---|---|---|
| eesel AI | $0.40 por sesión | $4.00 por blog | Prueba gratuita de $50; sin mínimos mensuales ni cargos de plataforma |
| Muse Spark 1.3 (estándar xhigh) | $1.25 | $4.25 | Muy verboso; 88% de descuento por caché; endpoint de contribuidor ~10-20x más barato |
| Muse Spark 1.3 (contribuidor) | ~$0.10 | ~$0.20 | Meta entrena con sus datos |
| Claude Opus 5 | mayor | mayor | Supera a 1.3 en la mayoría de las evaluaciones de agentes; nivel premium |
| GPT-6 Astra | medio | medio | Estructura de precios diferente; vea su propio desglose |
| Gemini 3.8 Flash | bajo | bajo | Lideró brevemente el mismo índice el día que salió el 1.3 |
| DeepSeek V4 Flash | muy bajo | muy bajo | Abierto, licencia MIT; el verdadero suelo de presupuesto |
| Kimi K3 | medio | medio | Otro competidor de pesos abiertos |
La lectura honesta es que, en el endpoint de contribuidor, 1.3 es más barato por millón que la mayoría de las opciones de vanguardia alojadas, e incluso supera a algunos modelos económicos antiguos, según señaló un comentarista. En el endpoint estándar, tiene un precio competitivo pero no es el más bajo, y la verbosidad significa que el costo efectivo sube más rápido de lo que sugiere el precio de lista. Si su único eje es el precio por token en trabajos no sensibles, el endpoint de contribuidor o un modelo abierto como DeepSeek V4 Flash son difíciles de superar. Si su eje es el precio por trabajo finalizado con datos reales, el cálculo se vuelve más interesante, y esa es la parte en la que conviene detenerse.
Del precio por token al precio por resultado
Aquí está la visión del desarrollador, y es lo que la mayoría de las publicaciones sobre precios omiten. Cada número mencionado arriba es un costo de materia prima, no el costo de realizar un trabajo. El precio de un token le indica cuánto cuesta el motor. No le dice nada sobre conectar el modelo a su centro de ayuda, cargarlo con el contexto de su empresa, probarlo contra casos excepcionales o hacer que pida confirmación antes de enviar un correo a un cliente. Usted construye y paga por todo eso adicionalmente.
Esa brecha es donde vive eesel AI. La forma en que yo lo plantearía es: modelos como Muse Spark 1.3 son la infraestructura, y eesel AI es el compañero que usted contrata sobre ella. Usted no elige un nivel, conecta las integraciones y asume la verbosidad en su propia factura. Usted contrata a un compañero listo para trabajar para una tarea definida, y este llega con las habilidades, integraciones y el contexto de la empresa necesarios para ese rol.
El modelo de precios es la diferencia concreta. eesel AI factura por resolución, no por token, por lo que un modelo que piense en voz alta el triple no es una línea que deba pronosticar en su presupuesto. El compañero de IA para soporte técnico se une a su cola de soporte, busca pedidos y redacta o envía respuestas dentro de su plataforma de ayuda actual, y el redactor de blogs de IA investiga y redacta publicaciones extensas como esta. En ambos casos, el precio que ve está vinculado al trabajo realizado, no a los tokens consumidos.
Pruebe eesel AI
Si está leyendo una publicación sobre los precios de Muse Spark 1.3 porque está decidiendo con qué construir, ese es el momento exacto para el que se diseñó eesel AI. Obtiene un compañero de IA listo para trabajar en lugar de una API de modelo puro, por lo que la matemática por token de arriba deja de ser un problema que deba gestionar.
El diferenciador concreto es la parte que un modelo puro no puede ofrecerle: el compañero para el centro de ayuda se simula contra tickets pasados antes de entrar en funcionamiento, para que vea cómo habría manejado conversaciones reales en lugar de esperar que un puntaje de referencia se traduzca en la realidad. Se conecta a sus herramientas en minutos, la prueba es gratuita con un crédito de $50 (sin cargos de plataforma ni mínimos mensuales) y, debido a que factura por resolución a solo $0.40 por sesión o $4.00 por entrada de blog, un modelo verboso pensando en voz alta no afectará su presupuesto.