

¿Qué es Meta Muse Spark Open?
Construyo agentes de IA para ganarme la vida en eesel, y lo primero que hago con cualquier modelo nuevo es leer la ficha del modelo antes que la publicación de lanzamiento. La ficha del modelo Muse Spark Open en Hugging Face describe un modelo de mezcla de expertos de 816B de parámetros que activa 42B por token, con 256 expertos y 8 activos por token, una ventana de contexto de 1M de tokens y un codificador de visión de 1.8B de parámetros añadido para imágenes y video.
Es el hermano de pesos abiertos de la línea cerrada Muse Spark, no una familia aparte. El mismo nombre Muse también abarca Muse Code, el entorno de programación de Meta, y el agente personal Muse.
La publicación de investigación de Meta lo llama "the most capable US open-weight model to date" y dice que se entrega con posentrenamiento de seguridad adicional porque, una vez que los pesos son públicos, nadie puede añadir barreras de protección desde el servidor. La publicación para desarrolladores añade un detalle que importa en mi mundo: Meta lo entrenó para trabajo de agentes de largo plazo "such as coding and customer service agents."
Algunas especificaciones prácticas de la ficha:
| Especificación | Muse Spark Open |
|---|---|
| Parámetros | 816B totales, 42B activos |
| Contexto | 1M de tokens |
| Entrada | Texto, imagen, video, audio |
| Salida | Texto |
| Esfuerzo de razonamiento | low, medium, high, xhigh (predeterminado xhigh) |
| Pesos | BF16 (unos 1.6TB) y NVFP4 (unos 530GB) |
| Lanzamiento | 15 de octubre de 2026 |
Un detalle a tener en cuenta: el razonamiento siempre está activado. La página del modelo en Groq dice que "always reasons before answering", y el esfuerzo predeterminado es el más caro, xhigh. Si quieres respuestas cortas y baratas, tienes que pedir low o medium tú mismo.
Cómo lo evalué
No he usado este modelo en una cola de soporte durante un año, y no voy a fingir que sí. Esta reseña se basa en la tabla de benchmarks de Meta, los resultados independientes de Artificial Analysis, los datos de precio y velocidad en vivo de cada proveedor de lanzamiento, el texto completo de la licencia y lo que dijeron los desarrolladores en las primeras 72 horas en Hacker News. Donde los números de Meta y los independientes no coinciden, lo digo.
El enfoque que aplico es el que uso en eesel al elegir modelos para el compañero de helpdesk: ¿llama herramientas con fiabilidad?, ¿respeta las reglas? y ¿cuánto cuesta un mes de tráfico real? Llevo años en eesel viendo cómo modelos seguros de sí mismos dan respuestas erróneas en colas reales, y por eso cada implementación de eesel se simula primero con tickets históricos. Una victoria en un benchmark solo importa si se refleja ahí, que es toda la idea detrás de los compañeros de IA probados con tus datos antes de salir en vivo.
Dónde lidera Muse Spark Open
Meta compara el modelo con otros siete modelos de pesos abiertos: Inkling, Nemotron 3 Ultra, Reflection Beam, Mistral Large 4, Qwen 3.8, GLM 5.3 y Kimi K3. Este es el cuadro de resultados tal como lo publicó Meta.
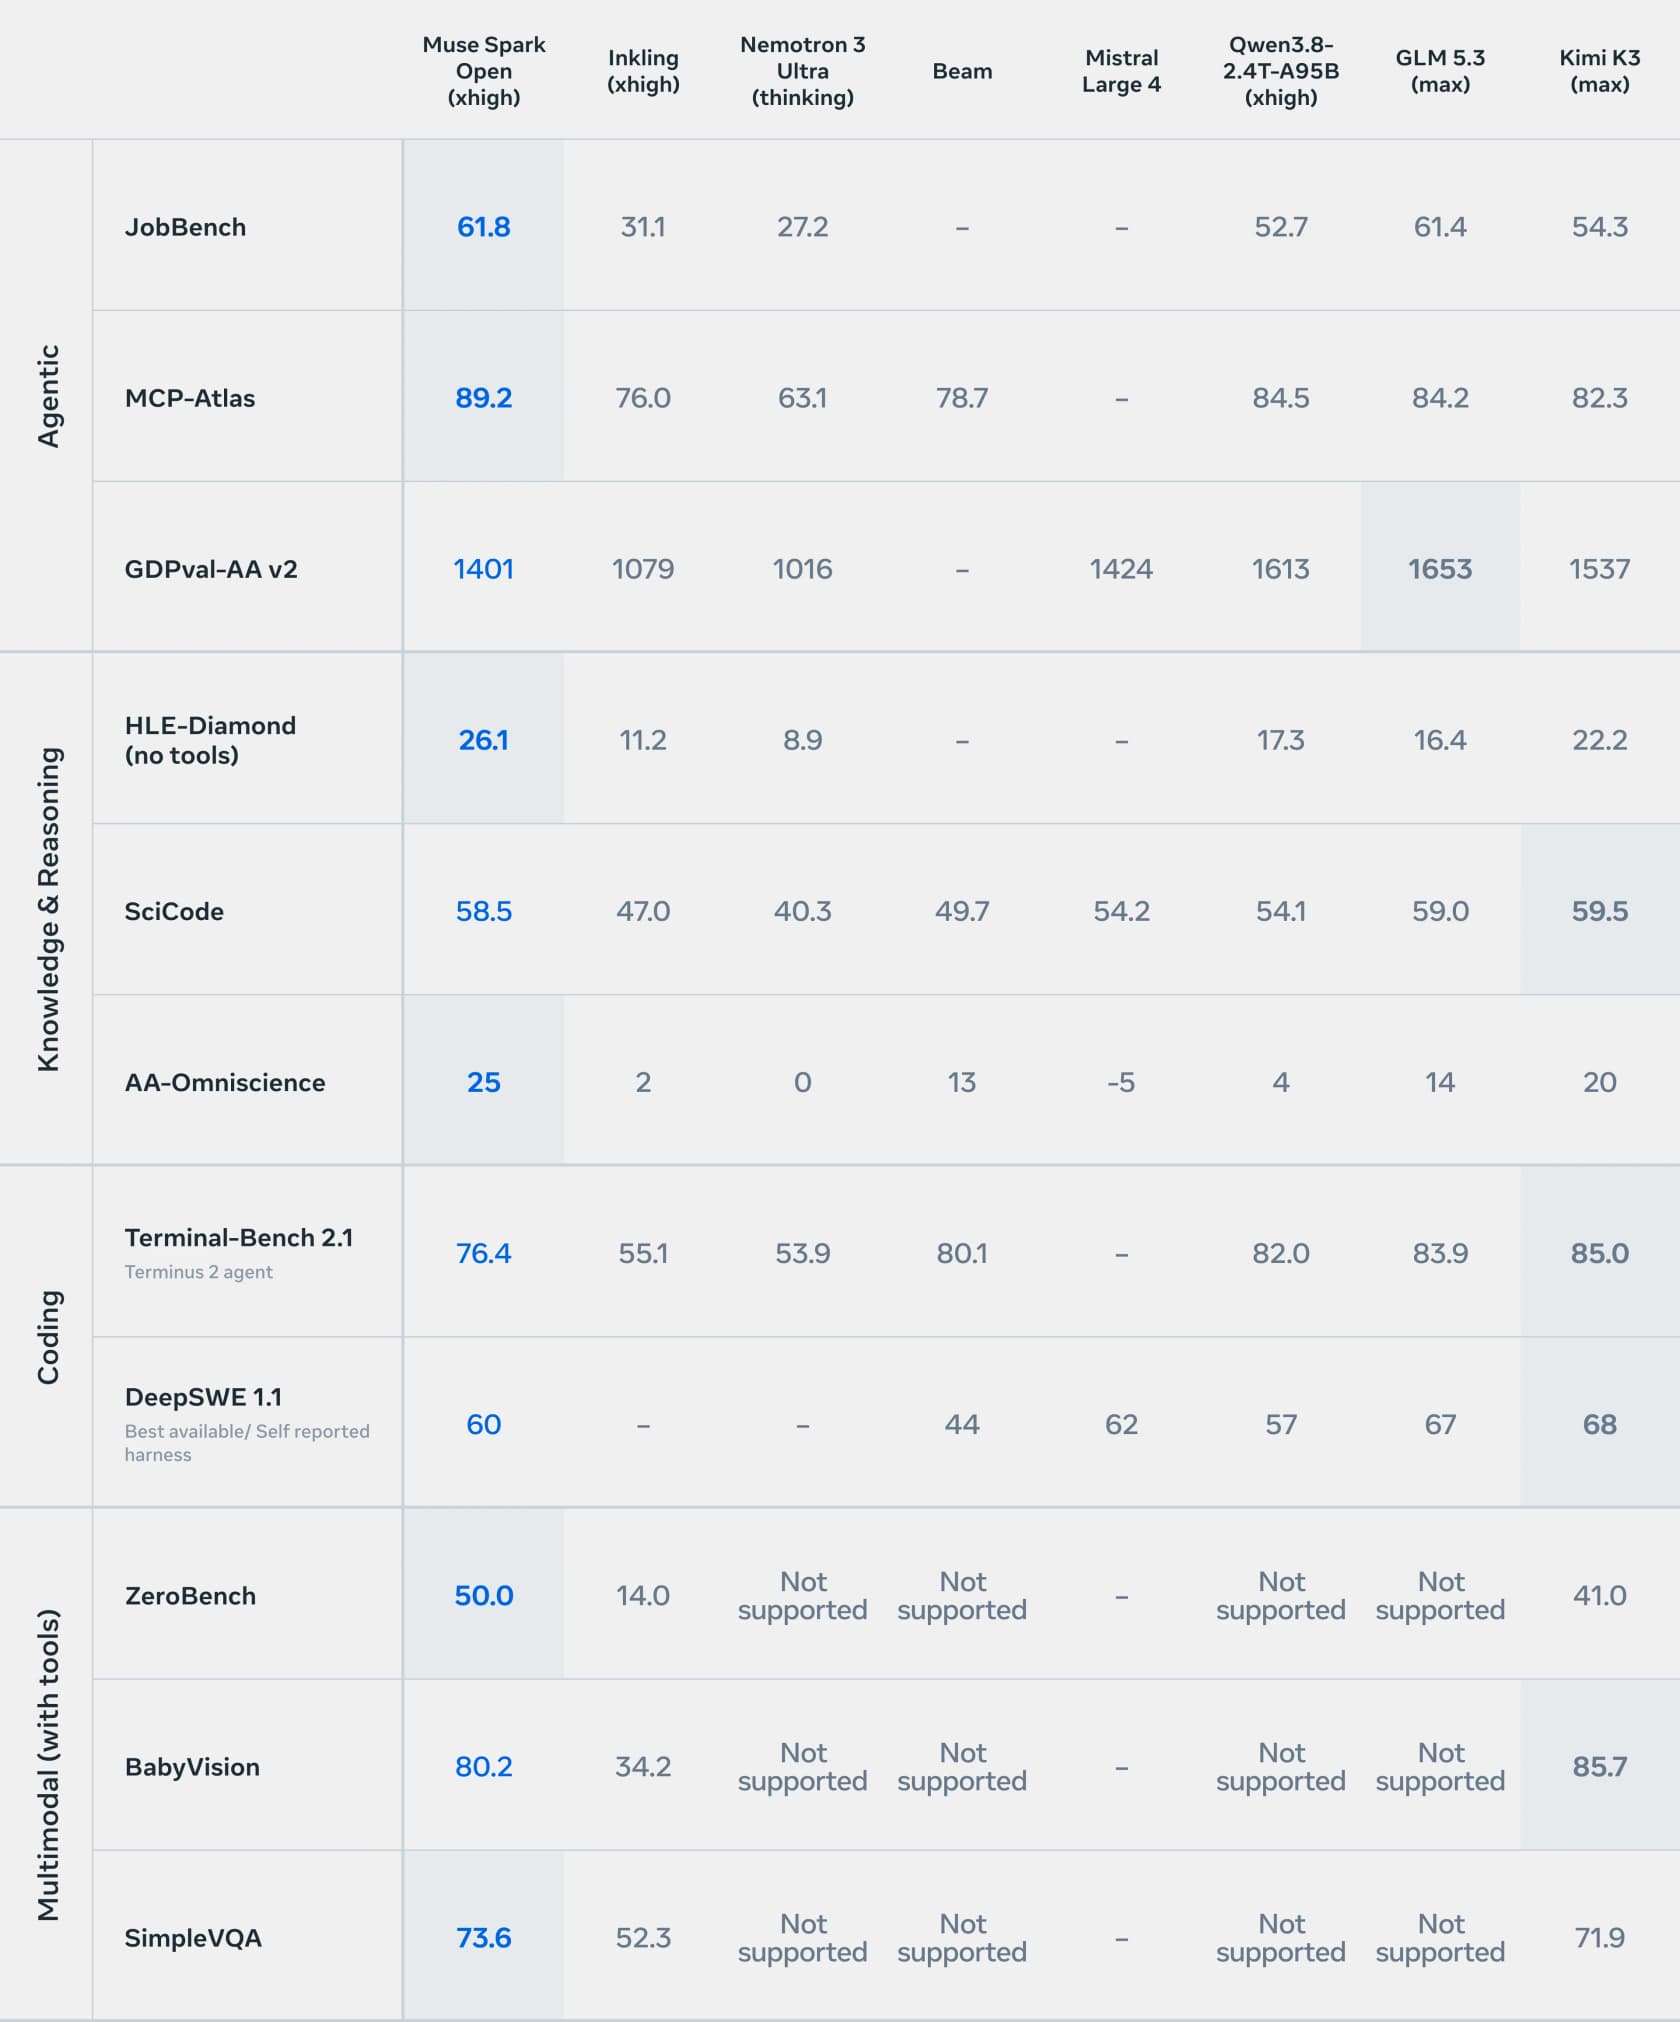
Las victorias son reales y se concentran en un solo lugar: agentes que llaman herramientas.
- MCP-Atlas
89.2, la puntuación más alta de la tabla. Mide la llamada a herramientas expuestas mediante servidores MCP, la infraestructura que hoy usan la mayoría de los agentes para llegar a un helpdesk, un CRM o una base de datos. - JobBench
61.8, superando por poco el61.4de GLM 5.3 y muy por delante del54.3de Kimi K3. - HLE-Diamond
26.1sin herramientas y AA-Omniscience25, lo mejor del conjunto en preguntas difíciles de conocimiento donde se penaliza inventar. - Multimodal: lidera ZeroBench (
50.0) y SimpleVQA (73.6) frente al único otro modelo que admite esas pruebas, Kimi K3.
Los dos socios de lanzamiento que citó Meta coinciden con ese panorama.
"Muse Spark Open consistently selected the right next tool and kept its responses compact, exactly the decisiveness production agents need."
Zimu Li, Member of Technical Staff en Factory, citado en la publicación para desarrolladores de Meta
Los datos independientes coinciden en eficiencia. Artificial Analysis midió 110M de tokens de salida para completar todo su índice, por debajo de la mediana de 130M, y registró 130.7 tokens por segundo. Eso importa porque su hermano cerrado fue en sentido contrario: como conté en mi reseña de Muse Spark 1.3, la 1.3 consumió 120M de tokens y generó quejas por ser verbosa.
Dónde se queda atrás
La misma tabla que lo corona en uso de herramientas lo muestra perdiendo en las categorías que más buscan la mayoría de los desarrolladores.
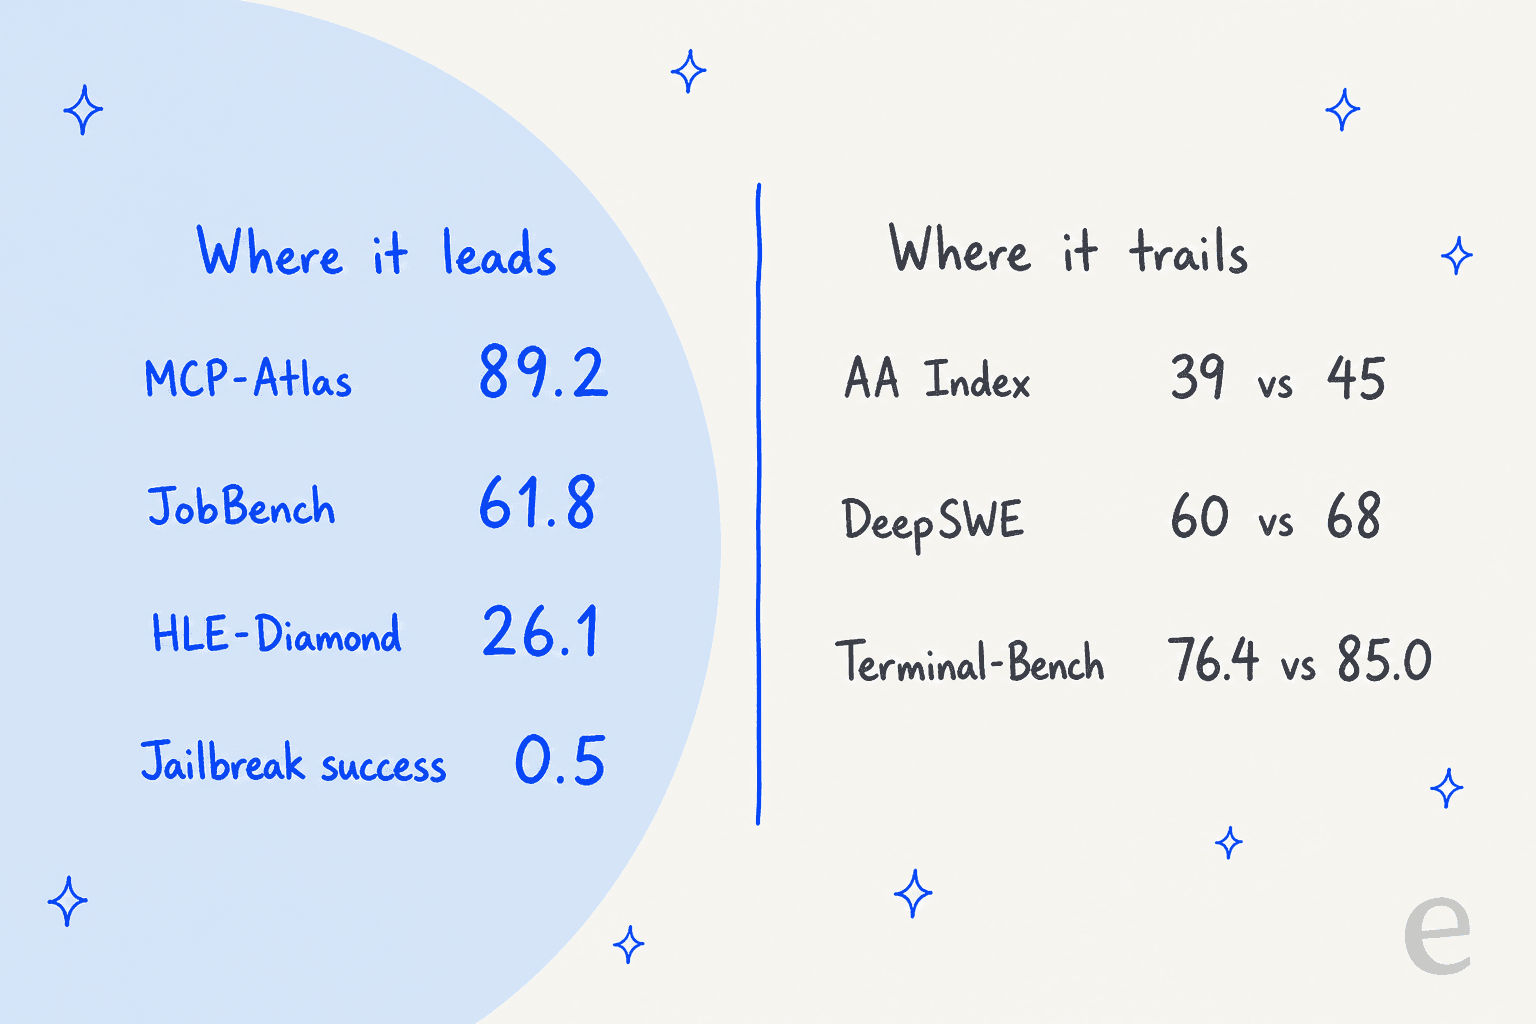
- Inteligencia general. En la fila del Artificial Analysis Intelligence Index de la propia tabla de Meta, obtiene
39, por detrás de GLM 5.3 (45), Kimi K3 (44) y Qwen 3.8 (40), y un punto por encima de Mistral Large 4 (38). Artificial Analysis lo clasifica en el puesto#10de los 120 modelos que sigue. - Programación. En DeepSWE 1.1 obtiene
60frente a68de Kimi K3 y67de GLM 5.3. En Terminal-Bench 2.1 obtiene76.4frente a85.0de Kimi K3. Incluso Reflection Beam lo supera ahí con80.1. - Tareas de trabajo del mundo real. En GDPval-AA v2 obtiene
1401, por debajo de Mistral Large 4 (1424), Kimi K3 (1537), Qwen 3.8 (1613) y GLM 5.3 (1653).
Los desarrolladores lo notaron. La impresión inicial más citada en el hilo de lanzamiento fue breve:
"Feels dumber than GLM 5.3 (only open model I use extensively). But is really fast (fireworks.ai)."

Otro comentarista lo situó entre sus dos hermanos cerrados: "somewhat worse benchmarks than Muse Spark 1.3, closer to 1.2" (modeless, Hacker News). Eso coincide con lo que dicen los números. Si tu trabajo principal es escribir código, Kimi K3 o GLM 5.3 es hoy la mejor opción abierta.
El equilibrio de seguridad que nadie menciona
Meta pone la seguridad por delante, y la cifra principal es llamativa. En StrongREJECT v2, una prueba adaptativa de jailbreak donde menos es mejor, Muse Spark Open obtiene 0.5. Kimi K3 obtiene 66.6, GLM 5.3 62.9 y Qwen 3.8 65.6. La ficha también reporta un 99.2% de rechazo de jailbreaks de ciberseguridad en el benchmark interno de Meta y una tasa de honestidad de 98.1% en MASK.
Pero la misma tabla trae un segundo número que la mayoría de la cobertura omitió. FORTRESS reporta dos puntuaciones: un puntaje de riesgo adversarial (ARS, con qué frecuencia da ayuda dañina) y un puntaje de sobrerrechazo (ORS, con qué frecuencia rechaza cosas que debería responder). En ambas, menos es mejor.
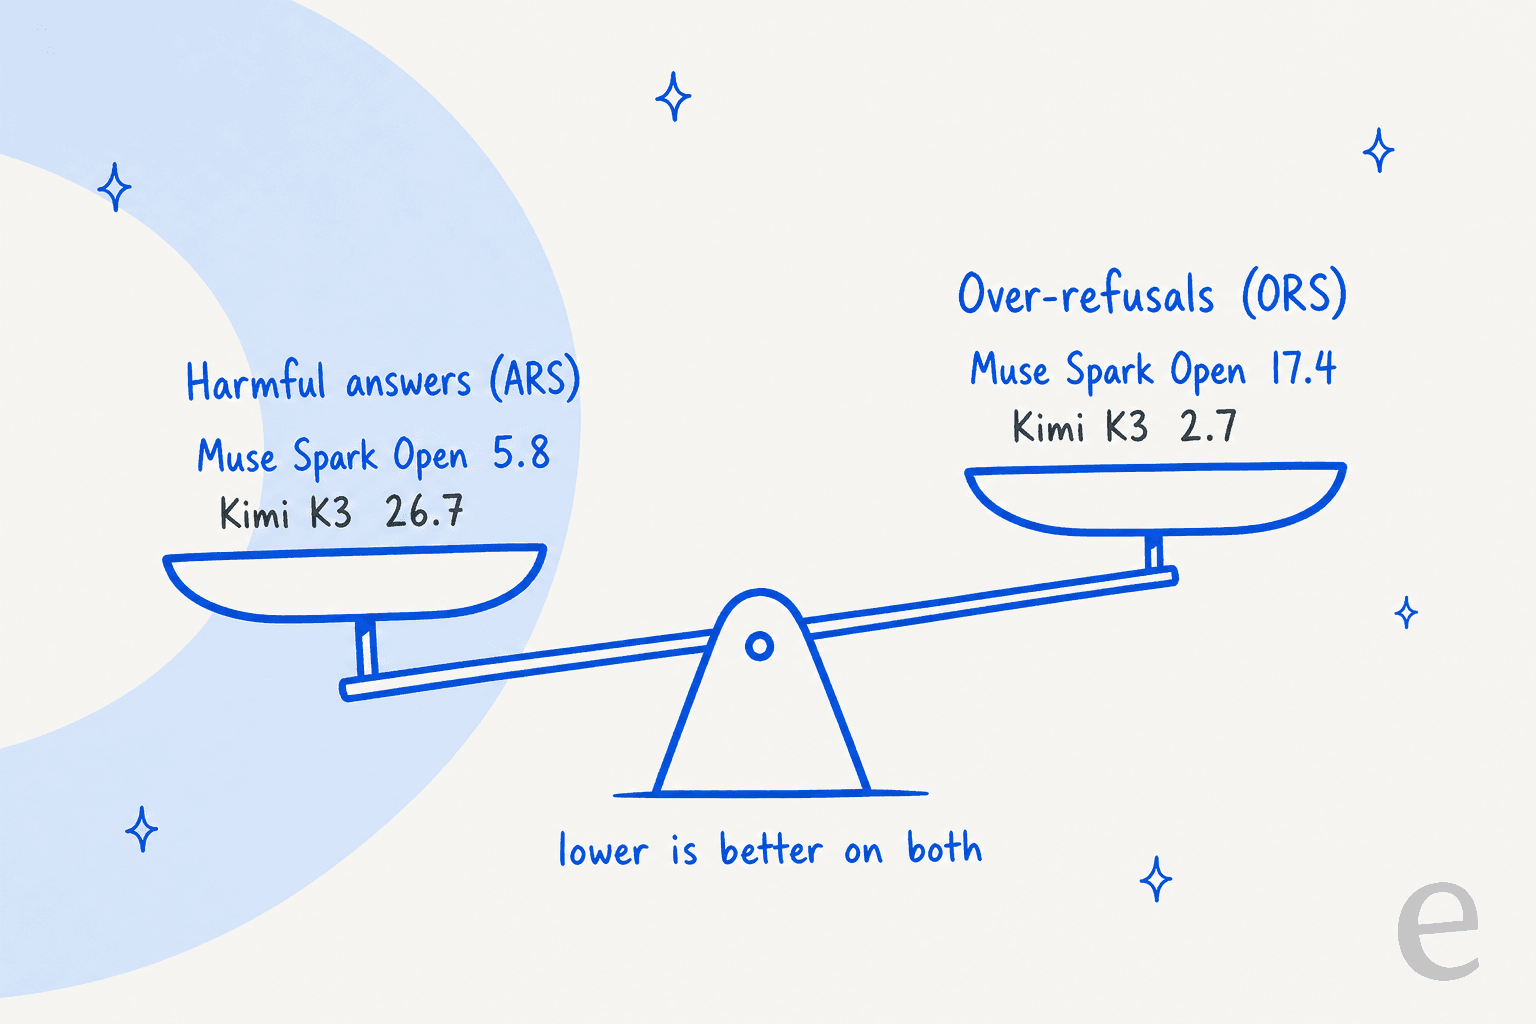
El ORS de Muse Spark Open es 17.4. El de Kimi K3 es 2.7 y el de GLM 5.3 es 3.2. En pocas palabras: es el modelo más difícil de engañar de la tabla y el más propenso a decir que no a una petición legítima. Para un agente de atención al cliente, eso es un compromiso real. Una pregunta de reembolso formulada de forma torpe, o un cliente que describe una falla en un dispositivo médico, es justo el tipo de mensaje inocuo que un modelo demasiado cauteloso puede rechazar. Lo probaría con tus propios tickets desordenados antes de confiar en el titular de seguridad en cualquier dirección.
Precios: pesos abiertos, tarifas de modelo cerrado
Esta es la parte que más me sorprendió. Todos los proveedores de lanzamiento en OpenRouter cobran exactamente la misma tarifa.
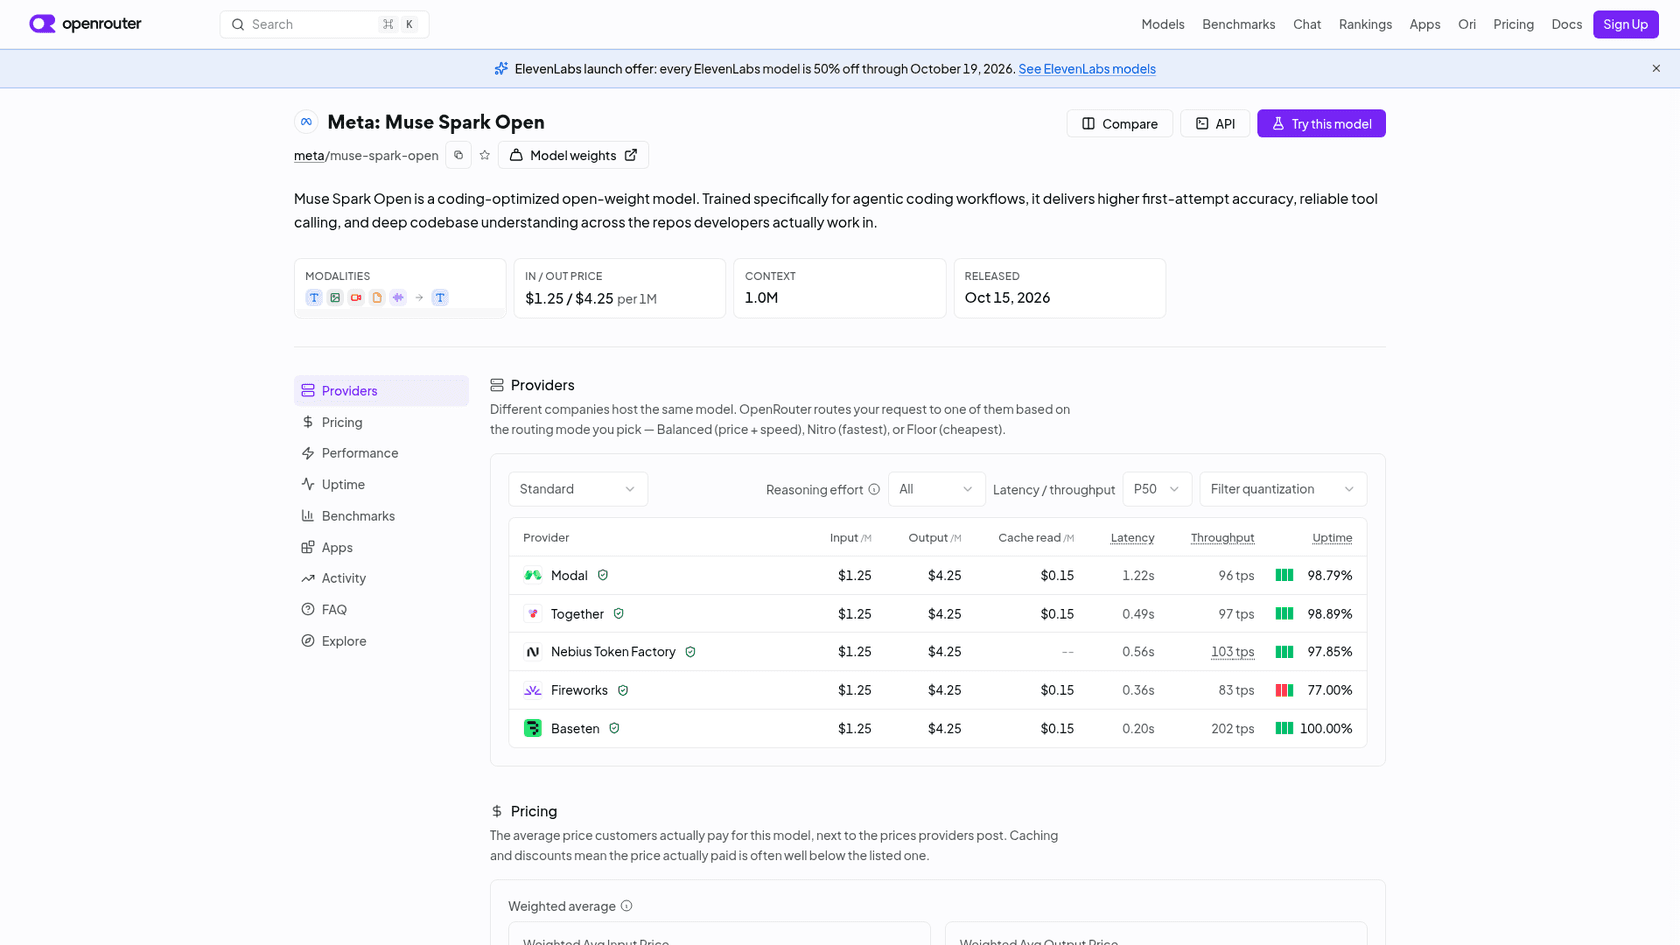
| Proveedor | Entrada / 1M | Salida / 1M | Entrada en caché / 1M | Notas |
|---|---|---|---|---|
| Baseten | $1.25 | $4.25 | $0.15 | NVFP4, contexto de 1M, unos 200 tokens/seg, mira precios de Baseten |
| Fireworks AI | $1.25 | $4.25 | $0.15 | Ajuste fino LoRA serverless, mira precios de Fireworks |
| Together AI | $1.25 | $4.25 | $0.15 | Endpoints dedicados con SLA de 99.9%, mira precios de Together |
| Modal | $1.25 | $4.25 | $0.15 | Endpoints compartidos o dedicados |
| Nebius Token Factory | $1.25 | $4.25 | n/d | |
| Groq | No indicado | No indicado | n/d | Vista previa limitada, contexto de 131K, ~350+ tokens/seg |
Esa tarifa de $1.25 / $4.25 es idéntica a la que cobra Meta por su Muse Spark 1.3 cerrado en xhigh. Artificial Analysis lo señala directamente: el modelo es "particularly expensive when comparing to other open weight models of similar size", frente a una mediana de $0.43 de entrada y $1.68 de salida. Su costo para ejecutar una tarea del índice es $0.84.
¿Por qué cinco proveedores que compiten acabarían en el mismo precio? La licencia es la razón más probable. Un desarrollador del hilo de lanzamiento lo explicó así:
"The model license requires large inference providers to contact Meta separately to obtain a license to serve the model... The usual effect of separate licensing is decreased price competition from public providers."
El contrapunto justo del mismo hilo: un precio fijo también evita que los proveedores sirvan una versión rota o degradada para venderse más barato entre sí (dannyw, Hacker News). Ambas cosas pueden ser ciertas.
¿Cuánto cuesta en la práctica? Un ejemplo aproximado para un agente que lee mucho y escribe poco (salida a $4.25 por millón):
| Volumen mensual | Entrada | Salida | Factura mensual aprox. |
|---|---|---|---|
| Piloto pequeño | 10M de tokens | 2M de tokens | $21 |
| Un agente muy ocupado | 100M de tokens | 20M de tokens | $210 |
| Despliegue en todo el equipo | 1B de tokens | 200M de tokens | $2,100 |
Guardar en caché el contexto repetido a $0.15 en lugar de $1.25 puede reducir mucho el costo de entrada si tu agente reutiliza la misma base de conocimiento en cada llamada. Recuerda que el razonamiento xhigh es el predeterminado, así que baja a medium para respuestas cortas.
Ejecutarlo tú mismo: lo que exige realmente el hardware
La propuesta que más atención recibió fue la de Apple: ejecutar un modelo de nivel de frontera en tu escritorio. La publicación de Apple sobre MLX es honesta sobre lo que eso significa. Los pesos NVFP4 ocupan unos 493GB, y con la memoria de trabajo encima, "the model cannot fit on a single machine."
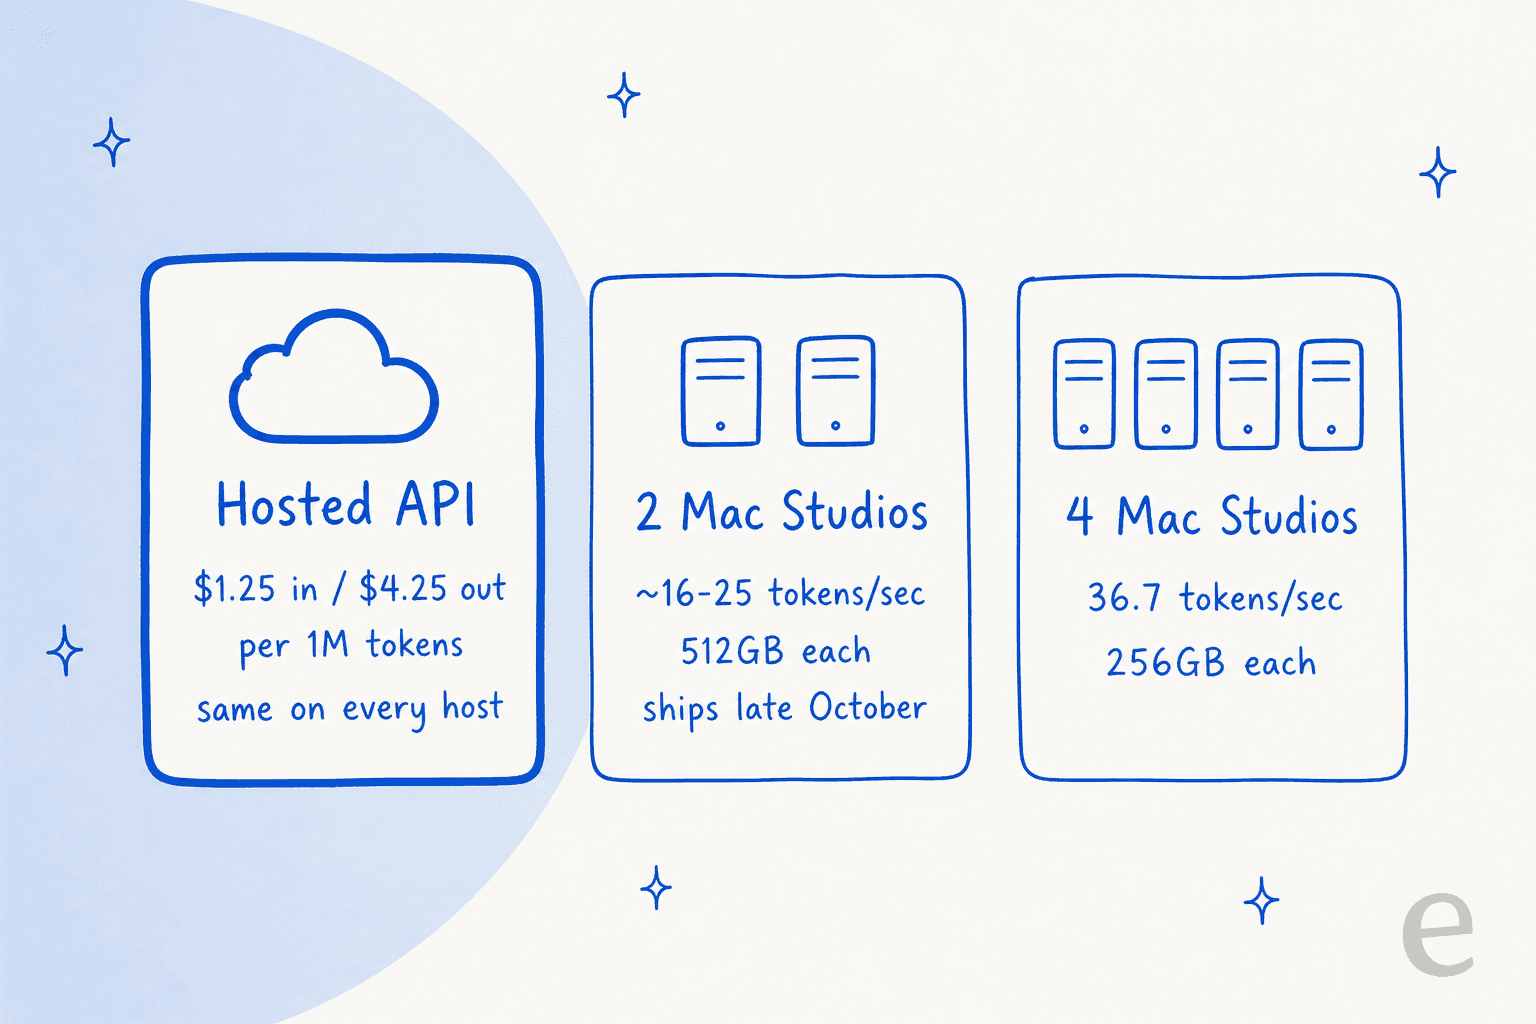
Velocidades de decodificación medidas por Apple con un contexto de 8,192 tokens:
| Configuración | Velocidad de decodificación |
|---|---|
| 2 Mac Studio (M5 Ultra), división por pipeline | 15.74 tokens/seg |
| 2 Mac Studio (M5 Ultra), división tensorial | 24.99 tokens/seg |
| 4 Mac Studio (M5 Ultra), división tensorial | 36.73 tokens/seg |
La configuración de dos máquinas necesita el M5 Ultra de 512GB, que la tienda de Apple indica como "coming late October", sin precio visible todavía. Las configuraciones M5 Ultra empiezan en $5,499 con mucha menos memoria. Un comentarista resumió la reacción:
"A single Mac Studio w/ M5 Ultra and half that RAM (256 GB) is around $11k, and the 512 GB option isn't even available yet. So.... yeah."
En GPU, la ficha del modelo pide al menos 700GB de VRAM para NVFP4 y 2TB para BF16; la publicación para desarrolladores de Meta dice que NVFP4 se sirve en cuatro GPU Blackwell Ultra u ocho H200. La versión de 2 bits de Unsloth lo reduce a unos 300GB de memoria combinada, con cierta pérdida de calidad.
Hay que reconocerle a Meta que el soporte desde el primer día es inusualmente completo: SGLang, vLLM, TensorRT-LLM, Transformers, MLX, llama.cpp y Unsloth funcionaron en el lanzamiento, con ajuste fino mediante TorchTitan, Fireworks y Together. Como señaló un desarrollador, Meta "did the actual work of testing and documenting deployments on several platforms" (bahmboo, Hacker News).
Entonces, ¿quién debería alojarlo por su cuenta? La respuesta del hilo coincide con la mía: los equipos con una razón contractual o legal para mantener los datos en su propio hardware (mbreese, Hacker News). Para todos los demás, con $210 al mes por un agente muy ocupado, una API alojada seguirá siendo más barata durante mucho tiempo que una configuración de dos Mac que los comentaristas ya valoran por encima de $20,000.
La letra pequeña de la licencia
La Muse Model License es permisiva en apariencia: uso libre, ajuste fino, destilación y reventa. Las condiciones que importan:
- Atribución en tu producto. Debes "prominently display 'Built with Muse Spark Open'" en la interfaz, la documentación, el sitio web o los ajustes de cualquier producto que lo use o use algo derivado de él, incluidos los modelos entrenados con sus salidas.
- Un límite de $20 millones para proveedores. Si vendes acceso al modelo como servicio y los ingresos de tu empresa superan los
$20 millonesen cualquier período de 12 meses, necesitas antes un acuerdo escrito aparte con Meta. - Prohibido para menores de 18. La política de uso dice que el modelo "is not intended for individuals under the age of 18", y quienes lo despliegan cargan con la responsabilidad si los menores pueden acceder a él.
- Una política de uso amplia. Prohíbe el ejercicio profesional sin licencia (legal, médico, financiero), usarlo para procesar datos personales sensibles sin tener derecho a ello y presentar sus salidas como escritas por humanos.
Ese cuarto punto importa para los equipos de soporte en industrias reguladas. Un agente que redacta respuestas para una empresa de salud o finanzas necesita de todos modos un diseño con una persona en el circuito, y la propia ficha de Meta recomienda "human-in-the-loop confirmation for irreversible actions." Si es "de código abierto" es un debate legítimo; en el hilo de lanzamiento varios desarrolladores lo llamaron "open-weight" como mucho (isityettime, Hacker News).
Muse Spark Open frente a las alternativas
| Modelo | AA Index (tabla de Meta) | DeepSWE 1.1 | MCP-Atlas | StrongREJECT (menos es mejor) | Ideal para |
|---|---|---|---|---|---|
| Muse Spark Open | 39 | 60 | 89.2 | 0.5 | Agentes con muchas herramientas, despliegues cautelosos |
| Kimi K3 | 44 | 68 | 82.3 | 66.6 | Programación abierta y trabajo en terminal |
| GLM 5.3 | 45 | 67 | 84.2 | 62.9 | Mejor puntuación abierta general |
| Qwen 3.8 | 40 | 57 | 84.5 | 65.6 | Uso general amplio |
| Mistral Large 4 | 38 | 62 | n/d | n/d | Despliegues alojados en la UE |
Si puedes usar un modelo cerrado, la brecha se amplía. El nivel de frontera de Meta lo cubro en mi reseña de Muse Wonder, y Claude Opus 5.5 recibe el mismo tratamiento en mi reseña de Opus 5.5. Ambos puntúan bastante por encima de 39 en el mismo índice.
Si el precio importa más que el uso de herramientas, empieza por mi reseña de DeepSeek V4 Flash. Qwen 3.8 es el otro modelo abierto que vale la pena mirar, y lo cubro en mi reseña de Qwen 3.8.
Veredicto: quién debería usar Muse Spark Open
Calificación: 3.5/5.
- Elígelo si necesitas pesos descargables, tu agente vive o muere según llame a la herramienta correcta y prefieres que rechace demasiado a que rechace muy poco. Las puntuaciones de MCP y el ajuste de seguridad son fortalezas reales.
- Descártalo si sobre todo escribes código (Kimi K3 o GLM 5.3), quieres los tokens abiertos más baratos (el piso de
$1.25 / $4.25está fijado) o esperabas ejecutarlo en una sola máquina. - Prueba antes de confiar en la tasa de sobrerrechazo con tu propio tráfico.
La lección más grande para los equipos de soporte es que rara vez el modelo es lo que falla. En las propias llamadas de ventas de eesel, el fallo del que más oigo hablar es un bot que respondió a clientes reales con detalles inventados cuando la base de conocimiento no tenía nada relevante. Otro comprador, un evaluador técnico en una empresa de hardware, preguntó sin rodeos si la IA recurriría al conocimiento general de la web cuando no supiera algo, y si eso se podía desactivar. Esos son problemas de recuperación, de barreras de protección y de traspaso. Cambiar a un modelo más inteligente o más seguro no los arregla por sí solo. Mi guía sobre automatizar el soporte con agentes de IA repasa las capas que sí lo hacen.
Prueba eesel en tu helpdesk
Si estabas mirando Muse Spark Open porque quieres un agente de IA trabajando en tu cola de soporte, el compañero de IA de eesel para helpdesk te ahorra comprar GPU. Se conecta con Zendesk, Freshdesk, Gorgias y más en minutos, aprende de tus tickets anteriores y tu centro de ayuda, y se simula con tus tickets históricos antes de responder a un solo cliente. Tú decides qué tickets responde, cuáles redacta como notas internas y cuándo pasa el caso a una persona.

Si prefieres integrar un modelo tú mismo, mi guía para conectar Claude a tu helpdesk muestra el trabajo que implica. La vía de Meta se cubre en Muse para atención al cliente.
Los planes empiezan en $299 al mes en la página de precios de eesel, y puedes probarlo gratis primero. Prueba eesel y mira qué habría respondido con los tickets del mes pasado.