

IBM Granite 4.2 es la familia de modelos de razonamiento abiertos de IBM, lanzada el 25 de agosto de 2026 en tres tamaños (3B, 8B, 30B), todos bajo una licencia permisiva Apache 2.0. El gran cambio respecto a Granite 4.0 es el razonamiento "thinking" nativo integrado en el modelo, con tres modos intercambiables (thinking completo, sin thinking y bajo esfuerzo) y una llamada a herramientas mucho más sólida.
¿Vale la pena? Depende de lo que valores:
- Quieres una IA de confianza, con licencia y en tus propios servidores: sí. Pesos firmados, una de las mejores puntuaciones de transparencia de Stanford y Apache 2.0 hacen de Granite la opción segura para empresas, y los modelos pequeños funcionan rápido en hardware común.
- Quieres la mejor puntuación bruta en programación o agentes: probablemente no. La comunidad de LLM locales sigue recurriendo a Qwen cuando se trata de capacidad pura, e IBM sobre todo se compara consigo misma.
- Quieres un agente de soporte terminado: esta es la capa equivocada. Granite es un motor, no un compañero de IA para el helpdesk. Tienes que construir encima la recuperación de información, las barreras de seguridad y las pruebas.
La forma más barata de probarlo: es gratis para alojar tú mismo bajo Apache 2.0 (el 3B es una descarga de 2,2 GB con Ollama). Como API alojada, Replicate ofrece el 8B a $0.06/$0.25 por millón de tokens.
Qué busco en un modelo abierto como Granite 4.2
Un poco de contexto sobre mi punto de vista. Construyo agentes de IA en eesel, y llevamos años poniendo IA en colas de soporte reales, así que leo el lanzamiento de un modelo de forma distinta a quien persigue benchmarks. Una puntuación alta en AIME está bien. Lo que de verdad me importa es si un modelo puede seguir instrucciones que no le gustan, llamar a la herramienta correcta sin inventarse una, mantenerse anclado a una base de conocimiento y comportarse igual en el ticket n.º 4.000 que en la demo. Hemos visto modelos de tono seguro dar respuestas erróneas sin que nadie lo note, y por eso simulamos cada despliegue con tickets históricos antes de que toque a un cliente.
Así que este análisis mira Granite 4.2 con esa lente: qué cambió realmente, dónde quedan los benchmarks con honestidad, cuánto cuesta ejecutarlo y para quién encaja.
Qué cambió en Granite 4.2
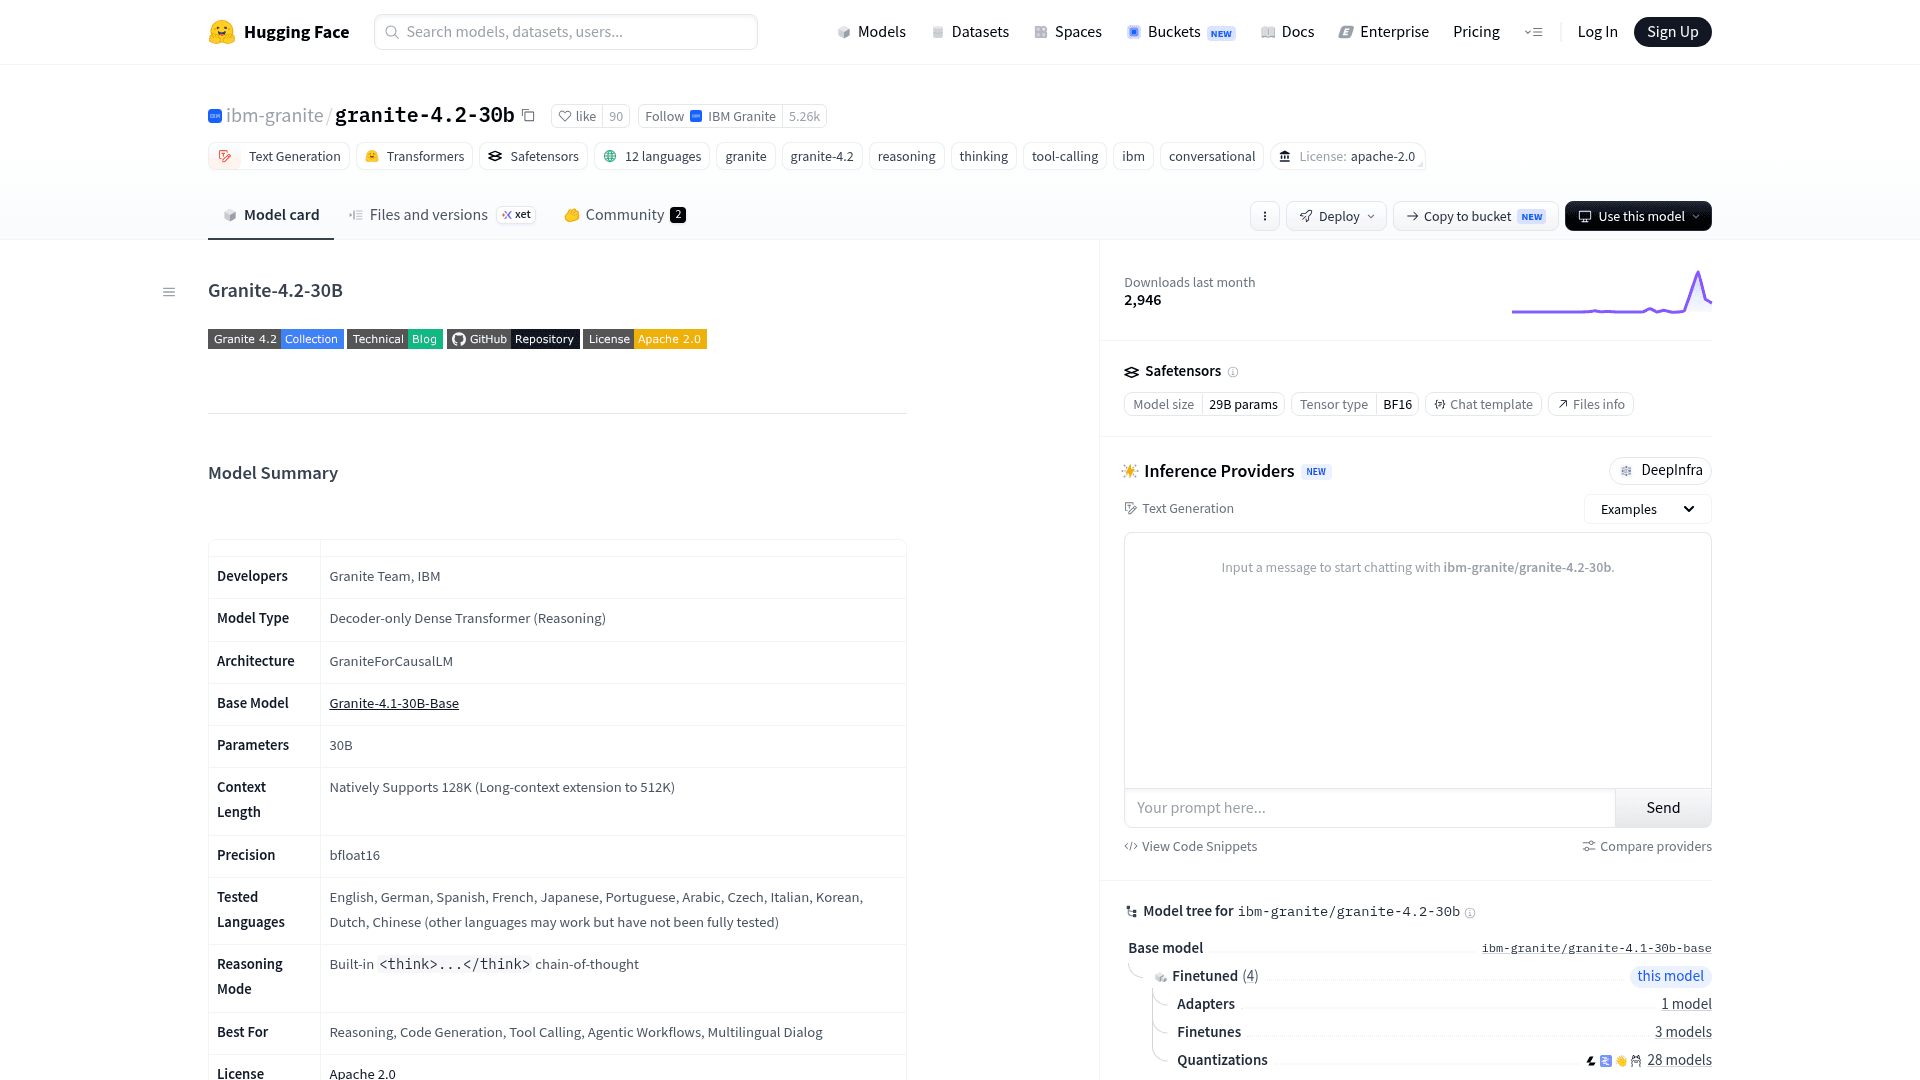
La versión en una línea: Granite 4.2 añade razonamiento nativo. Mientras que Granite 4.0 era un modelo instruct rápido y eficiente, 4.2 puede planificar, autocorregirse y razonar paso a paso dentro de etiquetas <think>...</think> antes de responder. Eso ayuda sobre todo en matemáticas, lógica de varios pasos y, lo que más me importa, en decidir qué herramienta llamar y por qué.
Lo ingenioso es que el razonamiento se puede activar o desactivar en un solo modelo, así que no pagas chain-of-thought en preguntas que no lo necesitan:
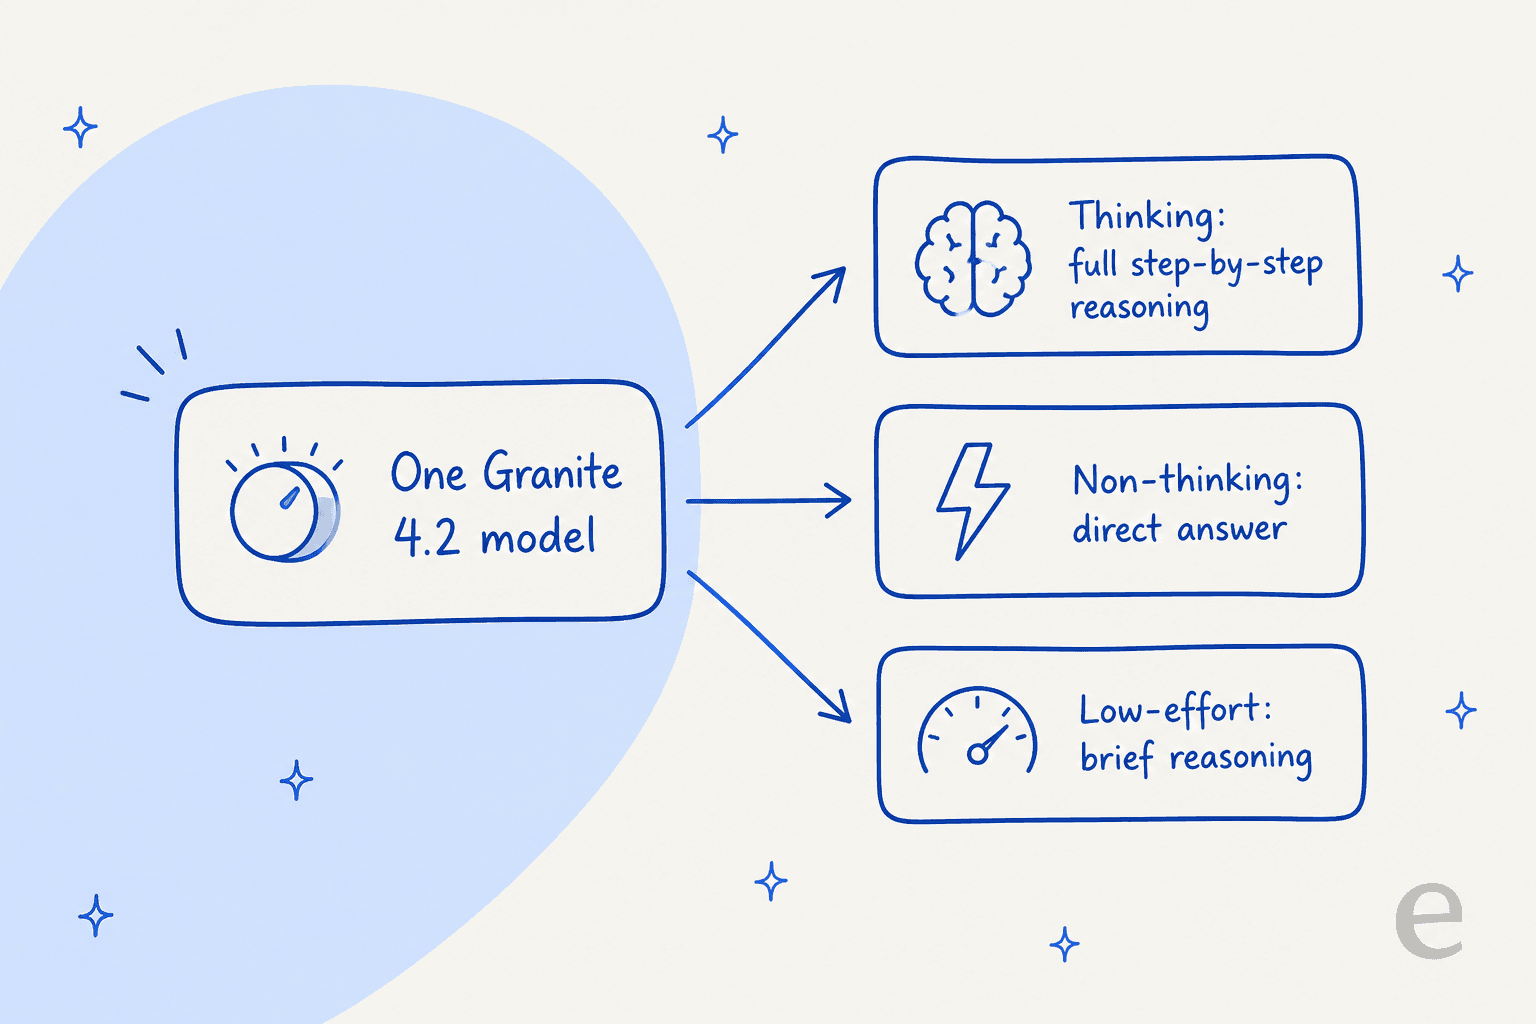
- Thinking (el predeterminado) da chain-of-thought completo.
- Sin thinking omite el razonamiento por completo para dar una respuesta directa, lo que importa cuando atiendes mucho volumen y no quieres la latencia ni el coste en tokens.
- Bajo esfuerzo hace un razonamiento breve para consultas más simples, una marcha intermedia.
En Ollama cambias entre ellos con /set think y /set nothink, un buen detalle para quien ajusta coste frente a calidad según el caso de uso.
También hay una historia de arquitectura, y vale la pena señalarla porque va contra la tendencia. Granite 4.0 usaba un diseño híbrido Mamba-2/transformer con una mezcla de expertos para ahorrar memoria. Granite 4.2 es un transformer denso solo decodificador sin más. El razonamiento de IBM es que "its dense architecture supports broad compatibility", lo cual es un punto real si despliegas en hardware mixto y distintos stacks de servicio. También significa que el número de parámetros del titular es el modelo completo, sin trucos de activos frente a totales.
Para cerrar el lanzamiento: el diálogo multilingüe se ha probado en 12 idiomas, e IBM lanzó dos diminutos modelos de transcripción Granite Speech 5.0 Turbo (470M de parámetros) junto a los LLM para audio en el borde.
Los tres modelos: 3B, 8B y 30B
Granite 4.2 son exactamente tres modelos densos, cada uno posentrenado a partir de la base Granite 4.1 correspondiente. Todos manejan de forma nativa un contexto de 128K tokens, y el 30B lo amplía a 512K.
| Modelo | Parámetros | Capas | Contexto | Descarga en Ollama | Ideal para |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B denso | 40 | 128K / 512K | 2,2 GB | Edge, portátiles, tareas baratas de alto volumen |
| granite-4.2-8b | 8B denso | 40 | 128K / 512K | 5,3 GB | Modelo equilibrado de uso general |
| granite-4.2-30b | 30B denso | 64 | 128K / 512K | 18 GB | Buque insignia para razonamiento y tareas con agentes |
IBM también ofrece cuantizaciones oficiales (fp8, mxfp4, nvfp4) de cada tamaño, además de versiones GGUF de la comunidad para llama.cpp y LM Studio. Conviene saber que las fichas de los modelos recomiendan explícitamente ejecutar Granite junto a Granite Guardian 4.1 8B, un modelo de seguridad independiente para detectar riesgos. La etiqueta "4.2" solo cubre los tres modelos de lenguaje; Vision, Guardian y Speech siguen sus propias versiones.
Benchmarks: dónde queda realmente Granite 4.2
Esta es la comparación principal de IBM, el 30B frente a Nemotron 3 Super 120B de Nvidia y Gemma 4 31B de Google:
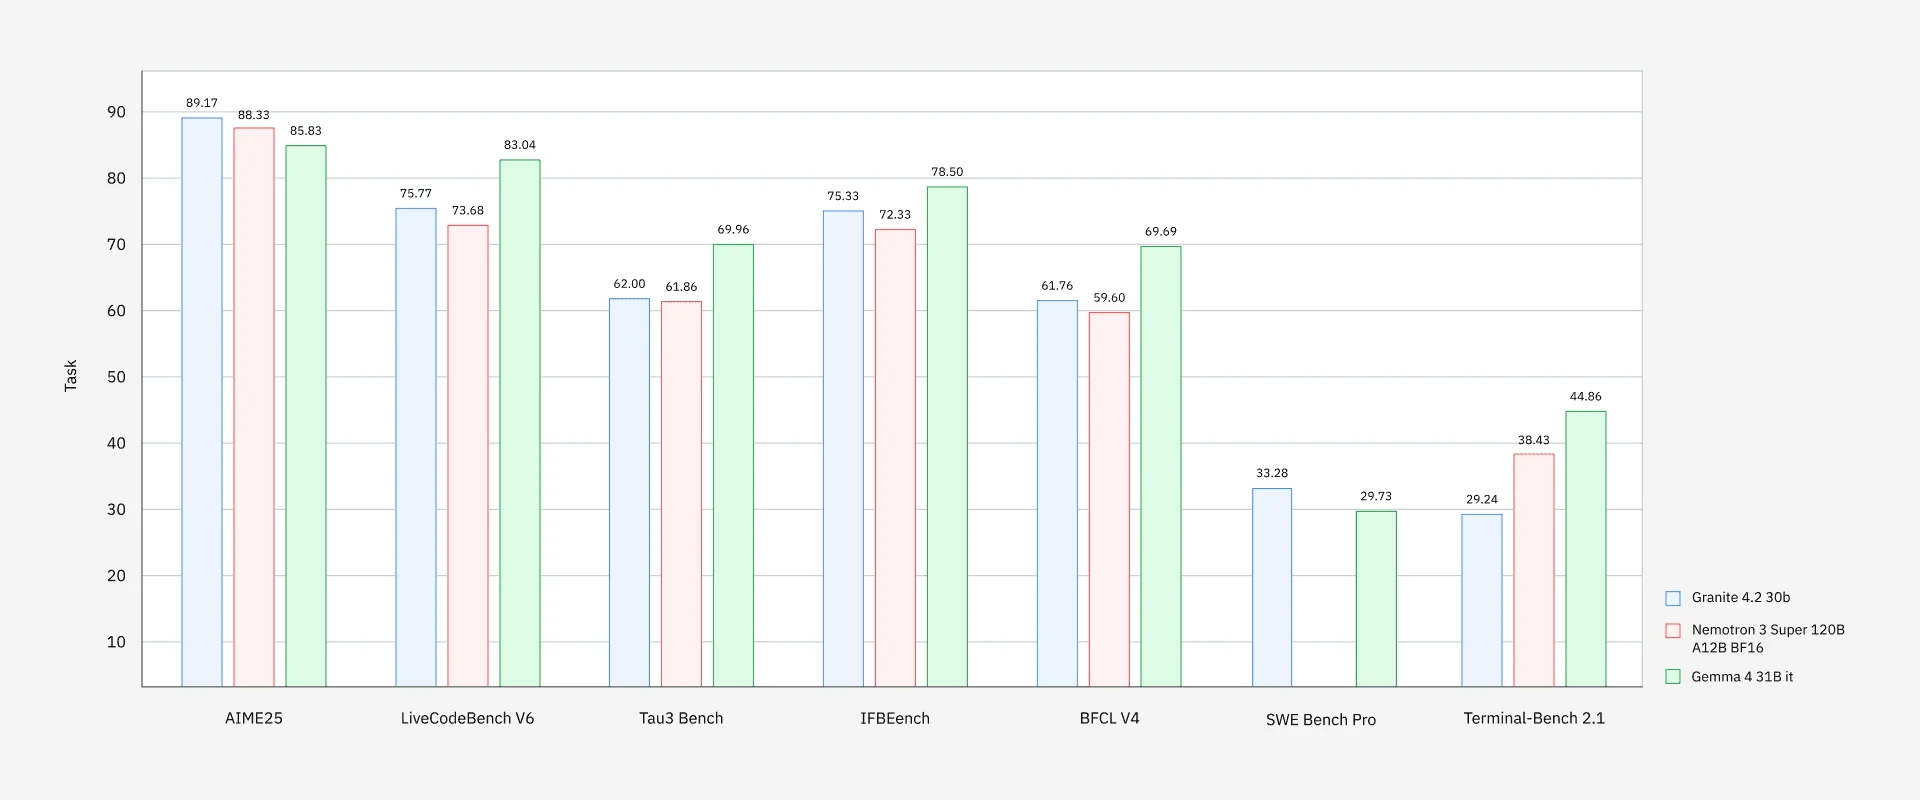
La historia que IBM quiere contar es real: en AIME25 el 30B obtiene 89.17, superando por poco a un modelo Nemotron de 120B parámetros, y también lidera en LiveCodeBench, IFBench y BFCL. "Competitivo con modelos thinking más grandes a una fracción del coste" es un resumen justo de ese gráfico.
Las salvedades honestas importan igual:
- El panorama se invierte en programación agéntica más exigente. Gemma 4 31B supera a Granite tanto en SWE-Bench Pro como en Terminal-Bench 2.1. Las cifras brutas de Granite como agente de programación (33.29 en SWE-Bench Pro, 29.24 en Terminal-Bench) son decentes para su tamaño, pero no lideran la categoría.
- IBM se compara con un conjunto de pares elegido con cuidado. Sigue siendo IBM quien elige la comparación. Como dijo un comentarista de Hacker News durante el lanzamiento de la 4.1:
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models. At least this is the most reasonable assumption until data comes out to the contrary."

En los números que me importan para la automatización del soporte, el panorama es alentador: el 30B alcanza 62.00 en tau3-bench (uso agéntico de herramientas), 61.39 en BFCL v4 (llamada a funciones) y 77.60 en MMLU-Pro. Esos son los músculos de llamada a herramientas y de seguimiento de instrucciones en los que un agente de soporte se apoya de verdad, y el 8B se acerca lo suficiente (52.39 en BFCL, 74.04 en MMLU-Pro) como para ser interesante en despliegues sensibles al coste.
Cómo funciona el bucle de razonamiento y llamada a herramientas
La mejora más útil para quien construye agentes es que Granite 4.2 razona sobre las herramientas antes de llamarlas. En lugar de asociar patrones con el nombre de una función, el modelo piensa qué herramienta encaja y por qué, y después hace la llamada. Esa es la diferencia entre un agente que consulta un pedido de forma fiable y uno que inventa una función que no existe.
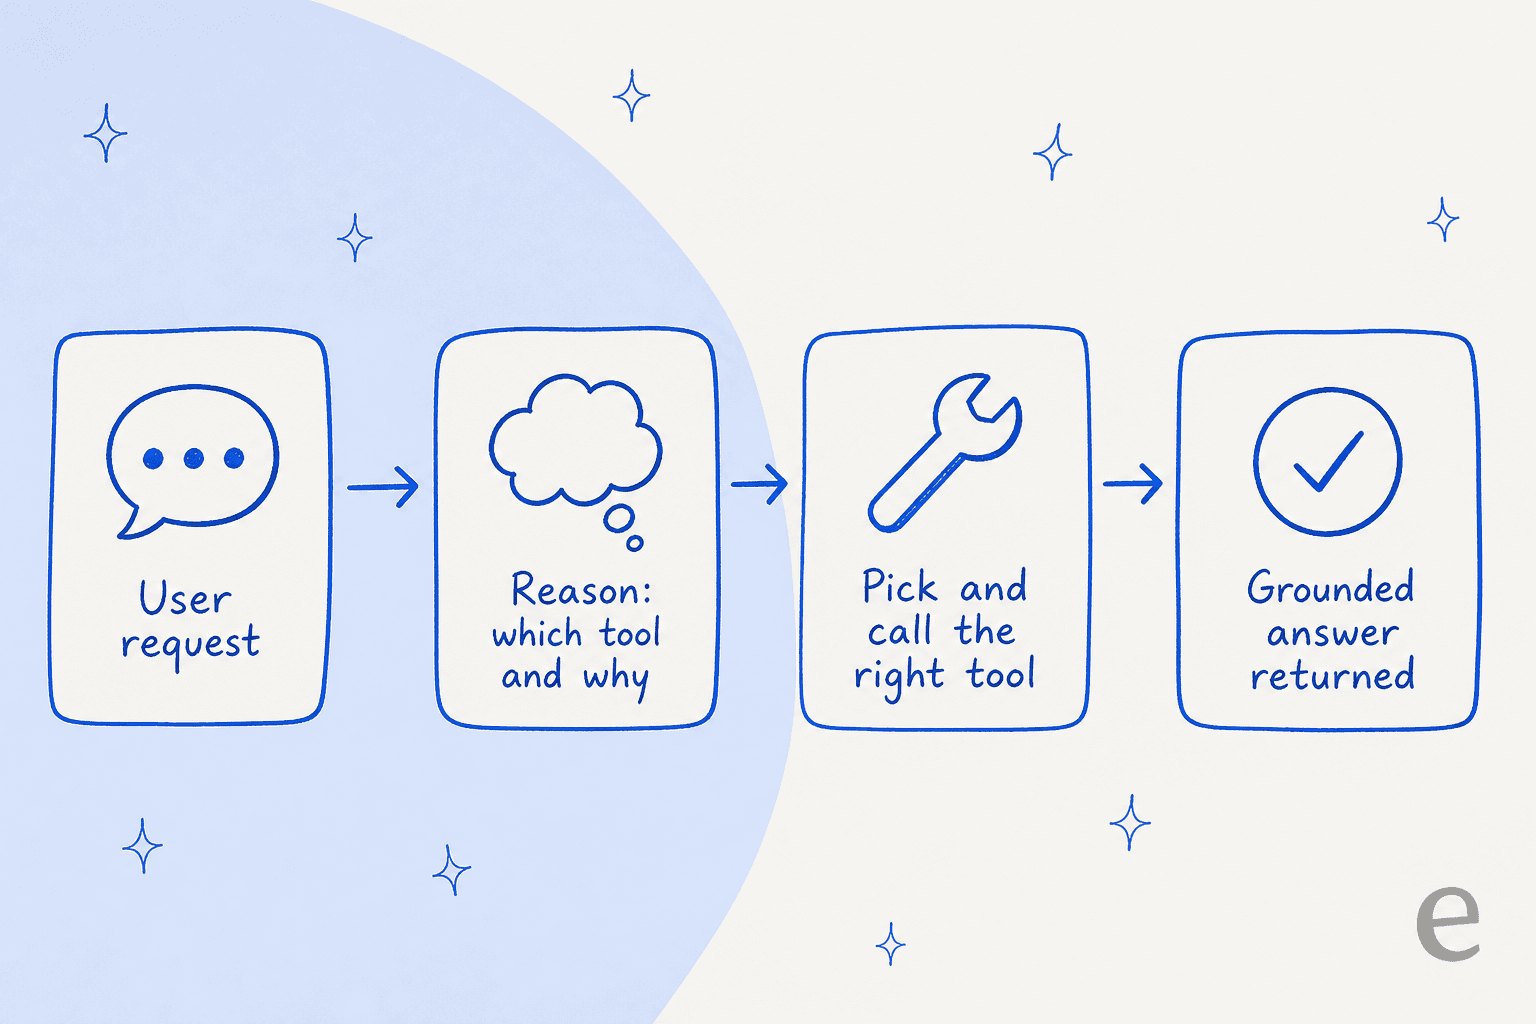
Se expone a través de una API compatible con OpenAI y funciona de inmediato con arneses de programación agéntica como OpenCode y OpenHands. La opinión de la comunidad respalda el diseño: los modelos pequeños de Granite son discretamente buenos en trabajo estructurado.
"IBM Granite 4H-Small, it's very good with tool calls. most tool-calling issues come from the model not sticking to the exact structure you"

Esta es la capa donde la elección del modelo se encuentra con un producto real. La llamada fiable a herramientas es lo que separa a un agente de IA de un chatbot basado en reglas, y es lo que permite a un agente consultar un pedido, etiquetar un ticket o activar un reembolso en lugar de limitarse a escribir una frase plausible sobre ello.
Acceso y precios
Aquí Granite resulta atractivo: como es Apache 2.0, el suelo es gratis. Puedes descargarlo, ajustarlo y llevarlo a producción sin tarifa de licencia y sin coste por token más allá del cómputo en el que lo ejecutes. Hay tres vías prácticas, que suben en comodidad y coste:
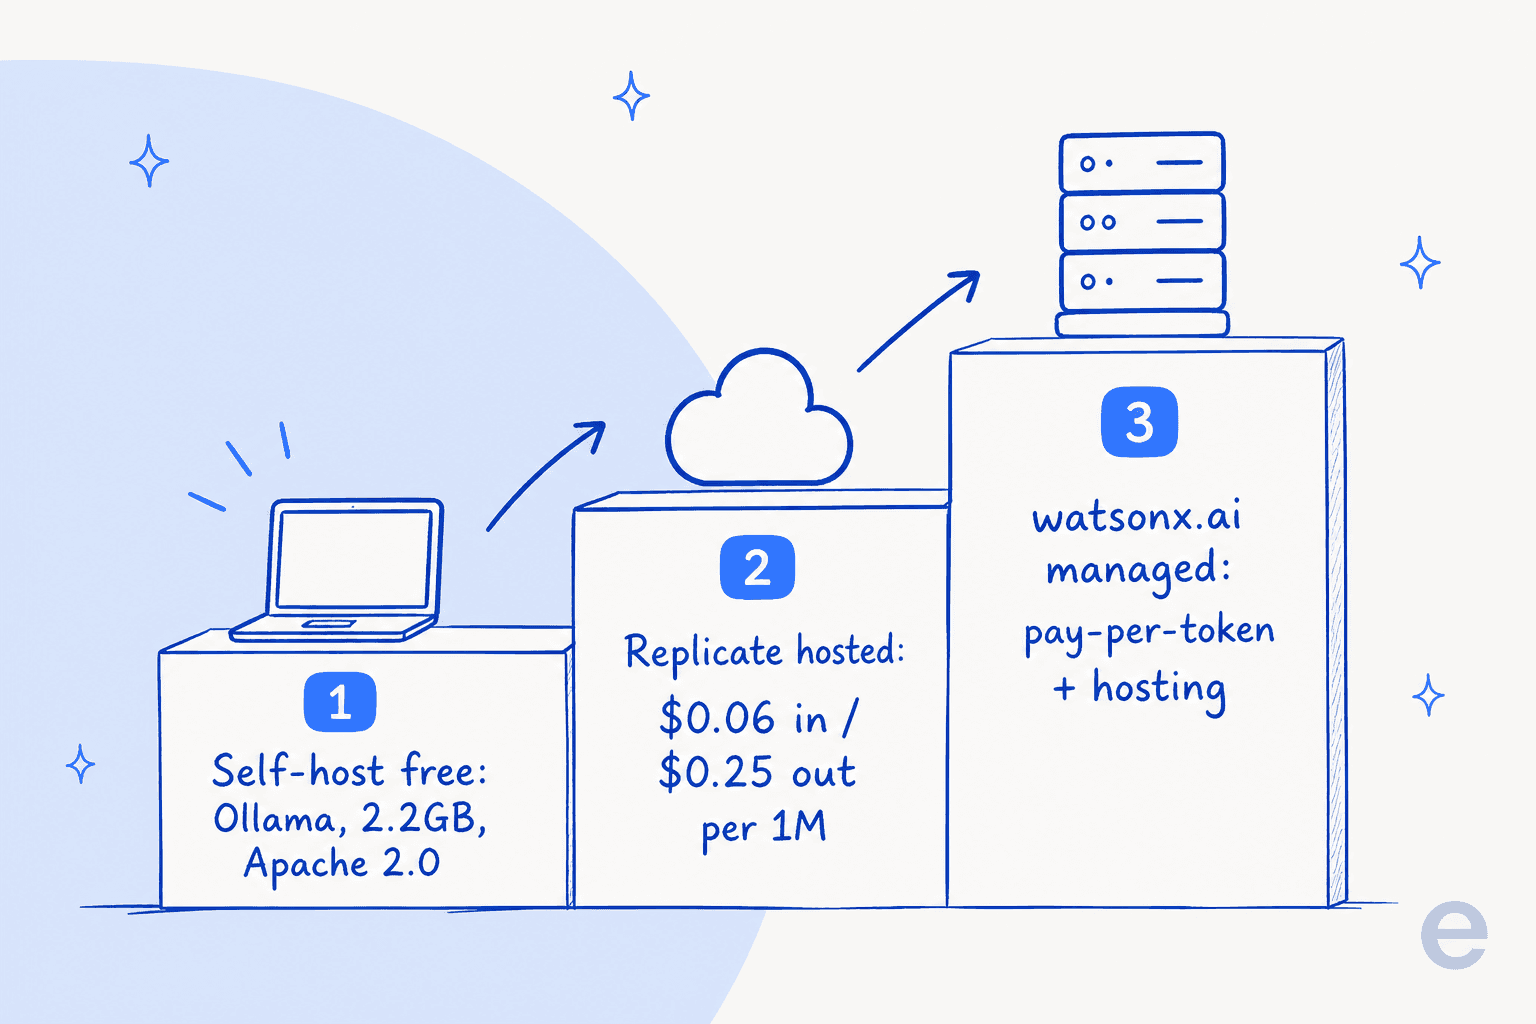
| Vía | Precio | Notas |
|---|---|---|
| Alojamiento propio (Ollama, vLLM, llama.cpp) | Gratis (tu cómputo) | El 3B funciona en un portátil; el 30B necesita ~18 GB+ de VRAM |
| API alojada de Replicate | $0.06 / 1M entrada, $0.25 / 1M salida | ~$0.0014 por ejecución típica; solo 8B, confirmado |
| watsonx.ai | Pago por 1M tokens + alojamiento por hora | Plan Standard ~$1,050/mes; plataforma gestionada de IBM |
Dos notas honestas. Primero, watsonx.ai de IBM es la vía empresarial, y su modelo de precios (pago por uso por millón de tokens, donde históricamente 1 Resource Unit = 1.000 tokens, más alojamiento bajo demanda por hora) está confirmado, pero la tabla de la documentación en vivo devolvió un error 500 cuando la consulté, así que no pude fijar la línea exacta de Granite 4.2. La tarifa confirmada más cercana de Granite 4 ronda los $0.06 por millón de entrada y $0.27 de salida. Segundo, en el momento de escribir esto los modelos 4.2 aún no aparecían en OpenRouter, que seguía mostrando solo Granite 4.1 8B y 4.0 Micro.
Aquí tienes la vía gratuita en acción con Ollama, que es como la mayoría lo probará:
Una trampa que la comunidad detectó rápido: el tamaño de descarga engaña sobre la memoria que necesitas. Un hilo en r/LocalLLaMA señaló que el 8B se hincha muy por encima de su tamaño:
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"
Eso es la caché KV y la asignación de contexto trabajando, y es algo normal de prever, pero si dimensionas una GPU con la cifra de descarga te quedarás corto. Deja margen, sobre todo con contextos largos.
Qué piensa realmente la comunidad
La opinión sobre Granite 4.x es consistente y, creo, acertada. Los elogios se agrupan justo en lo que IBM construyó: los modelos pequeños funcionan rápido en hardware común, tienen datos de entrenamiento recientes y una licencia comercial sin restricciones.
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly... Granite has recent training data which is nice."
La crítica es igual de consistente: en capacidad bruta, sobre todo en programación, la gente sigue recurriendo a Qwen.
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
Y un comentarista en X captó el posicionamiento mejor que el propio marketing de IBM: Granite compite en confianza en lugar de intentar liderar una clasificación.
"IBM just released a model built to need less of your trust, not more of your capability. Granite 4.2 ships in 3, 8, and 30 billion parameter sizes, fully open under Apache 2.0. It's trained specifically for tool use, terminal work, and multistep agent tasks."
Esa es toda la reseña en un párrafo, sinceramente. Granite 4.2 no intenta ser el modelo más inteligente que puedas ejecutar. Intenta ser el que aprueben tus equipos de seguridad y legal: pesos firmados, certificación ISO, una de las mejores puntuaciones de transparencia de Stanford y una licencia que no te encierra. Para una empresa regulada que monta modelos específicos de dominio en sus propios servidores, esa combinación vale más que dos puntos en un benchmark de programación.
Dónde encaja Granite 4.2 para equipos de soporte e IA
Entonces, ¿debería importarle a un equipo de soporte u operaciones? Sí, pero conviene tener claro qué tienes realmente entre manos. Granite 4.2 es infraestructura, un motor. Por sí solo no es un agente de atención al cliente, igual que un V8 no es un coche.
Si tienes un equipo de ML y quieres el máximo control (datos que nunca salen de tu VPC, un modelo ajustado con tus propios tickets, sin factura por token a escala), alojar tú mismo un modelo abierto como Granite es un camino real y cada vez más popular. El 8B es un punto de partida sensato para la automatización del servicio al cliente: buena llamada a herramientas, barato de ejecutar, con licencia. Después construirías el resto tú mismo: recuperación sobre tu centro de ayuda, lógica de escalada, barreras contra las alucinaciones, una forma de medir la tasa de resolución y una manera segura de probar antes de salir en vivo.
Ese "construir el resto tú mismo" es todo el trabajo, y es la parte que los análisis de modelos se saltan. Elegir el modelo es quizá el 10 % de lanzar un agente de soporte que de verdad desvíe tickets de nivel 1 sin empeorar las cosas. El otro 90 % es la infraestructura, las pruebas y la seguridad operativa, que es donde se atascan la mayoría de los proyectos internos.
Prueba eesel: la capa que Granite no te da
Si tu objetivo es un agente de soporte que funcione y no un modelo sobre el que construir, ese es justo el hueco que cubre eesel. Granite te da un motor. eesel es el compañero de IA para el helpdesk listo para trabajar que ya lleva el motor, más todo lo que lo rodea: se entrena con tus tickets pasados y tu centro de ayuda, se conecta al helpdesk que ya usas (Zendesk, Freshdesk, Gorgias y más de 1.000 integraciones) y se incorpora a la cola en minutos en lugar de trimestres.

La diferencia es lo que dije al principio que me importa: antes de que eesel responda a un solo cliente real, puedes simularlo con miles de tus tickets históricos para ver exactamente cómo habría respondido y qué habría resuelto. Esa es la red de seguridad que un modelo en bruto, sea Granite u otro, no trae consigo. Un cliente, Global Pay, informó de hasta un 80 % de ahorro de tiempo con ella.
Usa Granite 4.2 si estás construyendo. Usa un compañero de IA para el helpdesk si lo que quieres es responder tickets. Puedes probar eesel gratis, sin tarjeta de crédito y sin llamada comercial para empezar.