

Granite 4.2 de IBM es una familia de pesos abiertos realmente buena: tres modelos de razonamiento pequeños (3B, 8B, 30B), Apache 2.0, pensamiento conmutable y baratos de operar. La mayoría busca una alternativa por una de tres razones: quieren más capacidad bruta (normalmente para programar), lo quieren aún más barato a escala, o necesitan un modelo con una licencia más amable o una API gestionada y alojada.
Este es el resumen de a quién elegir:
- Qwen 3.8 si quieres la mayor capacidad bruta, sobre todo en programación. Checkpoint abierto de 27B, Apache 2.0.
- DeepSeek V4 Flash si el costo a escala lo es todo. Licencia MIT, la opción seria más barata de aquí.
- GLM 5.3 Flash si quieres agentes baratos, multimodales y aficionados a las herramientas con pesos abiertos.
- Kimi K3 si ejecutas trabajo agéntico de largo recorrido y pagarás un extra por ello.
- Mistral (Large 3 + modelos abiertos) si te importa un proveedor europeo y una licencia on-prem limpia.
- Google Gemini 3.6 Flash si prefieres una API gestionada y alojada antes que alojar algo tú mismo.
- NVIDIA Nemotron 3 si vives en hardware NVIDIA, o quieres pesos y recetas de entrenamiento abiertas.
Algo que conviene decir desde el principio, porque construir IA de soporte es mi trabajo diario: cada modelo de esta lista es un motor, no un producto. Si lo que realmente quieres es un agente de IA que resuelva tickets, el modelo es el 10% fácil; el conocimiento, las integraciones y las barreras de seguridad son el otro 90%. Más sobre eso al final.
Por qué la gente busca una alternativa a Granite 4.2
Seamos justos con Granite primero, porque se lo gana (analicé la familia a fondo en mi reseña completa de Granite 4.2). Granite 4.2 salió el 25 de agosto de 2026 como tres modelos de razonamiento densos bajo una licencia Apache 2.0. Los pequeños corren rápido en hardware común (el 3B es una descarga de 2,2 GB), los datos de entrenamiento son recientes y el consenso de la comunidad es que Granite es discretamente excelente en trabajo estructurado y fundamentado: llamadas a herramientas, resúmenes, y etiquetado de documentos y extracción. Si necesitas un modelo licenciable y on-prem que se porte bien en un bucle de agente, es una opción por defecto sólida.
Entonces, ¿por qué cambiar? Siguen apareciendo algunas razones reales, y ninguna es palabrería de marketing.
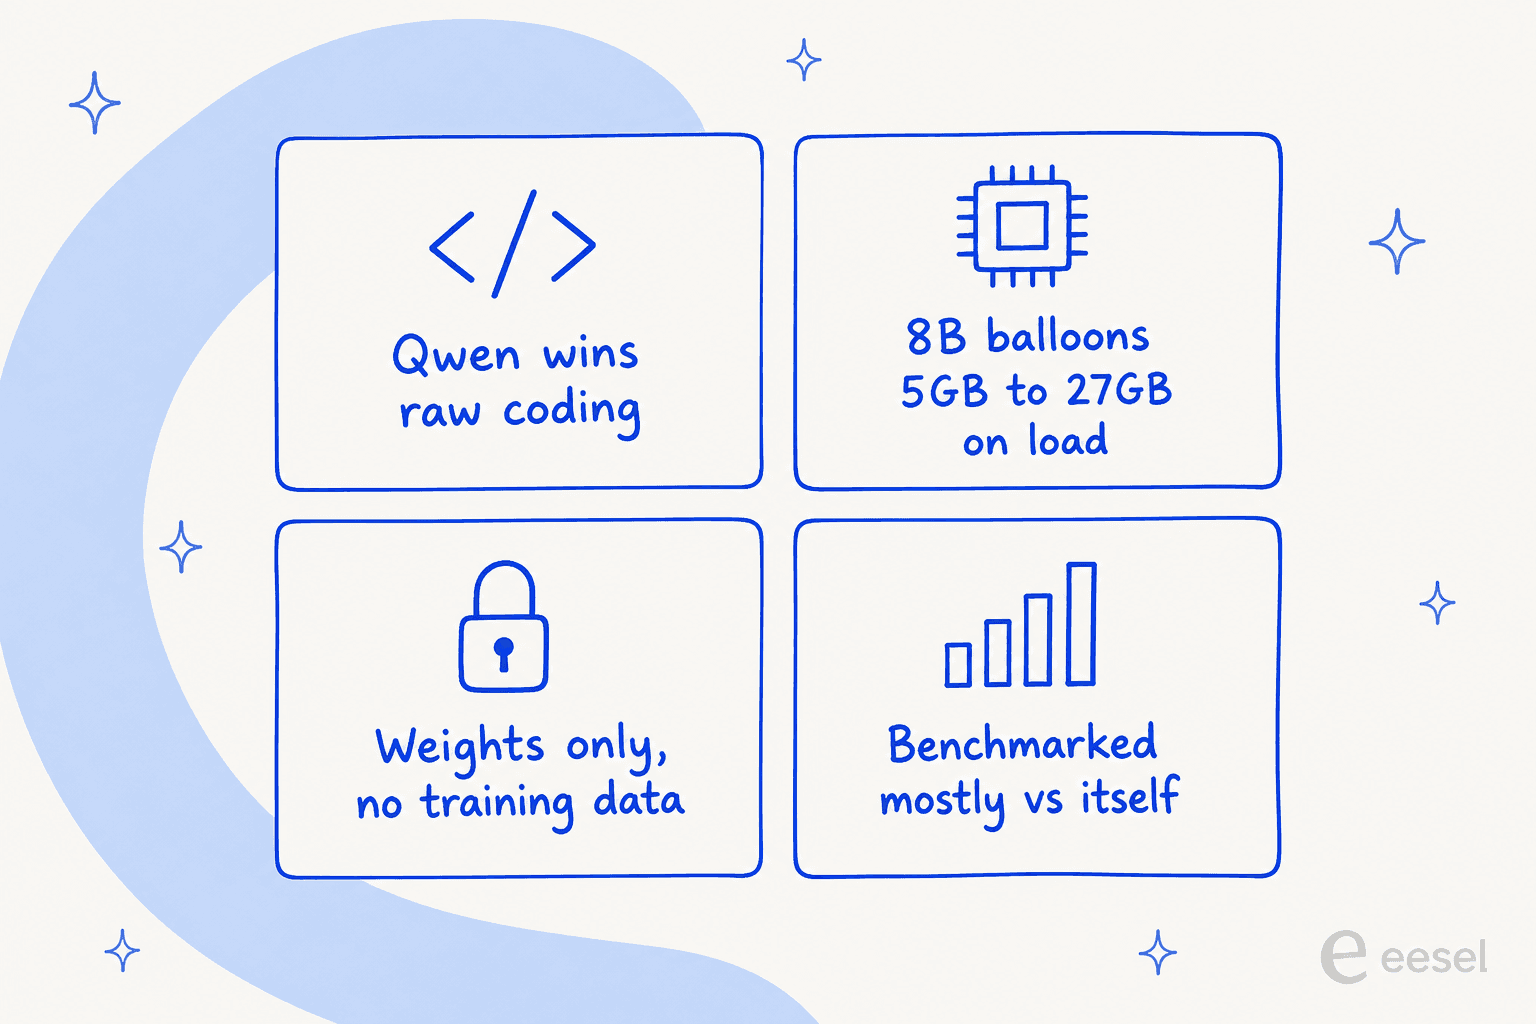
Capacidad bruta, sobre todo en programación. Es la razón más repetida. En Hacker News, la frase recurrente es contundente:
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."

Incluso quienes quedaron contentos con Granite mantuvieron su favorito de siempre para lo difícil:
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly. Qwen3.6 35b a3b is still my local champion but I may use this for auto complete and small tasks."
IBM se compara sobre todo consigo misma. Las fichas de modelo de Granite lo comparan con versiones anteriores de Granite y un conjunto reducido de rivales como Nemotron de NVIDIA y Gemma de Google, no con Qwen. Eso genera un tipo concreto de escepticismo:
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."
Un inconveniente operativo real. El 8B es una descarga de 5,3 GB, pero un hilo de r/LocalLLaMA muy compartido señaló que puede inflarse hasta 27 GB en memoria al cargar una vez asignada la caché KV, lo bastante como para dejarlo fuera de una GPU de consumo. Conviene comprobarlo antes de comprometerte.
"Solo pesos no es realmente código abierto." Granite publica pesos bajo Apache 2.0, pero no los datos ni la receta de entrenamiento, y parte de la comunidad mantiene una línea más estricta sobre lo que debería significar "abierto". Si te importa la reproducibilidad, esa brecha es un motivo para mirar modelos que publican más.
También está el ángulo práctico del costo. Digamos que ejecutas una carga tipo soporte de 5 millones de tokens de salida al mes. Con la tarifa alojada confirmada más barata de Granite 4.2 son unos $1.25; con Kimi K3, los mismos tokens cuestan $75. Esa diferencia de 60 veces es justo la razón por la que vale la pena responder con cuidado a "qué alternativa" en lugar de agarrar lo que lideró un ranking la semana pasada.
Cómo elegí estas alternativas
Incliné la lista hacia lo que Granite realmente es: un modelo abierto, de tamaño pequeño a medio y con capacidad de razonamiento que puedes alojar tú mismo a bajo costo. El listón fue:
- Primero, pesos abiertos. Seis de los siete publican pesos descargables, porque esa es la razón por la que se ejecuta Granite en vez de una API cerrada. Gemini 3.6 Flash es la única opción solo alojada, incluida porque muchos equipos cambiarían gustosamente apertura por un endpoint gestionado.
- Razonamiento y uso de herramientas. La característica principal de Granite es el pensamiento conmutable y las llamadas a herramientas apoyadas en razonamiento, así que todos los modelos de aquí pueden razonar y llamar herramientas en un bucle de agente.
- Precios reales y verificables. Nada de "contacta con ventas". Cada precio de abajo se remonta a una página del proveedor. (Si tu pregunta real es qué motor poner detrás de un bot de soporte, lo comparé aparte en mejor modelo de IA para tickets de soporte.)
- Solo fuentes primarias. Las especificaciones salen de fichas de modelo y páginas de precios; la opinión, de Hacker News, Reddit y X, no de listas de agregadores.
Aquí está todo el panorama de un vistazo antes de ir herramienta por herramienta.
| Modelo | Mejor para | Pesos abiertos | Licencia | Contexto | Alojado entrada/salida por 1M | Razonamiento |
|---|---|---|---|---|---|---|
| Granite 4.2 (el actual) | Agentes empresariales on-prem | Sí | Apache 2.0 | 128K–512K | $0.06 / $0.25 | Conmutable |
| Qwen 3.8 | Capacidad bruta de programación | Sí (27B Apache) | Mixta | 1M | $2 / $6 (Max) | Activo (xhigh) |
| DeepSeek V4 Flash | Costo a escala | Sí | MIT | 1M | $0.22 / $0.66 (fuera de hora punta) | Activo (high) |
| GLM 5.3 Flash | Agentes multimodales baratos | Sí | Abierta | 1M | $0.075 / $0.25 (promo) | Solo pensamiento |
| Kimi K3 | Agentes de largo recorrido | Sí | Modificada | 1M | $3 / $15 | Siempre activo |
| Mistral Large 3 | Europeo / on-prem | Parcial (modelos pequeños Apache) | Mixta | 128K+ | $0.50 / $1.50 | Opcional |
| Gemini 3.6 Flash | API gestionada alojada | No | Propietaria | 1M | $1.50 / $7.50 | Opcional |
| NVIDIA Nemotron 3 | Stack NVIDIA, recetas abiertas | Sí | Abierta | hasta 1M | Endpoints gratuitos / cómputo | Sí |
Las 7 mejores alternativas a Granite 4.2 en 2026
1. Qwen 3.8 - lo mejor en capacidad bruta y programación
Ideal para: equipos que eligieron Granite por la licencia pero chocan una y otra vez con su techo en programación y razonamiento difíciles.
Si hay un solo modelo al que recurre la comunidad de LLM locales en lugar de Granite, es Qwen. La comparación es tan automática que, cuando salió Granite 4.2, la pregunta principal en X era literalmente cómo se comparaba:
"Anyone tested Granite 4.2 30B from IBM yet? How does it compare to Qwen-3.8-27B?"
Qwen 3.8 viene en dos formas. El buque insignia Qwen 3.8 Max es un modelo de mezcla de expertos de 2,4T parámetros (95B activos) con contexto de 1M de tokens, vendido como API alojada. Por debajo está el checkpoint abierto Qwen3.8-27B con una licencia Apache 2.0 de verdad, que es la comparación directa con los tamaños abiertos de Granite. Conviene saber que los pesos base abiertos de Max usan la licencia restrictiva propia de Alibaba, no Apache, así que "Qwen abierto" con libertad comercial significa el 27B, no el gigante.
Dónde supera a Granite: en capacidad bruta, sin más. En LMArena, Qwen 3.8 Max está cerca de la cima en texto y desarrollo web, y el veredicto de la comunidad sobre programación está zanjado. El contexto de 1M también eclipsa los 128K nativos de Granite.
Dónde se queda corto: la opción limpia con Apache es el 27B, no el Max de portada, así que la historia de apertura es más estrecha de lo que parece. Y el arnés de programación de Qwen viene configurado con un techo de salida de 64K, así que la cifra de "1M de contexto" es más teórica de lo que la mayoría de las cargas llegará a tocar.
Precios: el 27B abierto es gratis de alojar. Qwen 3.8 Max en la nube de Alibaba cuesta $2 por millón de tokens de entrada y $6 por millón de salida, con lecturas de entrada en caché a $0.25.
Veredicto: si dejaste Granite porque no daba la talla en programación o razonamiento difícil, Qwen es el primer lugar donde mirar. Elige el 27B si importa una licencia limpia, o el Max alojado si quieres la versión más potente y no te molestan los términos de Alibaba.
2. DeepSeek V4 Flash - lo mejor en costo a escala
Ideal para: cargas de alto volumen donde la factura por token es lo que realmente decide la arquitectura.
DeepSeek V4 Flash es el campeón del presupuesto de esta lista y, a diferencia del modelo estrella de Qwen, tiene de verdad licencia MIT, una de las más permisivas que existen.
Es un modelo de mezcla de expertos de 284B parámetros (13B activos) con contexto de 1M de tokens, publicado como unos 167 GB de pesos abiertos. El razonamiento viene activado por defecto en "high", y aquí está la particularidad que lo hace interesante: la configuración barata y la buena son literalmente ejecuciones distintas de los mismos pesos (el equilibrio entre RAG y LLM en bruto también aparece aquí, porque pensar más implica más tokens facturados). Las cifras de DeepSeek muestran que Flash saca 8.1 en HLE sin pensamiento frente a 34.8 con esfuerzo máximo. Tú eliges cuánto piensa, y pagas los tokens de razonamiento a la tarifa de salida.
Dónde supera a Granite: en precio y en una licencia más limpia. Además es un modelo mucho más grande que el 30B de Granite, así que con esfuerzo máximo alcanza capacidades que los tamaños pequeños de Granite no logran.
Dónde se queda corto: es solo texto (sin entrada de imagen documentada), puede ser verboso y hay un problema real de gobernanza de datos. Los términos de la API de pago de DeepSeek callan sobre si entrenan con tus entradas, y el servicio opera bajo la ley de la RPC, así que no sirve sin más para datos regulados de clientes (si manejas datos de soporte, aquí importa el ángulo de SOC 2 y GDPR). Vigila también el reloj de precios: las tarifas se duplican en horas punta (01:00–04:00 y 06:00–10:00 UTC), que casualmente son horas valle para la mayoría de las colas occidentales.
Precios: fuera de hora punta, la entrada sin caché cuesta $0.22 por millón y la salida $0.66; las tarifas de hora punta son exactamente el doble. Alojar tú mismo los pesos MIT es gratis.
Veredicto: si tu carga es grande y tus datos no están regulados, nada aquí supera a DeepSeek en costo por unidad de capacidad. Solo construye tu modelo de costos sobre la tarifa de hora punta para que un cambio de zona horaria nunca te sorprenda, y mantén los datos personales de clientes fuera de la API propia.
3. GLM 5.3 Flash - lo mejor en agentes multimodales baratos
Ideal para: quienes construyen y quieren agentes multimodales aficionados a las herramientas con pesos abiertos sin pagar precios de frontera.
GLM 5.3 Flash de Z.ai (Zhipu) es el modelo más nuevo de aquí, y se apoya justo en el nicho agéntico y de llamadas a herramientas donde Granite es más fuerte, y luego lo supera en precio.
Es un MoE de 320B parámetros (18B activos), el primer modelo nativamente multimodal de la línea GLM-5, con contexto de 1M y pesos abiertos en Hugging Face. Obtiene un Artificial Analysis Intelligence Index de 57, igualando a modelos mucho más caros, a una fracción del costo por tarea.
Dónde supera a Granite: es nativamente multimodal (Granite 4.2 no tiene variante de visión), el contexto es 8 veces mayor y el precio promocional es casi gratis. También lideró durante un tiempo los gráficos de uso de OpenRouter, así que está probado a volumen.
Dónde se queda corto: el razonamiento siempre está activo y no se puede desactivar, así que no hay un verdadero modo "rápido, barato y sin pensar" como el que ofrece Granite. La API propia además es lenta (~49 tokens/segundo); querrás un host más rápido como Databricks para trabajo sensible a la latencia.
Precios: tarifas promocionales de $0.075 por millón de entrada y $0.25 por millón de salida (lista $0.15/$0.50), con la promoción vigente hasta el 9 de septiembre de 2026, y entrada en caché a $0.015. Un GLM Coding Plan aparte cuesta $18/$80/$168 al mes. Los pesos abiertos son gratis de alojar.
Veredicto: para agentes baratos que necesitan ver imágenes y llamar herramientas, GLM 5.3 Flash es el cambio más directo de "Granite pero más grande y multimodal" de esta lista. Solo ten en cuenta que siempre piensa.
4. Kimi K3 - lo mejor en trabajo agéntico de largo recorrido
Ideal para: ejecuciones de agentes complejas y de varios pasos donde prefieres pagar más antes que vigilar a un modelo más débil.
Kimi K3 de Moonshot AI es la opción premium de pesos abiertos: más grande, más cara y ajustada para razonamiento agéntico sostenido en lugar de rendimiento barato.
Es un MoE de 2,8T parámetros (104B activos) con contexto de 1M de tokens y visión nativa, y Moonshot publicó los pesos abiertos según lo previsto. En el Artificial Analysis Intelligence Index queda en torno a 57 (n.º 4 en general), superando a algunos modelos de frontera en muchas tareas.
Dónde supera a Granite: es un modelo mucho más fuerte en tareas difíciles y de larga duración, y un razonador agéntico serio donde los tamaños pequeños de Granite se quedan sin margen.
Dónde se queda corto: el precio. A $3 de entrada / $15 de salida por millón de tokens, está en la misma banda que Claude Sonnet, unas 50 veces la tarifa de salida de DeepSeek, así que es lo opuesto a una opción económica. Además, el razonamiento no se puede desactivar en ningún nivel (el ajuste de esfuerzo es un control de latencia, no un nivel de costo), y los pesos abiertos son una descarga de 1.561 GB, así que "alojarlo tú mismo" aquí implica infraestructura seria.
Precios: $3 por millón de entrada, $0.30 con acierto de caché, $15 por millón de salida. Los planes de la app de consumo son Free / $19 / $39 / $99 / $199 al mes.
Veredicto: Kimi K3 es lo que eliges cuando la tarea es tan difícil que un modelo más barato fallaría y el costo del fallo supera el costo de los tokens. Para trabajo rutinario de alto volumen es excesivo frente a Granite o DeepSeek.
5. Mistral (Large 3 + modelos abiertos) - lo mejor para equipos europeos y on-prem limpio
Ideal para: equipos que quieren un proveedor no estadounidense, residencia de datos en la UE y licencias realmente permisivas para modelos pequeños.
Mistral es la respuesta europea a la propuesta de "abierto, licenciable, on-prem" que atrae a la gente a Granite en primer lugar, y sus modelos pequeños se publican bajo Apache 2.0.
La gama se divide con claridad: Mistral Large 3 es el buque insignia alojado, Codestral y Devstral cubren programación y trabajo agéntico, y una familia de modelos abiertos más pequeños cubre el caso de autoalojamiento. El asistente de consumo de Mistral, antes llamado Le Chat, ahora se llama Vibe.
Dónde supera a Granite: jurisdicción europea y una propuesta empresarial madura (residencia de datos en la UE, despliegue on-prem). Los modelos abiertos pequeños dan una vía de autoalojamiento con licencia Apache y un proveedor occidental detrás, algo que importa en las compras de una forma que el texto de la licencia por sí solo no recoge.
Dónde se queda corto: los mejores y más grandes modelos de Mistral son los alojados de pago, así que el nivel abierto no es la frontera. Y en capacidad pura de benchmarks, los modelos abiertos chinos (Qwen, DeepSeek, GLM) tienden a liderar ahora mismo.
Precios: Mistral Large 3 ronda los $0.50 por millón de entrada y $1.50 por millón de salida; Codestral cuesta aproximadamente $0.30/$0.90. Los planes de consumo de Vibe son Free / $14.99 / $24.99 por usuario al mes. Los modelos abiertos pequeños son gratis de alojar.
Veredicto: si tu razón para ir a abierto fue la gobernanza y la jurisdicción del proveedor y no exprimir el último centavo de un benchmark, Mistral es el encaje más cómodo aquí. Si fue la capacidad bruta, mira primero Qwen o DeepSeek.
6. Google Gemini 3.6 Flash - lo mejor en API gestionada y alojada
Ideal para: equipos que prefieren no tocar nunca pesos y solo quieren un endpoint alojado rápido, barato y fiable.
No todos los usuarios de Granite quieren alojarlo ellos mismos; algunos solo quieren un caballo de batalla barato y más o menos abierto, y eligieron Granite porque era económico. Para ellos, Gemini 3.6 Flash es la alternativa cerrada pero sencilla.
Es el nivel Flash "caballo de batalla" de Google, lanzado el 21 de julio de 2026, con ~1M de tokens de contexto, uso de computadora integrado y fecha de corte de conocimiento en marzo de 2026. Google informa que usa aproximadamente un 17% menos de tokens de salida que el Flash anterior en las mismas tareas, lo que reduce discretamente la factura real.
Dónde supera a Granite: cero carga operativa. Sin GPUs, sin configuración de vLLM, sin sorpresas de caché KV. Es fuerte en uso de computadora y tareas de contexto largo, y es realmente rápido.
Dónde se queda corto: es propietario y solo alojado, así que no hay autoalojamiento, ni on-prem, ni libertad de licencia, justo lo que la mayoría buscaba en Granite. Y el precio de salida es alto para esta lista.
Precios: $1.50 por millón de entrada y $7.50 por millón de salida, con solicitudes por lotes al 50% de descuento ($0.75/$3.75).
Veredicto: si nunca te importaron los pesos abiertos y solo querías una API barata y capaz, Gemini 3.6 Flash es una vida más limpia que ejecutar Granite tú mismo. Si la apertura o el on-prem eran el punto, es la dirección equivocada.
7. NVIDIA Nemotron 3 - lo mejor para el stack de NVIDIA y recetas realmente abiertas
Ideal para: equipos que ya usan hardware NVIDIA y cualquiera que quiera la reproducibilidad que Granite no ofrece.
La familia Nemotron de NVIDIA es uno de los rivales contra los que IBM realmente compara Granite, lo que la convierte en un cara a cara natural, y responde directamente a la queja de "solo pesos no es abierto".
Nemotron es la línea de modelos fundacionales de NVIDIA diseñados para lenguaje, razonamiento, visión y recuperación. Los modelos de lenguaje actuales van desde nemotron-3.5-lightning-30b-a3b (un MoE de 30B totales / 3B activos ajustado para agentes autónomos de larga ejecución) hasta nemotron-3-ultra-550b-a55b (un MoE híbrido abierto Mamba-Transformer con contexto de 1M, creado para razonamiento agéntico, programación y llamadas a herramientas). Lo crucial: NVIDIA dice que la familia se publica con "open weights, open datasets, and reproducible training recipes."
Dónde supera a Granite: esa línea de reproducibilidad es todo el argumento. Donde Granite da pesos, Nemotron da pesos, datos y receta, que es la definición más estricta de abierto que reclama parte de la comunidad. Además está optimizado para silicio NVIDIA, y puedes llamar a los modelos gratis en build.nvidia.com antes de comprometerte.
Dónde se queda corto: los mejores modelos Nemotron son grandes (el ultra tiene 550B), así que la historia de "corre en un portátil" que hace entrañable al 3B de Granite no se aplica en lo alto de la gama. Y el precio minorista por token es menos claro que el de los demás; el alojamiento en producción pasa por NVIDIA NIM o socios de nube y se cobra por cómputo.
Precios: los pesos abiertos se descargan gratis, y NVIDIA ofrece endpoints alojados gratuitos en build.nvidia.com. El alojamiento en producción mediante NVIDIA NIM o un socio de nube se cobra por el cómputo subyacente y no por una tarifa pública por token.
Veredicto: si ya estás en infraestructura NVIDIA, o si la pregunta de "¿es realmente abierto?" es la razón por la que dejas Granite, Nemotron es el cambio más coherente de la lista. Solo dimensiónalo a tu hardware.
Lo que todos los modelos de esta lista tienen en común
Esta es la parte que se pierde en los hilos de benchmarks. Elijas Granite, Qwen, DeepSeek o Nemotron, has elegido un motor. Un modelo, por sí solo, no conoce tu política de reembolsos, no puede ver tus tickets de Zendesk y no tiene idea de si la respuesta que acaba de generar es segura para enviar a un cliente real. Esa es toda la razón por la que la IA para atención al cliente es una categoría de producto y no solo una clave de API.
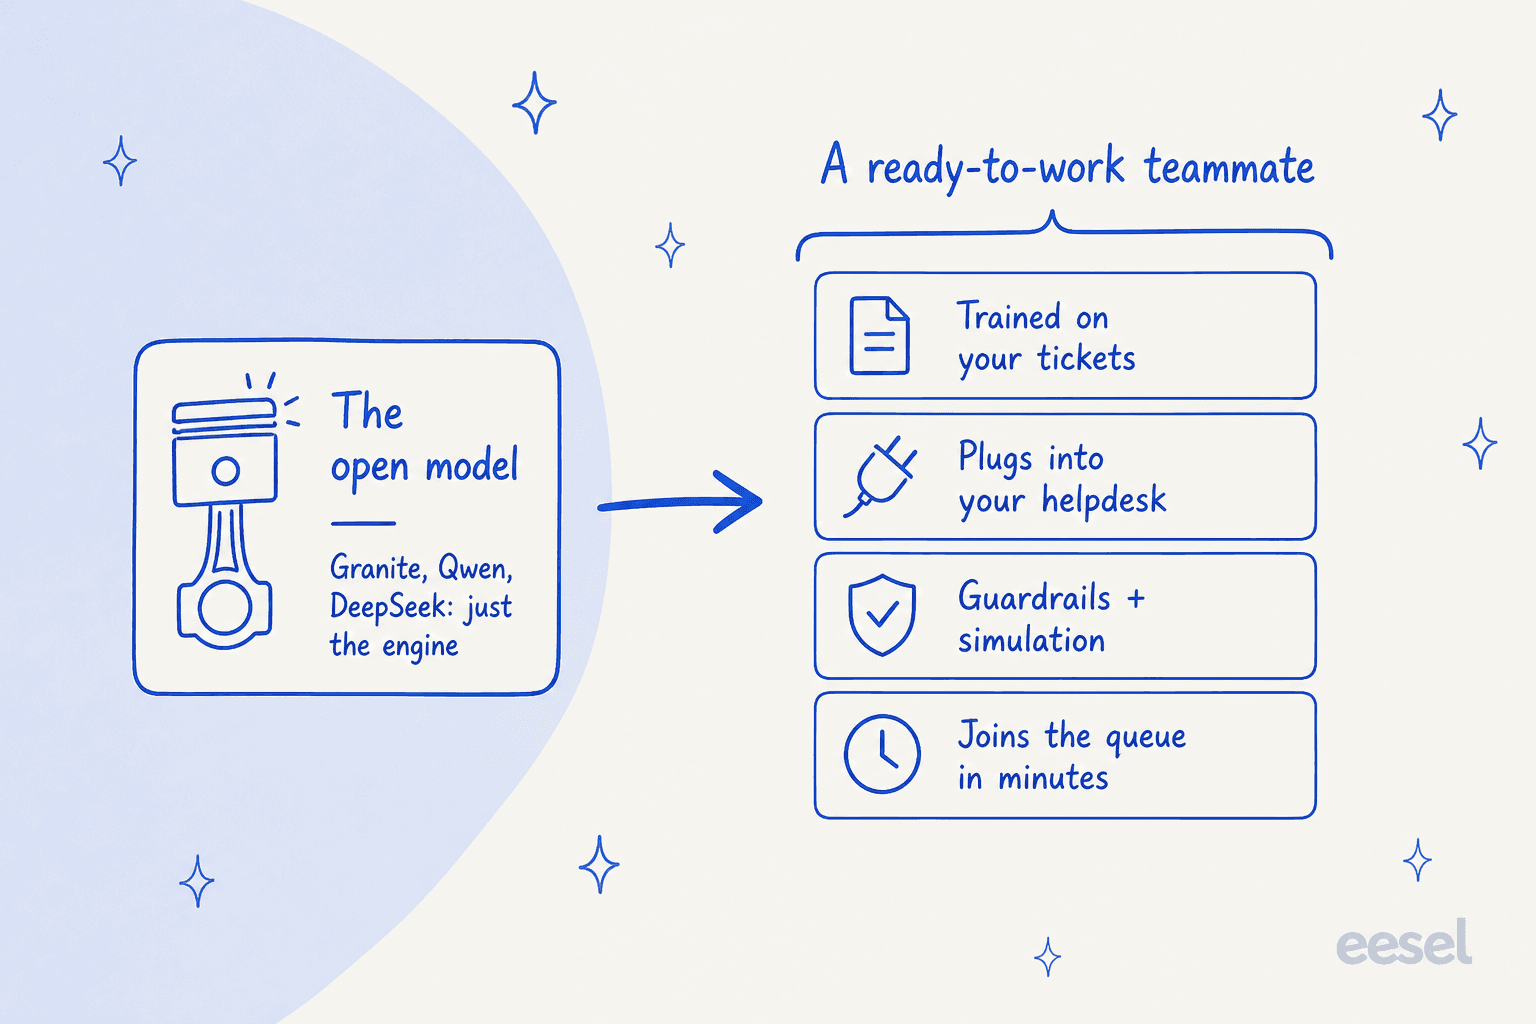
Si estás eligiendo entre estos modelos para construir algo, perfecto; elige el motor que encaje y adelante. Pero si el objetivo real es un agente de IA que resuelva tickets de soporte, cambiar Granite por Qwen modifica el 10% fácil y deja intacto el 90% difícil: conectar con tu base de conocimiento, integrarse con el helpdesk, escribir las barreras de seguridad y demostrar que es seguro antes de salir en producción. Esa es la diferencia entre un agente de IA y un chatbot basado en reglas, y ahí está todo el trabajo real.
Prueba eesel: la capa que ningún modelo de esta lista te da
Si tu objetivo es responder tickets y no elegir un modelo sobre el que construir, ese es justo el hueco que cubre eesel. Cada modelo de arriba te da un motor. eesel es el compañero de IA para helpdesk listo para trabajar que ya tiene un motor, más todo lo que lo rodea: se entrena con tus tickets anteriores y tu centro de ayuda, se conecta al helpdesk que ya usas (Zendesk, Freshdesk, Gorgias y más de 1.000 integraciones), y se une a la cola en minutos en lugar de trimestres.

La diferencia es la red de seguridad que un modelo desnudo, Granite o cualquier otro, no trae: antes de que eesel responda a un solo cliente real, puedes simularlo con miles de tickets históricos para ver exactamente cómo habría respondido y qué habría resuelto. Usa cualquier modelo de esta lista si estás construyendo. Usa un compañero de IA para helpdesk si lo que quieres es responder tickets. Puedes probar eesel gratis, sin tarjeta de crédito y sin llamada de ventas para empezar.
Preguntas frecuentes
¿Cuál es la mejor alternativa de pesos abiertos a IBM Granite 4.2?
En capacidad bruta, la comunidad de LLM locales señala una y otra vez a Qwen: su checkpoint abierto de 27B es Apache 2.0 y supera a Granite en programación. Si el factor decisivo es el costo, DeepSeek V4 Flash tiene licencia MIT y es más barato de operar a escala. Ambos se tratan en detalle más arriba, junto con nuestro resumen de Granite 4.2.
¿Hay una alternativa más barata a Granite 4.2?
Granite ya está cerca del piso: los pesos son Apache 2.0, así que alojarlo uno mismo es gratis, y el 8B de Replicate cuesta $0.06/$0.25 por millón de tokens. Entre las tarifas alojadas, el precio promocional de GLM 5.3 Flash ($0.075/$0.25) es comparable, y la salida de DeepSeek V4 Flash fuera de hora punta cuesta $0.66. Aun así, el modelo rara vez es la parte cara de un agente de IA; lo caro son el conocimiento, las integraciones y las barreras de seguridad.
¿Qué alternativa a Granite 4.2 es mejor para programar?
Qwen es la opción consensuada para programar entre quienes ejecutan modelos en local, y DeepSeek V4 Flash también rinde bien. El 30B de Granite 4.2 es creíble (57.0 en SWE-Bench Verified), pero para generar código puro la mayoría de los analistas sigue recurriendo a Qwen. Si estás eligiendo un modelo para automatizar el soporte en lugar de una herramienta de programación, consulta nuestra guía del mejor modelo de IA para tickets de soporte.
¿Las alternativas a Granite 4.2 se ejecutan en hardware propio?
La mayoría sí. Qwen, DeepSeek V4 Flash, GLM 5.3 Flash, Kimi K3, los modelos pequeños de Mistral y NVIDIA Nemotron publican pesos abiertos que puedes descargar y ejecutar con Ollama, vLLM o llama.cpp. Gemini 3.6 Flash de Google es la excepción; solo está alojado. Para usar cualquiera con clientes reales sigues necesitando recuperación y barreras de seguridad alrededor del modelo.
¿Qué debería usar en lugar de Granite 4.2 para crear un agente de soporte?
Si el objetivo es resolver tickets y no construir infraestructura, no quieres un modelo en bruto, sino la capa que va encima. eesel es un compañero de IA para helpdesk que se entrena con tus tickets anteriores y tu centro de ayuda, se conecta a tu helpdesk actual y se puede simular con tickets históricos antes de responder a un solo cliente real. El modelo de base es la parte fácil.